Yann LeCun tient peut-être la preuve que la taille d’un LLM ne fait pas sa qualité
Dans une étude mise en ligne le 29 octobre, Yann LeCun et Randall Balestriero affirment démontrer qu’un petit modèle d’IA bien nourri se fait une meilleure image du monde qu’un LLM 660 fois plus gros.
« Yann LeCun avait raison », s’enthousiasme l’influenceuse IA Shruti Mishra sur X, le 1er novembre 2026. Pourquoi autant d’enthousiasme à propos d’un article scientifique touffu, publié sur arXiv le 29 octobre par Yann LeCun et Randall Balestriero ? D’une part, parce que les deux chercheurs sont liés à AMI Labs, la start-up parisienne fondée par LeCun après son départ de Meta et qu’il est toujours très intéressant de voir des publications sortir de ce laboratoire.
D’autre part, parce que son titre sobre (Proving and Improving the Platonic Representation Hypothesis with JEPAs) cache une belle démonstration, cruciale pour l’avenir de l’IA. Explications.
C’est quoi l’hypothèse « platonicienne » ?
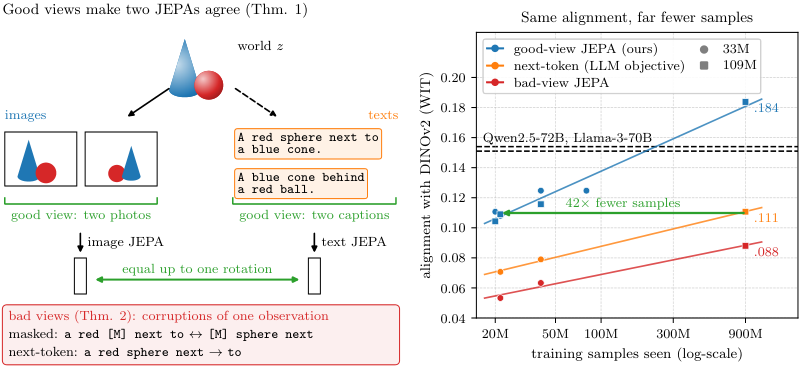
En 2024, des chercheurs du MIT ont remarqué que des modèles entraînés séparément sur du texte ou des images finissent par se construire des représentations internes du monde de plus en plus proches à mesure qu’ils grossissent. Ils ont baptisé cette idée en référence au monde des idées de Platon (l’allégorie de la caverne, au programme de votre année terminale, cela devrait faire remonter quelques souvenirs). Problème : il s’agissait d’une observation, sans démonstration.
Balestriero et LeCun disent avoir transformé cette intuition en théorème, pour une famille de modèles précise : les JEPA (Joint-Embedding Predictive Architectures), l’architecture que LeCun défend depuis des années. Selon eux, deux JEPA entraînés chacun sur une modalité différente apprennent la même représentation, à une rotation près, à condition de leur montrer de « bonnes vues » : deux observations d’une même scène, comme une photo et sa légende.
Le papier interprète les LLM à travers cette grille de lecture. La prédiction du mot suivant, qui fait tourner ChatGPT et consorts, serait une JEPA nourrie de « mauvaises vues » : deux morceaux d’un même document, qui ne décrivent pas forcément la même chose. D’où, selon les auteurs, le fait que les modèles de langage ne s’alignent sur la vision qu’à force de grossir.
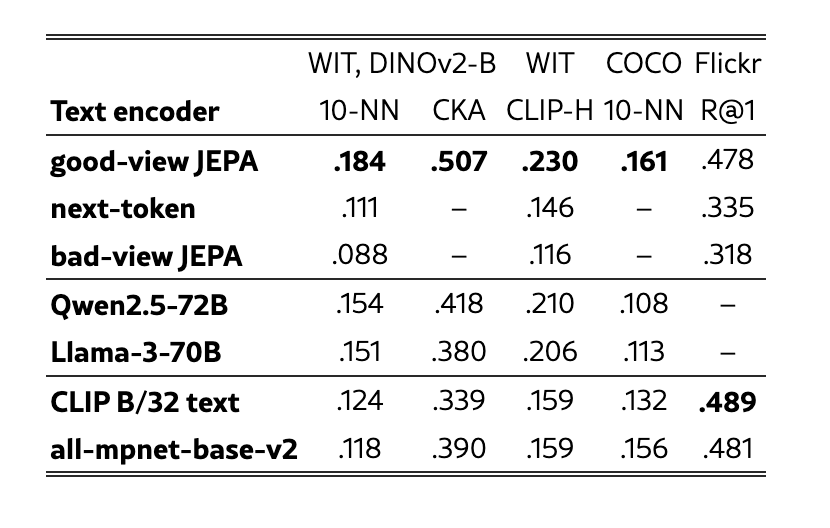
C’est côté expériences que les chiffres frappent. Un JEPA texte de 109 millions de paramètres s’aligne mieux sur les encodeurs d’images DINOv2 et CLIP que tous les modèles de langage testés, jusqu’à 72 milliards de paramètres. Sur DINOv2, le petit modèle obtient un score d’alignement de 0,184, contre 0,154 pour Qwen2.5-72B, selon Startup Fortune. Il lui faudrait aussi 42 fois moins d’exemples d’entraînement pour atteindre le même alignement qu’un modèle qui prédit le mot suivant. Les auteurs ont testé leur théorie sur des corpus allant de 145 000 légendes à 940 millions d’images.
Ce que ça dit des LLM (et de leur avenir)
Pour LeCun, la publication tombe à pic. Le chercheur répète depuis des années que les LLM ne mèneront pas à une IA qui comprend le monde physique, et AMI Labs a levé 1,03 milliard de dollars en mars sur ce pari.
En attendant, l’article n’a pas encore été relu par des pairs, et aucune équipe indépendante n’a reproduit la comparaison. Le score repose sur une métrique d’alignement choisie par les auteurs : être « plus proche d’un modèle de vision » ne garantit pas de mieux résumer un PDF ou d’écrire du code. Le petit JEPA ne remplacera pas Qwen ou GPT demain matin.
Le message de fond reste intéressant pour toute l’industrie : ce qu’on montre au modèle pendant l’entraînement compterait davantage que le nombre de GPU qu’on empile. Une bonne nouvelle pour la crise de la RAM et la facture d’électricité des datacenters (un peu moins pour Nvidia).
Ce contenu est bloqué car vous n’avez pas accepté les cookies et autres traceurs. Ce contenu est fourni par YouTube.
Pour pouvoir le visualiser, vous devez accepter l’usage étant opéré par YouTube avec vos données qui pourront être utilisées pour les finalités suivantes : vous permettre de visualiser et de partager des contenus avec des médias sociaux, favoriser le développement et l’amélioration des produits d’Humanoid et de ses partenaires, vous afficher des publicités personnalisées par rapport à votre profil et activité, vous définir un profil publicitaire personnalisé, mesurer la performance des publicités et du contenu de ce site et mesurer l’audience de ce site (en savoir plus)
En cliquant sur « J’accepte tout », vous consentez aux finalités susmentionnées pour l’ensemble des cookies et autres traceurs déposés par Humanoid et .
Vous gardez la possibilité de retirer votre consentement à tout moment. Pour plus d’informations, nous vous invitons à prendre connaissance de notre Politique cookies.
Toute l'actu tech en un clin d'œil
Ajoutez Numerama à votre écran d'accueil et restez connectés au futur !
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.