ИИ-Стоматолог 2
Анализ рентгенограмм зубов с помощью YOLOv8l: очистка датасета, двухстадийное обучение и калибровка порогов
1 Контекст и изменение состава классов
В первой части работы прототип YOLO26n тестировался на четырех классах стоматологических патологий (на тестовой выборке полнота составила 0.966 для класса Impacted, 0.837 для Deep Caries, 0.768 для Periapical Lesion и 0.581 для Caries). Во время проверки выяснилось, что в обучающий архив попали цветные фотографии ротовой полости, которые вызывали срабатывания модели вне целевого распределения данных.
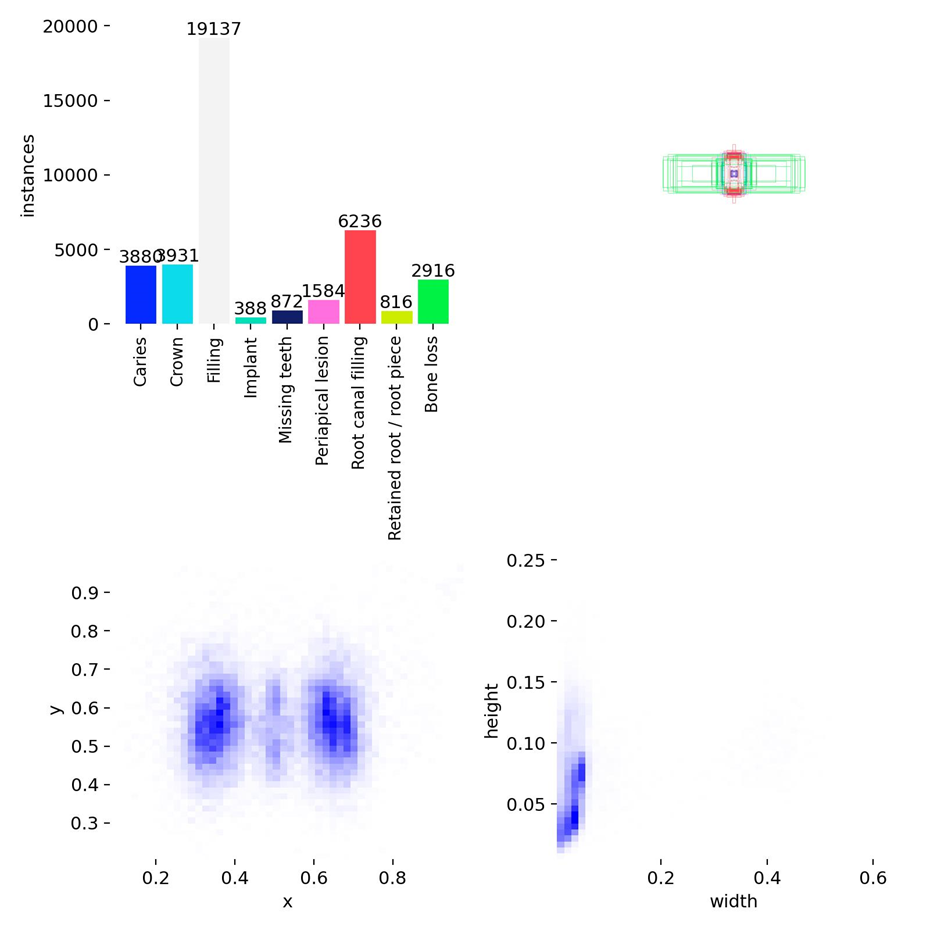
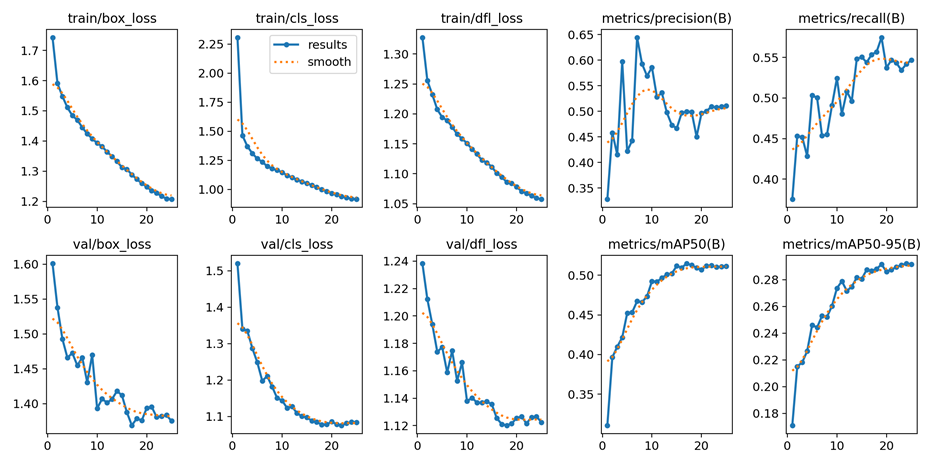
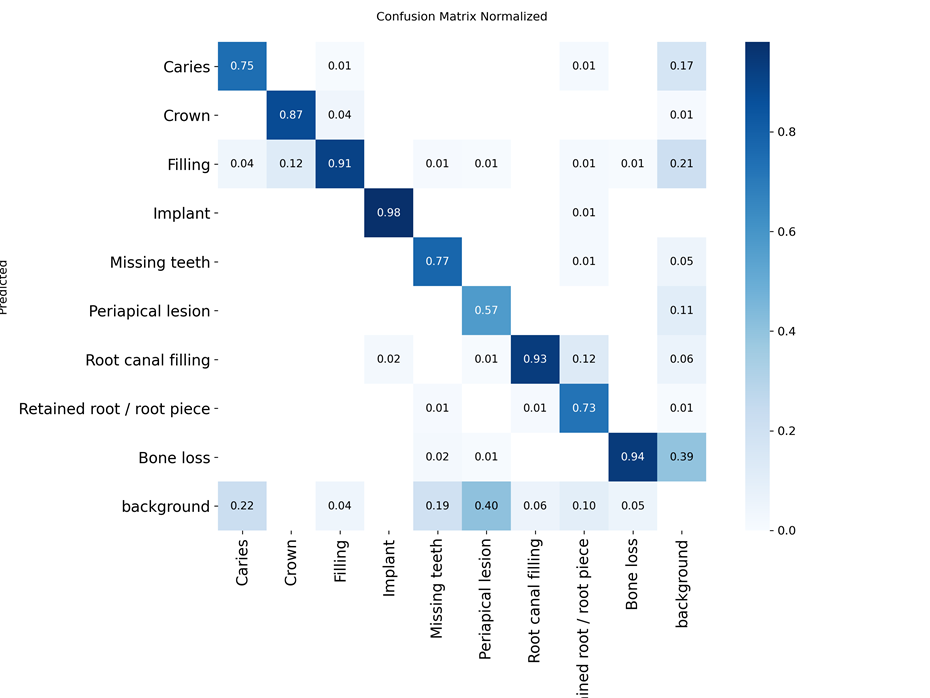
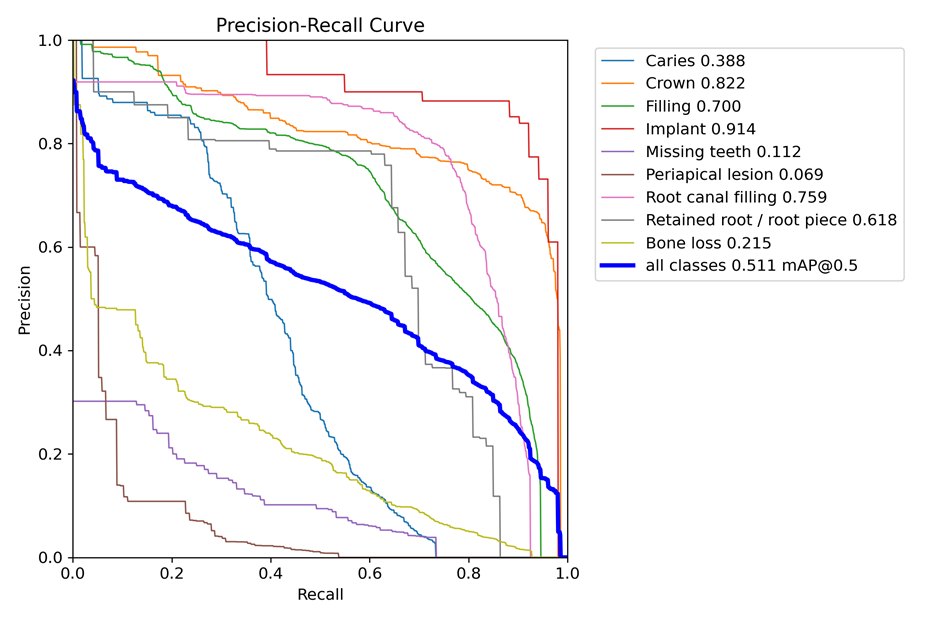
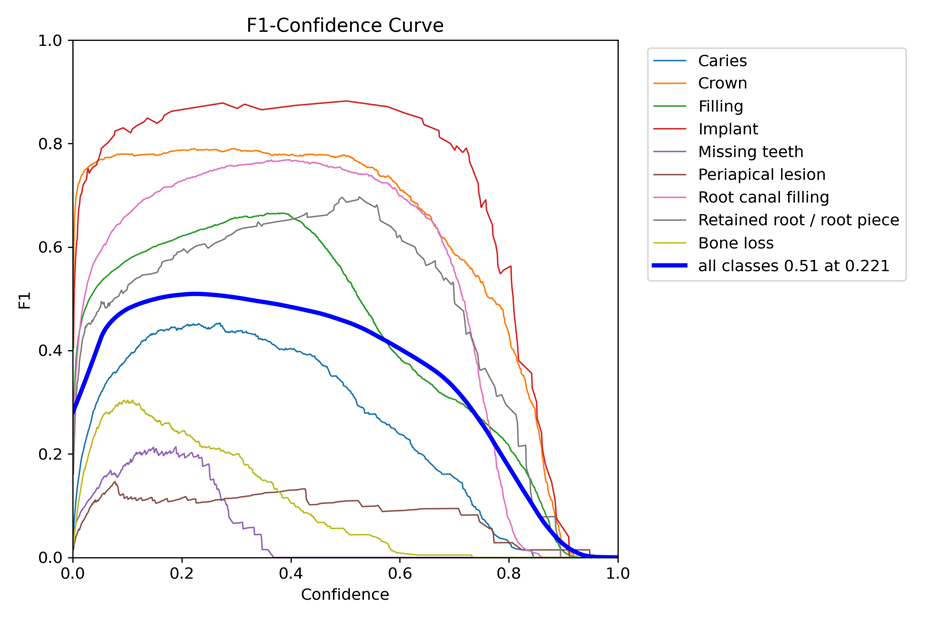
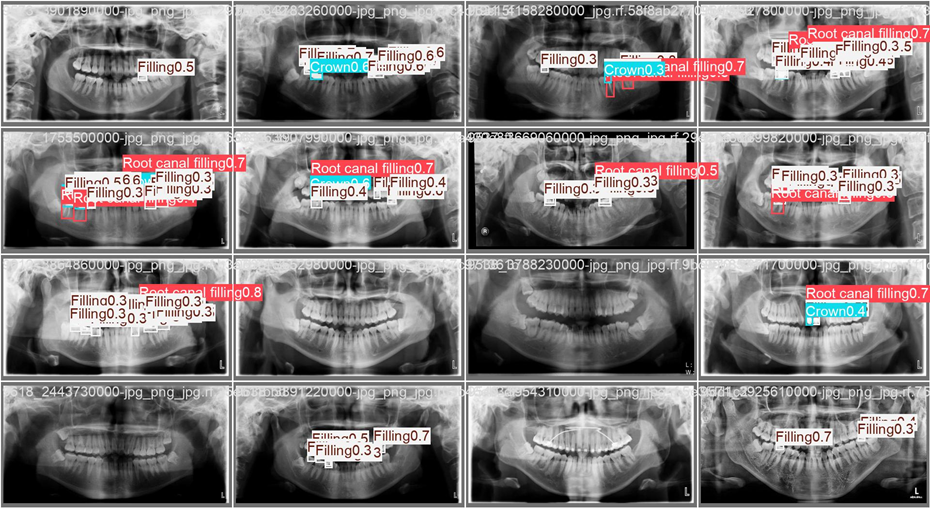
На промежуточном этапе очистки данных в Google Colab при подключении архива Loki_Dental проверялась расширенная схема из девяти классов, включавшая патологии и стоматологические реставрации (Caries, Crown, Filling, Implant, Missing teeth, Periapical lesion, Root canal filling, Retained root / root piece, Bone loss). В этой выборке класс пломб (Filling, 19 137 объектов) и пломбированных каналов (Root canal filling, 6 236 объектов) составил свыше 65% всех меток, а на периапикальные очаги приходилось 1 584 объекта (Рисунок 1). В девятиклассовом запуске общий показатель mAP50 составил 0.511 (mAP50-95 = 0.290), при этом для класса Periapical lesion метрика AP50 составила 0.069, а 40% размеченных очагов относились моделью к фону (Рисунки 2–5, 8).
В финальной версии датасета Clean_Dental_v3 перед обучением на NVIDIA A100 80GB мы исключили реставрации и оставили четыре класса патологий:
1. Caries (код МКБ-10: K02.1) - начальный и средний кариес эмали и дентина;
2. Deep Caries (K02.1 / K04.0) - глубокий кариес с проекционным расстоянием до пульпарной камеры менее 2 мм;
3. Impacted (K01.0 / K01.1) - ретинированные и дистопированные зубы;
4. Periapical Lesion (K04.5) - периапикальное разрежение костной ткани у верхушки корня.
В финальном четырехклассовом эксперименте mAP50 составил 0.642 (AP50 для класса Periapical Lesion - 0.516). Прямое сравнение с девятиклассовой версией ограничено различиями в составе классов, объеме выборки и протоколе обучения.
2 Формирование выборки Clean_Dental_v3 и разделение данных
Выборка Clean_Dental_v3 собрана из трех источников: соревновательного датасета DENTEX Challenge (MICCAI 2023, разрешение снимков 2585x1353), экспертного архива Tufts Dental Database (1615x840) и репозитория Loki_Dental (13 932 файла, 1615x840).
2.1 Изоляция валидации и регламент DENTEX
Валидационная выборка (valid) зафиксирована в объеме 144 панорамных снимков (709 объектов) из датасета DENTEX (MICCAI 2023). По регламенту DENTEX каждый снимок принадлежит отдельному пациенту (один пациент - одна ОПТГ), что исключает пересечение снимков одного человека между обучающей и проверочной выборками внутри DENTEX.
2.2 Изоляция внешних баз
Все 1 000 снимков из базы Tufts и отобранные снимки из Loki_Dental записывались только в обучающую выборку (train). В валидационный набор внешние архивы не добавлялись, чтобы проверять модель на фиксированном стандарте разметки DENTEX.
2.3 Дедупликация (dHash) и входной фильтр (OOD)
При сборке датасета каждый файл проверялся разностным перцептивным хэшем dHash (hash_size=8), что позволило удалить 33 дубликата. Для отсева цветных фотографий, узких прицельных снимков и кадров с некорректной экспозицией применялась проверка пропорций и разницы цветовых каналов (отсеяно 1 571 изображение):
def is_valid_panoramic_xray(img_bgr, max_color_saturation=12.0, max_channel_diff=6.0):
if img_bgr is None or img_bgr.size == 0:
return False, "Пустой файл"
h, w = img_bgr.shape[:2]
aspect = w / float(h)
if w < 350 or h < 256 or aspect < 1.35 or aspect > 2.80:
return False, "Неподходящие пропорции или низкое разрешение"
if len(img_bgr.shape) == 3 and img_bgr.shape[2] == 3:
b, g, r = cv2.split(img_bgr)
if max(np.mean(np.abs(r.astype(float)-g)), np.mean(np.abs(g.astype(float)-b))) > max_channel_diff:
return False, "Обнаружено цветное RGB-изображение"
hsv = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2HSV)
if float(np.mean(hsv[:, :, 1])) > max_color_saturation:
return False, "Высокая цветовая насыщенность - не рентгенограмма"
return True, "OK (Валидный снимок ОПТГ)"
2.4 Исправление разметки, нормализация контраста и балансировка
При ревизии скрипта сборки данных мы исправили две ошибки предыдущей итерации:
1. Исключение перевода кариеса по площади рамки: в базе Loki_Dental нет отдельного класса Deep Caries (весь кариес размечен классом 0). В ранней версии скрипта крупные рамки (bw * bh > 0.0035) автоматически переводились в класс Deep Caries (2 463 объекта). Поскольку рентгенологически глубокий кариес определяется близостью к пульпарной камере, а не общей площадью коронки, такое правило создавало шум в метках класса 1. В Clean_Dental_v3 для класса Deep Caries оставлены только 565 разметок из DENTEX, а все кариесы из Loki_Dental сохранены в классе 0 (3 556 объектов).
2. Двухпроходный отбор снимков из Loki_Dental: в ранней версии чтение архива Loki_Dental прерывалось после достижения общего лимита в 1 200 снимков (на 6 118-м файле из 13 932), из-за чего 56% архива не попадало в выборку. В новом сборщике первый проход проверяет все 13 932 файла разметки и отбирает все снимки с классами Periapical lesion и Cyst (2 379 кандидатов, из которых после фильтрации в выборку вошли 1 366 объектов Periapical Lesion и 3 721 объект Impacted).
Для выравнивания контраста при сохранении обучающих снимков применялся алгоритм CLAHE (clipLimit=2.0, сетка 8x8). Чтобы избежать повторного наложения CLAHE при инференсе на уже нормализованных данных и снизить влияние блочных JPEG-артефактов на сжатых изображениях из интернета (шириной менее 1300 пикселей), в модуль предобработки добавлена проверка стандартного отклонения яркости и предварительная фильтрация:
def preprocess_and_restore_xray(img_bgr, target_min_width=1600, prevent_double_clahe=True):
gray = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2GRAY) if len(img_bgr.shape) == 3 else img_bgr
h, w = gray.shape[:2]
if w < 1300:
denoised = cv2.bilateralFilter(gray, d=5, sigmaColor=18, sigmaSpace=18)
scale = target_min_width / float(w)
upscaled = cv2.resize(denoised, (int(round(w*scale)), int(round(h*scale))), interpolation=cv2.INTER_LANCZOS4)
sharpened = cv2.addWeighted(upscaled, 1.25, cv2.GaussianBlur(upscaled, (0, 0), 1.2), -0.25, 0)
if float(np.std(sharpened)) < 50.0:
sharpened = cv2.createCLAHE(clipLimit=1.4, tileGridSize=(12, 12)).apply(sharpened)
return cv2.cvtColor(sharpened, cv2.COLOR_GRAY2BGR), scale
std_val, dyn_range = float(np.std(gray)), float(np.percentile(gray, 95) - np.percentile(gray, 5))
if prevent_double_clahe and (std_val >= 48.0 or dyn_range >= 168.0):
return cv2.cvtColor(gray, cv2.COLOR_GRAY2BGR), 1.0
return cv2.cvtColor(cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8)).apply(gray), cv2.COLOR_GRAY2BGR), 1.0
Обучающий список формировался с дублированием редких классов:
1. Коэффициент 3x - для снимков DENTEX, содержащих классы Deep Caries (1) или Periapical Lesion (3);
2. Коэффициент 2x - для снимков Tufts и отобранных снимков Loki_Dental с классом Periapical Lesion (3);
3. Коэффициент 1x - для остальных снимков выборки.
3.Схема двухстадийного обучения на NVIDIA A100 80GB
Модель YOLOv8l (209 слоев, 43.6 млн параметров, 165.4 GFLOPs) обучалась в разрешении 1280x1280. Предварительные эксперименты и отладка фильтрации в Google Colab (Tesla T4) заняли около 3 часов. Финальное двухстадийное обучение на одной карте NVIDIA A100 80GB PCIe заняло 29.3 минуты (0.488 часа): 23.9 минуты на первом этапе (25 эпох до остановки по EarlyStopping, лучший результат на 10-й эпохе) и 5.4 минуты на втором этапе (12 эпох).
3.1 Параметры двухстадийного обучения YOLOv8l (1280px)
Параметр | Stage 1 (Full Backbone) | Stage 2 (Fine-Tuning) |
Стартовый чекпоинт | Предобученный yolov8l.pt | Лучший вес Stage 1 (best.pt, эпоха 10) |
Объем выборки (train / val) | 2 636 выборок (DENTEX+Tufts > 72%) / 144 | 1 726 выборок / 144 |
Входной размер (imgsz) | 1280 x 1280 | 1280 x 1280 |
Число эпох и время на A100 | 25 эпох (23.9 мин, EarlyStopping) | 12 эпох (5.4 мин, лучший вес на эпохе 2) |
Размер батча (batch) | 16 (кэширование в RAM) | 16 (кэширование в RAM) |
Заморозка слоев (freeze) | None (все слои активны) | 10 (заморожены первые 10 слоев бэкбона) |
Прогрев и шаг обучения (lr0 / lrf) | warmup=3.0, lr0=0.0006, lrf=0.01 | warmup=0.0, lr0=0.0001, lrf=0.05 |
Веса функции потерь (box / cls / dfl) | 7.5 / 1.6 / 1.5 | 7.5 / 1.8 / 1.5 |
Аугментации | degrees=6.0, scale=0.15, fliplr=0.5, erasing=0.0 | degrees=4.0, scale=0.10, fliplr=0.5, erasing=0.0 |
3.2 Проверка смешивания весов (Model Soup)
На третьем шаге мы проверили линейное усреднение весов первого и второго этапов с равными коэффициентами (theta_soup = 0.5 theta_stage1 + 0.5 theta_stage2):
import copy, torch
def create_model_soup(ckpt1_path, ckpt2_path, out_path, alpha=0.5):
state1 = torch.load(ckpt1_path, map_location="cpu", weights_only=False)
state2 = torch.load(ckpt2_path, map_location="cpu", weights_only=False)
soup_state = copy.deepcopy(state2)
m1, m2 = state1["model"].float().state_dict(), state2["model"].float().state_dict()
soup_dict = {k: (alpha m1[k] + (1.0 - alpha) m2[k] if k in m2 else m1[k]) for k in m1.keys()}
soup_state["model"].load_state_dict(soup_dict)
soup_state["model"].half()
torch.save(soup_state, out_path)
В отличие от предварительных запусков на Tesla T4 (1024px), где усреднение весов давало небольшой прирост mAP50 (с 0.599 до 0.605–0.611), на архитектуре YOLOv8l (1280px) равномерный Model Soup показал отрицательный результат относительно чистого второго этапа: общий mAP50 снизился с 0.642 до 0.634 (mAP50-95 снизился с 0.408 до 0.404), хотя средний Precision в точке максимального F1 вырос с 69.6% до 75.6% за счет сдвига оптимального порога по классу Periapical Lesion до 0.52. Поэтому в качестве основной рабочей модели выбран чистый чекпоинт второго этапа .
4 Результаты валидации и проверка TTA
Метрики рассчитаны на валидационном наборе DENTEX (144 снимка, 709 объектов) при разрешении 1280px без использования Test-Time Augmentation (augment=False):
Этап и модель (NVIDIA A100, 1280px) | mAP50 | mAP50-95 | Caries AP50 | Deep Caries AP50 | Impacted AP50 | Periapical AP50 | Precision / Recall (@MaxF1) | Время на кадр |
Stage 1: YOLOv8l-1280 Full | 0.609 | 0.379 | 0.502 | 0.509 | 0.962 | 0.461 | 68.9% / 59.4% (F1=0.628) | 5.3 мс |
Stage 2: YOLOv8l-1280 Calibrated | 0.642 | 0.408 | 0.546 | 0.546 | 0.961 | 0.516 | 69.6% / 60.7% (F1=0.640) | 5.8 мс |
Stage 3: Model Soup (50/50) | 0.634 | 0.404 | 0.542 | 0.531 | 0.962 | 0.501 | 75.6% / 59.9% (F1=0.639) | 7.3 мс |
Поклассовые показатели выбранной модели Stage 2 (best_stage2_yolov8l_1280.pt):
Класс патологии | Max F1 (@conf) | Recall (@MaxF1) | Precision (@MaxF1) | AP50 | mAP50-95 |
0: Caries (Кариес) | 0.530 (@0.23) | 55.0% (0.550) | 51.2% (0.512) | 0.546 | 0.379 |
1: Deep Caries (Глубокий кариес) | 0.562 (@0.21) | 54.0% (0.540) | 58.6% (0.586) | 0.546 | 0.334 |
2: Impacted (Ретинированный зуб) | 0.914 (@0.56) | 90.6% (0.906) | 92.3% (0.923) | 0.961 | 0.582 |
3: Periapical Lesion (Периапикальный очаг) | 0.553 (@0.26) | 43.3% (0.433) | 76.4% (0.764) | 0.516 | 0.334 |
Среднее по модели (Stage 2) | 0.640 | 60.7% (0.607) | 69.6% (0.696) | 0.642 | 0.408 |
4.1 Сравнение инференса с TTA и без TTA
При проверке модели на валидационной выборке в двух режимах (augment=False и augment=True) получены следующие результаты:
Режим инференса (на одних и тех же весах v3) | Precision (Deep Caries @0.25) | Precision (Periapical @0.18) | Deep Caries AP50 | mAP50 / mAP50-95 | Время на кадр (T4) |
Без TTA (augment=False) | 60.5% | 39.2% | 0.530 | 0.597 / 0.354 | 54.5 мс |
С мульти-скейл TTA (augment=True) | 25.9% | 20.3% | 0.485 | 0.592 / 0.344 | 128.0 мс |
1. Измеренный результат: при включении стандартного TTA в Ultralytics точность (Precision) на фиксированном пороге падает с 60.5% до 25.9% для класса Deep Caries и с 39.2% до 20.3% для класса Periapical Lesion, а время инференса возрастает более чем в два раза;
2. Интерпретация: стандартный TTA в YOLO включает прогон изображения в уменьшенном масштабе (0.83x) с последующим объединением рамок перед NMS, что увеличивает число низкопороговых предсказаний на мелких структурах и снижает избирательность. В итоговом пайплайне параметр augment зафиксирован в значении False.
4.2 Поклассовые пороги уверенности
По кривым F1-Confidence вместо единого порога conf=0.50 заданы два набора индивидуальных порогов:
1. Профиль высокой избирательности (high_precision): для чекпоинта Stage 2 - Caries: 0.23, Deep Caries: 0.21, Impacted: 0.56, Periapical Lesion: 0.26 (при работе со сжатыми снимками из интернета пороги повышаются до 0.26, 0.28, 0.50 и 0.34 соответственно); для чекпоинта Model Soup - Caries: 0.16, Deep Caries: 0.26, Impacted: 0.48, Periapical Lesion: 0.52;
2. Скрининговый профиль (screening): Caries: 0.18–0.21, Deep Caries: 0.22–0.25, Impacted: 0.38–0.42, Periapical Lesion: 0.18–0.22.
5 Разбор предсказаний модели и ошибок нумерации зубов на контрольных снимках
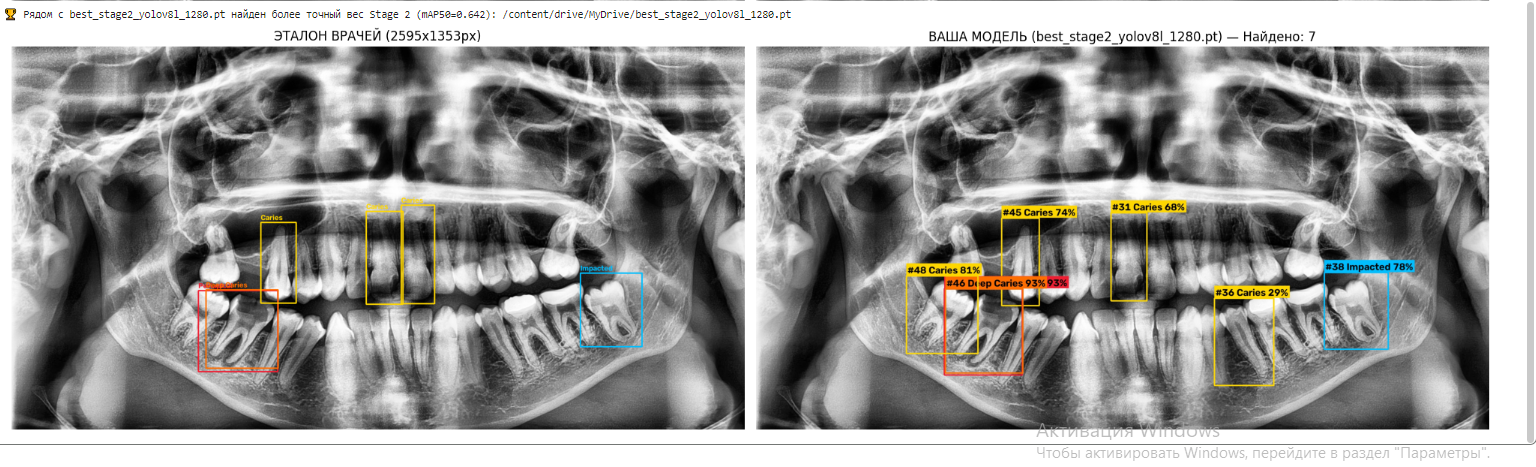
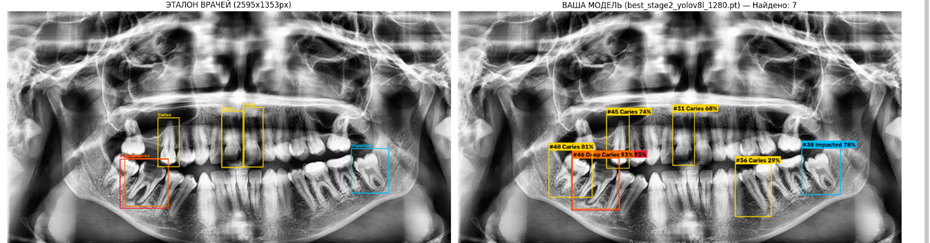
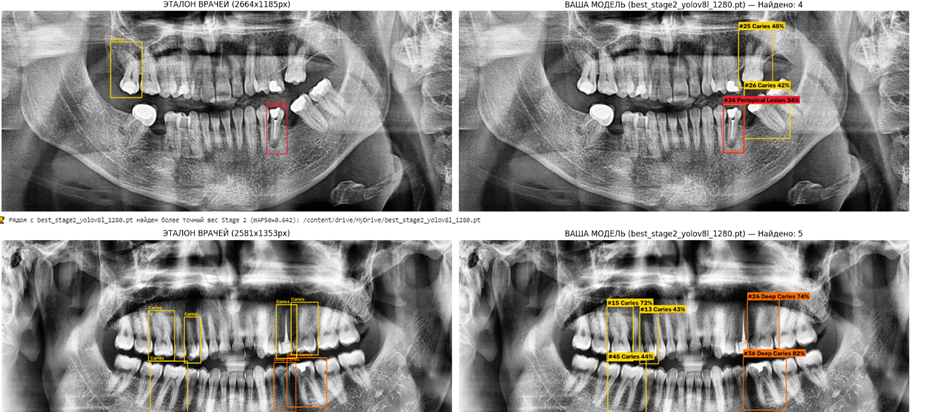
Сопоставление предсказаний модели best_stage2_yolov8l_1280.pt с разметкой из валидационного набора DENTEX на трех панорамах (2595x1353, 2664x1185 и 2581x1353, Рисунки 6 и 7) показывает как совпадения с эталоном, так и характерные ошибки:
1. Совпадения и дополнительные срабатывания на контактных поверхностях (Рисунок 6, 2595x1353px): в разметке DENTEX (слева) выделено 5 объектов (глубокий кариес нижнего правого моляра, три кариеса верхнего ряда и ретинированный нижний левый зуб мудрости). Модель (справа) выделяет эти области (#46 Deep Caries 93%, #38 Impacted 78%, верхние кариесы 74% и 68%) и дополнительно отмечает две рамки Caries на зубах #48 (81%) и #36 (29%), которые отсутствуют в разметке тестового файла;
2. Периапикальный очаг и пропуск одиночного кариеса (Рисунок 7, верхний снимок 2664x1185px): модель выделяет зону разрежения у верхушки корня левого нижнего премоляра с пломбированным каналом (#34 Periapical Lesion 34%) и отмечает два участка на верхних левых молярах (#25 Caries 48%, #26 Caries 42%), но пропускает размеченный врачами кариес на верхнем правом моляре. На нижнем снимке (2581x1353px) модель находит 5 из 6 размеченных очагов, включая два участка глубокого кариеса (#26 Deep Caries 74% и #36 Deep Caries 82%);
3. Пример ошибки геометрической нумерации зубов FDI: на Рисунке 6 рамка кариеса на верхнем правом премоляре получила номер #45 (нижний правый сектор 4) вместо #15 (верхний правый сектор 1). В текущей версии номер зуба оценивается по координатам центра рамки относительно горизонтальной линии смыкания челюстей (y = 0.52). Поскольку в разметке DENTEX бокс охватывает зуб целиком от коронки до корня, вертикальный центр крупной рамки сместился ниже границы 0.52 и попал в нижний квадрант. Чтобы устранить такие ошибки привязки, а также ошибки при смещении зубного ряда после удалений, геометрическую формулу необходимо заменить отдельной моделью сегментации 32 зубов.
5.1 Ограничения текущей проверки и дальнейшие шаги
1. Метрики mAP50 = 0.642 и mAP50-95 = 0.408 получены на валидационной выборке DENTEX (144 снимка). Для оценки переносимости на российские клиники требуется отдельная тестовая выборка с отечественных томографов и ортопантомографов;
2. Дополнительные рамки, найденные моделью на контрольных снимках сверх разметки DENTEX (участки на зубах #48 и #36 на Рисунке 6, #25 и #26 на Рисунке 7), оценивались нами только визуально по рентгенологическим признакам (близость полости к рогу пульпы, прерывистость кортикальной пластинки, просветление у апекса). Без слепой проверки независимыми стоматологами-рентгенологами нельзя утверждать, являются ли эти срабатывания пропущенными в датасете патологиями или ложноположительными ответами модели на артефакты наложения коронок;
3. На сжатых изображениях из интернета и мессенджеров (разрешением 650x340 - 900x600 пикселей) качество детекции мелкого кариеса остается ниже, чем на полноразмерных рентгенограммах (2585x1353), даже после фильтрации JPEG-блоков. В рабочем интерфейсе такие файлы должны сопровождаться предупреждением о низком разрешении исходного снимка.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.