Спекулятивный декодинг в проде: сравнение методов в ИИ-ассистенте покупателя на Wildberries
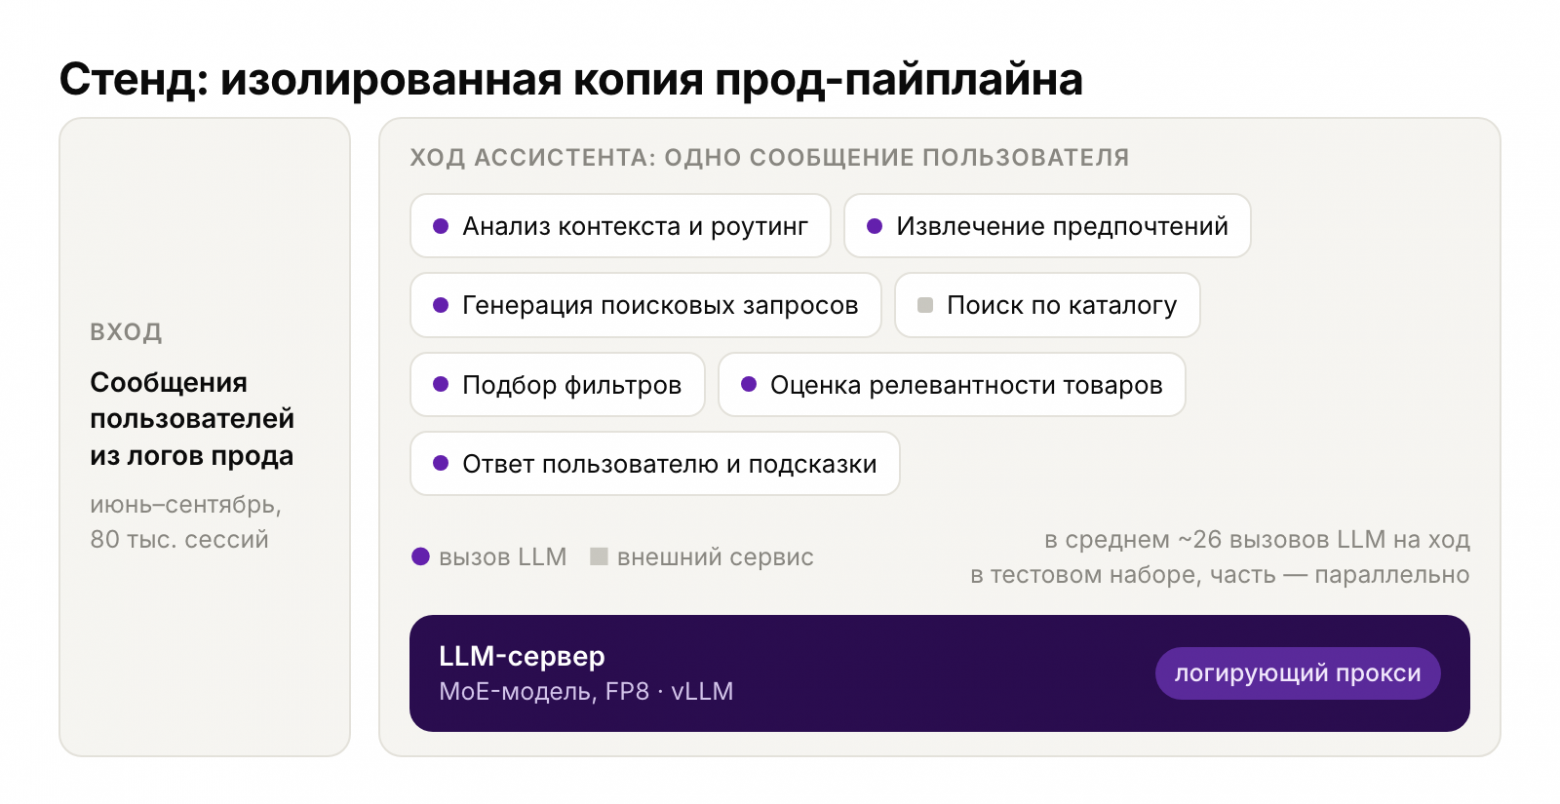
ИИ-ассистент покупателя на Wildberries работает на модели из нашего собственного семейства языковых моделей BerryLM, дообученной под сценарии ассистента. На одно сообщение пользователя он делает много вызовов LLM, в нашем тестовом наборе в среднем около 26: разбирает контекст, извлекает предпочтения, генерирует поисковые запросы, подбирает фильтры, пишет ответ. Часть вызовов идёт параллельно. А пользователь всё это время ждёт, так что от скорости генерации напрямую зависит, как быстро ответит ассистент.
Мы перевели ассистента на спекулятивный декодинг. Но сначала прогнали на одном стенде, одной нагрузке и одних данных семь методов: от n-gram без обучения до свежих DFlash 2 и DSpark. Это рассказ о том, что из этого вышло, какие грабли нашлись по дороге и почему в проде в итоге DFlash 2.
Коротко:
Лучшие — параллельные драфтеры: DFlash, DSpark и DFlash 2. При малой нагрузке ход ассистента у них в ~2 раза быстрее, при 128 одновременных пользователях — в 1,4 раза. Между собой они в пределах шума.
MTP-голова самой модели, дообученная под наш домен, даёт ×1,7–1,8 при малой нагрузке — против ×2 у лидеров.
EAGLE-3 принимает почти столько же токенов за шаг, сколько DFlash, но медленнее на 11–23%: черновик строится последовательно.
Готовые драфтеры работают и без обучения: на открытой модели её MTP-голова и публичный DFlash-драфтер ускоряют ход в 1,6–2 раза при малой нагрузке и в 1,2–1,3 раза при 128 пользователях.
n-gram и suffix decoding в vLLM 0.30 на гибридной модели с линейным вниманием ломают ответы. Мы нашли закономерность и контрольный эксперимент.
В проде после перехода медиана времени обработки сообщения упала с 10,9 до 3,6 с. Однако это не чистая абляция, подробности в конце.
Откуда взялся спекулятивный декодинг
Генерация текста большой моделью упирается не в вычисления, а в память. Чтобы выдать один токен, GPU читает из памяти все веса, которые участвуют в проходе, а считает при этом совсем немного. Если подать на вход не один токен, а восемь, проход стоит почти столько же: веса читаются один раз.
Отсюда идея: без больших затрат угадать продолжение на несколько токенов вперёд и проверить догадку одним проходом большой модели. Как и при обучении, за один проход модель выдаёт распределение следующего токена для каждой позиции входа, поэтому все угаданные токены проверяются разом. Модель принимает самый длинный правильный префикс черновика, а на первой ошибке ставит свой токен.
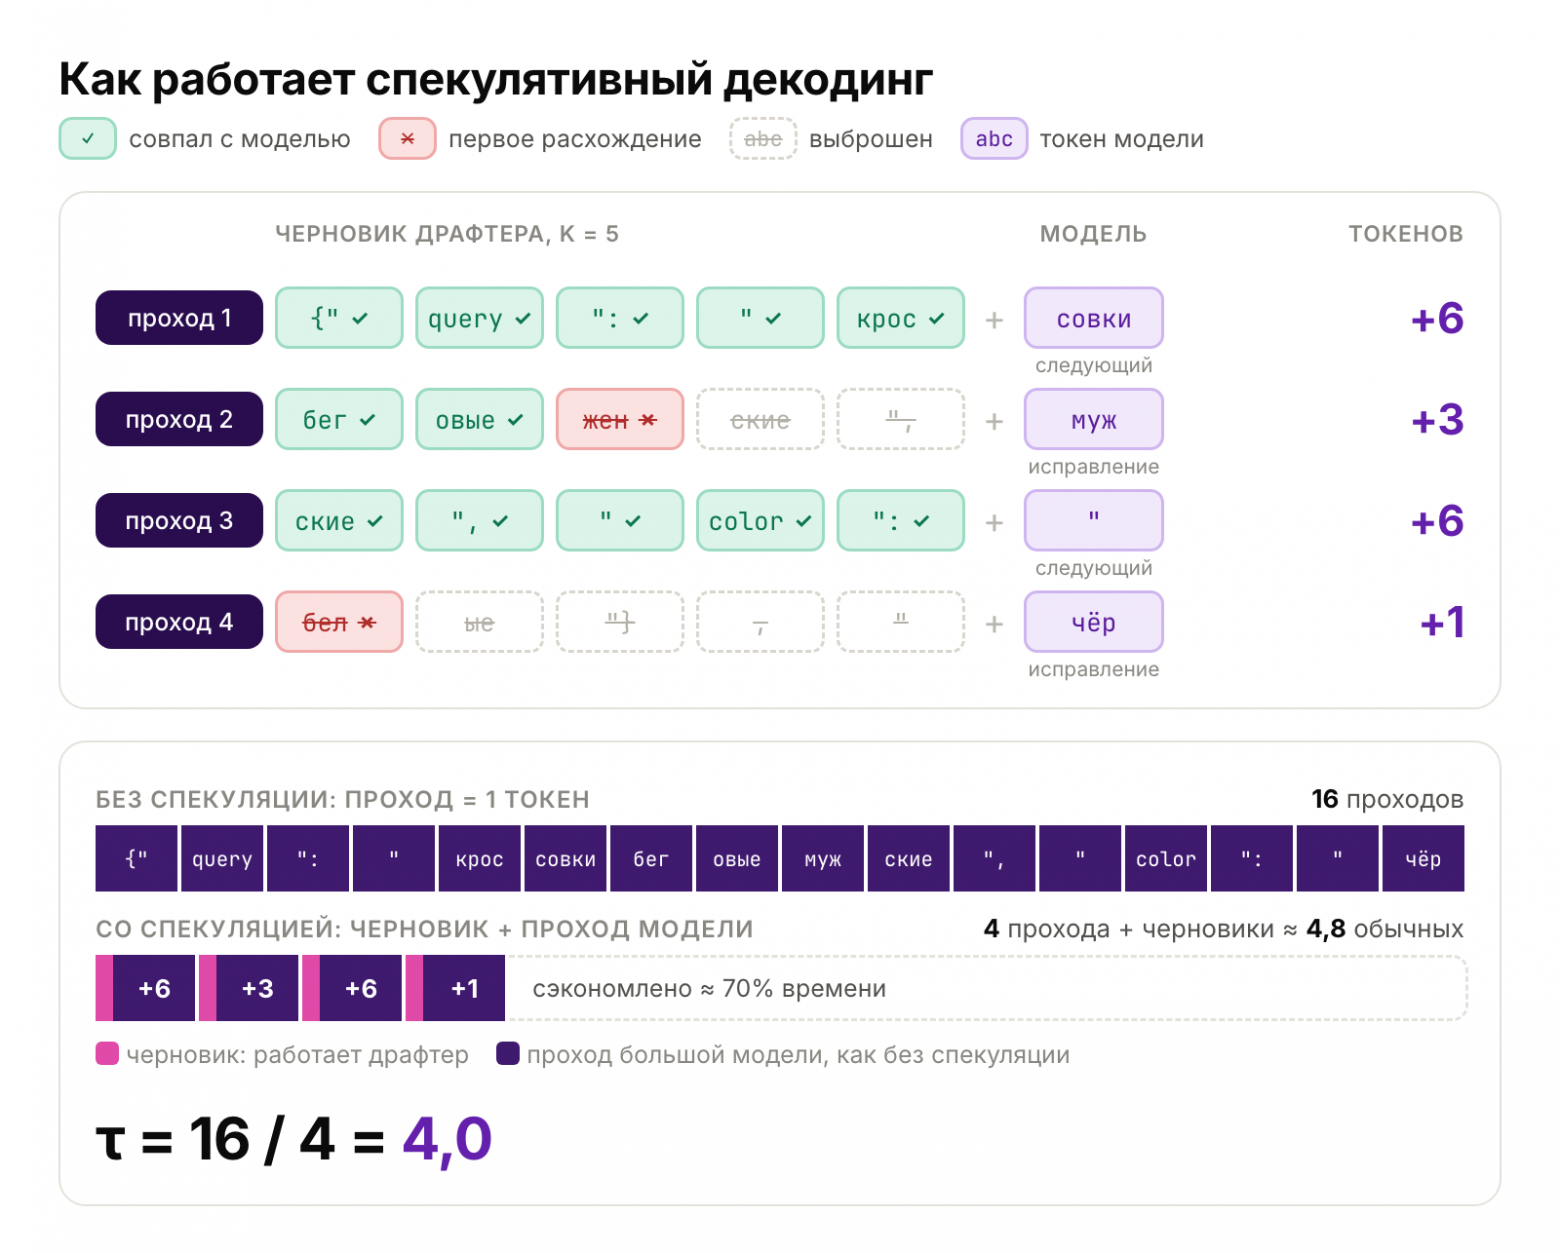
Главное свойство: при корректной проверке сохраняется распределение ответов целевой модели. При вероятностной генерации отдельные строки не обязаны совпадать. Ускорение при этом не гарантировано: оно зависит от стоимости черновика, проверки и доли принятых токенов. Основная характеристика драфтера —  , среднее число токенов, которое даёт один проход большой модели вместе с драфтером: принятые токены черновика плюс один токен самой модели.
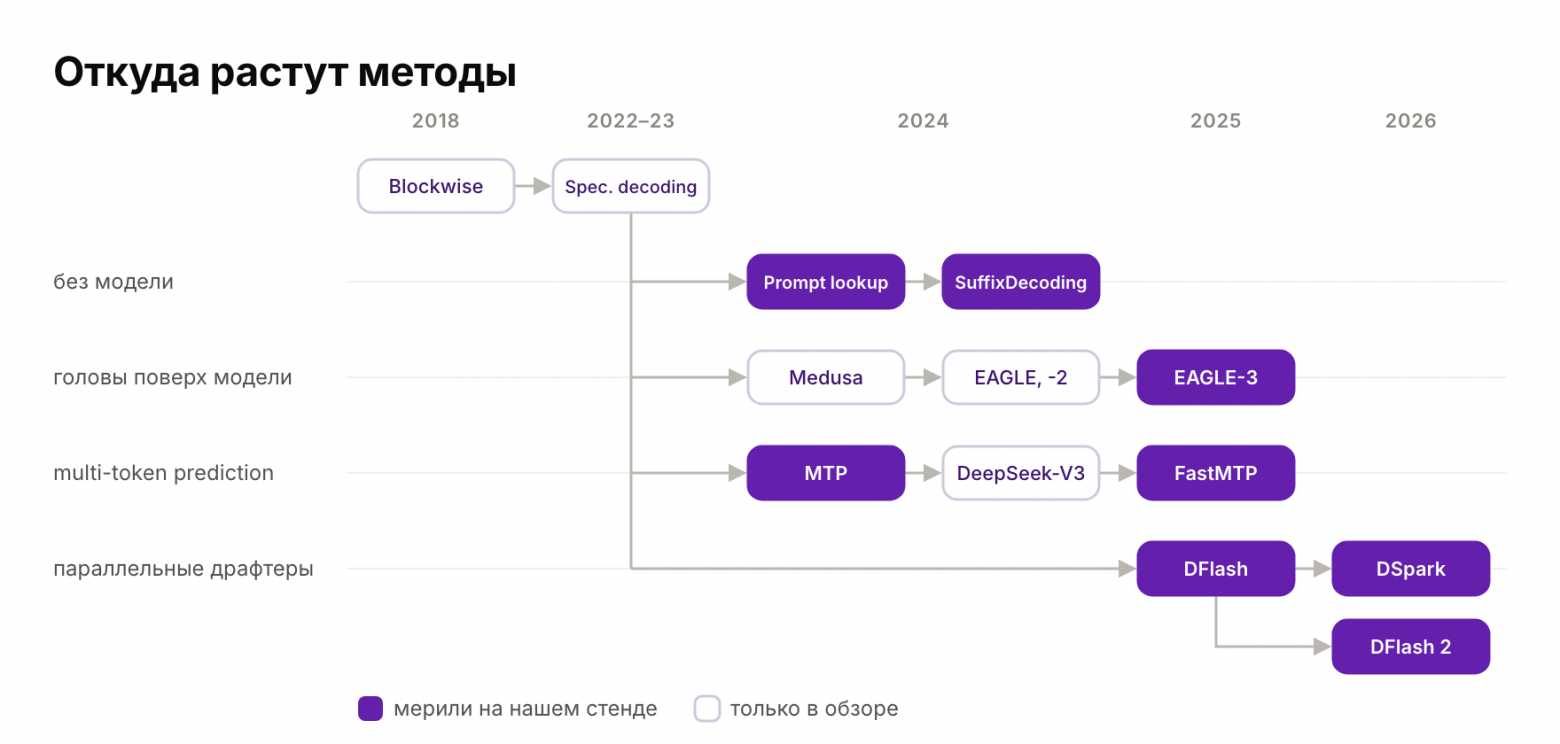
Идея проверять несколько угаданных токенов за проход появилась в Blockwise Parallel Decoding (2018). В современном виде, с отдельной маленькой моделью-черновиком и проверкой без потери качества, её сформулировали почти одновременно две группы: Leviathan et al. из Google и Chen et al. из DeepMind.
Дальше направление разошлось на несколько веток:
Черновик без модели. Prompt Lookup Decoding ищет продолжение в самом промпте, SuffixDecoding — в дереве прошлых ответов.
Лёгкие головы поверх самой модели. Medusa, EAGLE, EAGLE-2 и EAGLE-3.
Multi-token prediction. Модель с самого начала учат предсказывать несколько токенов вперёд (Gloeckle et al.). В DeepSeek-V3 MTP-модуль стал готовым драфтером, а FastMTP дообучает его специально под спекуляцию.
Параллельные драфтеры. DFlash строит весь черновик за один проход с помощью блочной диффузии, но позиции блока при этом предсказываются независимо друг от друга. DSpark и DFlash 2 лечат это слабое место, каждый по-своему.
Немного теории: почему спекуляция не меняет распределение ответов и сколько она даёт
Чтобы было понятнее, что происходит в замерах дальше, нам пригодились три факта: почему спекуляция не меняет распределение ответов, сколько токенов в среднем даёт один проход модели и как это превращается в ускорение.
Обозначения. На очередной позиции  — распределение большой модели после температуры,
 — распределение драфтера. Драфтер предложил токен
 .
Правило проверки. Токен принимается с вероятностью 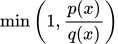 . Если его отвергли, новый токен сэмплируется из остатка
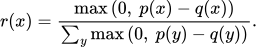
Утверждение 1. Итоговый токен распределён ровно по  , какой бы ни была
 .
Доказательство. Вероятность принять предложенный токен
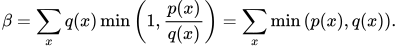
Знаменатель  равен
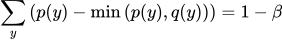 . Выход равен
 , если предложили и приняли или если предложенный токен отвергли и из остатка выпал :
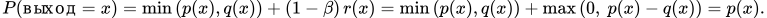
Что и требовалось. Плохой драфтер не портит ответы, он только реже угадывает.
Два следствия:
Утверждение 2 (сколько токенов даёт проход). Пусть 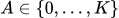 — число принятых токенов черновика длины
 . Проход даёт
 токен: принятые плюс токен самой модели. Для неотрицательной целочисленной величины
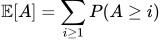 , поэтому
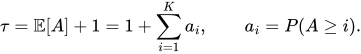
Здесь  — доля черновиков, у которых приняты первые
 токенов. Её и показывают графики принятия по позициям ниже.
Если считать, что каждый токен принимается независимо с одной вероятностью  , то
 и
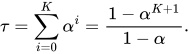
При  и
 это
 токена, а потолок —
 .
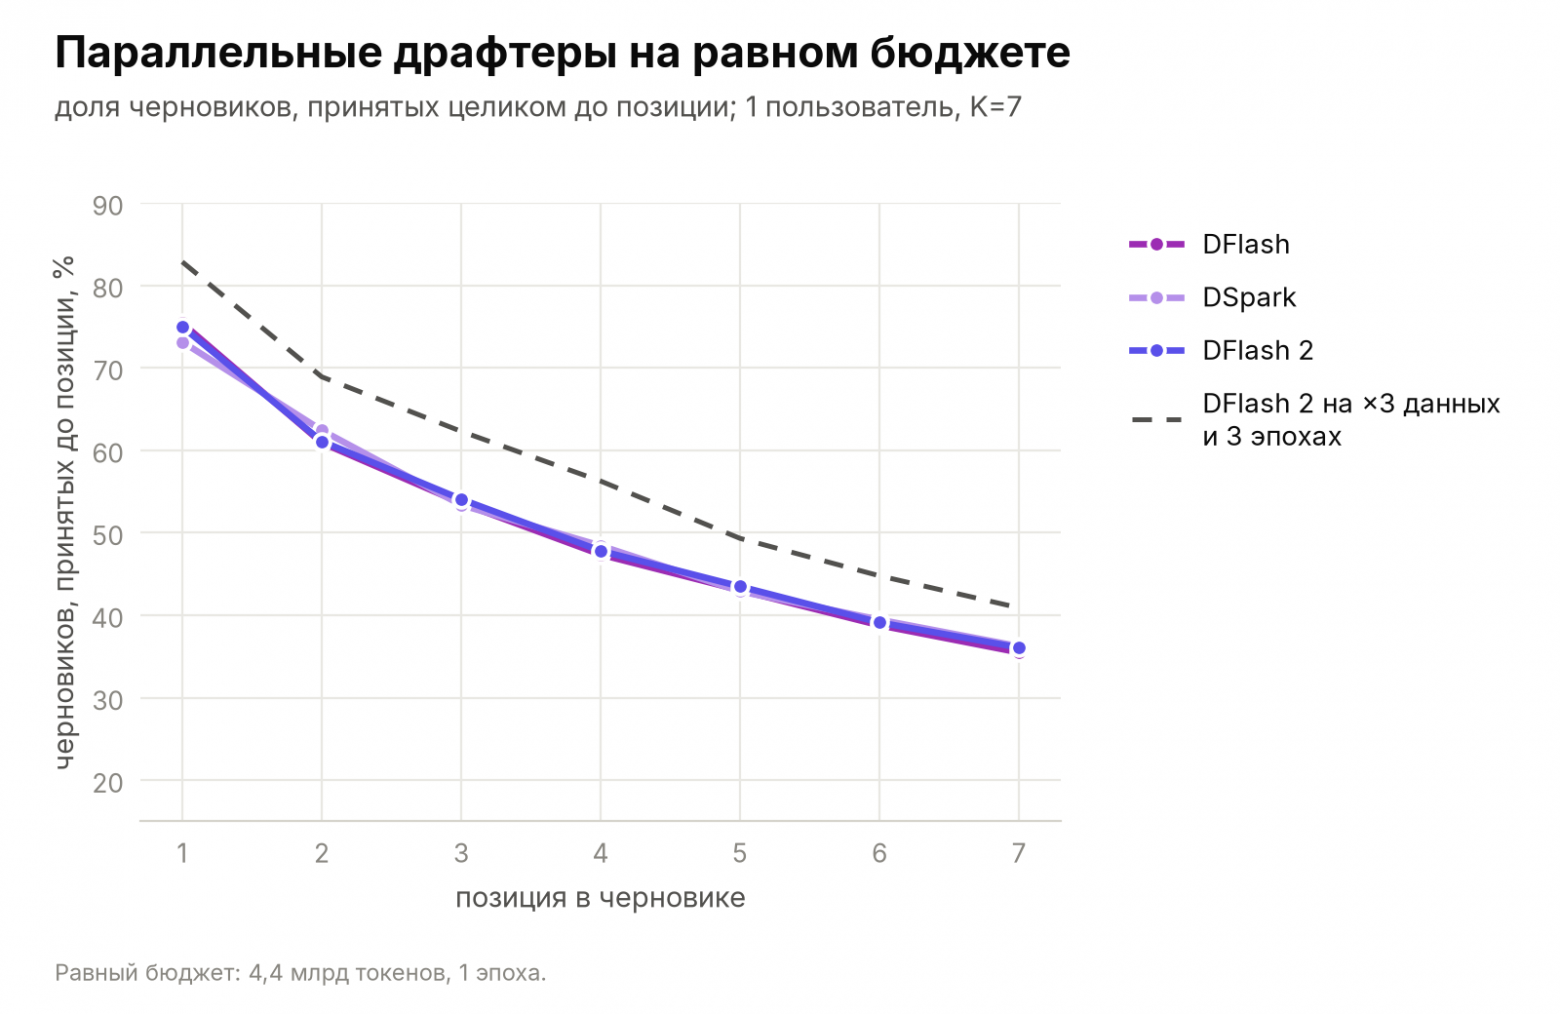
В реальности принятие не независимое. У пилотного DFlash 2 при одном пользователе  = 0,75; 0,61; 0,54; 0,48; 0,43; 0,39; 0,36, и
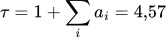 . Модель с
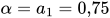 дала бы только
 . Условная вероятность принять следующий токен
 растёт с глубиной, от 0,81 до 0,92. Черновик, который пережил первые позиции, обычно попал в предсказуемый кусок ответа, например в разметку JSON.
Утверждение 3 (от к ускорению). Пусть  — время обычного шага модели,
 — время прохода, который проверяет
 токенов,
 — время построения черновика. Тогда ускорение генерации
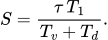
При малой нагрузке шаг упирается в чтение весов, и  . Если один проход драфтера стоит
 , то последовательному драфтеру нужно проходов, а параллельному — один:
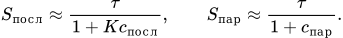
Проход параллельного драфтера тяжелее: у DFlash 5 слоёв против одного у EAGLE-3. Но при семь последовательных проходов с их запусками ядер и синхронизациями стоят дороже одного. Поэтому при равном последовательный драфтер медленнее, и ниже это хорошо видно на EAGLE-3.
Под нагрузкой перестаёт выполняться. В батче много запросов, каждый приносит на проверку токенов, шаг упирается уже в вычисления, и растёт с . Поэтому при 128 пользователях ускорение у всех методов меньше, чем при одном.
Задача и стенд
Модель и нагрузка
В проде ассистента работает MoE-модель, обученная под наши сценарии и квантованная в FP8. На каждый токен у неё активны несколько миллиардов параметров.
Архитектура гибридная: часть слоёв — линейное внимание, остальные — обычное полное. Для спекулятивного декодинга эта деталь оказалась важной.
Почему гибридное внимание важно для спекуляции
Профиль нагрузки необычный. В среднем вызов — это промпт на ~5 тыс. токенов и ответ на ~45 токенов, чаще всего JSON по схеме. Генерация короткая, но её много, и она стоит на критическом пути ответа пользователю. Драфтеру нужно хорошо угадывать структурированные ответы именно этой модели.
Стенд
Мерить на проде нельзя. Ассистент обращается к смежным системам со строгими лимитами по RPS, и лишняя нагрузка от замеров может сказаться на работе прода. Синтетические бенчмарки тоже не подходят: они не похожи на наш трафик. Поэтому мы собрали изолированный стенд: тот же код ассистента, та же модель, тот же vLLM с флагами прода. Отличия — нет персонализации и нет сценариев, которые ходят в системы с жёсткими лимитами по RPS.
Чтобы проверить, насколько стенд похож на прод, мы прогнали на нём реальные сессии и сравнили финальные ответы с продовыми. Они близки, но различия сохраняются: классификатор «стенд или прод» даёт AUC 0,62–0,69 (0,5 — неотличимы). Главное отличие — ответы стенда чуть короче. Это проверка сходства, а не доказательство эквивалентности, но сравнению методов различия не мешают: все методы идут на одном стенде против одной базы.
Данные
Через стенд мы прогнали реальные сессии за июнь–сентябрь с упором на сентябрь. Ход — это одно сообщение пользователя и вся работа ассистента над ним.
Логирующий прокси записал каждый вызов LLM, промпт и ответ, а дубликаты мы убрали. Что получилось — на картинке ниже.
Важная деталь: ответы в датасете сгенерировала та же модель, что работает в проде. Драфтер учится угадывать не «правильный текст», а продолжение именно нашей модели. В этом суть спекуляции.
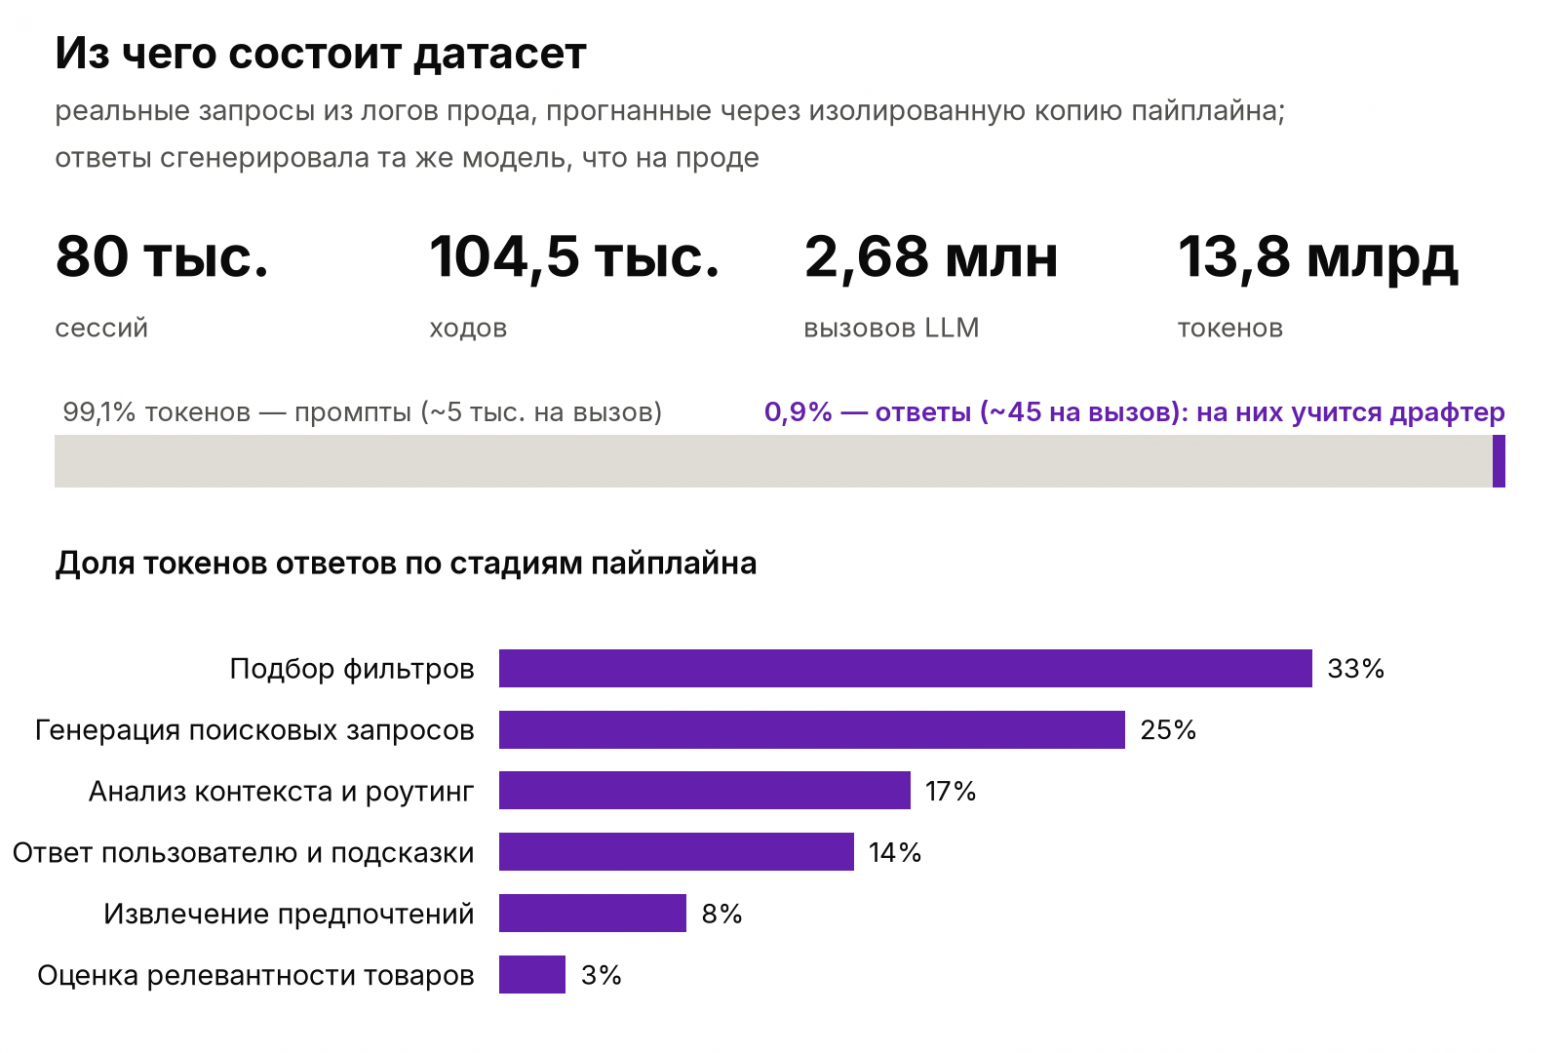
Драфтер угадывает только то, что пишет модель, поэтому учится он только на токенах ответов, а промпт видит как контекст. Почти 60% токенов ответов дают две стадии, подбор фильтров и генерация поисковых запросов. Их драфтеру важнее всего угадывать.
Для бенчмарка мы сделали отдельный прогон: 449 ходов из 300 сессий, которых нет в обучении. На ход в нём приходится в среднем 26 вызовов LLM, часть из них параллельно.
Как обучали драфтеры: общая схема
Все обучаемые драфтеры учили в одном фреймворке, speculators от команды vLLM, онлайн-дистилляцией и на одном бюджете. Чем они отличаются — признаками, лоссом и весами позиций черновика, — расписано в разделе каждого метода.
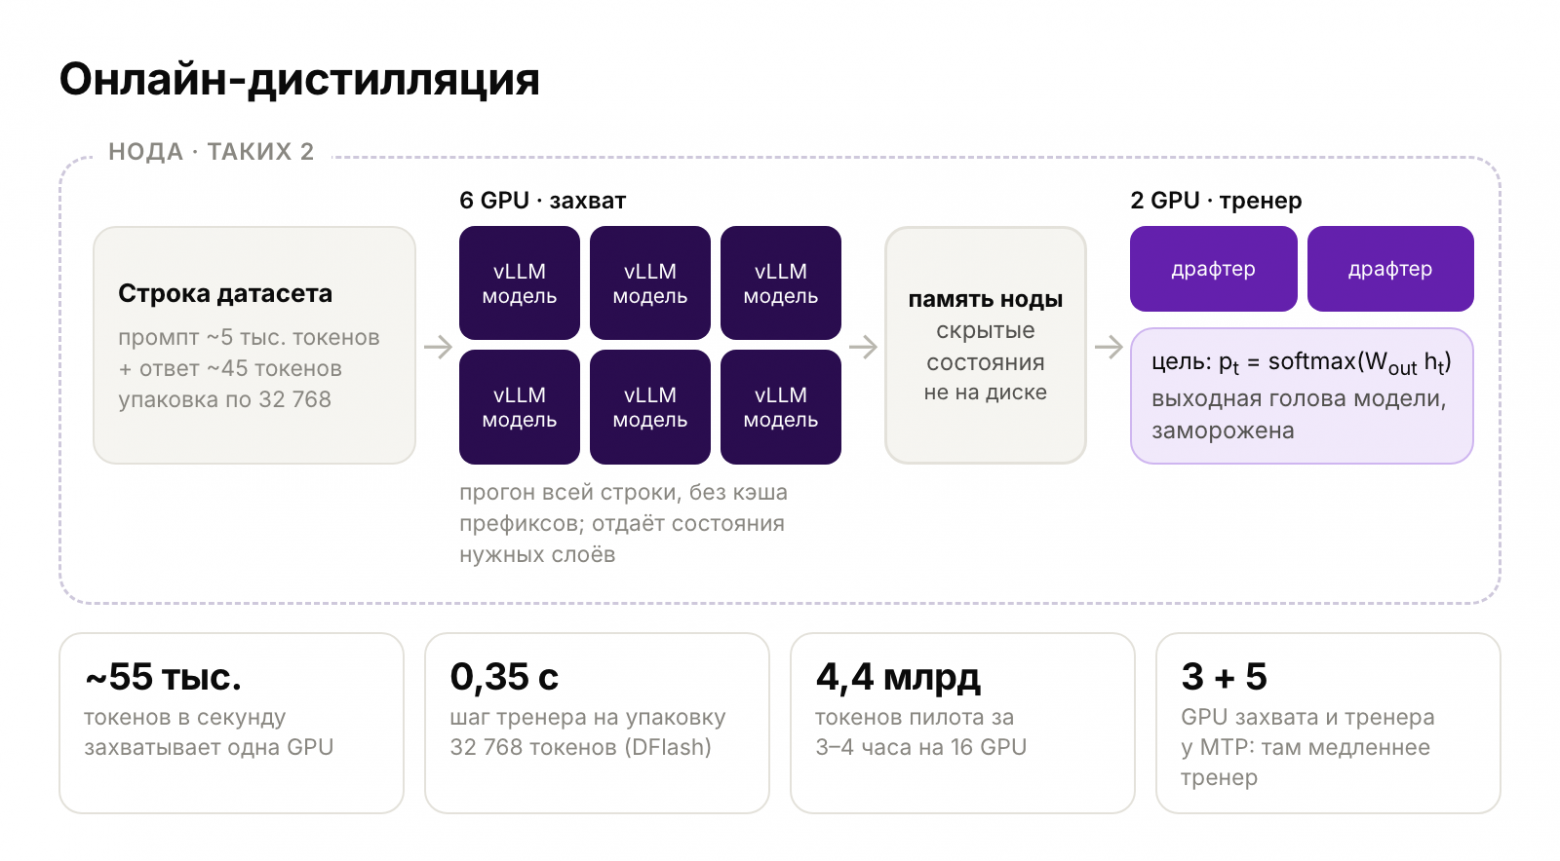
Общая схема. На каждой ноде 6 GPU держат по серверу vLLM с большой моделью. Сервер прогоняет строку датасета, промпт вместе с ответом, одним проходом и отдаёт скрытые состояния нужных слоёв. Ещё 2 GPU учат драфтер. Скрытые состояния не пишутся на диск: сервер кладёт их в разделяемую память ноды, и они лежат там, только пока их не заберёт тренер. Целевое распределение на позиции  тренер считает сам, выходной головой большой модели из её последнего скрытого состояния:
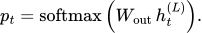
Лосс считается только на токенах ответов, промпт служит контекстом.
Бюджет для честного сравнения. Пилотный срез: 847 тыс. строк, 4,4 млрд токенов, из них 39 млн — токены ответов. Одна эпоха, упаковка по 32 768 токенов на GPU тренера. Оптимизатор Muon для матриц и AdamW для остальных весов, линейное расписание LR, мастер-веса в fp32, вычисления в bf16.
Как мерили
Мы мерили не токены в секунду на одном запросе, а время целого хода под нагрузкой: это то, что видит пользователь.
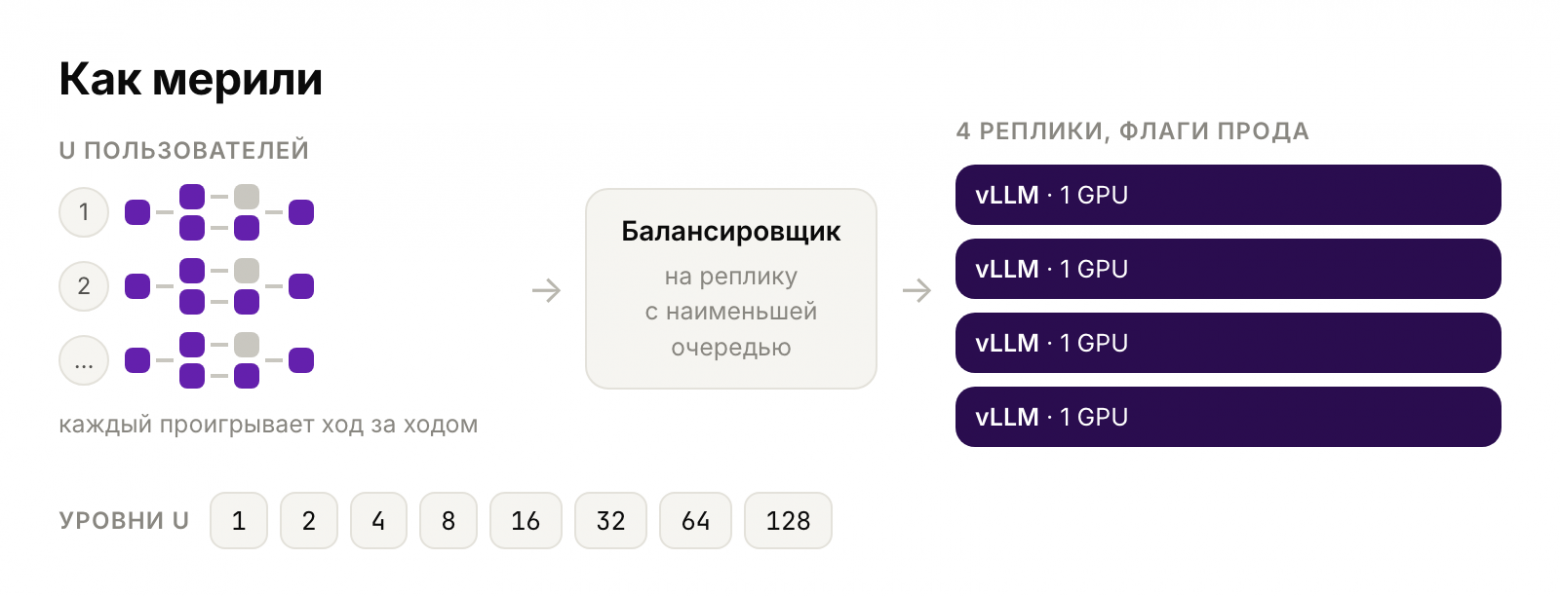
Нагрузка. Генератор проигрывает записанные ходы: внутри хода вызов стартует, когда готовы все вызовы, от которых он зависел в исходном прогоне, плюс записанная пауза. Каждый из U пользователей проигрывает ходы один за другим.
Сервинг. Реплики — vLLM 0.30 с флагами прода: FP8 KV-кэш, кэш префиксов, CUDA graphs.
Метрики. Время хода p50 и p90, ходов в секунду, и битый JSON — доля вызовов, где ждали JSON по схеме, а ответ не парсится. Правильная спекуляция не меняет распределение ответов, поэтому у любого метода эта доля должна остаться как у базы.
Шум. Один и тот же метод от прогона к прогону даёт разное время: у восьми повторов одного метода разброс доходит до 9% при малой нагрузке и до 4,5% при 128 пользователях. Поэтому каждый метод мы запускали по нескольку раз, а методы, которые отличаются меньше чем на этот разброс, считаем равными.
Начнём с базы — генерации без спекуляции. Дальше каждый раздел добавляет в таблицу по столбцу.
База | |
|---|---|
K | — |
Ход p50, 1 польз., с | 6,4 |
Ход p50, 4 польз., с | 6,7 |
Ход p50, 16 польз., с | 13,3 |
Ход p50, 128 польз., с | 46,9 |
Ускорение, 4 польз. | ×1,00 |
Ходов/с, 128 польз. | 2,35 |
τ, 1 польз. | — |
Битый JSON | 0,13% |
Обучение, GPU·ч | — |
1. n-gram: черновик из промпта
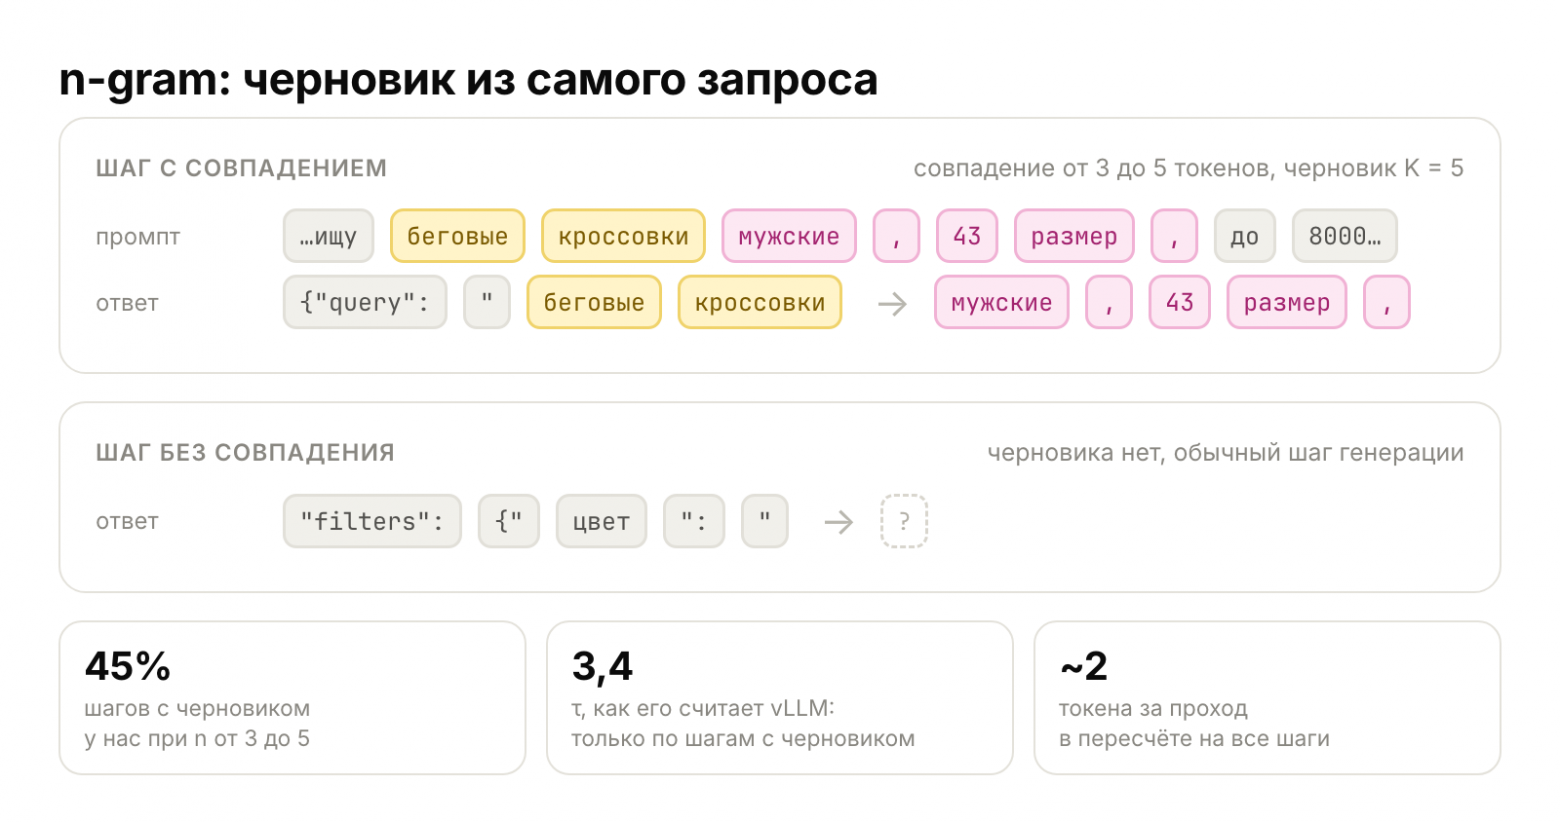
Что делает. Драфтера здесь нет. На каждом шаге vLLM берёт хвост уже сгенерированного текста и ищет его в токенах запроса: в промпте и в уже написанной части ответа. Ищется самое длинное совпадение длиной от  до
 токенов, у нас от 3 до 5. Если совпадение нашлось, черновиком становятся токенов, которые шли в тексте сразу за ним. Мы перебрали = 3, 5 и 7, лучшим оказалось
 .
Если хвост нигде не встречается, на этом шаге черновика нет, и модель делает обычный шаг на один токен. Такие шаги vLLM не учитывает в : он делит принятые токены на число черновиков, а не на число шагов. Пусть  — доля шагов с черновиком, а
 — то, что показывает vLLM. Тогда в среднем на шаг приходится
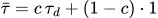
токенов. При малом это заметно меньше .
Зачем нам. Ответы ассистента часто копируют куски промпта: названия товаров, значения фильтров, формулировки пользователя. Метод без обучения, который может на этом выиграть, проверить стоило.
База | n-gram² | |
|---|---|---|
K | — | 5 |
Ход p50, 1 польз., с | 6,4 | 9,3 |
Ход p50, 4 польз., с | 6,7 | 11,5 |
Ход p50, 16 польз., с | 13,3 | 31,1 |
Ход p50, 128 польз., с | 46,9 | 62,2 |
Ускорение, 4 польз. | ×1,00 | ×0,59 |
Ходов/с, 128 польз. | 2,35 | 1,49 |
τ, 1 польз. | — | 3,4¹ |
Битый JSON | 0,13% | 72% |
Обучение, GPU·ч | — | — |
¹ У n-gram vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram работает только на старом раннере vLLM: новый его не поддерживает.
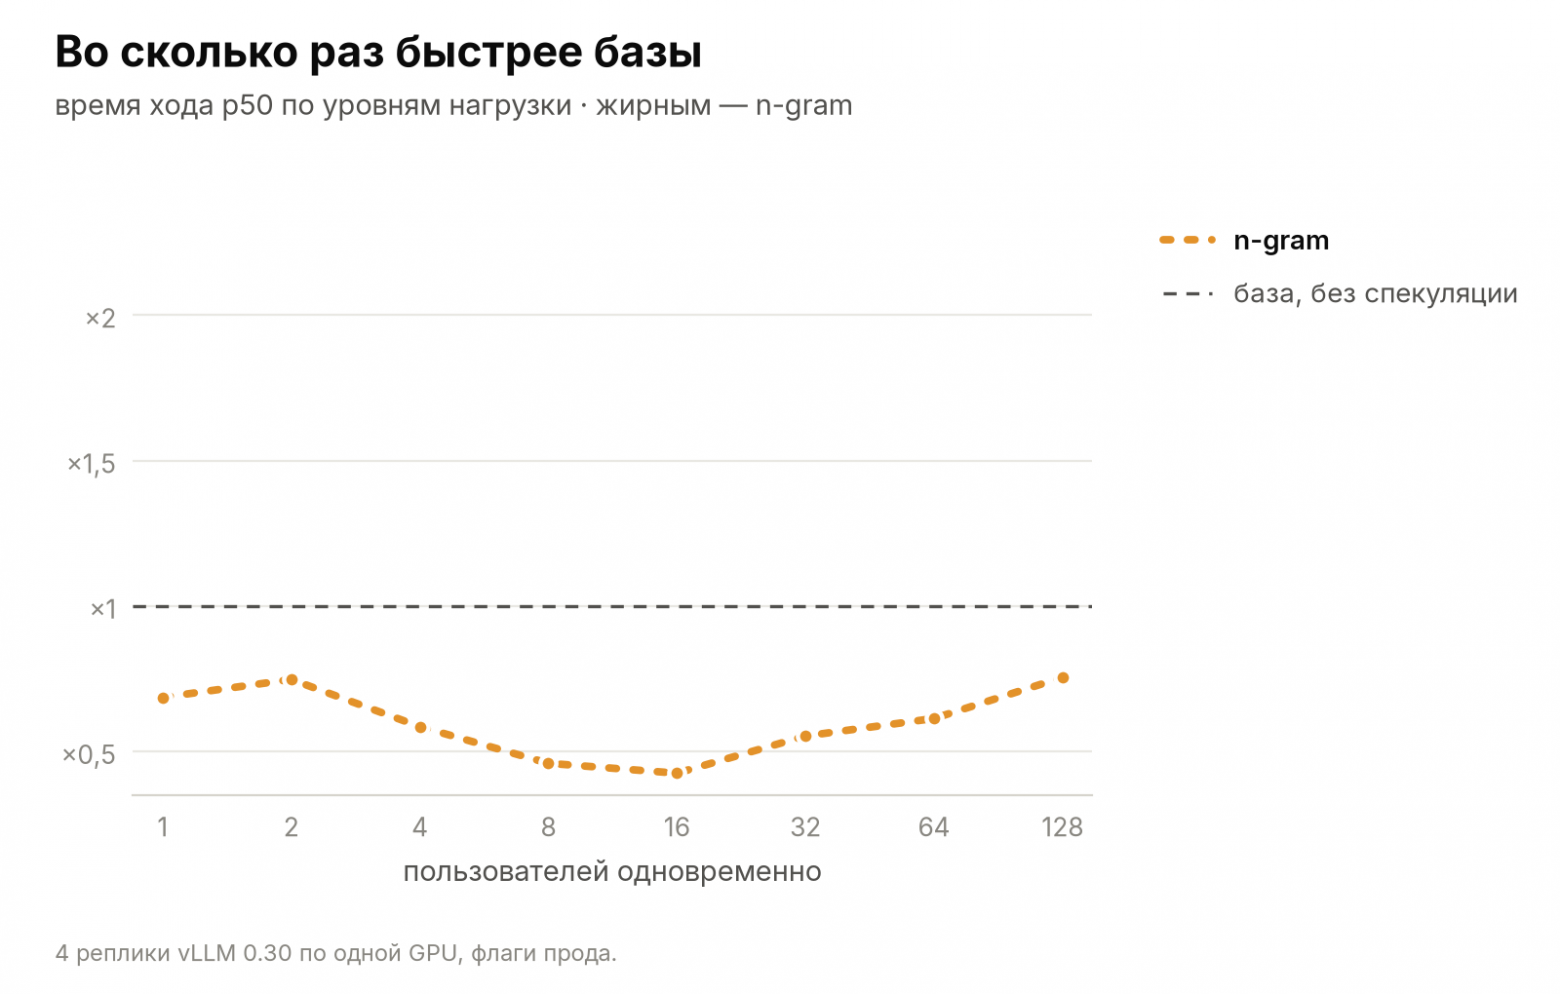
Получилось хуже базы: ход в 1,3–2,3 раза медленнее, а 72% JSON-ответов не парсятся.
Грабли.
В vLLM 0.30 n-gram и suffix есть только в старом раннере. Новый раннер, на котором работают остальные методы, их не поддерживает. Асинхронное планирование для n-gram и suffix отключается. Поэтому эталоном для этих двух методов была база на старом раннере. Скорость у неё такая же, как на новом.
n-gram портит ответы. Правильная спекуляция не меняет распределение ответов модели: плохой черновик просто чаще отвергается. Значит, битого JSON должно быть столько же, сколько у базы, — 0,13%. У n-gram его 72%. Ответы портятся изнутри: посреди строки появляются управляющие символы, пропадают запятые и кавычки, а генерация при этом заканчивается штатно, по стоп-токену. Раз ответ изменился, ошибка не в драфтере, а в движке. Мы последовательно исключили очевидные причины:
CUDA graphs: с
--enforce-eagerто же самое;кэш префиксов: без него то же самое;
грамматика: guided-декодинг в этих запросах не включён, как и в проде;
сэмплирование: при
 поломка воспроизводится.
Решающим оказался контрольный эксперимент. Мы взяли открытую MoE-модель без линейного внимания и запустили тот же n-gram. Там 317 из 320 ответов при совпали с базой. А на нашей гибридной модели — 42.
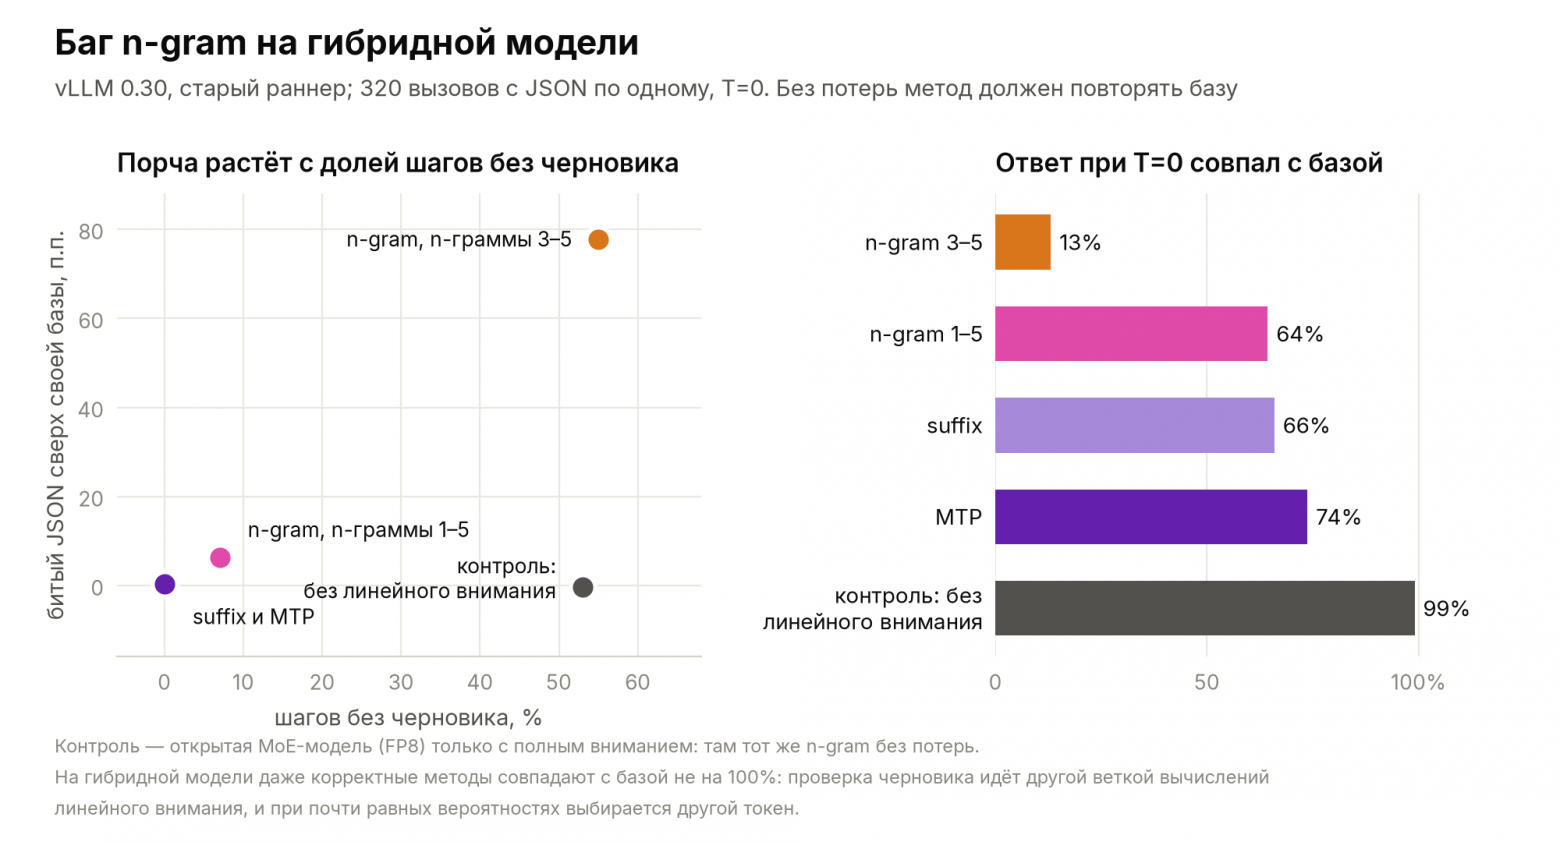
Порча растёт с долей шагов, на которых n-gram не нашёл черновика. С n-граммами от 3 токенов черновика нет на 55% шагов, и битых ответов 78%. Если разрешить совпадения от 1 токена, черновик появляется почти на каждом шаге, и битых ответов становится 7%. У suffix черновик есть почти всегда, на 92–100% шагов, у MTP — всегда, и порчи гораздо меньше.
Наша гипотеза: старый раннер неправильно ведёт состояние линейного внимания, когда шаги с черновиком чередуются с шагами без него. Похожего issue в vLLM мы не нашли.
обманывает. vLLM считает только по шагам, где черновик был. У n-gram получается
 , но черновик есть лишь на 45% шагов, и по формуле выше в пересчёте на все шаги выходит
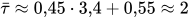 токена за проход.
2. Suffix decoding: черновик из прошлых ответов
Что делает. Метод из SuffixDecoding держит два дерева суффиксов. Первое строится по промпту текущего запроса. Второе общее, по последним 10 тыс. ответов сервера: каждый завершённый ответ добавляется в него, самые старые вытесняются. В каждом узле дерева хранится, сколько раз встречалось продолжение.
На каждом шаге хвост текущего ответа ищется в деревьях. От найденного узла черновик растёт по самому частому продолжению, а вероятность пути оценивается как произведение частот на рёбрах:
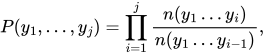
где  — сколько раз в дереве встречался этот префикс продолжения. Рост останавливается, когда вероятность пути падает ниже 0,1, когда черновик догоняет по длине совпавший хвост или когда кончается лимит . Хвосты пробуются разной длины, и выигрывает черновик с наибольшей суммой вероятностей по позициям. Глубина дерева — 24 токена на хвост и черновик вместе. Все параметры, кроме , — умолчания vLLM. мы перебрали из 8, 16 и 32.
Поэтому длина черновика меняется от шага к шагу. На шаблонных кусках JSON он длинный, на содержательных — короткий или пустой.
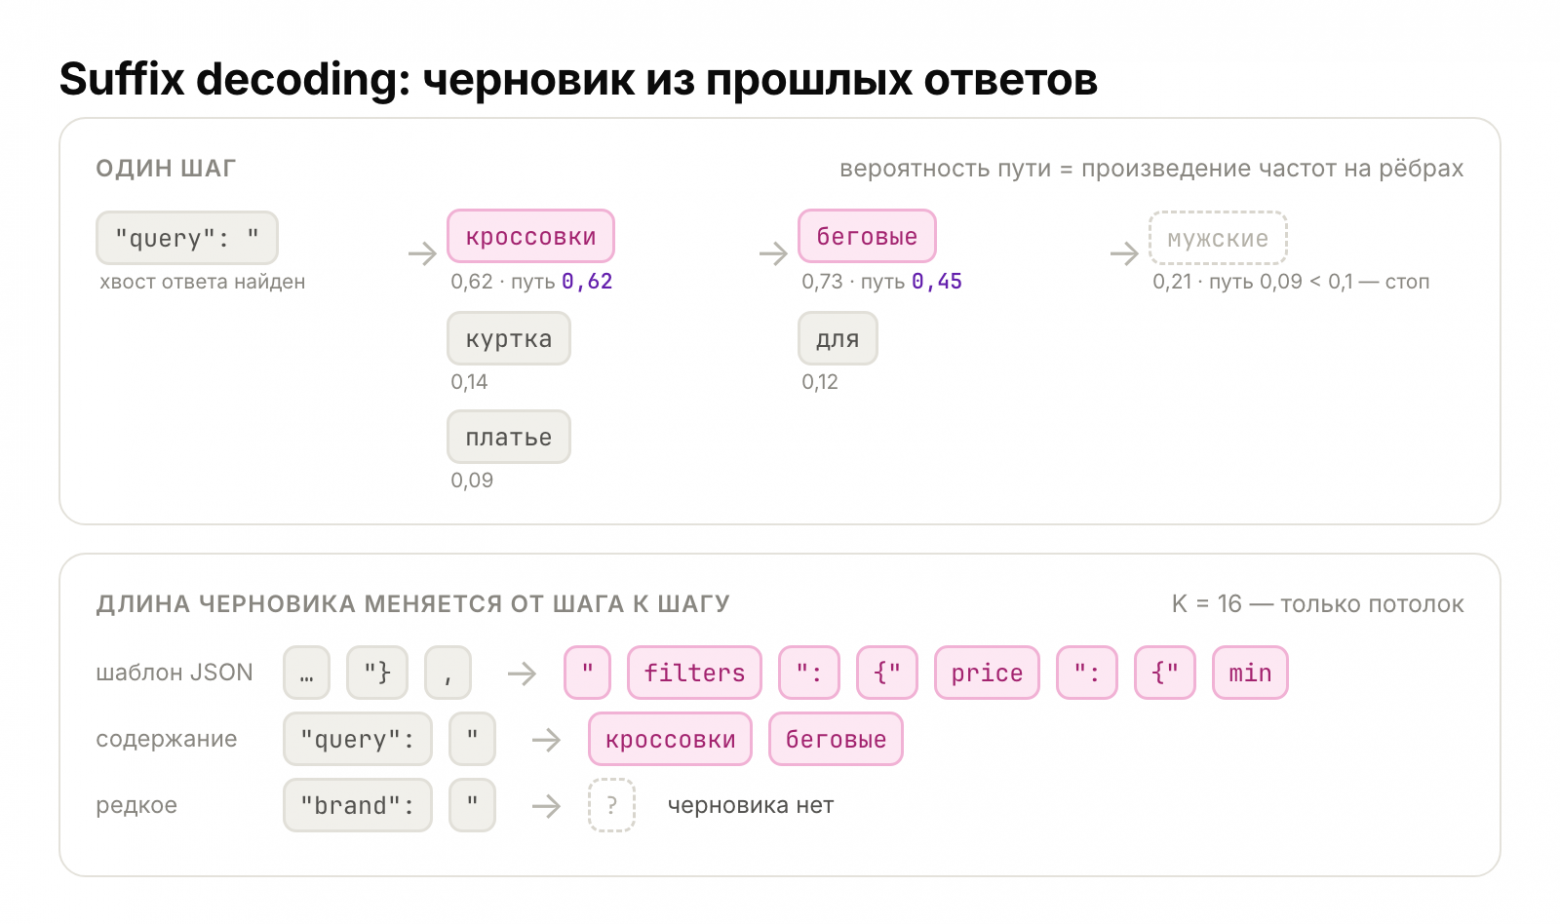
Зачем нам. Пайплайн агентный: одни и те же стадии раз за разом выдают JSON одной и той же структуры. Разметка, имена полей и частые значения фильтров повторяются из ответа в ответ, и общее дерево быстро их запоминает. Ровно на такую нагрузку метод и рассчитан: его авторы показывали выигрыш как раз на агентных задачах.
База | n-gram² | suffix² | |
|---|---|---|---|
K | — | 5 | 16 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ |
Битый JSON | 0,13% | 72% | 1,1% |
Обучение, GPU·ч | — | — | — |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
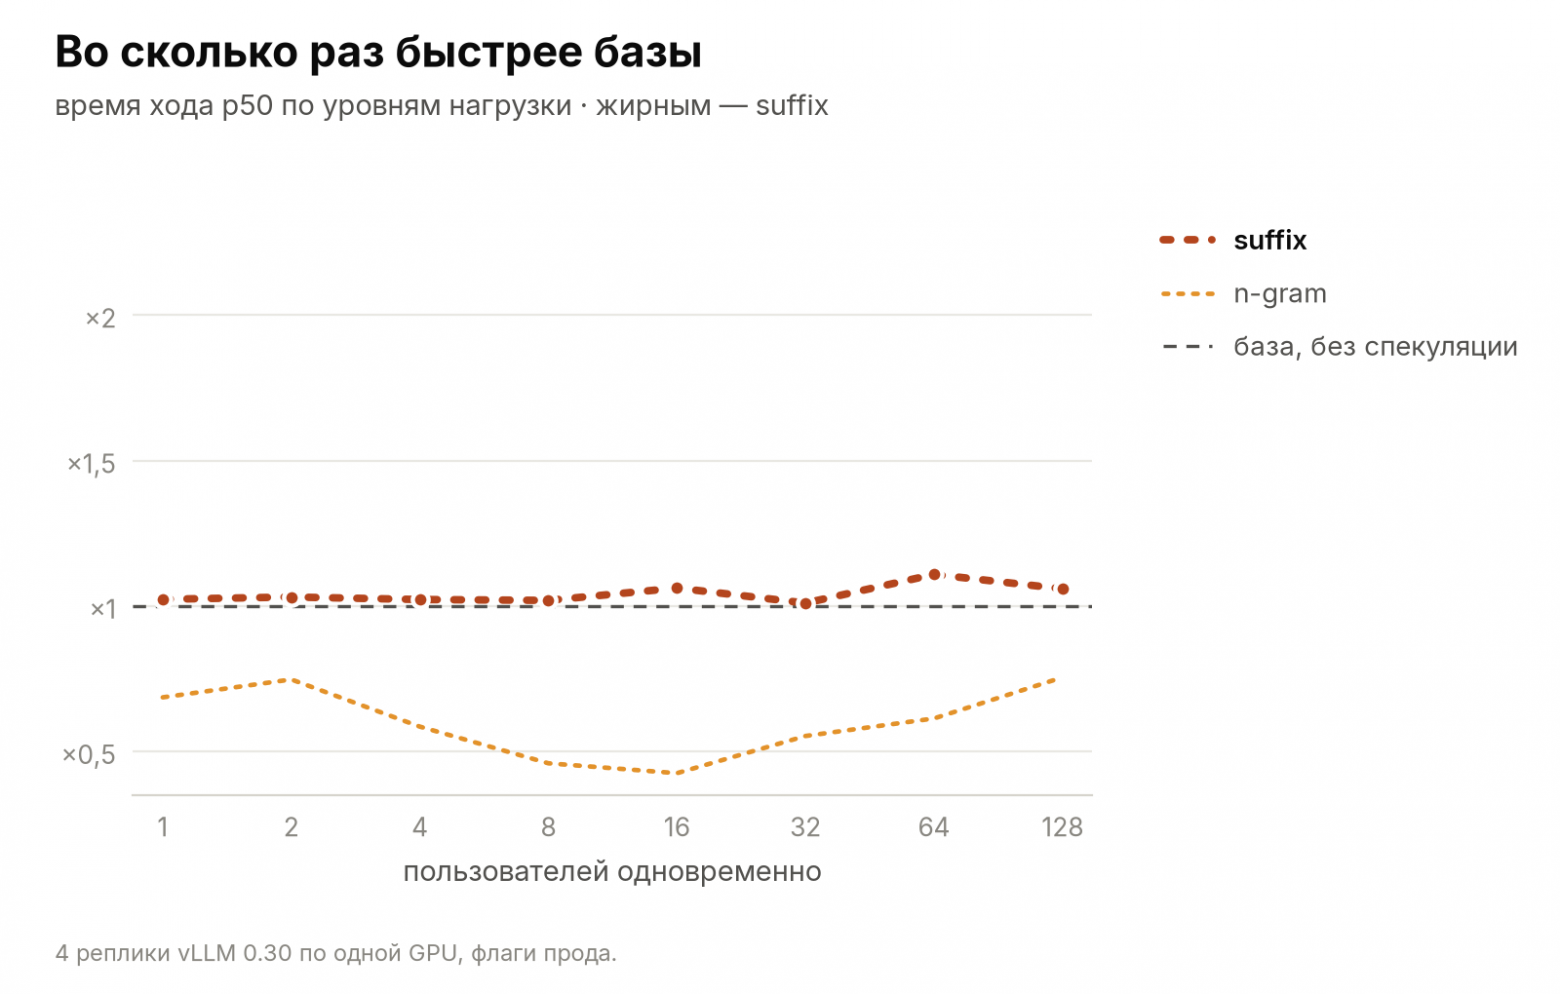
Скорость почти не выросла относительно базы: выигрыш 1–11% по уровням нагрузки, и почти весь он внутри шума. Битых JSON 1,1% против 0,13% у базы.
Грабли.
Сборка. Suffix decoding в vLLM живёт в пакете Arctic Inference от Snowflake. Под наше окружение готовой сборки не нашлось. Пришлось собрать из исходников только C+±расширение с деревом суффиксов: vLLM проверяет лишь то, что модуль импортируется.
Та же порча, что у n-gram, но реже: черновик есть на 92–100% шагов.
Длинный черновик под нагрузкой. При
 и 128 пользователях vLLM резервирует KV-кэш под черновик каждого запроса. Кэша перестаёт хватать, начинаются вытеснения запросов, и медиана хода выросла до 67 с.
Почти три токена за проход, а время то же.
 –
 , но ход не ускоряется. Похоже, выигрыш съедают отключённое асинхронное планирование и работа с деревом на CPU на каждом шаге. Глубже мы не профилировали.
3. MTP: дообучаем голову самой модели
Что делает. MTP-слой — ещё один слой модели: по её последнему скрытому состоянию и следующему токену он предсказывает токен после него. На инференсе его гоняют как драфтер, раз подряд, и со второго шага он работает на своём же выходе. Мы дообучили его на узкоспециализированных данных нашего пайплайна по рецепту FastMTP: сразу на несколько шагов развёртки, так же, как его гоняют при генерации. Данные те же, что у остальных драфтеров: промпты стадий ассистента и ответы самой модели, чаще всего JSON по схеме. На схеме — как слой разворачивается в черновик.
Зачем нам. Из обучаемых драфтеров этот самый простой. Учим не с нуля, а дообучаем готовый MTP-слой самой модели, и дообученный слой vLLM запускает штатно, без доработок.
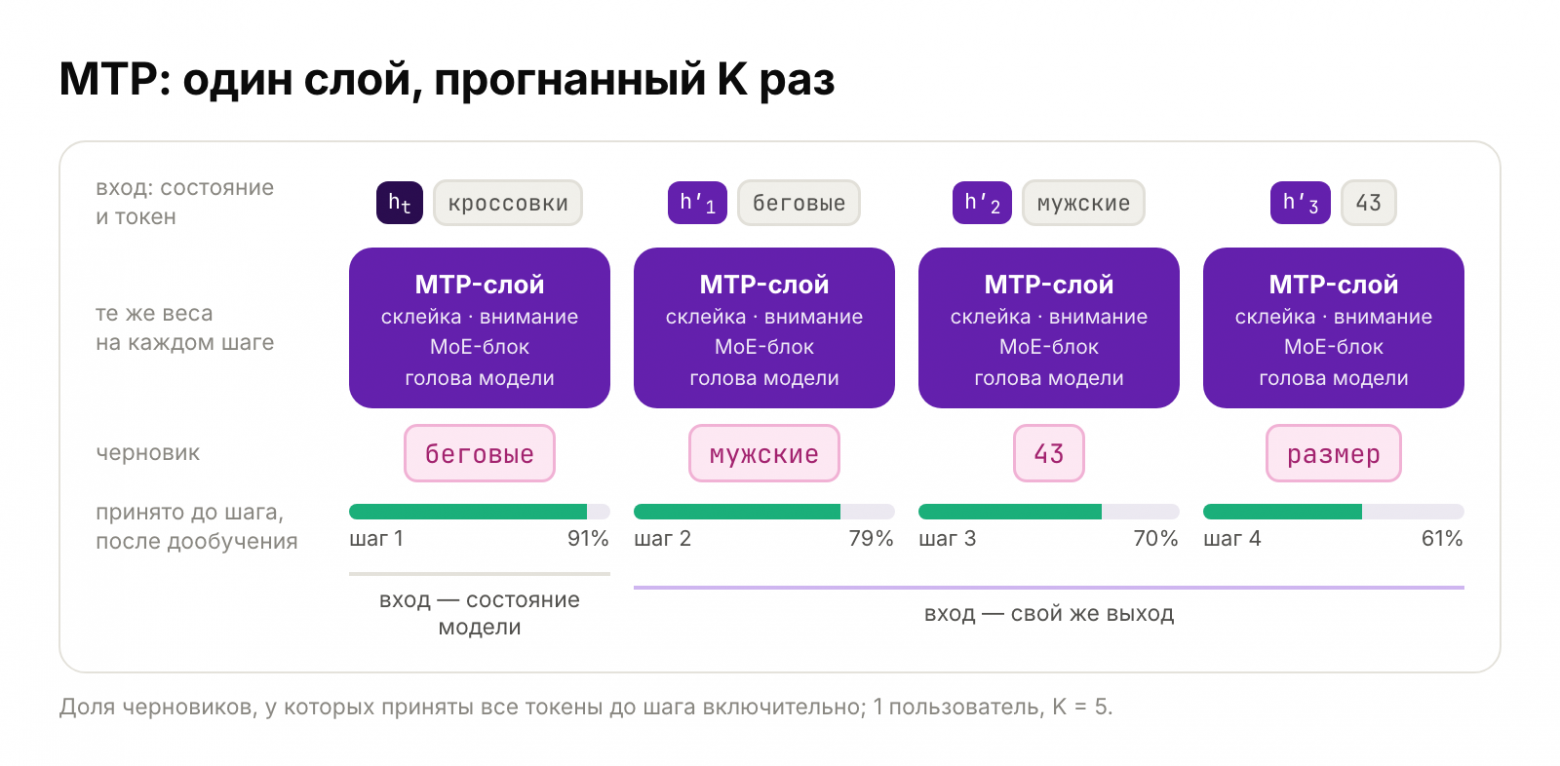
Как обучали. Признаки: последний слой модели и следующий токен. Черновик при обучении: 5 шагов развёртки. Лосс: кросс-энтропия с убывающими весами шагов.
Рецепт обучения MTP
Грабли.
Память. Логиты по всему словарю модели для 32 тыс. позиций упаковки на 5 шагах не помещаются в память. Мы считаем их только на позициях ответов, это около 1% позиций, а результат обучения от этого не меняется.
Скорость обучения. MTP-голова у этой модели — полноценный MoE-слой. Transformers считал экспертов в цикле в fp32. Мы перевели их на grouped GEMM в bf16, а внимание — на flex attention по упакованным документам. Шаг обучения ускорился с 8 до 0,8 с. Даже так это самое тяжёлое обучение из всех.
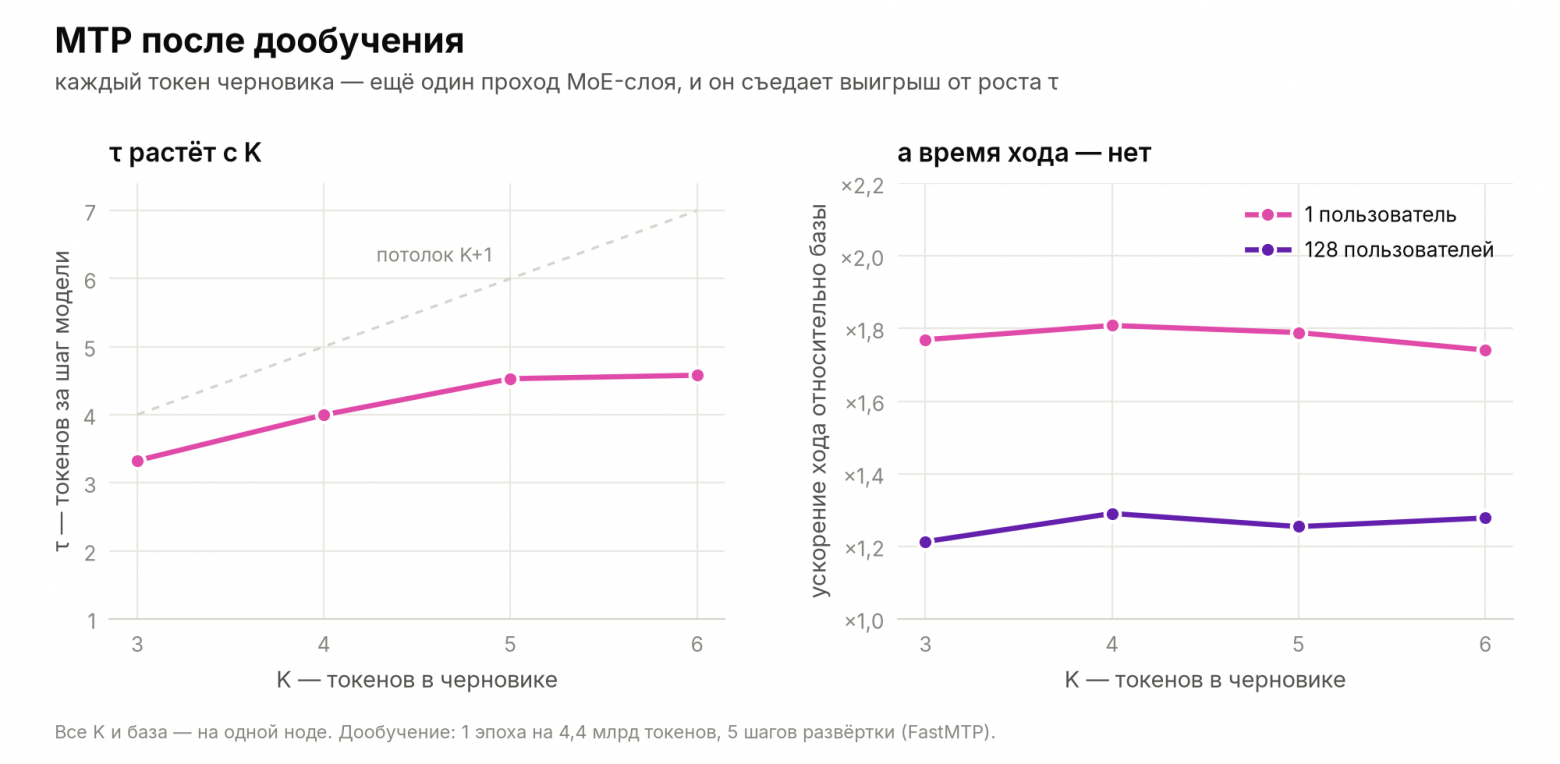
растёт с , а время хода — нет: каждый лишний токен черновика стоит ещё одного прохода MoE-слоя. При от 3 до 6 время различается в пределах шума, в таблицах — .
База | n-gram² | suffix² | MTP + дообучение | |
|---|---|---|---|---|
K | — | 5 | 16 | 5 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 | 3,5 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 | 4,0 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 | 8,9 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 | 37,2 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 | ×1,70 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 | 2,98 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ | 4,5 |
Битый JSON | 0,13% | 72% | 1,1% | 0,10% |
Обучение, GPU·ч | — | — | — | 64 |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
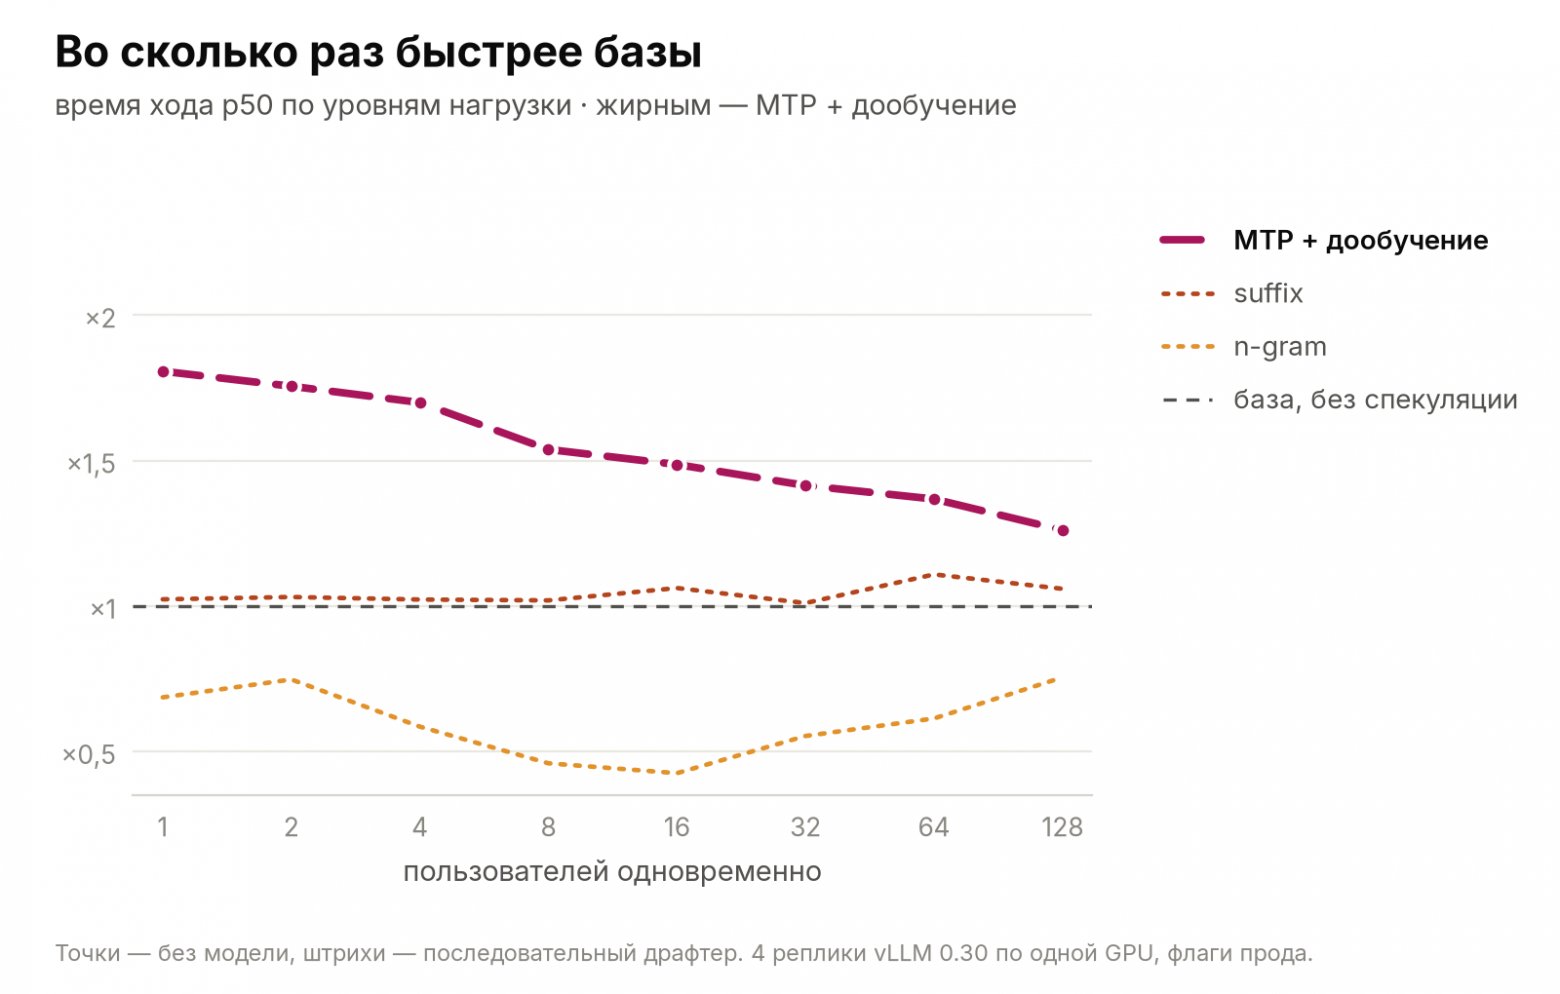
MTP после дообучения ускоряет ход в 1,8 раза при одном пользователе и в 1,26 раза при 128. Само дообучение добавило немного: голова модели и до него держала точность на дальних шагах, и время хода до и после различается в пределах шума. При малой нагрузке это уже близко к лидерам, но черновик по-прежнему строится последовательно. Как это сказывается на скорости, видно в следующем разделе.
4. EAGLE-3: лёгкий авторегрессионный драфтер
Что делает. Лёгкий авторегрессионный драфтер: один слой трансформера поверх признаков самой модели. Черновик строится токен за токеном. Поэтому при обучении драфтер видит собственные предсказания (training-time test), и на длинных черновиках ошибки накапливаются медленнее.
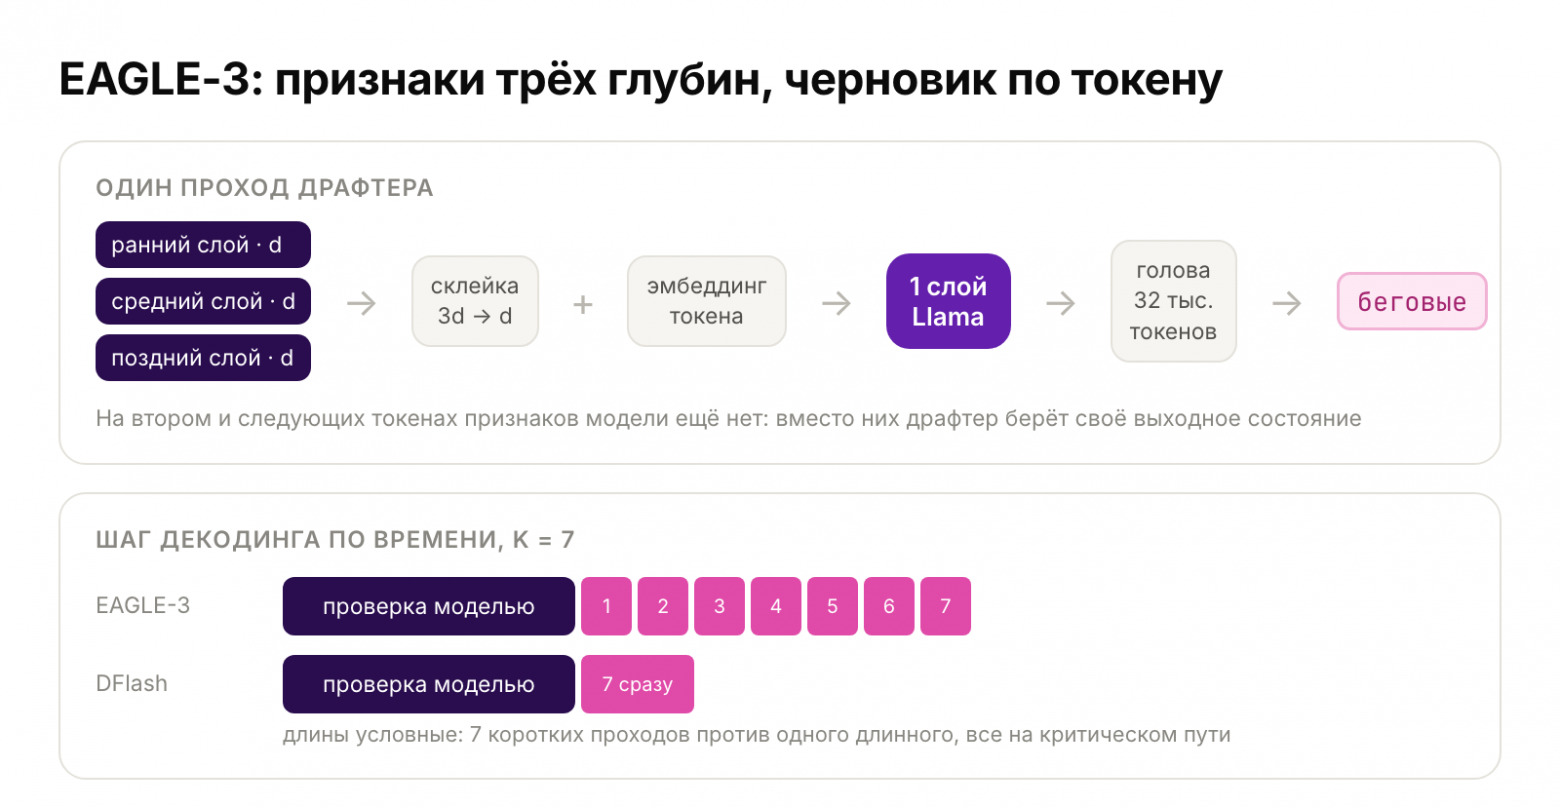
Как обучали. Признаки: 3 слоя из начала, середины и конца модели. Черновик при обучении: 3 шага training-time test. Лосс: KL к распределению модели.
Рецепт обучения EAGLE-3
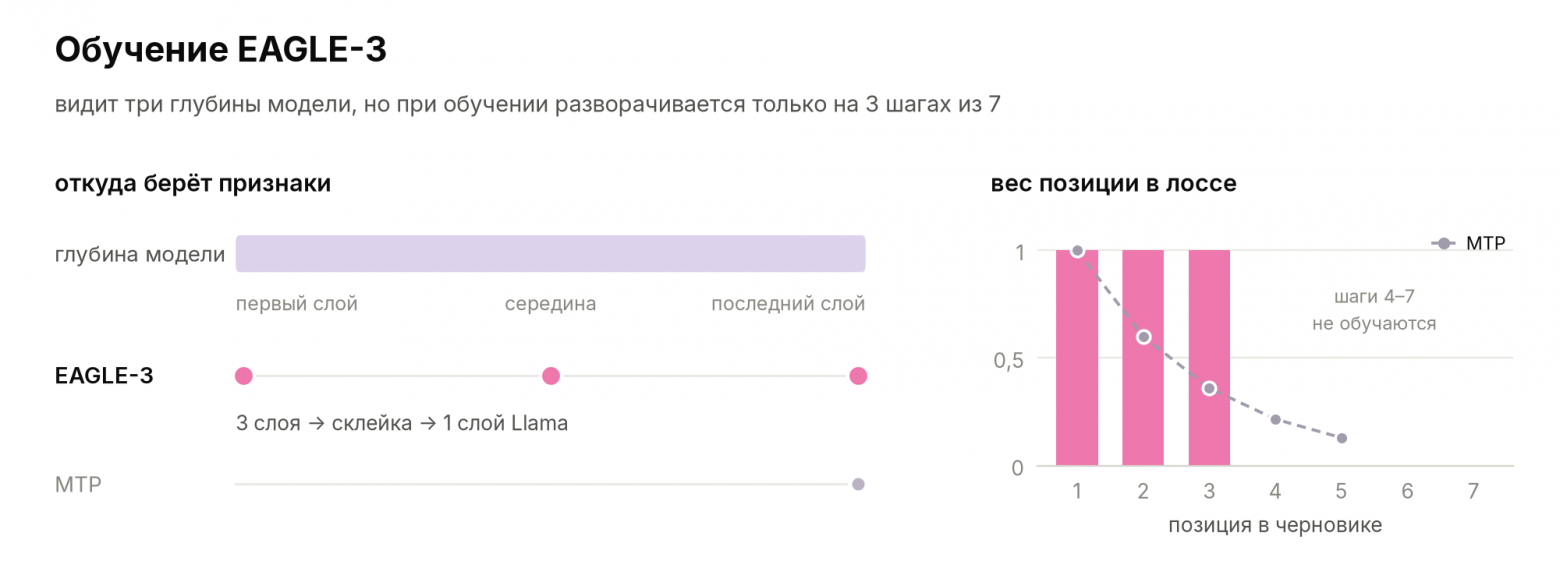
Скрытые состояния трёх слоёв — из начала, середины и конца модели — склеиваются и сжимаются линейным слоем до размерности модели. Поверх — один слой Llama и своя выходная голова на 32 тыс. токенов. Словарь урезан до самых частых токенов ответов. В наших ответах нашлось всего 24 365 различных токенов — малая доля словаря модели, так что в словарь драфтера вошли все. Обучение — training-time test на 3 шага: на шагах 2 и 3 драфтер получает на вход свои же выходы вместо признаков модели, как при генерации. Лосс — KL к распределению модели, перенесённому на словарь драфтера, с равными весами шагов:
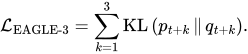
База | n-gram² | suffix² | MTP + дообучение | EAGLE-3 | |
|---|---|---|---|---|---|
K | — | 5 | 16 | 5 | 7 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 | 3,5 | 3,8 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 | 4,0 | 3,9 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 | 8,9 | 10,4 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 | 37,2 | 37,8 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 | ×1,70 | ×1,73 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 | 2,98 | 3,06 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ | 4,5 | 4,3 |
Битый JSON | 0,13% | 72% | 1,1% | 0,10% | 0,09% |
Обучение, GPU·ч | — | — | — | 64 | 52 |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
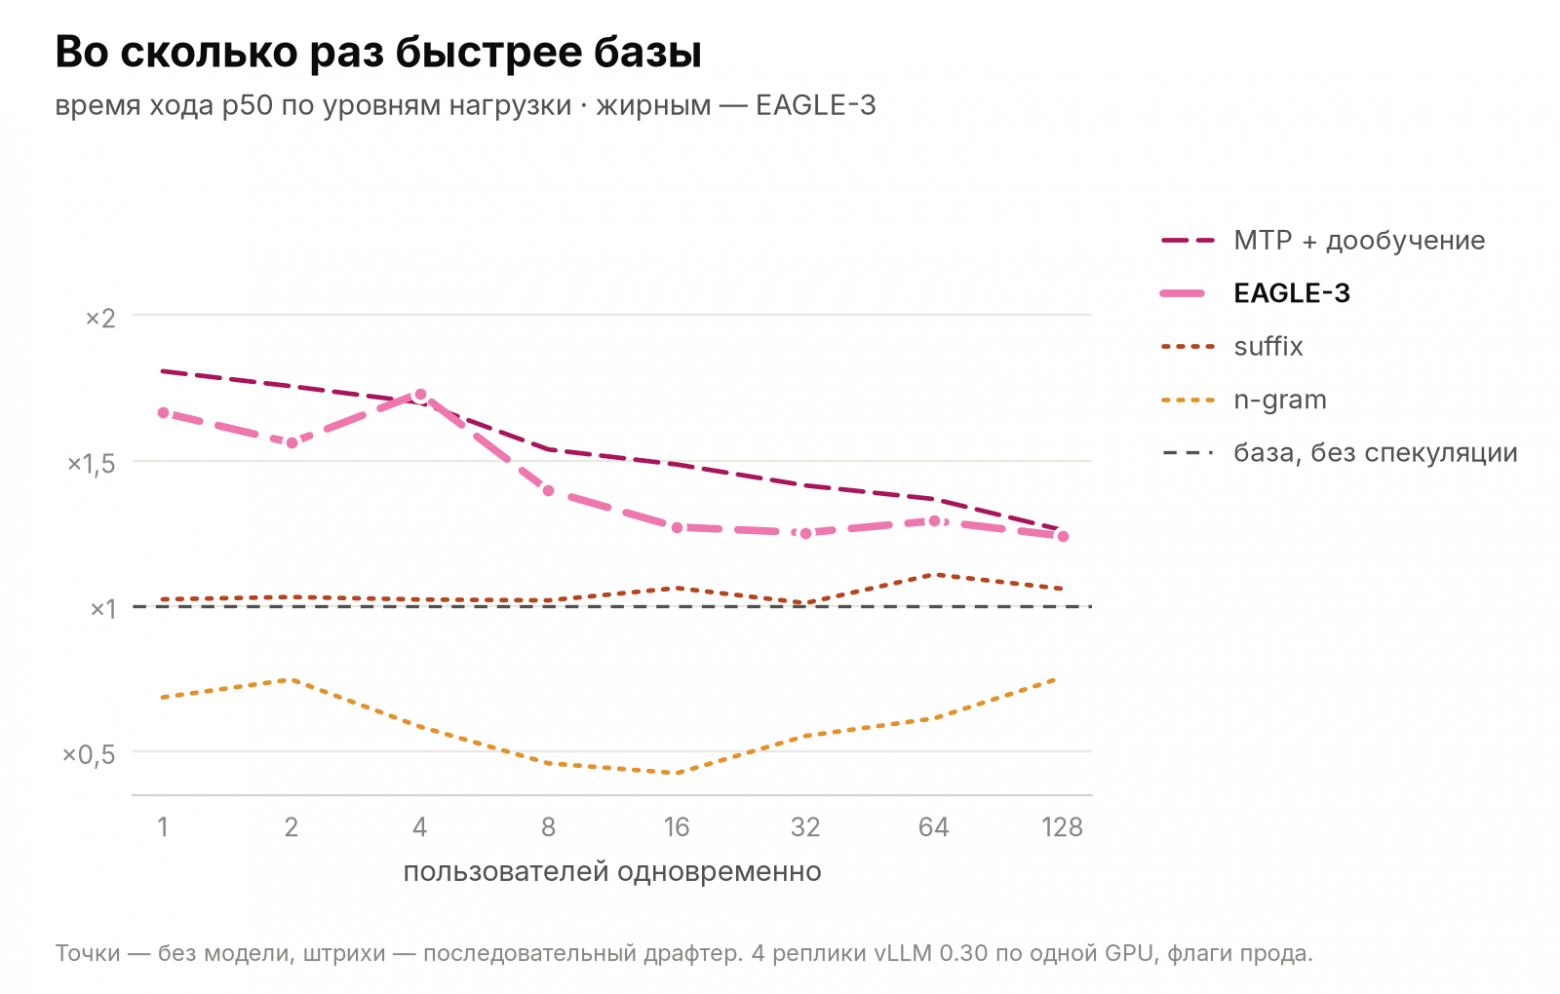
у EAGLE-3 почти как у параллельных драфтеров: 4,3–5,4 при . Но ход на 11–23% медленнее, чем у DFlash 2. Причина в цене черновика: токенов — это последовательных проходов драфтера, и при малой нагрузке они стоят на критическом пути.
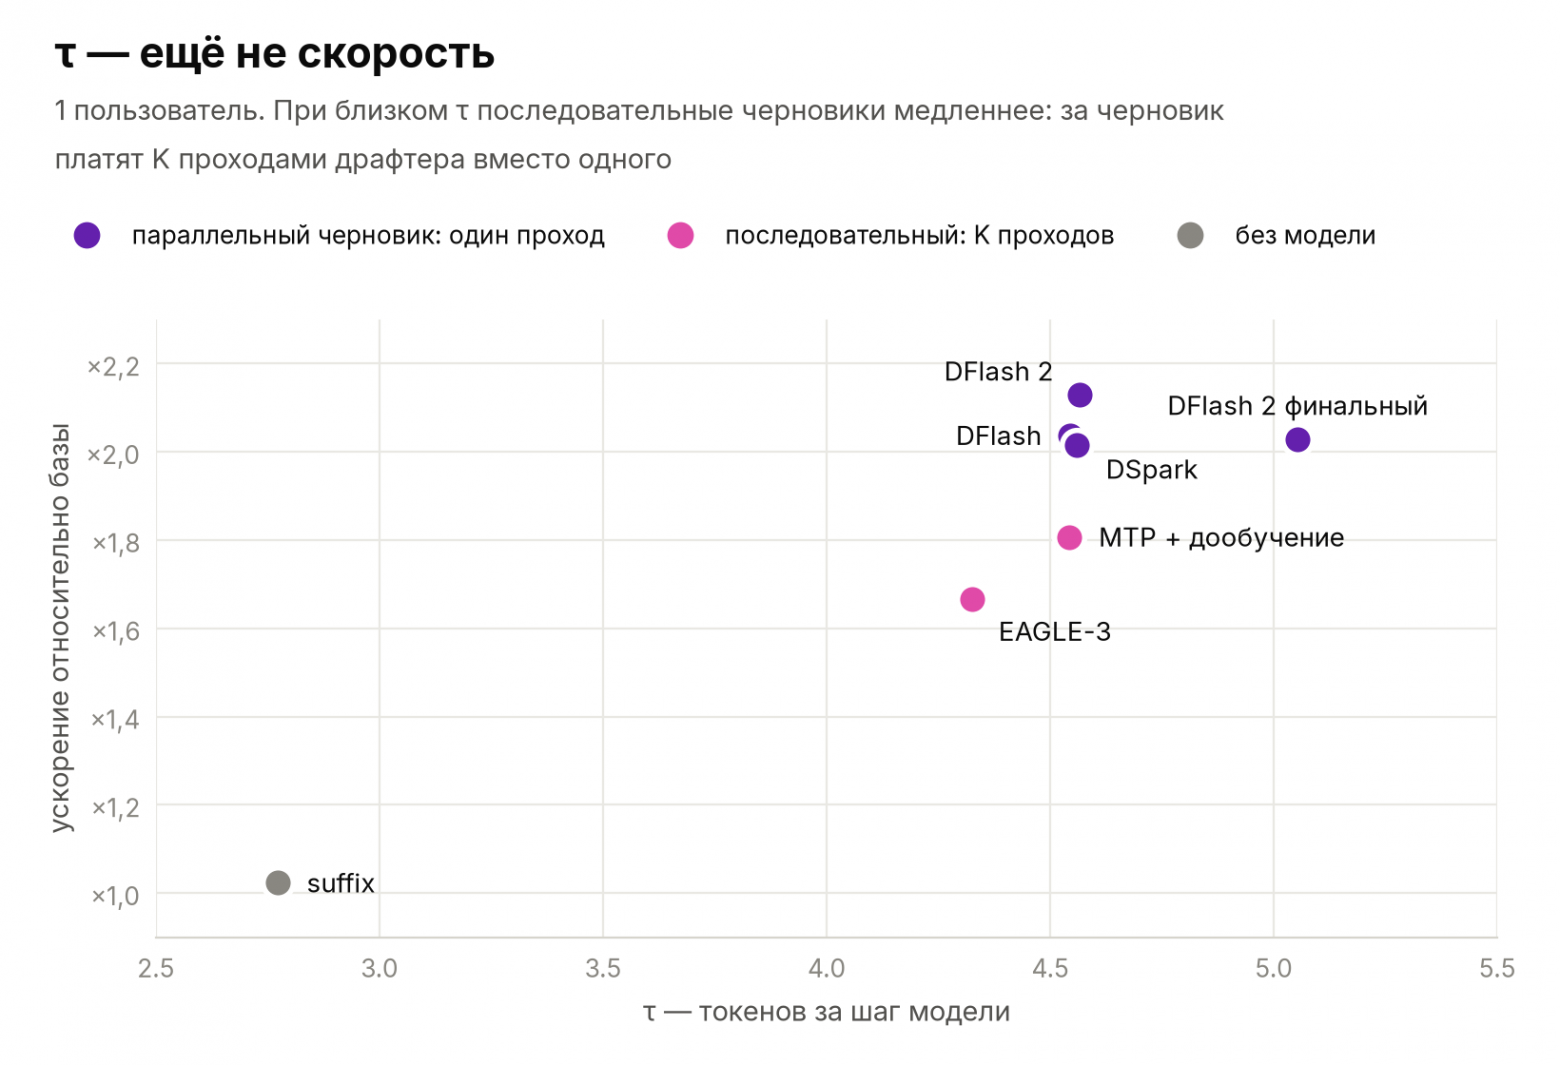
Это главный урок раздела: — ещё не скорость. Сравнивать драфтеры только по , как часто делают в статьях, нельзя. Нужно мерить время.
5. DFlash: весь черновик за один проход
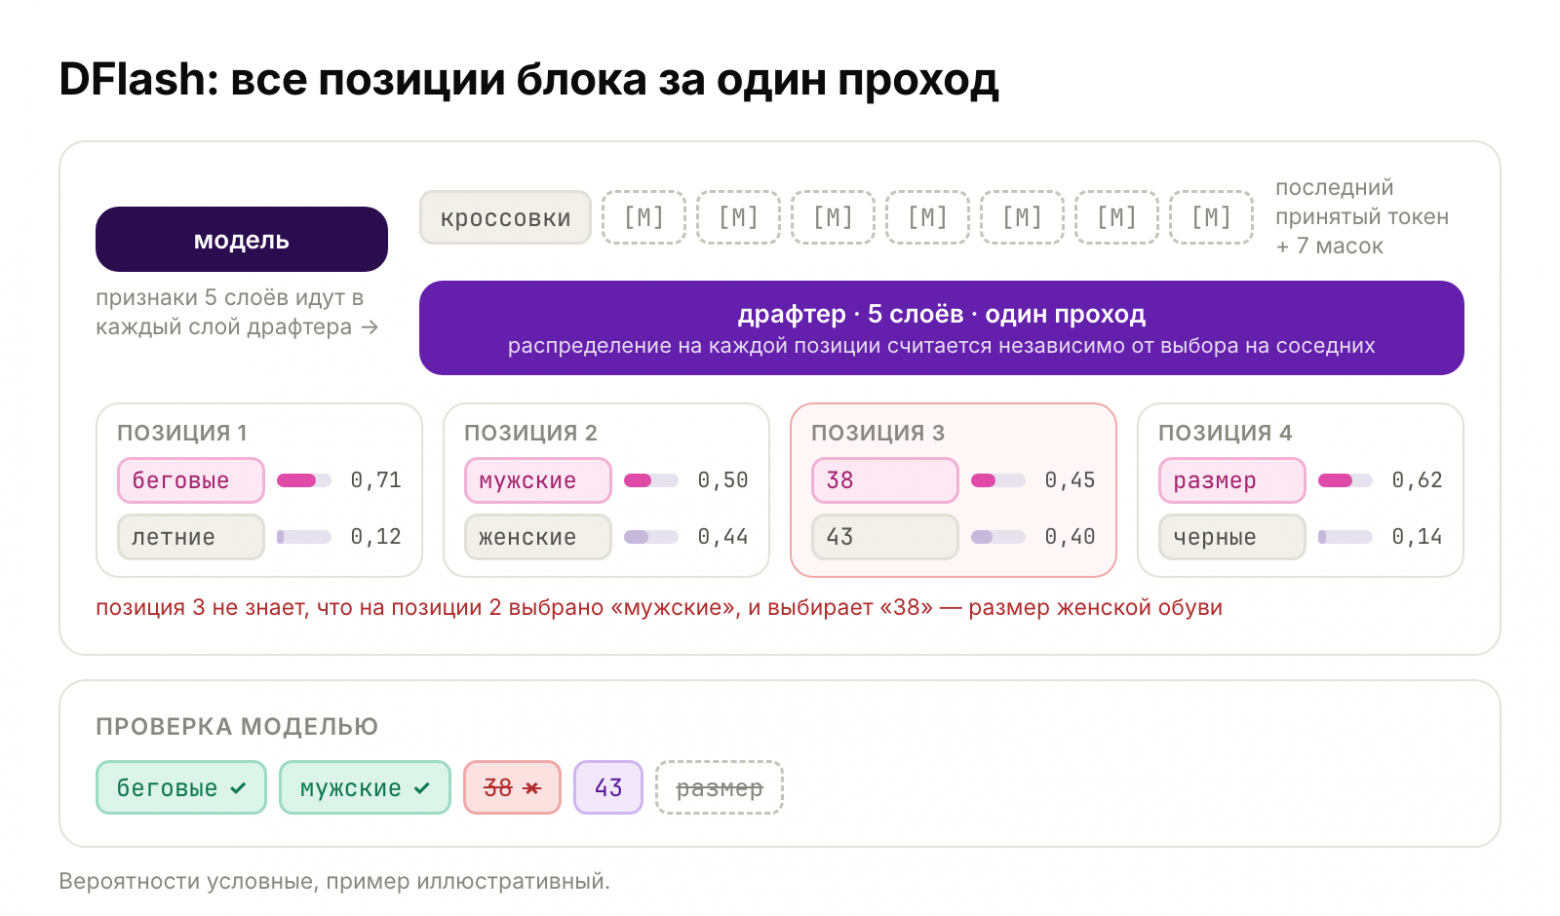
Что делает. Блочная диффузия: весь блок черновика заполняется за один проход драфтера, поэтому цена черновика почти не зависит от и выгодны длинные блоки. Слабое место видно на схеме: позиции блока не знают, что выбрано на соседних.
Как обучали. Признаки: 5 слоёв по всей глубине модели. Черновик при обучении: блок 8, то есть . Лосс: кросс-энтропия с весами позиций D-PACE.
Рецепт обучения DFlash
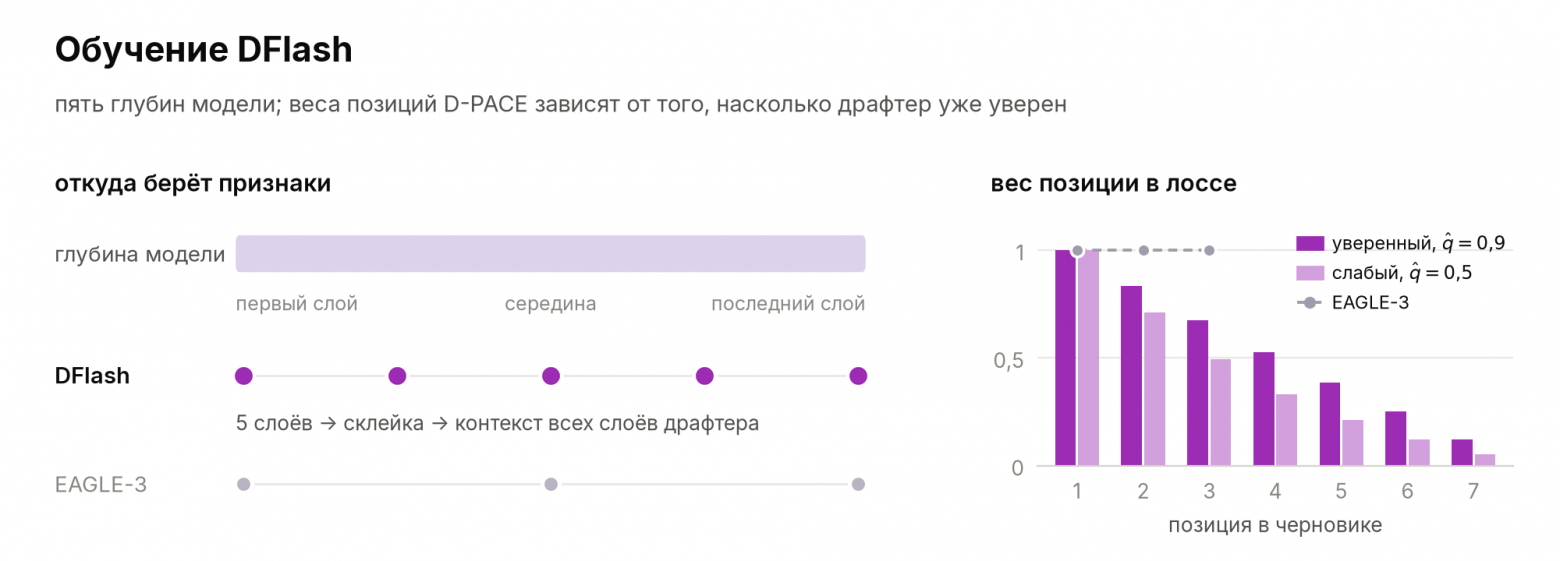
Скрытые состояния пяти слоёв склеиваются, проецируются и подаются во все слои драфтера как дополнительный контекст. В упакованной последовательности выбирается до 1024 якорей — позиций внутри ответов. Для якоря  драфтер получает блок из токена
 и 7 масок и учится восстанавливать
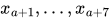 , видя состояния модели только до позиции . Все якоря упаковки считаются за один проход: маска внимания не даёт блокам видеть друг друга.
Лосс — умолчание speculators для DFlash: кросс-энтропия к argmax модели с весами позиций D-PACE. Пусть  — кросс-энтропия на позиции
 блока, а
 — вероятность, которую драфтер даёт правильному токену. Веса считаются без градиента:
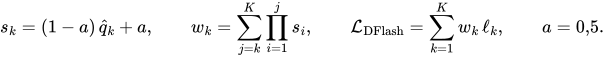
Смысл весов виден из утверждения 2. Если позиции принимаются независимо с вероятностями  , ожидаемая длина принятого префикса
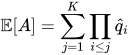 , и
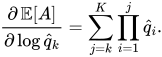
То есть D-PACE взвешивает позицию тем, насколько от неё зависит длина принятого черновика, а сглаживание не даёт весам обнулиться. Ранние позиции весят больше поздних, но профиль весов подстраивается под текущее качество драфтера.
Блок 8 и жадный выбор черновика мы перенесли из прошлых экспериментов с DFlash: там блок 8 оказался лучше 16, а жадный выбор лучше сэмплированного.
База | n-gram² | suffix² | MTP + дообучение | EAGLE-3 | DFlash | |
|---|---|---|---|---|---|---|
K | — | 5 | 16 | 5 | 7 | 7 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 | 3,5 | 3,8 | 3,1 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 | 4,0 | 3,9 | 3,3 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 | 8,9 | 10,4 | 8,5 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 | 37,2 | 37,8 | 35,3 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 | ×1,70 | ×1,73 | ×2,02 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 | 2,98 | 3,06 | 3,29 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ | 4,5 | 4,3 | 4,5 |
Битый JSON | 0,13% | 72% | 1,1% | 0,10% | 0,09% | 0,07% |
Обучение, GPU·ч | — | — | — | 64 | 52 | 64 |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
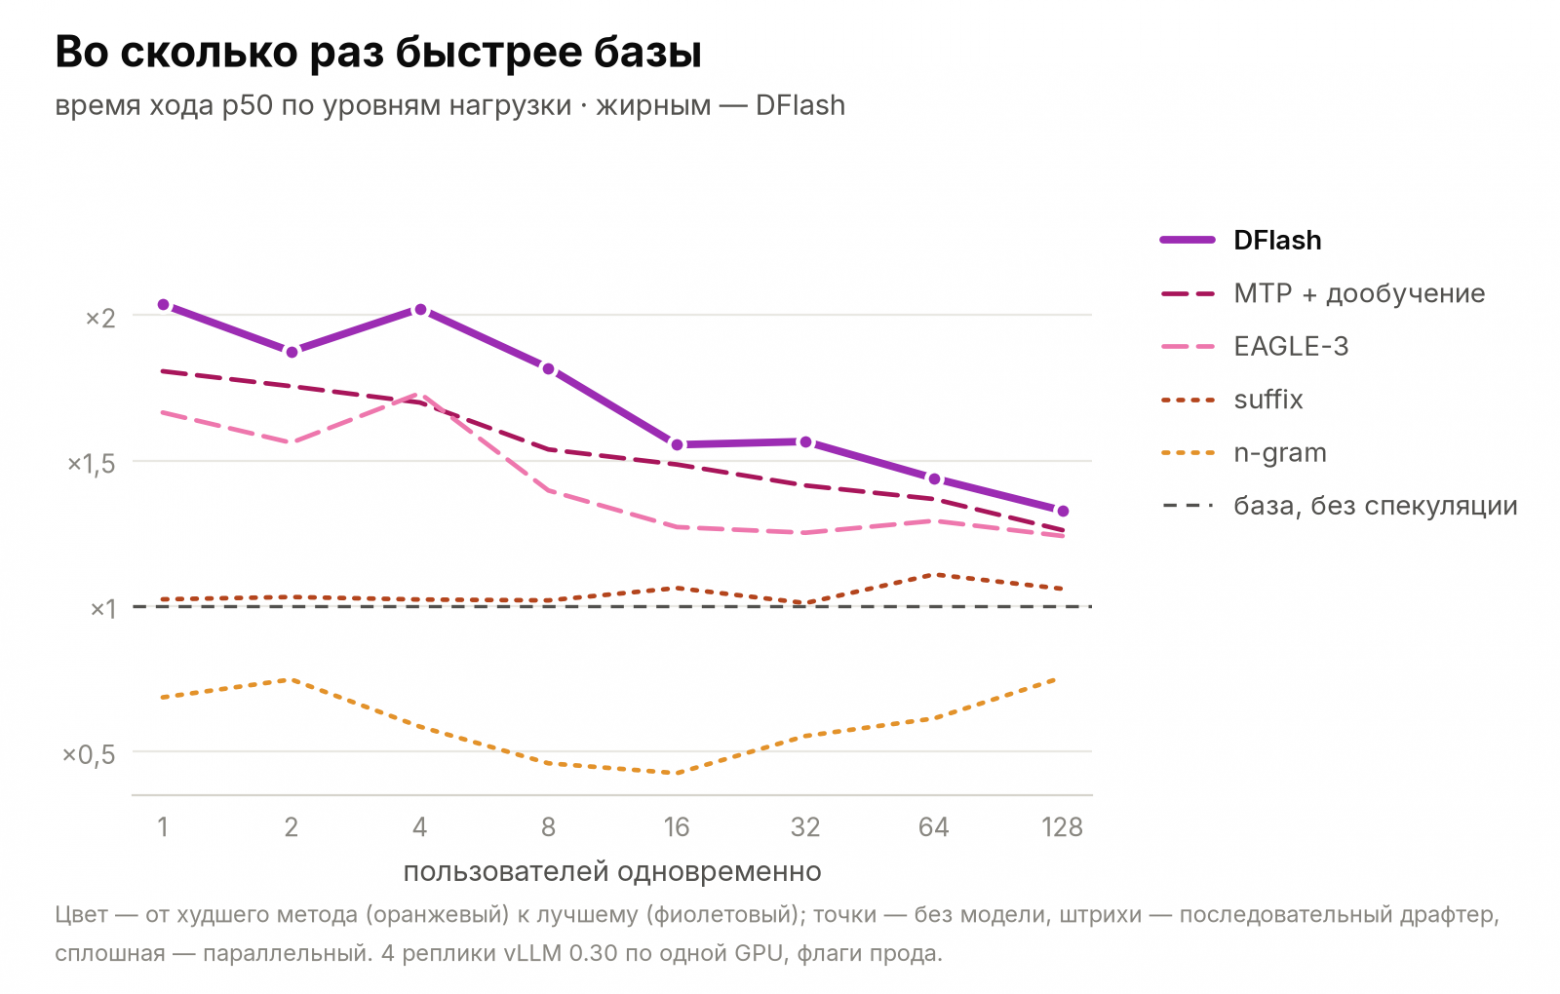
DFlash сразу выходит в лидеры: ×2,0 при малой нагрузке.
Грабли.
Инфраструктура обучения:
Норма. В speculators норма верификатора для этой архитектуры считалась как
output * weightвместоoutput * (1 + weight), и цели обучения получались неверными.Загрузчик. 12 воркеров не успевали подавать данные, понадобилось 40.
Слабое место метода. Позиции блока не согласованы друг с другом, как на схеме выше, и к концу блока точность падает. Его и лечат следующие два метода.
6. DSpark: параллельный драфтер с марковской головой
Что делает. Добавляет к параллельной основе DFlash две маленькие головы. Марковская голова поправляет логиты позиции по токену, выбранному на предыдущей, и почти без дополнительных затрат делает позиции блока зависимыми друг от друга. Голова уверенности оценивает, будет ли позиция принята, чтобы планировщик мог обрезать черновик ещё до проверки. На схеме тот же пример, что у DFlash.
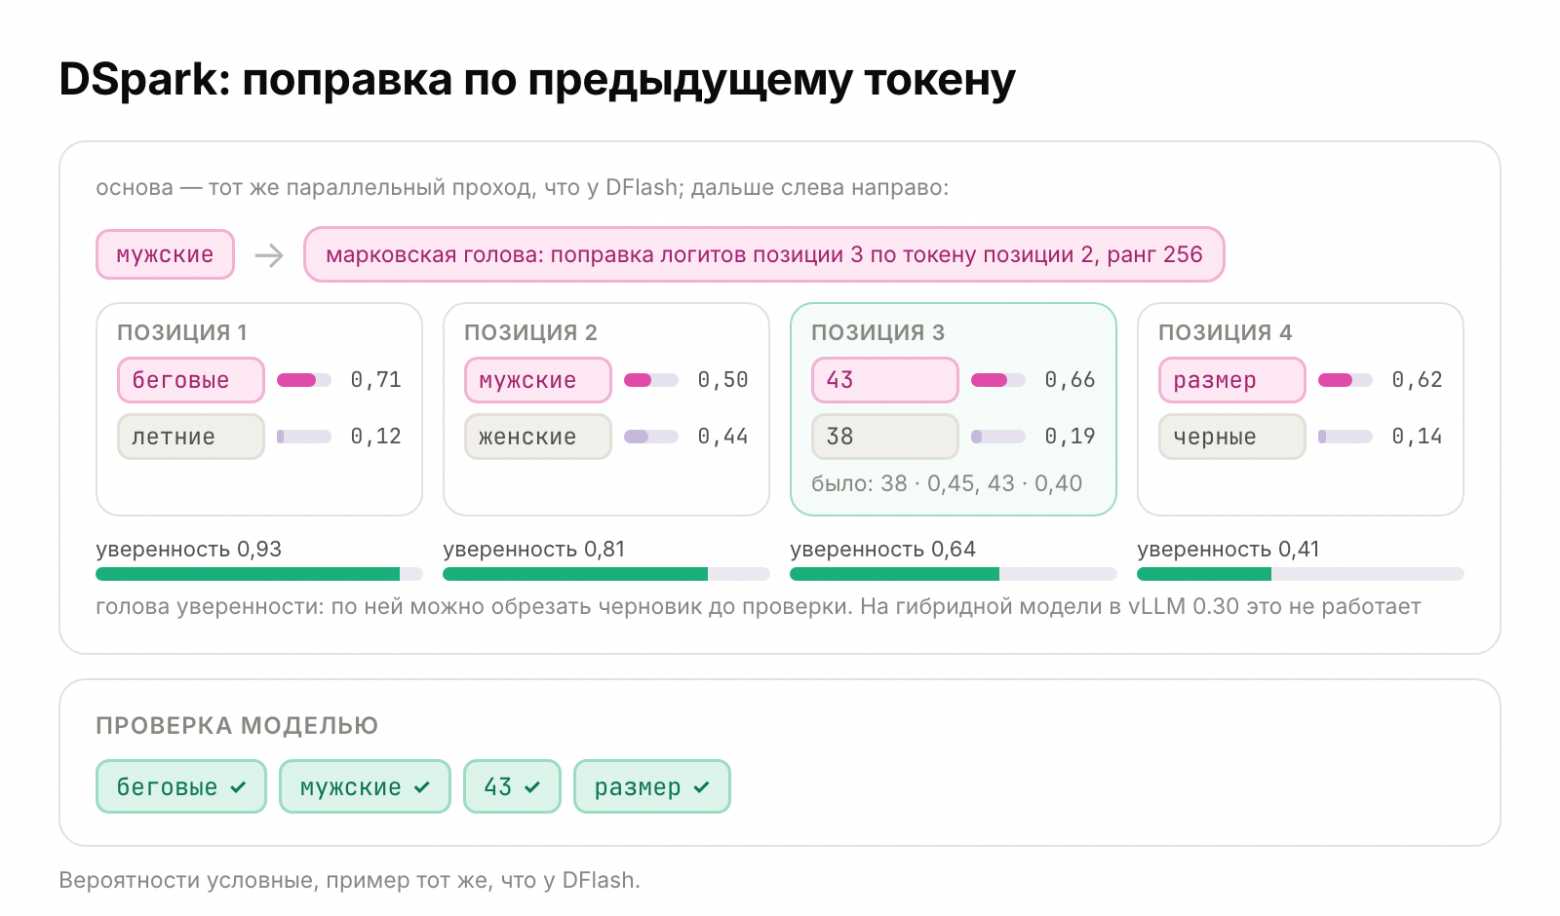
Как обучали. Признаки: те же 5 слоёв модели, что у DFlash. Черновик при обучении: блок 8. Лосс: кросс-энтропия,  и лосс уверенности.
Рецепт обучения DSpark
База | n-gram² | suffix² | MTP + дообучение | EAGLE-3 | DFlash | DSpark | |
|---|---|---|---|---|---|---|---|
K | — | 5 | 16 | 5 | 7 | 7 | 7 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 | 3,5 | 3,8 | 3,1 | 3,2 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 | 4,0 | 3,9 | 3,3 | 3,6 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 | 8,9 | 10,4 | 8,5 | 8,7 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 | 37,2 | 37,8 | 35,3 | 33,7 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 | ×1,70 | ×1,73 | ×2,02 | ×1,87 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 | 2,98 | 3,06 | 3,29 | 3,23 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ | 4,5 | 4,3 | 4,5 | 4,6 |
Битый JSON | 0,13% | 72% | 1,1% | 0,10% | 0,09% | 0,07% | 0,12% |
Обучение, GPU·ч | — | — | — | 64 | 52 | 64 | 60 |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
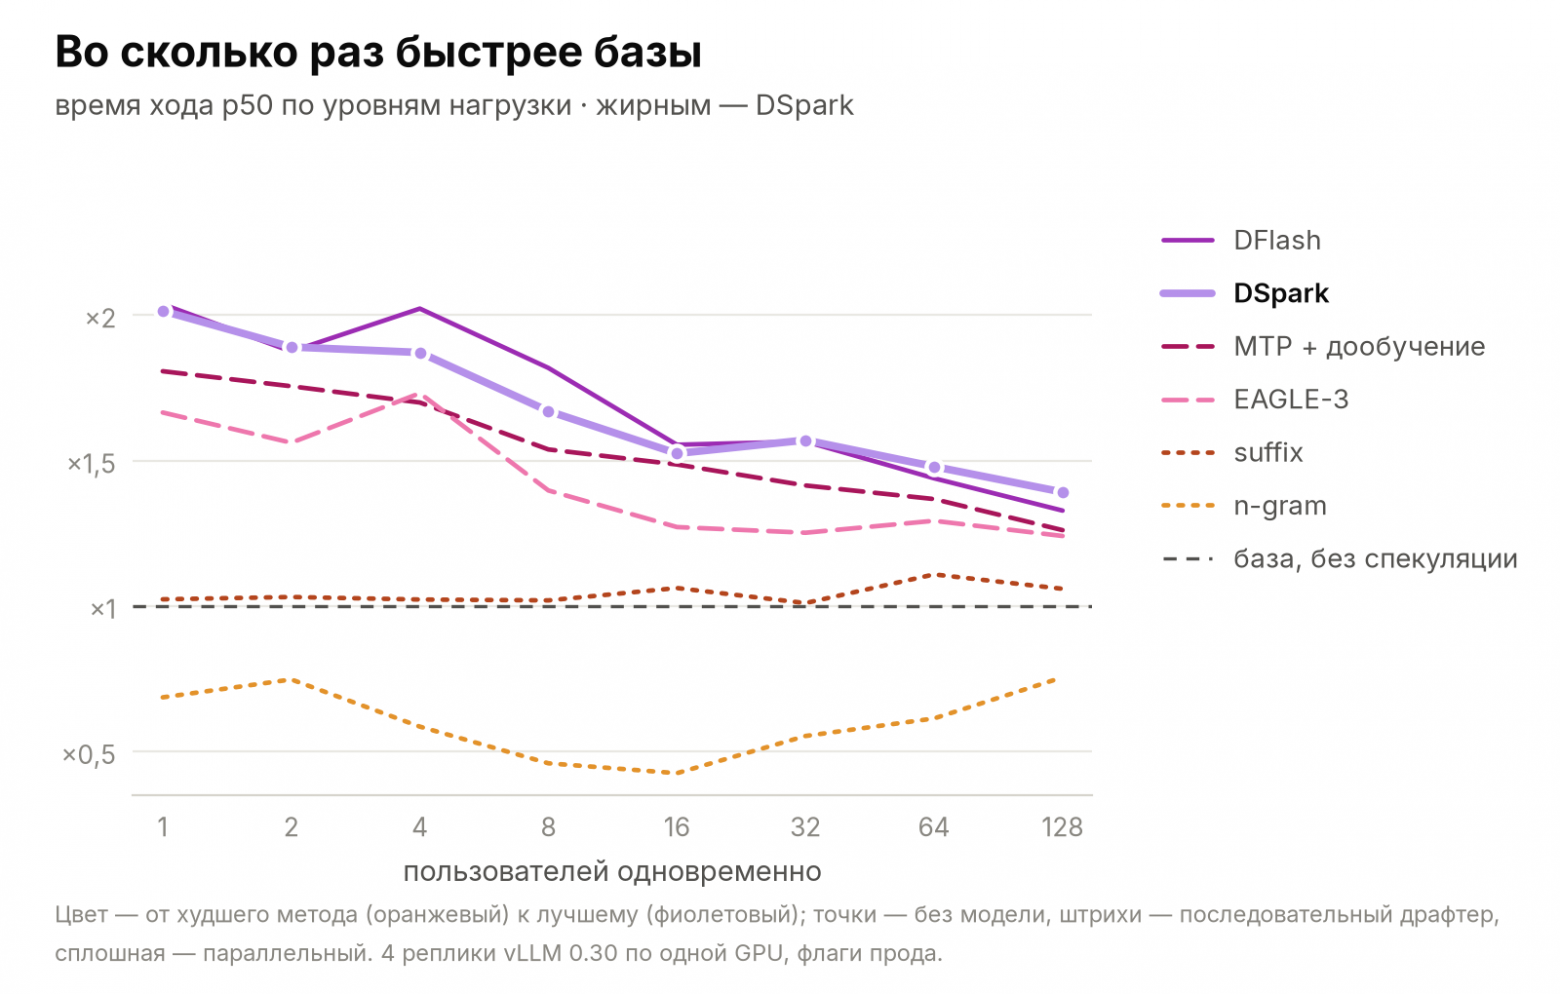
DSpark догнал DFlash, но не обогнал. Лучшее время при 128 пользователях — ×1,39, при малой нагрузке он в пределах шума от DFlash 2. На графике принятия по позициям видно, почему: на равном бюджете обучения DFlash, DSpark и DFlash 2 принимают черновики практически одинаково.
Грабли. Голова уверенности у нас не пригодилась. Она нужна для адаптивной проверки: планировщик обрезает черновик там, где драфтер не уверен, и не тратит проверку на заведомо слабые токены. Но в vLLM 0.30 бэкенд линейного внимания не умеет обрезать черновики прямо на GPU, и с этим режимом сервер падает при старте. Поэтому DSpark работал с фиксированным , как остальные драфтеры. На моделях с обычным вниманием он может показать себя лучше.
7. DFlash 2: та же проблема, решённая параллельно
Что делает. Решает ту же проблему без последовательной головы. На каждой позиции берутся 16 лучших кандидатов, и маленький ранжировщик выбирает среди них согласованный путь. Свёртка в слоях драфтера смешивает соседние позиции ещё до выбора. Основное время черновика по-прежнему уходит на один параллельный проход, последовательно работает только ранжировщик.
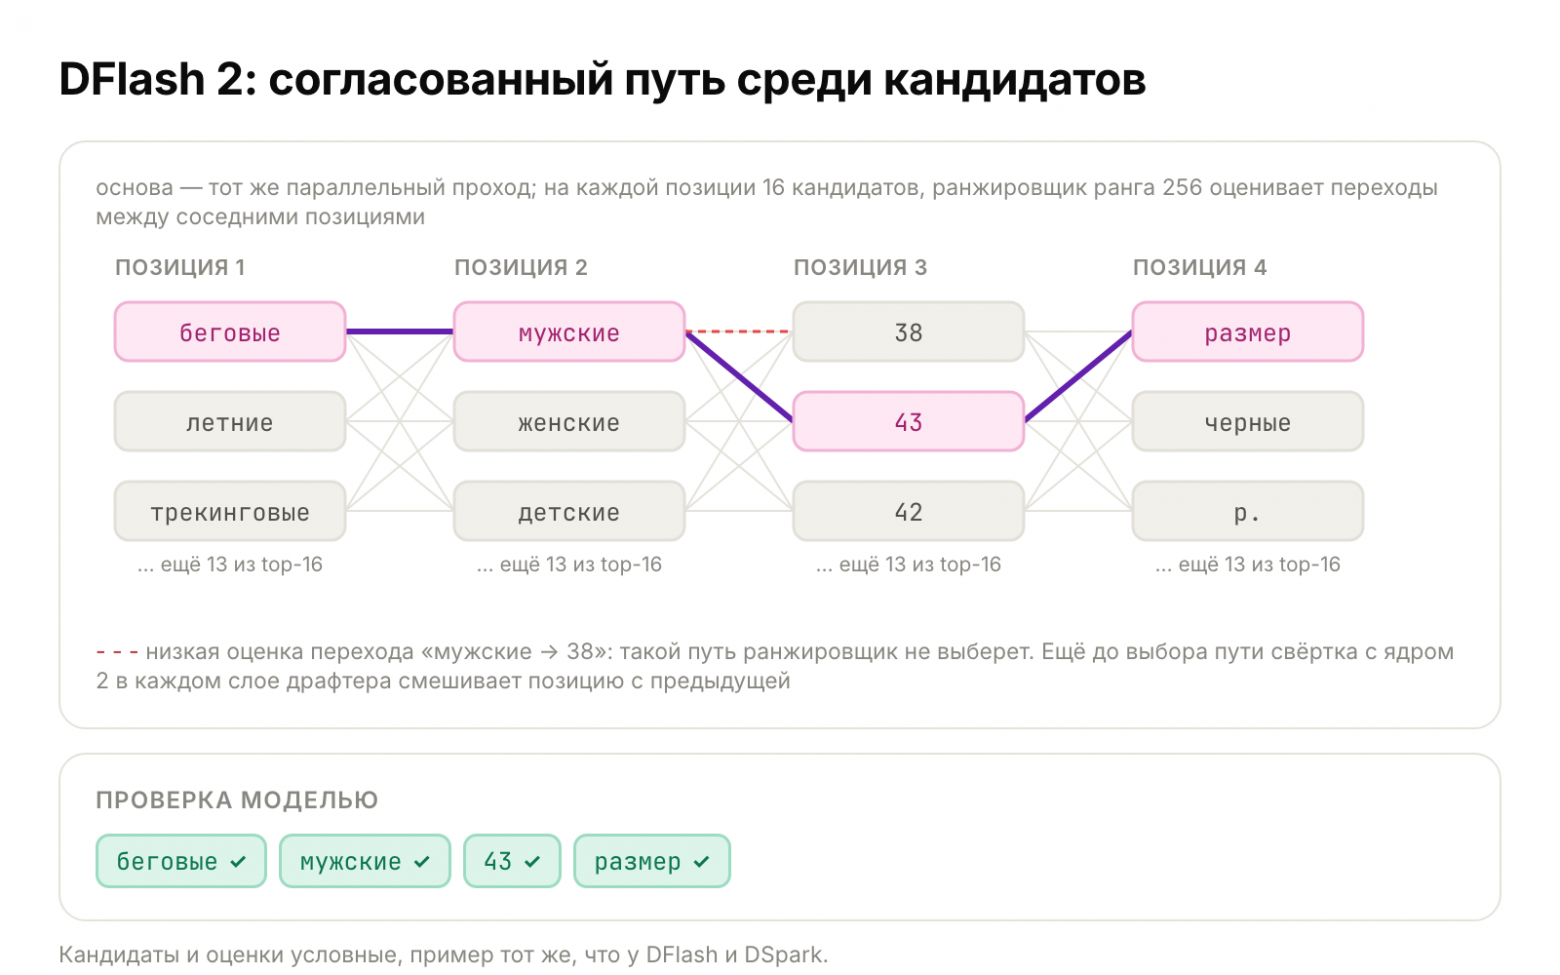
Как обучали. Признаки: те же 5 слоёв модели. Черновик при обучении: блок 8. Лосс: KL к распределению модели плюс лосс ранжировщика.
Рецепт обучения DFlash 2
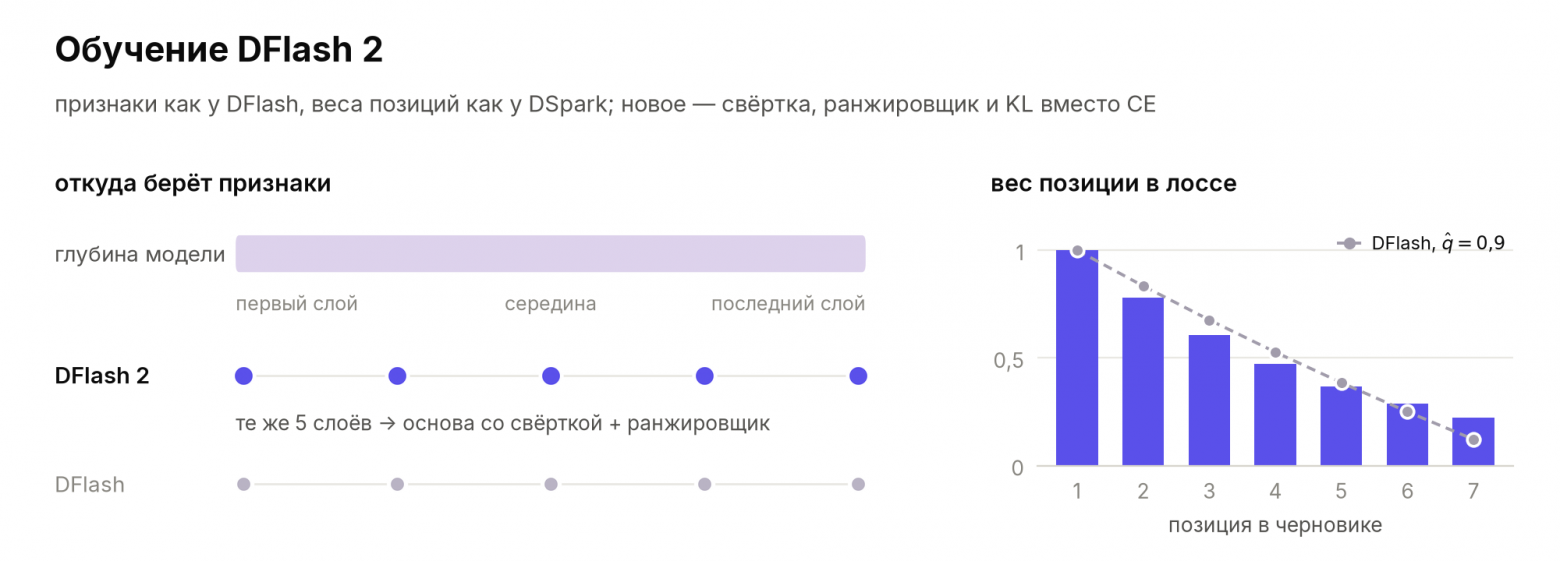
Основа та же, что у DSpark: 5 слоёв со скользящим окном 2048, блок 8, те же слои и якоря. Добавки — свёртка с ядром 2 вокруг внимания и MLP в каждом слое и ранжировщик путей ранга 256 по 16 кандидатам на позицию. Лосс:
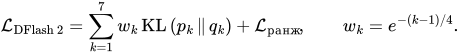
 — кросс-энтропия выбора среди 16 кандидатов позиции. Метка — токен, который выбрала бы большая модель. Если его нет среди 16, он подставляется на место самого слабого кандидата.
База | n-gram² | suffix² | MTP + дообучение | EAGLE-3 | DFlash | DSpark | DFlash 2 | |
|---|---|---|---|---|---|---|---|---|
K | — | 5 | 16 | 5 | 7 | 7 | 7 | 7 |
Ход p50, 1 польз., с | 6,4 | 9,3 | 6,2 | 3,5 | 3,8 | 3,1 | 3,2 | 3,0 |
Ход p50, 4 польз., с | 6,7 | 11,5 | 6,6 | 4,0 | 3,9 | 3,3 | 3,6 | 3,2 |
Ход p50, 16 польз., с | 13,3 | 31,1 | 12,5 | 8,9 | 10,4 | 8,5 | 8,7 | 8,2 |
Ход p50, 128 польз., с | 46,9 | 62,2 | 44,3 | 37,2 | 37,8 | 35,3 | 33,7 | 34,3 |
Ускорение, 4 польз. | ×1,00 | ×0,59 | ×1,02 | ×1,70 | ×1,73 | ×2,02 | ×1,87 | ×2,07 |
Ходов/с, 128 польз. | 2,35 | 1,49 | 2,51 | 2,98 | 3,06 | 3,29 | 3,23 | 3,33 |
τ, 1 польз. | — | 3,4¹ | 2,8¹ | 4,5 | 4,3 | 4,5 | 4,6 | 4,5 |
Битый JSON | 0,13% | 72% | 1,1% | 0,10% | 0,09% | 0,07% | 0,12% | 0,12% |
Обучение, GPU·ч | — | — | — | 64 | 52 | 64 | 60 | 60 |
¹ У n-gram и suffix vLLM считает только по шагам с черновиком. В пересчёте на все шаги у n-gram выходит ~2 токена за проход.
² n-gram и suffix работают только на старом раннере vLLM: новый их не поддерживает. Остальные методы — на новом.
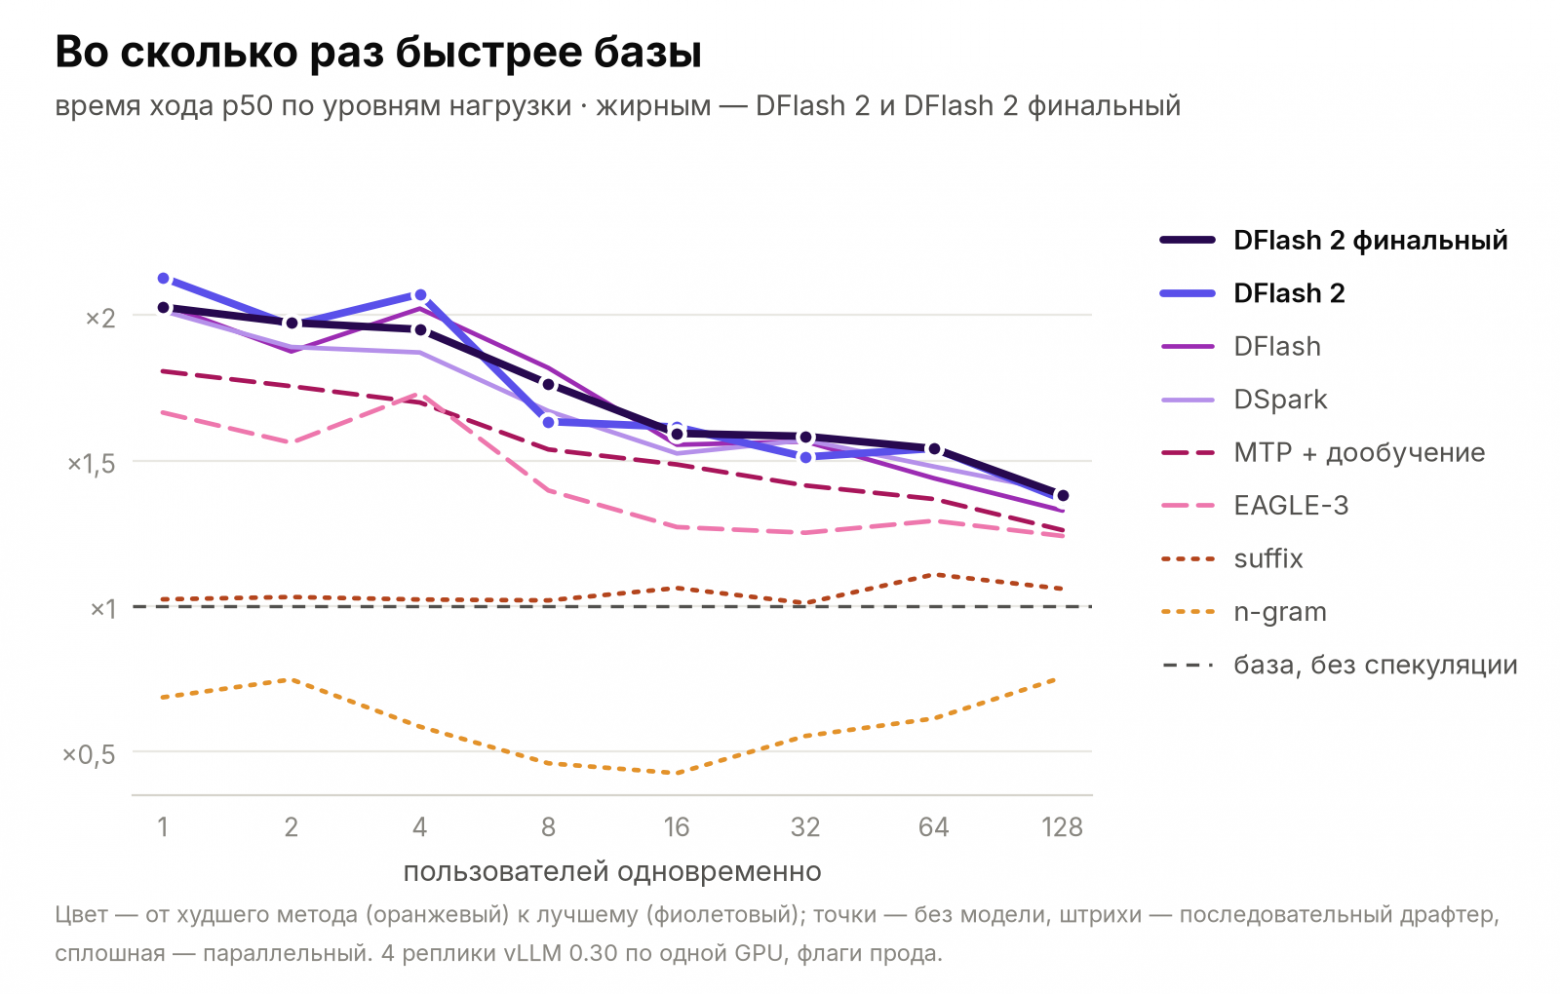
На равном бюджете DFlash 2 — первый или в пределах шума от первого на всех уровнях нагрузки: ×2,1 при одном пользователе, ×2,07 при четырёх и ×1,37 при 128.
Для прода мы обучали DFlash 2 дольше: втрое больше данных (все 13,8 млрд токенов) и 3 эпохи, около 34 часов на тех же двух нодах. вырос на ~8%, а время хода почти не изменилось: финальный и пилотный драфтеры в пределах шума, но финальный ведёт себя чуть стабильнее.
Итог: почему DFlash 2
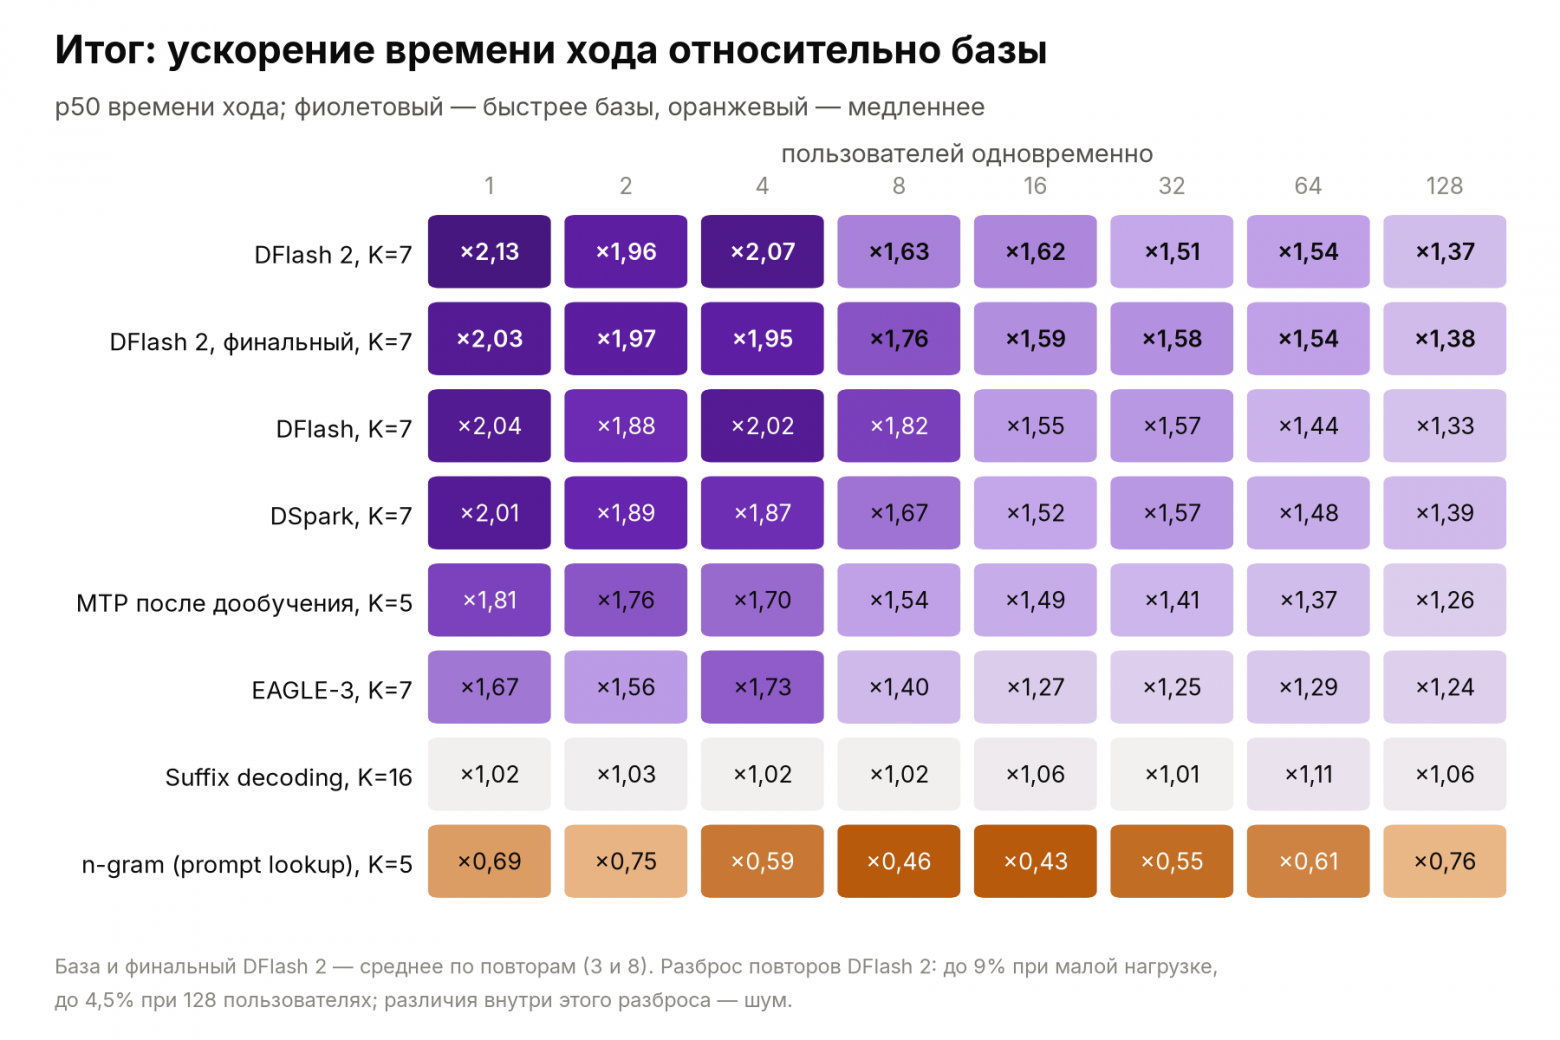
Лидеров трое: DFlash, DSpark и DFlash 2, и между собой они в пределах шума. Мы выбрали DFlash 2:
Он среди лучших на всех уровнях нагрузки. Восемь повторов на разных нодах дали стабильный результат.
Черновик параллельный. Цена черновика почти не зависит от , а последовательная часть — только крошечный ранжировщик.
Работает на новом раннере vLLM без обходных путей и не зависит от функций, которые на гибридной модели пока недоступны.
Что получилось в проде
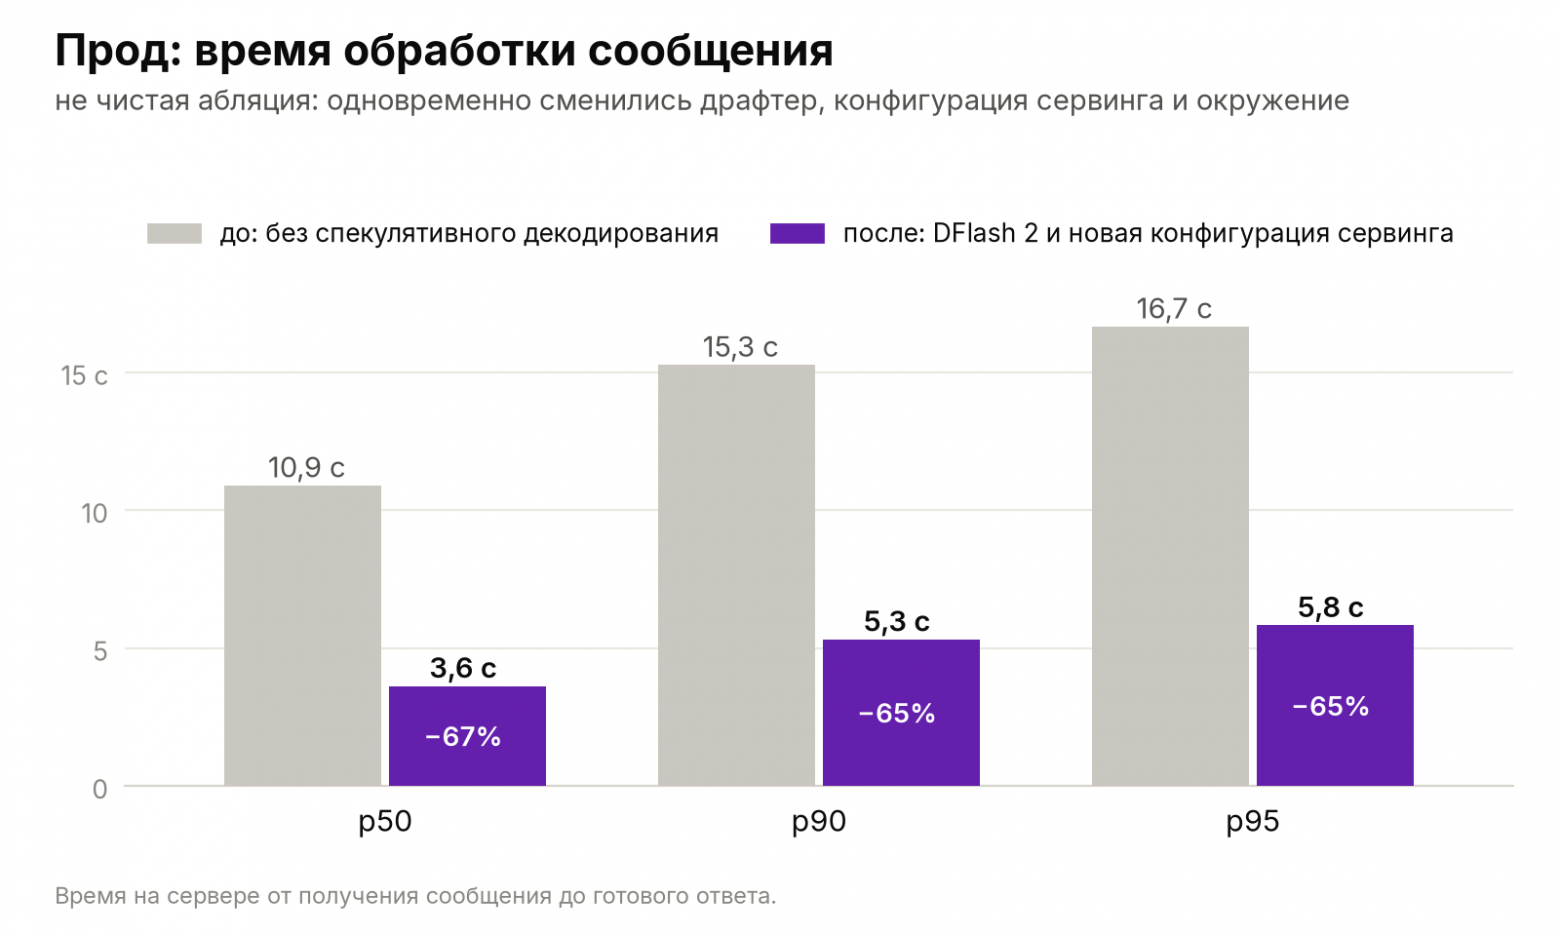
После перехода медиана времени обработки сообщения на сервере упала с 10,9 до 3,6 с, p90 — с 15,3 до 5,3 с, p95 — с 16,7 до 5,8 с.
Это не чистая абляция. Вместе с драфтером сменились конфигурация сервинга и окружение, а «до» и «после» сняты в разные периоды. Но трафик в оба периода был сопоставим, так что ускорение не объясняется тем, что запросов стало меньше. Вклад самого драфтера честнее оценивать по стенду. Там при той же конфигурации сервинга DFlash 2 ускоряет ход в 1,95–2,1 раза при малой нагрузке и в 1,4 раза при 128 пользователях.
А если своего драфтера нет
Обучать драфтер не обязательно: для популярных открытых моделей готовые уже выложены. Сколько они дают, мы проверили на открытой Qwen3.5-35B-A3B. Стенд, нагрузка и флаги vLLM те же, что в основном сравнении. Драфтеров два:
MTP-голова, которая идёт в комплекте с моделью,
 ;
публичный DFlash-драфтер от авторов метода, z-lab/Qwen3.5-35B-A3B-DFlash, , как у наших параллельных драфтеров (авторы рекомендуют
 ).
Модель мерили в двух вариантах: в bf16, как она выложена, и в FP8. Каждый драфтер работал на одной ноде рядом с той же моделью без драфтера, и ускорение считаем относительно неё.
MTP · FP8 | DFlash публичный · FP8 | MTP · bf16 | DFlash публичный · bf16 | |
|---|---|---|---|---|
K | 4 | 7 | 4 | 7 |
Ускорение хода, 1 польз. | ×1,67 | ×1,61 | ×1,68 | ×1,58 |
Ускорение хода, 4 польз. | ×2,00 | ×1,61 | ×1,56 | ×1,59 |
Ускорение хода, 16 польз. | ×1,46 | ×1,42 | ×1,28 | ×1,34 |
Ускорение хода, 128 польз. | ×1,34 | ×1,24 | ×1,25 | ×1,21 |
Ходов/с, 128 польз. | +32% | +20% | +19% | +21% |
τ, 1 польз. | 4,0 | 3,8 | 4,0 | 3,9 |
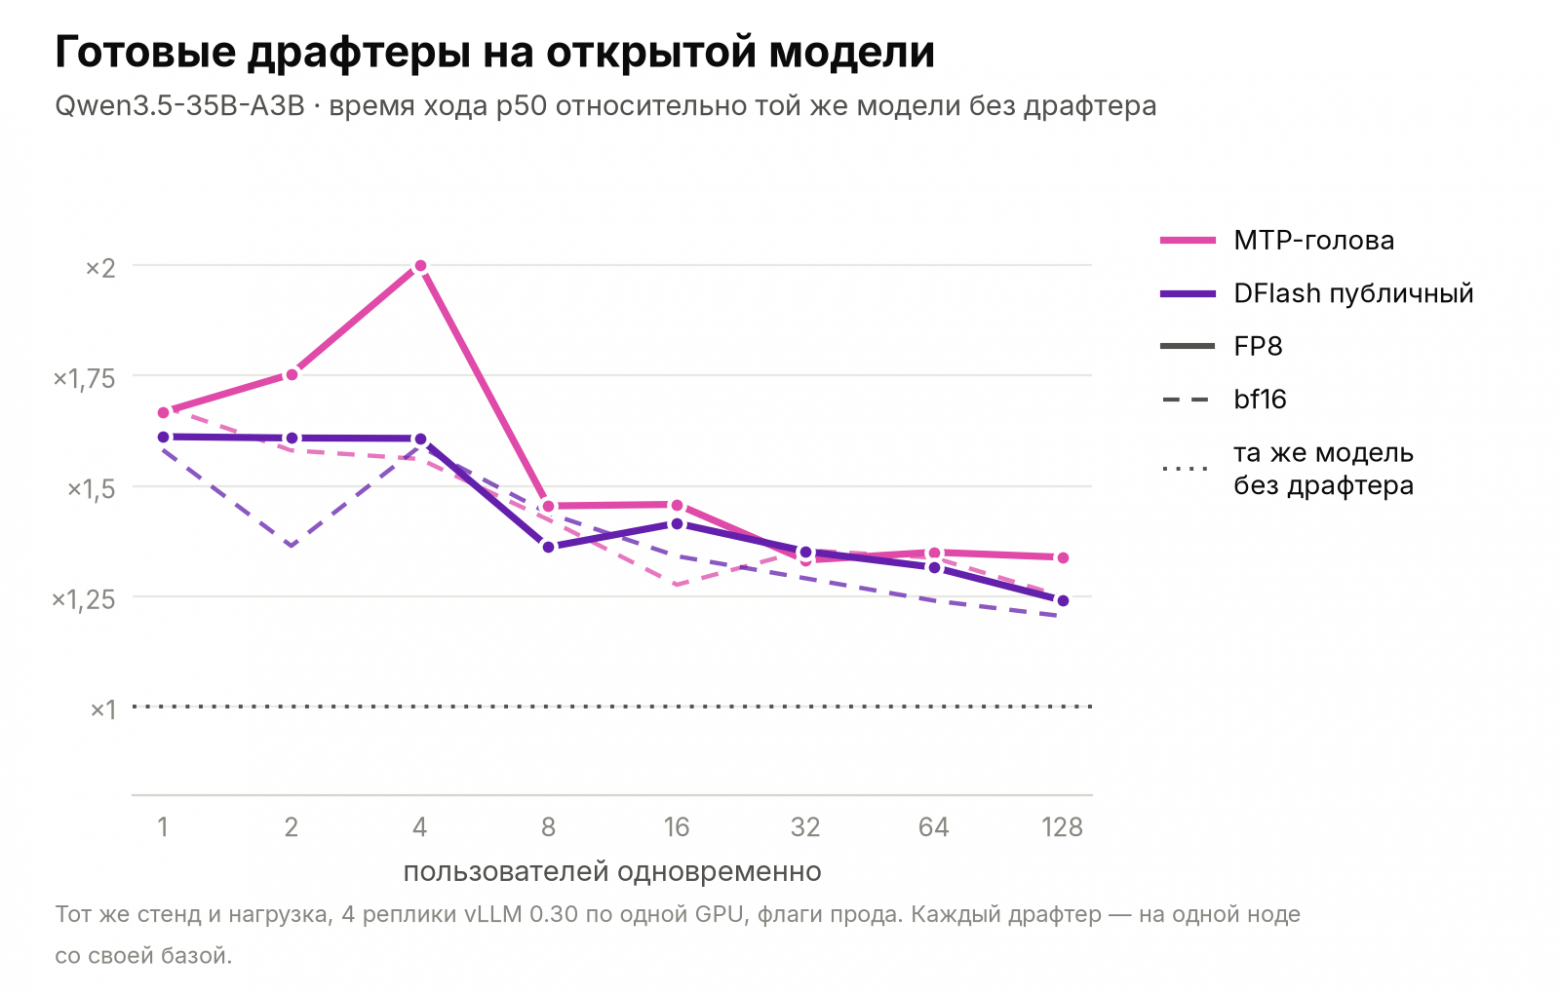
Без единого часа обучения ход ускоряется в 1,6–2 раза при малой нагрузке и в 1,2–1,3 раза при 128 пользователях, а пропускная способность растёт на 20–32%. MTP и DFlash между собой близки,  у обоих. В FP8 ускорение в среднем на 5–8% выше, чем в bf16, но это на грани шума замера.
Что мы вынесли
Мерьте время сценария под нагрузкой, а не токены в секунду на одном запросе. Порядок методов при 1 и при 128 пользователях разный, а выигрыш спекуляции под нагрузкой тает.
— ещё не скорость. Последовательный драфтер с тем же медленнее параллельного.
Проверяйте ответы, а не только скорость. Спекуляция в теории не меняет распределение ответов, а на практике её ломают баги движка. Мы бы не заметили порчу от n-gram, если бы не считали валидность JSON.
На гибридных моделях проверяйте, что поддерживается. У нас не заработали n-gram, suffix и адаптивная проверка DSpark.
Шум бывает до 9%. Без повторов часть выводов можно было бы сделать наоборот.
Данные не обязаны повторять прод один в один. Наш датасет — реальные сессии, прогнанные через стенд без персонализации, и по ответам он немного отличается от прода (AUC 0,62–0,69). Собрать точную копию продового трафика сложно: многое в проде персонализировано и быстро меняется, а контекст пользователя почти невозможно восстановить по историческим логам. Но если домен близок, драфтер всё равно выучивает распределение модели достаточно хорошо, и ускорение видно и в проде.
Авторы статьи
Матвей Сапрыкин (@Vtmpas), Данил Сморчков (@danilsmor), Александр Костылев(@al_kost), Юлия Иванова (@x_oncrix), Антон Тихонов (@itwastony), Антон Егоров (@trueanton1), Юрий Софронов (@YuriyYurievich), Адель Халилов (@adelkhalilov), Андрей Якубой (@FutynMaker), Игорь Богданов (@ievbogdanov), Мария Коршунова (@mmkorshunova), Михаил Алешин (@mikhailalesh), Дамир Чанышев (@Binar)
Ссылки
Stern, Shazeer, Uszkoreit. Blockwise Parallel Decoding for Deep Autoregressive Models, 2018
Leviathan, Kalman, Matias. Fast Inference from Transformers via Speculative Decoding, 2022
Chen et al. Accelerating Large Language Model Decoding with Speculative Sampling, 2023
Saxena. Prompt Lookup Decoding, 2023
Cai et al. Medusa, 2024
Gloeckle et al. Better & Faster Large Language Models via Multi-token Prediction, 2024
DeepSeek-AI. DeepSeek-V3 Technical Report, 2024
Oliaro et al. SuffixDecoding, 2024
Cai et al. FastMTP, 2025
Chen, Liang, Liu. DFlash: Block Diffusion for Flash Speculative Decoding, 2026
DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation, 2026
DFlash 2 и его описание в speculators, 2026
Yang, Kautz, Hatamizadeh. Gated Delta Networks, 2024
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.