איך מלמדים רכב אוטונומי להגיב לסכנה שהוא מעולם לא ראה?
מעגלת תינוק נטושה ועד משאית בזווית חריגה - מודלי AI ברכב האוטונומי מתקשים לזהות אובייקטים שהם מעולם לא פגשו, אבל שני פיתוחים ישראליים הצליחו לייצר עבורם "זיכרון חכם" ומגרש אימונים וירטואלי
מה עושים במקרים כל כך נדירים, שאי אפשר לצפות מראש ולהכניס אותם לאימונים? (צילום: Dreamstime)
מאת מיכאל בלטקסה, עודד ביאלר ודן לוי
דמיינו את הסיטואציה הבאה: כביש מהיר באמצע הלילה. הרכב האוטונומי נוסע חלק, המחשב מנטר עשרות מכוניות סביבו והכל עובד פיקס. פתאום, במרחק מאה מטרים, מופיע פרט לא שגרתי: עגלת תינוק ריקה שננטשה בצד הדרך. עבור העין האנושית, מספיק מבט מהיר כדי להבין מה אנחנו רואים ומהו המרחק מהעצם, ולהאט בהתאם. אבל עבור אלגוריתם AI – גם המתקדם ביותר – זו עלולה להיות חידה קשה לפיצוח, ובמקרה שלנו גם מאוד מסוכנת.
זהו אחד האתגרים הכי גדולים בעולם הרכב האוטונומי, והוא מכונה Long Tail – כל אותם תרחישי קצה נדירים שמודל ה-AI לא אומן עליהם, אבל חייב לפצח בזמן אמת כדי להציל חיים.
לאתגר הזה ישנם כמה פתרונות שנועדו לפתח מכוניות אוטונומיות חכמות ובטוחות יותר, שמסוגלות לנהוג בכל מצב ללא השגחה אנושית. אחד מהם הוא אימון מודלי AI באמצעות דאטה סינתטי שמדמה מצבי קצה נדירים ומסוכנים בכביש. פתרון נוסף הוא הטמעת מודלים מתקדמים המחברים בין וידאו, חיישנים וטקסט על מנת לזהות עצמים, לעזור לרכב להבין סיטואציות מורכבות ולהתכונן מראש לתרחישים בלתי צפויים. אבל מה עושים במקרים כל כך נדירים, שאי אפשר לצפות מראש ולהכניס אותם לאימונים?
גישת RAD: לשלוף דוגמאות בזמן אמת
אחד האתגרים הגדולים בראייה ממוחשבת הוא הערכה של עומק מתוך תמונה אחת בלבד. כלומר, הצורך להבין עד כמה אובייקט רחוק מהמצלמה מבלי להיעזר בחיישן עומק, ב-LiDAR (מדידת מרחק באמצעות לייזר) או בזוג מצלמות סטריאו. היכולת הזאת קריטית למערכות אוטונומיות, לרובוטים, ל-AR/VR ולכל מערכת שמנסה להבין את העולם הפיזי בזמן אמת.
המודלים האלה עובדים לא רע על אובייקטים "רגילים" שהם רואים שוב ושוב בזמן האימון, אבל הם מתקשים עם אובייקטים נדירים יותר – כמו נר, עגלה, קרון רכבת או משאית שעומדת בזווית לא שגרתית. זאת בדיוק בעיית ה-Long Tail: בעולם האמיתי, המון מקרים שהרכב חייב להכיר אינם מופיעים בדאטה כלל, או לא מספיק, ולכן המודל מתמודד איתם פחות טוב.
מאמר שכתבנו (מיכאל בלטקסה, דן לוי ושגיא בן נעים) והתקבל ל-CVPR Findings מציג גישה חדשה בשם Retrieval-Augmented Depth. הרעיון פשוט אך אפקטיבי: במקום להסתמך רק על מה שהרשת “זוכרת” מהאימון, בזמן הריצה אנחנו מאפשרים לה לחפש דוגמאות דומות מתוך מאגר קיים ולהשתמש בהן כרמז גיאומטרי נוסף.

שיפור של שערוך עומק באמצעות שימוש בדוגמאות רלוונטיות
מה שמיוחד בשיטה הזאת הוא לא רק החיפוש עצמו, אלא הדרך שבה בוחרים מה לחפש. RAD קודם מזהה אזורים בתמונה שבהם המודל לא בטוח בעצמו, ואז מתמקד בהם. לאחר מכן הוא מאתר תמונות עם תוכן דומה מבחינה סמנטית, ומעביר מהן מידע גיאומטרי רק בנקודות התאמה אמינות, באמצעות מנגנון שנקרא Matched Cross-Attention.
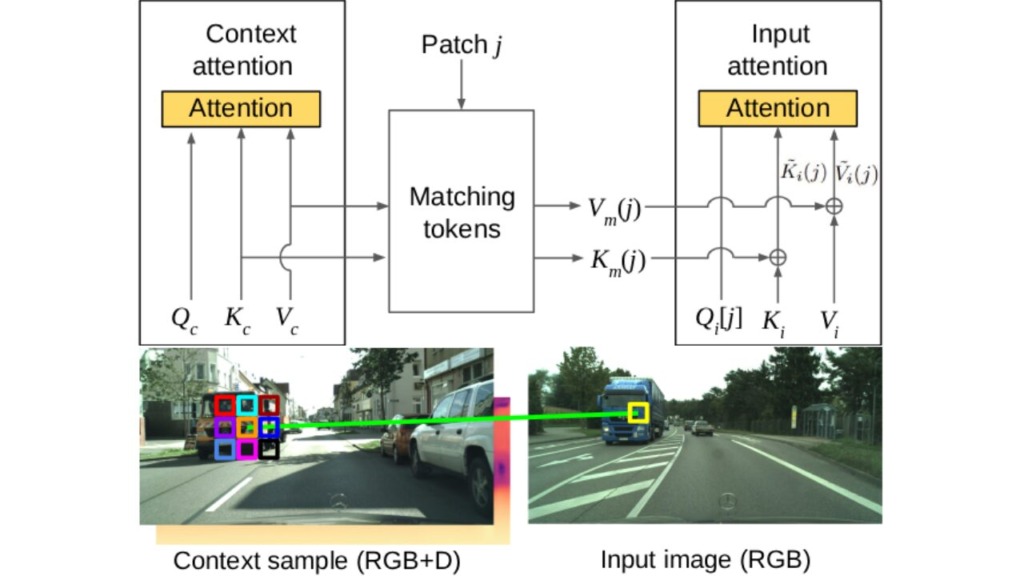
Matched Cross-Attention
ניתן לחשוב על זה כדרך "לשאול ניסיון" או ללמוד מדוגמאות אחרות. אם המודל נתקל באובייקט שהוא פחות מכיר, הוא לא צריך לנחש רק מתוך הייצוג הפנימי שלו; הוא יכול להיעזר בהקשר חיצוני שמזכיר לו איך אובייקט כזה נראה גיאומטרית. זוהי השראה ברורה משיטת RAG (Retrieval-Augmented Generation) המוכרת מ-LLMs, שבה מחברים את המודל למאגר מידע חיצוני, שולפים ממנו נתונים רלוונטיים בזמן אמת ומזינים אותם למודל כדי לייצר תשובות מדויקות, אמינות ומעודכנות בלי הצורך לאמן את המודל מחדש. ההבדל הוא שב-RAD לא שולפים טקסט, אלא רמזים ויזואליים וגיאומטריים.
התוצאות מרשימות: כאשר הצגנו למודל אובייקטים שהוא כמעט ולא פגש באימון – גישת RAD השיגה שיפור יחסי של 29.2% ב-AbsRel (המדד המרכזי בעולם הראייה הממוחשבת למדידת דיוק של עומק) על NYU Depth v2 (מאגר המציג סביבות פנים כמו בתים, משרדים וחדרים שצולמו במצלמות עומק). בנוסף, הוכחנו שיפור של 13.3% על KITTI – מאגר הנתונים המפורסם והחשוב ביותר לעולם הרכב האוטונומי, הכולל צילומי נסיעה ברחובות ובכבישים מהירים לצד נתוני LiDAR מדויקים.
לצד כל אלה, השגנו גם שיפור של 7.2% על Cityscapes – מאגר המבוסס על שיטוט עירוני בעשרות ערים באירופה, שנועד לבדיקת היכולת של המודל לנתח רחובות צפופים עם הולכי רגל, תמרורים ורכבים. השיטה שפיתחנו מצליחה להישאר מאוד תחרותית על כלל המחלקות, ולעתים משפרת את התוצאה מבלי לפגוע בביצועים על הדאטה "הרגיל". כל אחוזי השיפור שתיארנו כאן הם בהשוואה למודלי הייחוס המובילים בשוק שאינם מבוססי RAD.
כמובן, ישנן גם מגבלות. המערכת כבדה יותר מהמודל הבסיסי ודורשת זמן ריצה ארוך בשל תהליך החיפוש וההתאמה של אזורים דומים, ולכן כרגע היא פחות מתאימה ליישומי זמן אמת. בנוסף, היא תלויה במאגר קונטקסט עם אנוטציות עומק, ורגישה לטעויות בשלבי השליפה וההתאמה.
ובכל זאת, המסקנה ברורה: אם אנחנו רוצים שמערכות ראייה ממוחשבת יעבדו היטב בעולם האמיתי, לא מספיק לאמן אותן על הממוצע או התדיר – צריך לעזור להן להתמודד עם סיטואציות לא סטנדרטיות. גישת RAD מציעה כיוון אפקטיבי ומעשי, שמשלב בין כוחם של מודלי יסוד לבין היכולת לשלוף הקשר רלוונטי בדיוק ברגע שבו המודל הכי זקוק לו.
השלב הבא: איך אימון סינתטי פותר את המחסור בנתונים?
הערכת עומק היא רק חלק מהפאזל. כדי להבין את הסביבה, הרכב האוטונומי חייב קודם כל לדעת מה הוא רואה – לזהות מכוניות, הולכי רגל, אופניים ותמרורים, ולסמן אותם במדויק. מערכות לגילוי עצמים ברכב נדרשות לזהות מה מופיע בתמונה ולסמן כל עצם באמצעות מלבן תוחם. כדי לאמן מערכת כזאת נדרשות כמויות גדולות של תמונות מתויגות, אבל יצירת מאגרי מידע איכותיים היא תהליך יקר ואיטי, משום שכל תמונה דורשת תיוג מדויק.
אחת הדרכים להתמודד עם המחסור בנתונים היא להשתמש במודלים גנרטיביים, ובפרט במודלי דיפוזיה, כדי לייצר תמונות סינתטיות ולהוסיף אותן למאגר האימון. אבל כדי שתמונה סינתטית תהיה שימושית לאימון גלאי עצמים, לא מספיק שהיא תיראה מציאותית – יש צורך גם בתיוג מדויק המתאר את מיקום העצמים ואת הסיווג שלהם.
מול האתגר הזה עומדות שתי גישות עיקריות. בגישה הראשונה, מספקים למודל את מיקומי העצמים הרצויים מראש, ומבקשים ממנו ליצור תמונה שמתאימה להם. שיטה זו שומרת על התיוג המקורי, אך אינה מייצרת גיוון משמעותי בסידור העצמים. בנוסף, המודל עלול ליצור עצם שלא הוגדר בתיוג, או לא ליצור עצם שהיה אמור להופיע בו. בגישה השנייה, קודם יוצרים תמונה ורק לאחר מכן מפעילים עליה מערכת נוספת כדי להפיק את התיוג. בדרך זו מתקבלות תמונות מגוונות יותר, אך איכות התיוג תלויה ביכולת של המערכת לנתח את התמונה לאחר שנוצרה.
אף אחת מהגישות הקיימות אינה מושלמת, אז החלטנו לפתח אחת חדשה. מחקר שחשפו רועי עוזיאל ועודד ביאלר בכנס WACV 2026, מציג את שיטת JointDiffuse ליצירה משותפת של תמונות והתיוגים המתאימים להן בו-זמנית. במקום שהתמונה תיווצר תחילה והתיוג יתווסף מאוחר יותר, שני המרכיבים מתפתחים יחד לאורך כל תהליך הדיפוזיה ומשפיעים זה על זה. הרעיון דומה לשני שרטטים העובדים במקביל – אחד מצייר את הסצנה, והשני מסמן את העצמים. בכל שלב הם מעבירים מידע זה לזה, כך שאם מבנה הסצנה משתנה, גם התיוג יכול להשתנות בהתאם, ולהפך.
האיור הבא מתאר את השיטה: בחלקו העליון מופיע שלב האימון, ובחלקו התחתון – שלב יצירת התמונות. כדי לאפשר תהליך משותף של יצירת תמונות ותיוג, אנחנו ממירים את המלבנים התוחמים של העצמים לשתי מפות סגמנטציה שהן Pixel-aligned – כלומר, חופפות בדיוק פיקסל-מול-פיקסל לתמונה המקורית. מפה אחת מבדילה בין מופעים שונים של עצמים, והמפה השנייה מייצגת את סוג העצם – לדוגמה אדם, מכונית או אופניים. במהלך האימון מוסיפים רעש גם לתמונה וגם למפות הסגמנטציה. שני מנגנוני הסרת רעש מקושרים לומדים לשחזר אותן: מנגנון המבוסס על Stable Diffusion מטפל בתמונה, ומנגנון קטן יותר מטפל במפות התיוג. החלפת המידע ביניהם מאפשרת למבנה התמונה ולמבנה התיוג להתעדכן יחד.
בשלב היצירה מתחילים מרעש אקראי עבור התמונה ועבור התיוג. בתהליך הדרגתי, המודל מסיר את הרעש ומייצר סצנה חדשה, יחד עם מפות המתארות את העצמים שבה. לבסוף, רשת גילוי עצמים מתרגמת את מפות הסגמנטציה והתמונה למלבנים תוחמים. זוהי כבר משימה פשוטה יחסית, משום שהמפות מציינות היכן נמצאים העצמים.

תהליך האימון והיצירה המשותפת של תמונות ותיוג עצמים באמצעות JointDiffuse
לגישה זו יש שני יתרונות עיקריים:
- גיוון: המודל אינו כבול לסידור העצמים שהיה קיים במאגר המקורי, ולכן הוא יכול ליצור סצנות ומיקומים חדשים.
- התאמה טובה יותר בין התמונה לתיוג: מאחר ששניהם נוצרים יחד, קטן הסיכוי שיופיע עצם ללא תיוג או תיוג ללא עצם מתאים.
המודל נבחן על מאגר התמונות הכללי COCO ועל מאגר הנהיגה nuImages. כאשר התמונות והתיוגים שנוצרו באמצעות JointDiffuse נוספו לנתוני האימון האמיתיים, התקבל שיפור בביצועי גלאי העצמים – זאת בהשוואה לאימון על המידע האמיתי בלבד ולעומת שיטות יצירת מידע סינתטי אחרות.
האיור הבא מציג דוגמאות לתוצאות השיטה, ומשווה את התמונות המקוריות, הגישה הקיימת שמייצרת תמונות מותנות בתיוג (CondDiffuse), והגישה המוצעת שלנו (JointDiffuse):

השוואת תוצאות הממחישה את הגיוון ואת ההתאמה המשופרת בין העצמים לתיוגים בשיטת JointDiffuse בהשוואה לשיטות אחרות
החיבור בין היכולת להבין עומק של מקרי קצה נדירים לבין היכולת לייצר נתונים סינתטיים מדויקים הוא יותר משיפור אלגוריתמי זניח – זוהי תשובה ישירה לשתי הבעיות הכי קשות של הבינה המלאכותית בכביש: המחסור במידע איכותי והפחד מהתרחיש הבלתי צפוי. הפיתוחים שלנו מראים שלבעיית ה-Long Tail יש פתרון כפול: אנחנו לא רק מלמדים את הרכב כיצד להתמודד בזמן אמת עם האובייקט החריג הבא שהוא יפגוש בכביש, אלא גם יודעים לייצר עבורו מגרש אימונים וירטואלי מדויק. בסופו של דבר, שילוב של פתרונות פורצי דרך הוא מה שיאפשר למכוניות אוטונומיות לנסוע בצורה בטוחה, עצמאית וללא צורך בהשגחה אנושית.
הכותבים הם Senior AI/ML Engineer; מוביל צוות פיתוח בבינה מלאכותית ולמידת מכונה; ומוביל קבוצת ה-Foundational AI Research ב-General Motors ישראל
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.