Снижаем барьеры: переведённая книга за день — без видеокарты, почти без Python
Третья статья о Sunny Narrator — переводчике книг нейросетями «для себя». Первая была про прототип, который переводил тысячу страниц два дня. Вторая — про словари, скорости и то, почему переводчики всё ещё нужны. Эта — про то, что запустить перевод теперь может почти любой.
ОФФтопик : Мне тоже жаль что Хабр да и весь инет залит нейрослопом, сырыми ИИ-продуктами, да и вообще, мы не так что бы нужны. Это не реклама - если вам она кажется такой поставь минус и получи мое сердечко и пусть у тебя будет хороший день завтра.
Это статья для тех кому нужен перевод некоего художественного текста, либо для тех кто решил открыть для себя мировую литературу и не осилил другие языки как и я (посыпаю голову пеплом), но вот не смог.
Коротко: немного питона и 100 рублей денег на сервисы нейронок и полдня . Такова цена входа. Ну для тех кто любит пожестче я уже писал - там CUDA, сервера , claude\chatgpt и прочеее длиной в месяцы и годы. Поэтому статья разделилась на две части:
просто как запустить этот чудо-переводчик и получить перевод.
до (много) технических деталей по тому, как работают нейронки и как работают переводы. Если вам это не нужно, то вам это не нужно.
Скрытый текст
Корейскую мангу я проверял на Лунном Скульпторе. Английские книги я проверял на Питере Гамильтоне и Ниле Эшере. Также есть куча бесплатных книг. Книги, естественно, я все купил. Купил в основном в Австралии, потому что там дешевле электронные версии. Корейскую мангу в оригинале нейронка первые 15 глав украла, честно скажу, прям выдрала с корейского сайта написав хак (там можно только читать).
Я очень благодарен переводчикам издательства Фантастика, а также сообществу и Дмитрию Одинову за Лунный скульптор - ребята , кто участвовал вам огромное спасибо (58 книг, 10 лет)! Мое (IMHO) мнение - ушла эпоха.
Если у вас есть свой офигенный переводчик, ну пользуйтесь им, или можете потырить мой и назвать своим, счас иногда случается, но хватит тыкать везде ссылки). Кстати да, классных нейропереводчиков в целом много.Я пользуюсь своим потому что таков мой странный путь.
Первая часть - вам нужен перевод.
Раньше для перевода книги нужны были гараж, пара Tesla P40, Python и упрямство или другой нейропереводчик. Теперь достаточно:
уметь открыть консоль (или попросить об этом ИИ-агента);
положить на ProxyAPI пару сотен рублей (из-за границы — пару долларов на OpenRouter);
дать команду два раза.
Первый запуск собирает словарь имён и терминов книги, второй переводит её целиком. Через несколько часов у вас EPUB на русском, который можно читать. Не «можно продраться», а читать.
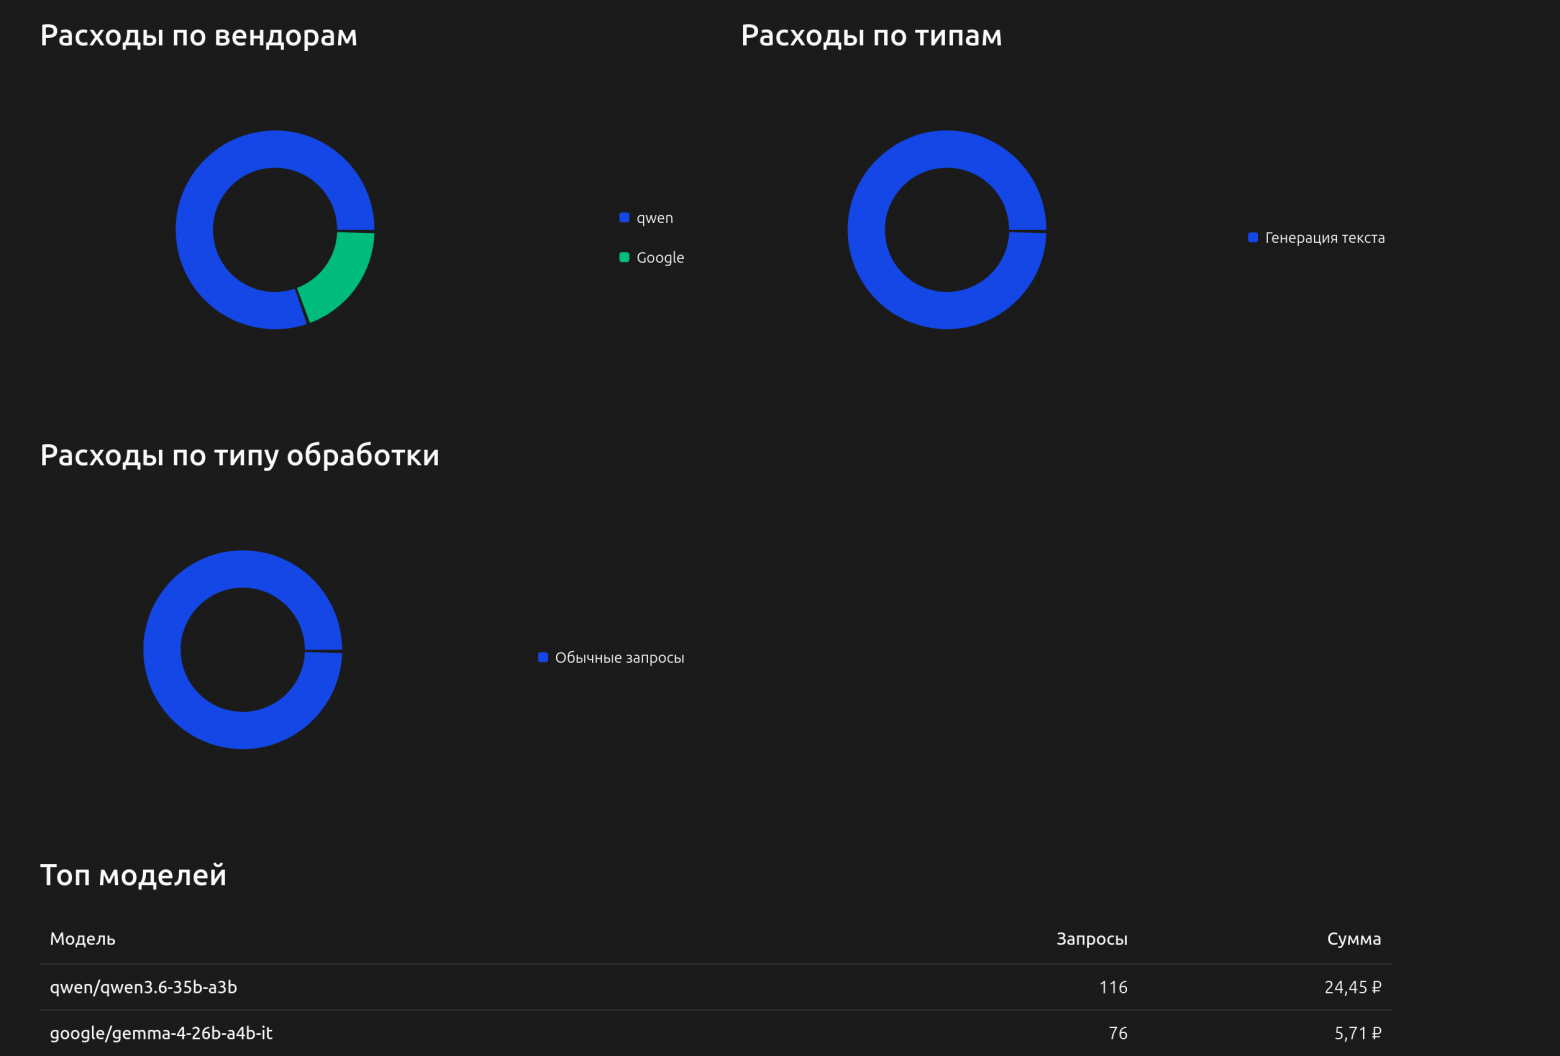
Словарь демо-сборника рассказов в облаке обошёлся в 13 копеек. Перевод всего сборника (~120 страниц) — 32 рубля и 41 минута.
Как запустить: четыре шага
Нужны Python 3.11+ и, для EPUB/DOCX/PDF, Calibre и pandoc. Видеокарта не нужна: модели работают в облаке. Для Windows \ Mac вам придется экстраполировать команды самому или прочитать еще дальше :
git clone https://github.com/NW15D/sunny-narrator && cd sunny-narrator
python3 -m venv .venv && source .venv/bin/activate
pip install -e .
sudo apt install calibre pandoc
Дальше:
Ключ. Регистрируетесь на ProxyAPI (из России, оплата в рублях) или OpenRouter (из-за границы), пополняете баланс.
Настройки.
cpenv.cloud.sample .env, вписываете ключ в две строки, путь к книге и языки. Для ProxyAPI раскомментируете блок в конце файла.Первый запуск — словарь.
pythonapp.pyнаходит в книге имена и термины, переводит их и останавливается: рядом с книгой появляетсяmybook_ru.dic. Его стоит просмотреть — переводы, категории, пол персонажей. Что книга не решает однозначно, перечислено вmybook.dictcheck.txt.Второй запуск — книга.
pythonapp.pyсам находит словарь и переводит. Результат —<название>_ru.epubрядом с исходником.
Модели те же, что у меня локально: Gemma 4 26B A4B переводит, Qwen 3.6 35B A3B вычитывает. Локально они крутятся в 4–5-битном квантовании (GGUF от Unsloth), в облаке — у провайдеров в своём, и перевод от этого не страдает.
Или не запускайте ничего сами
В репозитории есть AGENTS.md — инструкция для ИИ-агентов (Claude Code, Codex, Cursor и прочих). Агент прочитает её, спросит провайдера, книгу, языки и готовы ли вы платить, установит, настроит и запустит. Ключ вы вписываете сами: агентам ключи не показываем, это не паранойя, а гигиена.
Примерный промпт:
Склонируй github.com/NW15D/sunny-narrator, прочитай AGENTS.md, установи и запроси ключи для подключения , а затем запусти перевод books/mybook.epub с английского на русский через ProxyAPI.
Вторая, техническая часть , для тех кому надо знать как и почему:
Словарь — всё ещё 80% успеха (теперь его проверяет машина)
Во второй статье я писал, что словарь — это 80% успеха, а его чистка занимает часы. Часы никуда не делись, но теперь большую часть работы делает код, без LLM.
Словарь проверяется по книге перед каждым переводом. Категория записи — по меткам NER в упоминаниях (персонаж, место, организация). Пол персонажа — по местоимениям в предложениях, где упомянут только он. Решение принимается, если свидетельств больше трёх и 85% из них за одну сторону. Иначе запись уходит в отчёт с пометкой «не уверен». Модель здесь не участвует вообще: она уверенно ошибается, а нам нужно неуверенно, но правильно.
На словаре одной научно-фантастической серии (около 750 записей) проверка нашла:
4 персонажа, у которых пол в словаре противоречит книге;
28 записей, где категория под вопросом (NER любит записывать выдуманные имена в организации: робот с названием из одного слога для spaCy — явно ООО);
около 90 записей, которых в этой книге просто нет — нормально для словаря серии, где у каждого тома свои герои.
Словарь серии переносится на следующий том (app.py dict extend). Новые имена из нового тома добавляются, а дубли, формы уже известных слов и фразы, содержащие известный термин, отбрасываются. Пол новых персонажей — по книге. Старые строки не трогаются. На проверке: словарь из 35 записей + новая книга того же автора → 86 новых записей, 28 дублей отброшено, у 7 старых записей появился пол, 51 секунда.
У каждого языка свой словарь — книга_ru.dic, книга_fr.dic. Звучит очевидно, но до этого словарь назывался просто книга.dic, и в демо под этим именем лежал… французский словарь. Который радостно подхватывался при переводе на русский. Нашёл это, конечно, не я.
Ещё команды: dict clean (дубли, обычные слова, обрезанные варианты), dict review (проверка по книге без перевода), dict convert (словарь на другие языки), audit (проверка готовой книги), eval (A/B промптов на отрывках).
Пол персонажей: самая заметная боль
Читатель ( а это в основном я ) простит кривой оборот. Не простит «Алиса сказал» на каждой второй странице. Маленькие модели путают пол постоянно: английский текст его почти не показывает, а русский требует на каждом глаголе.
Что сделано:
Пол из словаря доходит до каждой стадии отдельным блоком, написанным так, как это видно в языке перевода: «Алиса — она (сказала)». Раньше пол был третьим полем в строке словаря, и редактор его вообще не видел.
Синопсис может дополнить пол, но только если два чанка подряд согласны. Один раз ошиблась — не страшно, ошибка не размножится на всю книгу.
Стадия GENDER. После перевода spaCy-модель языка перевода разбирает предложения и ищет, где персонаж из словаря — подлежащее, а сказуемое другого рода. Только такие предложения уходят в LLM с просьбой поправить. Модель исправляет не всё подряд, а то, что ей показали.
По книге: 10 найденных ошибок пола, 9 исправлено на роман в 800 тыс. знаков. Десятая — обычно случай, где разбор предложения запутался (об этом ниже).
47:23,646 - INFO - [synopsis] Dictionary candidates reported: 4
47:23,653 - INFO - Dictionary: added Jan = Ян, PERSON
47:39,487 - INFO - [synopsis] Dictionary candidates reported: 3
47:39,488 - INFO - [gender] Jan = he: from the synopsis (2 chunks agree)
47:39,493 - INFO - Dictionary: added Lina = Лина, PERSON
47:39,494 - INFO - [gender] Valeris = she: from the synopsis (2 chunks agree)
48:17,106 - WARNING - [final_edit] foreign words (other alphabet): B, Kingdrom, Hyteriax
48:17,565 - INFO - Translation successful (tokens: 25,966, total: 1,163,001)
48:50,247 - INFO - [synopsis] Dictionary candidates reported: 6
48:50,248 - INFO - Dictionary: ordinary words not added as terms: ['carroñeros']
49:08,266 - INFO - Translation successful (tokens: 14,166, total: 1,177,167)
49:53,561 - INFO - [synopsis] Dictionary candidates reported: 5
49:53,561 - INFO - Dictionary: ordinary words not added as terms: ['armadillo']
50:45,202 - INFO - Translation successful (tokens: 25,553, total: 1,202,720)
Без LLM, но с подвохами. Первая версия проверки выдала 7 ложных срабатываний из 24: парсер принял заголовок главы «### Мария» за подлежащее следующего абзаца («Петров пришёл») и решил, что «Мария пришёл». Теперь текст разбирается по блокам, а имя считается только в именительном падеже.
Статистика: что показывают прогоны
Все цифры — на одном и том же романе (~805 тыс. знаков, около 450 страниц), локально, до и после правок этих двух месяцев:
Прогон 1 | Прогон 2 | |
|---|---|---|
Записей в словаре серии | 685 | 753 |
Токенов на книгу | 3,23 млн | 2,97 млн |
Время | 7 ч 02 мин | 5 ч 10 мин |
Ошибки пола: найдено / исправлено | 10 / 0 | 10 / 9 |
Слова в двух алфавитах | 1 | 10 |
Чанков, разбитых пополам | 24 | 32 |
Да, во втором прогоне слов-«кентавров» стало больше. Это не регресс, это недетерминированность: те же модели, почти те же промпты, другой результат. Об этом следующий раздел.
Самое большое улучшение пришло после второго прогона: стадия REFLECTION (модель-корректор ищет ошибки перевода) зацикливалась. Её попросили «проверить словарь», и она добросовестно перечисляла каждый термин с пометкой «здесь всё верно». Потом перечисляла ещё раз. Однажды она написала 15 841 символ рассуждений о том, как правильно транслитерировать одно имя. Как я её понимаю.
Облако на демо-сборнике рассказов (206 тыс. знаков текста, 36 чанков, ProxyAPI, Gemma 4 переводит, Qwen 3.6 вычитывает, два чанка в работе одновременно):
Облако | |
|---|---|
Время | 41 минута |
Токенов | 748 тыс. (534 тыс. на вход, 236 тыс. на выход) — ~3,6 на знак |
Стоимость | 31 ₽ перевод + 0,13 ₽ словарь |
Ошибки пола | 0 найдено |
Пол дописан синопсисом | 7 персонажей (два чанка подряд согласились) |
Чанков переведено повторно | 1 |
Слова в двух алфавитах | 13 — все в одном чанке (о них ниже) |
Готовый EPUB | валидация без ошибок |
Куда уходят токены и время по стадиям:
Стадия | Модель | Вход | Выход | Время |
|---|---|---|---|---|
Перевод (INITIAL) | Gemma 4 | 80 тыс. | 71 тыс. | 15 мин |
Синопсис | Gemma 4 | 146 тыс. | 6 тыс. | 2 мин |
Поиск ошибок (REFLECTION) | Qwen 3.6 | 143 тыс. | 23 тыс. | 5 мин |
Исправление (IMPROVE) | Qwen 3.6 | 92 тыс. | 68 тыс. | 18 мин |
Редактура (FINAL_EDIT) | Qwen 3.6 | 73 тыс. | 67 тыс. | 13 мин |
Видно, что синопсис почти ничего не пишет, но много читает (ему нужен контекст), а три стадии вычитки стоят больше самого перевода. Если нужен быстрый черновик, FAST_TRANS=true выкидывает именно их.
На роман в 800 тыс. знаков это масштабируется примерно в 125 ₽ и 2,5–3 часа. Локальный прогон того же романа на паре P40 занимает 5 часов — облако быстрее, потому что провайдер обслуживает обе модели одновременно.
Статистика прогонов. Одна книга Форстера (231 тыс. символов) переведена на семь языков — французский, испанский, польский, португальский, русский, турецкий и китайский: 33–64 минуты на язык, ноль упавших чанков, род в финале чистый везде (польский — 1 ошибка найдена и исправлена). Отдельно прогнана корейская веб-новелла (20 глав) на английский: 50 минут, текст ×1,96 к источнику, без единой дыры. Все EPUB, словари и полные логи лежат в репозитории — books/samples/, цифры и методика — в docs/LANGUAGES.md: каждый результат можно сверить с логом и прочитать перевод самому.
Что всё ещё ломается
Нейросети недетерминированы, и честнее это показать, чем спрятать.
Слова-кентавры. dошло, Gород, taкого — модель начинает слово латиницей и заканчивает кириллицей.
Облачный прогон дал 13 таких слов, и все в одном чанке: dверей, dень, tихие, gромкий, cветок. Я посмотрел на сырые ответы модели, и картина сложилась: каждый кентавр стоял сразу после переноса строки. pandoc при конвертации EPUB переносил строки каждые 72 символа, внутри JSON перенос превращается в \n, а у токенизатора Qwen есть токены nd, nt, ng — частые английские пары. Модель пишет \ + nd + верей, и получается «dверей». То есть кентавров мы подсовывали модели сами. Теперь абзац передаётся одной строкой, без переносов. [РЕЗУЛЬТАТ повторного прогона.]
Вторая причина нашлась раньше и тоже забавная: сервер llama.cpp для Qwen по умолчанию штрафует за повтор только что написанных токенов (presence_penalty 1.5). Стадии, которая переписывает текст, нужно повторить слово «сприна» — а за только что написанные токены штраф, вот она и пишет «спринa» с латинской «a». Теперь штраф явно выставляется для каждой стадии. Слова-кентавры всё ещё появляются, их находит и пишет в отчёт код, но не исправляет: автозамену букв я пробовал, она тихо портила нормальные слова. Лучше честный список, чем незаметная порча.
Пол в сложных сценах. В диалоге двоих «она» рядом с мужским именем часто относится к собеседнице. Проверка по местоимениям в таких сценах сомневается и пол не ставит — это правильно, но кто-то должен решить руками.
Говорящие имена и придуманные слова. Модель по-прежнему предпочитает транслитерировать, а не придумывать. «Уткотрёп» из прошлой статьи она сама не изобретёт — его нужно положить в словарь.
Длина. Модель иногда «съедает» абзац или пересказывает вместо перевода. Чанк, длина которого сильно расходится с ожидаемой, режется пополам и переводится заново. Такие события есть в каждом прогоне (24–32 на роман), и это нормально.
Вычитка нужна. Это всё ещё черновик высокой готовности. Но читаемый.
Чего не стоит бояться в логе
Когда вы запустите перевод, лог будет выглядеть тревожно. Вот реальный фрагмент облачного прогона демо-сборника (сокращён):
INFO  - Dictionary: added Happy Isles = Счастливые острова, TERM
INFO  - [improve_translation] words in two alphabets: dверей, dень, camеры, dержала, gромкий, tихие, cветок …
INFO  - [final_edit] words in two alphabets: dверей, dдень, camеры, dержала, gромкий, tихие, cветок …
WARNING - Words in two alphabets: dверей, dдень, camеры, dержала, gромкий, tихие, cветок …
Progress: 14/36 (38.9%)
INFO  - [gender] Janet = she: from the synopsis (2 chunks agree)
Progress: 17/36 (47.2%)
INFO  - [improve_translation] words in two alphabets: nравнина, nвыглядывали, nчто, nвероятно, nтебе …
ERROR - ⚠ SPLIT [FINAL] 8224 → 1552 chars (×0.19, expected ×0.99, 81.0% off) - rechunking needed
ERROR - RECHUNK #1 at depth 0: 81.0% length difference
Разберём по строкам.
Dictionary: added …— хорошая новость. Синопсис нашёл в тексте новое название, которого не было в словаре, и следующие чанки уже переводят его одинаково.[gender] Janet = she: from the synopsis (2 chunks agree)— тоже хорошая. У персонажа не было пола в словаре, два чанка подряд согласились, что это «она», и дальше модель будет писать «Джанет сказала», а не гадать.ERROR … SPLIT … RECHUNK— выглядит страшно, но это штатная работа. Модель вернула обрубок: 1552 символа вместо ~8200. Программа это заметила, разрезала чанк пополам и перевела каждую половину заново. Такое бывает на каждой книге — 24–32 раза на роман, — и в готовый текст обрубок не попадает.words in two alphabets— слова-кентавры (dверей,gромкий). СтрокиINFO— это промежуточные стадии: следующая стадия часто их чинит. СтрокаWARNING— то, что дошло до книги. Эти слова попадут в отчёт в конце прогона, и их стоит поправить руками поиском по книге. Читать с ними можно: глаз спотыкается, но смысл не теряется.
Что не исправляется автоматически и требует рук:
кентавры, дошедшие до
WARNING(список — в отчёте);пол, который иногда «плывёт» в сценах, где говорят двое, — в отчёте есть раздел «перевод расходится со словарём», с него и стоит начать вычитку;
имена, которых не было в словаре, — модель могла назвать их по-разному в разных главах.
Нейросети делают это не идеально, и чудес не обещаю. Но разница между «книгу невозможно читать» и «в книге десяток опечаток» — это и есть то, ради чего всё затевалось.
Сколько здесь нейронки (спойлер: почти всё)
Проект начинался в мае 2024-го как способ разобраться в двух вещах: как работают нейросети и как программировать на Python.
Цифры из git:
602 коммита за всё время;
390 из них сделал «Dev Agent» — тут я учился сначала через Antigravity , а потом с openclaw (qwen\deepseek), весна 2026-го;
со второй статьи — 126 коммитов, 110 из них написаны вместе с Claude;
в октябре 71 из 79 коммитов — с Claude - кто пользуется все понимает, добро пожаловать и я рад что в клубе.) ;
код: +8,8 тыс. / −4,4 тыс. строк, тесты: +8,5 тыс. строк, тестов стало в 2,1 раза больше (382 → 821).
Как выглядит работа сейчас: я описываю задачу, Claude читает код, предлагает план, я спорю, он делает, гоняет тесты, проверяет на живых моделях и пишет коммит. Половину багов из прошлого раздела он нашёл сам, ставя программу на чистую машину. Французский словарь в русском переводе — тоже он.
Итог эксперимента «выучить нейросети и Python»: нейросети я теперь понимаю — знаю, почему они зацикливаются, зачем им штраф за повторы и чем Q4 отличается от fp8. Они крутятся у меня дома. А Python… Python я, боюсь, уже не выучу. Зачем, если за меня его пишет нейросеть, которую я теперь понимаю.
Сколько стоит
На что тратим | Сумма |
|---|---|
Словарь демо-сборника (облако, ProxyAPI) | 0,13 ₽ |
Перевод демо-сборника (~120 страниц, 41 минута) | 32 ₽ |
Роман на 450 страниц (по цене сборника) | ~80 ₽ / ~$1 |
Что дальше
Сайт обмена словарями (анонсирован во второй статье) — как будто уже и не нужен , сообщества сделают сами если вообще им это надо .
Сравнение облака и локальных моделей на одних и тех же отрывках:
app.pyeval --compareуже умеет, осталось набрать статистику.Если вы запустите перевод — расскажите, что получилось: в репозитории есть шаблон «Translation report» и CONTRIBUTING.md на русском. Особенно нужны носители польского, украинского, турецкого, португальского — проверить согласование рода на демо-переводах. Полчаса чтения — уже вклад.
И да: если хотите перевести книгу из общественного достояния, но не хотите ничего ставить, напишите в issue. Переведу и выложу результат с отчётом.
Переводчики по-прежнему нужны и важны. Особенно хорошие. Но книгу «для себя» теперь можно получить к вечеру.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.