Как мы построили Network Load Balancer в MWS Cloud Platform
Всем привет, меня зовут Вадим Лазук, я разработчик в команде VPC облака MWS Cloud Platform. Пару месяцев назад мы запустили в Preview сервис Network Load Balancer, а в этой статье решили рассказать о нём подробнее. Сегодня рассмотрим, как устроен балансировщик в нашем облаке, на какой архитектуре он базируется и какие технологии использует под капотом.
Зачем вообще нужен балансировщик
Допустим, у вас есть сервис, развёрнутый на какой-нибудь виртуальной машине в облаке. У сервиса есть пользователи где-то в интернете. Пока пользователей мало, всё работает нормально. Со временем пользователей становится больше и больше — вы увеличиваете ресурсы своей виртуальной машины, но не можете делать это бесконечно.
Плюс ко всему вы понимаете, что если с вашей единственной виртуальной машиной что-то случится, то сервис попросту перестанет работать. Всё это естественным образом приводит вас к решению: поднять несколько виртуальных машин с одним и тем же сервисом, а перед ними поставить балансировщик, который бы принимал весь трафик на один адрес, равномерно распределял нагрузку между ВМ, умел определять, какая ВМ вышла из строя, и исключать её из трафика, пока она не поднимется. Это минимальный набор функций для любого балансировщика.
Можно выделить два вида балансировщиков: Application Load Balancer (ALB) и Network Load Balancer (NLB).
Application Load Balancer работает на 7-м уровне OSI на уровне приложения: видит HTTP/HTTPS (и надстройки — gRPC, WebSocket), принимает решения, что и куда балансировать по содержимому запроса.
Network Load Balancer работает на 4-м уровне: TCP/UDP. Имеет сильные ограничения по анализу содержимого пакета, зато поддерживает любой протокол поверх TCP/UDP и работает значительно быстрее ALB.
В нашей статье мы будем говорить только о NLB.
Возможные архитектуры NLB
Для реализации NLB можно выделить две основные архитектуры: Proxy и Passthrough. Давайте подробнее рассмотрим каждую.
Proxy NLB
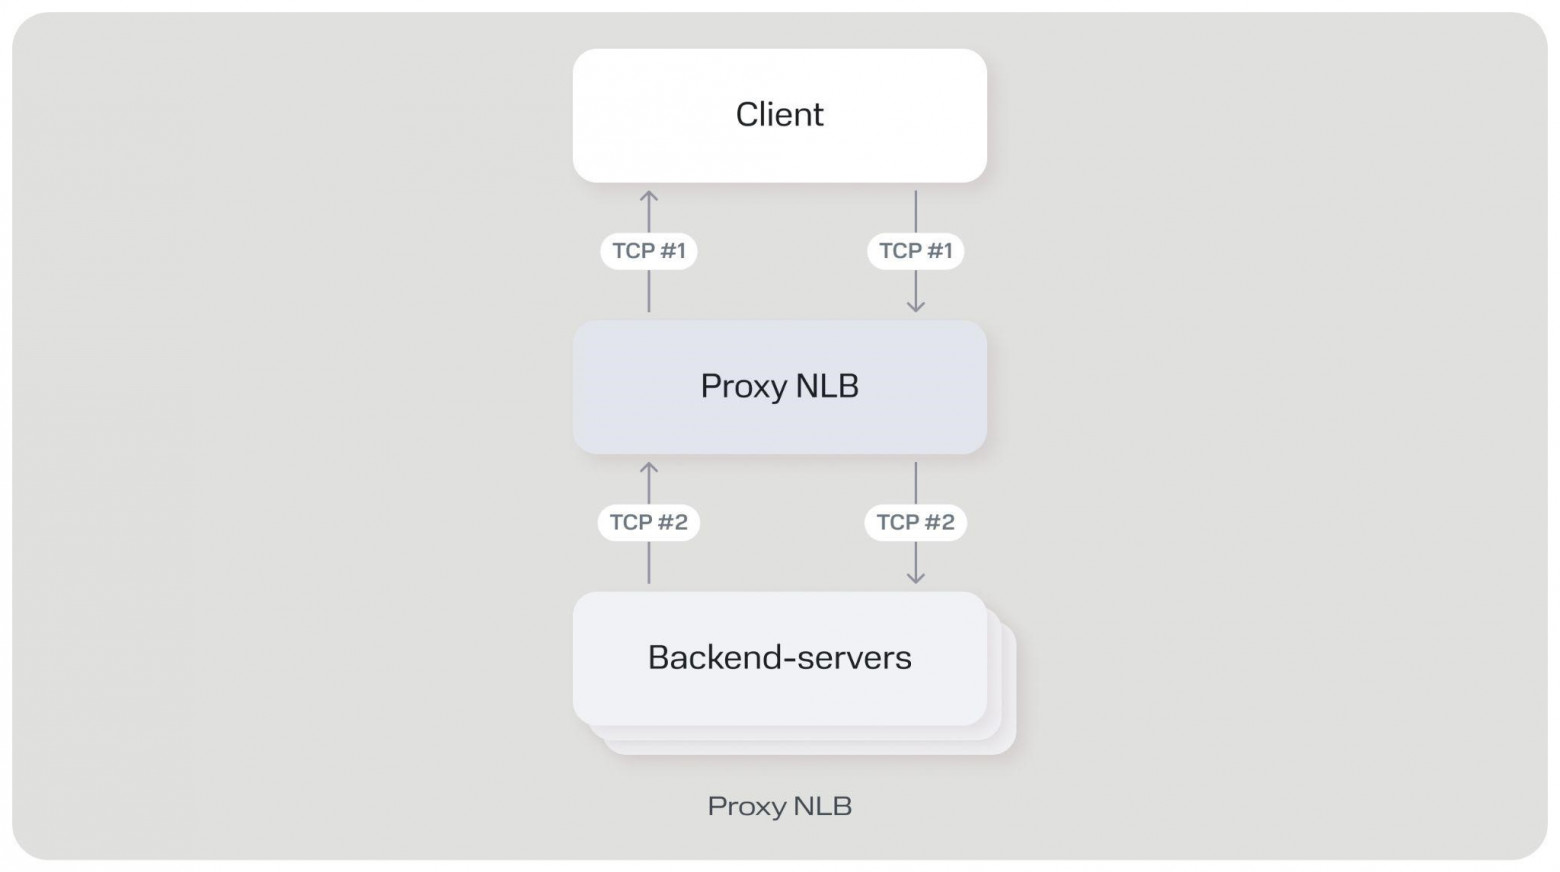
Proxy NLB терминирует TCP-соединение с клиентом и устанавливает новое с бэкенд-серверами.
Плюсы
— SSL-терминация: TLS заканчивается на балансировщике, все сертификаты в одном месте, TLS-CPU не касается бэкенд-серверов.
— Полный контроль над сессиями пользователей.
— Может стать основой для Application Load Balancer.
Минусы
— Производительность: каждый байт проходит через балансировщик дважды — и входящий, и исходящий трафик. Для тяжёлых ответов (видео, стриминг, репликация БД) такой NLB становится узким местом.
— Теряется клиентский IP (решается через PROXY protocol v1/v2).
— Отказ ноды NLB рвёт соединения безвозвратно. TCP-состояние живёт на ноде, и если она вышла из строя, то другая нода не может «подхватить» установленную сессию.
Примеры таких NLB: HAProxy (mode tcp), nginx (stream-модуль), Envoy (TCP proxy), AWS Classic LB.
Passthrough NLB
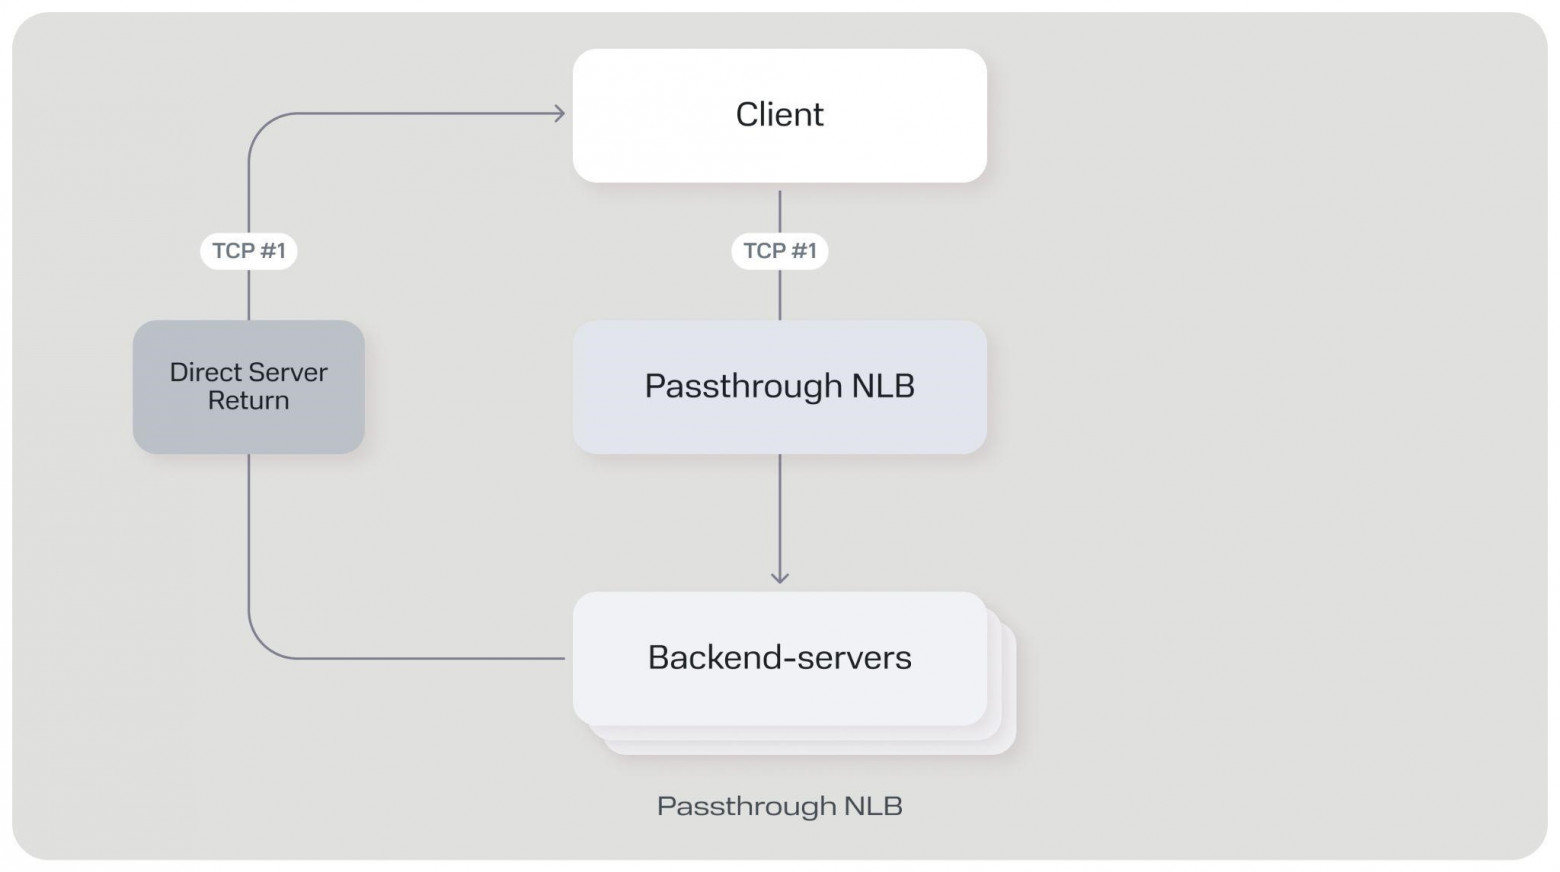
Passthrough NLB не терминирует TCP-соединение, а перенаправляет пакеты на бэкенд сервера, и TCP-сессия клиента фактически устанавливается с бэкенд-серверами напрямую. В дополнение к этому добавим Direct Server Return — это когда обратные пакеты не проходят через NLB, а идут напрямую клиенту.
Плюсы
— Производительность: нет терминирования, нет второго соединения, нет лишних сетевых хопов — задержки и пропускная способность почти равны прямому соединению.
— Клиентский IP сохраняется нативно, отказ NLB ноды переживается перекодированием, подхватить трафик может любая другая.
— Direct Server Return — ответ идёт в обход балансировщика, очень важно для асимметричного трафика, где ответ в разы тяжелее запроса.
Минусы
— Никакого контроля за сессиями пользователей, SSL-терминация невозможна.
— Нельзя использовать как базу для ALB.
Примеры таких NLB: LVS/IPVS во всех режимах, AWS NLB, Google Maglev, Yandex NLB (VPP DNAT), Katran, Azure SLB.
Можно заметить, что в общем виде плюсы и минусы для двух видов зеркальные: всё, что Proxy контролирует, Passthrough не видит, и всё, что Passthrough пробрасывает насквозь, Proxy вынужден обрабатывать сам. Также отметим, что мы рассмотрели «классический» Proxy и Passthrough — между ними есть переходные формы, где та или иная архитектура заимствует какие-то части другой.
Что выбрали мы
Поскольку Passthrough NLB обладают в разы большей пропускной способностью, чем Proxy, и все крупные провайдеры (Google Maglev, Azure, Ananta) для своих L4-балансировщиков используют именно такую архитектуру, мы также решили выбрать именно Passthrough. А фичи, которые нельзя реализовать на Passthrough, например SSL-терминация, перенесём в отдельный ALB.
Из чего состоит NLB
Теперь давайте немного познакомимся с тем, из чего обычно состоит балансировщик:
VIP (Virtual IP) — адрес балансировщика, с которым будут взаимодействовать пользователи.
Real servers — бэкенд-сервера, на которые балансировщик будет перенаправлять трафик.
Rules — правила балансировки, где задано, какой трафик и куда перенаправлять, например, если запрос приходит на адрес балансировщика по протоколу TCP на 443-й порт, то такой трафик нужно направлять на бэкенд-серверы на порт 8080. А если трафик приходит по протоколу UDP на порт 80, то перенаправлять его нужно на бэкенд-серверы на порт 8080.
Health check — правила проверки работоспособности бэкенд-серверов: по какому протоколу делать опрос, например, TCP, с какой частотой делать опрос, например, каждую секунду, какое количество подряд идущих проверок должно быть неуспешным, чтобы признать бэкенд-сервер неработоспособным и прочее.
Фундамент: VPP и Maglev
Прежде чем разбирать, как конкретно работает наш NLB, как пакеты доходят от клиентов до бэкенд-серверов и обратно, давайте рассмотрим фундамент нашей сети.
VPP: Vector Packet Processor
Внутренняя инфраструктура облака состоит из вычислительных compute-хостов и пограничных border-хостов, которые выполняют разные роли в обработке сетевого трафика. Виртуальные машины запускаются на compute-хостах.
Border-хосты предназначены для обработки трафика, направленного из интернета к виртуальным машинам и обратно. На каждом compute и border-хосте работает
VPP (Vector Packet Processor) — он выступает в роли Data Plane, то есть обрабатывает (и перенаправляет куда надо) все пакеты, которые поступают на хост.
На VPP реализована куча сетевых функций: NAT, фаерволы, хитрый роутинг и многое другое — целая вселенная сетевых штук. Про то, почему у нас выбран именно VPP и почему он невероятно крут, у нас есть отдельный шестой эпизод реалити «Создавая облако» — очень рекомендую. Также у нас уже есть отличная статья о том, как устроен наш сетевой dataplane.
Для нас сейчас важно другое: VPP построен на модульной архитектуре с использованием системы плагинов. Можно написать свой плагин и встроиться в обработку сетевого пакета. Также у VPP есть ряд готовых плагинов, среди которых есть Load Balancer Plugin.
В описании плагина есть пункт, что он «вдохновлён Google Maglev» — звучит многообещающе :) Сразу признаемся, что этот плагин и будет основой нашего NLB в MWS Cloud. Но перед тем, как мы перейдём к нашему NLB, давайте рассмотрим основные принципы работы Google Maglev, потому что наш NLB их унаследует.
Google Maglev
Много лет назад Google опубликовал ряд документов, описывающих свой сетевой стек Andromeda — он используется и для обработки трафика Google-сервисов, и для GCP. Одна из частей этого стека — Maglev, программный сетевой балансировщик.
Перед собой Google поставил следующие требования к своему NLB:
— Программный: работает на commodity-железе, любой сервер с Linux, никакого железного балансера.
— Супергоризонтально масштабируемый: Google — это всемирный масштаб.
— Direct Server Return: при таких объёмах гнать трафик через лишнюю машину никому не хорошо.
— Максимальная производительность: десятки, а то и до сотни гигабит в секунду на каждую Maglev-машину.
Как устроен Maglev изнутри:
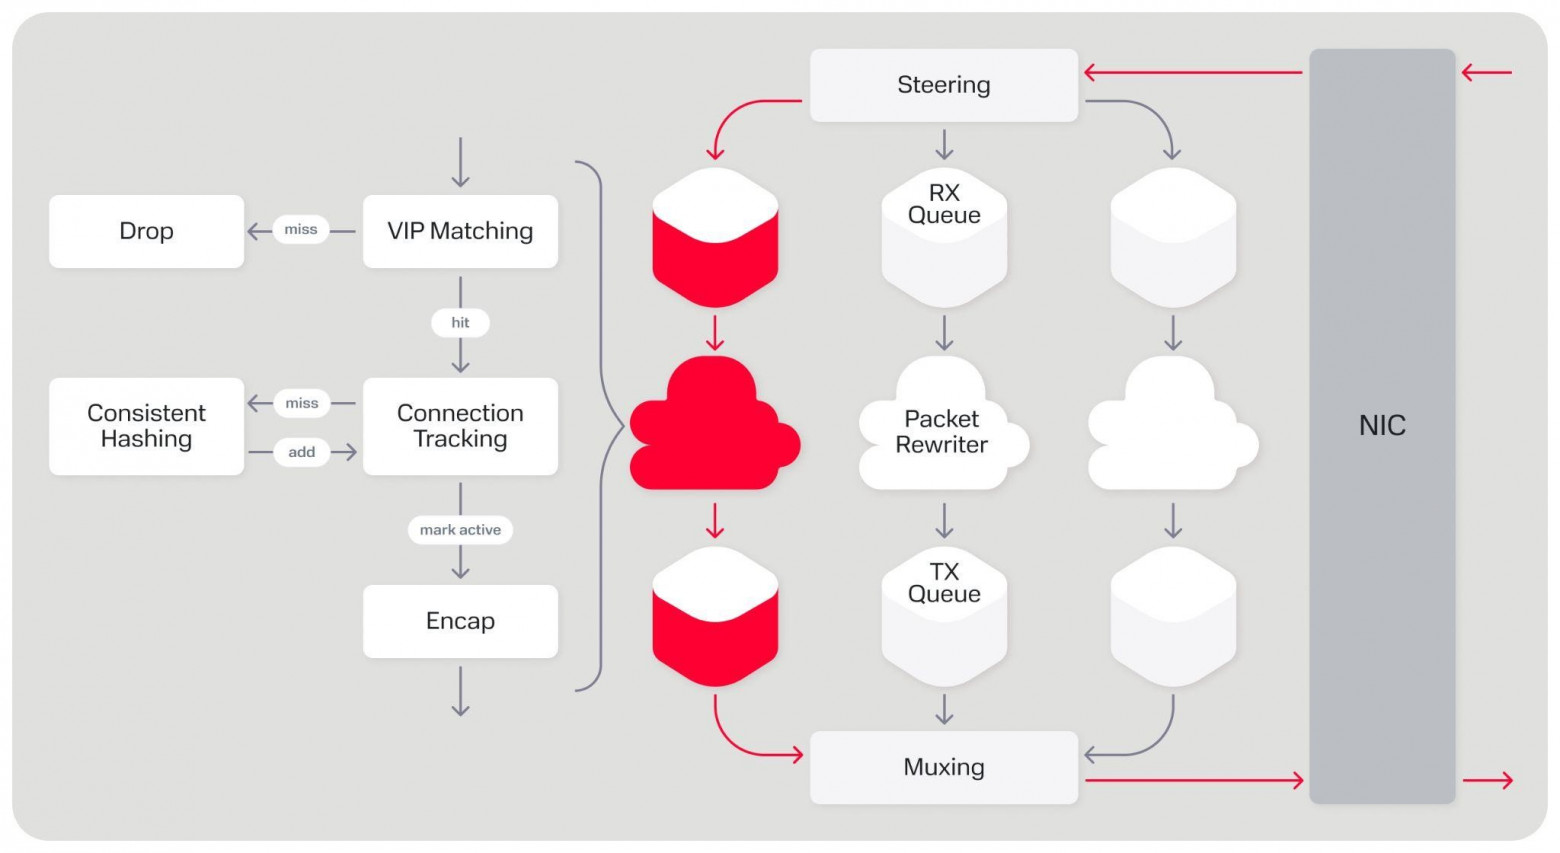
1. Пакет приходит на сетевую карту Maglev-машины.
2. Сначала проверяется VIP — Virtual IP. Каждая Maglev-машина объявляет адрес, по которому к ней можно достучаться. Если Maglev-машина не нашла VIP — пакет просто терминируется.
3. Дальше предполагаем, что пакет, возможно, уже принадлежит сессии, которую мы когда-то направили на конкретный бэкенд-сервер. Хочется, чтобы даже в случае, если в экосистеме что-то поменялось, пакеты одной сессии продолжали идти на тот же бэкенд-сервер. Для этого есть connection tracking table — таблица, где хранится привязка сессий к бэкендам. Идентификатор сессии считается как хэш от пяти полей TCP-заголовка: source IP, source port, destination IP, destination port, protocol. Это называется 5-tuple hash.
4. Если по 5-tuple в connection tracking table уже есть запись — отлично, мы знаем, куда отправлять пакет.
5. Если записи в connection tracking table нет — нужно выбрать бэкенд-сервер. Тут вступает в игру consistent hashing. Главная задача consistent hashing — распределить запросы максимально равномерно между бэкенд-серверами, и при этом сделать так, чтобы при добавлении или удалении бэкенда пострадало минимальное количество уже установленных соединений (minimal disruption). И всё это — без какой-либо координации между Maglev-машинами, потому что connection tracking table и lookup-таблица хранятся в памяти каждой машины независимо.
Как конфигурации NLB доходят до хостов
Выше мы говорили про Maglev и VPP, но не касались важного вопроса: а как вообще конфигурация NLB попадает на хосты:
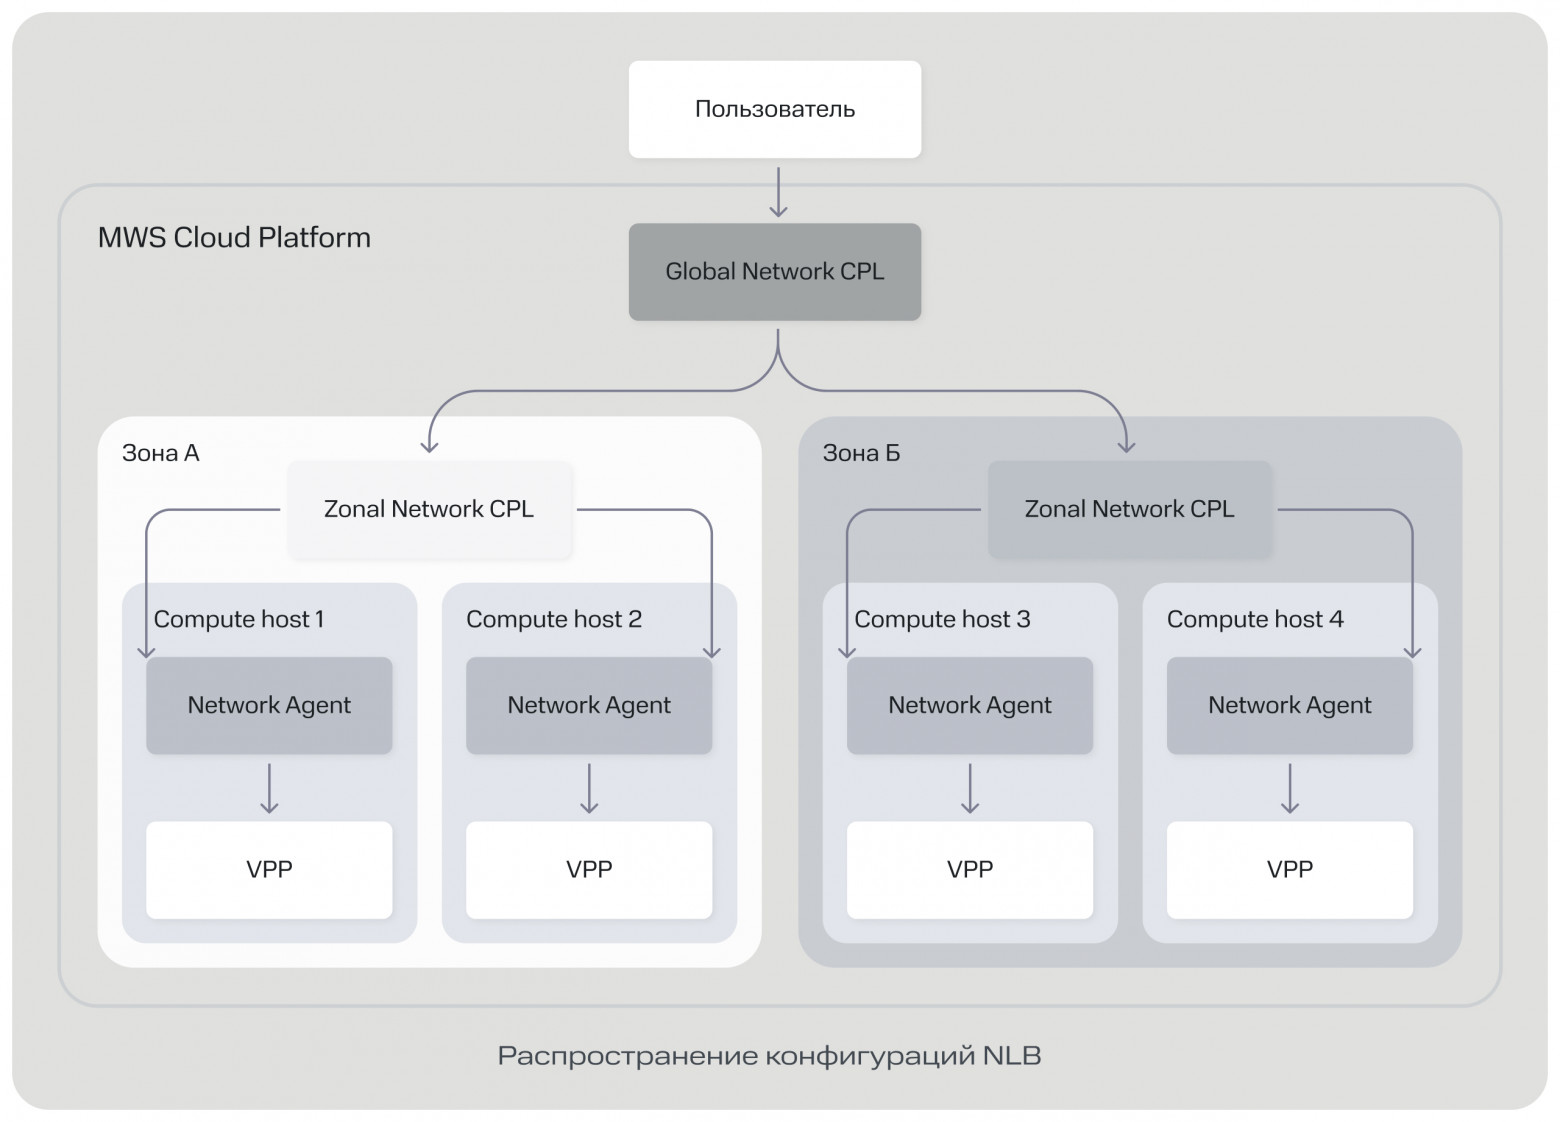
Пользователь создаёт балансировщик через REST API. Запрос уходит в глобальный control plane, тот передаёт настройки в зональные control plane, а зональные уже управляют хостами своей зоны. На каждом хосте запущен network-agent — приложение, которое непосредственно и настраивает VPP.
Внешний NLB
Теория — это, конечно, хорошо, но давайте практически посмотрим, как трафик от пользователя проходит через NLB, попадает на рил и как ответ обратно попадает к пользователю. Давайте сделаем это на примерах.
Пусть у нас в облаке есть две ВМ-ки с внутренними адресами 192.168.0.1 и 192.168.0.2. Для них создан NLB, который имеет белый VIP адрес 74.10.1.1, маршрутизируемый в интернет — такие NLB мы называем внешними. NLB принимает запросы на порт 443, а рилы слушают порт 80. Пользователь с адресом 42.10.10.1 хочет отправить запрос нашему NLB.
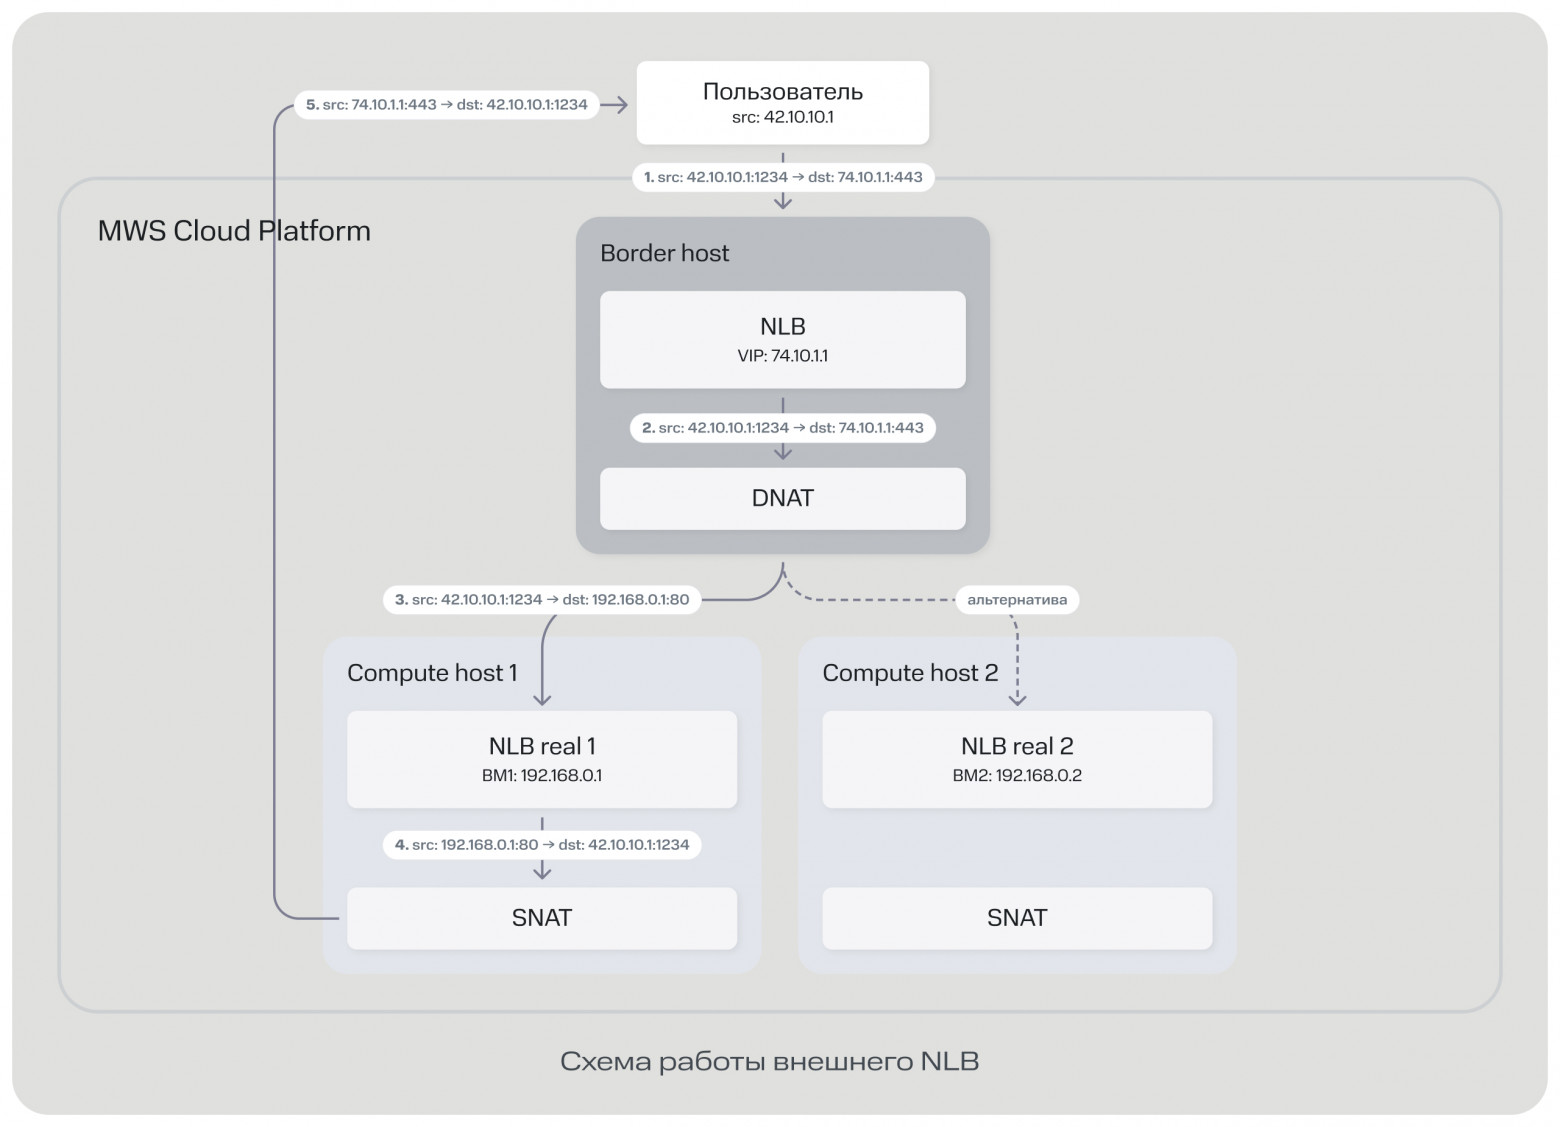
Разберём по шагам:
1. Запрос на VIP. Первое, куда попадает пользовательский запрос, — это border хост. Это граница между внешним миром и нашим облаком. На border хост уже загружена конфигурация нашего NLB: какой VIP адрес, какие рилы у нашего NLB, и тп.
2. NLB выбирает рил. NLB на нашем border хост делает свою работу и выбирает рил — например, NLB real 1 — и передаёт пакет в DNAT, сам пакет при этом не меняется.
3. Destination NAT(DNAT). DNAT меняет destination с VIP 74.10.1.1:443 на адрес VM1 192.168.0.1:80. Пакет покидает border уже с destination = 192.168.0.1:80.
4. Ответ от VM1. VM1 обрабатывает запрос и отвечает со своего адреса — 192.168.0.1:80 → 42.10.10.1:1234 — и ответ попадает в Source NAT(SNAT) на Compute хосте VM1.
5. Ответ клиенту (DSR). Отдать ответ клиенту так нельзя: клиент ждёт ответ от 74.10.1.1:443. Поэтому SNAT меняет source с 192.168.0.1:80 на 74.10.1.1:443, и ответ улетает пользователю напрямую.
Внутренний NLB
Теперь давайте представим, что у нас есть три ВМ-ки с внутренними адресами 192.168.0.1, 192.168.0.2, 192.168.5.1. Для них создан NLB, который имеет серый VIP адрес 192.168.10.5 — такие NLB мы называем внутренними. NLB принимает запросы на порт 443, а рилы слушают порт 80. Пользователь — ВМ-клиент с адресом 192.168.5.1 — хочет отправить запрос нашему NLB.
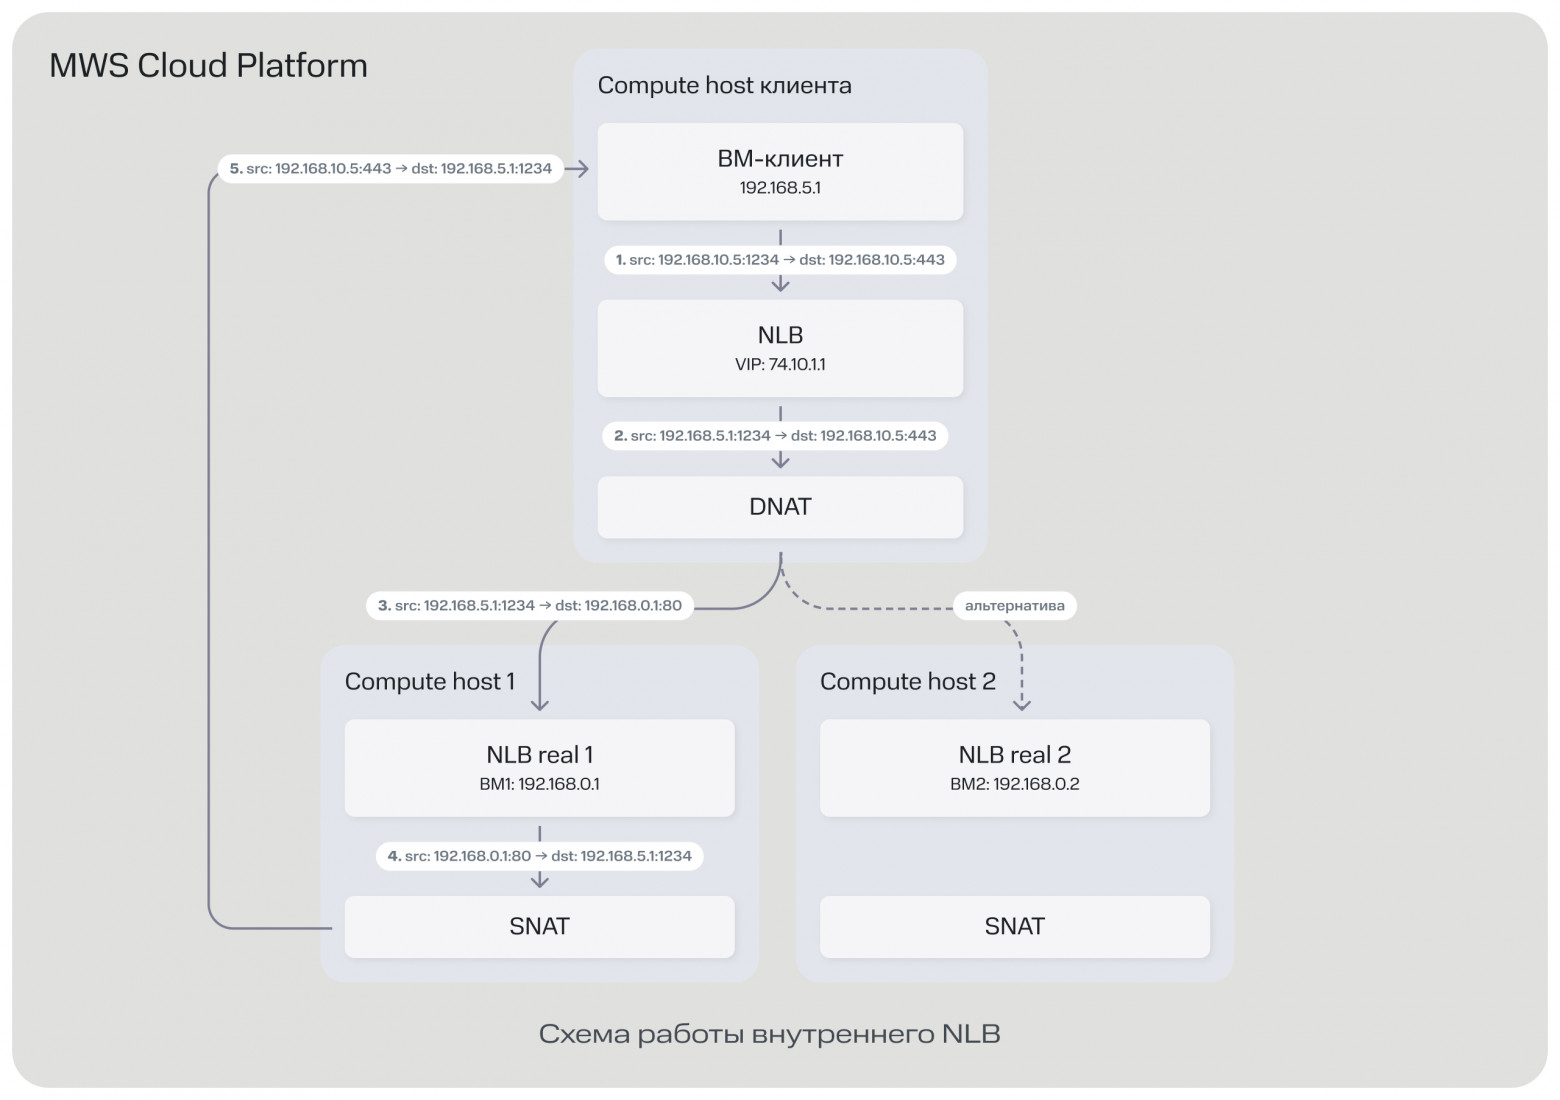
1. Запрос на VIP. На compute хост клиента уже загружена конфигурация NLB. ВМ-клиент отправляет запрос на адрес 192.168.10.5:443.
2. NLB выбирает рил. NLB на хосте клиента выбирает рил — например, NLB real 1 — и передаёт пакет в DNAT, сам пакет при этом не меняется.
3. DNAT. DNAT меняет destination с VIP 192.168.10.5:443 на адрес рила 192.168.0.1:80. Пакет покидает compute хост клиента уже с destination = 192.168.0.1:80.
4. Ответ VM1. VM1 обрабатывает запрос и отвечает со своего адреса — 192.168.0.1:80 → 192.168.5.1:1234 — и ответ попадает в SNAT на compute хосте VM1.
5. Ответ клиенту (DSR). Как и в случае с внешним NLB, SNAT меняет source ответа с 192.168.0.1:80 на VIP 192.168.10.5:443, и ответ уходит ВМ-клиенту напрямую.
Схема предельно простая, давайте сразу отметим ключевые положительные моменты:
Между хостом клиента и хостом рила NLB нет лишних сетевых хопов — как если бы балансировщика не существовало. Делаем балансировку и дальше трафик без дополнительных сетевых хопов отправляется по нужному адресу.
Пропускная способность остаётся практически такая же, как и при прямом общении.
Горизонтальное масштабирование — если клиентов становится больше и они на разных хостах, мы просто копируем конфиг NLB на эти хосты. Если все ВМ-клиенты на одном хосте, то с точки зрения NLB ничего не меняется — процесс балансировки запросов очень простой, быстрый и легко параллелится.
В то же время данная архитектура накладывает на нас некоторые ограничения:
К рилу под NLB нельзя достучаться напрямую по порту — поскольку мы делаем SNAT на compute хосте рила, подменяя source ip и source port на VIP адрес NLB и NLB port, прямой заход на этот port (минуя NLB) становится невозможным: произойдёт SNAT с подменой на VIP адрес NLB и обратный трафик дойдёт до отправителя с неверным source ip и портом и не будет обработан.
Один рил нельзя использовать в разных NLB с одним портом — по той же причине, что и выше, на Compute-хосте рила мы не можем знать через какой NLB (если их несколько) прошёл запрос и, как следствие, не знаем, какой SNAT необходимо сделать.
Каждый хост, который потенциально может иметь клиента, обязан иметь конфиг NLB — представим себе ситуацию, когда в вашей облачной сети есть 100 ВМ-ок и все они находятся на разных Compute-хостах. Для двух ВМ-ок создан внутренний NLB. Опираясь на описанную схему, на все 100 хостов должен быть загружен конфиг нашего NLB, так как каждая ВМ в облачной сети — потенциальный клиент внутреннего NLB. То же самое верно и для внешнего NLB: на каждый Border-хост должны быть загружены конфигурации всех внешних NLB.
Сразу оговоримся, что все описанные ограничения решаемые, об этом мы поговорим подробнее ниже в наших планах на ближайшее будущее.
Health check для NLB
Сам по себе NLB сложно использовать в чистом виде: если какой-то рил упадёт, то мы будем терять часть трафика, которая идёт на этот рил. Соответственно, нам нужна дополнительная функциональность, которая будет проверять работоспособность, и если какой-то рил перестал отвечать, мы должны выключать его из трафика NLB.
В нашем облаке health check-ом занимается отдельный компонент — LBHC (Load Balancer Health Checker). LBHC живёт на каждом хосте облака и получает конфигурации, как и кого надо проверять, от зонального Control Plane. Настройки Health check, которые можно использовать для наших NLB:
— protocol: по какому протоколу проводить проверки;
— port: на какой порт отправлять запросы;
— statusCode и path: если выбраны протоколы http или https, можно настроить, по какому пути делать проверки и какой ожидаемый код ответа;
— interval: с каким интервалом делать проверки;
— timeout: таймаут запроса на проверку;
— unhealthyThreshold: количество последовательных неуспешных проверок, после которого рил считается неработоспособным;
— healthyThreshold: количество последовательных успешных проверок, после которого рил считается работоспособным.
Давайте рассмотрим различные варианты реализации Health check для NLB.
Первый вариант: Health check со всех хостов
На начальном этапе основным требованием было то, что путь health check-а должен быть максимально близким к пути обычного клиентского трафика. То есть если клиент находится на хосте А, а рил на хосте Б, то и путь health check-а должен также начинаться от хоста А.
Когда мы создаём балансировщик, настройки проверок работоспособности грузятся на каждый хост, куда грузятся и основные настройки NLB. Зональный Control Plane задаёт полный список рилов, а LBHC на каждом конкретном хосте управляет рилами.
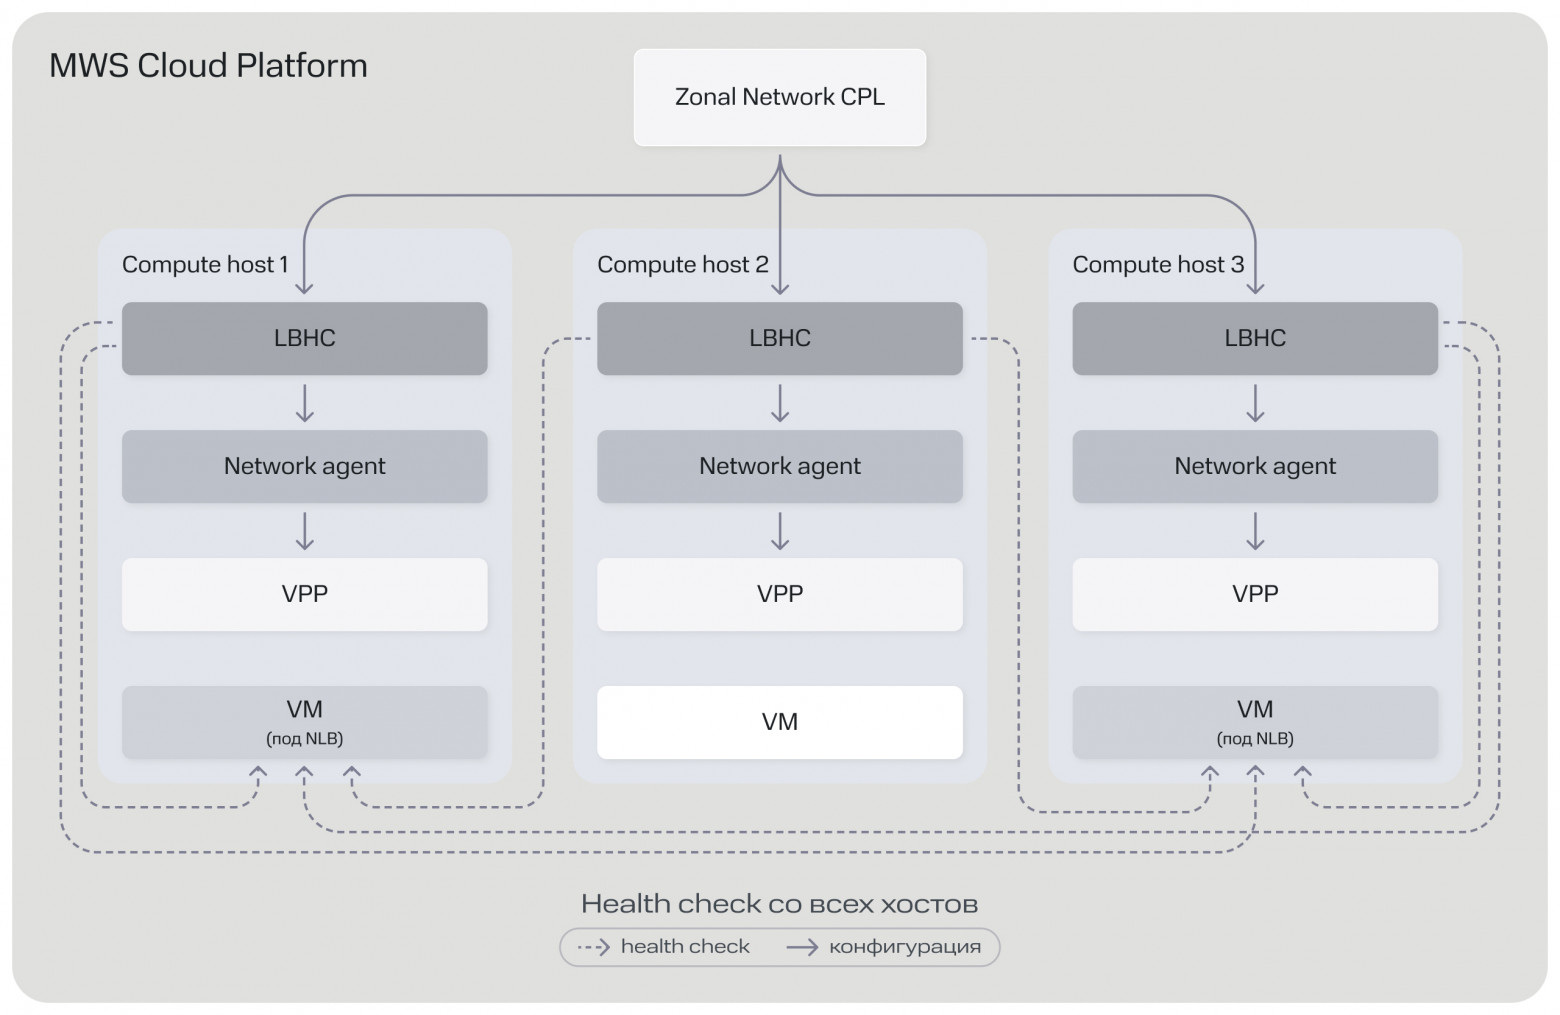
1. Каждый health-checker-агент периодически опрашивает назначенные ему рилы — отправляет запрос (HTTP или TCP) и выносит вердикт: работает или нет.
2. Все результаты агрегируются самим LBHC — решение принимается по трешолду, заданному к конфигурации health check.
3. На основании этого решения LBHC обновляет конфиг NLB через network-agent только на том хосте, где работает LBHC.
Плюсы
Максимальная «честность»: мы проверяем рил ровно из тех мест, откуда реально может прийти трафик, и агрегация происходит в рамках конкретного хоста. Если какой-то рил недоступен с хоста А и он выведен из трафика на этом хосте, то это никак не влияет на хост Б, где этот рил может быть всё ещё «живым».
Скорость сходимости: так как LBHC живёт прямо на хосте, то вся агрегация происходит тут же. Нет необходимости ждать проверок с других хостов и как-то это агрегировать — скорость добавления и удаления рила из трафика высокая.
Минусы
Плохая горизонтальная масштабируемость: это N (хостов) × M (балансировщиков) проверок. Облако растёт, число хостов и число балансировщиков растёт, и объём проверочного трафика и нагрузки на LBHC тоже растёт без какой-то ощутимой пользы.
Плохая отказоустойчивость: если на каком-то хосте LBHC перестал работать, то и NLB на этом хосте перестанет получать «обновления» — если какой-то рил упадёт, NLB об этом не узнает.
Это был наш первый вариант — мы намеренно его выбрали из-за простоты и быстроты реализации. Но одновременно с этим, исходя из минусов, продумали, как его улучшить в будущем.
Второй вариант: health check с ограниченного числа хостов плюс агрегатор
Чтобы убрать минусы горизонтальной масштабируемости, естественное решение — делать health check с ограниченного набора хостов. Это убирает проблемы с масштабируемостью, но привносит новый вызов: теперь необходим агрегатор, который будет собирать health check статусы и рассылать их на все хосты, где есть конфигурация этого NLB.
В прошлой схеме этой проблемы не было, так как на каждом хосте был свой LBHC, который конкретно для данного хоста делал необходимую агрегацию. В качестве агрегатора мы выбрали зональный Control Plane — он уже знает о полной конфигурации NLB и его health check, знает, на каких хостах они живут.
Остаётся только добавить логику по агрегации статусов рилов. Агрегатор, в свою очередь, помогает справиться со вторым минусом: если один или несколько LBHC упадут, зональный Control Plane сможет перераспределить нагрузку на LBHC на других хостах.
Как это работает:
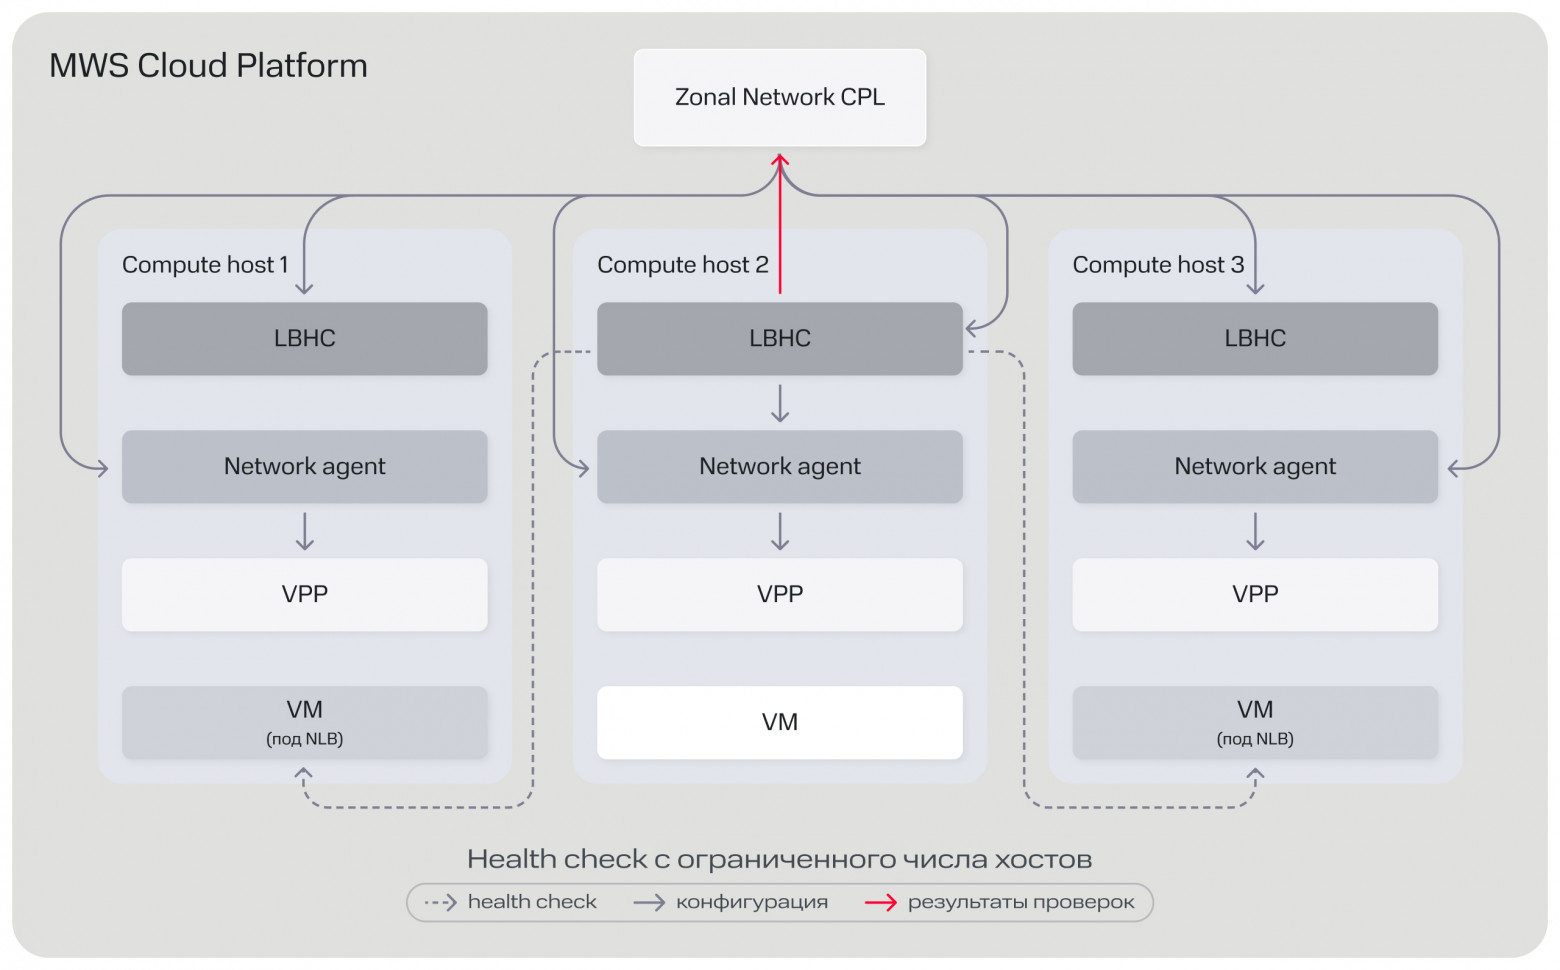
1. Зональный Control Plane выбирает часть хостов и отправляет LBHC на эти хосты конфигурации о health check конкретного NLB.
2. Каждый health-checker-агент периодически опрашивает назначенные ему рилы — отправляет запрос (HTTP или TCP) и выносит вердикт: работает или нет.
3. Все результаты отправляются в зональный Control Plane и агрегируются. Решение принимается с опорой на трешхолд: например, проверяем с пяти хостов, если с одного-двух хостов рил «мёртвый» — ещё считаем рил в целом «живым», если с трёх и более «мёртвый» — считаем, что рил в целом «мёртвый».
4. На основании этого решения зональный Control Plane обновляет конфиг NLB на всех хостах через network-agent.
5. Если какой-то LBHC упал, зональный Control Plane находит новый хост и отправляет туда нужную конфигурацию для health check.
Такая схема полностью решает минусы предыдущей, но рождает новый: теперь точка отказа — сам зональный Control Plane, если упадёт он, то все NLB на всех хостах перестанут получать обновления. Так как зональный Control Plane — сервис немаленький, он управляет всеми сетевыми ресурсами в зоне, то функциональность по агрегации и обработке статусов рилов хочется вынести в отдельный сервис, чтобы повысить в целом отказоустойчивость NLB при сбоях зонального Control Plane.
Планы на ближайшее будущее и над чем мы сейчас работаем
Наш NLB только в начале своего пути, и у нас есть много разных идей по улучшению и оптимизации. Я расскажу только о тех, которыми мы уже занимаемся и которые появятся в ближайшем будущем.
Снятие ограничений для использования рилов с несколькими NLB
Исходя из текущей архитектуры мы отмечали выше, что использовать один рил с тем же портом в разных NLB не получится. Проблема сходу решается достаточно просто: вместо того чтобы делать DNAT на хосте клиента, необходимо это делать на хосте рила, тогда на риле мы будем знать, через какой NLB прошёл запрос, и сможем правильно сделать SNAT для обратного трафика.
Но тут скрывается один неприятный нюанс. Представим, что у вас есть две ВМ-ки в облаке и они ходят в интернет через Egress NAT. У вашего Egress NAT один внешний адрес. Также у вас есть два внешних NLB с разными адресами. Под каждым NLB для простоты только один рил, и он общий. Первая VM идёт на первый NLB, и Egress NAT выделяет ей тот же порт, что и второй VM при походе на другой NLB. Это допустимо, так как NLB разные и dest ip запросов с VM разные.
Оба запроса придут на хост рила, и после DNAT мы потеряем информацию, какой запрос прошёл через какой NLB, и так как у обоих запросов после DNAT полностью одинаковые 5-tuple, мы никак не сможем определить, какой обратный SNAT для какого запроса нужен.
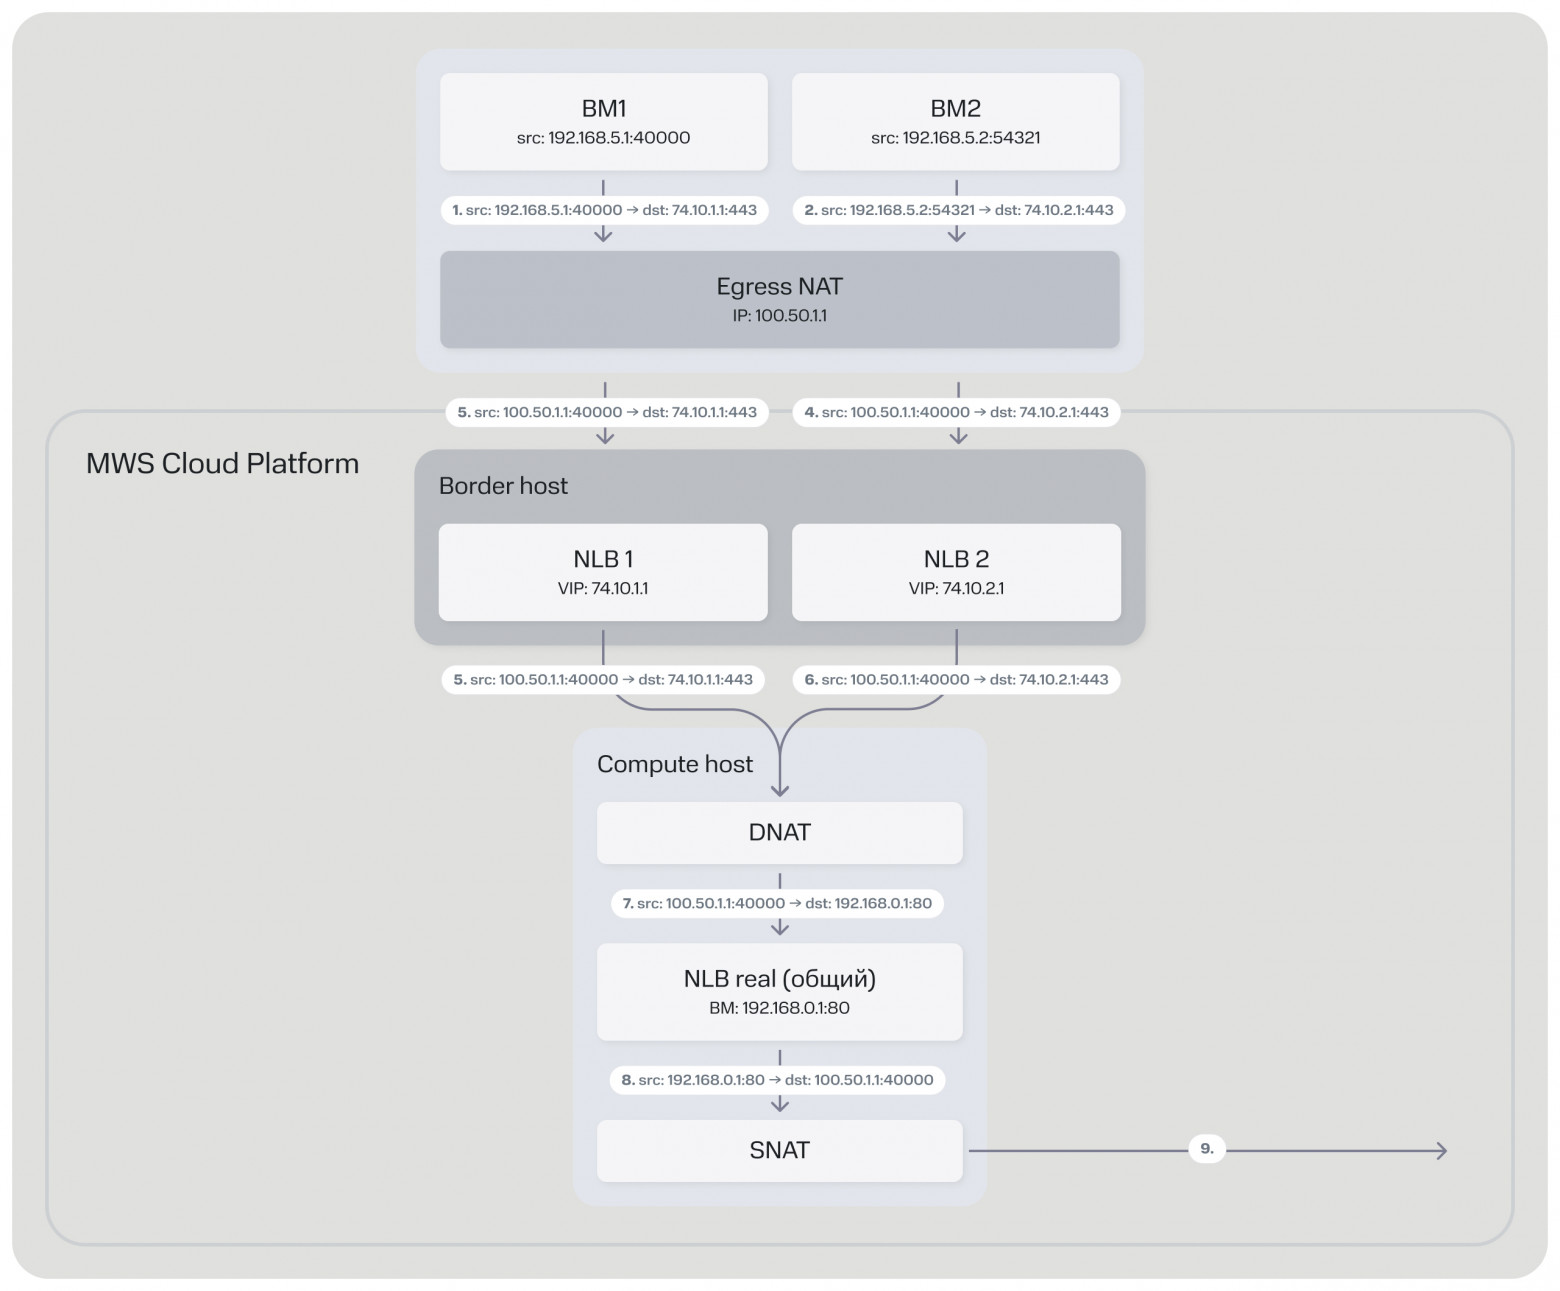
Разберём по шагам:
1. Стрелки 1 и 2 — запросы ВМ через Egress NAT. ВМ1 и ВМ2 отправляют запросы на разные NLB. Исходные порты у ВМ свои и в данном случае разные: 192.168.5.1:40000 → 74.10.1.1:443 и 192.168.5.2:54321 → 74.10.2.1:443.
2. Стрелки 3 и 4 — Egress NAT выделяет один порт на двоих.* Оба запроса уходят в интернет с одного адреса и одного порта — 100.50.1.1:40000. Это допустимо: назначения разные, поэтому 5-tuple сессий не конфликтуют.
3. Стрелки 5 и 6 — запросы от NLB на хост рила. NLB не меняет пакет и направляет его на compute-хост единственного рила в исходном виде — адреса те же, что и на стрелках 3 и 4: 100.50.1.1:40000 → 74.10.1.1:443 и 100.50.1.1:40000 → 74.10.2.1:443.
4. Стрелка 7 — запрос до рила. DNAT на хосте рила меняет destination с VIP на адрес рила — 100.50.1.1:40000 → 192.168.0.1:80. Теперь 5-tuple обоих запросов полностью идентичны, и информация о том, через какой NLB шёл запрос, потеряна.
5. Стрелка 8 — ответ рила. Рил отвечает одним и тем же 5-tuple — 192.168.0.1:80 → 100.50.1.1:40000 — и ответ попадает в SNAT-модуль на том же хосте.
6. Стрелка 9 — обратный SNAT. Чтобы ответ дошёл до клиента, SNAT должен подменить source на VIP одного из NLB — но какой из двух VIPов выбрать, определить уже невозможно: для SNAT-модуля оба ответа выглядят одинаково.
Такая ситуация маловероятна, но вполне возможна. Эту проблему решает двойной NAT.
Двойной NAT
Идея в том, чтобы добавить дополнительный NAT на хосте рила, чтобы для разных NLB сессии NAT не пересекались, как в примере выше.
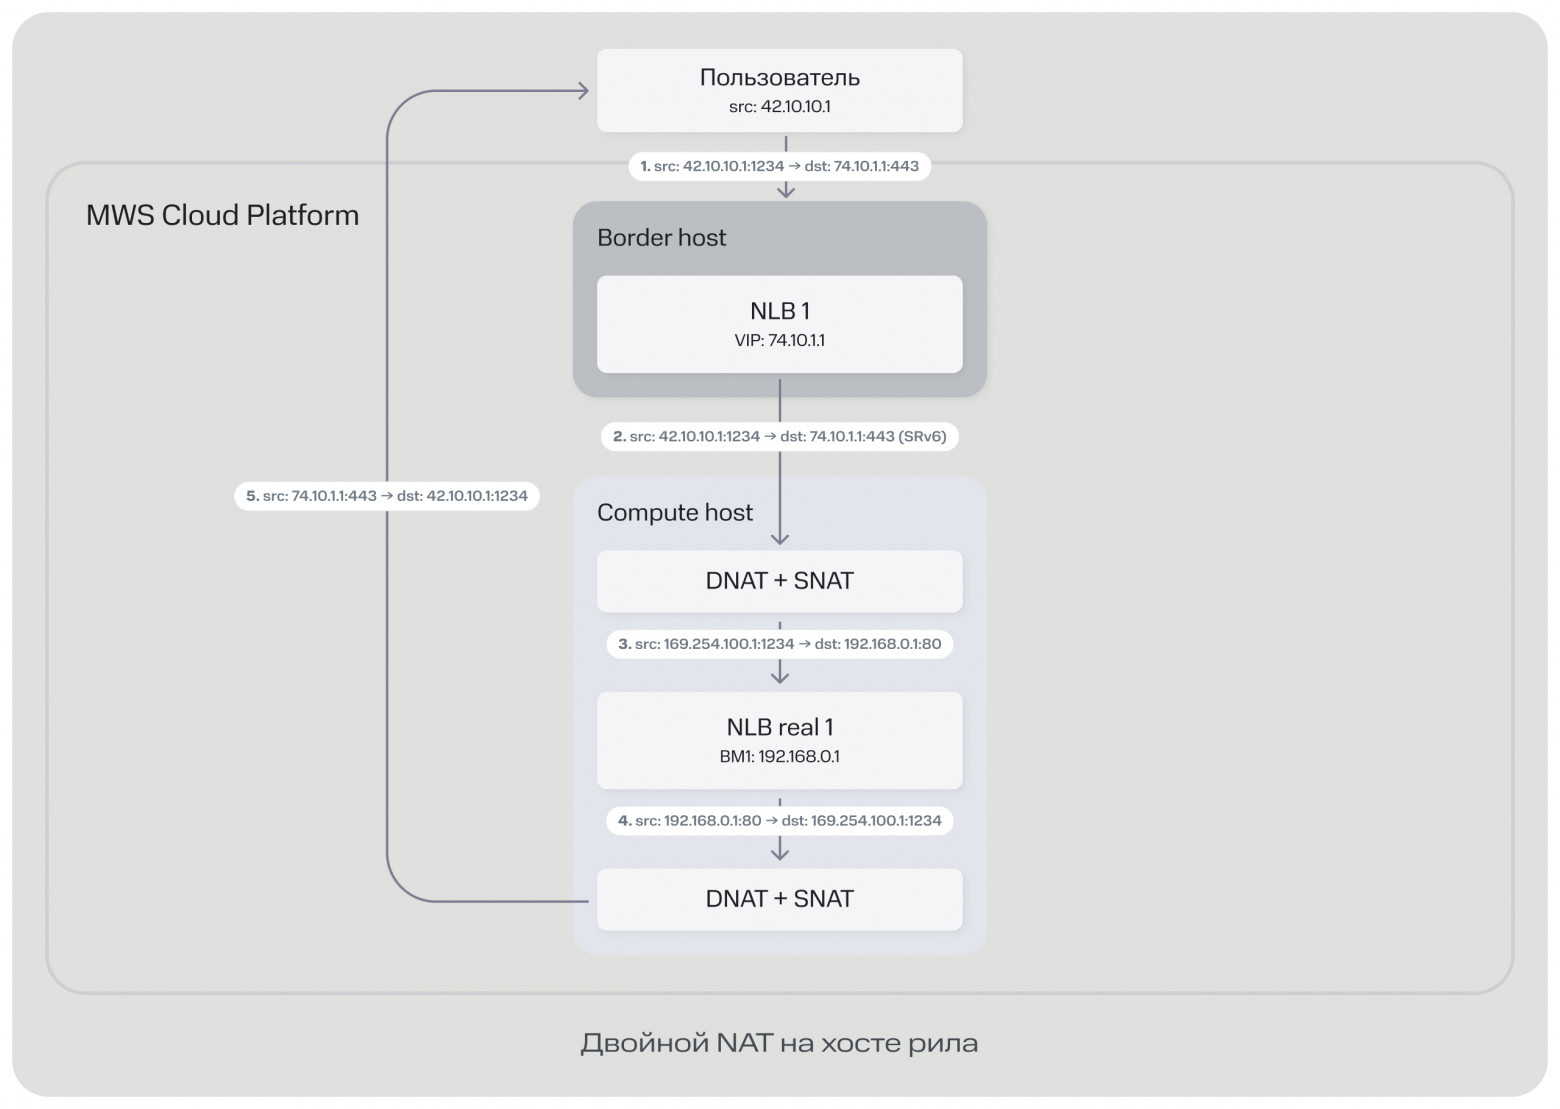
1. Запрос на VIP. Запрос пользователя приходит на border host, где уже есть конфигурация NLB. NLB выбирает рил, но, в отличие от текущей схемы, не делает DNAT.
2. Запрос на хост рила. NLB отправляет запрос в почти исходном виде и адресует его compute-хосту выбранного рила — там пакет попадает в верхний модуль DNAT + SNAT.
3. DNAT и SNAT. Модуль выполняет сразу два преобразования: DNAT (destination меняется с VIP 74.10.1.1:443 на адрес рила 192.168.0.1:80) и SNAT (source меняется с адреса клиента 42.10.10.1 на адрес из служебной подсети, например 169.254.100.0/26), после чего пакет доставляется на рил.
4. Ответ рила. Рил отвечает, и его ответ попадает в обратный DNAT + SNAT
5. DNAT и SNAT. Выполняется обратное преобразование DNAT + SNAT, и пакет с source = 74.10.1.1:443 → 42.10.10.1:1234 уходит клиенту напрямую.
Все трансляции конкретного NLB теперь живут в его собственном NAT-пуле на хосте рила: сессии разных NLB не пересекаются между собой, и один рил можно использовать в нескольких NLB с одним и тем же портом. Но появляется проблема: теряется IP-адрес клиента. Для некоторых пользователей это допустимо и не критично, но для других это неприемлемо и они обязательно хотят знать IP клиента.
Proxy Protocol V2 (PPv2)
Чтобы рил не терял IP-адрес клиента, мы добавим поддержку PROXY protocol v2.
Кратко о том, как работает PPv2: после того как прошли SYN/ACK и TCP-соединение установлено, клиент в первом пакете полезной нагрузки первым сегментом заголовка отправляет информацию о том, какие source ip, source port, dest ip, dest port были у исходного TCP пакета.
Ключевое здесь то, что потребитель должен знать и уметь работать с PPv2, чтобы правильно парсить и интерпретировать то, что написано в заголовке. Популярные решения, например nginx, HAProxy, Envoy, PostgreSQL 14+, ClickHouse, имеют эту опцию из коробки. А если у вас какой-то нестандартный сервер, то придётся дописывать это руками.
Важно отметить, что работа PPv2 требует двустороннего согласования: если одна из сторон будет настроена на работу с PPv2, а вторая — нет, то ничего не будет работать в принципе. Также не менее важный нюанс заключается в том, что PPv2 хорошо работает c TCP, и очень плохо с UDP — в UDP нет SYN/ACK, нет порядка пакетов и не гарантируется доставка.
В нашем случае NAT-модуль на хосте рила будет перед полезной нагрузкой каждого соединения отправлять PPv2-заголовок, в котором передаются настоящие адреса: src — реальный адрес клиента, dst — VIP NLB, на который клиент обратился. Рил сможет определять и реального отправителя, и то, через какой VIP к нему пришли. По сути, мы используем тот же штатный механизм, что и другие облачные passthrough-балансировщики (например, AWS NLB), где PPv2 — стандартный способ вернуть клиентский IP за SNAT.
В итоге, используя двойной NAT и PPv2 как возможные опции, мы даём пользователям возможность более гибко настраивать NLB под каждый конкретный случай.
Балансировка с весами
На данный момент все рилы в нашем NLB равнозначны — мы будем стараться равномерно распределить нагрузку между всеми «живыми» рилами. Но иногда очень удобно задавать веса конкретным рилам. Например, если вы хотите плавно вывести какой-нибудь рил из трафика, вы просто будете понижать его вес с 1 до 0 — это позволит минимизировать или полностью исключить потери трафика. Или обратная ситуация: вы хотите добавить новый рил в балансировку и хотите постепенно увеличивать трафик на данный рил.
В то же время некоторые облачные провайдеры позволяют динамически управлять весами рилов через специальные HTTP Headers (например, GCP, заголовок X-Load-Balancing-Endpoint-Weight) в ответах на запрос от health checker. Это позволяет гибче построить балансировку нагрузки между рилами. Например, к вам в сервис, который находится за NLB, приходят лёгкие и тяжёлые запросы, тяжёлых запросов мало и даже при небольшом количестве сервис может сильно просаживаться. Было бы очень удобно, если бы сам рил мог сообщить NLB, что в данный момент он загружен работой (например, его CPU usage уже близко к 100%) и новые запросы ему лучше не отправлять (или отправлять их сильно меньше), пока он не разберётся с текущими.
На данный момент функциональность балансировки с весами находится на ранней стадии проработки.
Балансировка по зонам доступности
Представим ситуацию, что в вашем балансировщике четыре рила: два в зоне А, два в зоне Б. И вы, находясь в зоне А, отправляете запросы на данный балансировщик — на данный момент балансировка будет честно распределять запросы между обеими зонами. В итоге у вас появляется кросс-зональный трафик там, где его можно исключить.
Мы планируем добавить возможность настраивать балансировщик таким образом, чтобы он умел балансировать по зонам доступности, если запрос идёт из зоны А и в зоне А есть хотя бы один рил, то запрос гарантированно будет направлен в рилы зоны А. Это позволит избежать кросс-зонального трафика и в целом улучшить работу балансировщика.
Повышение отказоустойчивости и надёжности
Как мы отмечали выше, на данный момент функции агрегатора у нас выполняет зональный Control Plane. Мы сейчас активно работаем над тем, чтобы вынести эту функциональность в отдельный сервис для повышения надёжности и отказоустойчивости. Ещё мы активно проводим нагрузочное тестирование всего NLB в целом, чтобы выявить узкие места.
Также мы собираем много метрик, но наиболее интересные в контексте надёжности NLB — это метрики по числу отброшенных пакетов в VPP. Для каждого балансировщика можно выделить два негативных сценария, когда пакеты теряются. В первом случае может быть неправильно сконфигурирован VIP (помним, что он определяется через 5-tuple: адрес и порт отправителя, адрес и порт получателя, протокол). Но, к примеру, при конфигурировании dport был указан 5678, а в пришедших пакетах — 5679. Счётчик отброшенных пакетов в этом случае — общий для всего балансировщика. Второй случай — это когда балансировщики сконфигурированы правильно, пакет приходит на VIP, но ни одного рила под ним не существует. Балансировать в итоге некуда. Опираясь на эти метрики можно быстро выявить проблемные балансировщики.
Диагностика проблем сети
Отдельное направление, которое сейчас активно развивается, — диагностика проблем overlay-сети. Для этого мы написали собственную утилиту. Её возможности гораздо шире отладки NLB, но диагностика балансировщика — одна из ключевых задач.
Как уже говорилось, наш проект построен на VPP, а у VPP из коробки есть «ручки» для диагностики: запись pcap (классика, знакомая каждому сетевому инженеру, который хоть раз открывал Wireshark), трассировка (запись в стиле VPP о том, как пакет путешествует по графу узлов) и dispatcher trace (смесь бульдога с носорогом pcap и трассировка в одном флаконе). На самом деле «ручек» куда больше, а у базовых плагинов хватает своих проблем, так что многое пришлось допиливать или переписывать под себя. Но это тема для отдельной статьи: о самом инструменте и о том, как мы прошли путь от боли к просветлению :)
Кроме того, у VPP масса настроек, связанных с балансировщиком. А зачем нужны настройки, если не для того, чтобы собрать их в одном месте и агрегировать? Вот и я так думаю.
Но есть нюанс. Как уже упоминалось, правила внешнего NLB дублируются на все border-хосты, а значит, для корректной диагностики нужно собирать информацию с нескольких border-хостов одновременно. А рилы-то живут на compute-хостах! Получается, нам нужно в один и тот же момент снять слепок сети со всех border-хостов и с нужных compute-хостов по заданному набору правил, причём с разными BPF-фильтрами для разных целей. Ведь какой толк от дампа с хоста, где живёт VM с IP 192.168.0.1, если фильтр ловит трафик 192.168.0.13?
Путём таких нехитрых рассуждений мы и сформулировали требования к инструменту диагностики:
собирать и обрабатывать настройки, выдавая оператору summary со всей нужной информацией и подсветкой типовых проблем (например, аномально большие счётчики дропов из-за того, что не найден нужный VIP — чем не зацепка для кейса «трафик не доходит до рила»?
снимать дампы сети по заданным правилам;
делать всё это распределенно, сразу во многих точках.
Инструмент уже сейчас помогает быстро находить реальные проблемы и не раз доказал свою эффективность в бою.
Заключение
Итак, что у нас в итоге получилось:
Passthrough NLB уровня L3–L4: построен с использованием плагина VPP, в основе которого алгоритм Google Maglev.
По производительности практически равный отсутствию NLB: никаких лишних сетевых хопов, latency и пропускная способность — как при прямом общении ВМ. Мы делали замеры и получили, что разница при прямом общении между ВМ-ками и при общении через NLB составляет не более 1–2%.
Горизонтально масштабируемый: конфиг NLB создаётся на хостах по мере роста числа клиентов.
С распределённым health check: проверки с нескольких хостов, переживает падение отдельных checker-агентов (LBHC).
На самом деле, при кажущейся простоте, в процессе разработки мы сталкивались и продолжаем сталкиваться с разными сложностями: например, если сам рил является и клиентом своего балансировщика, то это требует некоторых специальных настроек, чтобы балансировка честно работала. Но, несмотря на разные вызовы, мы идём дальше и стараемся делать наш балансировщик лучше и лучше.
Оглядываясь на наш путь, можно заметить, что мы не пытались сделать всё сразу идеально — мы осознанно шли на компромиссы в архитектуре и реализации, с пониманием, что в дальнейшем будем с этим делать.
Сама статья носит ознакомительный характер, где мы постарались в общих чертах описать, как работает наш балансировщик, без глубокого погружения в детали. Спасибо, что дочитали. Если есть вопросы — добро пожаловать в комментарии или приходите в наше сообщество в Телеграме.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.