Применение физически информированных нейронных сетей (PINN) в пучковых нейросетях на графах
Привет, Хабр! Мы студенты мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK: Ксения Белькова, Тимур Лиджиев и Мария Стеблий. В этой статье хотим рассказать об исследовании, в котором изучали, можно ли применять физически информированные нейронные сети (PINN) для аппроксимации диффузионных процессов в графовых нейронных сетях на пучках.
Исследование мы проводили совместно с Александром Таракановым, инженером машинного обучения AI VK и доцентом ФКН НИУ ВШЭ. В статье расскажем о подходе, проведенных экспериментах и полученных результатах.
В экспериментах PINN показал точность на уровне других методов и позволил сократить время инференса. Значит, PINN может быть полезен для ускорения работы моделей, но его влияние на качество классификации нужно изучить отдельно.
Большинство графовых нейронных сетей строится на механизме message passing. На каждом слое вершина получает информацию от соседних вершин, агрегирует её и обновляет по ней собственное представление.
Обозначим через  представление вершины
 на слое
 . Тогда в общем виде message passing можно записать так:
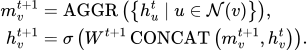
Когда слоёв становится больше, у такого подхода возникают проблемы — например, over-smoothing и over-squashing. В первом случае представления разных вершин постепенно становятся слишком похожими друг на друга. Во втором случае информацию от большого числа удалённых вершин приходится передавать через ограниченное число промежуточных представлений.
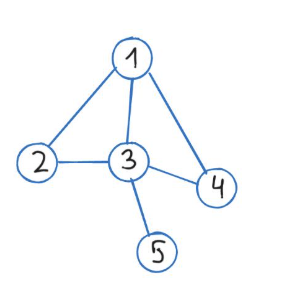
В стандартных GNN передачу информации между соседними вершинами обычно задают с помощью операций, основанных на графовой структуре. Однако для графов, где признаки связанных вершин сильно различаются, такого описания может быть недостаточно. Один из способов расширить представление локальных взаимодействий — клеточные пучки (cellular sheaves). Они задают преобразования признаков между локальными пространствами, связанными рёбрами графа.
На основе пучка (sheaf) строится sheaf Laplacian — оператор, обобщающий обычный графовый лапласиан. Если обычный лапласиан определяет взаимодействие признаков соседних вершин, то sheaf Laplacian дополнительно учитывает линейные restriction maps, связывающие локальные пространства признаков. Поэтому распространение признаков можно рассматривать как диффузионный процесс с дополнительной структурой локальных преобразований (Bodnar et al. 2022, Barbero et al. 2022).
Задачу распространения признаков можно записать в виде дифференциального уравнения
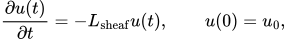
где  — sheaf Laplacian, а
 — начальное состояние. В такой постановке sheaf Laplacian не только описывает взаимодействие признаков на графе, но и определяет непрерывную во времени диффузионную динамику.
Мы предлагаем использовать Physics-Informed Neural Network (PINN) для аппроксимации решения диффузионной задачи. Вместо того чтобы напрямую интегрировать уравнение численно, нейронная сеть обучается предсказывать состояние системы в зависимости от времени, а корректность получаемого решения контролирует невязка исходного дифференциального уравнения (Raissi et al. 2019). Диффузионное уравнение выступает как ограничение при обучении модели.
Дополнительная особенность предлагаемого подхода — использование представления Крылова. Мы не передаём в нейронную сеть плотное представление оператора  , а используем последовательность его применений к начальному состоянию:
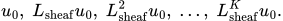
Такое представление сохраняет информацию о действии оператора на начальное состояние и позволяет использовать разреженность графового оператора (Saad 1992).
Метод объединяет обучаемое sheaf-представление графа и PINN, и их параметры оптимизируются совместно. Sheaf Laplacian определяет диффузионную динамику, Krylov-представление используется как компактное представление действия оператора, а PINN аппроксимирует зависящее от времени состояние системы. Обучение дополнительно учитывает начальное условие и невязку диффузионного уравнения.
Цель работы — исследовать, как PINN можно применять для аппроксимации диффузионных процессов в графовых нейронных сетях.
Мы рассматриваем два варианта:
аппроксимация sheaf diffusion с использованием Krylov-представления
применение предварительно обученной PINN для аппроксимации действия матричной экспоненты внутри Bundle Neural Networks
Теория
Граф
Пусть задан граф  , где
 — множество вершин, а
 — множество рёбер.
Каждой вершине  сопоставим вектор признаков
 .
Все признаки можно объединить в вектор 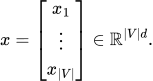
Для нескольких каналов признаков будем использовать матрицу  .
Клеточный пучок
Клеточный пучок  над графом
 сопоставляет каждой вершине
 векторное пространство
 , каждому ребру
 пространство
 , а каждой паре «вершина — инцидентное ребро» линейное отображение
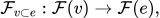 называемое
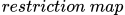 .
Таким образом, вместо одного скалярного веса ребра sheaf позволяет задавать линейное преобразование между локальными пространствами признаков.
Предположим, что все stalk имеют размерность  , поэтому restriction maps — матрицы размера
 .
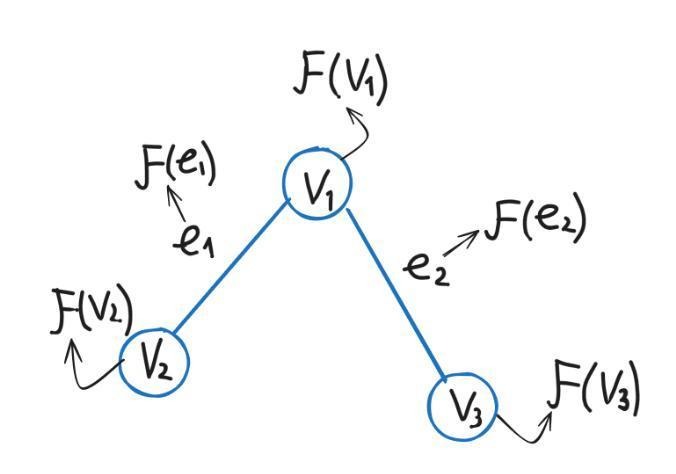
На рисунке показано, что значения в вершинах сначала принадлежат своим локальным пространствам  , а restriction maps переводят и в пространство соответствующего ребра
 . Поэтому признаки соседних вершин можно сравнивать после их отображения в общее пространство.
0- и 1-коцепи
Пространство значений на вершинах задаётся как 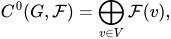
а пространство значений на рёбрах: 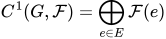 .Таким образом, элемент
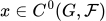 — это набор векторов
 , по одному для каждой вершины.
Coboundary operator
Выберем ориентацию каждого ребра. Для ребра  определим оператор
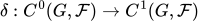 как
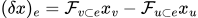 . Таким образом,
 сравнивает значения на концах ребра после их отображения в общее пространство
 .
Sheaf Laplacian
Sheaf Laplacian определяется как  Для любого
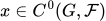
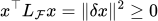 , поэтому
 — симметричная положительно полуопределённая матрица.
Диагональный блок, соответствующий вершине  , имеет вид
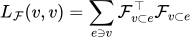 . Для соседних вершин
 и
 , соединённых ребром
 ,
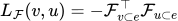 . В тривиальном случае, когда все stalk одномерны, а restriction maps тождественны, эта конструкция сводится к обычному графовому лапласиану.
Sheaf diffusion
Для обычного графа диффузионный процесс задаётся уравнением 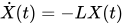 , где
 — графовый лапласиан. Это уравнение описывает распространение признаков между соседними вершинами. Оно служит дискретным аналогом уравнения теплопроводности.
Sheaf Laplacian обобщает эту конструкцию: он заменяет обычный графовый лапласиан матричным оператором, учитывающим restriction maps. Поэтому аналогичный диффузионный процесс принимает вид 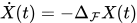 .
Именно этот процесс называется sheaf diffusion. В отличие от обычной графовой диффузии, он учитывает не только структуру связей между вершинами, но и преобразования признаков между их локальными пространствами.
Bundle Neural Networks
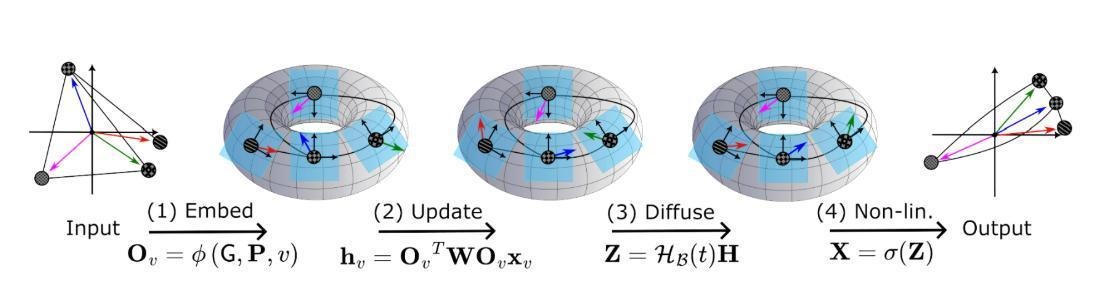
Эту идею развивают Bundle Neural Networks (BuNN), предложенные в работе Bamberger et al. В BuNN каждой вершине сопоставляется локальное векторное пространство, а переход между локальными пространствами соседних вершин задаётся ортогональным преобразованием. Для соседних вершин  и
 его можно записать как
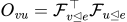 , причём
 . Тогда сообщение для вершины
 можно представить в виде
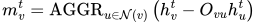 .
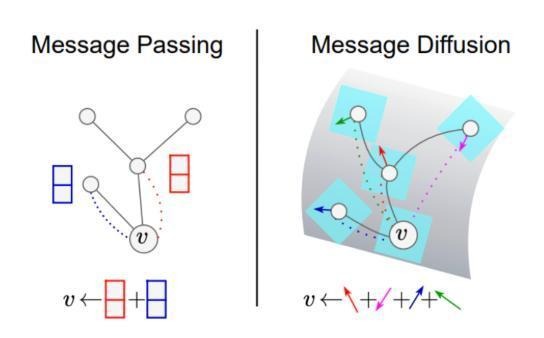
В отличие от обычного локального message passing, в BuNN для распространения признаков используется диффузия. Это позволяет учитывать информацию не только от соседей вершины.
Диффузия в BuNN
Как и в случае sheaf diffusion, распространение признаков в BuNN можно рассматривать как диффузионный процесс. Диффузию признаков можно описать уравнением  , где $L$ — оператор Лапласа. Для постоянного
 решение имеет вид
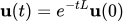 .
Чтобы реализовать диффузию, нужно вычислить действие матричной экспоненты  на начальный вектор признаков.
Обзор существующих методов
Существующие sheaf-based методы в основном используют sheaf Laplacian как основу для дискретного распространения признаков. В Neural Sheaf Diffusion sheaf обучается вместе с моделью и помогает формировать диффузию на гетерофильных графах. В Sheaf Neural Networks with Connection Laplacians restriction maps вычисляются заранее на основе геометрического выравнивания локальных пространств, что позволяет снизить вычислительные затраты. Другие работы рассматривают совместные диффузионные процессы и оптимизацию спектральных свойств sheaf Laplacian.
Близкий подход предлагает работа Bundle Neural Networks for Message Diffusion on Graphs. Диффузию на векторных пучках после дискретизации можно интерпретировать как частный случай SNN.
Существующие sheaf-based подходы можно условно разделить на две группы:
методы, в которых диффузия реализуется дискретно через sheaf Laplacian
модели типа BuNN, где распространение сообщений описывается непрерывным диффузионным уравнением на векторных пучках, но при обучении дискретизируется
Мы предлагаем другой способ решения диффузионного уравнения — с помощью Physics-Informed Neural Network (PINN).
Physics-Informed Neural Network
Вместо непосредственного численного решения диффузионного уравнения 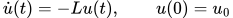 , можно аппроксимировать его решение нейронной сетью
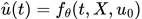 , где
 — параметры сети,
 задаёт структуру оператора, а
 — начальное состояние.
Ключевая особенность PINN — сеть обучается не только по известному решению, но и с учётом самого дифференциального уравнения. Для этого вводится невязка 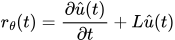 , которая должна быть близка к нулю.
В нашей задаче вместо обычного в невязку входит sheaf Laplacian. Таким образом, PINN не заменяет математическую структуру модели, а аппроксимирует решение диффузионного уравнения.
В статье мы рассмотрим две реализации нейросетевой модели для классификации вершин графа. В первой PINN обучается совместно со всеми слоями модели под конкретную задачу. Во второй применяется подход, где используется предварительно обученная сеть (pre-trained PINN). Веса модели инициализируются результатами предварительного обучения, после чего замораживаются.
Предобученная PINN для действия матричной экспоненты
Рассмотрим подробнее, как устроена и обучается PINN, которая во втором варианте заменяет вычисление  внутри BuNN. Ниже — её упрощённое описание.
Какую задачу решает сеть
Сеть обучается не для одной конкретной матрицы, а для целого семейства задач Коши 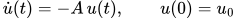 , где
 — кососимметричная (
 ) ленточная матрица с
 ненулевыми наддиагоналями. Точное решение
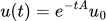 .
Экспонента кососимметричной матрицы ортогональна, поэтому 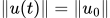 при любом
 : решение изменяет направление вектора, но не его длину. Мы используем это свойство при обучении PINN: оно даёт устойчивую динамику и сохраняет норму решения.
Ортогональные матрицы, возникающие как экспоненты кососимметричных матриц при обучении PINN, — не то же самое, что ортогональные преобразования в BuNN. В BuNN такие преобразования используются при построении bundle Laplacian, который затем определяет диффузионный процесс.
Кроме того, для кососимметричной матрицы  выполняется
 . Поэтому в энергетической оценке этот член не влияет на изменение нормы ошибки. Аналогичную оценку через невязку можно получить и для рассматриваемой системы.
Действие матричной экспоненты  на начальный вектор можно вычислять разными численными методами. В эксперименте ниже базовый метод — приближение усечённым рядом Тейлора порядка 16. Идея PINN-подхода — перенести основную часть вычислений на этап предварительного обучения, а на инференсе получать приближение решения с помощью прямого прохода нейронной сети.
Вход модели
Плотная матрица  содержит
 элементов, но независимых среди них только
 . Поэтому на вход подаются наддиагоналей
 (дополненные нулями до длины
 ) вместе с начальным состоянием
 — как
 каналов одномерного сигнала:
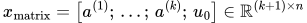 .
Для трёхдиагональной матрицы из BuNN ( ) это всего два канала.
Архитектура FiLM-PINN
Общая схема модели показана на рис. 5. Сеть состоит из двух потоков, которые обрабатывают время и матрицу по отдельности, и блоков слияния.
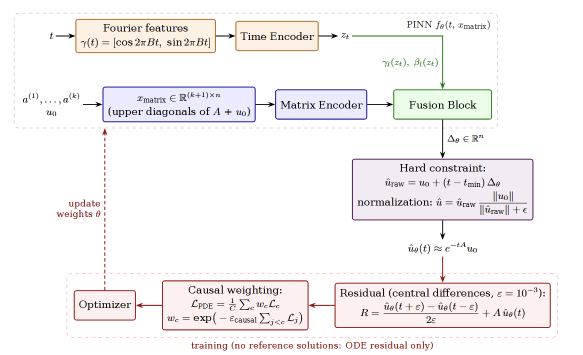
Временной поток. Обычный MLP плохо выучивает высокочастотные функции (эффект spectral bias), а на длинных интервалах решение сильно осциллирует. Поэтому скалярное время сначала отображается в признаки Фурье 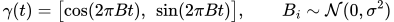 , а затем двухслойным MLP переводится в эмбеддинг
 .
Матричный поток. Вход  проходит через свёртку
 (поднятие до
 каналов) и несколько остаточных блоков из одномерных свёрток.
Выбор свёрток обусловлен структурой задачи:  -я компонента
 зависит только от соседних компонент
 и соответствующих элементов диагоналей. То есть оператор локален — и это хорошо описывает свёрточный фильтр. Число весов свёрток не зависит от
 , поэтому одна и та же сеть подходит для матриц любого размера.
Слияние через FiLM. Самое важное — как время влияет на обработку матрицы. Вместо простой конкатенации признаков используется Feature-wise Linear Modulation: эмбеддинг времени генерирует для каждого блока поканальные коэффициенты масштаба  и сдвига
 :
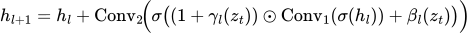 .
Фактически временной энкодер работает как гиперсеть, которая перенастраивает свёрточные фильтры под конкретный момент времени.
Параметризация  делает модуляцию близкой к тождественной в начале обучения.
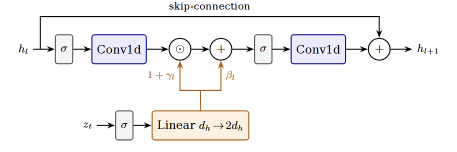
 и
 вычисляются по эмбеддингу времени
 .
Жёсткое начальное условие. Последняя свёртка  выдаёт вектор
 — не само решение, а его приращение. Время нормируется на отрезок
 , причём
 соответствует
 , и предсказание строится как
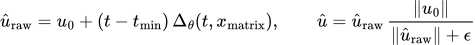 .
Первое равенство гарантирует  по построению (hard constraint), поэтому слагаемое
 в функции потерь не нужно. Нормировка явно сохраняет норму решения, как и положено динамике с кососимметричной матрицей
 .
Обучение
Схема обучения показана в нижней части рис. 5.
Данные. Эталонные решения для обучения не нужны. Элементы диагоналей  и начальные состояния
 семплируются из
 , моменты времени — из
 . Точные значения
 используются только на валидации.
Невязка. Производная по времени вычисляется не автоматическим дифференцированием, а центральной разностью с шагом  :
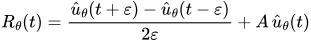 .
Это стоит двух дополнительных прямых проходов, но дешевле и стабильнее, чем дифференцирование по входу через модулированные слои. Аналогичный гибридный подход используется в Chiu et al. 2022.
Произведение  вычисляется сдвигами по диагоналям без формирования плотной матрицы:
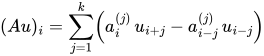 , где выходящие за границы индексы считаются нулевыми.
Причинное взвешивание. В эволюционных уравнениях PINN склонна подгонять невязку на поздних временах раньше, чем решение выучено на ранних. Из-за этого она сходится к неверному решению. Чтобы этого избежать, можно использовать causal weighting: батч сортируется по  и делится на
 последовательных блоков с невязками
 , а итоговая потеря равна
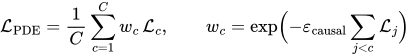 .
Пока невязка на ранних временах велика, поздние блоки почти не влияют на потерю, и сеть учится по порядку — от  вперёд, как численный интегратор.
Оптимизация. Используется Adam с косинусным расписанием скорости обучения ( итераций) и экспоненциальным скользящим средним весов (EMA, коэффициент 0,999), которое и применяется на инференсе. Размерность скрытого пространства
 .
Точность и обобщение
В табл. 1 есть сравнение FiLM с более простыми способами объединения временного и матричного потоков при  и
 : конкатенацией признаков (Baseline) и аддитивным добавлением эмбеддинга времени внутри остаточных блоков (ResNet).
Таблица 1. Относительная ошибка  аппроксимации
 на
 ,
 , среднее по пяти запускам.
Модель | Параметры | Rel. L_2, k=1 | Rel.L_2, k=2 |
|---|---|---|---|
Baseline (конкатенация) | 13,76 тыс. |
|
|
ResNet (сложение) | 29,25 тыс. |
|
|
FiLM Small | 8,54 тыс. |
| — |
FiLM | 32,42 тыс. |
|
|


Даже у FiLM Small, где параметров меньше, чем у Baseline, ошибка почти на порядок ниже. Значит, выигрыш даёт способ учитывать время, а не размер модели. На коротком интервале предсказание FiLM-PINN визуально совпадает с точным решением (рис. 7).
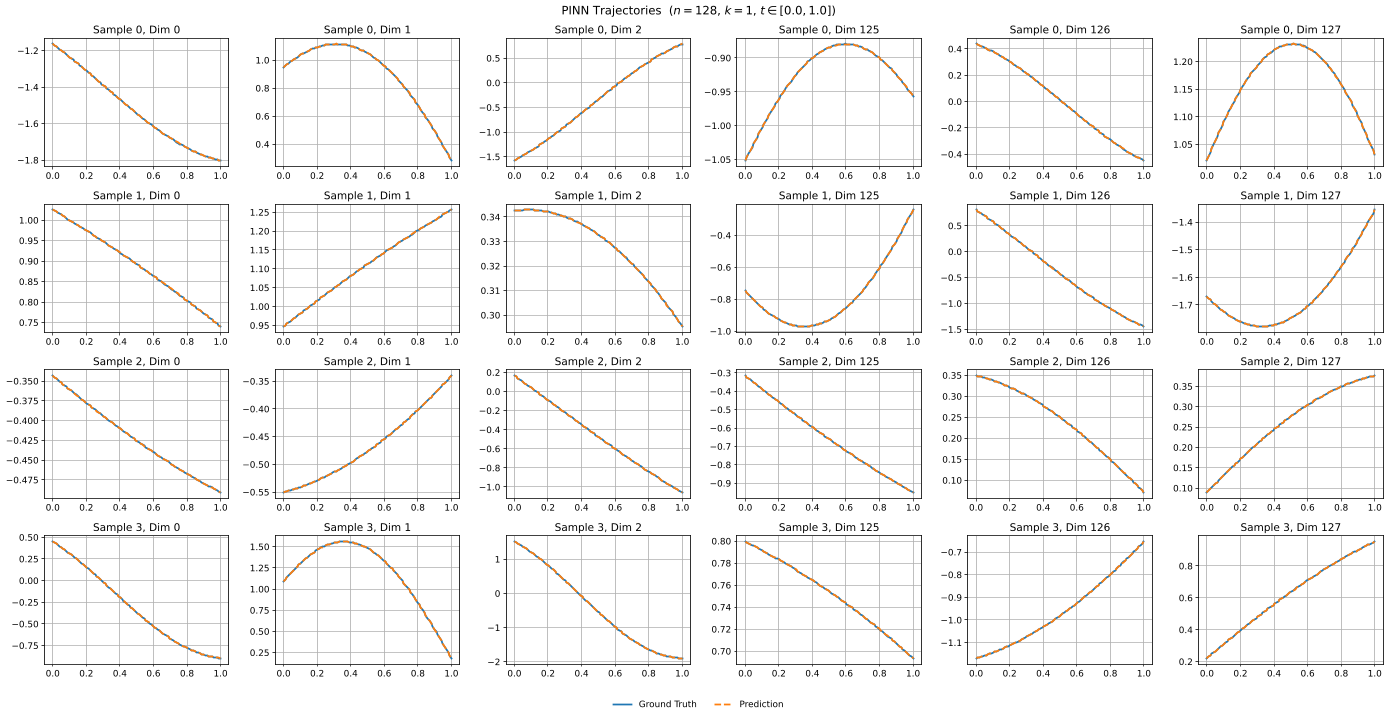
 (сплошная линия) и предсказание FiLM-PINN (пунктир) на интервале
 для четырёх случайных пар
 ,
 ,
 . Показаны первые и последние три компоненты вектора
 .
Длинные интервалы. При  решение сильно осциллирует, и обучать сеть на независимых случайных точках мало: решение расходится при
 . Лучше семплировать батч полными траекториями (много моментов для одной пары
 ). Тогда сеть в целом воспроизводит форму и фазу колебаний. Но к концу интервала накапливаются заметные отклонения по амплитуде и фазе (рис. 8).
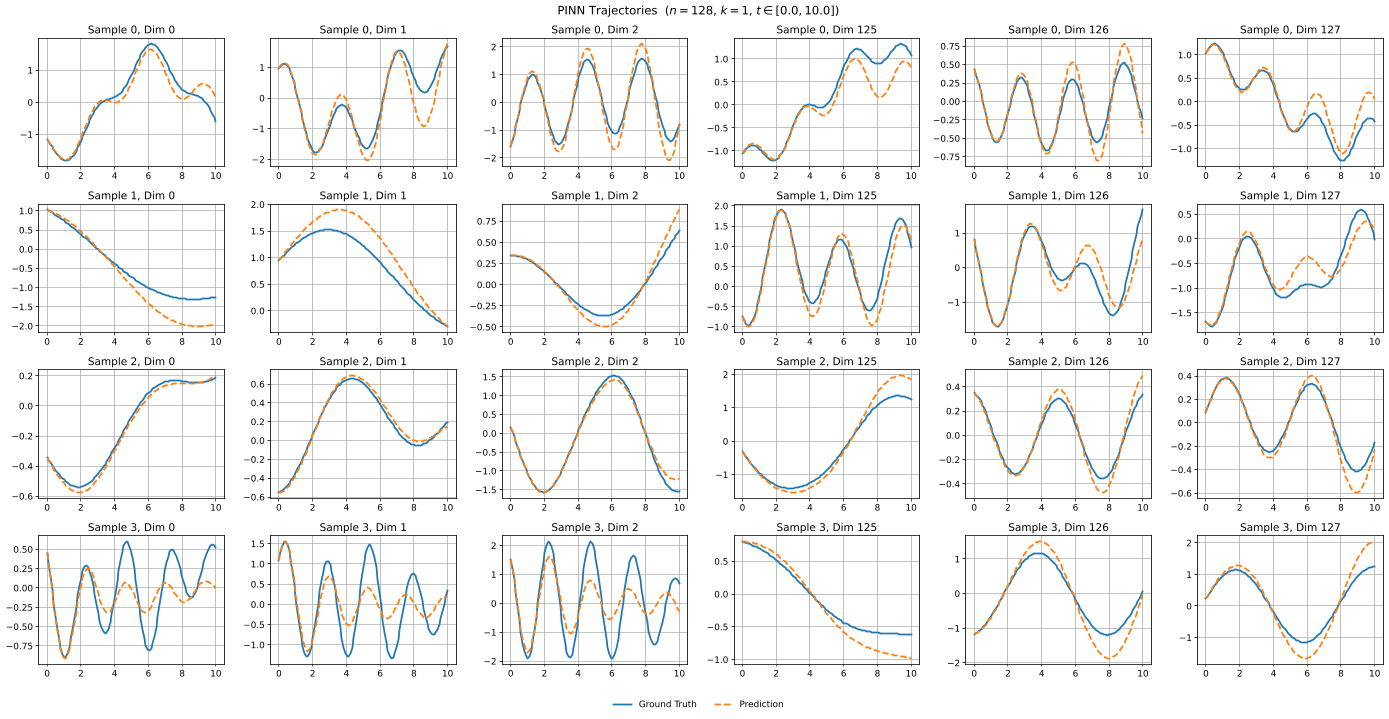
 : FiLM-PINN, обученная на полных траекториях при
 (
 ,
 ).
Гораздо лучше работает другой приём: обучить сеть на коротком интервале  и применять её авторегрессионно. Предсказание
 становится новым начальным условием для следующего отрезка. Это корректно благодаря свойству
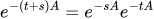 . Относительная ошибка
 на
 при этом составляет 0,0009 против 0,37 при прямой аппроксимации. Авторегрессионная траектория практически совпадает с точным решением (рис. 9).
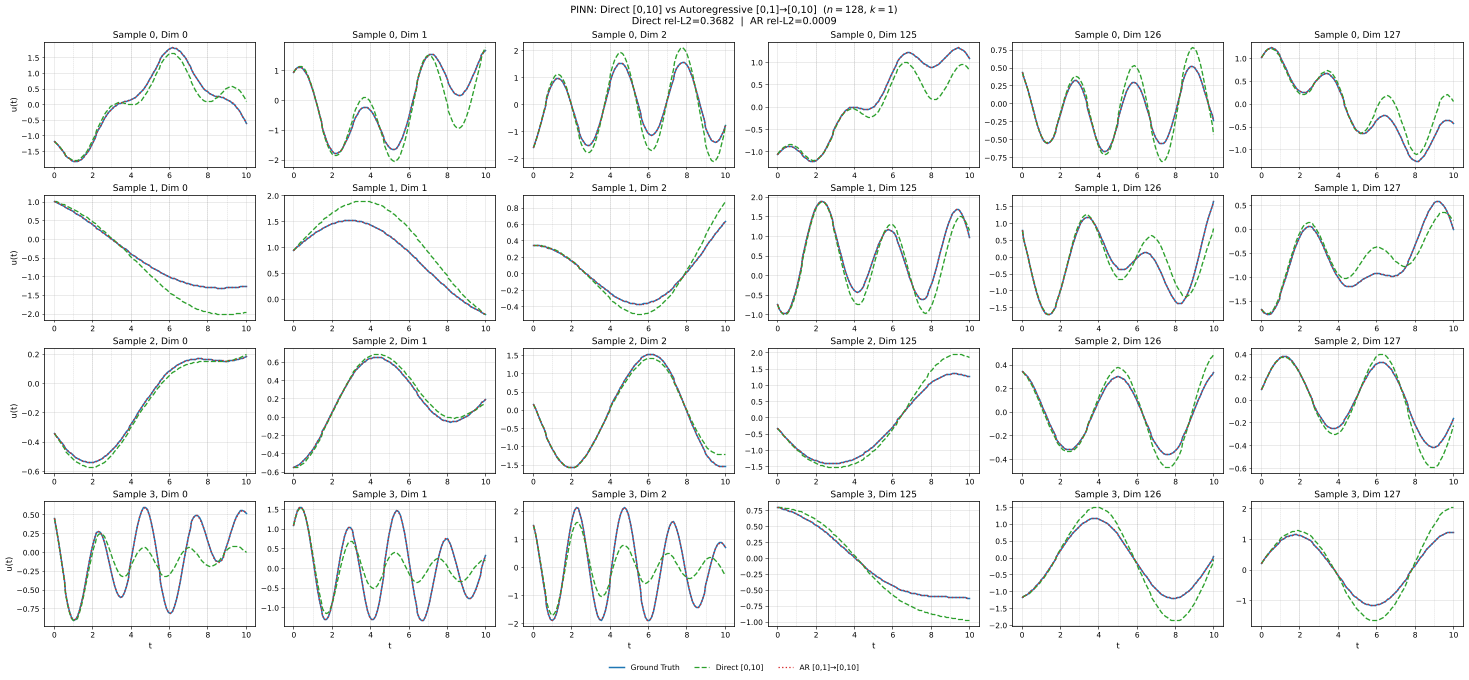
 (зелёный пунктир) и авторегрессионного применения модели, обученной на
 (красный пунктир), с точным решением (синяя линия).
Благодаря свёрточной архитектуре модель переносится на другие размерности без дообучения. Сеть, обученная при  , на матрицах размера от
 до
 сохраняет относительную ошибку на уровне
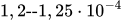 . Именно эта модель с
 (трёхдиагональная кососимметричная матрица) используется дальше в эксперименте с BuNN. После предобучения её веса замораживаются. PINN используется для аппроксимации действия матричной экспоненты
 на начальный вектор
 — в базовом варианте его вычисляют с помощью усечённого ряда Тейлора.
Обзор методов
Мотивация метода с представлением Крылова
Для линейного диффузионного уравнения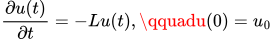 , точное решение имеет вид
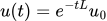 . Основная вычислительная задача связана с действием функции матрицы
 на начальное состояние. Чтобы эффективно представить такое действие, используют подпространства Крылова
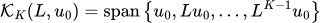 . Krylov-методы широко применяют, чтобы приближать действия матричной экспоненты и решать эволюционные задачи. Они позволяют заменить работу с исходным оператором на операции в подпространстве, порождённом последовательным применением оператора к начальному состоянию (Saad 1992).
В нашей реализации эта идея — не отдельный численный решатель, а представление действия L для нейронной сети. В PINN передаётся последовательность  . Это позволяет сохранять разреженность оператора и не подавать в сеть его плотное представление.
Пусть  — точное решение дискретного диффузионного уравнения
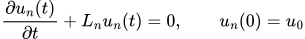 , а
 — его нейросетевое приближение. Определим невязку PINN:
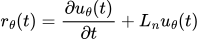 .
Обозначим ошибку приближения через 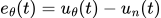 . Тогда из уравнений для
 и
 следует
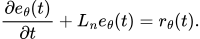
Если  — симметричный положительно полуопределённый оператор, то, умножая последнее уравнение скалярно на
 , получаем оценку
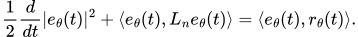
Поскольку для симметричного положительно полуопределённого выполняется 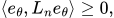 верна оценка
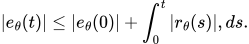
Точность решения PINN контролируют две величины: ошибка начального условия и невязка дифференциального уравнения. Поэтому минимизация 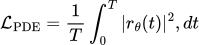 совместно с
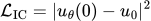 напрямую уменьшает ошибку приближения решения диффузионного уравнения.
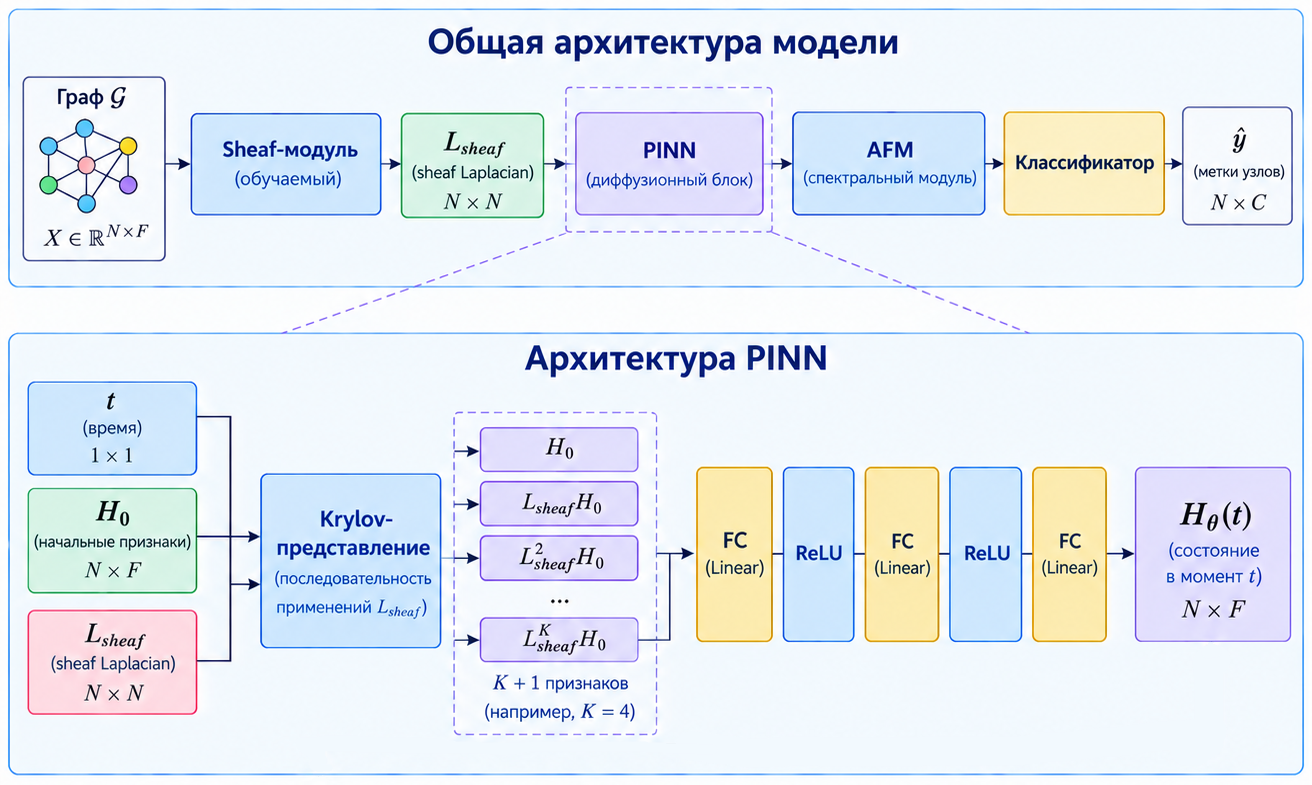
PINN для аппроксимации экспоненты с использованием представления Крылова
Модель объединяет обучаемое sheaf-представление графа, предложенное в работе Y. Choi, J. Choi, T. Ko, J. Kim и C.-K. Kim «Sheaf Graph Neural Networks via PAC-Bayes Spectral Optimization», с физически информированной нейронной сетью (PINN), аппроксимирующей решение уравнения диффузии.
В работе Choi et al. (2026) диффузионная ветвь реализована на основе слоя  , который совмещает диффузию со стохастическим уменьшением дисперсии (Stochastic Variance Reduced, SVR) и адаптивное частотное смешивание (Adaptive Frequency Mixing, AFM). В нашей модели SVR-компонента уступает место PINN, а конфигурация обозначена как
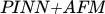 .
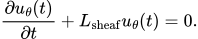
Оператор  строится из обучаемых sheaf-представлений, поэтому его параметры оптимизируются совместно с параметрами PINN. На вход PINN получает начальное состояние , оператор
 и время . Действие оператора передаётся через Krylov-представление
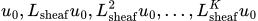 . Это позволяет работать с разреженным оператором без формирования его плотного представления.
Физическое ограничение задаётся через невязку 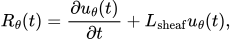 а начальное условие контролируется отдельно:
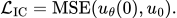
Обучение включает одновременно задачу классификации и ограничения, задаваемые диффузионным уравнением: 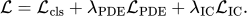
Результаты на тестовой выборке и время инференса. Значения представлены как среднее ± стандартное отклонение по пяти запускам с различными random seed. Метод SVR+AFM приведён из работы Choi et al. 2026. Модели мы отбирали по валидационной выборке.
Таблица 2. Время для этого метода мы замеряли на GPU NVIDIA GeForce RTX 4060, а вычисления запускали через CUDA. Поэтому характеристики времени в таблицах 2, 4 относятся именно к вычислениям на GPU, а не к CPU.
Dataset | Method | Test Accuracy (%) | Inference Time (ms) |
|---|---|---|---|
Cora | PINN+AFM | 81,42 ± 1,25 | 3,76 ± 0,02 |
SVR+AFM | 81,26 ± 1,27 | 6,17 ± 0,05 | |
Citeseer | PINN+AFM | 71,30 ± 0,88 | 4,14 ± 0,02 |
SVR+AFM | 71,36 ± 0,83 | 6,51 ± 0,12 | |
Pubmed | PINN+AFM | 75,46 ± 2,38 | 8,16 ± 0,16 |
SVR+AFM | 77,36 ± 0,50 | 11,61 ± 0,02 | |
Chameleon | PINN+AFM | 49,34 ± 1,28 | 3,43 ± 0,31 |
SVR+AFM | 50,31 ± 1,43 | 10,26 ± 0,18 | |
Squirrel | PINN+AFM | 34,49 ± 1,47 | 7,22 ± 0,11 |
SVR+AFM | 34,70 ± 0,87 | 15,96 ± 0,46 | |
Actor | PINN+AFM | 37,42 ± 0,98 | 2,95 ± 0,06 |
SVR+AFM | 36,39 ± 0,49 | 9,85 ± 0,22 | |
Cornell | PINN+AFM | 76,76 ± 2,42 | 2,64 ± 0,40 |
SVR+AFM | 78,38 ± 1,91 | 4,30 ± 0,64 | |
Texas | PINN+AFM | 79,46 ± 1,48 | 2,65 ± 0,14 |
SVR+AFM | 82,16 ± 4,10 | 3,11 ± 0,14 | |
Wisconsin | PINN+AFM | 80,39 ± 1,39 | 2,61 ± 0,04 |
SVR+AFM | 80,78 ± 1,64 | 5,05 ± 0,70 |
PINN для аппроксимации матричной экспоненты в BuNN
Кроме аппроксимации sheaf diffusion через Krylov-представление, мы рассмотрели отдельный вариант использования PINN внутри Bundle Neural Networks. Здесь мы берём заранее обученную PINN, которая аппроксимирует действие матричной экспоненты: 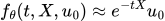 .
После предварительного обучения параметры PINN замораживаются. При обучении графовой модели PINN используется для аппроксимации действия матричной экспоненты на вектор с помощью прямого прохода нейронной сети. Таким образом, она заменяет исходный численный метод вычисления этого действия.
В качестве baseline мы взяли приближение экспоненты усечённым рядом Тейлора порядка 16:
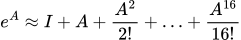 .
В эксперименте мы сравниваем два способа вычисления действия одной и той же матричной экспоненты на вектор:
аппроксимация усечённым рядом Тейлора порядка 16;
предварительно обученная PINN.
Низкоразмерная параметризация
В этой реализации оператор задаёт кососимметричная трёхдиагональная матрица
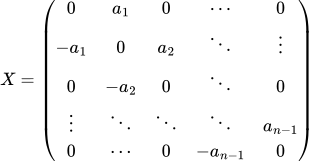 .
Поэтому вместо передачи всех  элементов матрицы достаточно задать вектор
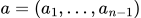 .
В наших экспериментах  , поэтому матрицу определяют 63 параметра.
Эксперимент с BuNN
Все эксперименты проводились на CPU MacBook Air с процессором Apple M4 без использования GPU. Поэтому время работы ниже соответствует вычислениям на CPU.
Перед запуском экспериментов на графовых датасетах мы отдельно проверили, насколько хорошо PINN воспроизводит действие матричной экспоненты, полученное с помощью Taylor-16.
При размере батча 2708 время вычисления составило 263,19 мс для PINN и 438,18 мс для Taylor-16, что соответствует ускорению в 1,66 раза.
При этом относительная ошибка составила undefined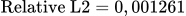 , а cosine similarity между результатами двух методов:
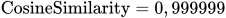 .
В этом тесте PINN практически воспроизводит результат Taylor-16, но требует меньше времени на вычисление.
Таблица 3. Сравнение PINN и Taylor-16 внутри BuNN.
Dataset | PINN acc. | Taylor acc. | PINN, ms | Taylor, ms | Speedup |
|---|---|---|---|---|---|
Cora | 0,455 | 0,312 | 360,5 | 484,5 | 1,34 |
CiteSeer | 0,388 | 0,192 | 400,1 | 595,1 | 1,49 |
PubMed | 0,627 | 0,632 | 3361,7 | 5357,8 | 1,59 |
Результаты и выводы
Мы рассмотрели подход к моделированию sheaf diffusion с помощью Physics-Informed Neural Network. В отличие от дискретного применения диффузионного оператора, наша модель аппроксимирует зависящее от времени решение диффузионного уравнения. Корректность этого решения контролируют невязка уравнения и начальное условие.
Важная часть метода — использование Krylov-представления, в котором PINN получает последовательность применений sheaf Laplacian к начальному состоянию. Это позволяет передавать информацию о действии разреженного оператора без формирования его плотного представления.
PINN не увеличивает точность классификации однозначно на всех рассматриваемых датасетах. На части наборов данных результаты методов близки, но на других есть различия в пользу одного из подходов. Так что по этим экспериментам нельзя сказать, что PINN универсально улучшает качество классификации.
Зато измерения времени инференса показывают более устойчивое различие между двумя подходами. Диффузионная ветка PINN работает быстрее соответствующей SVR-ветки на всех рассмотренных датасетах.
Результаты показывают, что PINN можно использовать как альтернативный способ реализации sheaf diffusion в обучаемой графовой модели. Главный эффект подхода в наших экспериментах — снижение вычислительных затрат диффузионной ветки при сопоставимом порядке точности. Но влияние PINN на качество классификации нужно исследовать на большем числе конфигураций и датасетов.
Также мы рассмотрели вариант, где предварительно обученная PINN аппроксимирует действие матричной экспоненты внутри Bundle Neural Networks. Отдельный тест показал, что результаты PINN и Taylor-16 близки: относительная ошибка составила 0,001261, а cosine Similarity — 0,999999.
Внутри BuNN PINN оказался быстрее Taylor-16 на всех трёх рассмотренных датасетах. Полученное ускорение составило от 1,34 до 1,59 раза. При этом accuracy на всех трёх датасетах осталась сопоставимой либо увеличилась.
Две серии экспериментов показывают, что PINN подходит не только для прямой аппроксимации sheaf diffusion. Она может аппроксимировать действия матричной экспоненты в рассмотренной реализации Bundle Neural Networks.
Перспективное направление для дальнейшей работы — исследовать влияние размерности Krylov-представления, весов  и
 , а также параметров PINN на точность и вычислительную стоимость модели.
Таблица 4. Время инференса диффузионной ветки для PINN и SVR. Значения представлены как среднее  стандартное отклонение по пяти запускам и указаны в миллисекундах
Dataset | PINN Diffusion (ms) | SVR Diffusion (ms) |
|---|---|---|
Cora | 0,671 ± 0,006 | 3,152 ± 0,032 |
Citeseer | 0,684 ± 0,006 | 3,098 ± 0,042 |
Pubmed | 1,674 ± 0,046 | 5,225 ± 0,021 |
Chameleon | 0,567 ± 0,088 | 7,558 ± 0,126 |
Squirrel | 0,595 ± 0,014 | 9,354 ± 0,317 |
Actor | 0,795 ± 0,013 | 7,764 ± 0,153 |
Cornell | 0,633 ± 0,092 | 2,497 ± 0,644 |
Texas | 0,631 ± 0,050 | 1,320 ± 0,135 |
Wisconsin | 0,615 ± 0,020 | 3,232 ± 0,708 |
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.