Morse AI
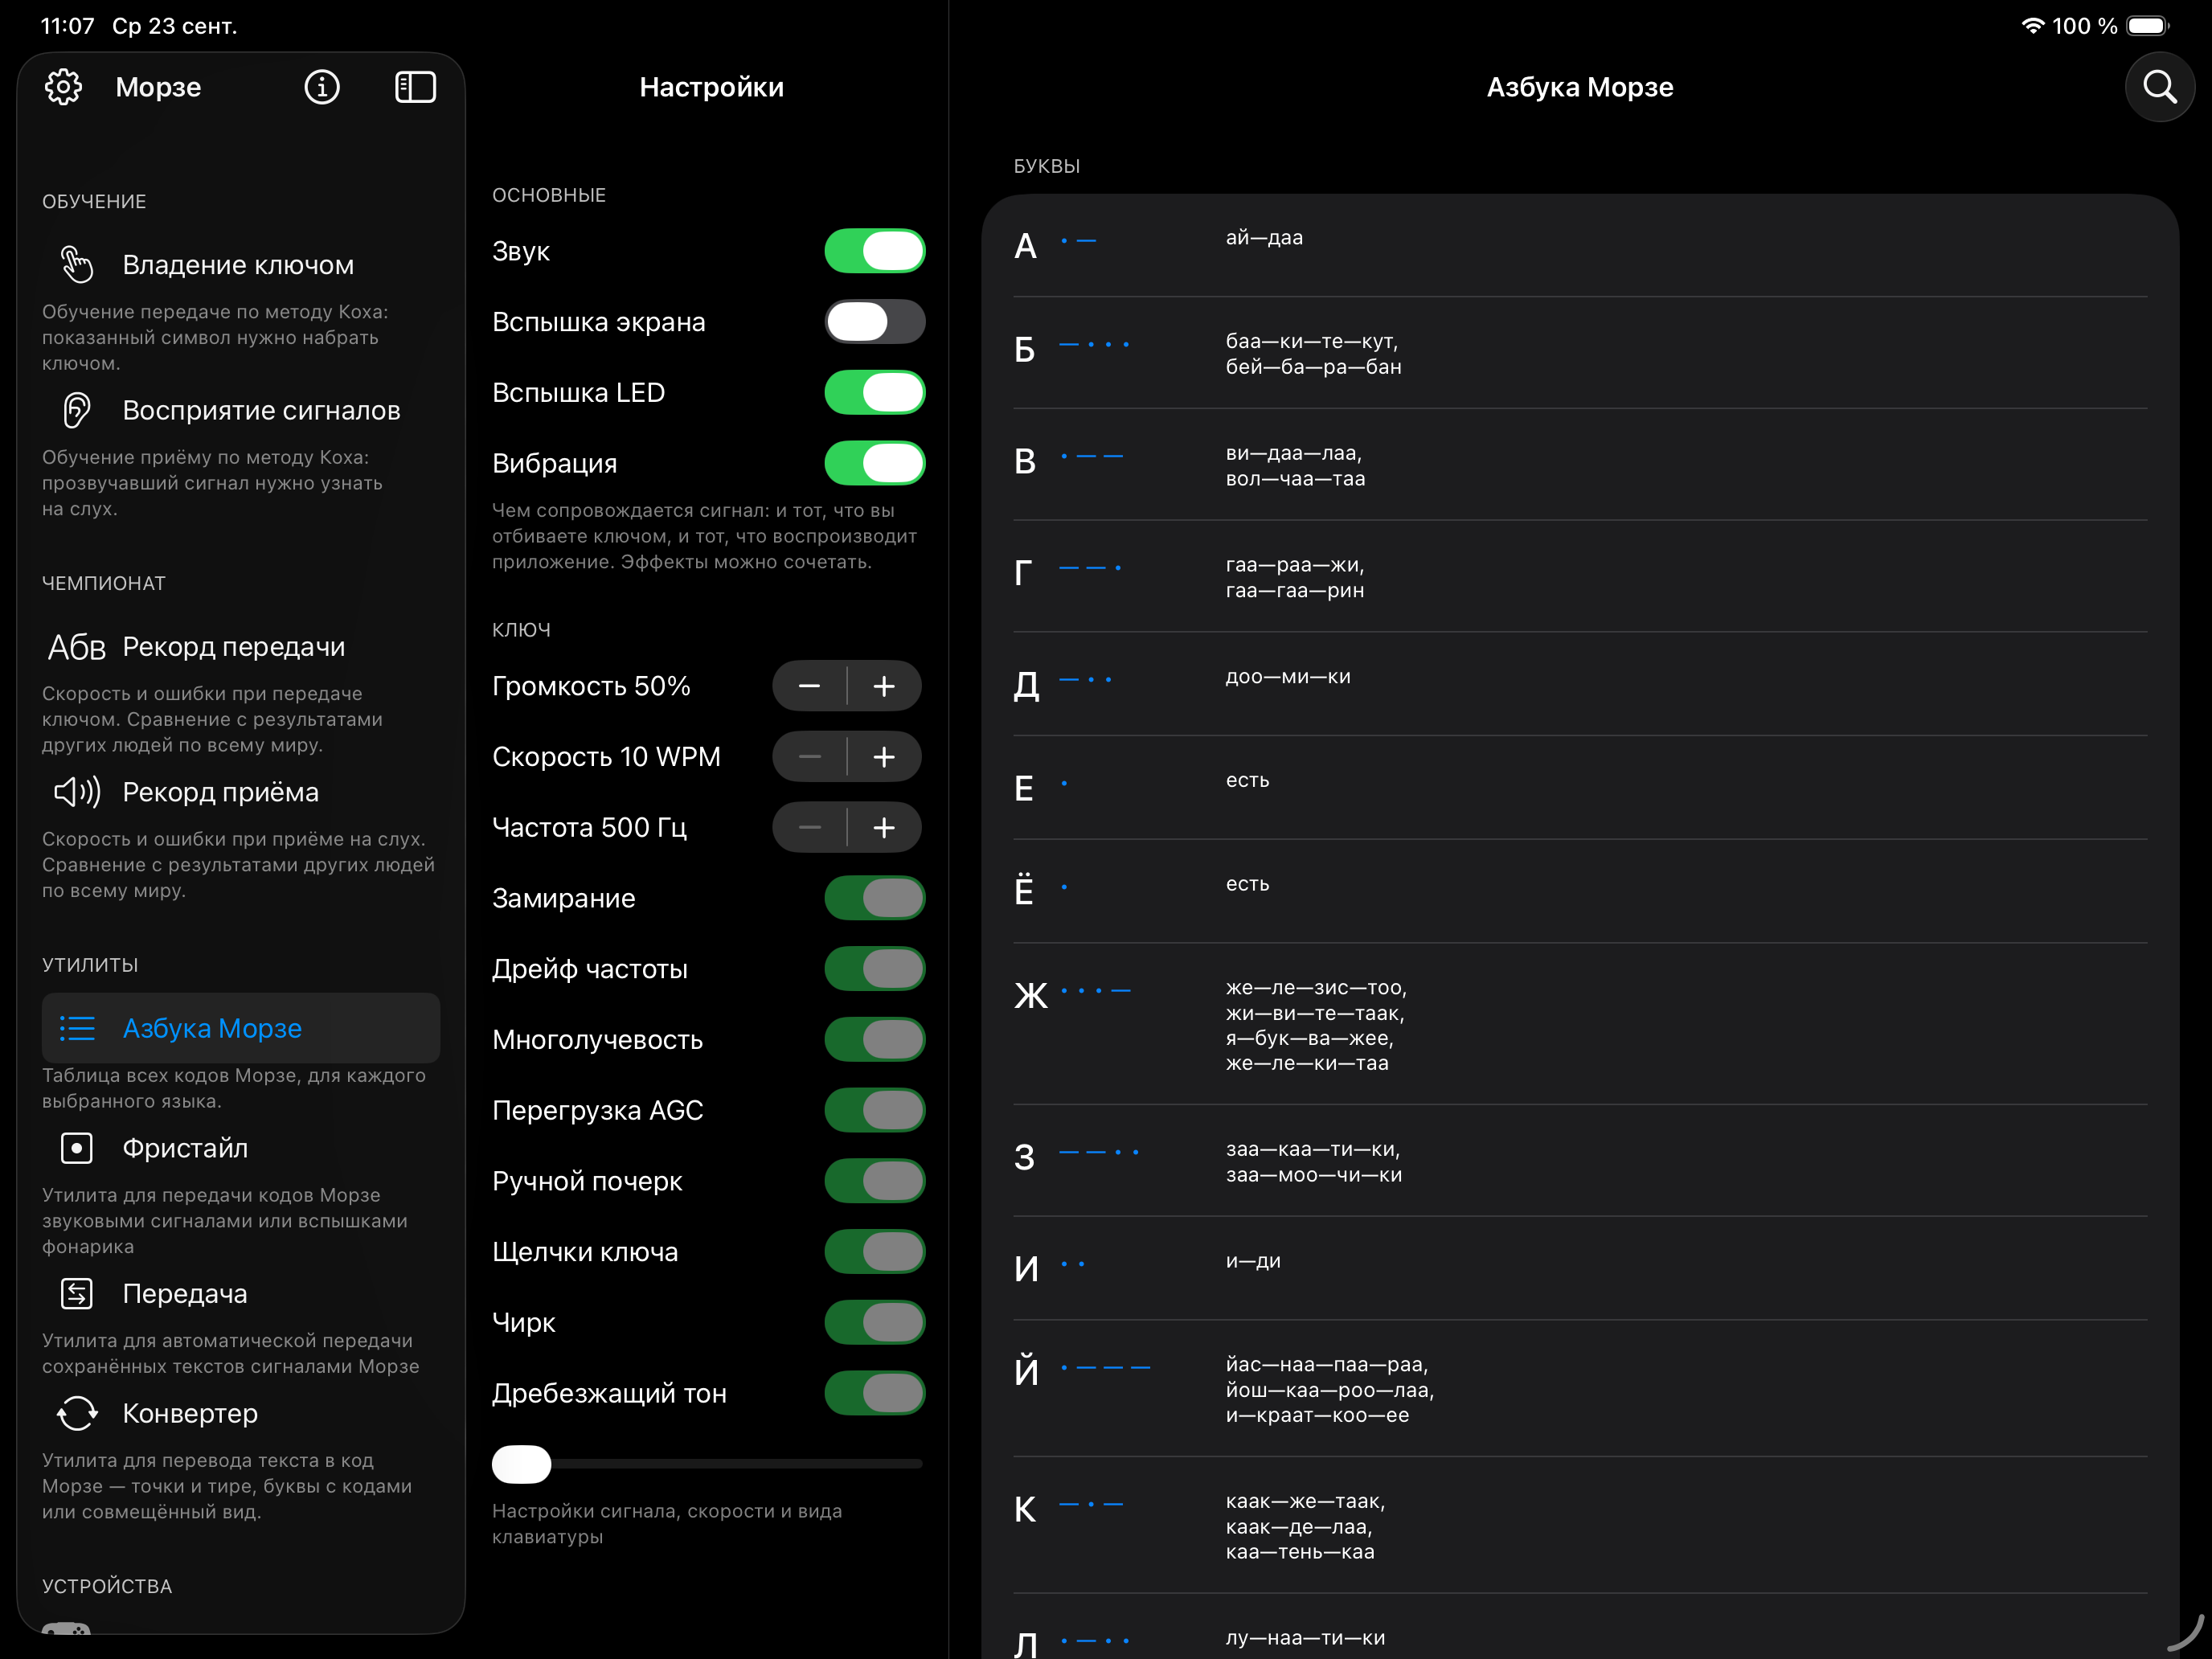
Я долго думал как назвать статью, но выбрал именно такое название, модное, а может уже и сильно надоевшее с приставкой AI. Уже понятно, что речь пойдет про нейронки, но при чем тут Морзе? Сейчас расскажу!
Ни для кого не секрет, что азбука Морзе используется буквально везде где требуется передать данные на большие расстояния через бури и штормы, через шум грозы, через ... в общем хоть ложкой по батарее. Морзянка, спасала жизни, помогала найти затерянные суда и самолеты. Даже сейчас, для капитана судна, или пилота самолета знание азбуки Морзе это требование, которое продиктовано безопасностью в крайней ситуации.
В давние-давние времена, когда еще царил флеш, а я был молод и красив, я решил сделать классную программу по морзянке. Полную историю можно почитать здесь, если кому-то действительно интересно. В результате этого эксперимента и череды итераций по улучшению получилось неплохое приложение с широким функционалом, которому все же было куда расти.
Проблемы легаси с двух ног
Мой проект приложения был целиком и полностью написан руками на Objective-C, поддерживался и исправно работал, но не обновлялся по разным причинам уже более 5 лет. И первой задачей, которой нужно было заняться, стал запуск приложения. В проекте устарело буквально всё, начиная от интерфейса и заканчивая ядром системы. Что делать, если времени на проект нет? Использовать ИИ.
Первое, что я сделал, это перевел проект на чистый macOS, так как раньше использовался Catalyst, а проблем с ним хватало и тогда. Второе, что я сделал, перевел весь Objective-C код на Swift и начал миграцию со сторонних библиотек, которые смотрели на CocoaPods. А затем перевел на Swift и само ядро.
Кстати, я сильно сомневался в том, что смогу перенести ядро на Swift, так как вся генерация сигнала была на чистом C! И сделано это было не по прихоти моей, а потому что даже Objective-C давал невероятную задержку и быстрые сигналы просто невозможно было генерировать. Кстати, именно это изначально отличало мою программу от остальных.
После переноса на Swift был переделан интерфейс на SwiftUI, а затем проведена череда крупных доработок и улучшений. На данный момент от старой программы не осталось и строчки кода, всё переписано с Claude целиком и полностью, под моим чутким руководством и пристальным вниманием.
Пара слов про переводы и ИИ
Раньше приложение я переводил вручную для тех стран где активность приложения была максимальной и одной из таких стран был Китай. Перевод на китайский я делал вручную привлекая китайцев, но у нас в руках есть сильнейший инструмент!
Но просто сделать перевод интерфейса это лишь часть работы, а как же AppStore... в нем нужны и картинки и подписи к ним и скриншот интрефейса сделанный на языке носителя. Для этого были сделаны питон файлы, запускающие приложение и снимающие скриншот в нужное время в нужном месте. Далее к каждому скриншоту нужны были подписи и красивый фон, все это так же заняло время, но результат получился великолепным.
Помимо переводов интерфейса, есть такая вещь как перевод самой таблицы Морзе. Суть здесь в том, что некоторые страны используют свои таблицы Морзе, а некоторые используют международную латиницу. Например Японская Морзе использует слоговую азбуку, Китайская использует unicode и сокращения, а Индийская и Тайская свои специальные комбинации.
Недолго думая интерфейс приложения был переведен на 60 языков мира, причем нейронки делают это очень классно, практически на языке носителя. Делают быстро, но проверять заними нужно. Что бы не было дефектов, я прогонял все переводы через две конкурирующие нейросетки, одна от Клода, вторая от Кодекса. Результатом стали великолепные переводы для всех 60 языков.
Таким образом у меня появилось буквально 37! азбук, с которыми пришлось долго возиться внедряя в свою архитектуру те хитрые практики которые они используют. Интеграция идет на уровне ядра, т.к. ввод с ключа так же должен позволять вбивать эти хитрые комбинации. Даже если они приходят с телеграфного ключа подключенного через адаптер.
Админка и ИИ
Куда уж без админки... В старом прилижении обратная связь происходила довольно просто, при нажатии проверялась возможность юзера написать разработчику в iMessage, а если возможности не было формировалось письмо. Мне хотелось улучшить этот опыт максимально.
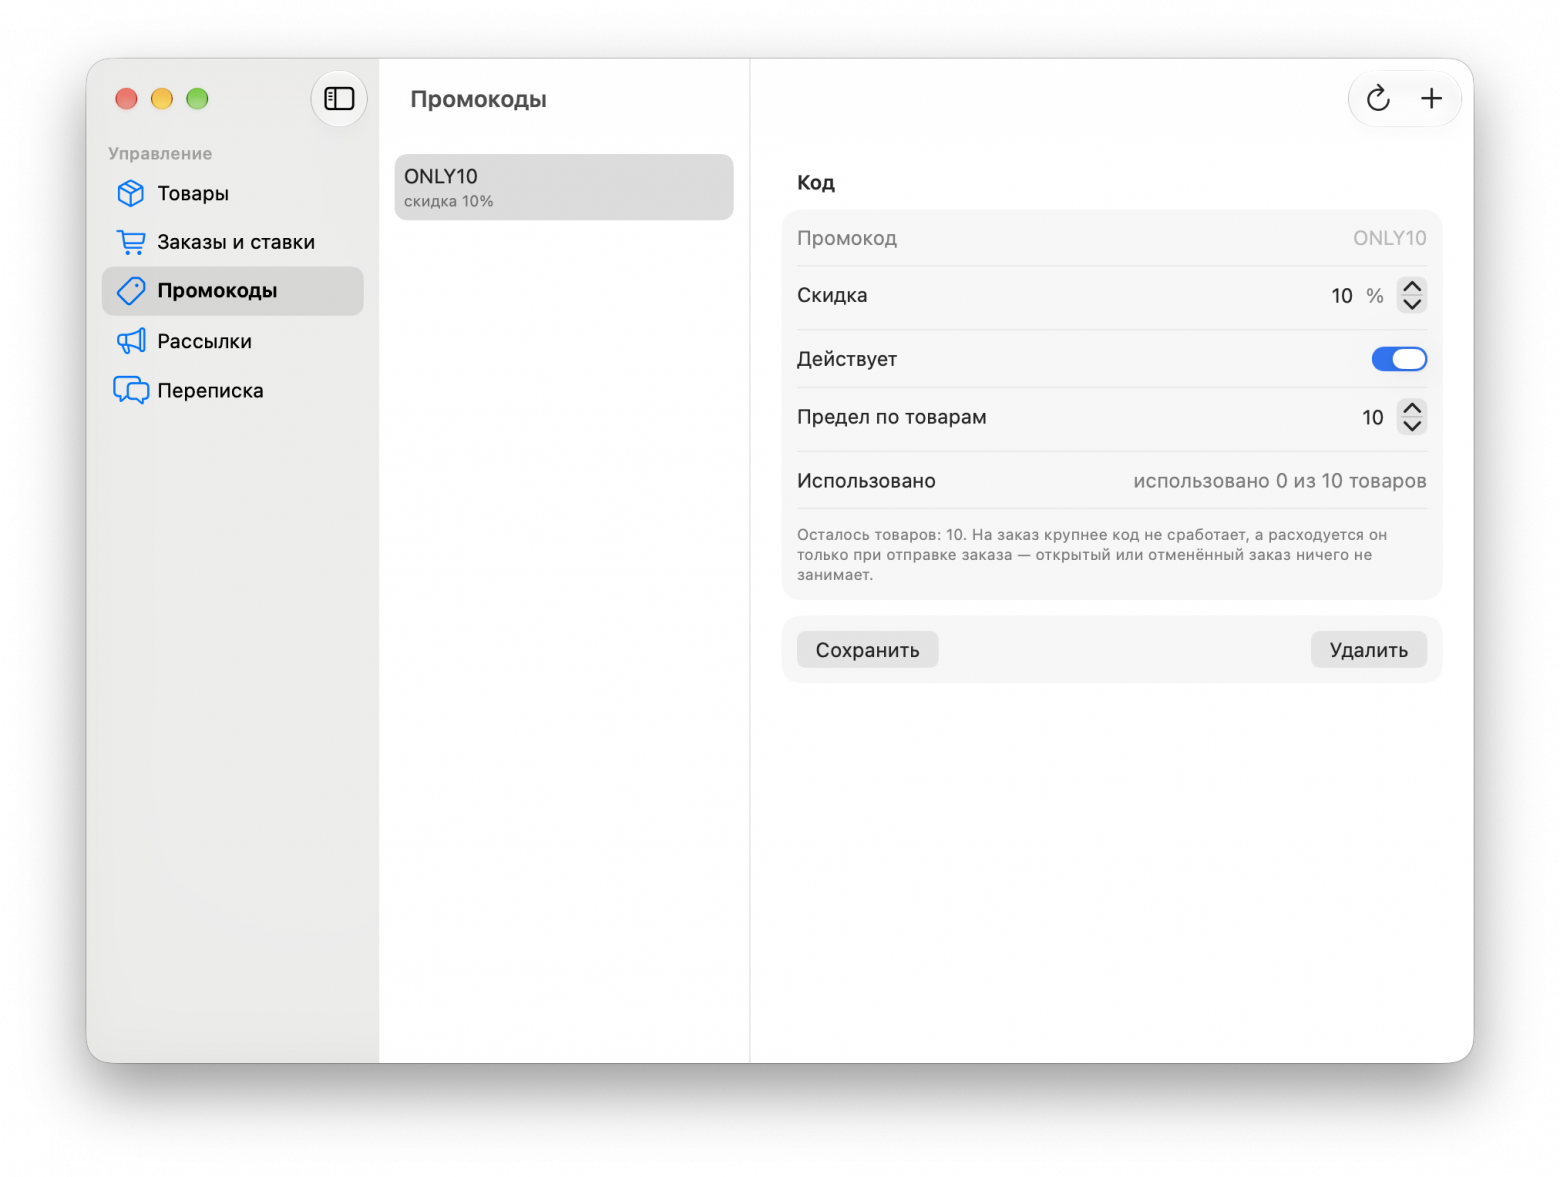
Поэтому была сделана отдельная админка, для работы с продуктом: рассылки, аукционы физических товаров, промокоды, а так же обратная связь с каждым в чате, с поддержкой видео и фото.
Так как приложение стало мультиязычным, в админку по работе с киентами был интегрированы модели для перевода текста от каждого кто пишет в службу поддержки, с обратной конвертаций на язык человека от службы поддержки. Такой простой механизм который по прежнему нигде не используется.
И это все?
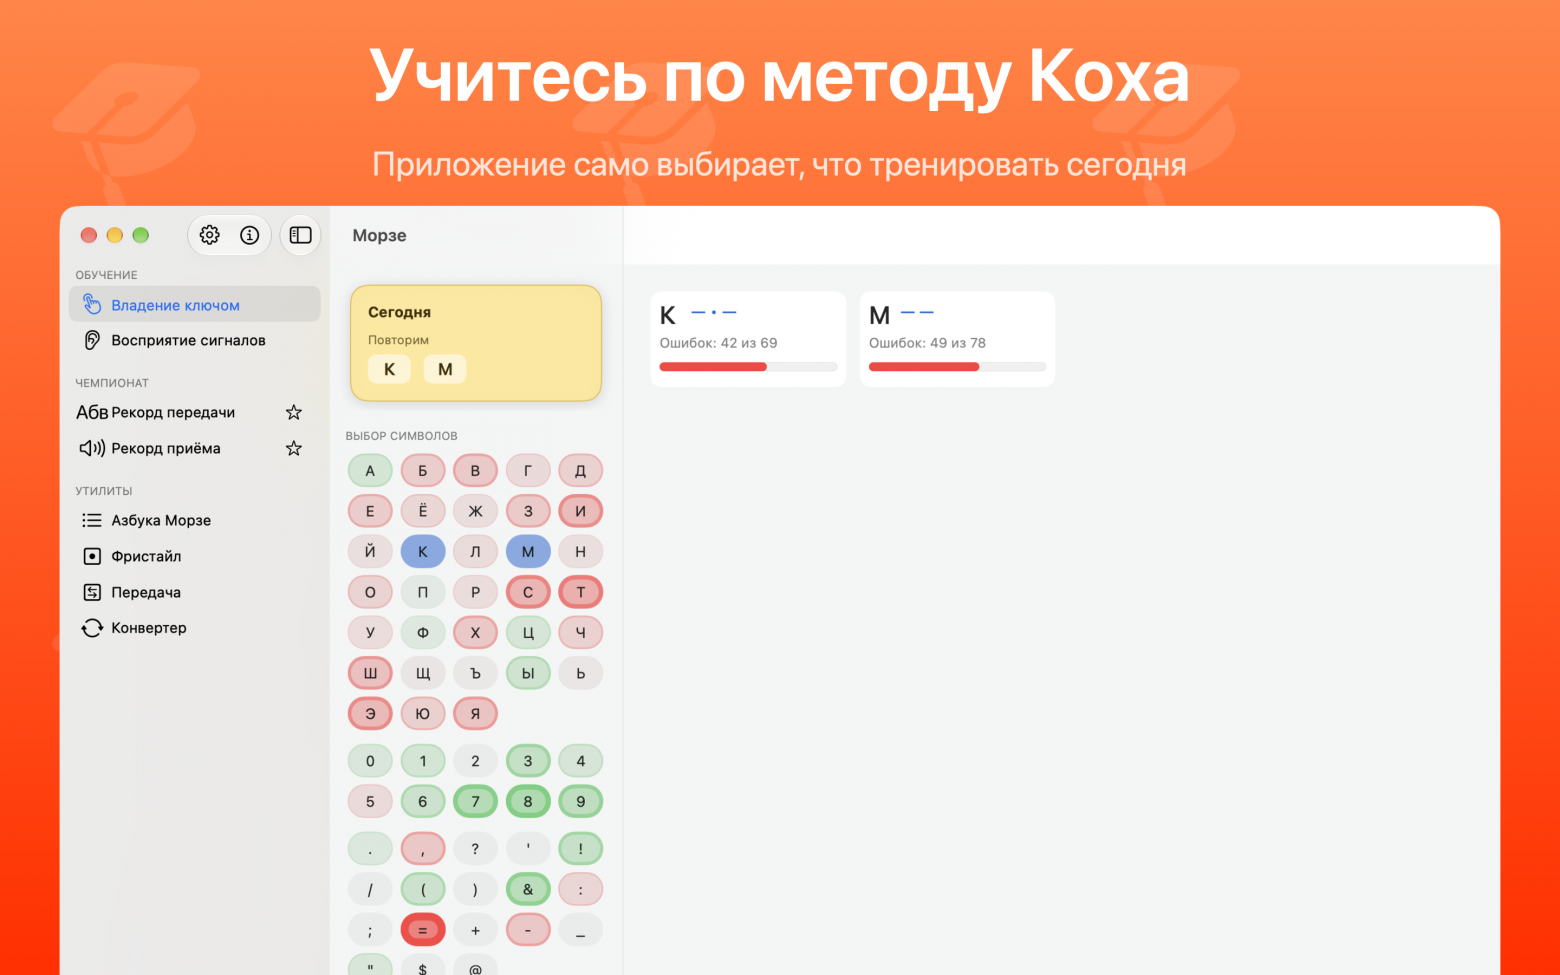
Нет не всё, в приложении есть раздел заточенный на обучение, где переделано буквально всё, по современным научным методологиям. Приложения раньше поддерживало лишь обучение по группам символов, а теперь само подбирает правильные пары с обучением по Коху. При этом нокто не мешает так же прорабатывать свои группы символов как раньше.
Так же после обучения должен быть и процесс тестирования своих знаний. И он так же был переделан, переделан так как это происходит на мировых соревнованиях. Группы символов, время, ошибки, все как на настоящих соревнованиях по Морзе.
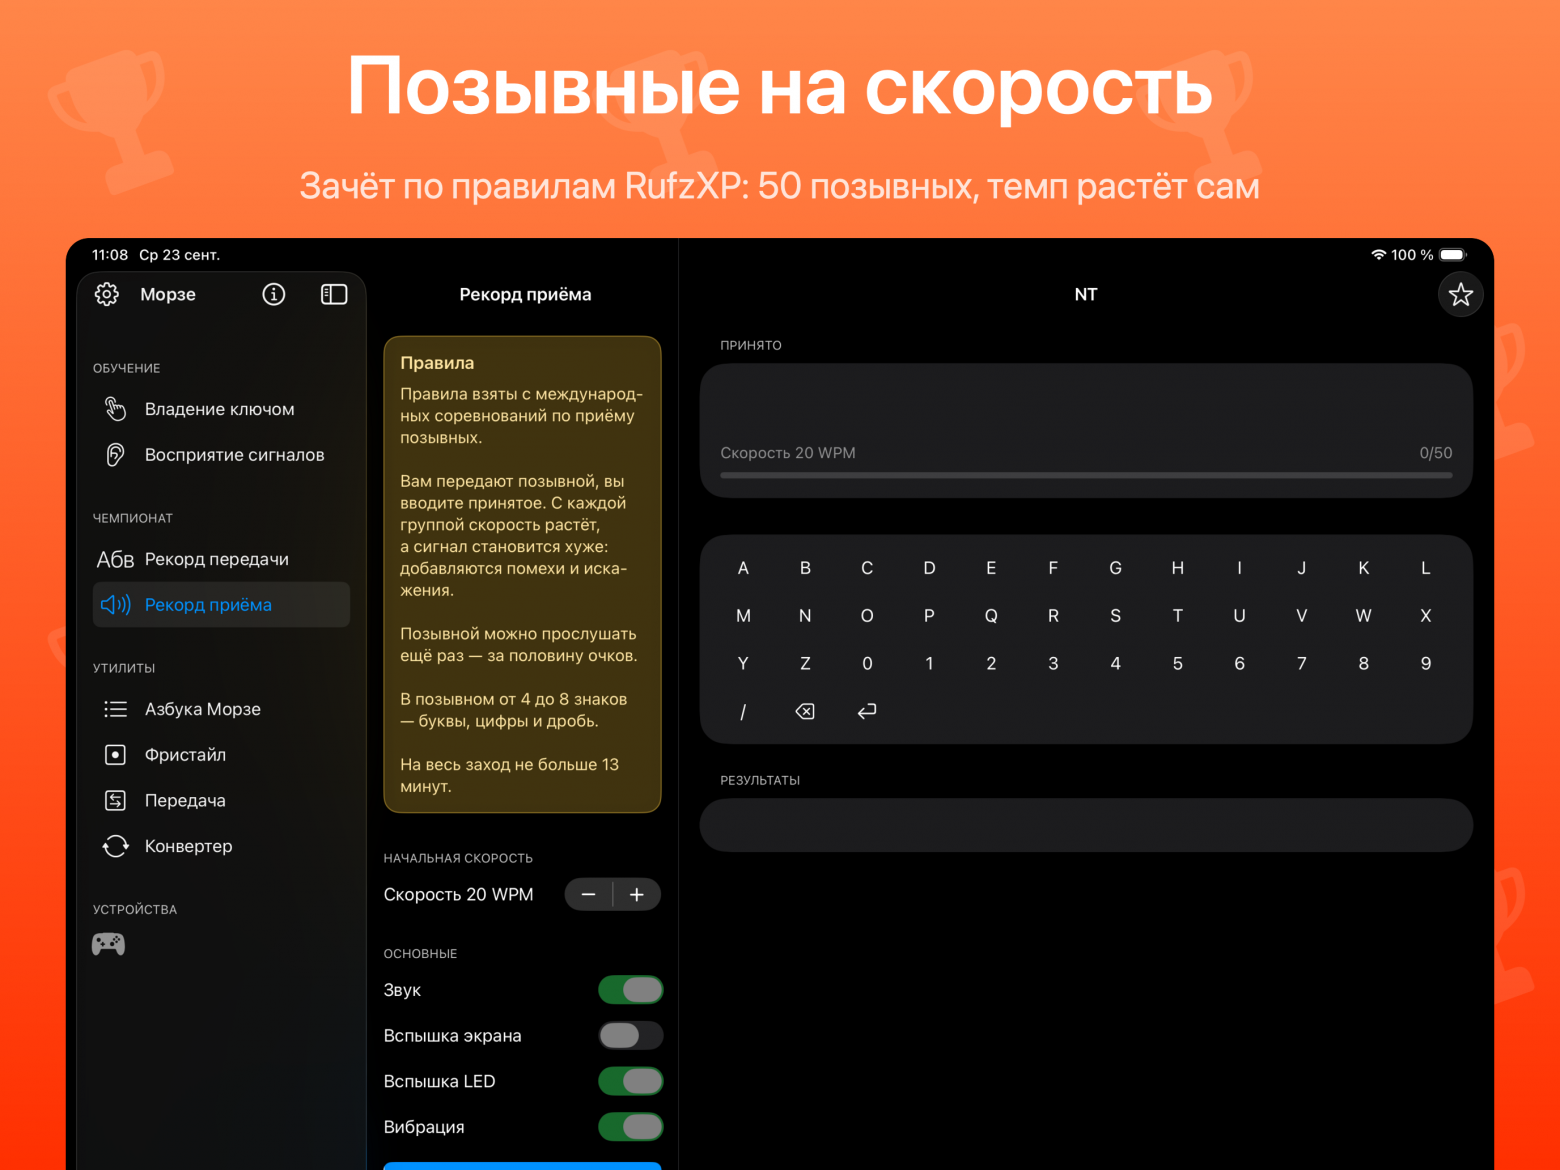
Переделаны расчеты прогресса обучения, теперь они показывают те символы на которые нужно обратить внимание при изучении, где человек совершает больше ошибок.
Неплохой слой измнений? Да и всё это сделано по вечерам и выходным с несколькими аккаунтами клод и кодекс. Лимиты легко улетали за один вечер.
Да, работа была проделана колоссальная и в короткое время, но осталось one more think.
Про нейронки и AI
В итоге приложения стало максимально полным, но оставалась последняя деталь, которая долго мне не давалась, это дешифровка морзянки прямо из радиоэфира. Причем не просто дешифровка, а распознавание сложного, шумного эфира, где даже человек-профессионал с трудом сможет что-то услышать. И не просто одной станции а сразу нескольких одновременно.
И надо сказать, этот функционал я хотел добавить в приложение уже давно, скажем так, с самого начала его создания. И кое что уже было реализовано на алгоритмах. Например, когда человек работает с ключом, он должен отбить точку и тире примерно правильной длины, а алгоритм в приложении должен это понять. Такое сделать довольно просто, используя цепи Маркова или используя другие адаптивные алгоритмы. Это отлично работает для ключа, но вот применять эти же подходы для чтения эфира очевидно провальная идея.
Когда я только пилил певую версию своего приложения, про нейронки ещё не знали, ну, точнее, не знали так сильно. Ведь в институте я даже делал проекты, где простая однослойная сетка распознавала рукописный ввод. Но чтобы вот так научить сеть слушать эфир? Прошло несколько лет, мощности железа подросли, и уже стали появляться некоторые проекты, связанные с нейронками и Морзе. Это были исследования на сайтах зарубежный иссследовательских институтов с небольшими примерами датасетов и оценкой тех или иных сетей.
Помню, как лет пять назад пробежался по готовым проектам, чтобы посмотреть, а что там есть-то вообще, и нашел несколько интересных решений... не одно, а несколько! Но всё, что было найдено, работало не супер. К тому же было заточено либо на определенную скорость приема, либо на чистый звук, либо на один-единственный канал приема.
Немного поковыряв готовые решения, я бросил это дело, так как банально не хватало времени на все проекты. Но месяц назад я вернулся, чтобы уже точно доделать начатое — прошло долгих 12 лет. Решение стало таким: натренирую свою сеть, тем более что железо уже позволяет. На моем MacBook Air M3 тренировка занимает не так много времени, как 5 лет назад на процессоре Intel, и уж совсем не так, как 12 лет назад.
Для почти любой нейронки требуется датасет с данными или «учитель» уже натренированная крутая модель, которая обучит «ученика», проведет «дистилляцию». Большая нейронка обучает мелкую, причем процесс этот происходит иногда лучше за счет того, что большая модель обучается на датасете с разметкой, а вот ученик обучается не только на разметке, но и на ответе учителя: что вот здесь сигнал нечеткий, а вот здесь смотри, совсем плохой и т.д.
Когда я изучал готовые сетки, в том числе исследования в больших зарубежных институтах, я видел, что данные, на которых нейронки обучались, брались с разметкой по буквам. Это значит, что, например, мы берем аудиофайл, затем делаем запись: вот точка-тире звучит с 1-й секунды по 3-ю, это символ «А». И так далее по всему датасету. Таким образом ИИ тренируется сопоставлять и классифицировать элементы звука с теми символами (токенами), которые прописаны в файле, то есть, фактически, она училась говорить только на английском.
Если следовать такому подходу, мне бы пришлось тренировать 37 нейронок, да-да, именно 37 нейронок! под разные локальные языковые таблицы Морзе, например под японскую, тайскую или любую другую. Язык Морзе универсальный, это точки, тире и паузы между ними, так почему бы не сделать одну универсальную сеть, которая бы работала на уровень ниже? Чтобы это заработало, датасет нужно было бы размечать так: точка с секунды 1.23 до 1.27 и так далее. Это была лишь гипотеза, но именно таким образом были сформированы требования.
до 16 станций одновременно в полосе SSB-приёмника, около 2,5–3 кГц;
скорость от 5 до 100 WPM, ручной ключ, ямбический и машинный;
шумный эфир: замирания, помехи, цифровые сигналы, перестройка приёмника, комната и микрофон телефона;
на выходе элементы: точка, тире, границы букв и слов, а не буквы. Буквы из элементов собирает приложение;
минимальная энергия: модель работает на телефоне потоково, без заглядывания вперёд;
одна обучаемая нейросеть без предфильтров, принимающих решения. Пороговые и полосовые фильтры перед сетью сознательно не используются, чтобы не терять слабые станции.
Всё дело в правильных тренировках
Теперь вернемся к тому, что требуется для тренировки. И, как я уже говорил, требуется датасет. Датасет это огромное количество данных с разметкой, на которых нейросеть начинает формировать свои векторы классификации, обучается на этих данных. Чем качественнее и правильнее подготовлены данные, тем лучше. Как я уже писал выше, получить такой огромный датасет это та еще задачка, а уж разметить эти данные вручную это вообще работа на целую вечность.
Я решил пойти другим путем и сделать это в два шага. Первым шагом я решил добавить реалистичности в саму программу, а потом уже на основе этого попробовать сделать генератор датасета.
Что я имею в виду под реалистичностью? Когда вы доходите до определенной стадии понимания морзянки на слух, а затем попадаете в радиоэфир, вы теряетесь. Звук там совсем не такой: в радиоэфире постоянно присутствуют шумы, ветер сдвигает антенну, меняя ее характеристики приема или передачи, гроза гремит в верхних слоях атмосферы и так далее. А еще влияет сама аппаратура, некачественные компоненты, дрейф сигнала и так далее...
Я давно хотел дать возможность тренироваться на реальном эфире. Более того, позволить фильтровать или, точнее, наоборот, добавлять лишь те шумы, которые именно вам не даются, которые хочется проработать отдельно.
В общем, как уже понятно, в программу были добавлены такие фичи, как шумы и эффекты. Шумы были разложены на типичные вроде гудения трансформатора и белого шума, а эффекты позволяли добавить дребезг ключа и другие артефакты стука. Сначала я решил задачу, что называется, в лоб, получив такой же результат. А затем посидел с Claude, добавил вариативности и реалистичности, причем до такого уровня, который позволил приблизиться к настоящему радиоэфиру. https://youtu.be/TPFljf2fjD0
Если послушать, можно, конечно, услышать синтетические нотки, но... что же на практике? На основе этого генератора был подготовлен датасет с разнообразными станциями, разных скоростей, тонов, уровней слышимости и дребезга. Получился очень большой, а главное правильно размеченный пакет с данными, на которых я решил обучить нейронку.
Грандиозные планы
Для начала сделал план совместно с клодом, и определился что именно у нас будет использоваться в качестве основы.
Цепочка от микрофона до элементов:
Микрофон 48 кГц → 8 кГц. Фильтр-дециматор (FIR Кайзера, 241 отвод), один и тот же в приложении и в генераторе данных.
Спектрограмма. Четыре окна одновременно: 8, 32, 64 и 128 мс. Шаг 4 мс, сетка 31,25 Гц, 104 полосы от 218,75 Гц. Короткое окно точно показывает время и нужно быстрым точкам, длинное точно показывает частоту и нужно слабым и близким станциям.
PCEN в логарифмической форме. Обучаемая нормализация энергии каждой полосы, работает как медленная АРУ и выравнивает громкость и замирания.
Кодировщик полосы. Двумерная причинная свёрточная сеть с одинаковыми весами на любой частоте и двумя блоками глобального контекста по всей полосе. На каждую полосу и кадр 8 мс выдаёт:
карту центров станций;
дробный сдвиг частоты внутри полосы;
вероятность нажатия ключа;
эмбеддинг для декодера.
Трекер. Единственная ненейросетевая часть, простые потоковые правила. Он копит уверенность по пикам карты центров, рождает трек, ведёт частоту фильтром α-β и смотрит на 2 секунды назад при рождении трека.
Декодер трека. Причинная временная свёрточная сеть (TCN) из 16 блоков, дилатации 1–64 дважды, 128 и 256, поле зрения около 10 секунд. Читает эмбеддинги и спектр вокруг частоты трека и выдаёт CTC по пяти классам: пусто, точка, тире, граница буквы, граница слова.
Размеры моделей:
Модель | Кодировщик / декодер, каналы | Параметров | Назначение |
Модель для телефона | 48 / 128 | 1,3 млн | итоговая |
Учитель | 80 / 256 | 4,8 млн | эталон и опыты с дистилляцией |
Обучение проводилось ТОЛЬКО на синтетике. Генератор написан на Swift и переиспользует генераторы шума, почерка и эффектов из приложения. Каждая сцена по 20 секунд в четырёх вариантах:
Вариант | Что в нём |
a | чистая смесь станций |
b | станции с эффектами передатчика и распространения |
c | чистая смесь плюс эфирный шум, помехи и приёмник |
d | всё вместе, через динамик, комнату и микрофон 48 кГц, затем фильтр приложения до 8 кГц |
В сценах моделируется:
станции: до 16 одновременно, 5–100 WPM, четыре типа ключа и неровный почерк;
передатчик: дрейф частоты, чирп, щелчки, дребезжащий тон;
распространение: замирания по модели Уоттерсона (Рэлей и Райс), до 30 Гц доплера, второй луч;
эфир: белый, розовый, атмосферный и реальный шум диапазона, цифровые помехи (RTTY, FT8 и другие);
приёмник: SSB- или CW-фильтр, АРУ, интермодуляция при перегрузке, перестройка посреди сцены, выключение;
комната: динамик, импульсная характеристика комнаты (RT60 0,15–0,6 с, DRR 8–25 дБ), шум микрофона, уровень записи.
Сцены бывают обычные, тихие, содержащие только шум или только помехи, с поздним стартом, с двумя станциями на одной частоте, с сильной станцией рядом со слабой, а также с перестройкой частоты. Разметка разборчивости измеряется на уже готовом звуке, а не задаётся формулой. Станция и её участки, утонувшие в замираниях, исключаются из потерь и из оценки. Обучение идёт пачками по 10 ГБ это около 7760 сцен на пачку. Каждая пачка генерируется заново и после обучения удаляется, так как диск позволяет держать одновременно только одну-две штуки.
Скажу сразу: с первой попытки всё гладко не получилось. Почти месяц ушел на цепочку «обучение → тестирование → доработки → обучение», подбор размеров сеток, проверку гипотез, замену датасетов и так далее. Ноутбук был горячим 24/7.
На ошибках учатся
Ошибка по элементам. Доля правок Левенштейна (замена, пропуск, лишний) по токенам: точкам, тире, границам букв и слов, относительно длины эталона. Чем меньше, тем лучше. Мерка строже буквенной в одном и мягче в другом: пропуск одной точки — одна ошибка, хотя буква при этом уже другая.
Ошибка по буквам (CER) для сравнения с другими работами. Токены переводятся в буквы по латинской таблице, пробелы схлопываются, считаются правки по знакам.
Три уровня оценки:
идеальные треки: декодер читает станцию по истинной частоте, без трекера. Это мерка самого декодера;
вся система: трекер сам находит станции, пропущенная станция считается целиком ошибочной. Так будет в приложении;
настоящий эфир: на записях с радиостанций
Синтетическая валидация: 1000 сцен, вариант d, около 5,6 часа звука. Модели сравниваются по сценам, разница — с 95% интервалом парного бутстрепа.
Процесс сравнения сетей дело довольно крапотливое, тем более что это происходит на разных данных, разных лабораториях и т.д., но примерные оценки можно собрать и сравнить.
Вся валидация, 1000 сцен, вариант d (через комнату и микрофон):
Модель | Идеальные треки | Вся система | Найдено станций | Ложных точек и тире в минуту |
Модель для телефона, 1,3 млн | 12,6% | 17,3% | 92,9% | 11,3 |
Учитель, 4,8 млн | 11,6% | 17,0% | 93,6% | 9,2 |
Путь ошибки всей системы за время разработки:
Этап | Ошибка всей системы |
Первая версия | 47,9% |
Комната без «бочки» (исправлена модель комнаты) | около 45% |
Треки как у трекера, холодный старт записи | 30,2% |
Реальная расстановка станций | 28,8% |
Усреднение весов, частый показ быстрых станций | 22,6% |
Трекер без перескоков на соседние станции | около 18% |
Исправления по аудиту, новый рецепт обучения | 17,3% |
Разбор оставшихся ошибок на идеальных треках, учитель:
Условия | Ошибка |
Сильный сигнал, ≥ 30 дБ на элемент | 5,8% |
Средний сигнал, 15–20 дБ | 17,5% |
Слабый сигнал, < 10 дБ | 35% |
Без замираний / с замираниями | 5,9% / 17,9% |
< 15 WPM / 15–60 WPM / ≥ 80 WPM | 17% / 10–13% / 26% |
Около 80% всех ошибок это пропуски элементов, а не путаница точки и тире.
Кстати, я думаю, что пропуски точек и тире можно будет так же доработать на втором этапе интеграции, где в дело будет вступать уже модель по исправлению пропусков. Фактически, если упущена лишь одна точка или одно тире, это означает смещение, и все последующие знаки будут интерпретироваться неправильно. Но ошибку можно контролировать, добавляя знак и делая обратную проверку, это то, что приходит в голову на лету.
Выводы и вводы
Готового размеченного набора настоящего эфира в открытом доступе нет, поэтому мы сделали свой.
Как получены записи:
Станция W1AW (ARRL, Ньюингтон, Коннектикут) по расписанию передаёт бюллетени, а их тексты ARRL публикует.
Одна и та же передача записывалась сразу с нескольких публичных удалённых приёмников KiwiSDR на расстоянии от 420 до 5800 км (Канада, США, Франция, Нидерланды) на нескольких диапазонах. Получились разные уровень сигнала, замирания, шум и помехи при одном известном тексте.
Текст бюллетеня привязывался к записи по времени. Модель-учитель читала самую чистую запись, и её расшифровка сопоставлялась с текстом приближённым поиском подстроки. На остальные записи разметка переносилась по сдвигу, найденному взаимной корреляцией огибающих сигнала. Участки, где подряд расходятся две и больше буквы, считались отклонением передачи от текста и в оценку не входили.
Набор: две передачи, бюллетень DX ARLD042 и бюллетень прохождения ARLP043, 18 WPM. Девять записей с сигналом, около 25 минут каждая, около 56 тысяч токенов и 16,6 тысячи букв.
Результаты, декодер на известной частоте тона:
Модель | Ошибка по элементам | CER по буквам |
Учитель, 4,8 млн | 13,3% | 18,0% |
Модель для телефона, 1,3 млн | 14,5% | 20,1% |
По записям, модель для телефона:
Запись | Ошибка по элементам |
420–1230 км, громкий сигнал | 8,3–9,8% |
3230 км, вечер | 11,3% |
5750 км, Франция | 12,0–16,7% |
5780 км, Нидерланды | 24,3% |
3230 км, день, слабый сигнал | 31,9% |
Главный вывод: синтетика хорошо переносится на эфир. Ошибка на настоящем эфире всего на 1–2 пункта выше, чем на синтетике, и порядок моделей тот же.
Важная оговорка про разметку. На громких записях все пять проверенных моделей дают одинаковые 8–10% ошибки по элементам, включая учителя на той записи, по которой строилась разметка. Значит, это нижний предел самой разметки: передача в эфире местами отличается от текста на сайте ARRL, например в ссылках, сокращениях и числах. Настоящая ошибка на сильном сигнале ниже. Для окончательных цифр разметку нужно уточнить на слух.
А что там у других?
Сравнение с другими работами
Работа | Подход | Данные проверки | Станций | Результат |
Наш декодер | CNN-кодировщик полосы + трекер + TCN-декодер, CTC; потоковый | настоящий эфир, W1AW, 9 записей с 420–5800 км, вместе со слабыми | до 16 сразу | 18,0% (учитель); синтетика: 17,3% всей системы |
Sagnik-Barman, Morse-CW-Decoder | CNN + BiGRU или Conformer, CTC | настоящий эфир: 380 записей маяков с KiwiSDR, разметка по расписанию маяков | 1 (самая сильная) | CER 17% в нормальных условиях, 38% во всех, 59–73% в тесной полосе; fldigi 58% и 65% |
DeepFist | компактная CNN + CTC | записи код-практики ARRL, 198 штук, 10–40 WPM | 1 | CER ≈ 7% (3–17% по скоростям) |
DeepCW | нейросеть, детали не раскрыты | синтетика, белый шум | 1 (многоканальность заявлена без замеров) | CER 0% при SNR от 0 до −4 дБ; < 1,5% при −8 дБ; < 8% при −10 дБ |
AG1LE (2019) | CNN + LSTM + CTC | синтетика, 25–30 WPM | 1 | CER 0,1%, держится до −12 дБ |
MaorAssayag | LSTM + CTC | синтетика | 1 | CER < 2% при SNR выше −5 дБ |
3DCNN-BiConvLSTM (китайский журнал) | 3D CNN + BiConvLSTM + CTC | синтетика | 1 | > 98% правильных слов |
CW Skimmer, fldigi, MRP40 | классическая обработка сигнала | опубликованных измерений нет | Skimmer — много, остальные — 1 | только отзывы пользователей |
Как читать сравнение:
Почти все красивые цифры получены на синтетике: CER 0–2%. Разные проекты задают SNR по-разному, в разной полосе и от разной мощности сигнала, поэтому пороги в децибелах между проектами напрямую не сравниваются.
На настоящем эфире нашёлся только один открытый замер, у Sagnik-Barman: 17–38%. Наш декодер в той же области (18–20%), при том что:
он читает все станции полосы сразу, а не одну, самую сильную;
работает потоково в реальном времени, без заглядывания вперёд;
модель для телефона весит 1,3 млн параметров;
наша цифра включает нижний предел разметки около 8% по элементам, см. раздел 6.
Многостанционного нейросетевого декодера с опубликованными замерами мы не нашли. Sagnik-Barman прямо называет одновременное чтение всех станций полосы нерешённой задачей.
DeepFist проверялся на записях код-практики ARRL, судя по описанию, без эфира, без шума и замираний. Это ближе к нашему чистому варианту a, чем к настоящему эфиру.
Немного итого
Для повышения качества приема сигнала я планирую добавить языковую модель внутрь поиска. Декодер выдаёт не один ответ, а вероятности по кадрам. Небольшая буквенная языковая модель подправляет выбор только там, где сам декодер сомневался. Где сигнал чёткий, акустика перевешивает, и выдумать уверенный позывной модель не сможет.
Что ещё можно сказать о самом процессе, так это то, что современные нейронки сильно ускоряют любые процессы разработки, проектирования и планирования. Тот путь, что я прошёл, раньше проходили целыми научными группами исследователей, а сейчас для этого достаточно компетенций, аккаунта Pro и одного человека.
Мое приложение достигло пика своего развития, дальше расти будет некуда. Любой человек, которому так или иначе нужна морзянка, знает про мой проект, и большая часть доработок была проведена именно за счет обратной связи от людей, заинтересованных в моем проекте.
Раз уж я затронул тему дальнейшего развития приложения, то роадмэп такой:
Применение постобработки для повышения качества принимаемого сигнала
Доработки по обратной связи на текущий функционал
Доработки и оптимизации приложения для iPhone Duo
Перенос кодовой базы и запуск приложения на Андроид
Перенос функционала и кодовой базы на Windows
Пару слов про подключение телеграфного ключа к приложению и зачем это нужно. Для подключения используется Bluetooth-адаптер, который позволяет подключить ключ буквально напрямую к программе и набивать руку в любое время дня и ночи. Адаптер принимает как ямбические ключи, так и ключи обыкновенные. Разработан адаптер мной с нуля, а прошивка переписана с Claude.
Вторая версия адаптера пока в разработке, в ней появляется обратный функционал: адаптер выступает в качестве ключа. Это позволяет, например, подключить его к настоящему трансиверу для работы в эфире, передавая сигнал с эмуляцией стука человека. Или, например, можно включить передачу определенного сигнала в определенное время с интервалами повтора и так далее.
Так как над проектом приходится работать лишь по вечерам и на выходных, процесс идет не очень быстро, но все-таки идет. Сейчас я провожу последние исследования и готовлю сборку версии 10 для публикации в App Store. То есть потрогать это можно будет уже через пару дней, а пока даю несколько промокодов для приложения.
Пара слов о промокодах
Для тех, кто никогда не пользовался промокодами, напоминаю, что они вводятся в App store, по кнопке “Ввести код”.
LE46PTH3RH6M
AJP4A3FYKYH6
T6AJ49AAY4YE
3FEEH7FTERXY
KLEFJEPPYME4
KXXRKHAAJ7W4
E7NF4FH67HYP
JELKT66LFWFL
39TEW9M6R4YE
FMHWRAX4LNHW
Если этой кнопки с первого раза найти не удается, прошу не паниковать, а в гугле найти одну из миллиона ссылок с примером, где эту кнопку найти конкретно в вашем устройстве. Есть даже видео.
Источники
DeepCW: e04/web-deep-cw-decoder, статья на Zenn
AG1LE: Performance characteristics of the ML Morse Decoder, Training a Computer to Listen and Decode Morse Code
3DCNN-BiConvLSTM для автоматического распознавания кода Морзе (CNKI)
Research on Automatic Decoding of Morse Code Based on Deep Learning (IEEE)
Automatic Decoding Algorithm of Morse Code Based on Deep Neural Network (JEIT)
Automatic Morse Code Recognition under Low SNR (Atlantis Press)
Сравнения классических декодеров: Comparing two CW decoding programs, Best Morse Decoder
Данные для проверки на эфире: W1AW Operating Schedule, W1AW Code Practice Files, бюллетени прохождения и DX
Запись с KiwiSDR: kiwiclient, пример использования kiwirecorder
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.