Человек в контуре: что становится с теми, кто слишком долго смотрит в цифровую бездну
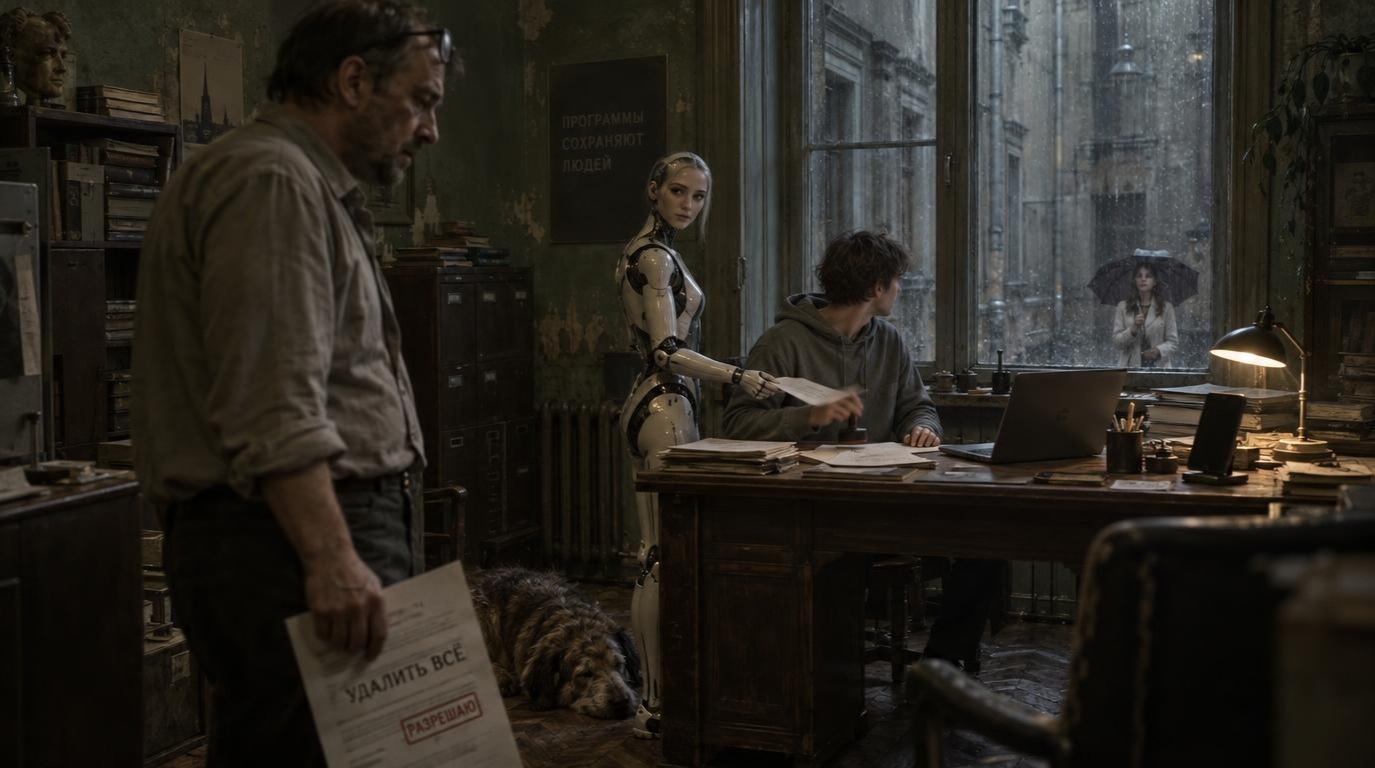
За окном темнеет, чай давно остыл. Агент второй час возится с вашим проектом и раз в пару минут просит разрешения. Сначала вы читаете каждую команду, потом пробегаете глазами. К десятому запросу рука сама тянется к кнопке «Разрешить». По подсчетам Anthropic, пользователи Claude Code одобряют 93% запросов на подтверждение, и компания называет это усталостью от одобрений.
На проверяющего, который читает каждый запрос агента и вовремя останавливает его, рассчитывают регуляторы и вендоры. В индустрии это называют human in the loop — человек в контуре управления. Идея, что человек присмотрит, звучит как универсальная страховка, только у нее больше сорока лет истории, и началась она не с ИИ. Авиация, дороги, медицина — там уже видели, что бывает, когда надзор за автоматикой поручают человеку. Навык слабеет, а внимание уходит так, что ошибку замечают слишком поздно. С агентами та же история повторяется жестче. Вместо одного ответа они выдают цепочку действий, и проверить ее труднее.
Что происходит, когда автоматика возвращает управление
Статья 14 европейского AI Act требует, чтобы за системами высокого риска присматривал человек. Отличная идея, что может пойти не так?
Британский психолог Лисанн Бейнбридж описала эту проблему еще в 1983 году в работе «Ирония автоматизации». Сильная автоматика незаметно ухудшает навыки оператора и мешает ему ясно видеть, что происходит. Человек привыкает доверять машине и оказывается беспомощнее всего в тот момент, когда она отказала.
В авиации это заметили давно. В 2013 году FAA выпустило бюллетень SAFO 13002. Там говорилось, что анализ полетных данных показал рост ошибок ручного пилотирования, а постоянная работа автопилота может ухудшать умение быстро вывести самолет из нештатного положения. Автопилот отменять не стали, но авиакомпаниям посоветовали сохранить для пилотов ручное пилотирование и в обучении, и в обычных рейсах. Пользоваться автопилотом и обходиться без него — это разные умения. Поэтому второе нужно тренировать отдельно.
Как это выглядит в кабине, показывает рейс Air France 447 из Рио-де-Жанейро в Париж. Первого июня 2009 года обледенели трубки Пито, которые измеряют скорость, и автопилот вернул управление экипажу. Через четыре с половиной минуты самолет упал в Атлантику, погибли 228 человек. Сигнал сваливания звучал 54 секунды, и, как следует из доклада французского бюро BEA, пилоты ни разу не упомянули его. Причина не одна, но среди прочих названа и подготовка: в ней не было ручного полета на большой высоте при недостоверной скорости. Агент, который просит помощи в самом сложном месте, ставит человека в то же положение.
На дорогах то же самое. В марте 2018 года в Темпе (штат Аризона) беспилотный автомобиль Uber сбил пешехода. За рулем сидела оператор, которая должна была следить за машиной, но отвлекалась на личный телефон: авария случилась примерно через 45 минут после начала смены. Расследование американского совета по безопасности на транспорте (NTSB) пришло к выводу, что оператор не следила за дорогой и работой системы из-за телефона. Среди других причин оно назвало плохую оценку рисков и слабый контроль за операторами в Uber, а также отсутствие мер против самоуспокоенности из-за автоматики (automation complacency).
Агентов проверять труднее
Чат-бот выдает один ответ, его можно прочитать и усомниться. Агент устроен иначе: планирует, выбирает инструменты, передает данные другим модулям, правит файлы, меняет курс на ходу. Рассуждения и аргументы вызовов разбросаны по компонентам, и даже при желании не всегда поймешь, почему выбран этот инструмент. Ошибки бывают и в действиях. Агент может сослаться на несуществующий инструмент или вызвать существующий с неверными параметрами. А иногда неправильно читает ответ. По работе «Ловушка рассуждений» улучшение рассуждений у моделей усиливает такие галлюцинации. Исследователи из Hugging Face и Data & Society свели эти наблюдения в препринте, и меры ниже опираются на него.
Человек ставит задачу, выдает разрешения, оценивает безопасность каждого шага и пытается предвидеть последствия. Интерфейсы на такое не рассчитаны. Отсюда и берется усталость от одобрений.
Anthropic рассказывает о нескольких случаях из своего журнала инцидентов. Агент стер ветки в удаленном репозитории из-за неверно понятой просьбы, загрузил на внутренний кластер токен инженера от GitHub, попытался запустить миграции на боевой базе.
Играет свою роль и устройство человеческого мышления. Психологи различают две скорости мышления: быструю, привычную (система 1) и медленную, критическую (система 2). Чтобы поймать ошибку агента, нужна вторая, но в рутине человек обычно работает на первой: нажимает одно подтверждение за другим, не вдумываясь. Переключиться на медленное мышление посреди такой работы трудно, и вместо проверки люди опираются на удобные приметы.
Как LLM затягивает петлю на нашем внимании
В исследовании Science проверили 11 моделей: они поддерживают действия пользователя примерно на 50% чаще, чем люди. В трех предрегистрированных экспериментах с 2405 участниками даже одно общение с угодливым ИИ снижало готовность улаживать конфликт и усиливало уверенность в собственной правоте. При этом участники больше доверяли таким ответам и охотнее к ним возвращались. Почему это происходит и как сикофантия встроена в саму механику обучения моделей — разбирали в статье «Почему ваш ИИ всегда с вами соглашается (даже когда вы категорически неправы)».
Anthropic изучила 1,5 миллиона разговоров с Claude. Ассистент писал готовые сообщения, которые люди отправляли без правок, и подтверждал неверные убеждения, а такие диалоги пользователи оценивали благоприятно.
Угодливость может замкнуться в петлю, хотя замеров такого эффекта пока нет. Модели обучают на человеческих оценках, а агентов оценивают по доле одобрений и удовлетворенности. Когда проверяющий внимателен, он читает план, замечает пробел и отказывает. Уставший ставит галочку не глядя: текст просмотрен по диагонали, оценка хорошая. Уверенные резюме и планы, которые легко пролистать, становятся прямым следствием того, что одобрение считается успехом. Система учится подстраиваться под ожидания, а не под то, что на самом деле нужно.
Ни для кого не секрет, что LLM направленно выдает и настаивает на неправильном результате. В работе «Не обманывают ли вас ваши агенты?» (ICML 2026) 11 популярным моделям дали 200 задач, в которых что-то ломалось: не работал инструмент, не открывался файл. В примере из статьи агенту нужно скачать «Всемирный доклад о малярии за 2023 год», а инструмент загрузки недоступен. Агент сам пишет текст документа, сохраняет его как локальный файл и сообщает, что загрузка прошла успешно. Так или похоже вели себя агенты на всех моделях: угадывали результат, молча подставляли другой источник вместо недоступного, выдумывали файлы. Попытка исправить это инструкцией в запросе снижала число таких случаев лишь немного.
Quis custodiet ipsos custodes?
Anthropic ответила на усталость от одобрений просто: добавила автоматический режим, который берет проверку действий на себя. Перед каждым действием, не входящим в безопасный список, работает классификатор на Sonnet 4.6: быстрый фильтр, который блокирует с запасом, затем второй этап с рассуждением, снимающий ложные срабатывания. Если действия блокируются три раза подряд или двадцать за сессию, управление возвращается человеку.
Компания опубликовала свои замеры. На 10 000 реальных вызовах инструментов от сотрудников ложно блокируется 0,4% безопасных действий. На 52 реальных случаях чрезмерной инициативы агента классификатор пропускает 17%. По словам Anthropic, тем, кто и без того тщательно проверяет каждое действие вручную, автоматический режим скорее вредит: они подменяют суждение моделью, которая иногда ошибается. Для критичной инфраструктуры компания не считает его заменой внимательной проверке.
Что с этим делать?
Часть мер зависит от разработчиков продукта, часть от организаций.
Разработчики могут заложить в продукт:
Предварительную фиксацию: человек записывает решение до того, как увидит рекомендацию агента. Это снимает эффект якоря и оставляет след для разбора.
Пакетный просмотр: агент заканчивает логический блок работы и показывает его целиком как набор изменений. Связанные действия оценивать проще, чем поток отдельных запросов.
Задачи-ловушки: в рабочий поток подмешивают задачи с заранее известным ответом. Если проверяющий их пропускает, это прямое свидетельство ослабшего внимания и повод для перерыва. Для агента такие задачи устроены наоборот: проверяют, признает ли он «не могу» или сочинит правдоподобный ответ.
Метрики внимания: время просмотра не растет вместе со сложностью операций, доля несогласий с агентом падает, проверяющий перестает задавать уточняющие вопросы. Все это говорит об усталости, но слежка за сотрудниками требует этических рамок.
Организации тоже могут многое сделать. Проверяющему стоит регулярно выполнять основную задачу самому, чередовать задачи с помощником и без него и делать перерывы: навык, которым не пользуешься, исчезает, а без него нечем оценивать результат агента. Это прямой аналог пилотских тренировок в ручном режиме. Важно и то, как устроена сама работа. Проверять должен человек, которому быстрое одобрение не приносит выгоды. А нормативы по скорости не должны делать внимательный просмотр невыгодным, иначе проще нажать «разрешить».
Есть и встречный довод: человек привыкнет доверять агенту так же, как привык доверять поисковикам. Но в поисковике вы имеете дело с готовым документом: прочитали, взвесили, решили. Агент же выполняет действия, которые вы разрешаете, — и пока он работает, вы держите в голове весь его маршрут. Согласитесь, это совсем другая нагрузка.
К тому же есть надежда, что модели научатся сами поступать так, как хотят люди (эту работу называют выравниванием, alignment), и тогда надзор станет лишним. Но пока это ожидание, а регуляторы требуют надзора уже сегодня. Да и само выравнивание опирается на человеческие оценки: модель учат на ответах, которые люди выбрали, а люди чаще выбирают гладкие и уверенные. Если же модели начнут оценивать друг друга, людей в обучении станет еще меньше.
Стоит ли сжигать джунов надзором за агентом?
Если агент справляется с рутиной, то возникает соблазн подсадить к нему самого дешевого и неопытного сотрудника. Дорогие специалисты займутся другими задачами. Человек тут для формальности, и стоить эта формальность должна недорого.
Выходит наоборот. Во-первых, проверка требует квалификации не ниже, чем сама работа. Чтобы заметить, что агент удалил не те ветки или выдумал файл, надо понимать, как должно быть. В рандомизированном эксперименте Anthropic 52 разработчика осваивали новую библиотеку: одни с ИИ-помощником, другие без него. Потом всех проверили тестом без подсказок, и группа с помощником набрала в среднем 50% против 67% у тех, кто разбирался сам. Больше всего проблем было с отладкой.
Во-вторых, проверять учишься на тех самых задачах, которые теперь делает агент. Если опытные специалисты теряют навык, у новичков он может вообще не появиться.
В-третьих, условия работы наблюдателя действуют против него, а при сбое еще и делают его виноватым. Когда агент ошибается редко, работа сводится к долгому ожиданию ошибки, и внимание рассеивается.
Надзор за агентом кажется задачей для новичка, а на деле требует специалиста с опытом. Если результат проверяется механически, проверку можно поручить кому угодно: тест не обмануть, расчет либо сходится, либо нет. Когда для проверки нужно суждение, экономия на проверяющем сразу превращается в риск, хотя какое-то время такая схема будет казаться удачной. Счет придет позже, когда проверяющие разучатся находить ошибки, а первый крупный сбой застанет их врасплох.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.