Настройка и пример работы LLM на встроенном NPU мини-компьютера с Intel Core Ultra 5 226V
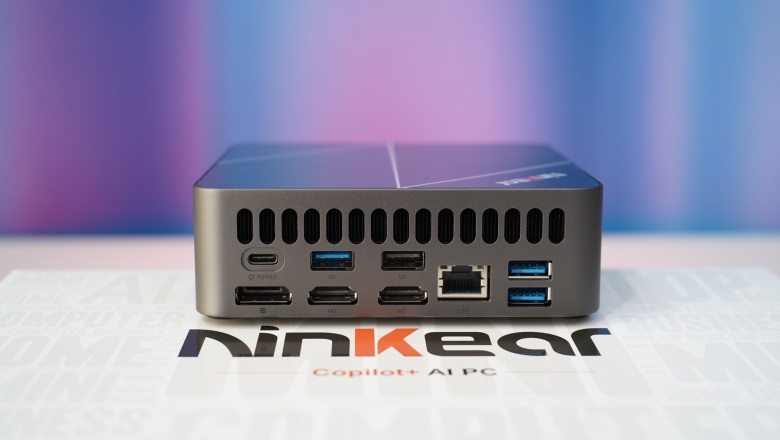
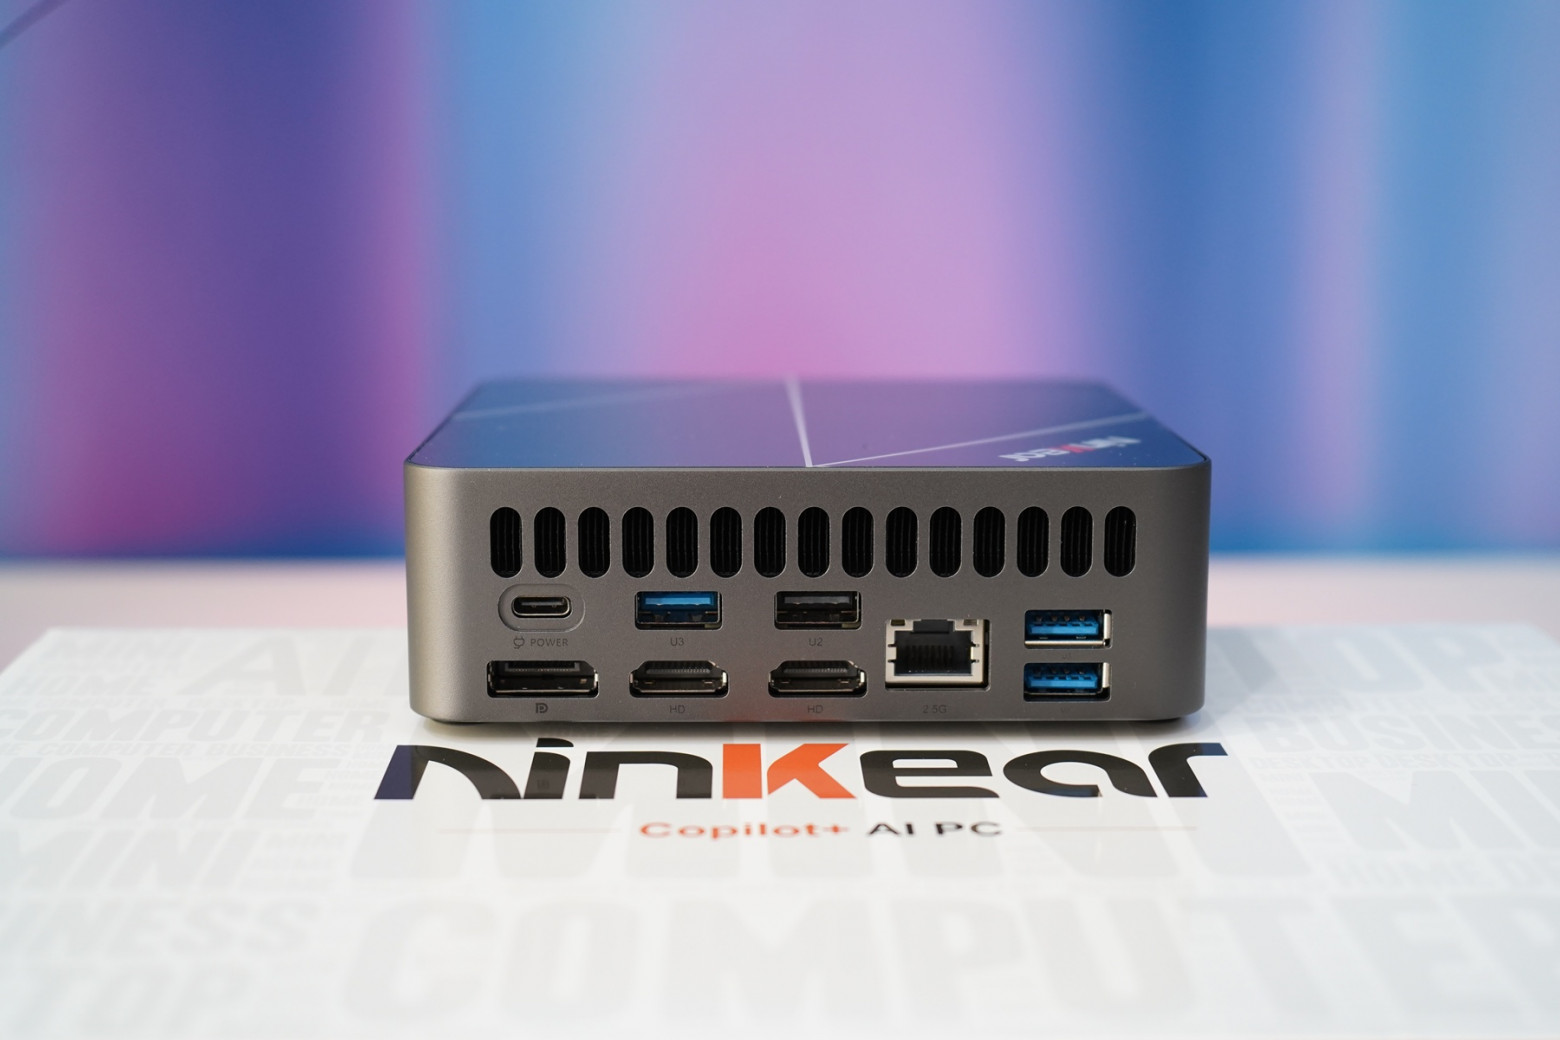
Подопытный - мини-ПК Ninkear L20 на Intel Core Ultra 5 226V с 16 ГБ памяти. В статье будет установка и настройка OpenVINO, запуск Qwen3-8B на NPU, замеры скорости и мощности по счётчикам самого процессора и сравнение с дорогой видеокартой RTX 5070 Ti. Плюс практическая часть: обработка фотографий, 3D-рельеф из фото, озвучка книг TTS, Blender и печатная плата. Всё работает локально, без утечек данных в интернет и без оплаты подписок.
В новых процессорах Intel Core Ultra появился третий вычислитель - нейронный процессор, NPU. Маркетинг обещает «ИИ-компьютер», но живых примеров обычно два: размытие фона в видеозвонке и Copilot. Мне стало интересно другое. Можно ли запустить на NPU настоящую языковую модель (LLM), сколько она выдаёт токенов в секунду и сколько при этом потребляет? Также мне интересно, что же получится, если загрузить сразу все три блока процессора: NPU, встроенную графику и обычные ядра. Постараюсь разобраться и подробно все рассказать.
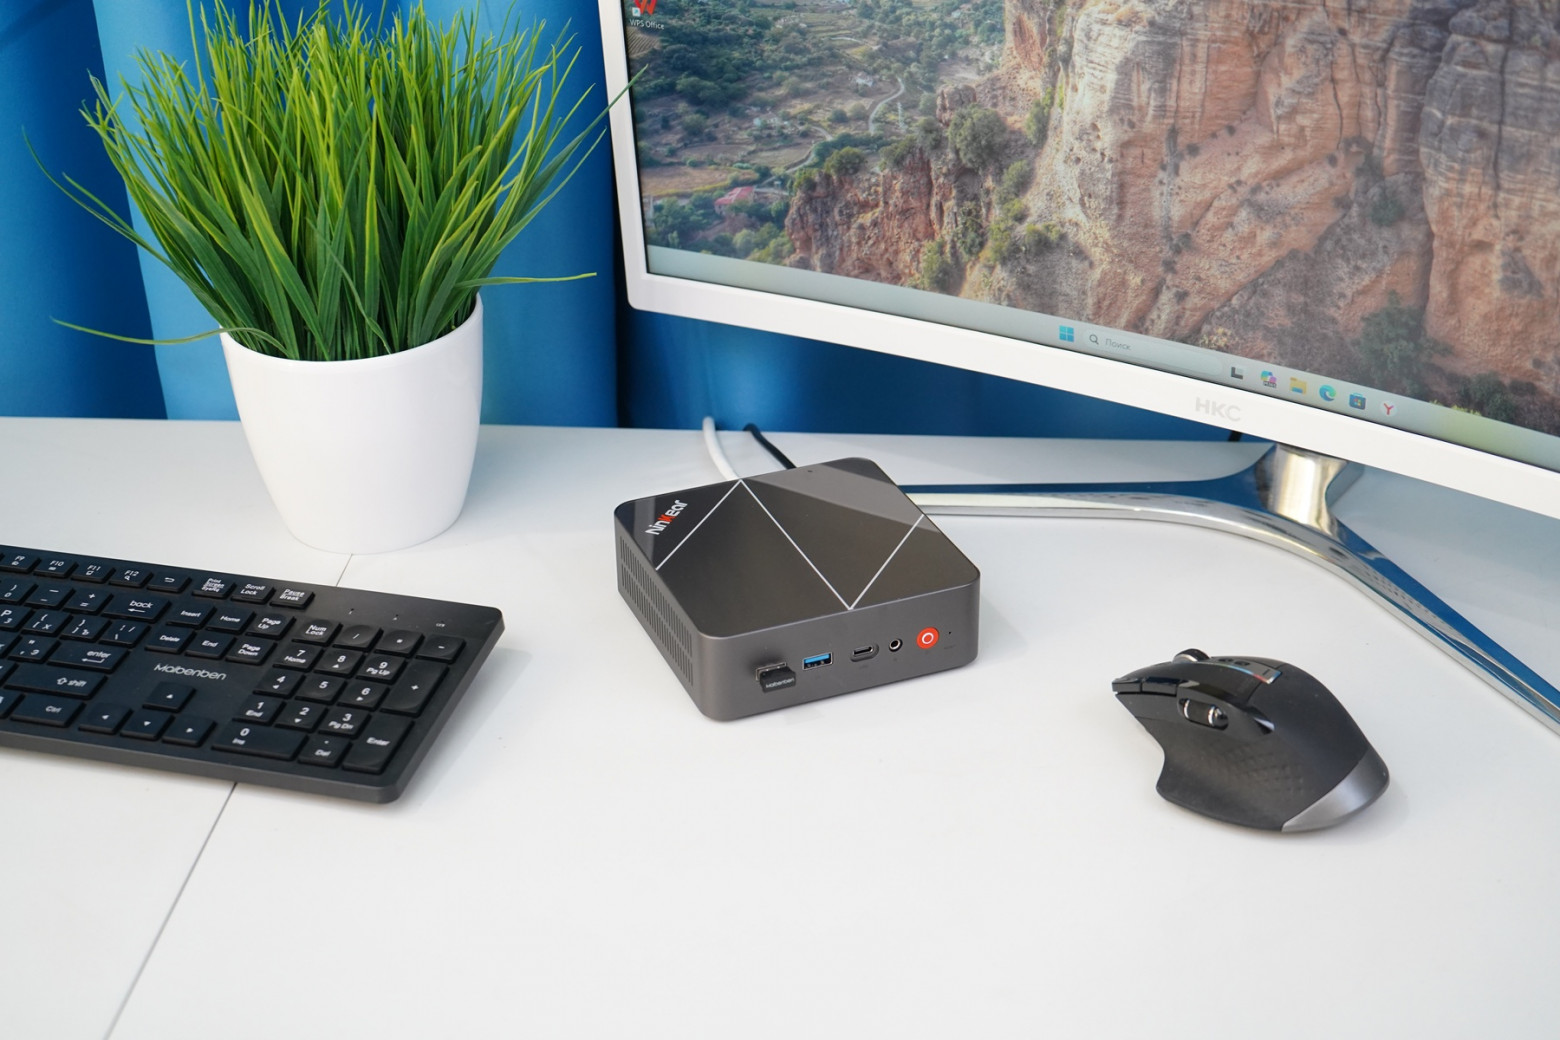
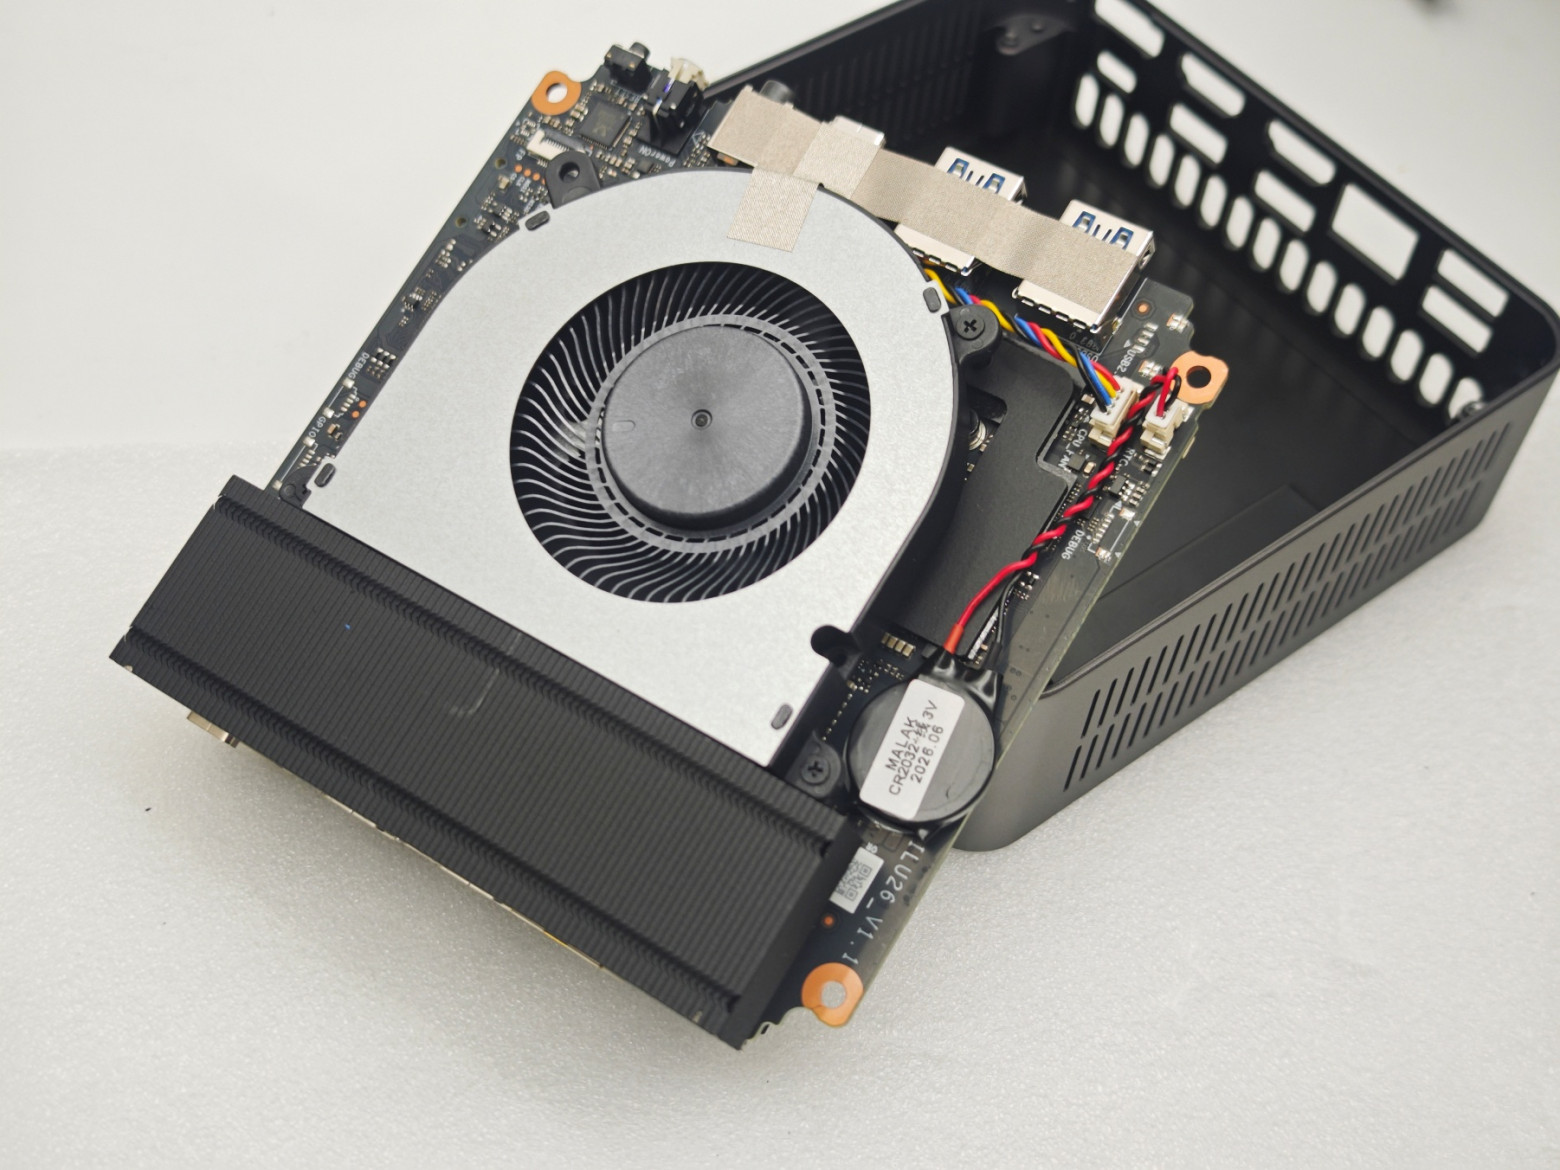
Начну с писания этого мини-ПК. Ninkear L20 построен на Intel Core Ultra 5 226V (Lunar Lake) с 16 ГБ памяти LPDDR5X-8533 на корпусе процессора. Рабочий диапазон мощности 17-37 Вт. Внутри три разных вычислителя:
CPU на 8 ядер (4 производительных + 4 энергоэффективных). Универсален, но на нейросетях медленный: мало параллельных блоков, высокая частота, высокое энергопотребление на операцию.
iGPU Intel Arc 130V (в терминах Intel и PyTorch XPU, в OpenVINO это GPU). Архитектура Xe2, сотни параллельных вычислителей, аппаратное умножение матриц. Самый быстрый блок для крупных нейросетей: языковых моделей, Stable Diffusion, длинных промптов.
NPU Intel AI Boost четвёртого поколения, по данным Intel до 40 TOPS. Узкий специалист: умножение матриц в INT8 и FP16 на низкой частоте и при малом напряжении. Не умеет динамические формы данных, требует долгой первой компиляции, поддерживает не все операции.
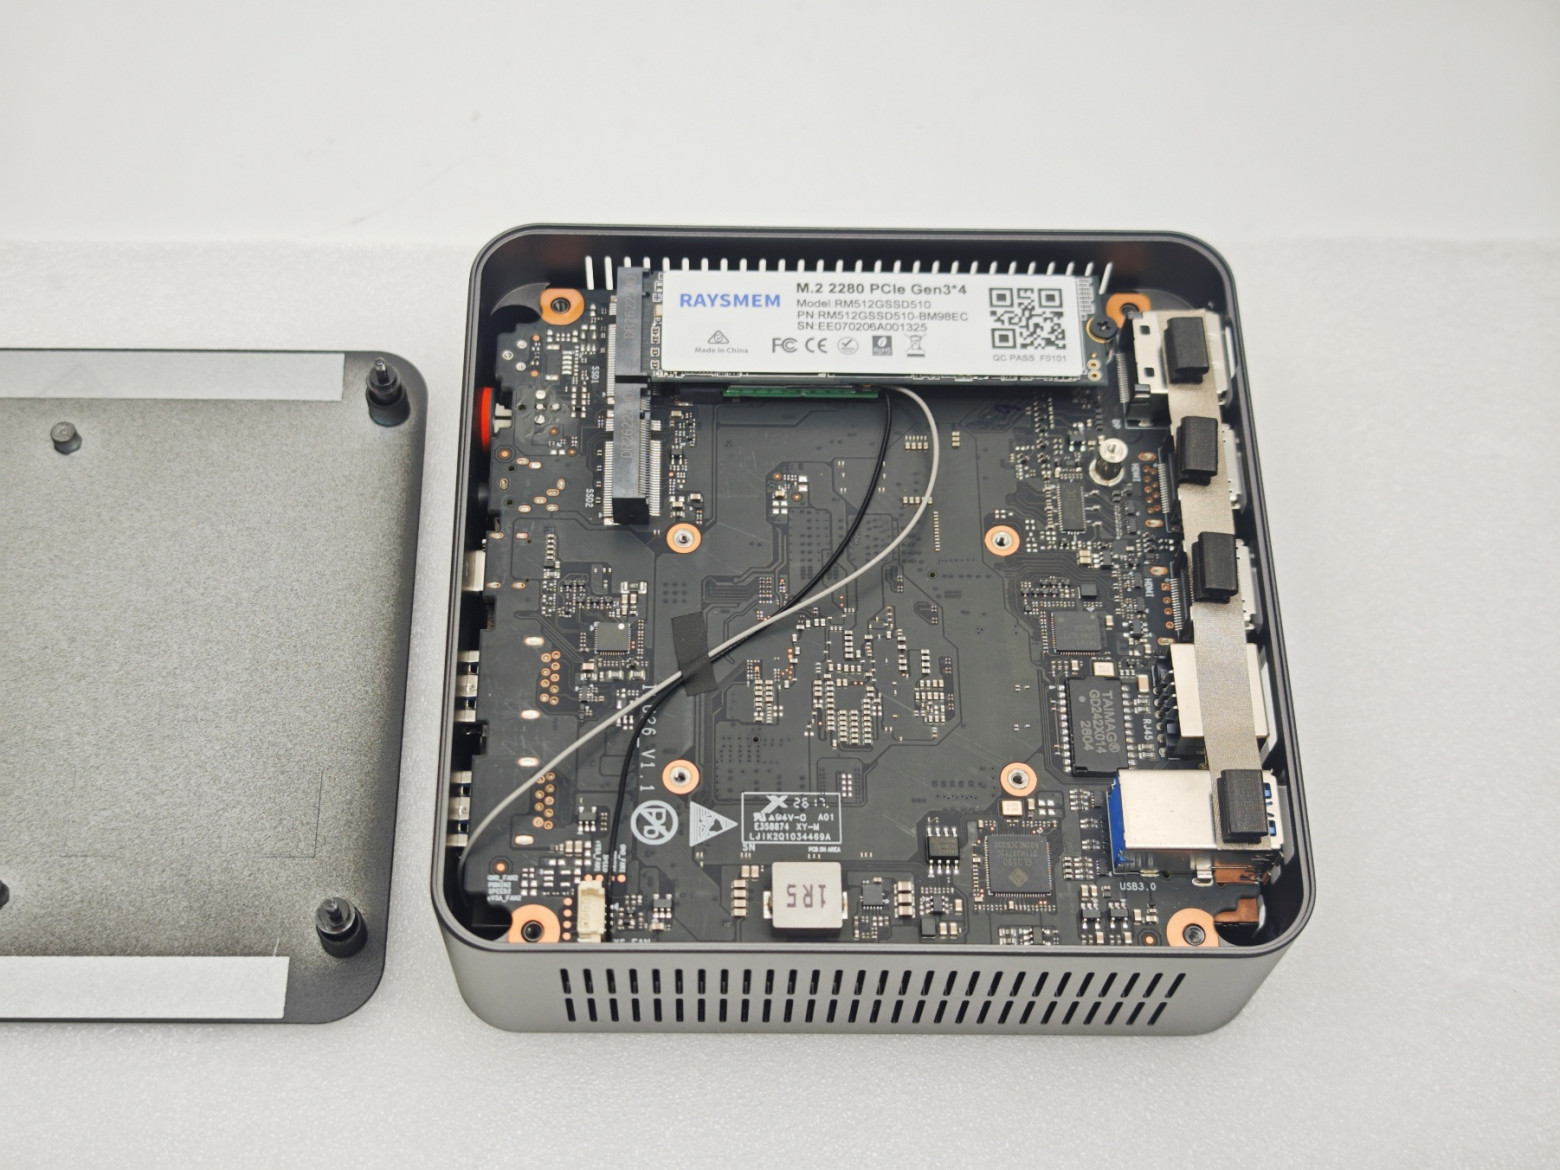
У всех трёх блоков общая оперативная память: своей видеопамяти у графики нет, своего ОЗУ у NPU тоже. Модель не нужно копировать между устройствами, но шина памяти одна на всех. При одновременной работе это видно. Чем NPU отличается от Arc 130V на практике.
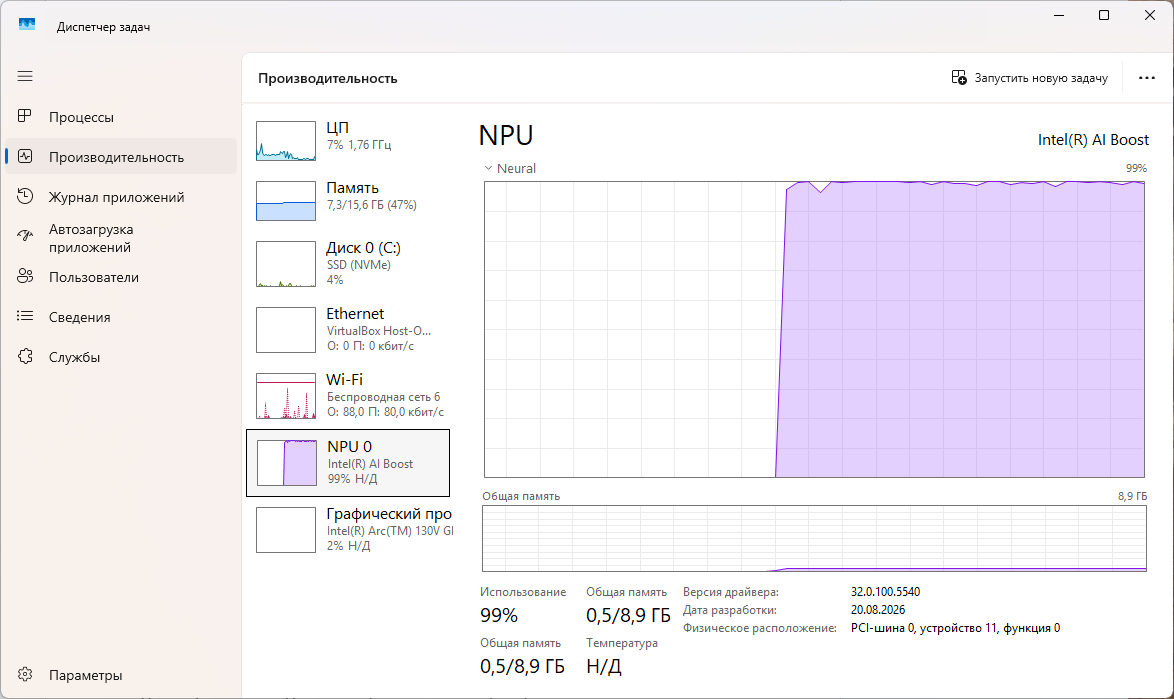
Графика быстрее на языковой модели вдвое. NPU выигрывает, когда задача длинная, нагрузка неполная и важны тишина и ватты:
Фоновая обработка (поток с камеры, пакет фотографий, пересказ документов) на NPU добавляет к простою 1-2 Вт (огромная разница по потреблению, если смотреть ту же RTX 5070 Ti, подходит для случаев, когда нужно не срочно).
Графика и процессор свободны для основной работы, будь то Blender, браузер или сборка проекта.
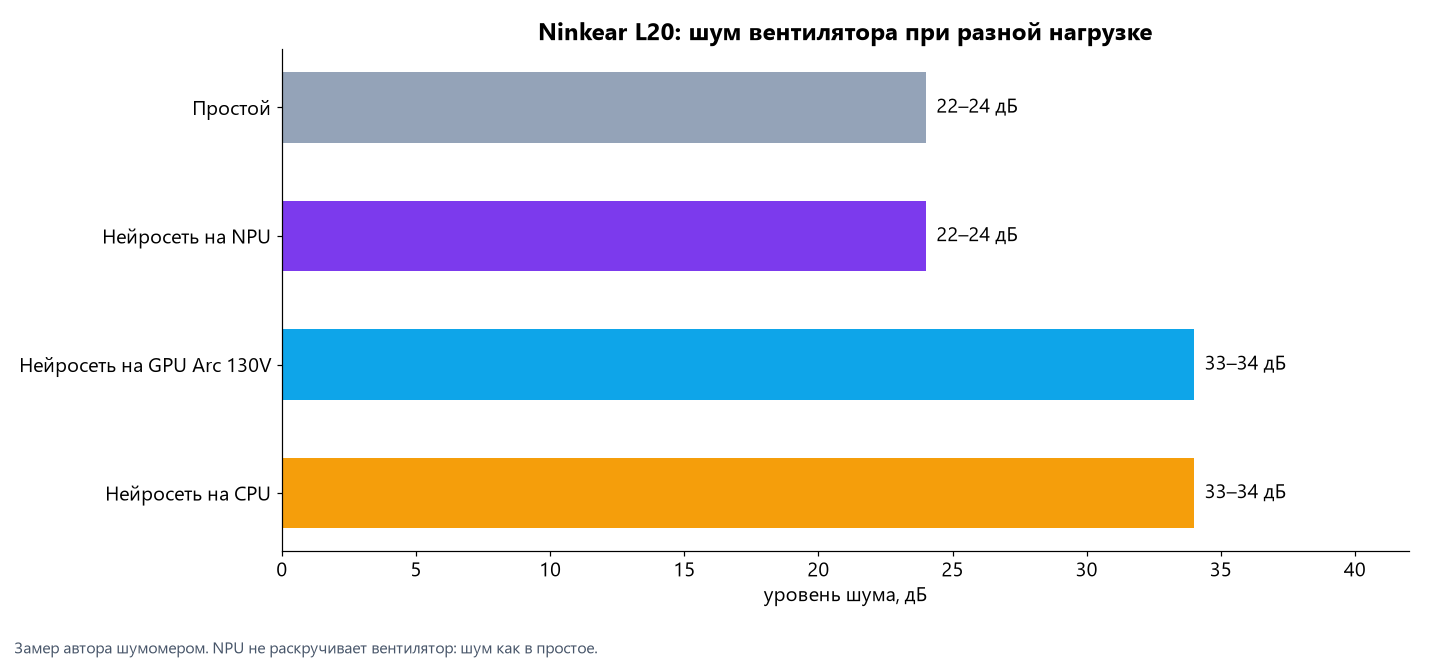
Вентилятор не раскручивается: шум остаётся на уровне простоя, 22-24 дБ, тогда как с графикой и процессором 33-34 дБ (для меня также критично - шум не раздражает).
NPU, графика и процессор в цифрах
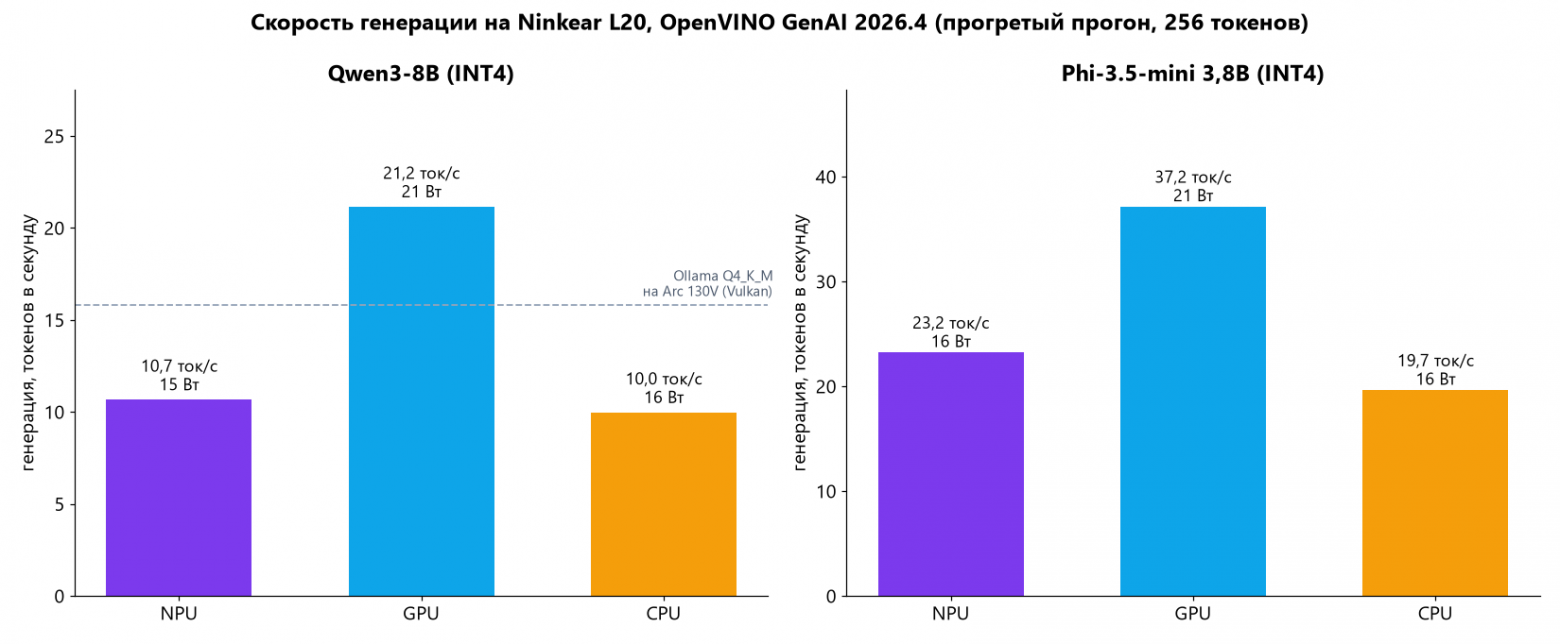
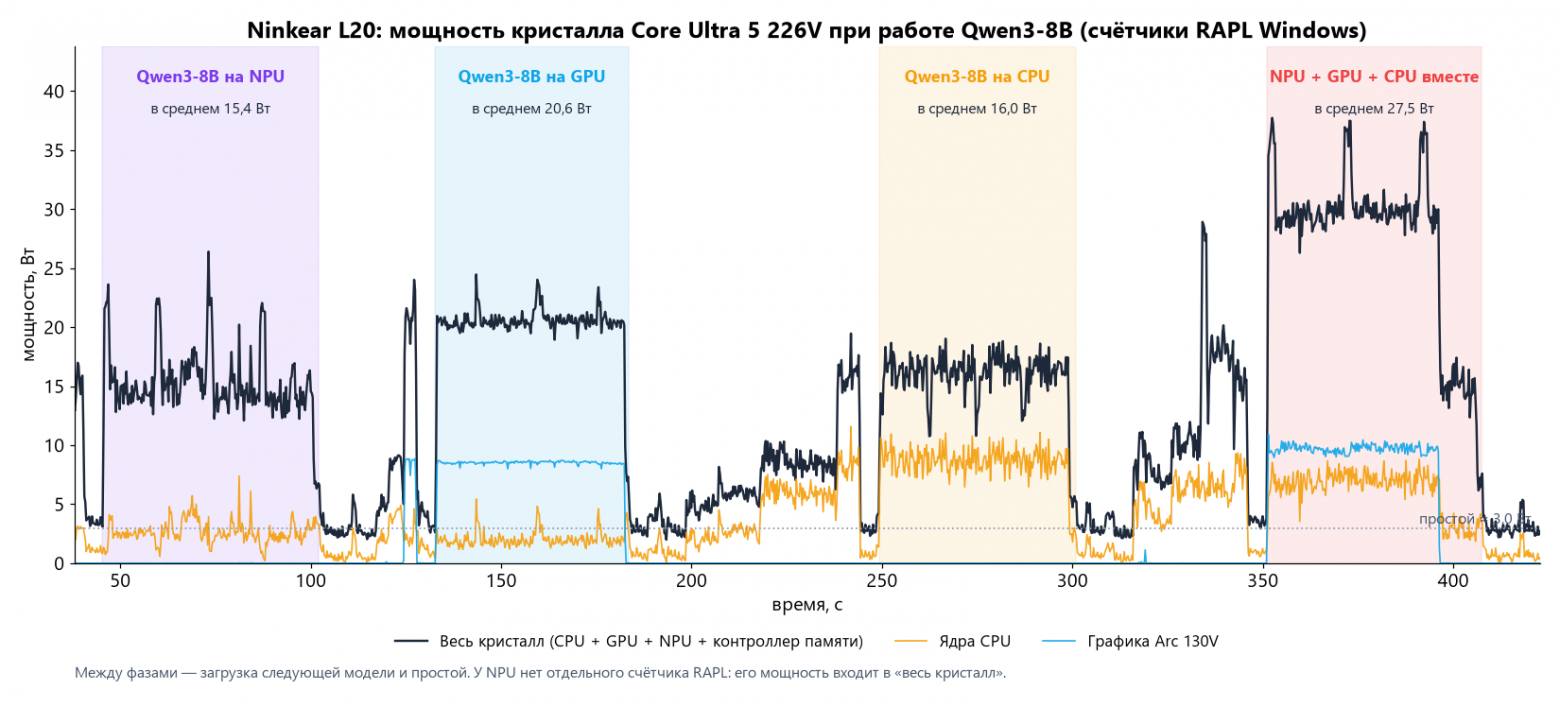
Для сравнения я взял одну и ту же языковую модель Qwen3-8B в 4-битном сжатии (OpenVINO GenAI 2026.4). Запрос - 77 токенов, ответ - 256, жадная генерация, засчитывается второй прогон. Мощность - среднее по счётчику RAPL всего кристалла (CPU + GPU + NPU + контроллер памяти) за время генерации.
Qwen3-8B INT4 | NPU | GPU Arc 130V | CPU |
Генерация, ток/с | 10,7 | 21,2 | 10,0 |
Первый токен, с | 1,7 | 0,17 | 0,46 |
Чтение промпта 1329 токенов, ток/с | 360 | 1171 | 30 |
Мощность кристалла, Вт | 15,4 | 20,6 | 16,0 |
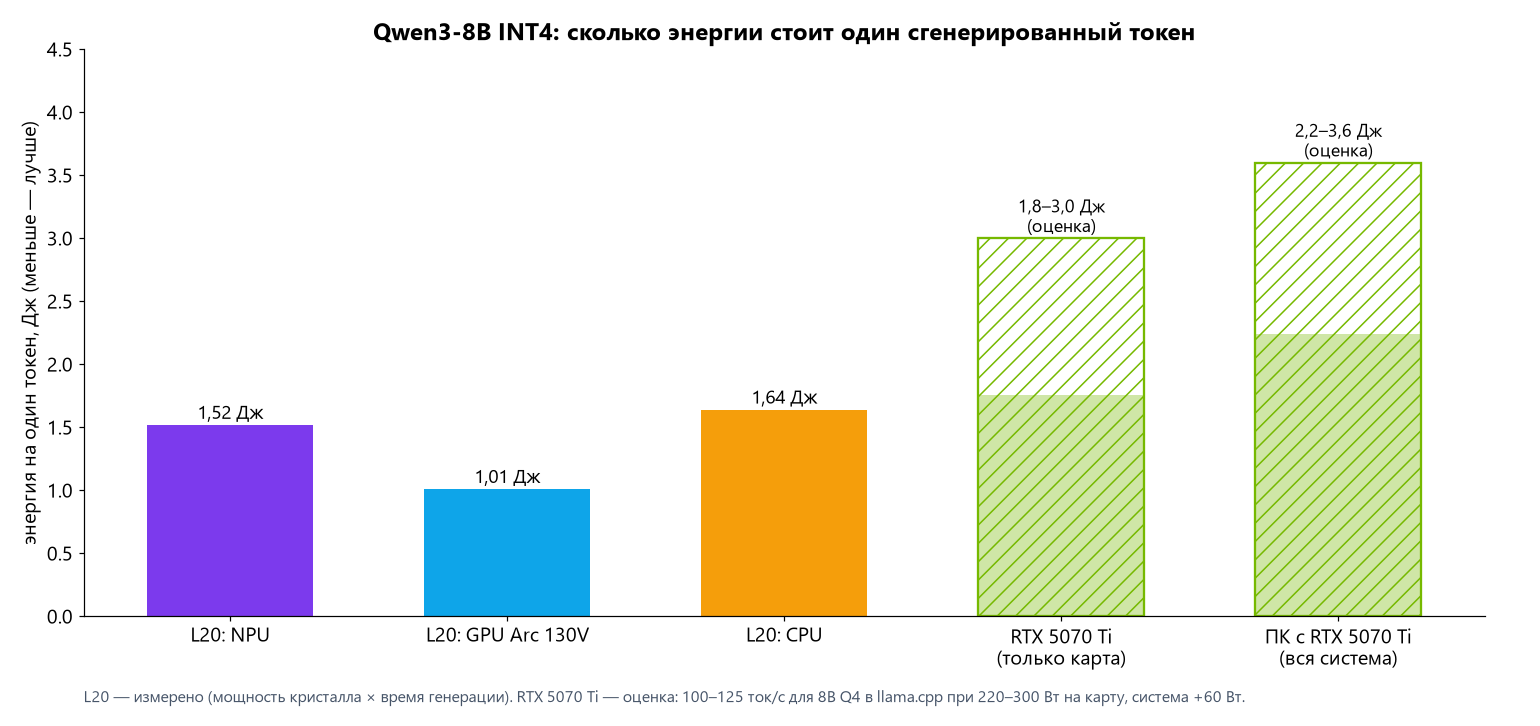
Энергия на токен, Дж | 1,52 | 1,01 | 1,64 |
Скажу прямо: Arc 130V быстрее NPU вдвое и даже тратит меньше энергии на токен 1,01 Дж против 1,52. Графика потребляет на треть больше мощности, но заканчивает работу вдвое быстрее.
Процессор по скорости генерации равен NPU, но читает длинный промпт в 12 раз медленнее и тратит больше всех. Привел данные в график к 1 токену и добавил для сравнения RTX 5070 Ti. Обратите внимание - подобный мини-ПК оказывается практически в 2-3 раза экономичнее, чем компьютер с полноценной дискретной видеокартой.
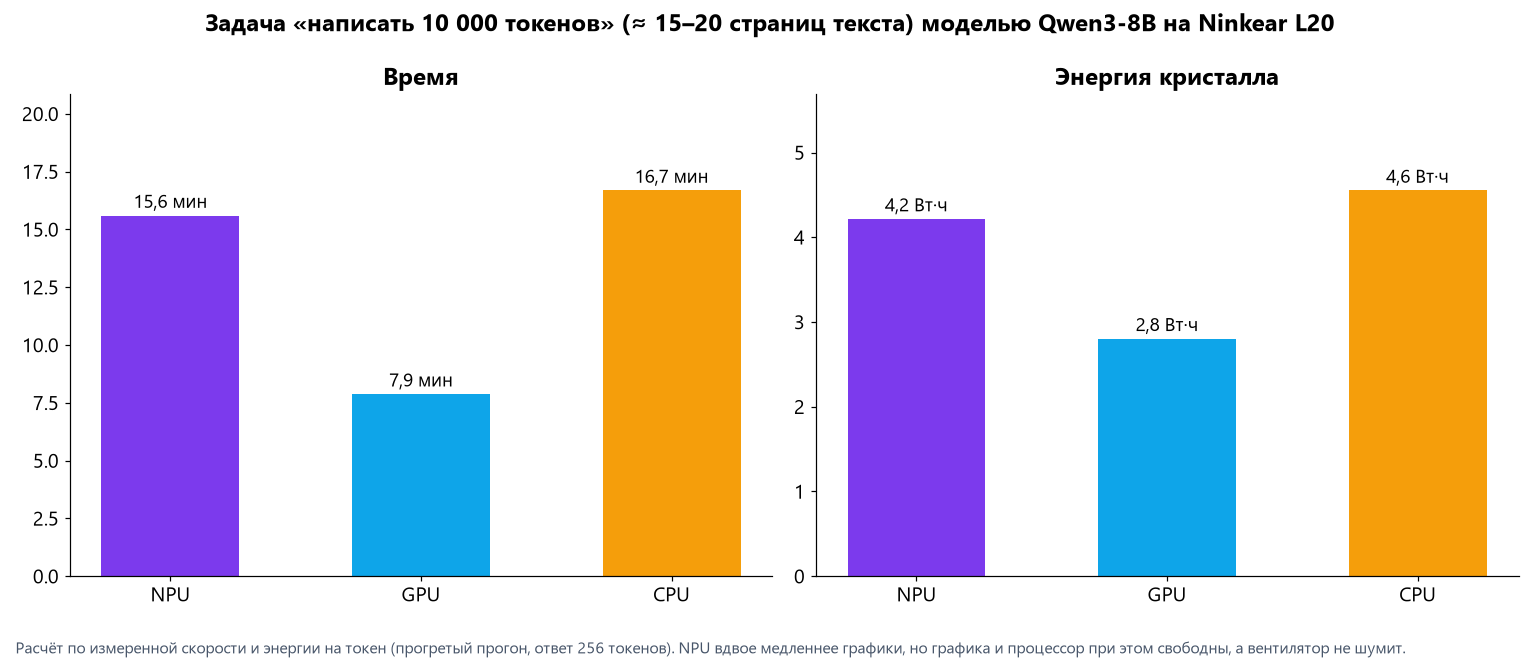
Как это выглядит на большой задаче, например, «написать 10 000 токенов» (15-20 страниц текста). NPU делает её за 15,6 минуты и 4,2 Вт·ч, графика - за 7,9 минуты и 2,8 Втч. Разница в энергии 1,4 Втч, меньше заряда одного телефона. На неполной нагрузке NPU на треть экономичнее графики и в 4-10 раз экономичнее процессора. Специально делаю акцент - если задача не срочная, NPU позволяет отдать её в фон и не занимать графику. Обычно я ставлю пакетную обработку фото или генерацию моделей через LLM и оставляю его работать.
Где NPU выигрывает: параллельная работа. Если две нейросети запустить на одной графике, каждая работает вдвое медленнее. Если языковую модель перенести на NPU, нейросеть на графике сохраняет 92% своей скорости. А все три блока одновременно потребляют 27,5 Вт.
Настройка OpenVINO
Пара слов про настройку. Работает такая связка на базе OpenVINO - это открытый набор инструментов Intel для запуска нейросетей на CPU, GPU и NPU. Модель хранится в формате IR (.xml граф, .bin веса). Для каждого устройства есть плагин: он компилирует граф под конкретное железо. Для работы потребуется настроить драйверы (речь про NPU драйвер) и установить связку OpenVINO+Python и что еще требуется. NPU виден в Диспетчере устройств в разделе «Нейронные процессоры» как Intel(R) AI Boost. Драйверы NPU и графики берутся с сайта Intel (Intel Driver & Support Assistant ставит оба). У меня: NPU 32.0.100.5540, графика 32.0.101.8331. Со старым драйвером NPU многие модели не компилируются - это первое, что стоит обновить. Потребуется Python 3.12 с python.org. На каждый проект - своё виртуальное окружение, чтобы зависимости разных программ не конфликтовали:
python -m venv C:\AI\npu\venv
C:\AI\npu\venv\Scripts\activate
pip install openvino openvino-genai nncf huggingface_hub
Здесь: openvino - среда выполнения, openvino-genai - готовые конвейеры для языковых моделей, Stable Diffusion и распознавания речи, nncf - сжатие моделей в INT8/INT4, huggingface_hub - скачивание моделей (команда hf).
Дальше - проверка устройств и свойств NPU.
python -c "import openvino as ov; c=ov.Core(); print(c.available_devices); print(c.get_property('NPU','FULL_DEVICE_NAME'), c.get_property('NPU','NPU_DRIVER_VERSION'))"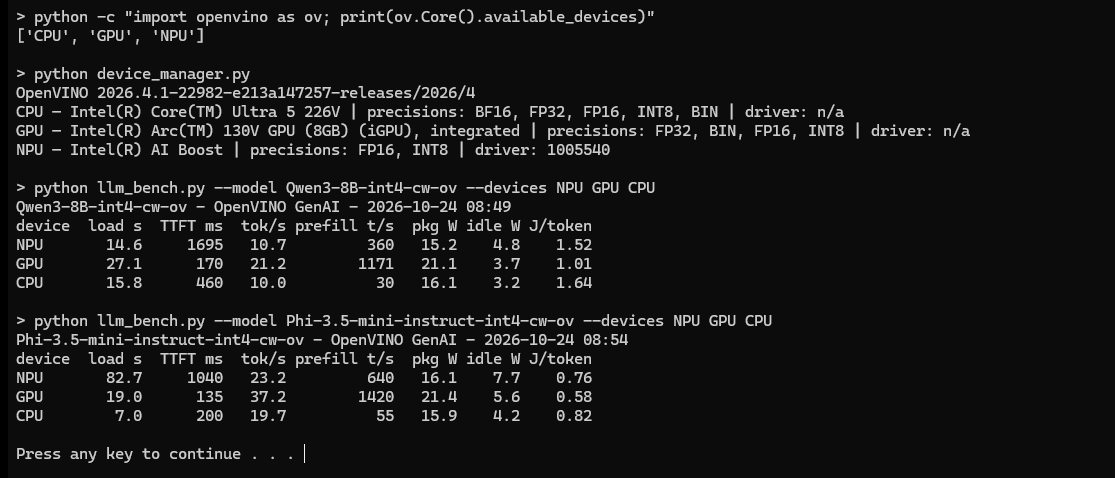
Выбор устройства в коде. Общего переключателя в системе нет: устройство задаёт программа. Варианты:
CPU, GPU, NPU - конкретное устройство. Две видеокарты Intel получают имена GPU.0 и GPU.1;
AUTO - OpenVINO выбирает сам;
HETERO:NPU,CPU - неподдерживаемые NPU операции уходят на процессор.
import openvino as ov
core = ov.Core()
model = core.read_model("model.xml")
compiled = core.compile_model(model, "NPU", {"CACHE_DIR": r"C:\AI\ov_cache", "PERFORMANCE_HINT": "LATENCY"})
result = compiled(input_tensor)[0]
Здесь: PERFORMANCE_HINT задаёт стратегию: LATENCY - один запрос как можно быстрее, THROUGHPUT - максимум кадров в секунду через несколько параллельных запросов. Тест NPU на 99% выше сделан именно с THROUGHPUT и очередью из 8 запросов.
Настройка LLM модели для работы с NPU
Первая компиляция для NPU долгая: Qwen3-8B - 97 секунд, Depth Anything - 30-40 секунд, ESRGAN - 12 минут. С CACHE_DIR скомпилированная модель сохраняется на диск, и следующий запуск занимает секунды (Qwen3-8B 14,6 с). Дальше отмечу, что NPU принимает только фиксированный размер входа. Для картинок модель экспортируют сразу под нужное разрешение (например, 1×3×518×518) или вызывают model.reshape(...) перед компиляцией. Для языковых моделей это делает OpenVINO GenAI: достаточно задать максимальную длину промпта и ответа (см. ниже). Готовые модели для NPU лежат на Hugging Face в коллекции OpenVINO. Для NPU нужны варианты -int4-cw-ov: веса в 4 бита, симметрично, одним масштабом на канал. Свою модель в этом формате можно собрать инструментом optimum-cli (пакет optimum-intel):
optimum-cli export openvino -m Qwen/Qwen3-4B --weight-format int4 --sym --group-size -1 --ratio 1.0 Qwen3-4B-int4-cw-ovЯ пользовался готовыми моделями, эту команду привожу для полноты. Продолжаю настройку:
hf download OpenVINO/Qwen3-8B-int4-cw-ov --local-dir C:\AI\models\Qwen3-8B-int4-cw-ov

import openvino_genai as og
pipe = og.LLMPipeline(r"C:\AI\models\Qwen3-8B-int4-cw-ov", "NPU",
                      CACHE_DIR=r"C:\AI\ov_cache", MAX_PROMPT_LEN=2048, MIN_RESPONSE_LEN=512)
cfg = og.GenerationConfig(); cfg.max_new_tokens = 400
print(pipe.generate("Перескажи текст в пяти пунктах: ... /no_think", cfg))
MAX_PROMPT_LEN и MIN_RESPONSE_LEN нужны только NPU: под эти размеры GenAI «нарезает» модель. Приписка /no_think выключает у Qwen3 режим размышлений. Для удобства я сделал окно чата с выбором устройства, в котором видны скорость и мощность:
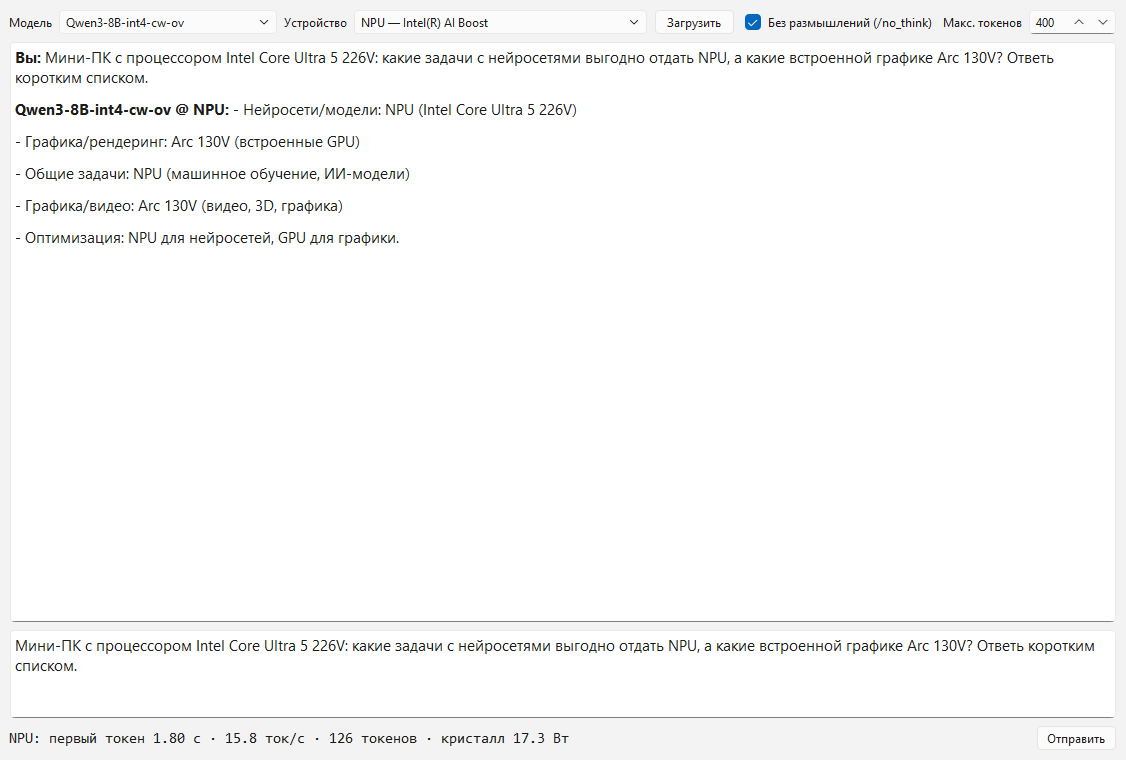
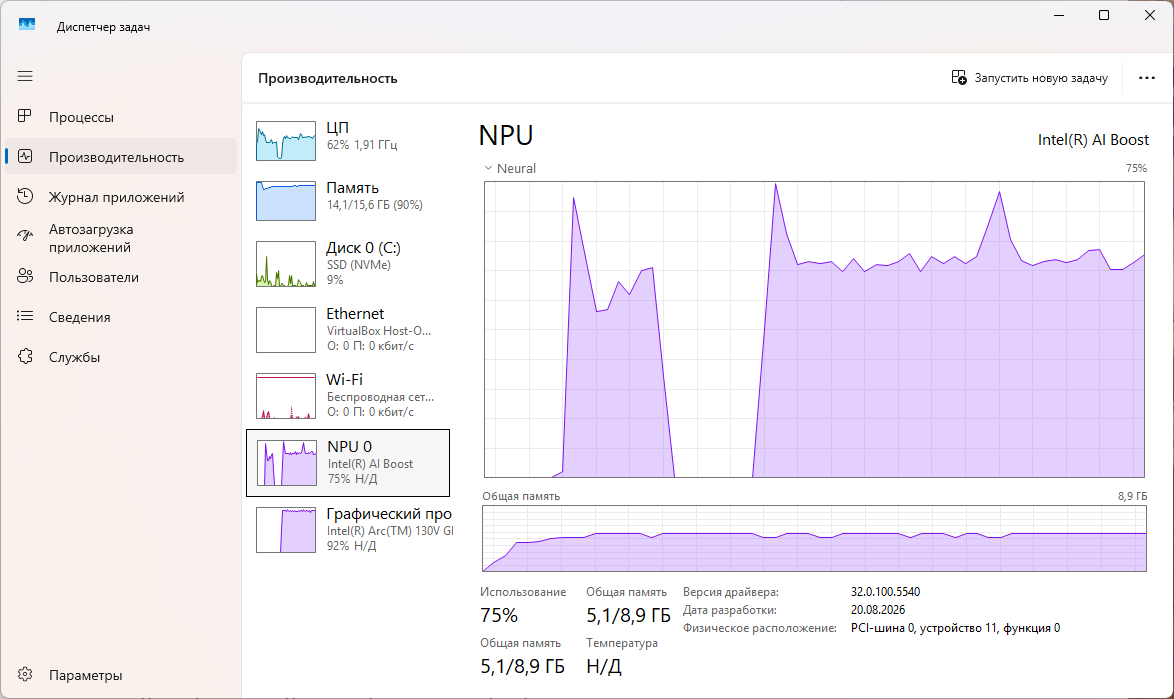
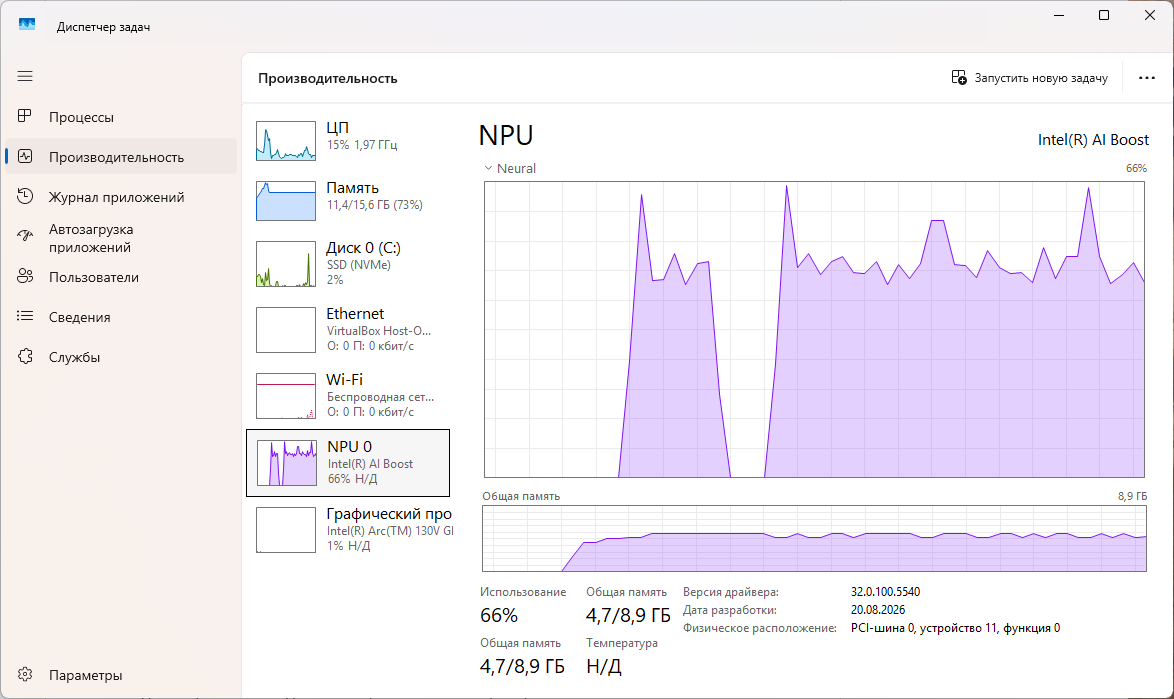
Во время генерации NPU загружен примерно на две трети: языковая модель упирается в скорость памяти.
Синтез речи Qwen3-TTS на NPU
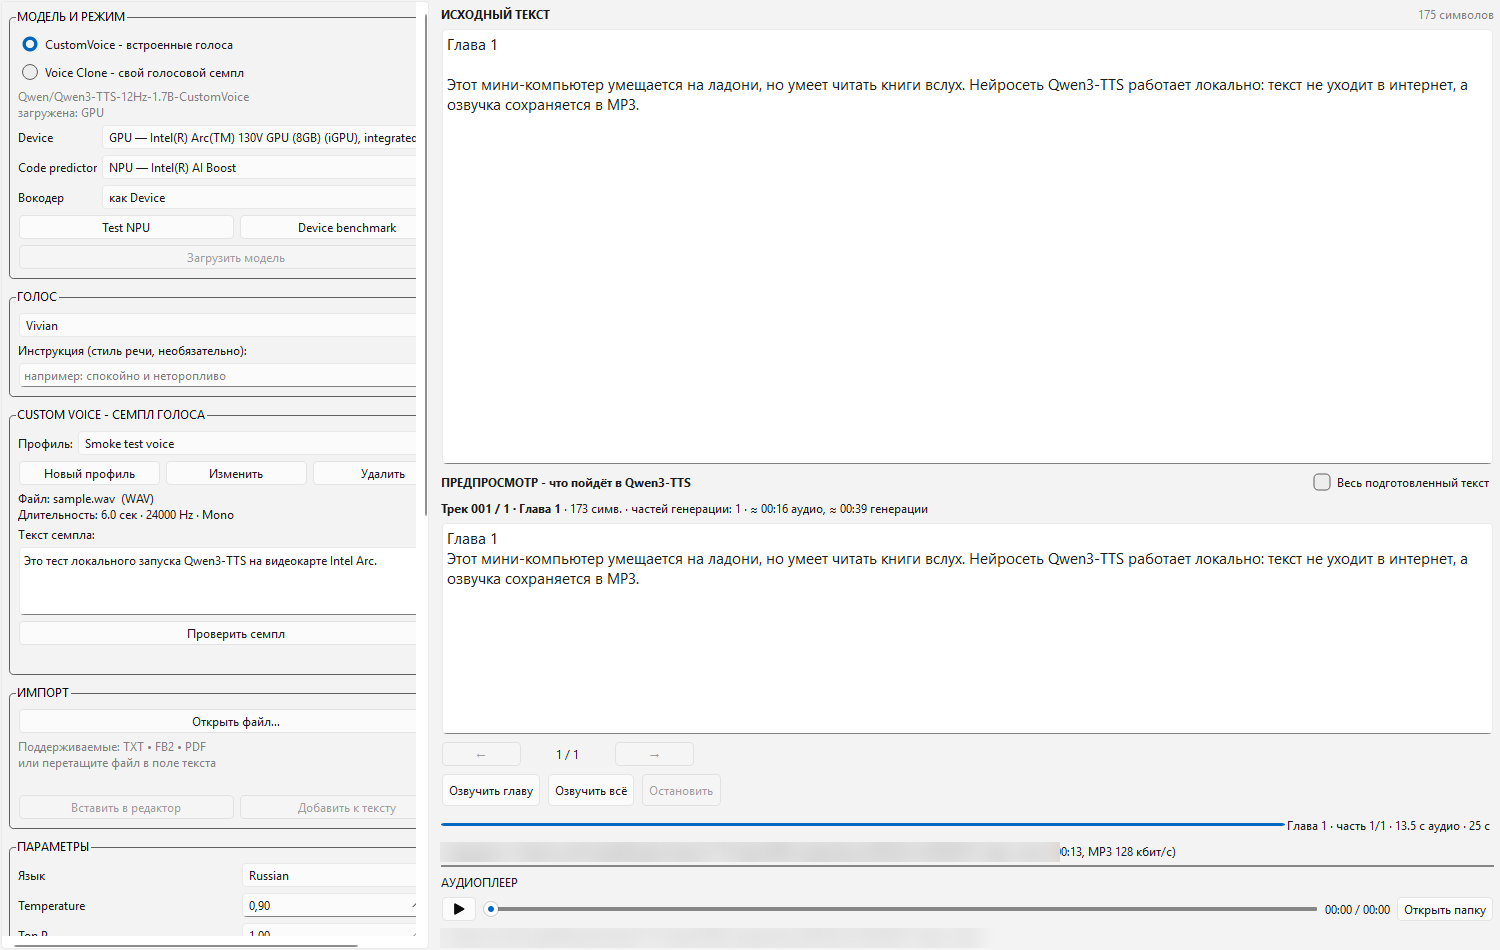
Qwen3-TTS - синтез речи на основе языковой модели (1,7 млрд параметров), с встроенными голосами и клонированием голоса по образцу. У Intel есть официальный пример запуска Qwen3-TTS в OpenVINO (ноутбук qwen3-tts в репозитории openvino_notebooks). Я взял из него конвертер и конвейер. Для Qwen3-TTS нужен PyTorch для конвертации, нужно настроить дополнительное окружение:
python -m venv C:\AI\tts\venv
C:\AI\tts\venv\Scripts\activate
pip install torch==2.8.0 torchaudio==2.8.0 --index-url https://download.pytorch.org/whl/cpu
pip install qwen-tts==0.1.1 openvino nncf soundfile
git clone --depth 1 https://github.com/openvinotoolkit/openvino_notebooks
hf download Qwen/Qwen3-TTS-12Hz-1.7B-CustomVoice --local-dir C:\AI\models\Qwen3-TTS-1.7B-CustomVoice
hf download Qwen/Qwen3-TTS-12Hz-1.7B-Base --local-dir C:\AI\models\Qwen3-TTS-1.7B-Base
CustomVoice - модель со встроенными голосами, Base - для клонирования голоса по образцу. Каждая весит около 4,2 ГБ. Конвертация в IR - функцией из примера Intel, около 3 минут на модель:
cd openvino_notebooks\notebooks\qwen3-tts
python -c "from qwen_3_tts_helper import convert_qwen3_tts_model as c; c(r'C:\AI\models\Qwen3-TTS-1.7B-CustomVoice', r'C:\AI\models\Qwen3-TTS-CV-OV')"
Процесс запуска генерации:
from qwen_3_tts_helper import OVQwen3TTSModel
import soundfile as sf
tts = OVQwen3TTSModel.from_pretrained(r"C:\AI\models\Qwen3-TTS-CV-OV", device="GPU")
wavs, sr = tts.generate_custom_voice(text="Глава первая. ...", speaker="aiden", language="Russian",
                                     temperature=0.9, top_k=50, repetition_penalty=1.05, max_new_tokens=2048)
sf.write("chapter1.wav", wavs[0], sr)
Параметры по умолчанию модели: temperature 0,9, top_k 50, repetition_penalty 1,05. За один проход модель озвучивает до 8192 токенов (около 11 минут звука), поэтому книгу я режу на куски около 1500 символов по абзацам и склеиваю результат. Пример Intel официально исключает NPU, и проверка это подтвердила. Основная часть модели (talker) и вокодер имеют динамические формы и KV-кэш, их компилятор NPU не принимает. Но в модели есть «предсказатель кодов» (code predictor), который вызывается 15 раз на каждый кадр звука. Я переэкспортировал его в статическую форму без состояния (вход 1×16×2048), и он заработал на NPU с тем же результатом, что в PyTorch.
Qwen3-TTS 1.7B | RTF |
Всё на графике (статический предсказатель) | 1,73 |
Графика + предсказатель на NPU | 2,0-2,1 |
Процессор + предсказатель на NPU | 6,7 |
Всё на процессоре | 8,8-9,9 |
RTF во сколько раз генерация дольше звука. Самый быстрый вариант - это графика ARC 130V. Вариант «процессор + NPU» в полтора раза быстрее чистого процессора и не трогает графику вовсе - удобно для озвучки книги ночью, пока компьютер занят чем-то ещё. Разборчивость проверялась распознаванием речи Whisper: 95-100% слов во всех вариантах.
GIMP и нейросети OpenVINO
Intel выпускает бесплатный набор плагинов для GIMP 3: увеличение разрешения, сегментация, Stable Diffusion (генерация и инпейнтинг) и FastSD. Устройство выбирается в окне плагина. Установка подобным образом:
winget install --id GIMP.GIMP.3 --version 3.0.8.2 --scope user
mkdir C:\AI\GIMP_OpenVINO
cd C:\AI\GIMP_OpenVINO
git clone --branch 3.3.0 https://github.com/intel/openvino-ai-plugins-gimp.git
openvino-ai-plugins-gimp\install.bat
gimpenv3\Scripts\python.exe -m pip install "optimum-intel==2.0.0"
gimpenv3\Scripts\python.exe openvino-ai-plugins-gimp\model_setup.py
Версию GIMP я взял 3.0.x: на ней Intel проверяет плагины. install.bat создаёт для плагинов отдельное окружение gimpenv3 и копирует их в %APPDATA%\GIMP\3.0\plug-ins. model_setup.py - меню загрузки моделей Stable Diffusion. Super Resolution и сегментация входят в комплект. Модели инпейнтинга меню скачивает целым репозиторием (14 и 19 ГБ) и конвертирует сам. Я поступил экономнее: скачал только FP16-веса и сконвертировал той же командой, что вызывает плагин, положив результат в его папку моделей:
hf download stable-diffusion-v1-5/stable-diffusion-inpainting --include "*.json" "*.txt" "*fp16.safetensors"
gimpenv3\Scripts\optimum-cli export openvino --model <папка_скачанной_модели> --variant fp16 --weight-format fp16 --task image-to-image %USERPROFILE%\openvino-ai-plugins-gimp\weights\stable-diffusion-ov\stable-diffusion-1.5\inpainting
Для SDXL - то же с репозиторием diffusers/stable-diffusion-xl-1.0-inpainting-0.1 и папкой stable-diffusion-xl\inpainting.
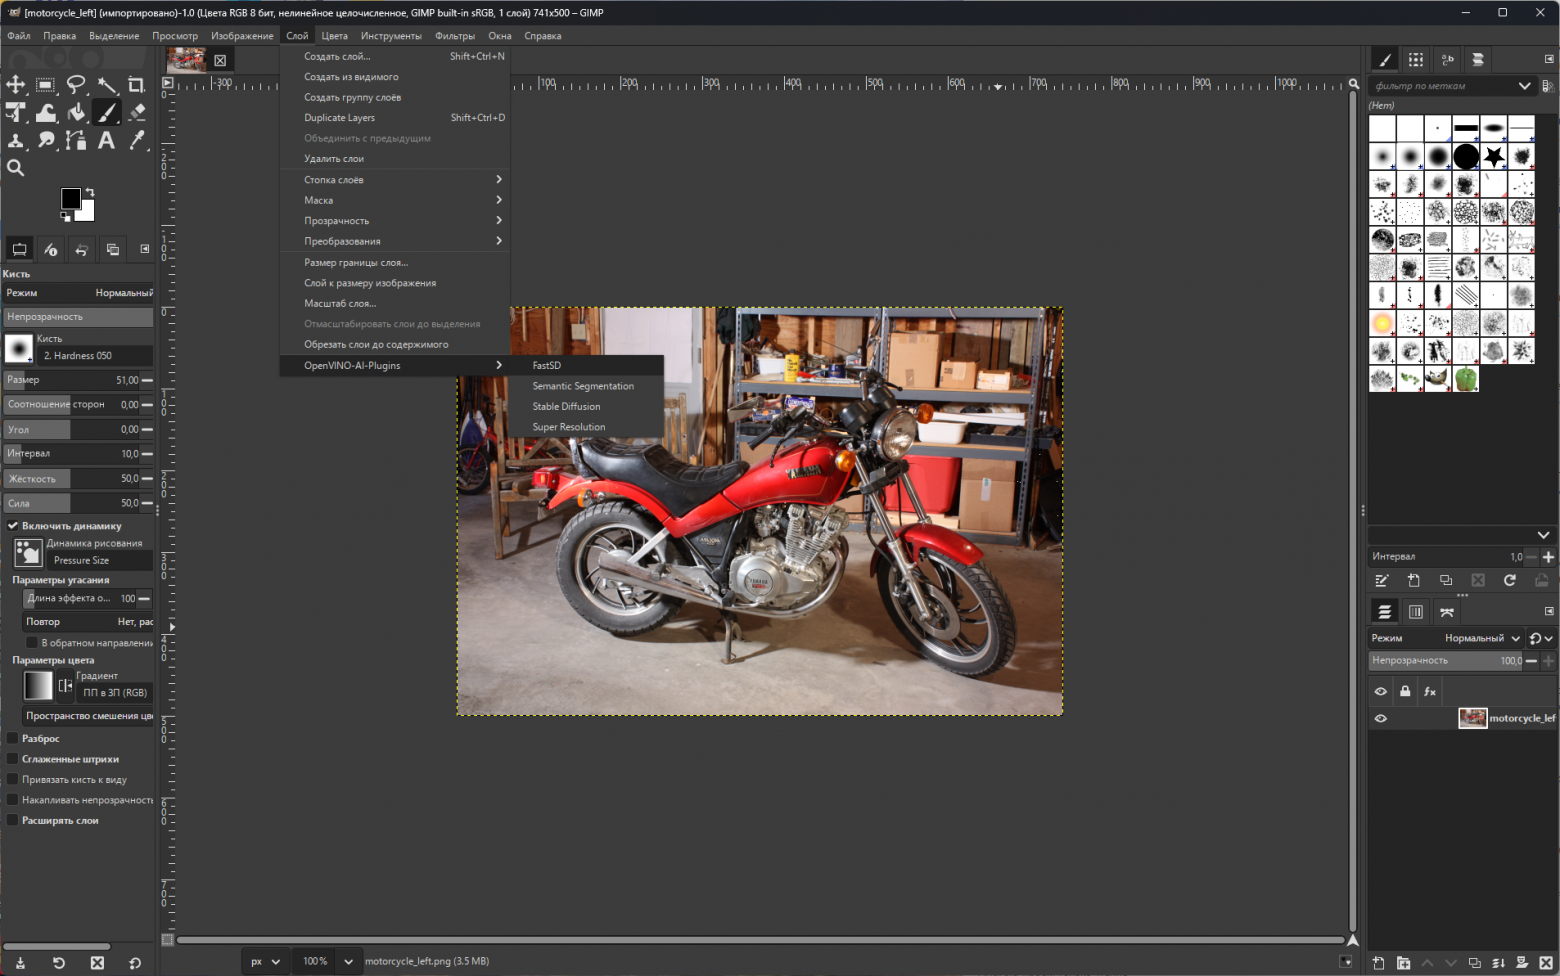
Нюанс: плагины работают только в интерактивном режиме. Из пакетного режима GIMP они ничего не делают.
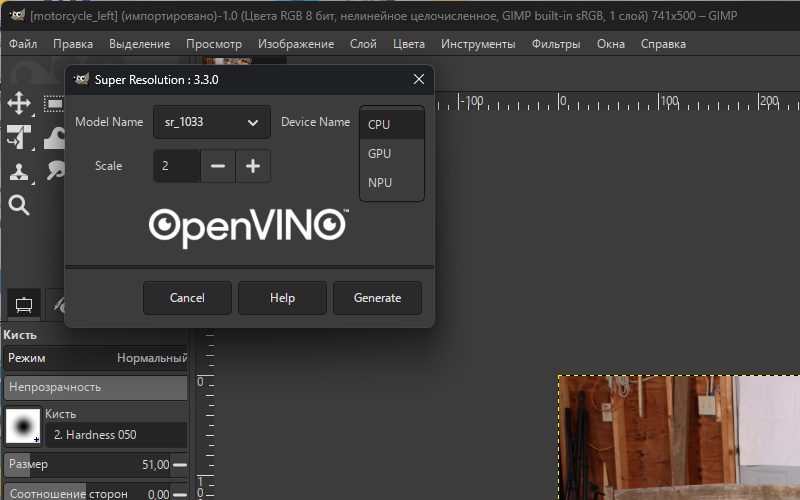
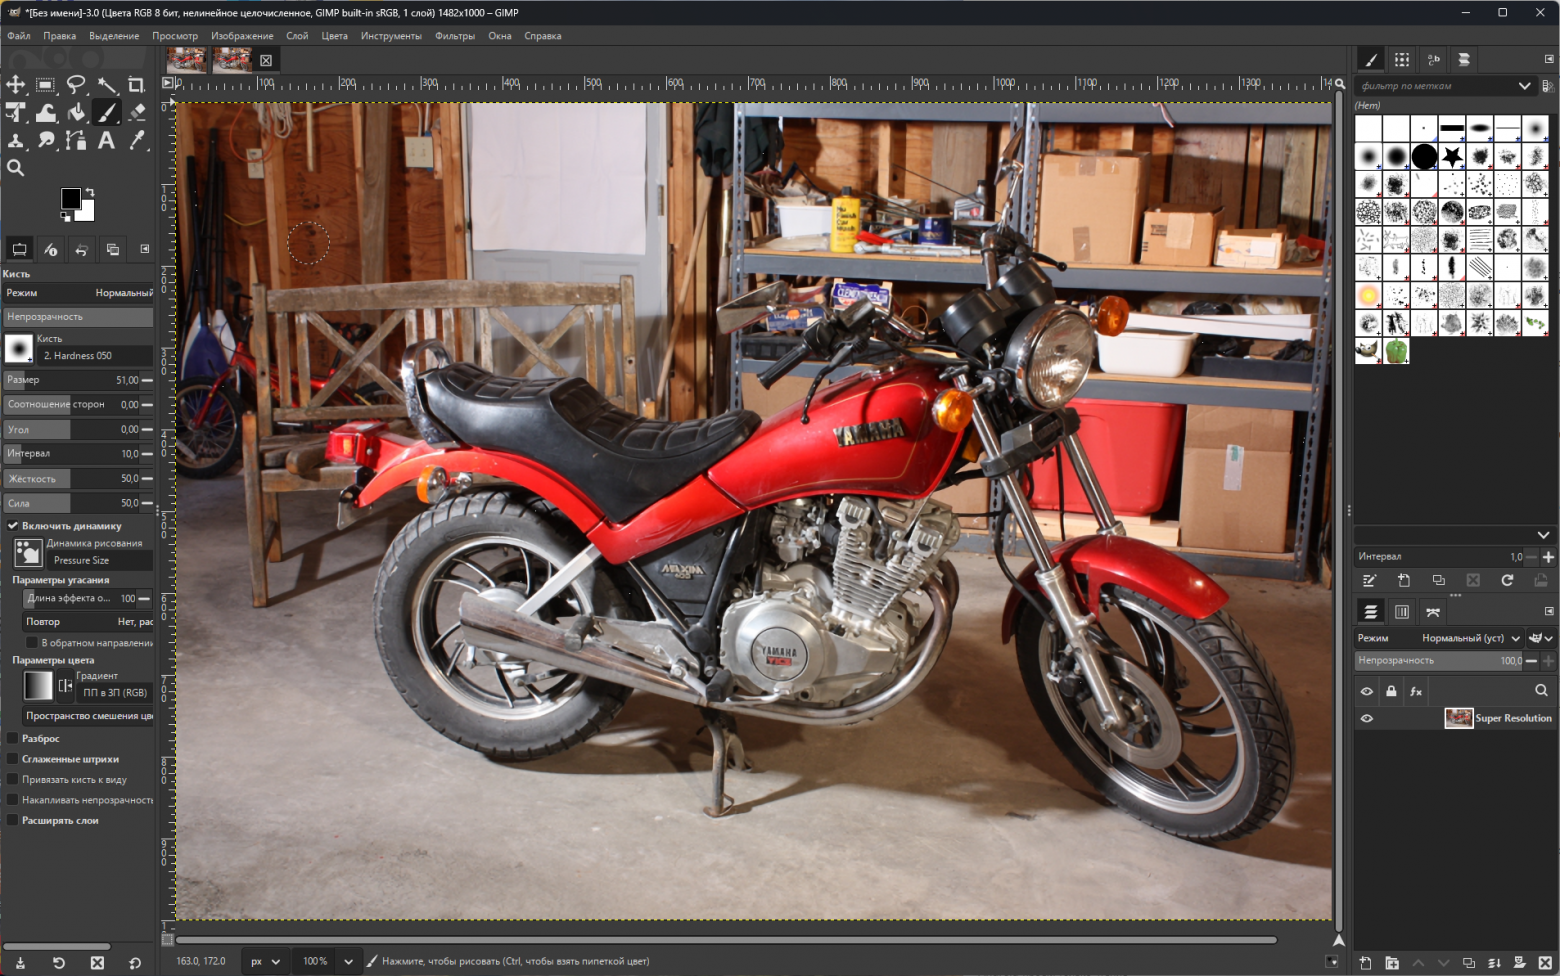
Тест апскейлинга 741×500 → 1482×1000 пх.
Модель | CPU | GPU | NPU |
Super Resolution sr_1033 | 151 мс | 32 мс | 46 мс |
Super Resolution ESRGAN ×4 | 64 с | 1,0 с | 1,2 с |
Сегментация deeplabv3 | 200 мс | 7,6 мс | 19,5 мс |
Сегментация sseg-adas-0001 | 491 мс | 31 мс | неверный результат |
SD 1.5 Inpainting, 512×512, 20 шагов | 284 с | 25 с | не компилируется |
SDXL Inpainting, 1024×1024, 20 шагов | - | 107 с | не компилируется |
Для NPU в GIMP подходят Super Resolution и сегментация deeplabv3. Модель sseg-adas-0001 на NPU работает без ошибок, но результат неверный: с процессором совпадают 2,3% пикселей. Stable Diffusion - только на графике, в режиме Power Mode - Best performance. Так что для тяжелых генераций имеет смысл подключить eGPU (но это уже отдельная история).
3D-рельеф из фото: Depth Anything на NPU
Depth Anything V2 строит карту глубины по одному фото. Из неё моя программа Depth & Relief Studio делает рельеф с основанием и рамкой и экспортирует STL для 3D-печати. Это идеальная задача для NPU: модель картиночная, размер входа фиксированный, а пакет из сотни фотографий можно поставить в фон. Настройка конвертации модели в IR под NPU (окружение с torch и transformers):
import torch, openvino as ov
from transformers import AutoModelForDepthEstimation
class DepthOnly(torch.nn.Module):
    def __init__(self, m):
        super().__init__()
        self.m = m
    def forward(self, x):
        return self.m(pixel_values=x).predicted_depth

m = AutoModelForDepthEstimation.from_pretrained("depth-anything/Depth-Anything-V2-Small-hf").eval()
with torch.no_grad():
    ovm = ov.convert_model(DepthOnly(m), example_input=torch.zeros(1, 3, 518, 518), input=[1, 3, 518, 518])
ov.save_model(ovm, "small_fp16_518/model.xml", compress_to_fp16=True)
Фиксированный вход 518×518 (кратно 14 - размеру патча ViT) сразу делает модель пригодной для NPU. Сжатие в INT8 инструментом NNCF, без переобучения. Для калибровки хватило восьми моих фото рельефов, размноженных отражениями и кадрированиями до 88 примеров. tensors - список этих примеров, подготовленных так же, как для инференса: размер 518×518, нормализация ImageNet, массив 1×3×518×518:
import nncf
q = nncf.quantize(ov.Core().read_model("small_fp16_518/model.xml"), nncf.Dataset(tensors),
                  model_type=nncf.ModelType.TRANSFORMER, subset_size=len(tensors))
ov.save_model(q, "small_int8_518/model.xml")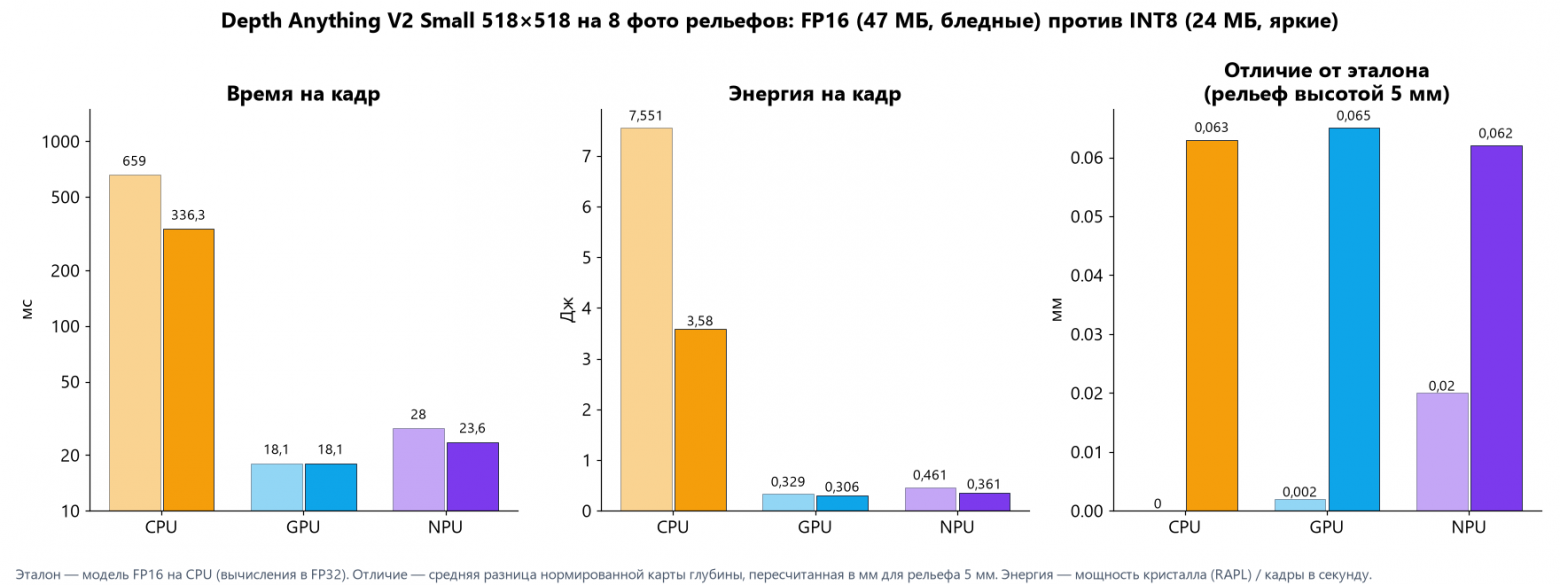
Depth Anything V2 Small | CPU | GPU | NPU |
FP16, мс на кадр | 659 | 18,1 | 28,0 |
INT8, мс на кадр | 336 | 18,1 | 23,6 |
INT8, Дж на кадр | 3,58 | 0,31 | 0,36 |
INT8, отличие от FP16 (рельеф 5 мм) | 0,063 мм | 0,065 мм | 0,062 мм |
INT8 уменьшает модель с 47 до 24 МБ, ускоряет NPU на 16% и процессор вдвое. Отличие от FP16 - в среднем 0,06 мм на рельефе высотой 5 мм, меньше слоя FDM-печати.
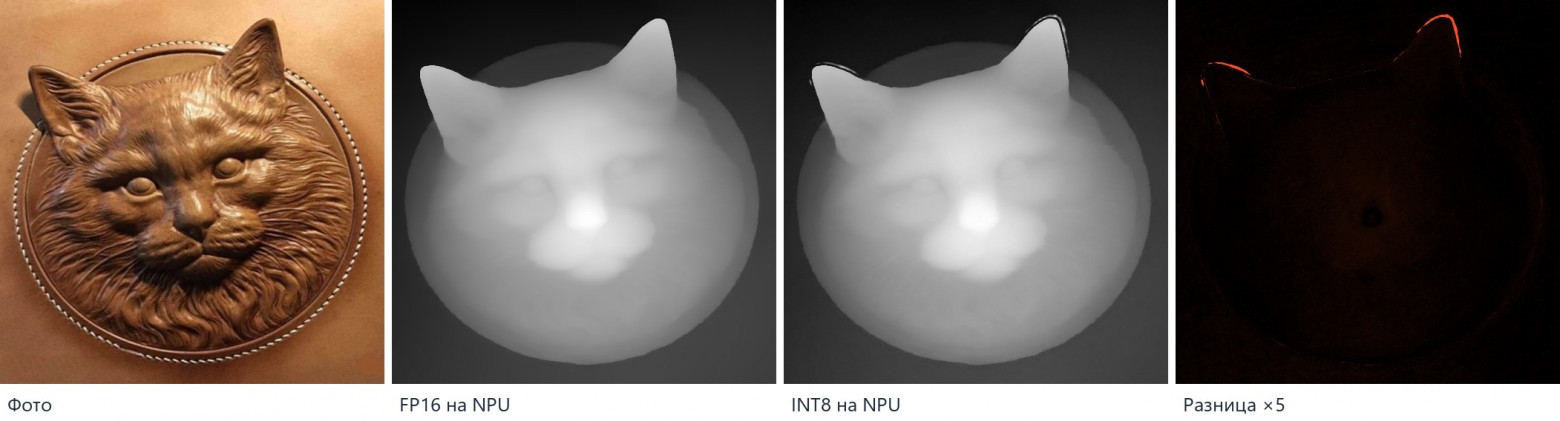
Разница собрана по резким контурам, а не по всей поверхности:
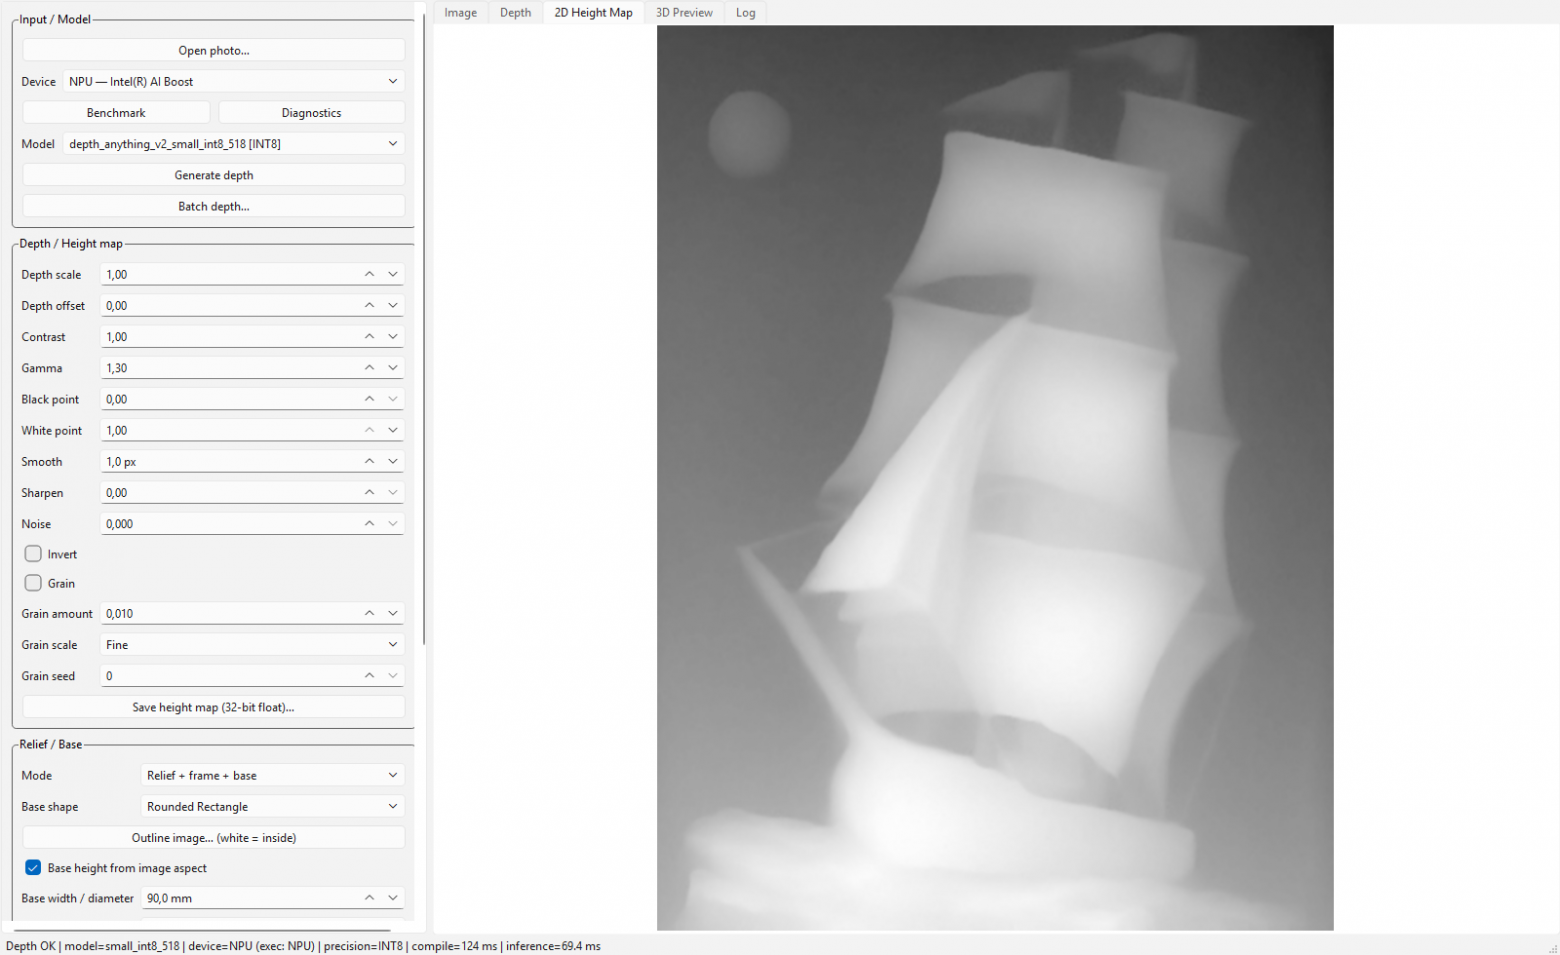
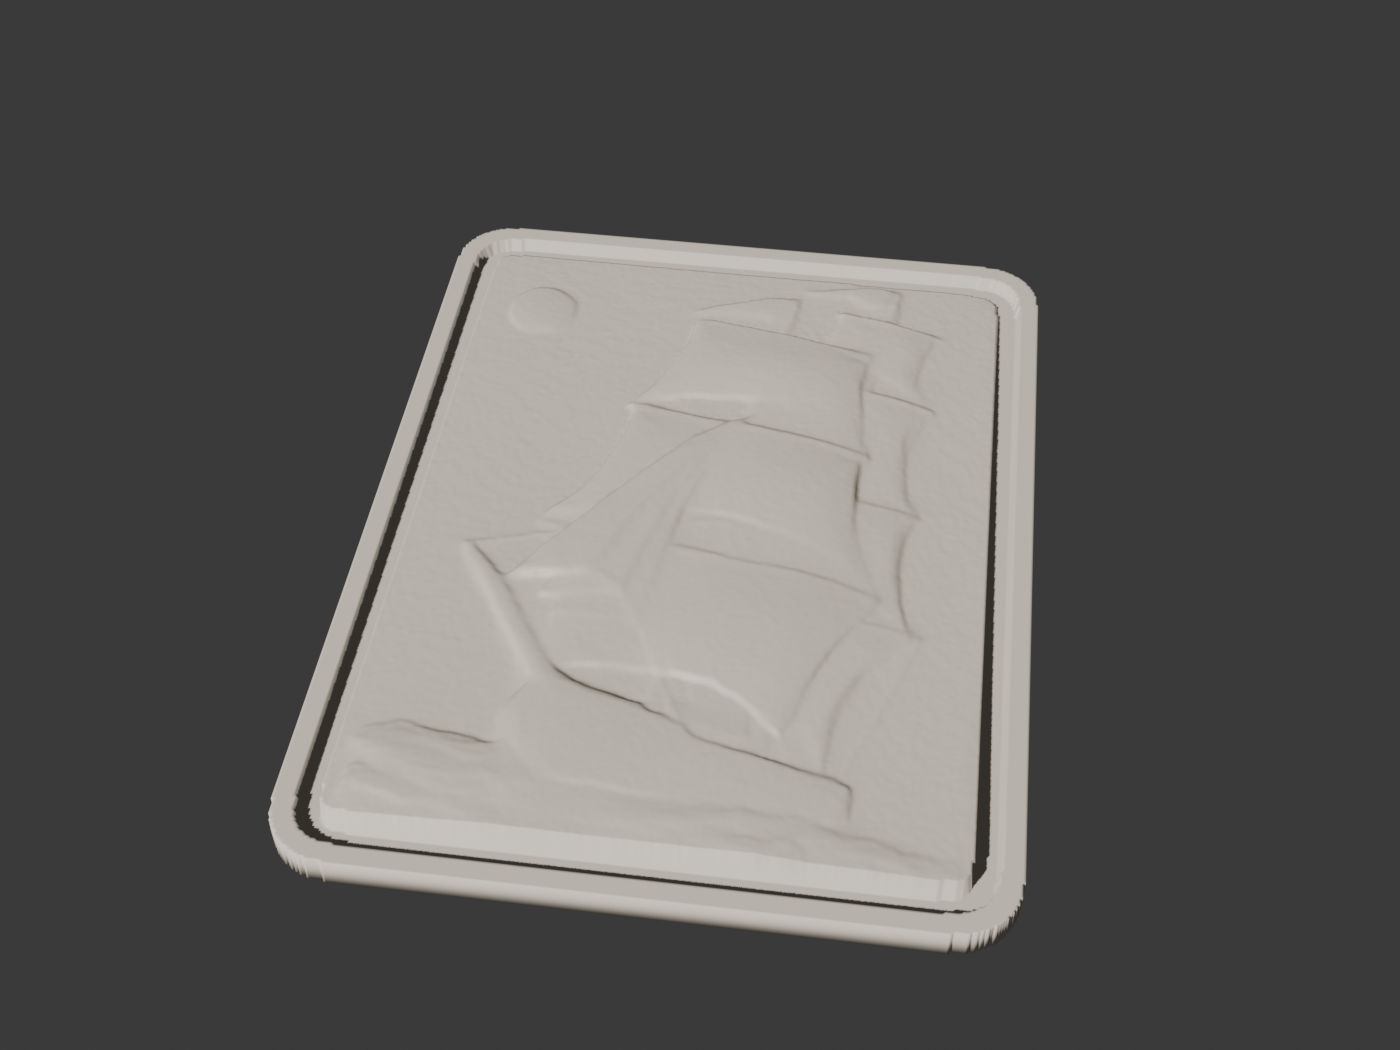
Рельеф Парусник 90 × 120 мм, STL прошёл проверку на замкнутость, можно отправлять на принтер для FDM печати.
Такой сценарий работы «поставить и забыть» удобен, особенно если в очереди много файлов для обработки: в программе есть пакетный режим (папка с фото → папка с картами глубины). На NPU в INT8 он идёт в фоне на 24 мс и 0,36 Дж на кадр, вентилятор при этом не слышно, а графика свободна для Blender или слайсера.
Сравнение с Tesla V100 и флагманскими видеокартами
Я не так давно рассказывал про приобретение Tesla V100 (и в качестве eGPU, и для домашнего ИИ-сервера). Для сравнения вот такой график. Указываю паспортную мощность видеокарт (реально могут быть другие цифры, нужно также прогонять на тестах для более детального сравнения), рядом с измеренной мощностью кристалла L20:
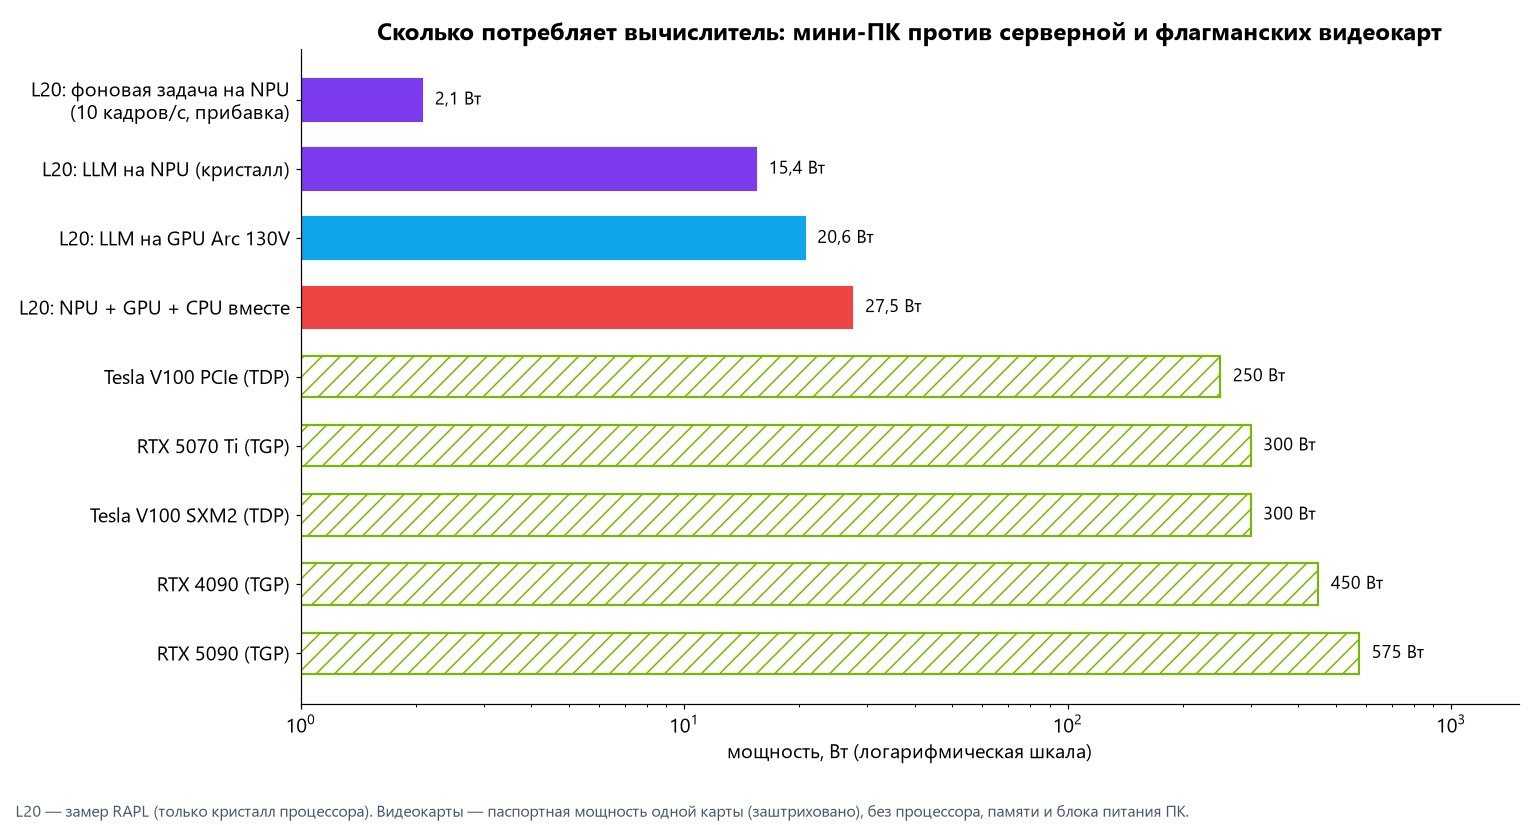
Tesla V100 - 250 Вт (PCIe) или 300 Вт (SXM2), RTX 5070 Ti - 300 Вт, RTX 4090 - 450 Вт, RTX 5090 - 575 Вт. И это одна карта, без процессора, памяти и блока питания.
L20 на языковой модели потребляет 15-21 Вт на кристалл, все три блока сразу - 27,5 Вт, фоновая задача на NPU - плюс 2 Вт к простою.
Выводы
NPU медленный. Языковая модель на нём работает вдвое медленнее, чем на Arc 130V, и тратит на токен даже больше энергии. Если результат нужен сейчас - считайте на графике.
NPU экономный в фоне. На неполной нагрузке он добавляет к простою 1-2 Вт - это на треть меньше графики и в 4-10 раз меньше процессора.
NPU почти не шумит. При работе нейросети на NPU шум L20 остаётся на уровне простоя (22-24 дБ). С графикой и процессором - 33-34 дБ.
NPU работает параллельно. Отдав ему одну нейросеть, вы сохраняете графику и процессор: задача на графике теряет всего 8% скорости.
Не всё запускается на NPU. Stable Diffusion, основная часть Qwen3-TTS и модели с динамическими формами не компилируются. Некоторые модели (sseg-adas-0001) дают неверный результат без ошибок - проверяйте на эталоне.
Кэш и статические формы - обязательны. Без CACHE_DIR каждый запуск начинается с минутной компиляции.
INT8 для картиночных моделей - да. Depth Anything в INT8 на NPU быстрее на 16%, вдвое меньше и почти не отличается от FP16.
Итог простой: NPU в L20 - не ускоритель «для скорости», а тихий экономичный помощник. Подходящий вариант, чтобы поставить задачу и забыть, если результат не нужен срочно: пересказ документов, пакетная обработка фото в рельефы, озвучка книги в связке с процессором. Мини-ПК при этом не слышно, а графика и процессор свободны для основной работы.
А какие фоновые задачи вы бы отдали NPU на своём компьютере?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.