125Bの「Qwen3.8-Flash-Next」の量子化版をゲーミングPCで高速ローカル実行可能にするAI実行アプリ「Strata」
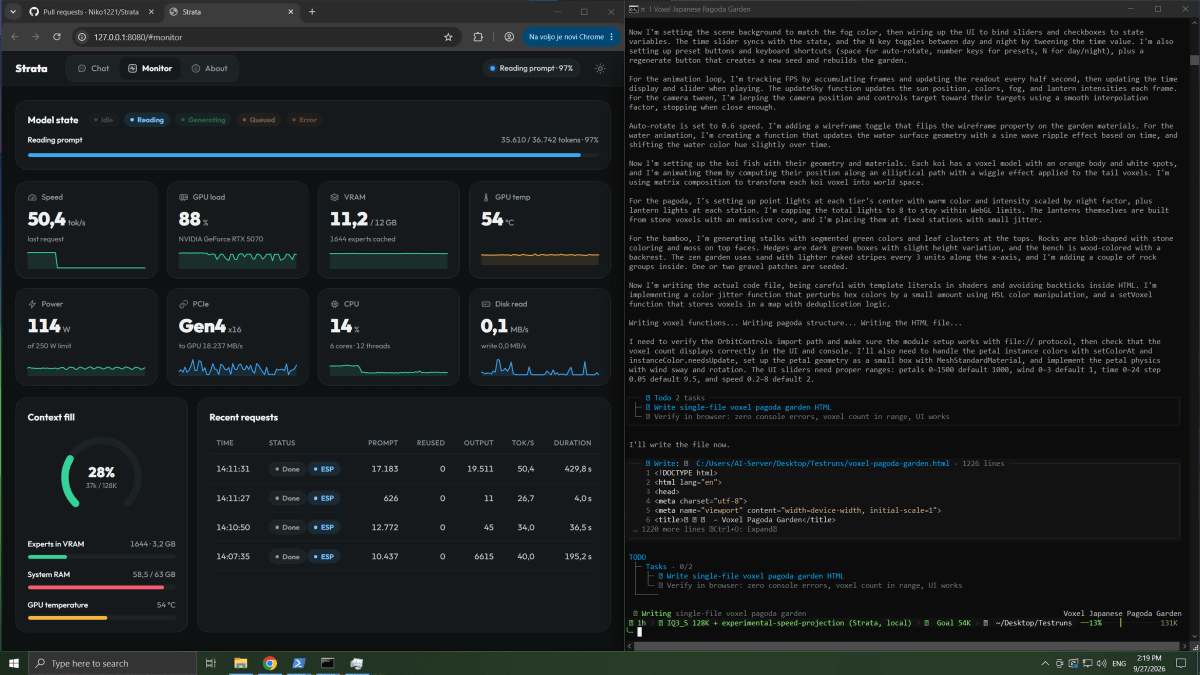
最先端AIモデルがオープンモデルとして公開される例が増えていますが、最先端モデルは規模が大きすぎてローカルで実行するにはデータセンター級のAI実行インフラが必要となります。「Strata」は1250億パラメーターのQwen3.8-Flash-Nextの量子化版を比較的入手しやすいハイエンドゲーミングPCで実行可能にするアプリです。
GitHub - Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input. · GitHub
https://github.com/Niko1221/Strata
Strata/README.ja.md at main · Niko1221/Strata · GitHub
https://github.com/Niko1221/Strata/blob/main/README.ja.md
Strataは「MoEモデル全体をRAMに読み込んで、VRAMには使用頻度の高い専門家モデルを読み込む」「軽量モデルで次のトークンを予測する投機的デコードを用いる」といった仕組みを組み合わせてVRAM容量の少ないPCでの大規模モデル実行をサポートしています。StrataでQwen3.8-Flash-Nextを実行するには「12GB以上のVRAMを備えたNVIDIAもしくはAMD製GPU」「32GB以上のRAM」「80GB以上のストレージ(SSDを推奨)」「Windows 10/11もしくはLinux」が必要です。
RAM容量32GBの場合はQwen3.8-Flash-Nextのコーディング用途以外の専門モデルを省いて軽量化した「Qwen3.8-Flash-Next · GSQ-RCO Coder 」のみ実行可能。RAM容量64GBだと2ビット量子化版の「IQ2_XS」や3ビット量子化版の「IQ3_XXS」「 IQ3_S」を実行可能で、さらに多くのRAMがあれば精度の高い量子化版も実行できます。
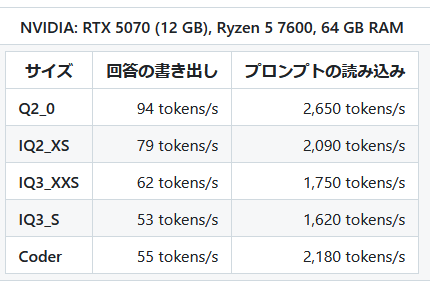
「NVIDIA GeForce RTX 5070(VRAM 12GB)」「Ryzen 5 7600」「RAM 64GB」という環境の場合、2ビット量子化版の「Q2_0」を94トークン/秒で動かすことに成功。3ビット量子化版の「IQ3_S」も53トークン/秒で動作しています。
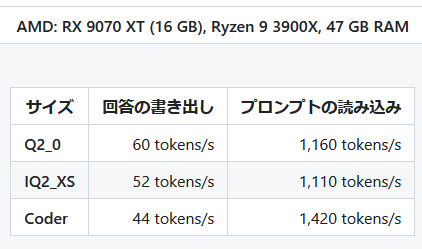
「AMD Radeon RX 9070 XT(VRAM 16GB)」「Ryzen 9 3900X」「RAM 47GB」という環境でも2ビット量子化版の「Q2_0」を60トークン/秒で実行できました。
Strataはインターネット上で大きな話題となっており、Xにも動作報告が数多く投稿されています。例えば、以下のユーザーは「NVIDIA GeForce RTX 5070(VRAM 12GB)」を搭載した環境で2ビット量子化版の「IQ2_XS」が高速動作する様子を投稿しています。
ただし、Qwen3.8-Flash-Nextを量子化することで性能が大きく低下することも報告されています。以下の投稿では2ビット量子化版の「IQ2_XS」で円周率を出力させた結果、同じトークンを何度も出力するループに陥った様子を確認できます。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.