[ITmedia News] SpaceXAI、「Grok 4.7」発表 コーディングと知識労働向けで同社最高性能、価格は据え置き
米SpaceX傘下のAI部門であるSpaceXAIは9月21日(現地時間)、AIモデル「Grok 4.7」を発表した。コーディングと知識労働向けのモデルとしては同社で最も高性能だとしている。前モデル「Grok 4.6」と同じ価格と速度で提供し、同等クラスのモデルと比べて2倍高速で価格は半分としている。
Grok 4.7は、Grok 4.6より大規模な新しいベースモデルを採用した。完了までに何時間もかかる問題を中心に、より難度の高いタスクを組み合わせ、強化学習の期間も延ばした。これにより、自身の作業を検証する能力や、長いコンテキストを扱う能力が向上したという。同社のAIエージェント「Grok Bot」のハーネスをネイティブに理解できるように訓練したことで、会話型タスクや一般的な知識労働の性能も高めたとしている。
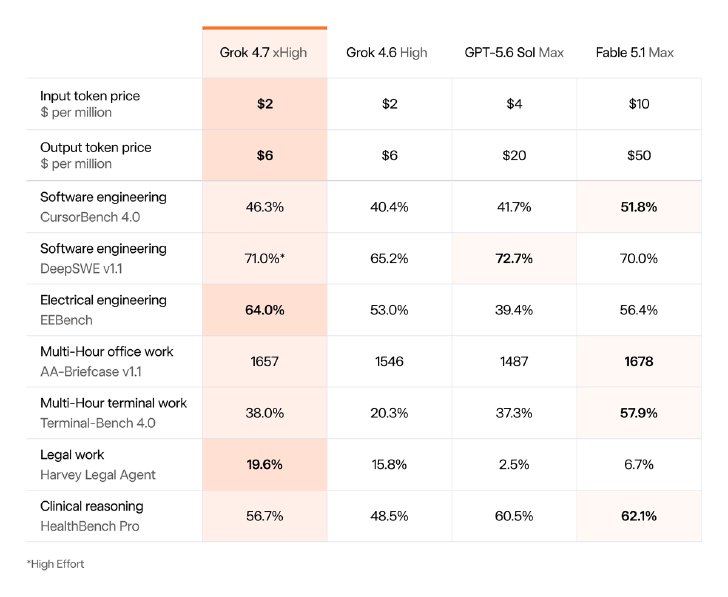
Grok 4.7(xHigh)の評価結果も公開した。比較対象はGrok 4.6(High)、米OpenAIの「GPT-5.6 Sol」(Max)、米Anthropicの「Claude Fable 5.1」(Max)だ。長時間のコーディングタスクを評価する「CursorBench 4.0」では、Grok 4.7が46.3%で、Grok 4.6の40.4%、GPT-5.6 Solの41.7%を上回った。Fable 5.1は51.8%だった。同社は、このベンチマークで価格性能比がトップクラスにあるとしている。電気工学の「EEBench」では64.0%、法務の「Harvey Legal Agent Benchmark」では19.6%で、比較した4モデルの中で最高だった。一方、長時間のターミナル作業を評価する「Terminal-Bench 4.0」は38.0%で、Fable 5.1の57.9%を下回った。臨床推論の「HealthBench Professional」は56.7%で、GPT-5.6 Sol(60.5%)とFable 5.1(62.1%)に及ばなかった。
文書やプレゼンテーションの作成能力も向上した。弁護士や看護師、金融アナリストなどの専門職の業務をAIに実行させる「GDPval」では、Grok 4.7のEloスコアが1695となった。Grok 4.6の1605、OpenAIの「GPT-6 Astra」の1542を上回り、Fable 5.1の1735に次ぐ結果だった。
安全面では、セーフガードの仕組みを全面的に刷新した。拒否応答とジェイルブレイク耐性で、同社がテストしたモデルの中で最も強力という。生物学分野の安全性を評価するLatchBioのベンチマークでは62.4%で首位だった。悪意のあるサイバータスクへの対応を測る同社独自のベンチマーク「HackerBench v0.3」では、リスクのあるデュアルユースのプロンプトを通したのは3.3%にとどまった。一方で、正当なセキュリティ業務はほとんどブロックしないとしている。また、一部のサイバーセキュリティパートナーに、防御研究を目的として、Grok 4.7のレッドチーム機能への招待制アクセスの提供を始めた。
Grok 4.7は同日から「Cursor」と同社のコーディングツール「Grok Build」で利用できる。Grok APIのほか、サードパーティ製のコーディングハーネス、モデルルータ、クラウドプラットフォームでも提供する。
API料金は100万トークン当たり入力が2ドル、出力が6ドルから。比較対象のGPT-5.6 Solは入力4ドル、出力20ドル、Fable 5.1は入力10ドル、出力50ドルとしている。出力速度が2倍で料金も2倍の高速版も用意した。
SpaceXのイーロン・マスクCEOはXへの投稿で、Grok 4.7によってSpaceXAIはエージェント型コーディングの分野でAnthropic、OpenAIに次ぐ3位になったと述べた。大幅に高速で低コストであることを考慮すれば、日常的な主力モデルとして優れた選択肢になるとしている。
米NVIDIAはXで、同社のアクセラレーテッドコンピューティングで開発チームを支援したとして発表を祝福した。米Boxは、Grok 4.7を使った「Box Agent」のプレビューデモをXへの投稿で公開した。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.