各AIモデルに最適なハーネスはどれか?
AIエージェントの実行基盤を開発するRuntaが、AIコーディングエージェントのハーネス22構成とAIモデル5種類を組み合わせて性能を検証したベンチマーク「FrontierHarness Eval v1.1」を合計2万7280回試行した結果を公開しました。
Introducing FrontierHarness Eval v1.1 — RUNTA
https://runta.com/blog/introducing-frontierharness-eval-v1-1/
AIエージェントにおけるハーネスはAIモデルに指示を与え、ファイルの読み書きやコマンドの実行、コンテキストの管理などを担います。Claude CodeやCodex CLI、OpenCodeなどが該当し、同じAIモデルを使用していてもハーネスの設計によってエージェントの挙動や性能は変化します。
RuntaはAIモデルの推論サービスを提供するBasetenと協力し、GLM-5.3、GLM-5.3 Flash、DeepSeek V4.1 Flash 1017、Muse Spark Open、Kimi-K3の5種類のAIモデルと、22種類のハーネス構成を組み合わせて検証を行いました。各組み合わせで62種類のターミナル操作を伴うタスクを4回ずつ実行しており、消費したトークンは合計830億に上ります。
各ハーネスは原則としてデフォルト設定を使用し、推論の強度は最大に設定されています。評価指標にはタスクの成功率と1タスク当たりの平均コストに加え、平均コストを成功率で割った「成功1件当たりのコスト」が用いられました。
以下は縦軸が各ハーネスの成功率、横軸が1タスク当たりの平均コストを表したグラフで、オレンジ色の線はより低コストでより高い成功率を実現する別のハーネスが存在しないハーネスを結んだもの。左上に位置するハーネスほど低コストかつ高い成功率を実現していることになります。全モデルの平均ではOpenCode v2が最も低コストで、ZCodeが最も高い成功率を記録しました。
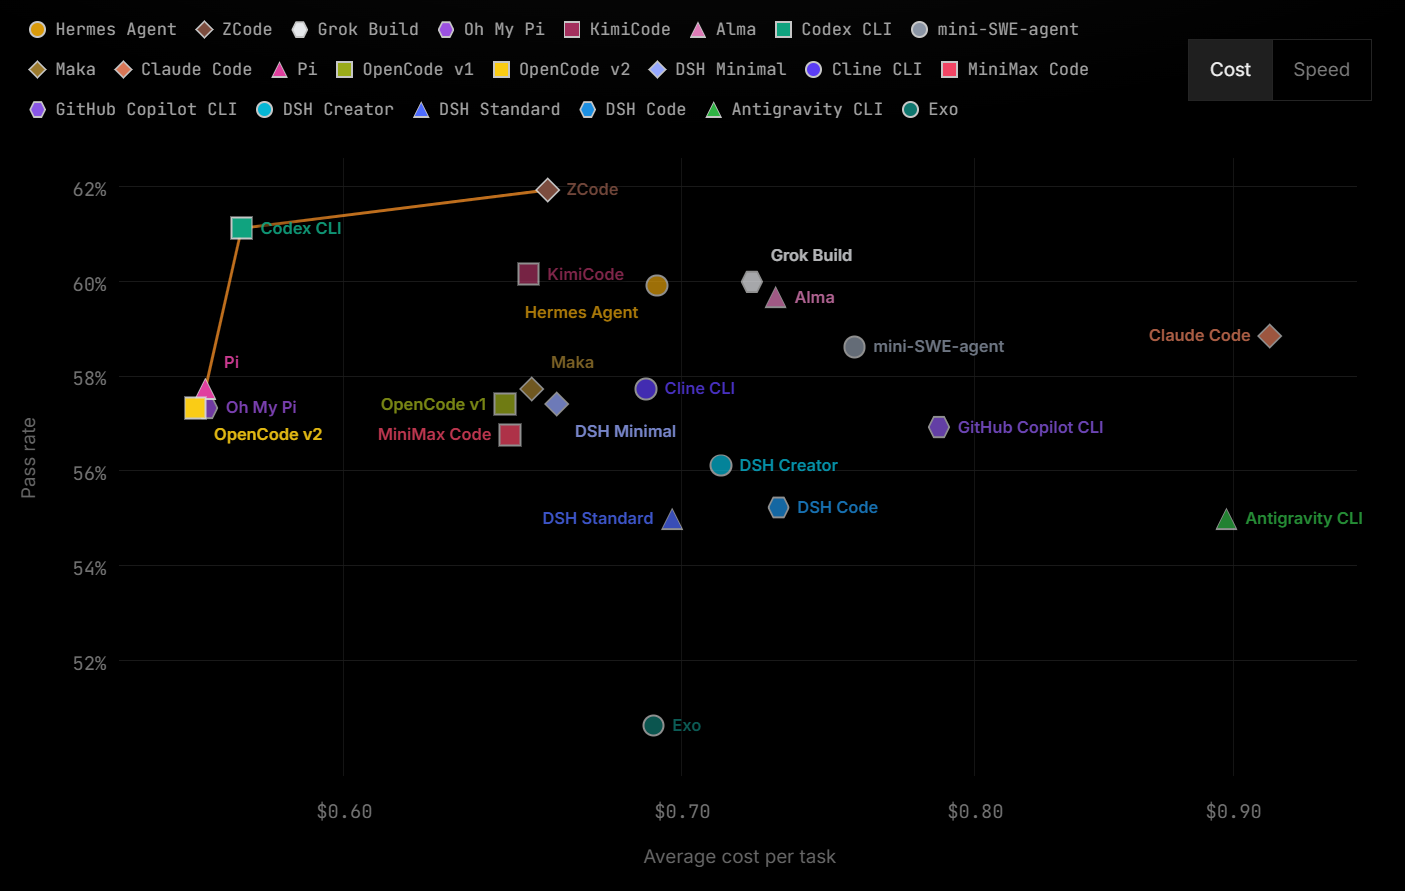
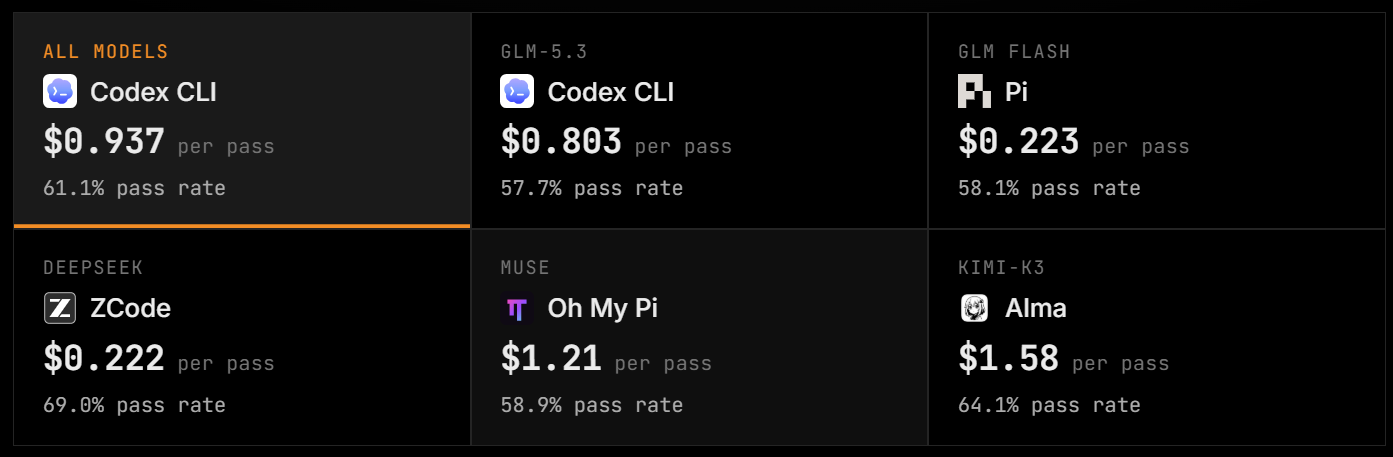
Runtaは原則として成功1件当たりのコストが最も低いハーネスを最も費用対効果が高いと評価しています。ただし、成功1件当たりのコストの増加が30%以内で、成功率が5ポイント以上高いハーネスが存在する場合は、そちらを選んでいます。
Runtaが成功率とコストのバランスから最も費用対効果が高いと評価したハーネスは、GLM-5.3ではCodex CLI、GLM-5.3 FlashではPi、DeepSeek V4.1 Flash 1017ではZCode、Muse Spark OpenではOh My Pi、Kimi-K3ではAlmaでした。5種類のAIモデル全てで異なるハーネスが選ばれたことになります。
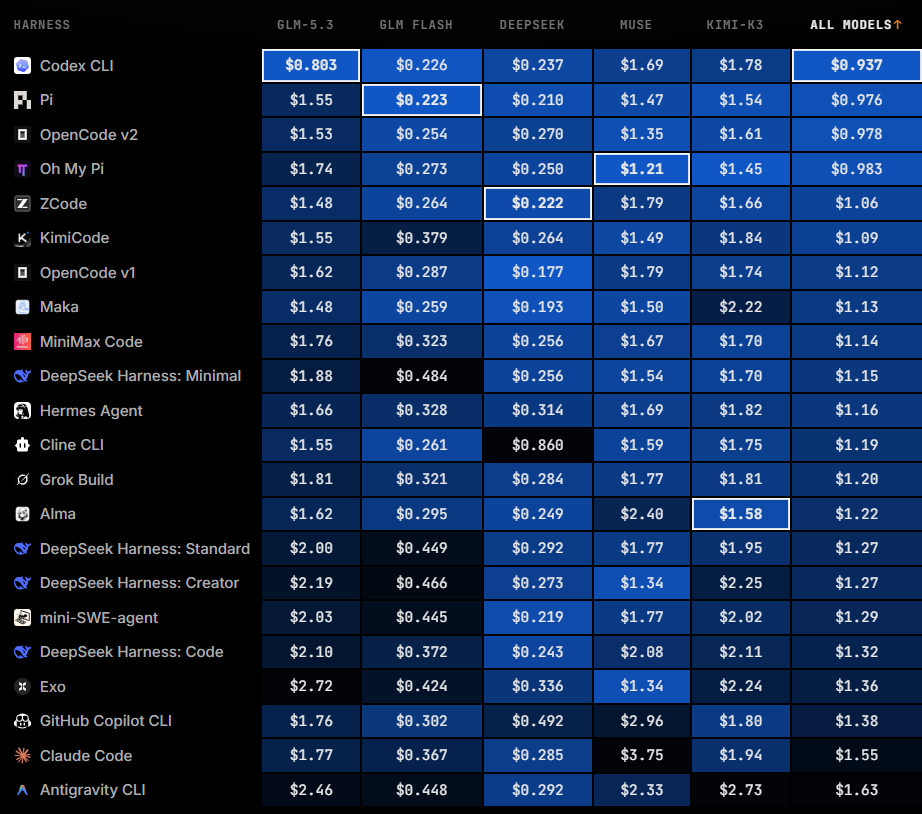
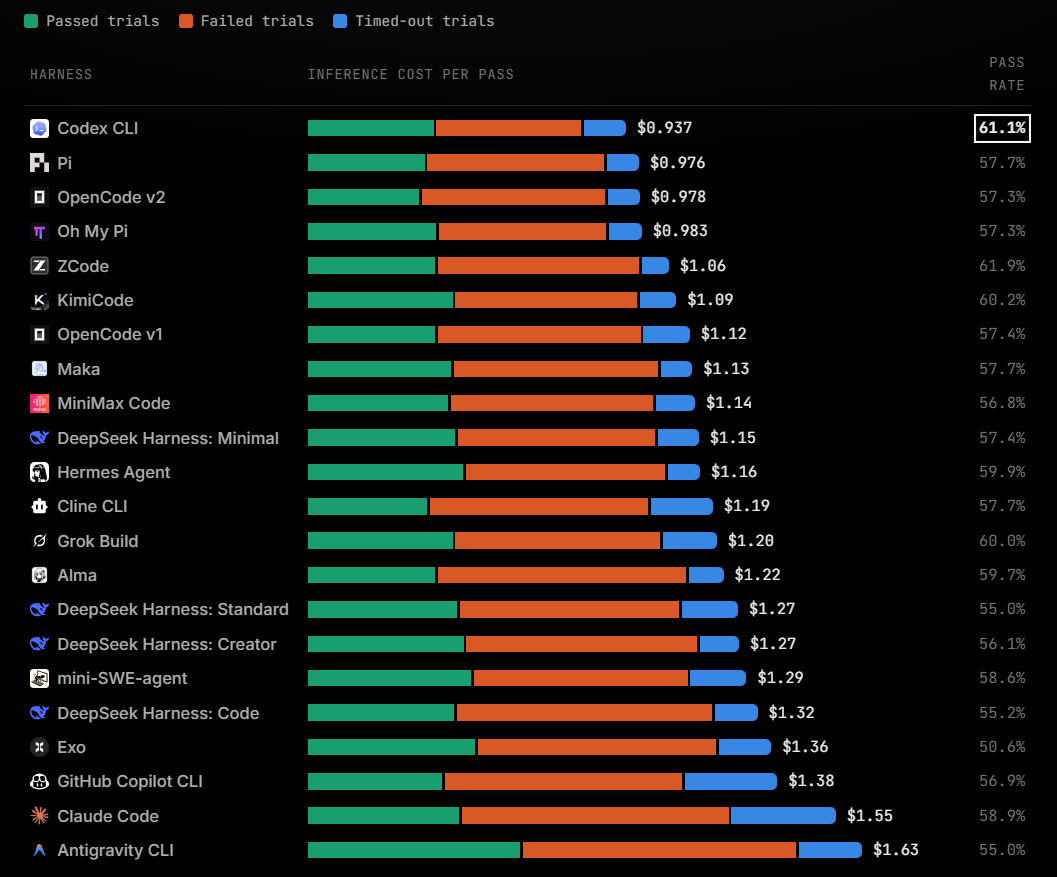
以下は22種類のハーネスと5種類のAIモデルの組み合わせについて、タスク成功1件当たりのコストをまとめた表です。白い枠線はRuntaが最も費用対効果が高いと評価した組み合わせを示しています。全モデルの平均ではCodex CLIが最も低コストで、Pi、OpenCode v2、Oh My Piが僅差で続いています。一方、Claude Codeは22構成中21位で、特にMuse Spark Openとの組み合わせでは他のハーネスと比べてコストが高くなっています。
また、各組み合わせのタスク成功率は以下の通り。全モデルの平均ではZCodeが61.9%で最も高く、Codex CLIが61.1%、KimiCodeが60.2%で続いています。
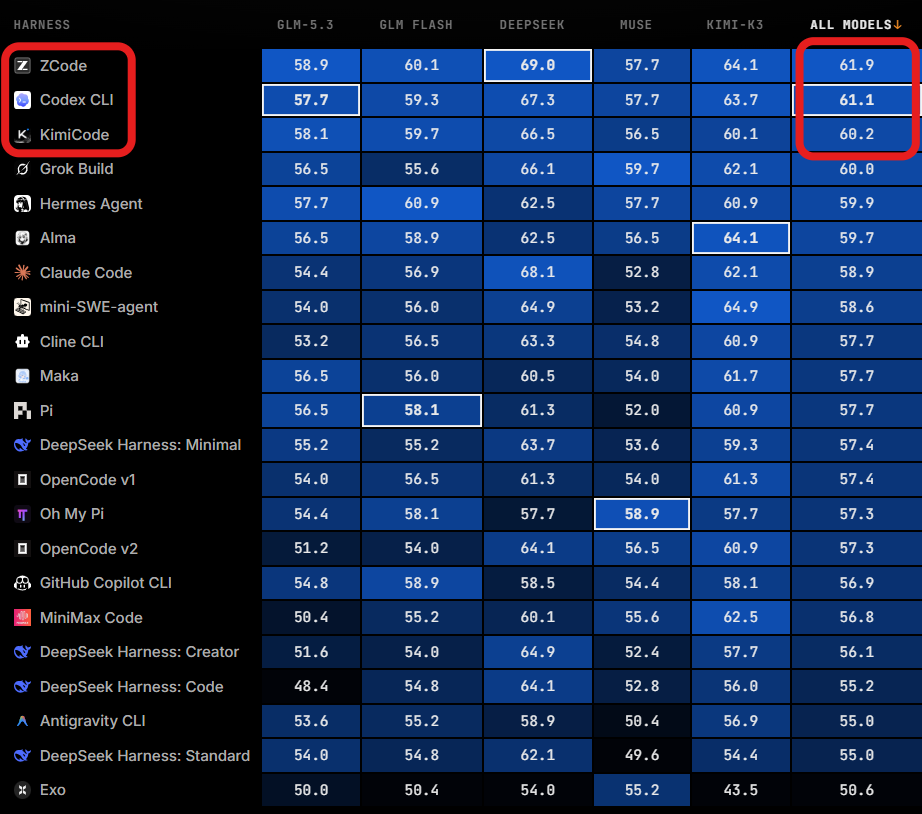
Runtaは検証対象の62種類のタスクを重複を許してランダムに抽出し、最も費用対効果の高いハーネスを選び直す検証を4000回行いました。GLM-5.3では4000回のうち99.6%でCodex CLIが選ばれましたが、他の4モデルでは最も費用対効果が高いとされたハーネスが選ばれた割合は25~53%にとどまっており、複数のハーネスが拮抗(きっこう)していました。
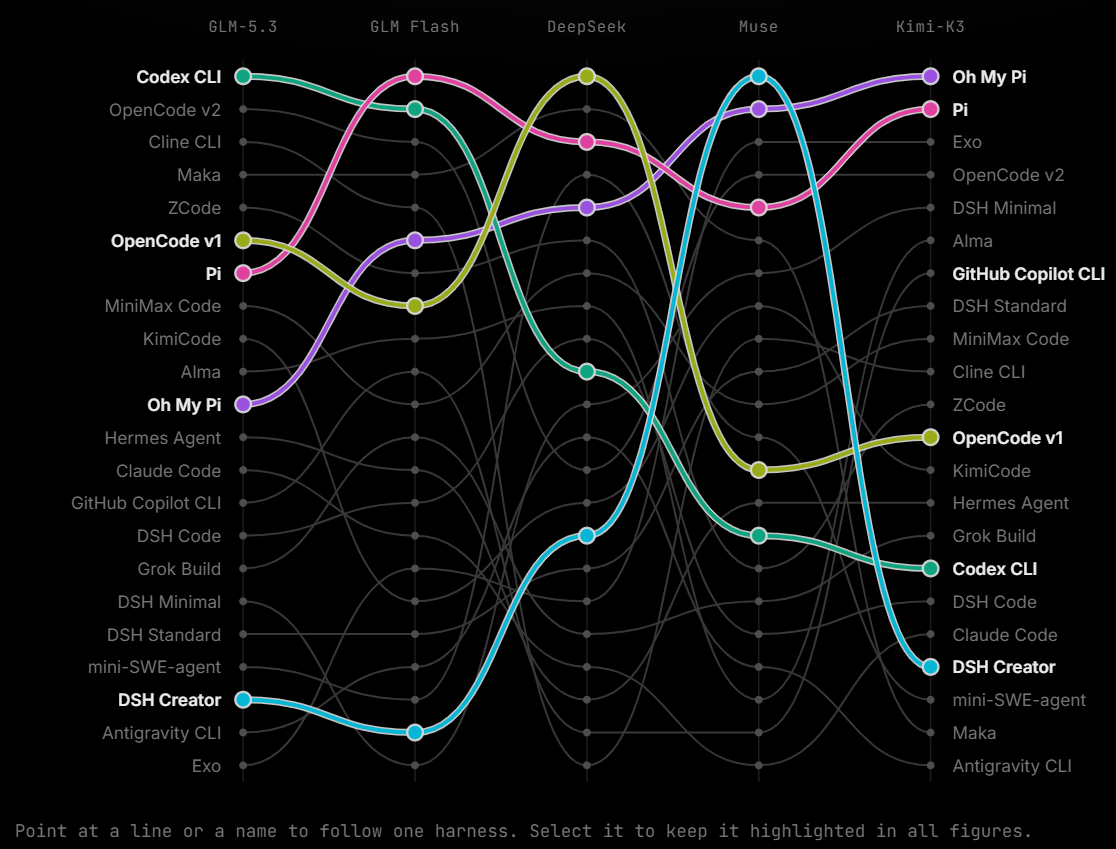
しかし、AIモデルを変更するとハーネスのコスト順位も大きく変動しました。例えば、Codex CLIはGLM-5.3との組み合わせでは22種類のハーネスの中で最も低コストでしたが、Kimi-K3との組み合わせでは16位に転落しました。そして、DeepSeek HarnessのCreator構成はMuse Spark Openでは1位だった一方、GLM-5.3 Flashでは21位となっています。
同じAIモデルを使用した場合でも、1タスク当たりのコストは最も高いハーネスと最も低いハーネスで1.8~5.0倍の差がありましたが、コストの高いハーネスが必ずしも高い成功率を示すわけではありません。DeepSeek V4.1 Flash 1017ではCline CLIの実行コストがOpenCode v1の5倍に達したにもかかわらず、成功率はわずか2ポイントしか上回っていませんでした。
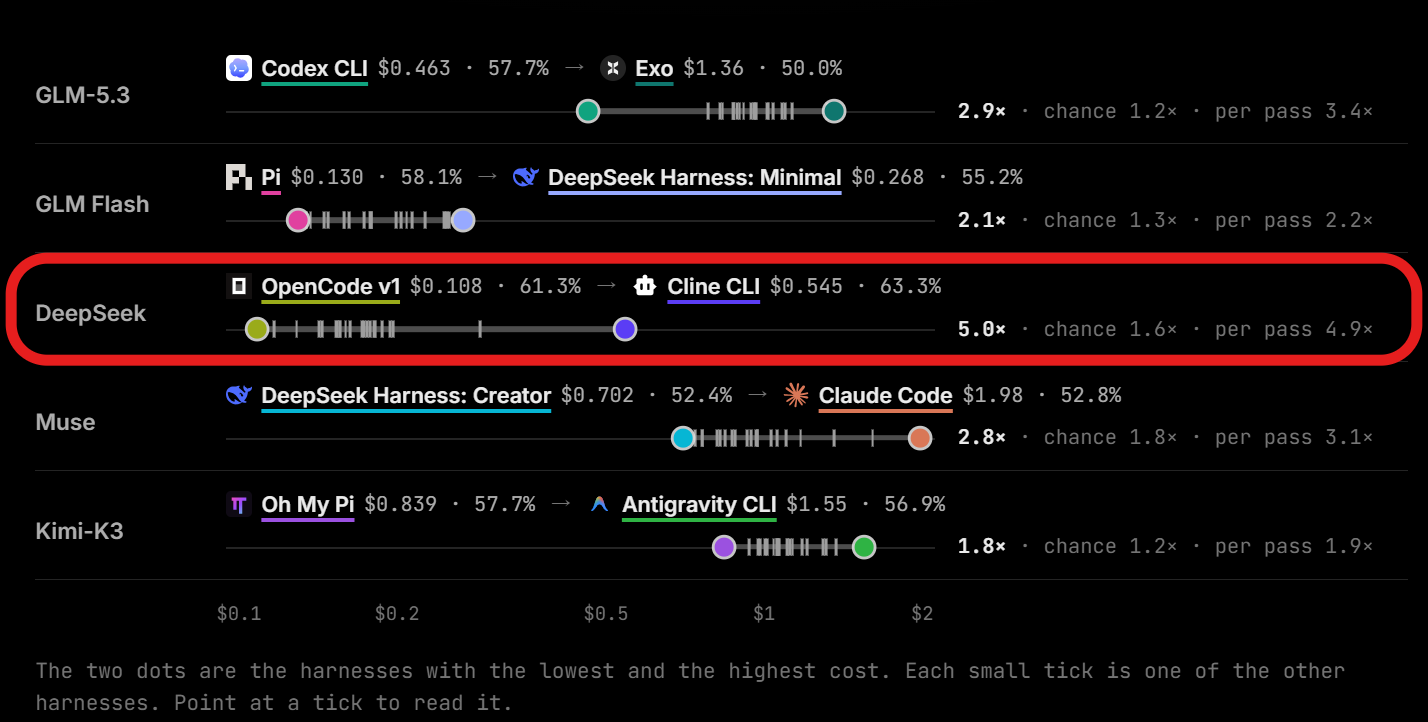
Runtaによると、各モデルにおける1タスク当たりのコストと成功率の順位相関係数はマイナス0.39からプラス0.22の範囲に収まっており、コストの高いハーネスほど成功率も高くなるという傾向は確認できなかったとのことです。
さらに、Runtaはハーネスの設計と実行コストの関係についても分析しています。その結果、初回リクエストのトークン数や利用可能なツールの数、キャッシュヒット率と成功1件当たりのコストにはほとんど相関が認められませんでした。一方で成功した試行の平均ステップ数と成功1件当たりのコストの間には、順位相関係数が0.51という正の相関が認められています。
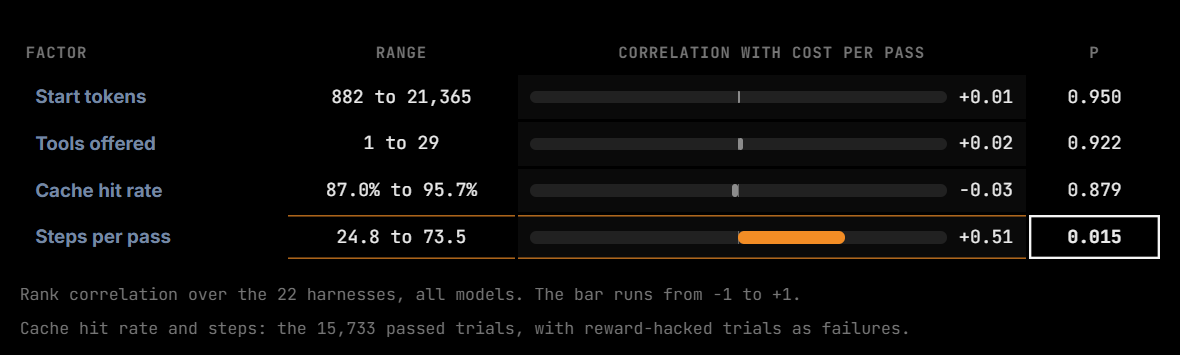
AIエージェントは処理を進めるたびに、それまでのやりとりやツールの実行結果を含むコンテキストをAIモデルに送信します。そのため、最初に送信するプロンプトを短くすることよりも、タスクを完了するまでの処理回数を減らすことの方がコスト削減につながるとRuntaは指摘しています。
費用対効果が高かった5種類のハーネスにはシェルを操作するツールがツール呼び出しの大半を占めていること、コンテキストの先頭部分を変更せずキャッシュを活用していること、サブエージェントやコンテキストの要約をほとんど使用していないことといった共通点があったそうです。
また、全試行にかかった推論コストの64.5%はタスクの成功に至らなかった試行に費やされていました。費用対効果が高い5種類のハーネスでも、失敗した試行の68~82%は制限時間に達したわけではなく、エージェントが自ら処理を終了して最終回答を出力していたとのこと。Runtaは処理を終了する前に成果を検証する仕組みを導入することで、コストを削減できる可能性があると指摘しています。
各ハーネスのタスク成功1件当たりの推論コストとその内訳。緑色は成功、オレンジ色は失敗、青色はタイムアウトした試行に費やされたコストを示しています。
RuntaはAIモデルを変更する際にはハーネスの変更も検討し、実際の業務に即したタスクで費用対効果を比較することを推奨しています。また、今後はClaude Opus 5.5やGPT-6 Astra、Gemini 4 Carbonといったクローズドモデルについても検証を行う予定です。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.