Как метрики помогают оптимизировать процессы тестирования?
Когда команда тестирования и продукт растут, растёт и сложность процессов: больше релизов, больше сценариев, больше специалистов, которых нужно синхронизировать. На этом этапе объективная картина происходящего — это то, на чём держится предсказуемость всего цикла разработки.
Внедрение и систематическое отслеживание метрик QA — это то, что позволяет команде сохранять эту объективную картину по мере роста. Метрики — не просто цифры на панели управления, а инструмент, который помогает вовремя видеть узкие места и обоснованно принимать решения по развитию процессов тестирования.
Меня зовут Аня, я руководитель команды QA (инженеров по тестированию) мобильной платформы в команде СберЗдоровья — медтех-компании №1 в России. В этой статье я расскажу, как мы пришли к необходимости внедрения дополнительных метрик, какие параметры решили отслеживать и какие результаты получили.
Начнем с начала: о метриках в командах
Представим небольшую команду инженеров по тестированию, которые работают над маленьким проектом. Изначально обычно всё просто: поскольку продукт небольшой, а людей мало — нет проблем с коммуникацией для сбора метрик и статусов по таскам, отслеживанием и решением актуальных задач, выбором инструментов и подходов. Здесь довольно просто всё держать под контролем.
Но с ростом команды и повышением сложности проекта подобный «ручной» контроль становится неэффективным, поскольку, как правило, поддерживать коммуникацию абсолютно со всеми становится затруднительно, договариваться сложнее, а самостоятельно мониторить действия каждого тестировщика — практически невозможно. В таких ситуациях лучшей практикой является отслеживание метрик, то есть показателей работы команды.
Метрикой для команд тестировщиков может быть всё, что угодно:
время — например, время работы над задачей или время прохождения автотестов;
количество чего-либо — например, число багов, задач, автотестов, тест-кейсов;
отношение одной величины к другой — например, скорость прохождения, процент успеха автотестов и другие.
Но как мы понимаем, выбрать метрики — недостаточно. Их надо контролировать и адаптировать под особенности продукта.
Какие потенциальные вызовы, связанные с расширением команды, мы видели
При росте команды и продукта мы столкнулись с тем, что порой тестировщики просто не успевали тестировать задачи. Это приводило к накоплению бэклога. При детальном анализе стало понятно, что причин возникновения подобной ситуации несколько:
Долгие регрессы мобильного приложения. Регресс шел весь релизный цикл (2 недели).
Возможное попадание багов в прод. QA не всегда успевали тестировать все задачи.
Недостаточно четкие стандарты в части тестовой документации. QA могли писать тест-кейсы по-своему, из-за чего у нас было большое количество тест-кейсов. Причем часть из них быстро устаревала и не поддерживалась.
Мы понимали, что для решения имеющихся трудностей нам нужно сформировать объективную картину происходящего. Поэтому в первую очередь было важно ответить на ряд вопросов:
Сколько времени занимает регрессионное тестирование?
Сколько ошибок может возникнуть в релизе?
Сколько тестовых сценариев соответствуют нашим стандартам?
Все ли задачи в релизе протестированы?
Сколько тестовых сценариев используется при тестировании?
Примечательно, что некоторые метрики мы уже отслеживали, но хотели контролировать больше показателей, чтобы ещё лучше понимать, что происходит с процессами внутри команды. Соответственно, чтобы найти ответы на все интересующие вопросы, нам предстояло обновить метрики.
К новым метрикам
При выборе метрик, которые на наш взгляд должны были помочь отслеживать и контролировать ещё больше показателей и процессов во время тестирования, мы опирались на вопросы, описанные выше.
Время тестирования регресса
У нас было понимание, сколько примерно времени уходит на прохождение регрессионных тестовых сценариев у каждой команды — для этого мы общались с тестировщиками.
Но чтобы иметь точные цифры, мы пошли дальше и адаптировали процессы под подсчет этой метрики. Так, при работе с задачей на регресс мы сделали обязательным поле, в котором нужно указать в часах время, потраченное на тестирование регрессионного набора сценариев.
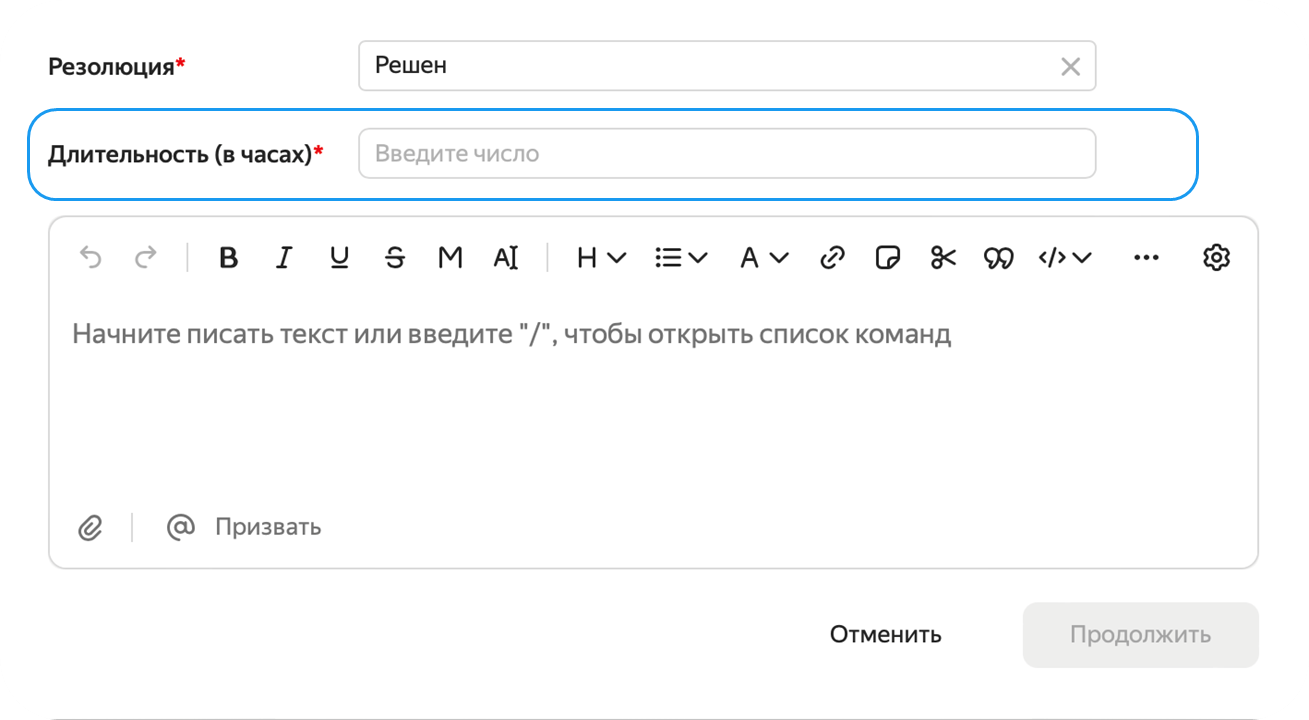
На основе указанных значений мы начали собирать статистику времени тестирования регресса по командам.
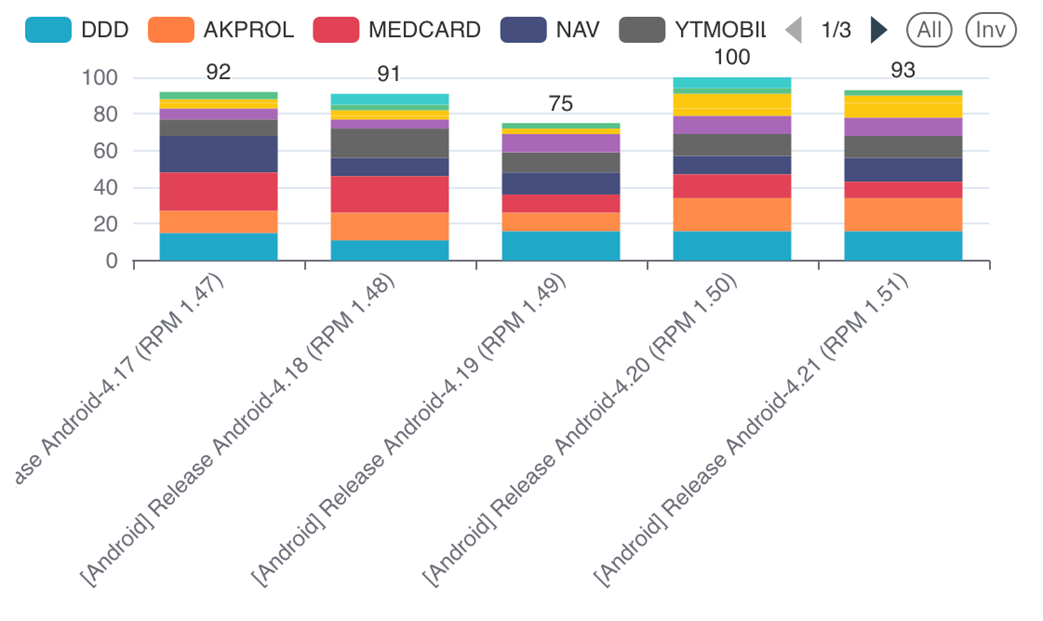
Это позволило нам определить команды, в которых на регресс уходит больше времени, и начать работу над оптимизацией процессов.
Нюанс в том, что по полученному графику нельзя сделать однозначных выводов о том, сколько сейчас уходит времени на регрессионное тестирование всего релиза. Поэтому мы изменили подход и приняли, что временем регресса всего релиза будем считать максимальное время тестирования регресса между командами.
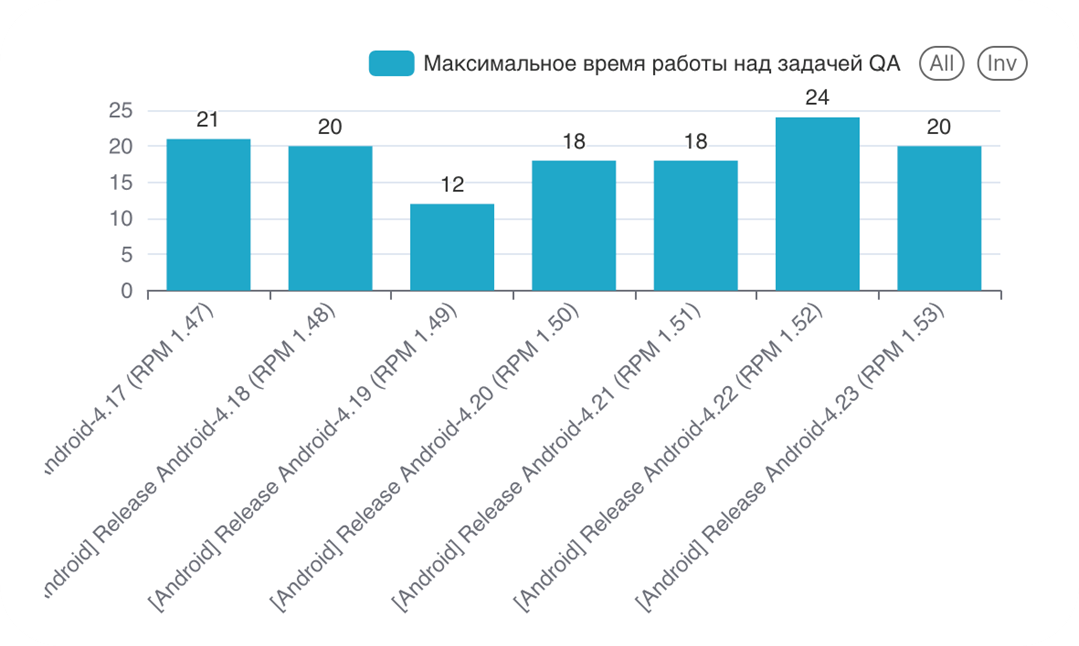
Так мы получили объективную статистику, которой можем полностью доверять.
Метрики качества релизов
Одного времени регресса релиза нам недостаточно — нужно также иметь четкое понимание о качестве релиза. Чтобы добиться этого, мы внедрили сразу три новые метрики.
Количество непротестированных задач в релизе
Логично, что чем больше непротестированных задач в релизе, тем потенциально больше багов, найденных врегрессе. Поэтому нам было важно понимать, сколько таких задач есть (если вообще есть) в нашем проекте.
Для сбора метрики мы также адаптировали процессы. Так, теперь, когда тестировщик переводит задачу из статуса «Тестируется» в статус «Готово к релизу», он должен заполнить обязательное поле с указанием, протестирована задача или нет.
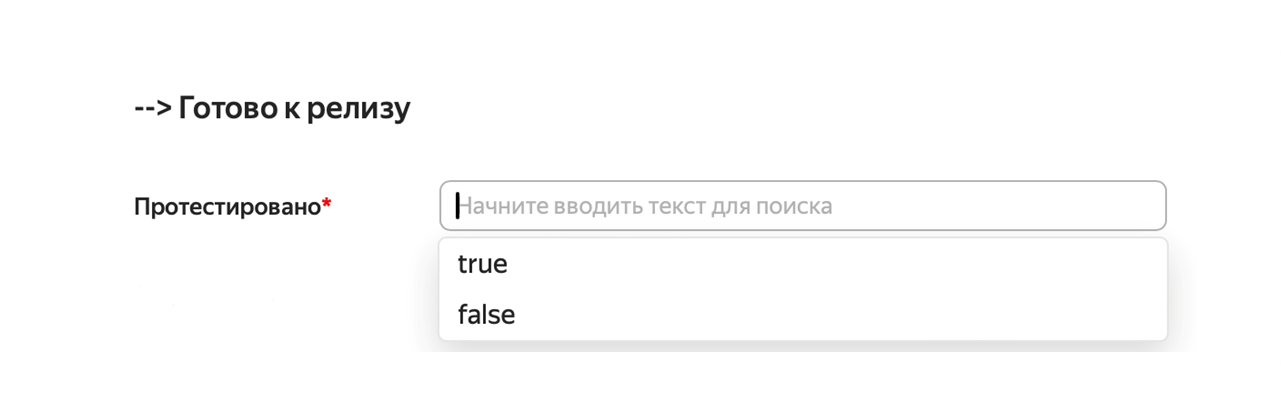
На основе этих ответов мы смогли собрать статистику, отражающую количество задач в выпущенном релизе с тестированием и без, а также понять, процессы каких команд следует дорабатывать.
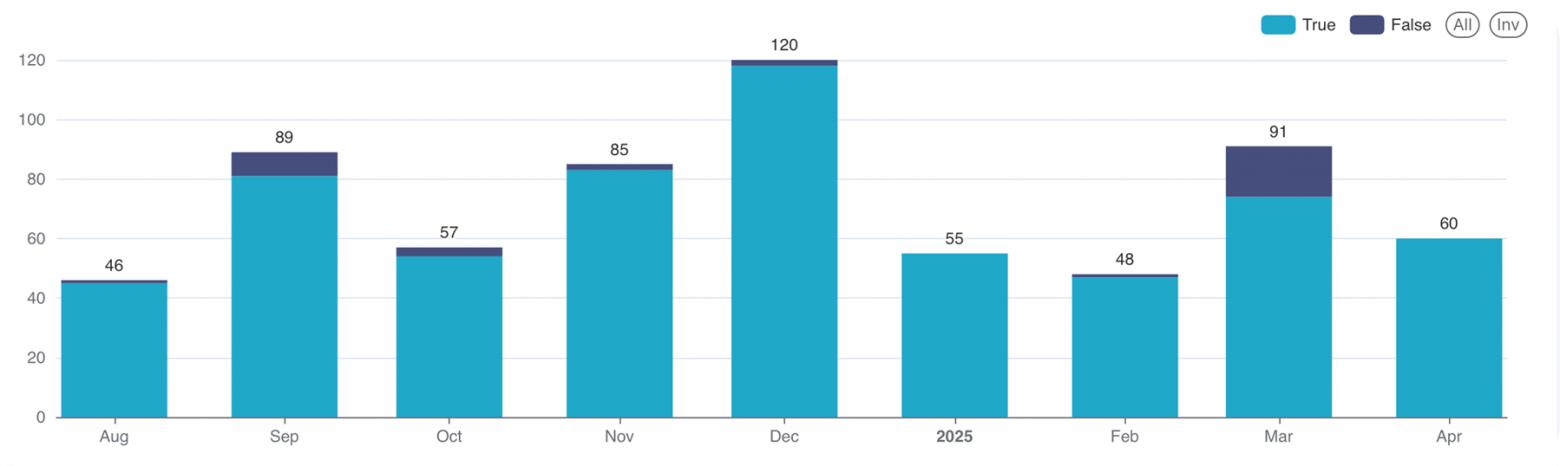
Количество багов, найденных в релизе
Следующая метрика, которая напрямую зависит от предыдущей, — количество ошибок, найденных в релизе. Здесь всё очевидно — чем больше непротестированных задач в релиз-кандидате, тем больше ошибок будет найдено в регрессе.
Чтобы получить сведения о количестве ошибок, мы воспользовались собственным артефактом — задачей на релиз, где связываются все задачи, — и согласовали в команде тестировщиков, что все найденные в рамках регресса ошибки будут связываться в ней по определенному типу связи.
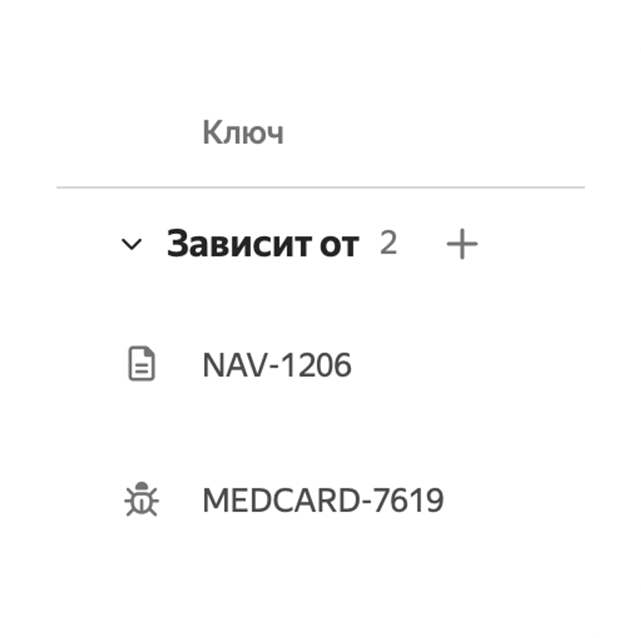
Таким образом мы смогли отслеживать все ошибки, найденные в рамках каждого релиза по платформам, а также сортировать их по командам.
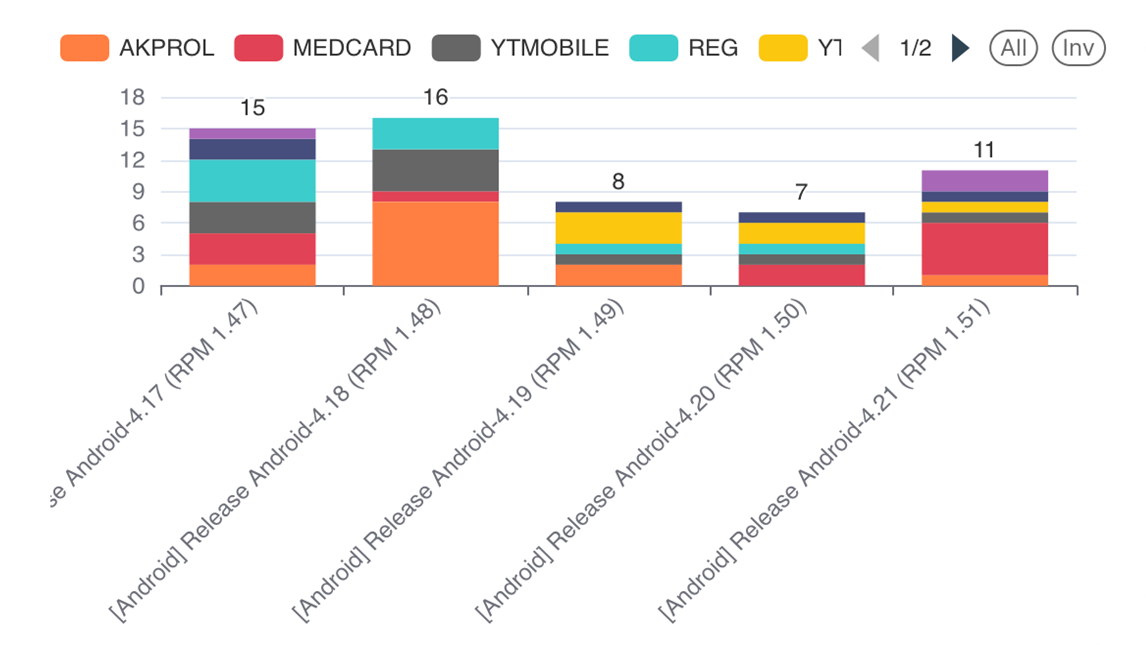
Благодаря этому мы также смогли понять, процессы каких команд еще можно оптимизировать.
Задачи, влитые в релиз после старта регресса
Качество релизов также напрямую зависит от того, сколько задач подливается в релиз-кандидат после старта регресса: чем больше — тем потенциально больше ошибок в релизе.
Собрать данные по этой метрике мы смогли по уже отработанной схеме — просто связывали такие задачи по определенному типу связи. В итоге получили наглядную статистику.
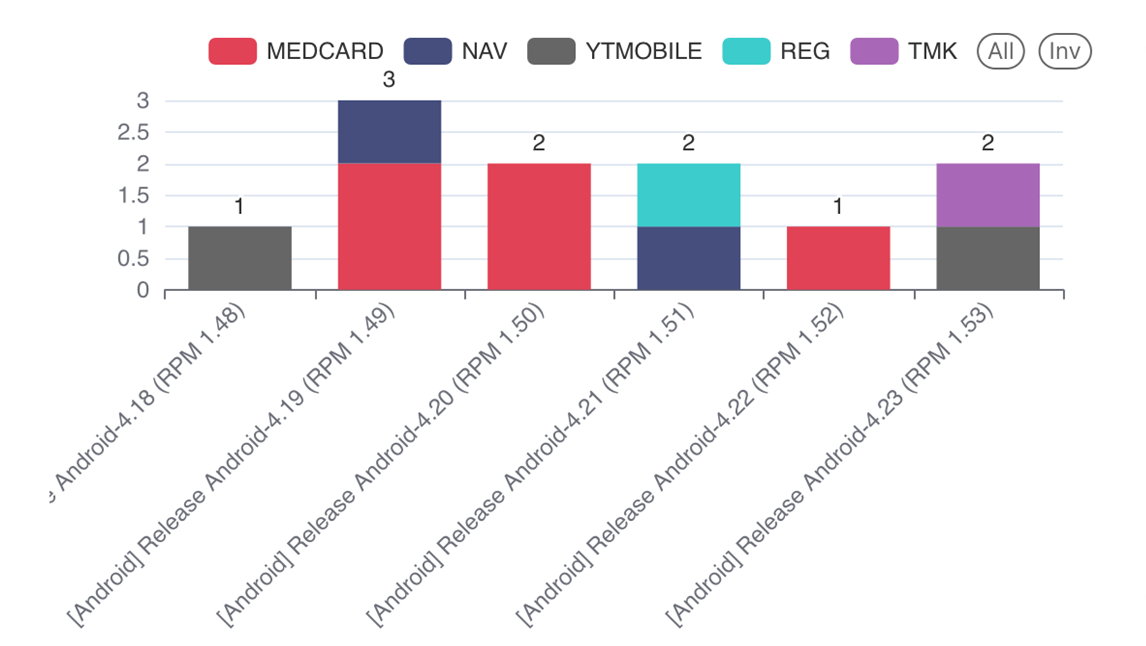
Исходя из этой статистики, мы смогли не только выявить команды, которые чаще других подливают задачи в релиз, но и ввести дополнительные ограничения на влитие задач, чем повысили стабильность наших релиз-кандидатов.
Метрика качества и количества тестовых сценариев
Помимо прочего, нам было важно понимать состояние наших тестовых сценариев, а именно, сколько из них используется при тестировании и сколько соответствует нашим стандартам.
Метрика используемости тестовых сценариев
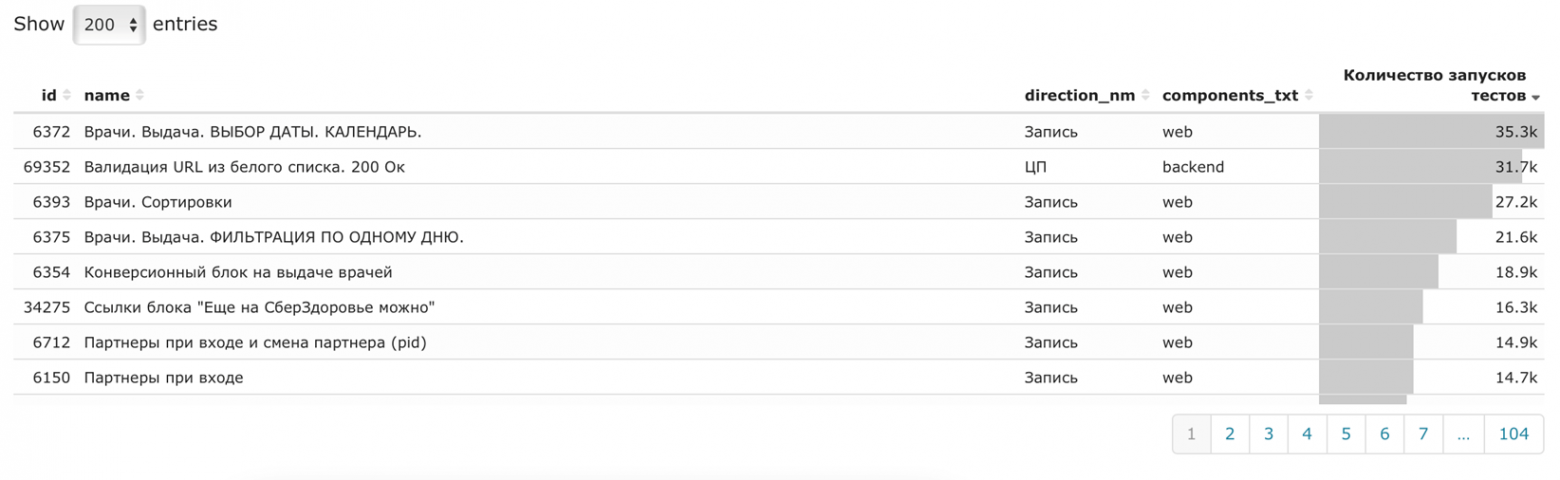
Для тестирования сервисов СберЗдоровья написано большое количество тестовых сценариев. Чтобы выявить те, которые реже всех используются, мы написали простой скрипт, который:
проходится по всем тестовым сценариям в Allure TestOps;
изучает их историю запуска за определенный период;
выгружает результаты запусков кейсов.
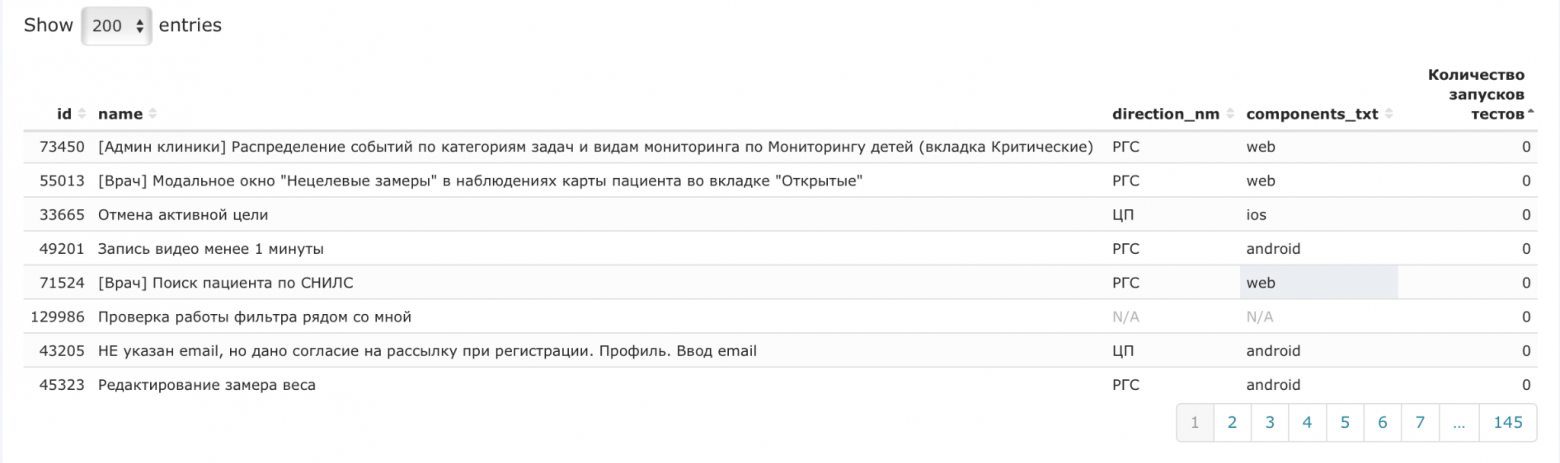
Такая детализация использования тестовых сценариев позволила нам определить, как самые используемые:
так и те, что уже давно не запускаются.
Количество качественных тестовых сценариев
У нас в команде есть четкий стандарт качества тестовых сценариев. Чтобы понять, сколько из наших тестов действительно соответствуют ему, мы также написали скрипт, который сравнивает сценарии в Allure TestOps с нашими требованиями по нескольким параметрам:
полям;
шагам;
ожидаемому результату;
настраиваемым полям.
Тесты, удовлетворяющие требованиям, отмечались пометкой «is beautiful», остальные — «is not beautiful».
Таким образом мы выявили набор тестовых сценариев, которые требуют доработки, и запланировали эту работу для всех ответственных команд.
Нюансы внедрения метрик
Итого мы внедрили шесть новых метрик:
время регресса и smoke-тестирования;
количество непротестированных задач в релизе;
количество ошибок, найденных в релизе;
количество задач, влитых в релиз после старта регрессионного тестирования;
метрика используемости тестовых сценариев;
количество качественных тестовых сценариев.
Чтобы сделать их внедрение максимально комфортным для всей команды, мы приняли три правила:
метрики всегда считаются автоматически;
метрики публичны — каждый может зайти и посмотреть их;
сбор метрик не мешает процессам.
Для отслеживания всех упомянутых метрик команды тестировщиков мы используем целых набор инструментов. Например:
Y.Tracker для подсчета ошибок и задач;
Allure TestOps для сбора метрик тестовых сценариев и автотестов;
SuperSet для сбора настраиваемых метрик, таких как количество качественных тестовых сценариев, и отрисовки графиков.
При этом метрики отслеживаются ежедневно всеми заинтересованными и раз в спринт — на командных встречах. Для дополнительного удобства мы подключили рассылку уведомлений о состоянии метрик в чат от бота. В первую очередь, такой поточный контроль нужен, чтобы не терять из фокуса поддержание стабильной работы процессов. И во вторую, что немало важно, — иметь возможность опираться на метрики при постановке целей для команды.
Итоги: что нам дало внедрение метрик
Внедрение практики отслеживания дополнительных метрик позволило нам ускорить регресс мобильных приложений и минимизировать количество неактуальных тестовых сценариев.
Так, чтобы оптимизировать время регресса мобильных приложений, мы:
выявили текущее время регресса и поставили цель по его сокращению;
смогли выявить команды, которые тормозили регресс;
стали следить за тестированием всех задач до регресса и стабильностью релиз-кандидата;
значительно сократили количество ошибок, найденных в регрессе;
сократили время регресса на 70%.
Хорошие результаты достигнуты и в контексте задачи минимизации неактуальных тестовых сценариев. Так, нам удалось:
выявить текущее количество неактуальных и неиспользуемых тестовых сценариев;
поставить цель по актуализации тестовых сценариев;
проработать процесс по контролю за написанием новых тестовых сценариев в соответствии с принятыми стандартами;
повысить число актуальных тестовых сценариев как минимум до 80%.
Наш опыт показывает, что отслеживание метрик в тестировании — это не просто сбор цифр, а мощный инструмент трансформации. Оно дает объективную картину качества, выявляет узкие места, оптимизирует ресурсы и повышает предсказуемость процессов. И именно метрики переводят работу тестировщиков из области субъективных оценок в плоскость измеримых результатов, укрепляя доверие к команде и ее вкладу в общий успех продукта.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.