Постоянный персонаж через Gemini API: референсы, нумерация картинок и метки IMAGE_REF
Я делаю короткие ролики и рекламу с постоянными героями: рыжая Агния, байкер Тихон. Главная техническая задача в такой работе - чтобы героиня из третьего кадра была той же, что в первом, а двое в одной сцене не обменивались лицами и одеждой. В статье покажу, как я передаю героев в gemini-3.1-flash-image и в видеомодель gemini-omni-1.1-flash через REST, как размечаю роли картинок и что показал небольшой замер: 18 генераций сцены с двумя героями при трёх вариантах промпта.
Почему лицо уплывает
У генератора картинок нет памяти между запросами. Каждый вызов собирает кадр заново из текста и приложенных изображений. Поэтому «постоянный персонаж» в API - это не настройка, а дисциплина на стороне клиента:
Паспорт - фиксированный текстовый блок с внешностью, который вставляется в каждый промпт байт в байт.
Эталон - портрет анфас на сером фоне, ровный свет, нейтральное лицо. Он идёт референсом в каждый запрос.
Виды - анфас в полный рост, три четверти, профиль, спина. Каждый генерируется отдельным запросом с эталоном на входе. Когда я попросил все четыре вида одной картинкой, модель развернула голову в профиль влево, а ступни вправо.
Проверка - каждый кадр сравнивается с эталоном глазами, в полном размере.
В паспорт идёт только то, что не меняется: возраст, волосы, глаза, приметы. Выражение лица, одежда и свет - это параметры сцены. Если вписать в паспорт улыбку, она появится в каждом кадре.
Шаг 1. Картинка с референсами через REST
generateContent принимает изображения как inlineData в том же массиве parts, что и текст. Порядок частей - это и есть порядок картинок, на который потом ссылается промпт.
import base64, json, mimetypes, urllib.request

KEY = open("/path/to/key").read().strip()
URL = "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-flash-image:generateContent"

def image_part(path):
    return {"inlineData": {"mimeType": mimetypes.guess_type(path)[0] or "image/png",
                           "data": base64.b64encode(open(path, "rb").read()).decode()}}

def generate(prompt, refs, out, aspect="4:5"):
    parts = [image_part(p) for p in refs] + [{"text": prompt}]  # картинки первыми, текст последним
    body = {"contents": [{"parts": parts}],
            "generationConfig": {"imageConfig": {"aspectRatio": aspect}}}
    req = urllib.request.Request(URL, data=json.dumps(body).encode(),
                                 headers={"x-goog-api-key": KEY, "Content-Type": "application/json"})
    reply = json.load(urllib.request.urlopen(req, timeout=180))
    for part in reply["candidates"][0]["content"]["parts"]:
        if "inlineData" in part:
            open(out, "wb").write(base64.b64decode(part["inlineData"]["data"]))
            return out
    raise RuntimeError("в ответе нет картинки: " + json.dumps(reply)[:300])
Соотношение сторон лучше задавать в imageConfig.aspectRatio, а не только строкой в промпте: строка остаётся подсказкой, параметр выполняется.
Для сцены с одним героем я передаю два файла: эталон и вид, ближайший к будущему кадру. В тексте прямо называю роли: «reference 1 - ориентир для лица, reference 2 - только для разворота тела, одежду и фон из него не копируй». Это просьба, а не замок: если одежда со второго файла всё равно перетекла, нужен новый дубль.
Шаг 2. Двое в кадре: замер
В посте про Тихона у меня был один неудачный дубль: два референса и промпт «эти двое встречаются в кафе». Агния села спиной, волосы потемнели. Один дубль ничего не доказывает, поэтому я повторил опыт серией.
Условия. Модель gemini-3.1-flash-image, 1K, 4:5. Две пары героев: женщина и мужчина (Агния и Тихон), две женщины (Агния и брюнетка с каре, у них заметно разная внешность). Три варианта промпта, по три дубля на пару:
Голый: «эти двое встречаются в кафе» плюс время суток и стиль. Ни ролей, ни примет.
Сцена с ролями: кто сидит, кто стоит или кто слева, кто справа, без нумерации картинок.
Нумерация: «Image 1 - это женщина: …», «Image 2 - это мужчина: …», приметы словами у каждого, прямой запрет смешивать лица и «оба лица хорошо видны».
Что считал: поменялись ли лица местами, ушёл ли кто-то спиной, перетекли ли одежда и аксессуары от одного героя к другому, появился ли непрошеный текст.
Результат, 18 генераций:
Лица местами не поменялись ни разу. Спиной никто не сел.
Голый промпт, женщина и мужчина: в одном дубле из трёх на Агнии тёмная куртка поверх свитера и золотой браслет, которых нет на эталоне, и выглядит она старше. Куртка не кожаная, браслет не стальные часы Тихона: это скорее дрейф от эталона, чем прямой перенос с соседа, но в сцене с ним читается именно так. Ещё в одном дубле на доске в кафе надпись «EVENING SPECIALS»: запрета на текст в голом промпте не было.
Голый промпт, две женщины: лица и одежда 3 из 3, но в одном дубле на фоне меловые доски с меню.
Сцена с ролями: лица и одежда 6 из 6. В двух дублях с Агнией и Тихоном на фоне надписи (неоновая вывеска, доска меню), хотя в промпте было
no text.Нумерация: 6 из 6 без ошибок, надписей нет.
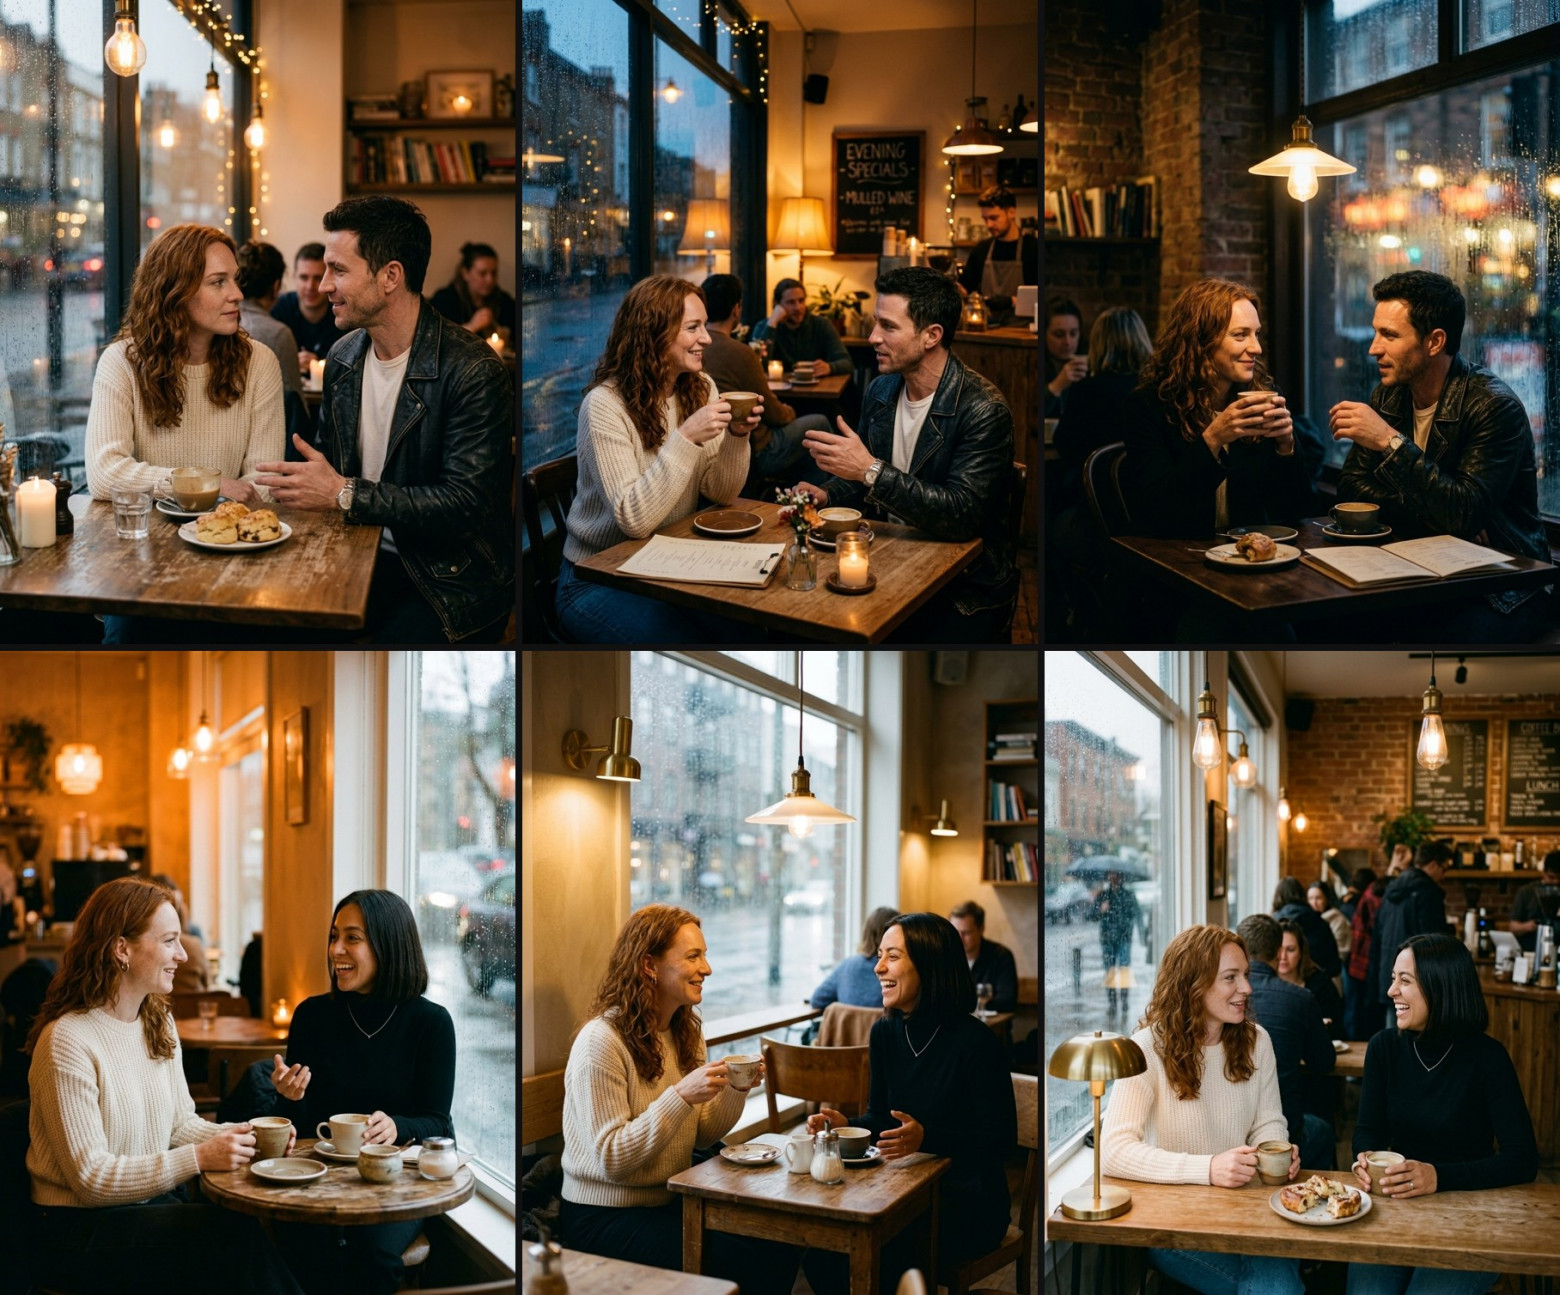
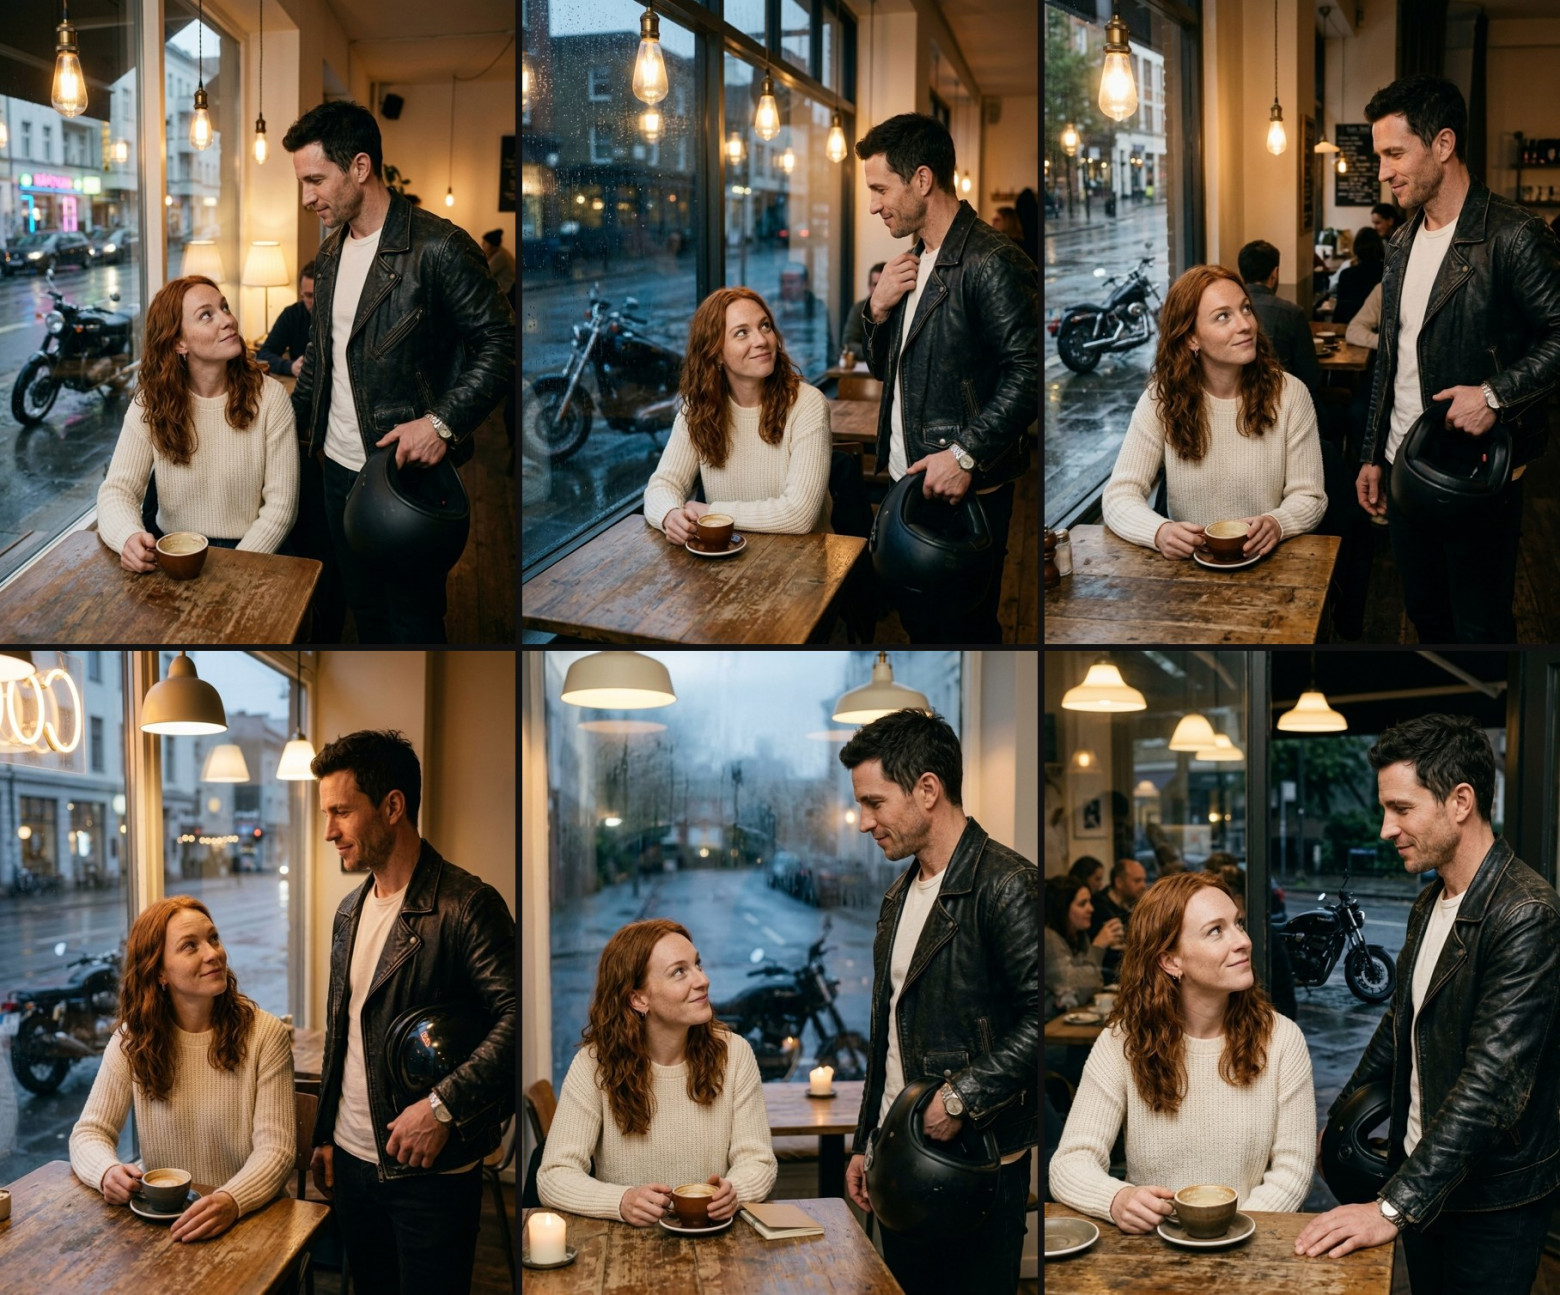
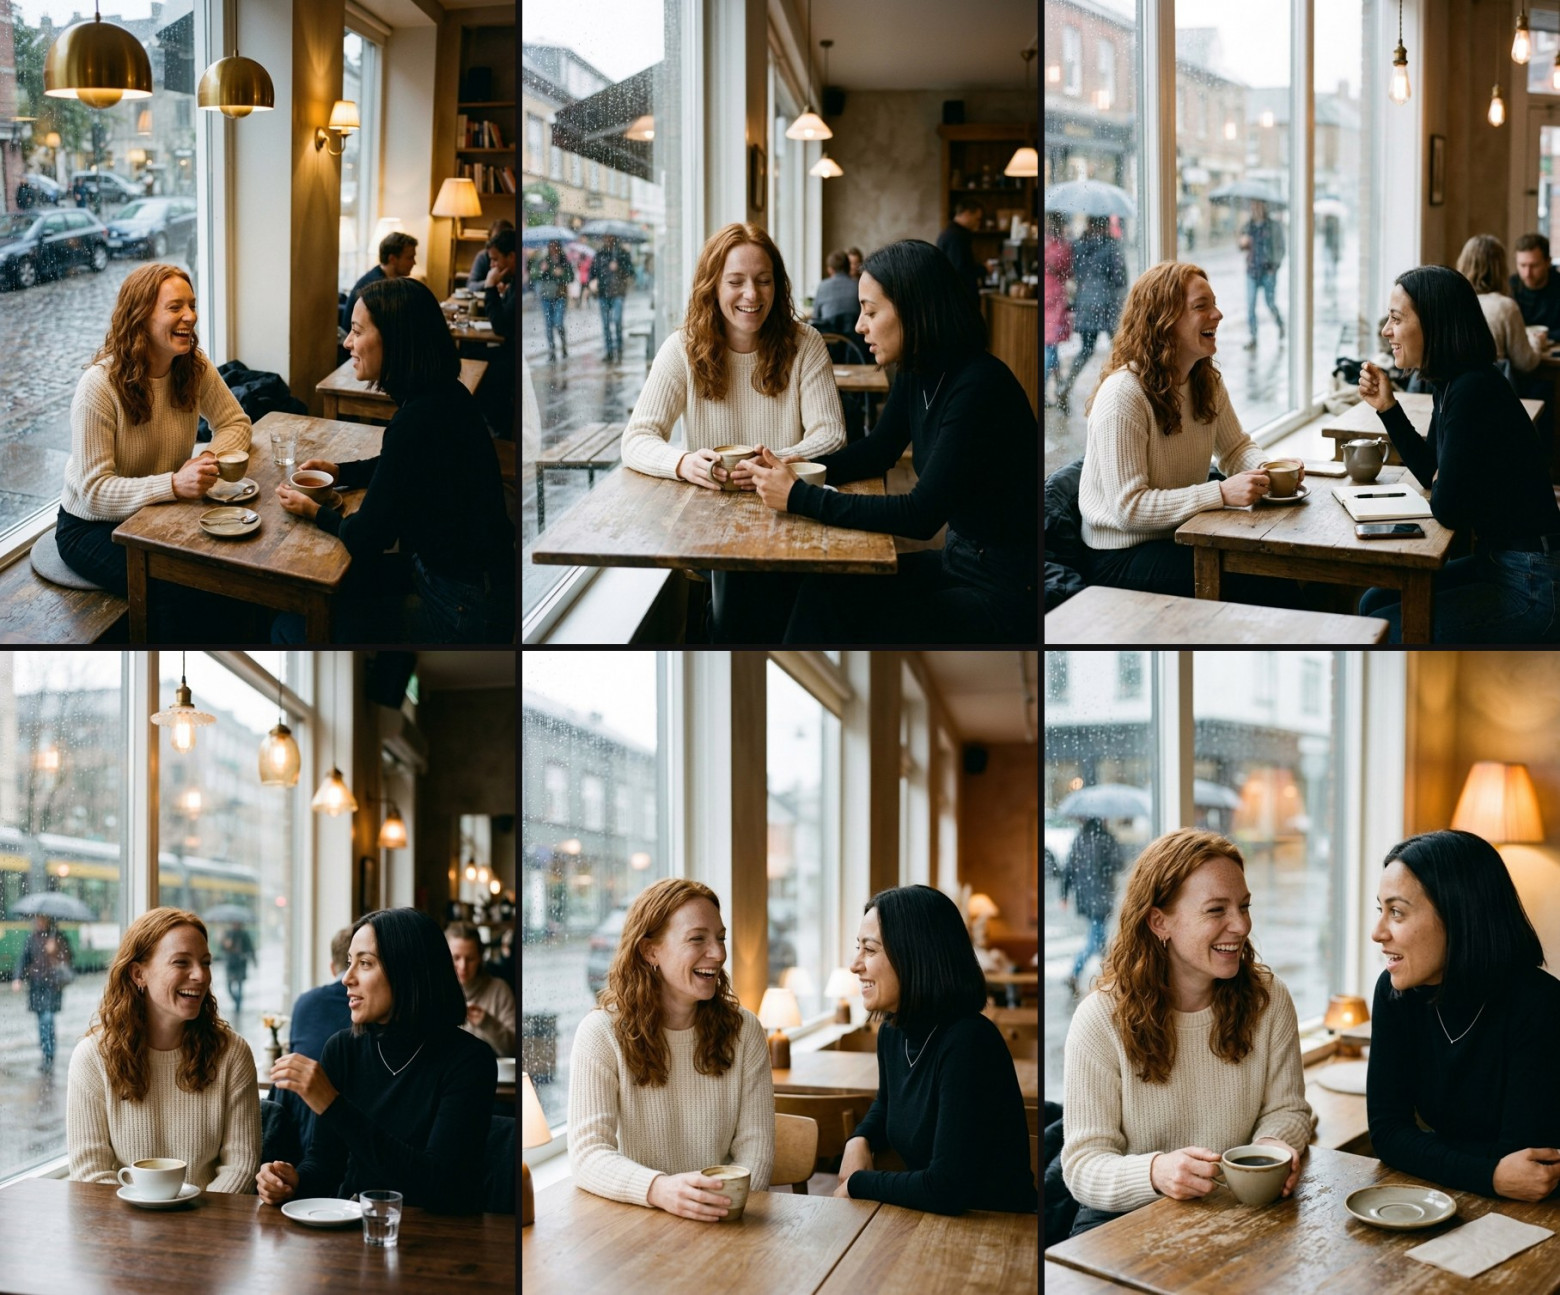
Три дубля на вариант - маленькая выборка, по ней нельзя сказать «нумерация снижает ошибки на N процентов». Но кое-что видно и так. В моём тесте модель не путала лица, когда герои заметно различаются внешне. Главный риск голого промпта не обмен лицами, а то, что одежда и аксессуары уходят от эталона. Сцена с ролями держит лица и одежду, потому что «первая сидит слева» - это неявная привязка к порядку картинок. Нумерация с приметами по лицам прироста не дала, но обходится в пару строк и делает промпт однозначным. Я оставляю её как дефолт, особенно для похожих героев: двух брюнетов в костюмах я не проверял. И отдельная находка: no text не гарантирует чистый фон. Вывеску или доску за спиной героя легко пропустить, а в рекламе она вылезет первой.
Сравнение не идеально ровное: голые промпты для двух пар отличаются временем суток, а в варианте с ролями, в отличие от голого, есть no text. Расстановку из промпта модель в этой серии выполнила во всех 12 дублях, а «средний план по пояс» в части дублей вышел чуть шире, до бёдер.
Промпт с нумерацией, который шёл во все шесть дублей с Агнией и Тихоном (сцена после запрета - это общая часть всех вариантов):
Generate an image. Image 1 is the woman: 26 years old, copper wavy shoulder-length hair,
light freckles, green eyes, small gold hoop earrings, cream knit sweater.
Image 2 is the man: 31 years old, short dark tousled hair, grey-blue eyes, light stubble,
a thin old scar on the outer end of his left eyebrow, worn black leather biker jacket
over a white t-shirt, steel watch on his left wrist.
Keep each face exactly from its own reference image, do not blend or swap their features.
Scene: evening in a small cafe by a big window, warm lamps inside, wet street and a parked
black motorcycle outside. The woman from image 1 sits at a wooden table with a cup of coffee
and looks up with a sly half-smile. The man from image 2 has just come in and stands by her
table holding a black motorcycle helmet under his arm, calm half-smile. 35mm, documentary
photo, natural skin texture, soft warm light, no text. Vertical 4:5.
Medium shot of both from the waist up, both faces clearly visible, eye level.
Промпты на английском: в документации Omni примеры только на английском, и картинки я делаю на нём же, чтобы сцена и видео собирались из одних формулировок.
Шаг 3. Видео: метки IMAGE_REF в Interactions API
Видеомодель gemini-omni-1.1-flash вызывается через Interactions API, и роли картинок там задаются метками прямо в тексте. Изображения передаются по порядку в массиве input, а в начале промпта объявляется, какая картинка чем служит: первый кадр, последний кадр или референс.
def image_input(path):
    return {"type": "image", "mime_type": mimetypes.guess_type(path)[0] or "image/png",
            "data": base64.b64encode(open(path, "rb").read()).decode()}

def video_body(prompt, first_frame, refs, seconds=6, aspect="9:16"):
    images = [image_input(first_frame)] + [image_input(p) for p in refs]
    head = "[# Sources <FIRST_FRAME>@Image1] "
    if refs:
        head += "[# References " + " ".join(f"<IMAGE_REF_{i}>@Image{i + 2}" for i in range(len(refs))) + "] "
    text = (head + prompt + f" A {seconds}-second video. A single continuous shot, no scene cuts."
            " Use the reference images for video generation, not as literal frames.")
    return {"model": "gemini-omni-1.1-flash",
            "input": images + [{"type": "text", "text": text}],
            "response_format": {"type": "video", "aspect_ratio": aspect,
                                "resolution": "720p", "delivery": "uri"},
            "background": False, "stream": False}
Тело уходит POST на /v1beta/interactions. Большое видео приходит ссылкой на файл: опрашиваешь GET /v1beta/files/{id}, пока state не станет ACTIVE, и скачиваешь через :download?alt=media.
Дальше в тексте промпта на метки можно ссылаться как на имена:
The woman is <IMAGE_REF_0>, the man is <IMAGE_REF_1>; keep each face exactly as in its
own reference, never swap or blend them. Evening in the cafe from the first frame.
The man calmly sets his black motorcycle helmet on the table and sits down opposite her...
Три практических детали.
Первый кадр - это уже готовая сцена. Сначала генерирую картинку с двумя героями (шаг 2), проверяю лица, и только потом отдаю её в видео как FIRST_FRAME. Эталоны героев идут отдельными IMAGE_REF. В моём клипе на 6 секунд лица продержались до конца, но это один дубль: клип нужно досматривать целиком, особенно повороты головы и моменты, когда лицо закрывает рука.
Расстановку модель решает сама. В промпте было «садится напротив неё», а Тихон сел рядом. В первом кадре он стоял сбоку, и модель выбрала ближайшее место. Если важно, кто где сидит, делай первый кадр, где они уже так сидят, а в видео оставляй только действие.
Длительности как параметра нет. Omni берёт длину из текста промпта, а платишь за фактическую. Поэтому длина файла в логе должна браться из файла, а не из запроса.
Обновление: Omni 1.2. 5 ноября вышла gemini-omni-1.2-flash, а с 3 декабря Google сам перенаправит на неё запросы к 1.1, так что код выше без правок начнёт работать на 1.2. Что это меняет:
Длительность стала параметром:
"duration": "6s"вresponse_format, от 3 до 15 секунд, а с первым и последним кадром до 10. Если параметр задан, длину в тексте промпта модель, по документации, не учитывает. Вvideo_bodyэто значит:secondsлучше передавать как"duration": f"{seconds}s", а фраза про длину в тексте становится лишней.Секунда 720p подешевела примерно с $0,10 до $0,07.
С метками
<FIRST_FRAME>и<LAST_FRAME>в моём тесте 1.2 не начала ролик с заданного кадра и не пришла к последнему, а сняла похожую, но свою сцену. Без меток вышло так же. Кадры встали на место, только когда я написал в начале промпта прямую фразу (ниже). Это по одному дублю на вариант (360p, 4 секунды) и только на переходе между двумя кадрами. Как на 1.2 ведёт себя вариант из кода выше, где задан одинFIRST_FRAME, и сцена с двумя героями иIMAGE_REF, я пока не проверял.
На русском:
Видео начинается точно на первой картинке и заканчивается точно на второй.
In English:
The video starts exactly on the first image and ends exactly on the second image.
Шаг 4. Проверка серии одним листом
Сравнивать 18 картинок по одной утомительно и ненадёжно. Я склеиваю дубли одного варианта в лист и смотрю его целиком, а подозрительные кадры открываю вырезкой с увеличением: руки, аксессуары, лицо.
from PIL import Image

def contact_sheet(paths, out, cols=3, w=600, h=750, gap=8):
    rows = (len(paths) + cols - 1) // cols
    sheet = Image.new("RGB", (cols * w + (cols - 1) * gap, rows * h + (rows - 1) * gap), (17, 17, 17))
    for i, p in enumerate(paths):
        tile = Image.open(p).convert("RGB").resize((w, h))
        sheet.paste(tile, ((i % cols) * (w + gap), (i // cols) * (h + gap)))
    sheet.save(out, quality=88)
Куртку и браслет из замера я заметил только на листе, рядом с чистыми дублями: в одиночном кадре тёмная куртка поверх свитера выглядит естественно, и глаз её пропускает. Надписи на фоне тоже нашлись при разборе листов, а не с первого взгляда.
Сколько стоит
gemini-3.1-flash-image, картинка 1K - $0,067 по тарифу Gemini API без налогов на октябрь 2026. Замер из 18 картинок обошёлся примерно в $1,21, референсы на входе добавляют немного сверху. Полная сборка одной героини (эталон, четыре вида, пять сцен и один бракованный лист) - 11 картинок, около $0,74. Клип 6 секунд в gemini-omni-1.1-flash 720p с тремя картинками на входе обошёлся в $0,63.
Итог
Паспорт героя - константа в коде, а не текст, который каждый раз пишется заново.
Эталон и виды генерируются по одному, каждый вид с эталоном на входе.
В сцене с двумя героями картинки нумеруются, приметы перечисляются у каждого, смешивание запрещается явно. В моём замере лица и так не путались, но на голом промпте одежда и аксессуары ушли от эталона.
Для видео сначала собирается и проверяется первый кадр, потом он идёт в
FIRST_FRAME, а эталоны - вIMAGE_REF_n(для 1.1; на 1.2 см. примечание в шаге 3).Серию проверяешь листом и вырезками, а не по одной картинке.
Разборы с постоянными героями, промптами и счётом за каждый кадр выкладываю в Telegram-канале @tairantino.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.