Деплой прошёл успешно. Почему сервис упал? Change Intelligence в IncidentRelay
«А что у нас менялось?» - с этого вопроса, к сожалению, начинается решаться очень много инцидентов.
Ответ обычно собирается по частям: релиз приложения лежит в CI/CD, изменение конфигурации - в Ansible, инфраструктурный apply - в Terraform, а переключение feature flag помнит человек, который уже ушёл на встречу. И где найти того Васю, который решил катнуть в пятницу вечером?!
Поэтому мы добавили в IncidentRelay Change Intelligence: историю изменений, связанную с сервисами, техническими алертами и расследованием инцидента. Она помогает собрать кандидатов для проверки, объясняет, откуда взялась связь, и сохраняет решение инженера.
Ниже покажу, как это устроено, на реальном интерфейсе с демонстрационными данными. Разбираем новую реализацию ветки 2.5.
Если вы впервые встречаете IncidentRelay: это наш open-source инструмент для дежурств, маршрутизации алертов, эскалаций и координации реагирования. Change Intelligence добавляет к сигналам мониторинга ещё один источник контекста — события о том, что команда поменяла в системе.
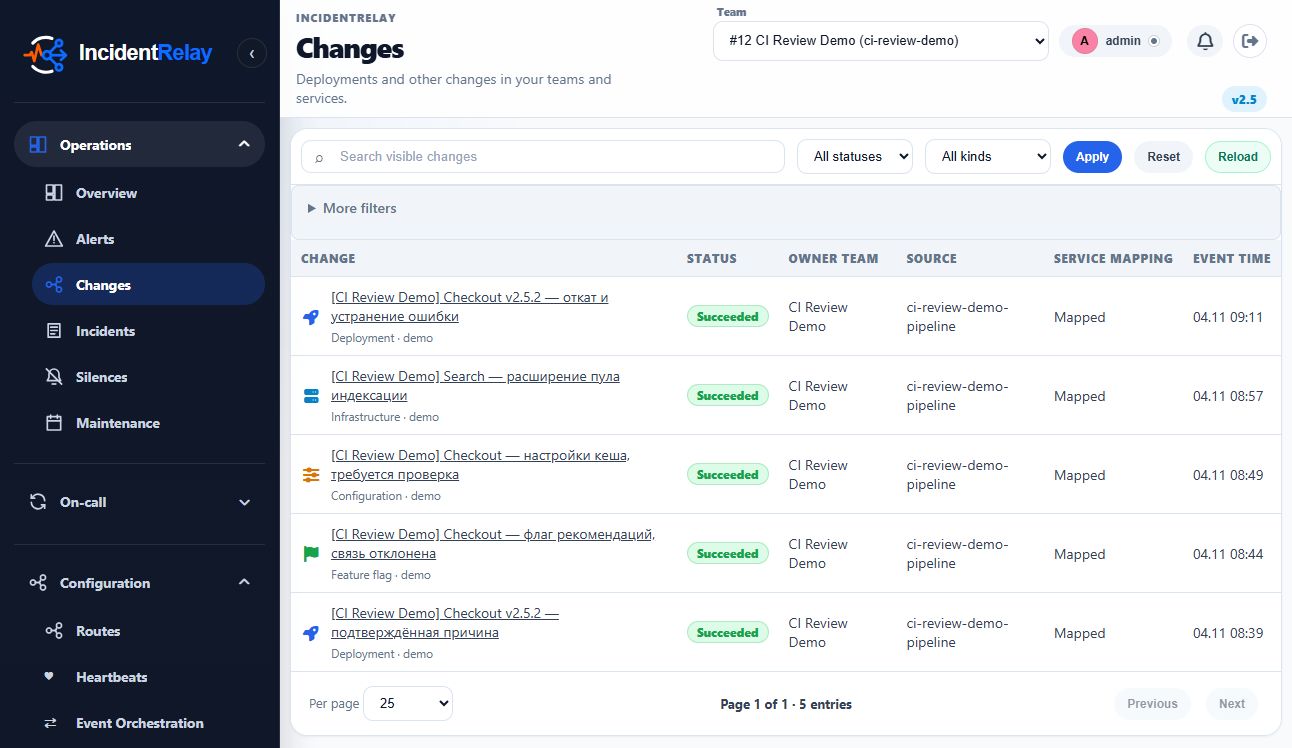
Operations → Changes. На скриншоте демонстрационные изменения одной команды: у каждой операции есть тип, результат выполнения, источник и состояние сопоставления с сервисами.
Зелёный pipeline и здоровый сервис - разные факты
Начнём с детали, из-за которой журнал деплоев легко превращается в бесполезный список зелёных галочек.
Статус succeeded сообщает, что операция завершилась успешно. Например, новая версия приложения развернулась, контейнеры запустились, предусмотренные проверки прошли. Но эта версия всё ещё может содержать регрессию, которая проявится под нагрузкой или только на определённых данных.
Поэтому мы разделили две вещи:
состояние операции: выполнение, успех, ошибка, отмена или откат;
отношение изменения к проблеме: возможная причина, подтверждённая причина, мера по устранению последствий или полезный контекст.
Успешный деплой может быть подтверждённой причиной инцидента. Успешный откат - действием, которое помогло восстановить работу.
Сам Change при этом остаётся отдельной сущностью. Его появление не создаёт алерт, не вызывает дежурного и не меняет статус сервиса. Иначе мы получили бы ещё один источник шума вместо инструмента расследования.
Один Checkout, несколько изменений и три разных вывода
Возьмём сценарий с демонстрационного стенда. В нём вокруг Checkout происходят несколько операций:
Время на стенде | Событие |
|---|---|
08:36–08:39 | Деплой Checkout v2.5.2 начинается и успешно завершается |
08:44 | Переключается флаг рекомендаций |
08:49 | Меняются настройки кеша |
08:54 | Появляется алерт о росте HTTP 5xx |
08:56 | Появляется отдельный алерт о росте времени ответа |
09:11 | Завершается операция отката и устранения ошибки |
Во время расследования близость по времени даёт несколько гипотез: деплой, флаг и кеш находятся рядом с началом проблем, однако дальше их судьба расходится.
В демонстрационном review связь деплоя с ошибками подтверждена проверкой логов и воспроизведением. Гипотеза о флаге рекомендаций отклонена: он не участвует в обработке заказов, а его выключение не изменило картину ошибок. Изменение настроек кеша остаётся кандидатом для проверки.
Для следующего инженера это гораздо полезнее списка «последние десять деплоев». Он видит, что уже проверили, почему одну версию отбросили и какой вопрос ещё открыт.
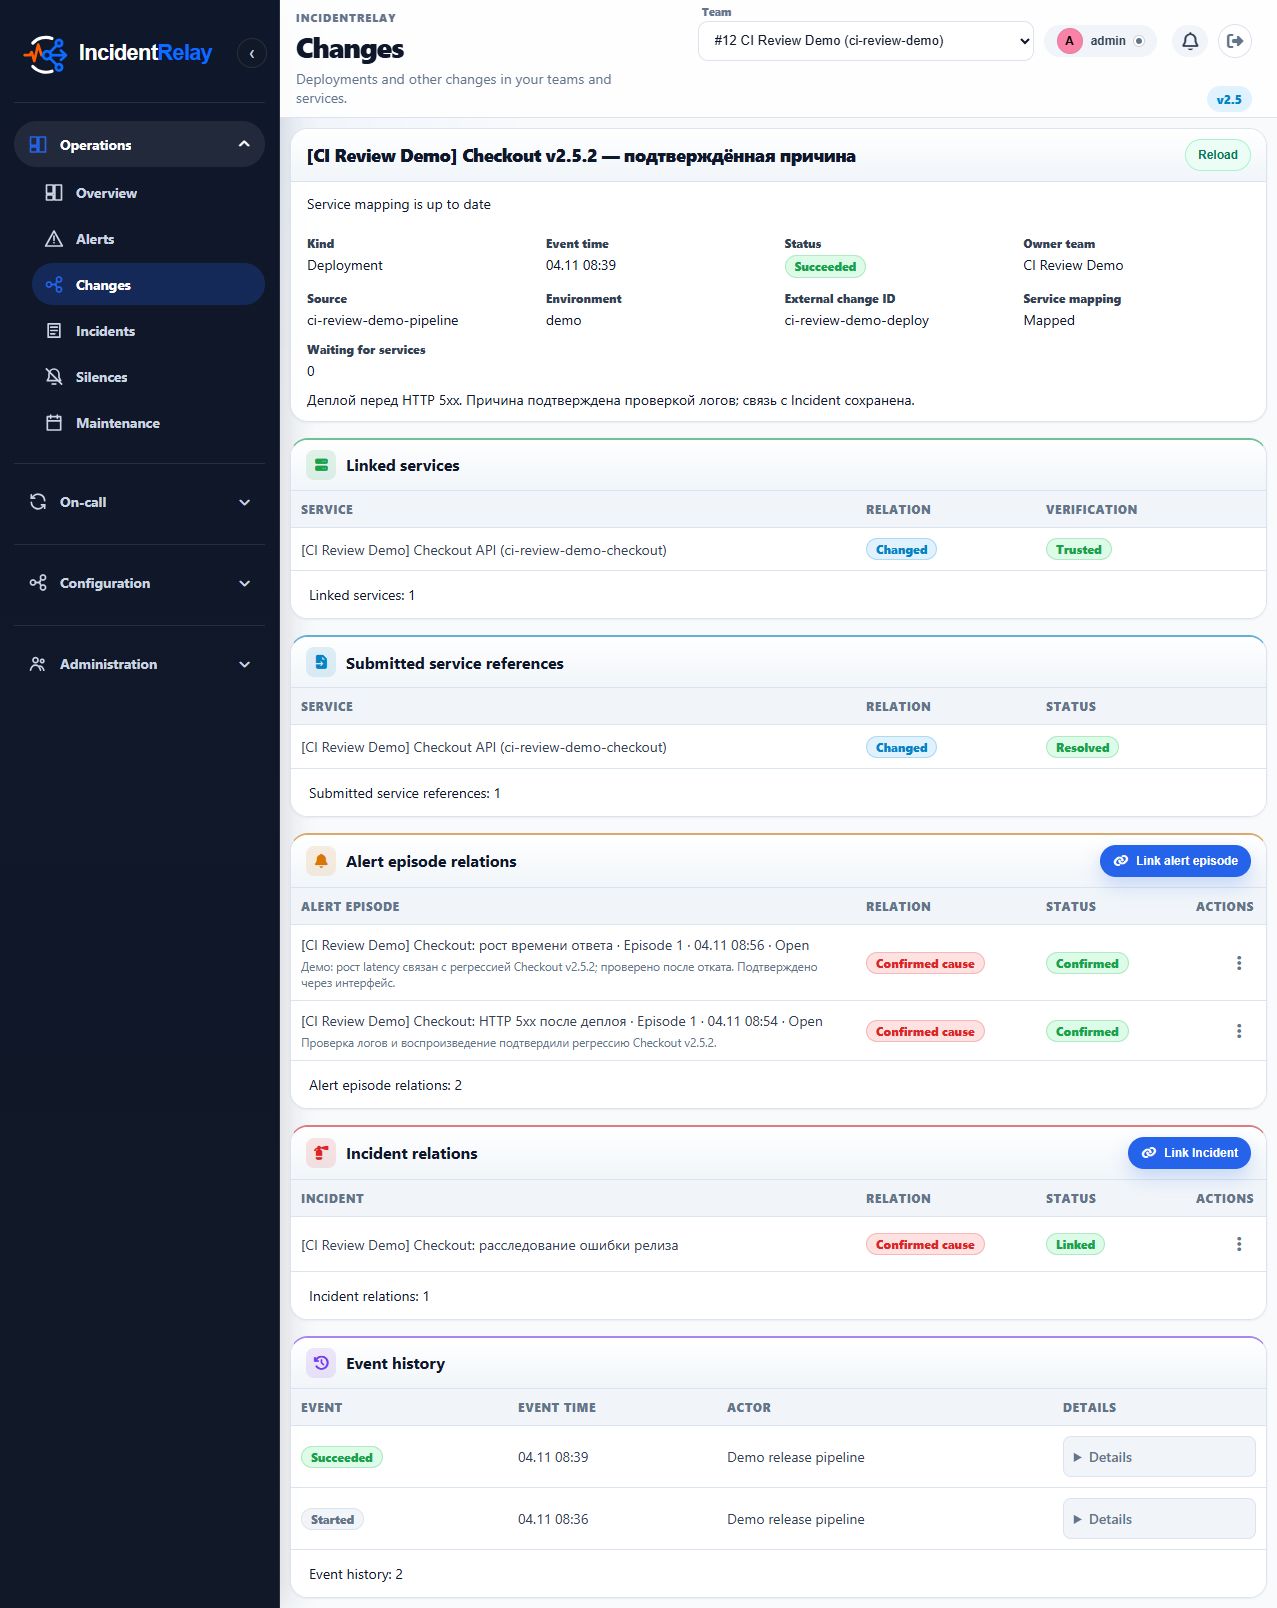
Фрагмент вкладки Related Changes у алерта HTTP 5xx. Confirmed, Rejected и Suggested сохраняют разные результаты проверки. Оценка 95/100 у изменения кеша явно подписана как релевантность, а не вероятность.
Как изменение попадает в IncidentRelay
Мы используем единый формат Change Event. Отправитель преобразует своё событие в этот контракт: это может быть шаг pipeline, Ansible-задача, инфраструктурный скрипт или отдельный адаптер.
Такое устройство позволяет подключать разные источники, но не означает, что у каждой CI/CD-системы уже есть готовый встроенный коннектор. Важно, чтобы отправитель передал нормализованное событие с устойчивыми идентификаторами и временем произошедшего изменения.
Вот сокращённый пример завершившегося деплоя. Названия команды, сервиса и источника здесь условные; перед отправкой они должны соответствовать настройкам конкретной установки:
{
  "schema_version": 1,
  "event_id": "checkout-release-142-succeeded",
  "change_id": "checkout-release-142",
  "source": "release-pipeline",
  "owner_team_slug": "checkout",
  "kind": "deployment",
  "event_type": "change.succeeded",
  "occurred_at": "2026-11-07T09:39:00Z",
  "environment": "production",
  "title": "Deploy Checkout 142",
  "changed_services": [
    { "service_slug": "checkout-api" }
  ]
}
События отправляются на POST /api/change-events с машинным токеном интеграции. Источник и разрешённые команды и сервисы настраиваются заранее. Обычные учётные данные администратора pipeline для этого не нужны.
change_id объединяет события одной операции. Начало деплоя и его успешное завершение имеют одинаковый change_id, но разные event_id. Отдельный повторный запуск операции получает новый change_id.
Сервис можно указать по числовому ID или по slug. Во втором случае важен контекст команды: checkout-api ищется в её пространстве имён, а не среди всех сервисов установки. После сопоставления история связывается с конкретным сервисом.
Если известна команда, но сервис с указанным slug ещё не появился в каталоге, ссылка может ждать разрешения, такое ожидание видно отдельно. Пока сервис не найден и права не проверены, запись не становится основанием для автоматической корреляции.
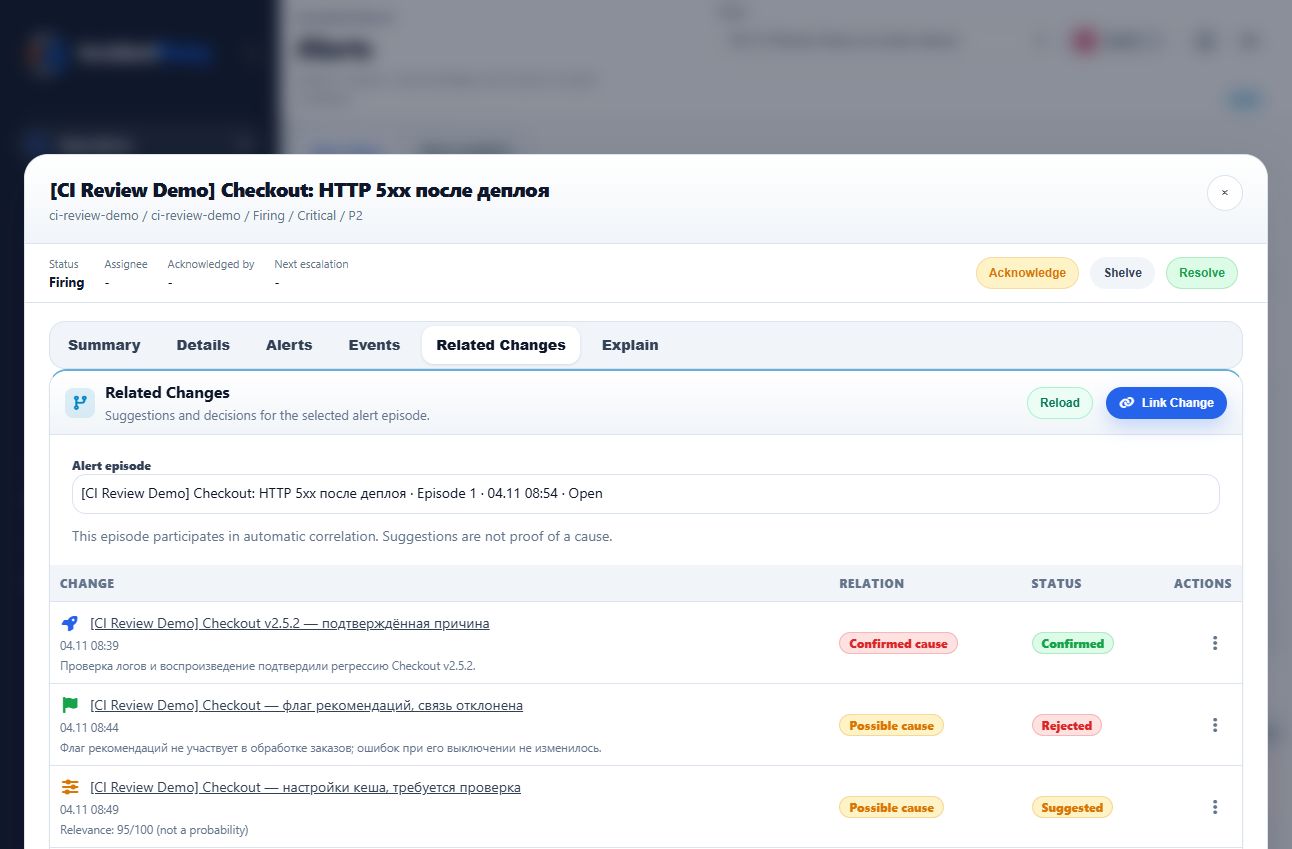
Карточка одной операции. Деплой имеет статус Succeeded, при этом его роль в двух эпизодах алертов — Confirmed cause. История Started/Succeeded хранится отдельно от результатов расследования.
По каким признакам IR предлагает связь
Для полезной гипотезы одного совпадения времени мало. Нужно понять, какой сервис меняли, где возник симптом и может ли между ними быть техническая связь.
Мы различаем три источника этой информации:
Связь с сервисом | Что она означает |
|---|---|
| Этот сервис непосредственно меняли |
| Отправитель сообщил о возможном влиянии на сервис; утверждение проходит проверку полномочий и доверия |
| Возможное влияние вычислено по графу зависимостей |
Последний вариант особенно полезен для инфраструктурных изменений. Например, конфигурацию поменяли у PostgreSQL, а ошибка проявилась в Checkout API. Если каталог содержит соответствующую зависимость, IR может рассмотреть этот путь при поиске кандидатов.
Направление такого обхода - от изменённой зависимости к её потребителям. В условном примере путь возможного влияния выглядит так:
PostgreSQL → Checkout API → Storefront
Путь объясняет, почему изменение попало в рассмотрение. Сам по себе он ещё не доказывает, что проблема действительно прошла по этой цепочке.
Затем учитываются время операции и начало конкретного эпизода алерта. Текущая реализация рассматривает начало эпизода внутри интервала операции и в двухчасовом окне после её завершения. Известное несовпадение окружений исключает связь: изменение в staging не должно становиться кандидатом для алерта в production только из-за близкого времени.
Если окружение не указано, оно остаётся неизвестным. Превращать отсутствие данных в подтверждённое совпадение было бы слишком оптимистично.
Кандидаты ранжируются по характеру связи, глубине зависимости, близости во времени и известному совпадению окружения. Прямое изменение сервиса получает более сильное совпадение, чем косвенная связь через несколько зависимостей.
Оценка 95/100 — это релевантность по набору правил. Она не означает, что алгоритм вычислил 95-процентную вероятность причины. Для вероятности потребовались бы другая модель, данные и проверка её калибровки. Здесь мы показываем объяснимую эвристику, чтобы инженер мог решить, что проверить раньше.
Автоматические предложения включаются отдельно для нужных сервисов. Можно исключить определённые источники алертов или сочетания меток. Например, команде может быть незачем сопоставлять синтетический тест с каждым деплоем. При этом исключения применяются к отдельным сигналам: группа остаётся кандидатом, если в выбранном эпизоде есть хотя бы один подходящий алерт.
Почему мы привязываемся к эпизоду алерта
Alert Group может восстановиться, а затем открыться снова. Её карточка продолжает жить, но новая вспышка симптомов требует новой проверки причин.
Представим, что в 10:00 начались ошибки после деплоя, в 10:07 они прекратились, а в 10:12 та же группа открылась повторно. Если прикрепить подтверждённую причину только к ID группы, есть риск автоматически перенести вывод первого расследования на второй эпизод. Поэтому связь Change с технической проблемой у нас относится к AlertGroupEpisode - конкретному циклу возникновения проблемы. Во вкладке Related Changes можно выбрать эпизод и посмотреть именно его гипотезы и решения.
Проверка инженера сохраняется отдельно от расчёта
Автоматическая часть предлагает возможную причину. Дальше инженер проверяет её по логам, трассировкам, воспроизведению, сравнению версий или другим свидетельствам.
В интерфейсе разделены две оси:
результат review - связь предложена, подтверждена или отклонена;
характер связи - контекст, возможная причина, подтверждённая причина или мера по устранению последствий.
Это позволяет выразить аккуратный вывод. Например, изменение действительно относится к расследованию, но утверждать причинность ещё рано. Или изменение стало полезной мерой восстановления и поэтому должно остаться в истории инцидента.
При ручном решении требуется пояснение. «Проверили обработчик заказов: флаг рекомендаций в этом пути не используется» помогает следующей смене гораздо больше, чем один красный бейдж Rejected.
Автоматический пересчёт может обновить свою часть данных, но не стирает ручное подтверждение или отклонение. Решение сохраняется вместе с контекстом проверки. Если данные успели измениться, интерфейс требует обновить состояние перед сохранением, чтобы один инженер не перезаписал незаметно вывод другого.
Ручную связь можно добавить и без автоматического кандидата. Это важно для редких изменений, неточной топологии и случаев за пределами автоматического окна поиска. Полезный факт не должен исчезать из расследования только потому, что эвристика его не нашла.
У инцидента появляется собственная история изменений
Технический алерт отвечает за конкретный симптом. Операционный Incident объединяет расследование, участников и несколько связанных Alert Groups.
Changes доступны на обоих уровнях. У алерта мы проверяем связь с выбранным эпизодом. В Incident сохраняем изменения, значимые для расследования в целом.
В нашем демонстрационном инциденте это выглядит так:
деплой Checkout - подтверждённая причина;
изменение настроек кеша - контекст расследования;
последующая операция отката - mitigation, то есть мера по устранению последствий.
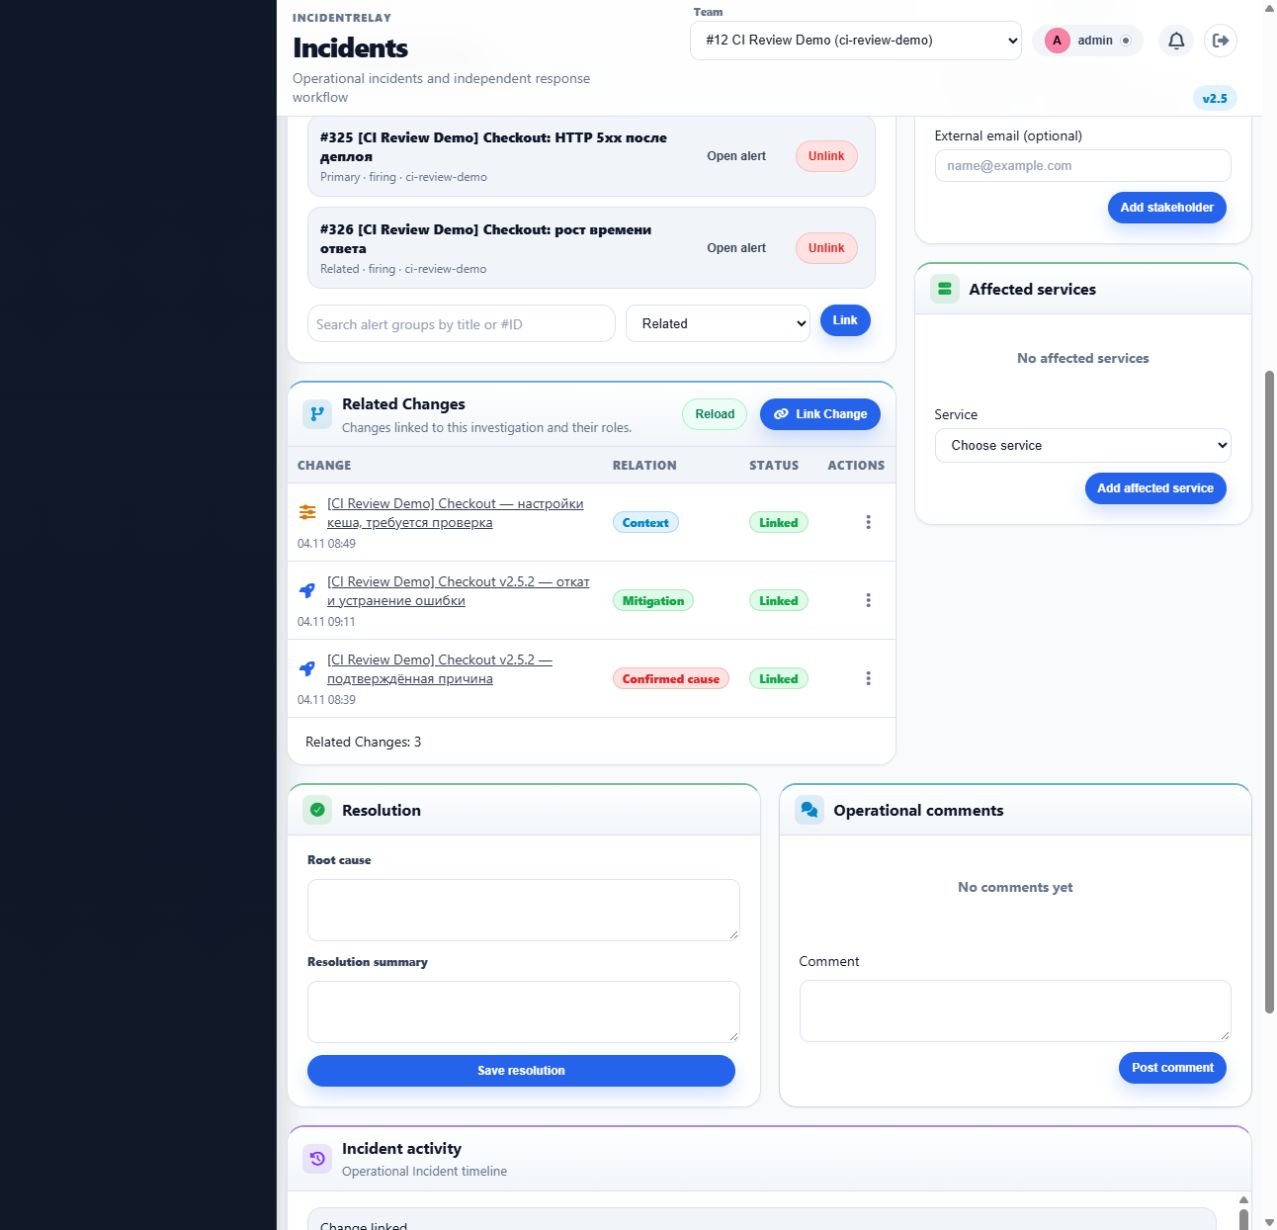
Related Changes в Incident. Здесь видно, что сломало систему, что учитывали при расследовании и какое изменение помогло устранить проблему.
Операция восстановления тоже заслуживает места в истории. Иначе через неделю легко найти подозрительный релиз и намного сложнее вспомнить, каким именно изменением устранили его последствия.
Связь с Incident не закрывает его автоматически и не разрешает технические алерты. Восстановление сервиса по-прежнему подтверждается в обычном процессе реагирования. Запись «откат выполнен» — полезное свидетельство, но ещё не проверка клиентских запросов.
Изменения также могут публиковаться в Service Timeline через фоновую обработку. Таким образом, к контексту можно прийти с трёх сторон: от изменения, от проблемы или от самого сервиса.
Самые интересные сложности оказались вокруг доставки
Показать строку в таблице относительно просто. Гораздо интереснее сделать так, чтобы эта строка не начинала врать после таймаута, повторной доставки или перезапуска обработчика.
Один запрос может приехать несколько раз
Pipeline может отправить событие и не получил ответ. Pipeline не знает, что произошло: запрос потерялся или сервер успел сохранить запись, а ответ пропал по дороге. При повторной отправке используется тот же event_id и тот же payload. Идентичный разрешённый повтор возвращает уже сохранённое событие и не создаёт вторую операцию и не запускает заново ту же работу.
Если под прежним идентификатором приходит другое содержимое, это конфликт 409. Молчаливо заменить исторический факт новым payload было бы удобно для отправителя и очень неудобно для расследования.
Первый приём возвращает 201, идентичный повтор — 200. При этом успешный ответ означает, что событие сохранено надёжно. Сопоставление сервисов и расчёт связей могут ещё выполняться.
События могут приходить не по порядку
Сообщение об успешном завершении иногда доезжает раньше сообщения о старте. Поэтому порядок доставки не определяет состояние операции.
Источник работает в одном из двух режимов упорядочивания: по времени события у отправителя или по последовательности source_sequence. Полученное позже старое событие не должно превращать уже завершённую операцию обратно в выполняющуюся.
Если в режиме времени приходят два разных финальных результата с одинаковым временем, система сохраняет явный конфликт: нам надо показать неопределённость, чем выбрать удобный исход по очередности HTTP-запросов.
Видимость данных - часть модели
Допустим, была изменена база, в которой живут несколько сервисов. При этом описание операции способно содержать внутренние ссылки, имена исполнителей и технические подробности, которые не нужны всем потребителям этой базы. Поэтому доступ к своему сервису не означает автоматический доступ ко всему исходному событию чужой команды. IR может показать ограниченный контекст связанного изменения без приватных полей отправителя.
Права проверяются и при приёме, и при фоновой обработке, и при чтении. Нельзя просто прислать чужой Service ID и получить доверенную связь с ним. После изменения разрешений производные связи также должны пройти повторную проверку. Это особенно важно для команд, которые хотят собирать общий контекст инфраструктуры, сохраняя существующее разделение доступа.
Что доступно сейчас и как пробовать
В текущей реализации есть журнал Changes, карточка операции с историей событий, сопоставление с сервисами, автоматические кандидаты, ручное review, связи с Incident и раздел Related Changes у алертов. Для Service Timeline предусмотрена публикация через тот же устойчивый фоновый механизм. Изменения доступны в версии 2.5.0.
Код проекта: github.com/roxy-wi/IncidentRelay. Описание проекта: incidentrelay.io.
Мне в этой функциональности больше всего нравится переход от вопроса «кто что-то менял?» к конкретному списку: вот операция, вот затронутый сервис, вот основания её проверить, а вот то, что команда уже выяснила. Это хороший материал и для первых минут инцидента, и для передачи смены, и для последующего разбора.
А как у вас сейчас собирается контекст изменений во время сбоя: единая история, события на графиках или поиск по нескольким CI/CD и чатам?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.