Генерация тест-кейсов с ИИ: опыт команды ТестОпс
Статья была бы невозможна без беседы с Татьяной Игнатьевой и Фаилем Нигматуллиным — большое им спасибо. Ответственность за любые ошибки на мне.
Поговорим о том, как от нейрослопа прийти к хорошим сгенерированным тест-кейсам. В любом ремесле качества добиваются кропотливыми итерациями по продукту, добавляя всё новые инструменты и проверки.
Скажем, скульптор не «находит» уже готовую статую в камне, а проходит по материалу много раз, каждый раз всё более точным инструментом: вначале шпунтом скалывает большие куски, потом скарпелем обрабатывает до относительной гладкости, потом полирует разными способами, чтобы скрыть следы скарпеля. Если бы мы заглянули в мастерскую посредине этого процесса, то увидели бы статую «размытую», с нечёткими очертаниями.
Так же нечётко и общо отвечают нейросети, если их специально не настроить. Наш резец здесь — контекст, и о том, как он важен для генерации тест-кейсов, уже писали на Хабре (тут и тут).
В прошлой статье я показывал гипотетический пример того, как с современными инструментами можно интегрировать в один процесс разные источники данных для генерации тест-кейсов. Сейчас же я расскажу о реальном опыте команды ТестОпс:
Вначале опишу цепочку от макетов в Figma до проверенных тест-кейсов в TMS.
Потом расскажу, с какими сложностями пришлось столкнуться и как их преодолевали итерация за итерацией, добавляя новые элементы контекста.
Со многими из этих проблем разработчики в ТестОпс уже столкнулись, когда настраивали своего агента для правки багов (об этом статья в двух частях — ч. 1 и ч. 2).
1. Как выглядит процесс сегодня
Сегодня команда генерирует тест-кейсы примерно по следующей схеме:
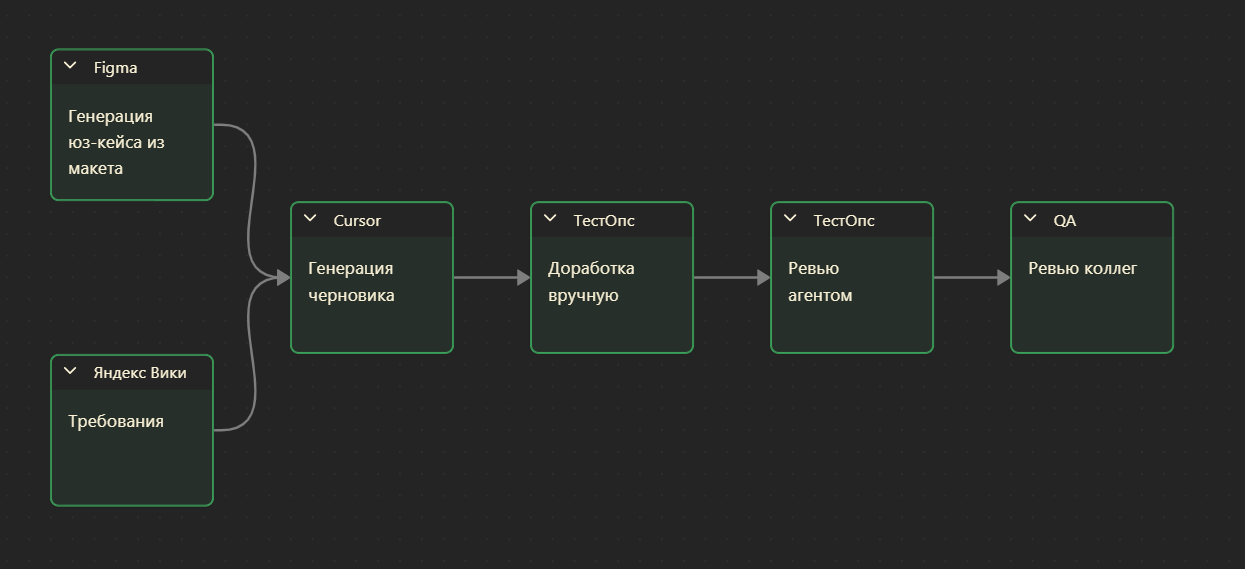
Макеты из Figma с помощью встроенного ИИ-ассистента превращаются в юз-кейсы. Промпт простой, буквально: «распиши юз-кейсы на основе данного макета».
Требования берутся Из Яндекс Вики.
Из требований и юз-кейсов в Cursor генерируются тест-кейсы, пока в очень сыром виде.
Тест-кейсы загружаются в TMS ТестОпс в статусе черновиков. Дорабатывать их вручную в TMS гораздо удобнее, чем объяснять агенту в чате, что именно нужно исправить. Кроме того, для массовых правок можно использовать внутреннего агента TMS.
Внутренний агент TMS проверяет кейсы на соответствие стилю проекта, логичность и отсутствие противоречий.
Тест-кейсы отправляются на ревью другим тестировщикам. Люди лучше знают контекст, видят связи между компонентами и предлагают новые сценарии проверки.
Точно оценить эффект от нейросетей команда пока только планирует. Но по ощущениям, дорабатывать сделанные ИИ черновики где-то на 30% быстрее, чем писать с нуля.
У этого процесса большой потенциал. В перспективе с ним можно сразу будет писать автотесты, и в QA уже всерьёз обдумывают такую цепочку. Она может выглядеть так:
В QA приходят требования.
По ним пишутся тест-кейсы, причём для happy-path они пишутся в свободной форме, без сильной привязки к правилам и структуре, с главной целью — передать смысл проверки.
Тест-кейсы проходят ревью. На мелочи не обращают внимания, но следят за тест-дизайном и всем, что может помешать понять тест-кейс и написать по нему e2e-тест.
На основе этих тест-кейсов генерируются автотесты. Для этого уже написан специальный скилл.
Но пока это в будущем. Сейчас же с генерацией есть трудности, и интересно посмотреть, как тестировщики их преодолевают.
2. Как добавляется новый контекст
Сейчас тестировщики пишут скилл (стандартный SKILL.md), который должен улучшить генерацию тест-кейсов. Это — как раз тот резец, который делает агента более точным. Вот его основные компоненты — уже работающие и запланированные:
Устранение дублирования
Модель сама по себе не следила за тем, перекрываются ли тест-кейсы друг с другом. Пришлось добавить отдельную проверку, которая исключала бы дублирование. Правда, здесь есть проблема с тем, что агент плохо ориентируется в существующих тест-кейсах и их структуре хранения, поэтому путает кейс и результат теста. Здесь нужна работа с промптом.
Кроме того, скилл проверяет, что повторяющиеся между тест-кейсами действия вынесены в общие шаги, а существующие общие шаги переиспользуются. Это должно существенно сократить количество правок.
Сверка терминологии
Чтобы обеспечить единство языка, в скилл добавили специальный файл с терминологией. Туда записывают специфичные проекту понятия или термины, которые нейросеть может интерпретировать неоднозначно.
Корректировка стиля
Без чёткого руководства по стилю модель гораздо чаще выдаёт нейрослоп, пытается уместить в один тест-кейс независимые проверки или описывает ожидаемые результаты очень общо — в стиле «проверь, что работает».
Чтобы улучшить ответы нейросети, был создан отдельный файл по стилистике, который также живёт внутри скилла. В нём описаны правила для каждого раздела тест-кейса, причём касающиеся как логики, так и языка:
Общие правила по языку и разметке
Название и описание тест-кейса (например, для похожих тест-кейсов названия должны точно передавать различия)
Структура и метаданные (например, для названий полей нужно использовать существующие варианты, а перед предложением нового поля проверять известные аналоги)
Предусловие
Вид сценария (например, подробный пошаговый сценарий не оформляется как чек-лист)
Текст и порядок шагов (в частности, все действия должны быть описаны инфинитивом: «Открыть», «Нажать»)
Ожидаемый результат (здесь как раз прописано, что ожидаемый результат должен быть конкретным наблюдаемым фактом, например «Открывается форма»)
Общие шаги
Источники, ссылки и сопровождающий отчёт (например, точные ссылки на источники требований)
Проверка оформления — перед передачей модель должна проверить весь текст
Это руководство можно дополнять и менять по мере того, как накапливаются замечания от тестировщиков или агента. Иначе говоря, у процесса появился механизм отладки.
Сверка с документацией
В перспективе можно дать агенту доступ к документации всего приложения, чтобы он мог сопоставлять новую фичу с существующей функциональностью. Это тоже сделает ответы более согласованными и единообразными.
Компиляция требований
Качество генерируемых тест-кейсов и покрытие фич напрямую зависят от того, насколько полны требования. Обеспечить эту полноту оказалось самой трудной проблемой — причём не только для команды ТестОпс.
Начнём с того, что весь описанный выше путь относится к UI-фичам, для которых есть макеты в Figma. Для задач без макетов (бэкенд, интеграции, API) полноценных требований обычно нет: тесты пишутся по коду готовой фичи. Но даже для UI требования обычно неполные и живут в разных источниках: Figma, вики, треды, а что-то — только в созвонах и личных чатах с заказчиком.
Частично эта проблема решаема благодаря гибкости ИИ-инструментов. Скилл, который пишет сейчас QA, должен будет собирать требования из нескольких источников:
Яндекс Вики
Яндекс Трекер
Figma (в перспективе — с прямым доступом к макетам через MCP-сервер)
Чаты
Это автоматизирует большой кусок работы с агентом. В этом же скилле будут жить проверки стиля, терминологии и дублирования, о которых я писал выше, так что качество ответов тоже должно вырасти.
И всё же даже это не решает проблему полноты требований, потому что как минимум часть из них живёт в голове у людей — а забраться туда ИИ пока, к сожалению (или к счастью?), не способен.
3. О чём думать дальше
Настроить нейросетевого агента сегодня — задача решаемая: инструментов много, и они очень гибкие. Тот же n8n позволяет на холсте собирать агента из нод отдельных инструментов.
Но если зарыться в каждую из этих нод и посмотреть, что стоит за ними в реальной трудовой практике, мы увидим, что многие из них очень нестабильны, потому что зависят от человеческих процессов. Например, чисто технически наладить сбор требований из разных источников вполне возможно — но это не гарантирует полноты, если какие-то вещи обговариваются только лично.
Команда QA ТестОпс сейчас отрабатывает агентную генерацию тест-кейсов, и итерация за итерацией результаты становятся всё более точными. Как будет выглядеть автоматизированный конвейер от требований к автотестам — покажет будущее.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.