RAG после reranker: от корпоративного поиска к агенту, которому можно поручить исследование
Привет, Хабр! На связи Александр Михеев, ML-инженер Центра гибридного интеллекта в Рунити. В первой статье мы рассказывали, как улучшали поиск по почти 35 тысячам страниц Confluence. Главная подсказка пришла из метрик: нужная информация часто уже находилась среди кандидатов, но стояла слишком низко. Reranker помог поднять подходящие фрагменты и заметно улучшил выдачу.
Следующий этап — сделать этот поиск доступным там, где сотрудник работает. Разработчик разбирает сервис вместе с агентом, обсуждает изменение в коде или выясняет причину ошибки. В этот момент ему может понадобиться внутренняя документация, описание архитектуры или связанная задача в Jira.
Когда начали объединять компоненты, выяснилось, что сам поиск — только часть работы. Даже при хорошей выдаче агент мог остаться без нужных документов после проверки прав или не дождаться завершения исследования. На этих случаях мы и проверяли, насколько работоспособной получилась интеграция.
Навигация по тексту:
Даем агенту доступ к поиску
К концу первой статьи у нас уже был поисковый пайплайн: подготовка данных, dense и sparse retrieval, объединение кандидатов и reranker. Следующая задача — дать агенту возможность вызывать его по мере необходимости.
Мы обернули RAG-поиск в MCP-сервер с HTTP-эндпоинтом /mcp: агент вызывает инструмент indexer_search через JSON-RPC, передавая запрос и фильтры. Сервер обращается к Indexer и возвращает фрагменты документов со ссылками обычным JSON-ответом — для этого поискового инструмента stdio и SSE не используются.
На этом уровне цепочка выглядит просто:
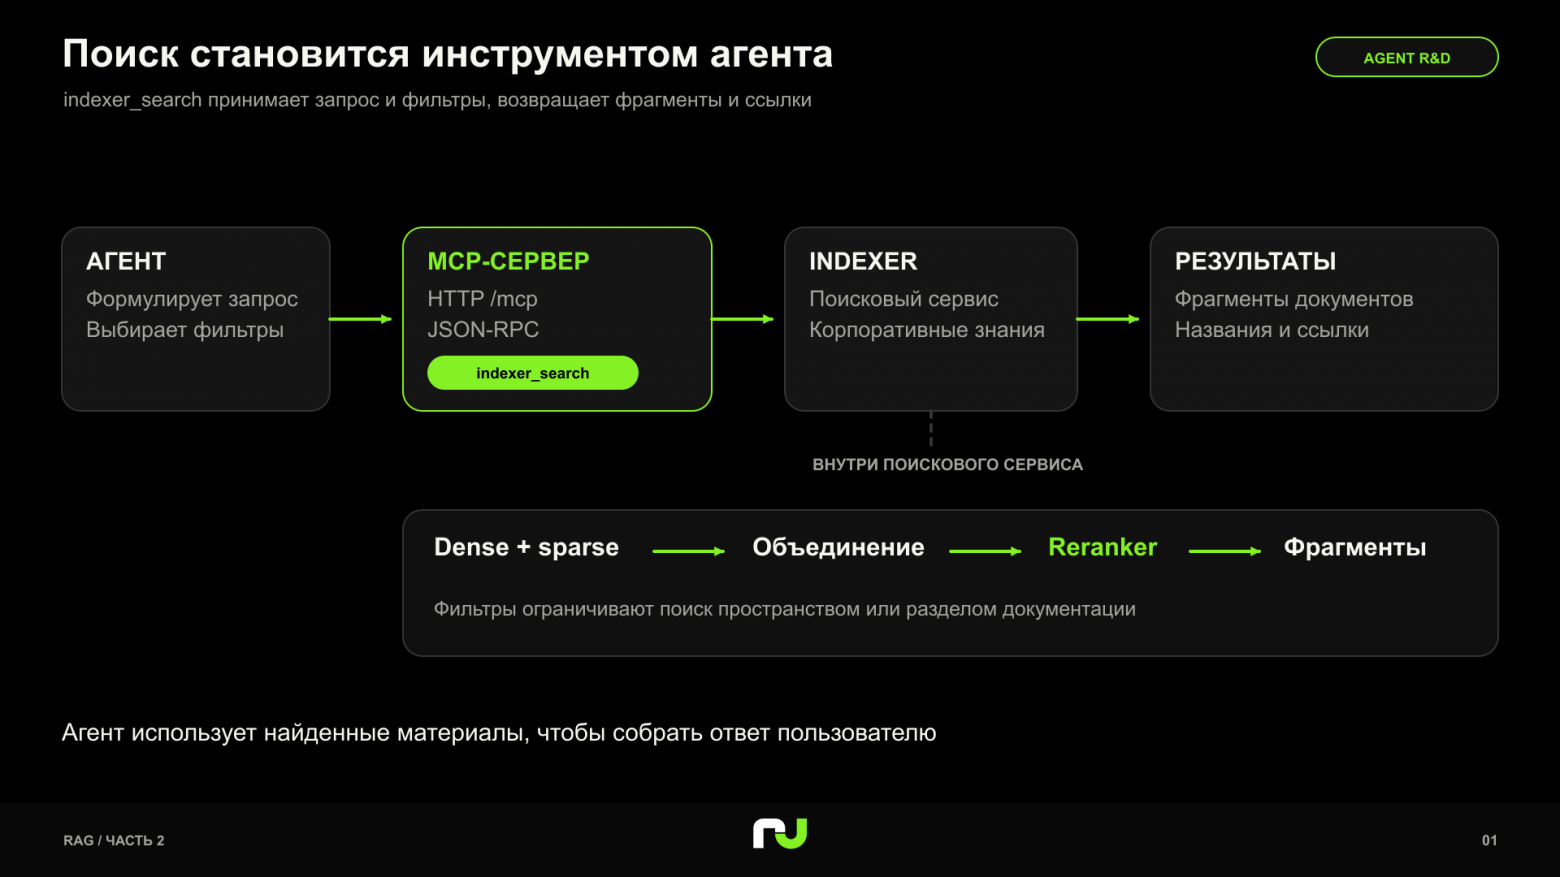
При необходимости запрос можно ограничить пространством Confluence или разделом документации. Агенту не нужно знать, как устроены векторы и объединяются результаты разных поисковых каналов. Эти детали остаются внутри поискового сервиса.
Но ответ поискового инструмента — ещё не ответ пользователю. Агенту предстоит выбрать подходящие материалы, сопоставить сведения и понять, достаточно ли их для ответа. Если информации не хватает, нужно уточнить запрос и получить дополнительные данные.
Например, по вопросу об устройстве сервиса поиск может вернуть обзорную страницу, инструкцию по развертыванию и несколько описаний отдельных компонентов. Все документы относятся к теме, но каждый отвечает только на часть вопроса.
Прежде чем поручать агенту такую работу, нужно решить еще одну задачу: какие из найденных материалов ему вообще можно передать.
Проверяем права до передачи документов модели
Доступ к поисковому инструменту и доступ к документу — разные разрешения. Сотрудник может пользоваться корпоративным агентом, но это не означает, что ему доступны все материалы в общей базе.
Проверку нужно выполнять до передачи содержимого документов модели. Просить ее самостоятельно скрывать закрытые сведения уже после чтения документа было бы слишком поздно.
Одна коллекция, разная выдача
Сначала мы проверили простую схему: хранить ограничения рядом с каждым чанком в Qdrant. В payload указали разрешенные группы, категории документов и специальные метки. Перед поиском обертка добавляла фильтр по этим полям, а после получения результатов повторно проверяла каждый payload.
При одинаковом поисковом запросе пользователь с правами чтения получал только публичный чанк, а пользователь с более широкими правами — и публичный, и внутренний. Отдельные запреты на использование материалов в AI действовали для обеих групп.
Так мы проверили, что общую коллекцию можно использовать для сотрудников с разными доступами. Это был небольшой эксперимент на синтетических данных: он проверял работу ограничений, а не качество семантического поиска.
Почему для Confluence понадобилась другая схема
В эксперименте мы сами задавали права в Qdrant. У реальных документов права уже существуют в источнике.
В Confluence настроены разрешения пространств и ограничения отдельных страниц. Они меняются независимо от содержимого: сотрудника перевели в другую команду, страницу закрыли, доступ выдали конкретному человеку.
Если скопировать эти разрешения в Qdrant, появится ещё одна версия прав. Ее придется обновлять при каждом изменении и следить, чтобы ограничения применялись ко всем чанкам документа. Сам текст страницы при этом может оставаться прежним.
В интеграции с Confluence мы использовали проверку через ACL-шлюз. Indexer сначала находит кандидатов, затем передает шлюзу идентификаторы страниц и пользователя. Шлюз проверяет права пространства и ограничения страницы по данным Confluence. В поисковую выдачу попадает только текст, доступный пользователю. Так проверка доступа выполняется отдельно от обновления поискового индекса.
Как добрать доступные документы
У проверки после поиска есть цена: часть найденных результатов приходится исключать.
Допустим, поиск вернул десять подходящих кандидатов, но восемь из них закрыты сотруднику. Останется два. При этом ниже в выдаче могут находиться другие доступные документы, которые тоже отвечают на вопрос.
Поэтому в Indexer реализовали поиск с запасом кандидатов. Если после проверки прав результатов недостаточно, выборка расширяется.
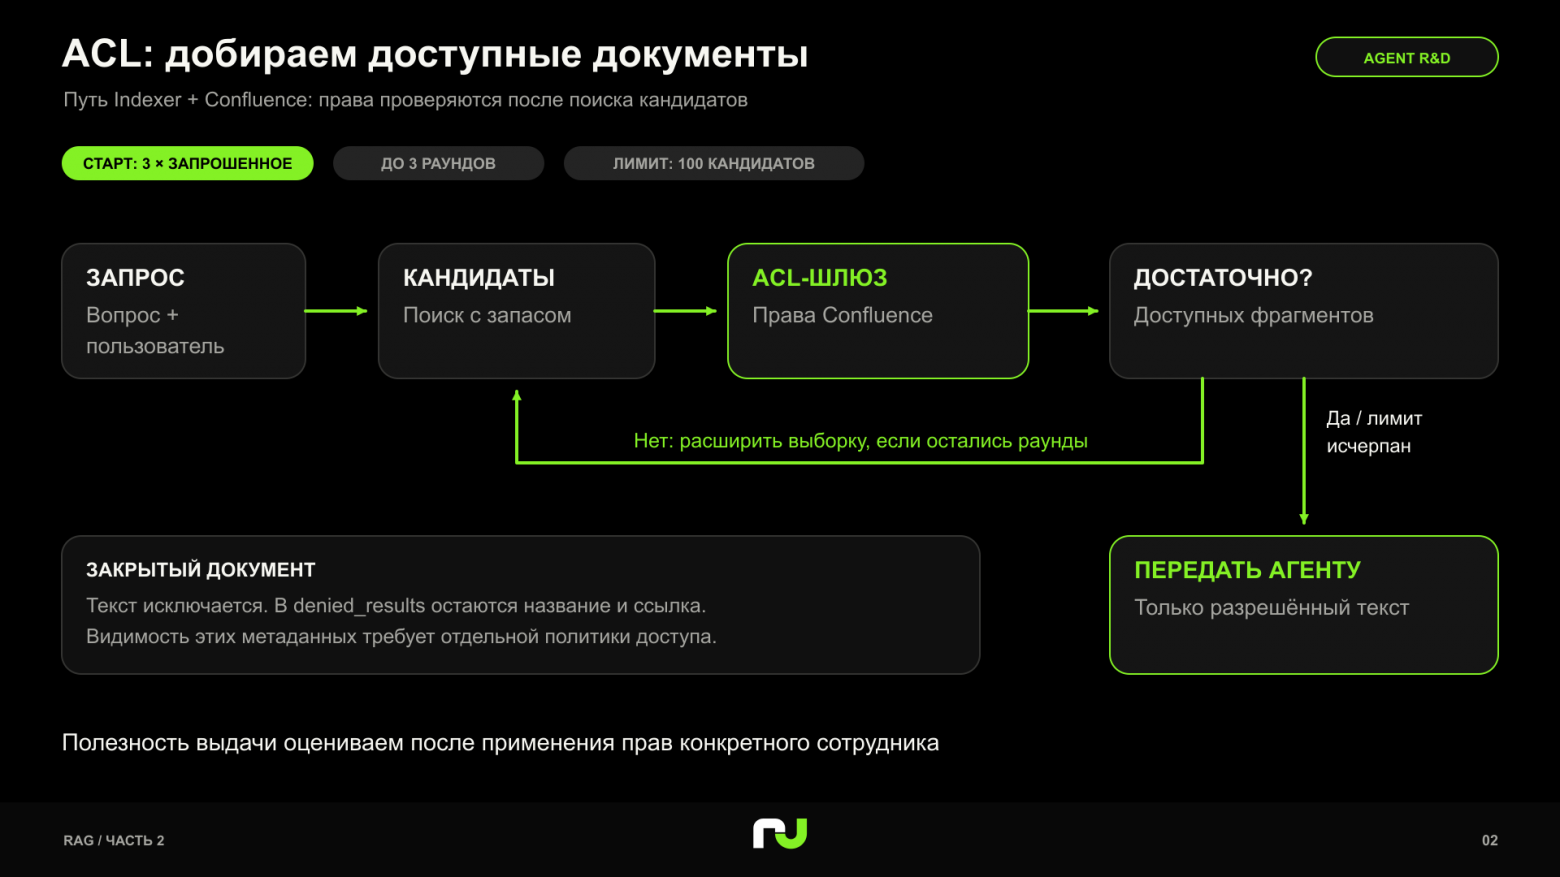
В конфигурации начальная выборка содержит втрое больше кандидатов, чем запрошено результатов. Предусмотрено до трех раундов поиска с ограничением в сто кандидатов за запрос. В тесте проверили сценарий, где после первого прохода оставался один доступный документ, а после расширения находились два — столько и требовалось.
Это важный момент для оценки качества. Метрики по всей коллекции показывают, насколько хорошо находятся документы вообще. Сотрудник получает выдачу с учетом своих прав. Поэтому оценивать пользовательский результат нужно уже после применения ограничений.
В первой статье предварительная ACL-фильтрация при retrieval была описана как целевая production-схема. В нашем Qdrant-прототипе ограничения действительно применяются до поиска. В описанной интеграции через Indexer права Confluence проверяются после получения кандидатов — отсюда и необходимость расширять выборку.
Что сообщать о закрытом документе
Для Indexer мы выбрали следующее поведение: содержимое закрытой страницы исключается, а в denied_results остаются название и ссылка.
Благодаря этому агент может различить два ответа:
«Поиск не нашел подходящих документов».
«Документ найден, но его содержимое вам недоступно».
Во втором случае пользователь понимает, что материал существует и можно запросить доступ. При этом название, ссылка и сам факт существования страницы остаются видимыми. Такое поведение нужно отдельно согласовывать с требованиями компании: закрыть текст и полностью скрыть документ — разные решения.
Собираем ответ из найденных материалов
После подключения поиска агент получил доступ к внутренним знаниям. Теперь нужно было определить, как он будет ими пользоваться.
Для короткого вопроса иногда достаточно одного найденного фрагмента. Для более сложной задачи требуется несколько действий: уточнить запрос, открыть страницу целиком, проверить сведения в Jira, изучить комментарии и данные об SLA, сопоставить источники.
Предположим, сотрудник спрашивает, как устроен сервис и какие изменения в нем сейчас планируются. Документация поможет разобраться с архитектурой, а актуальность нужно искать в Jira. Одного набора похожих фрагментов для такого ответа недостаточно.
Эту работу мы поручили Hermes — готовому агенту со своей средой выполнения (harness). Она отвечает за вызовы инструментов, управление состоянием задачи, ограничения и продолжение работы между шагами. Мы дополнили Hermes корпоративными инструментами, инструкциями и проверками.
Внутри получился следующий процесс:
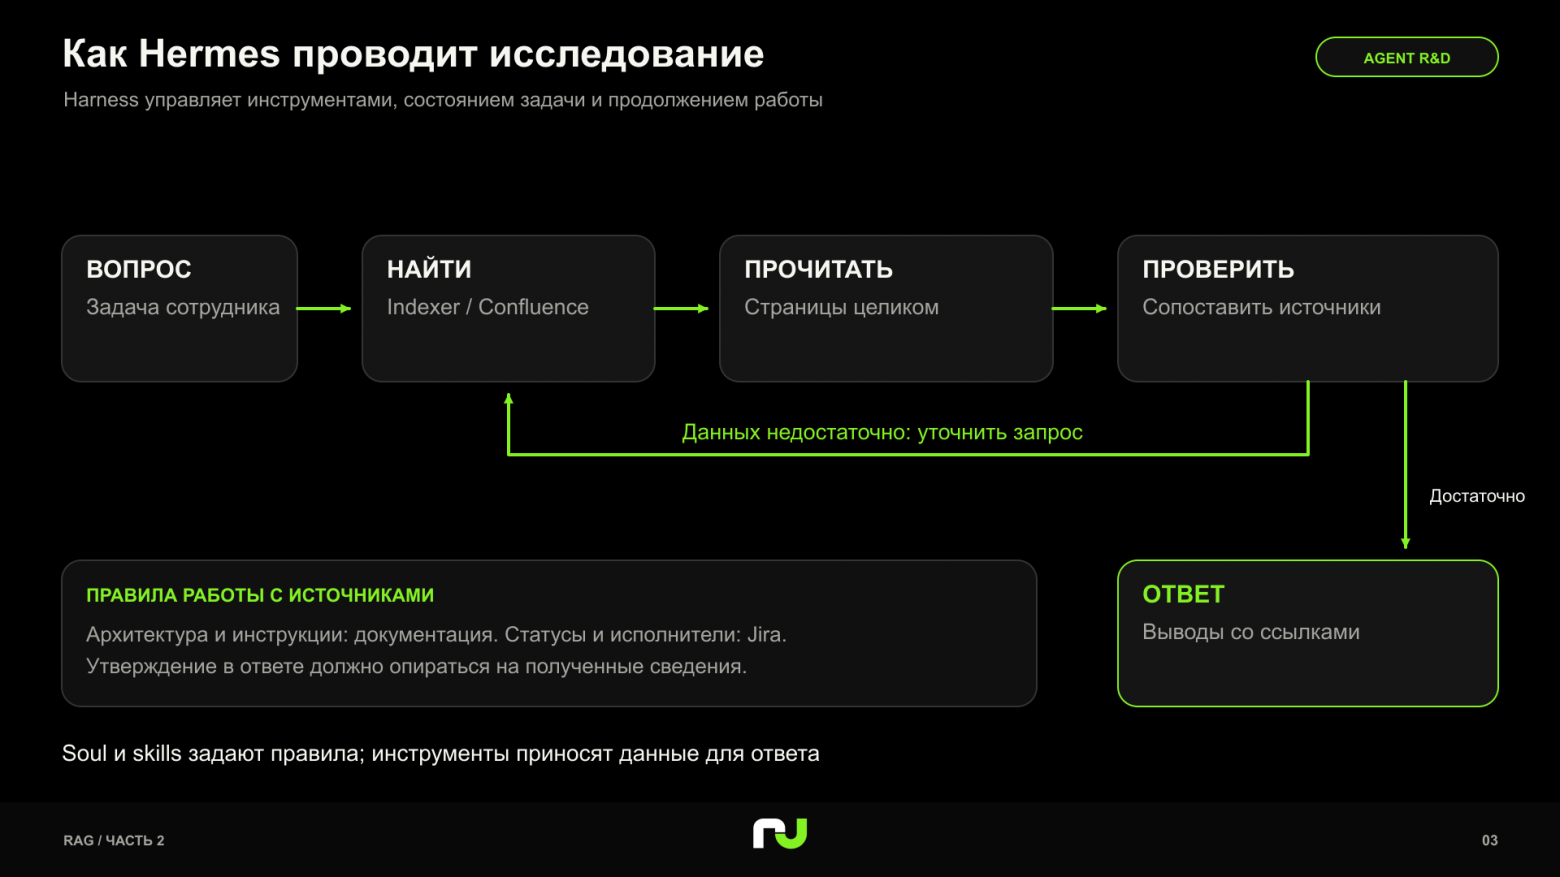
Для разных источников нужны свои правила. Вопрос по документации ведет в Indexer и Confluence. Вопрос об актуальном состоянии задачи — в Jira. Перед утверждением о статусе, исполнителе или описании задачи агент должен получить соответствующие сведения из инструмента.
Правила описали в soul («душе») агента и в отдельных skill-инструкциях для конкретных MCP-инструментов. Например, проверяется, возвращались ли упомянутые задачи из Jira и были ли получены детали, на которые ссылается ответ.
За счет этого правила корпоративного исследования поддерживаются в одном месте. Их можно версионировать и дорабатывать вместе с поиском и инструментами, а затем использовать из разных клиентских приложений.
Именно здесь проходит граница между подключенным поиском и настроенным исследовательским агентом. Первый возвращает материалы. Второй выполняет последовательность действий, необходимую для ответа.
Подключаем готовое исследование к другим агентам
Агент Hermes уже умеет работать с корпоративными источниками, но просить сотрудников установить всю обвязку с адаптацией инструкций и скиллов под свои harness — неудобно, и мы решили подключать наших исследовательских агентов к внешнему агенту как отдельный инструмент MCP.
Так появился hermes_research. На вход он получает вопрос, на выходе возвращает подготовленный ответ со ссылками.
Разница между двумя интерфейсами выглядит так:
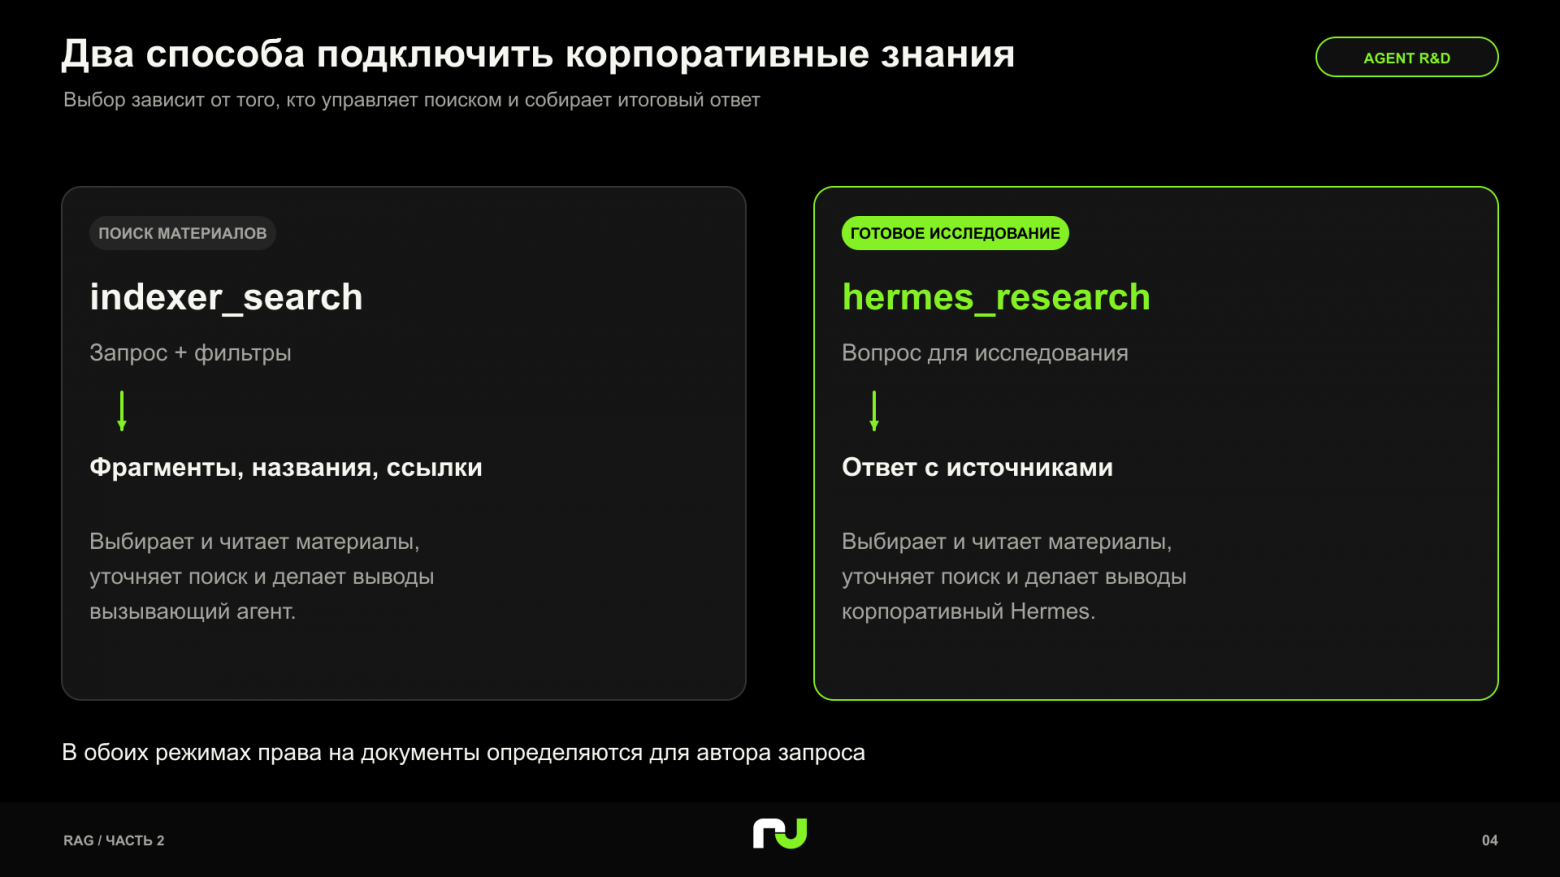
Первый вариант подходит, когда агент сам управляет поиском и сборкой ответа. Во втором он делегирует корпоративное исследование Hermes.
Сначала мы интегрировали внешний DeepSeek Harness, затем настроили подключение через MCP Hub. Запрос проходил по следующей цепочке:
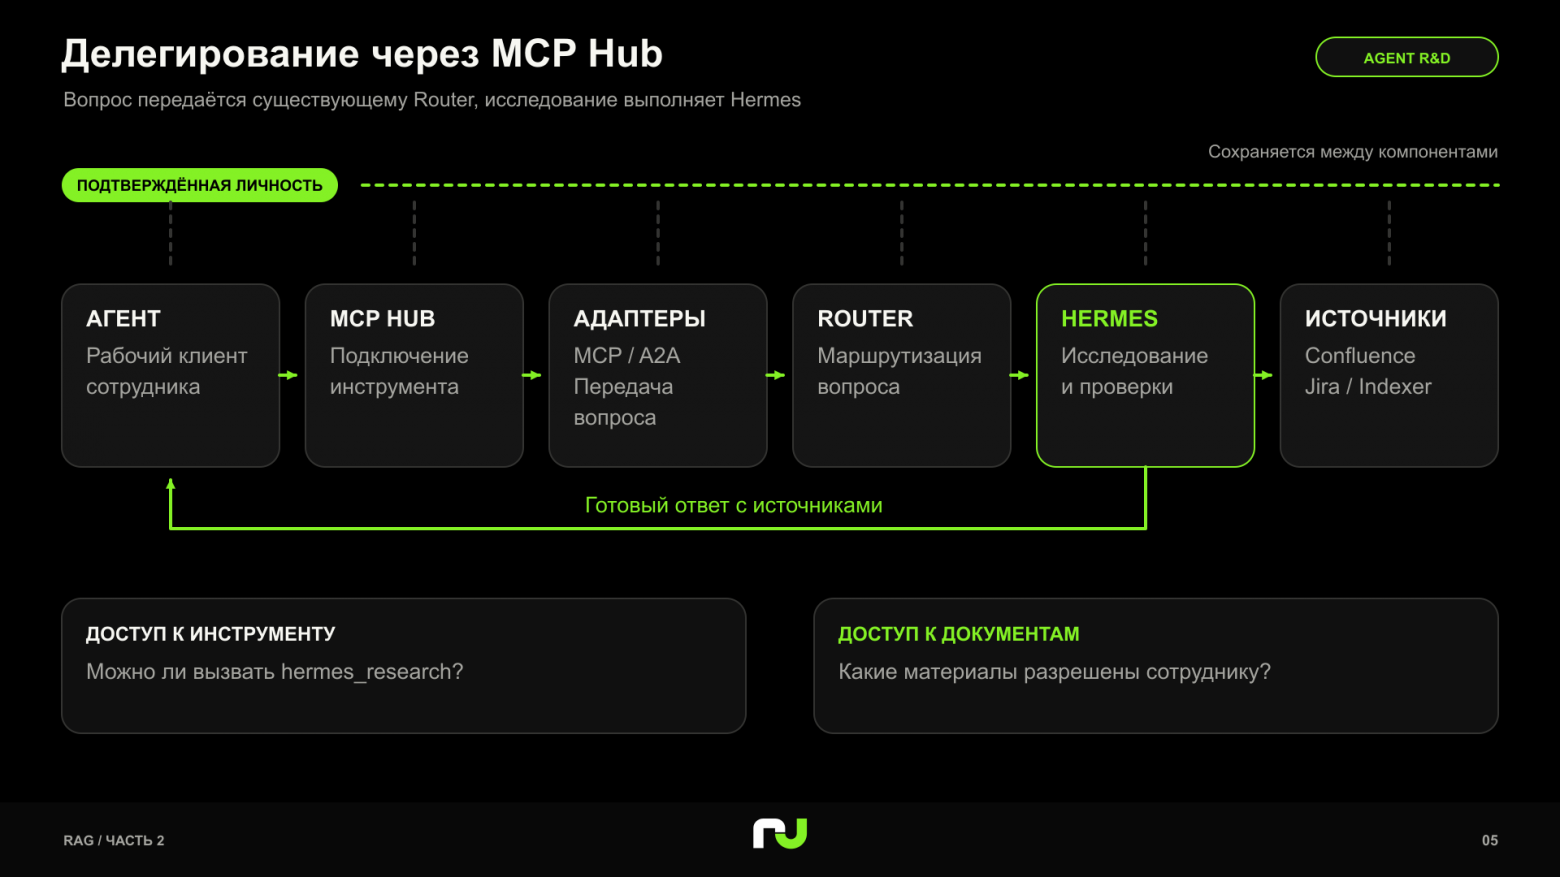
MCP используется для подключения инструмента к клиенту, A2A — во внутреннем взаимодействии с агентом. Само исследование выполняет уже существующий нейропоиск.
В Hub-режиме адаптер передает полученный вопрос существующему Router. В тесте проверили, что адаптер передает вопрос без изменений, не добавляет собственный системный промпт и не инициирует дополнительный вызов модели после получения ответа.
В результате сотрудник может обратиться к корпоративным знаниям из своего рабочего агента. Инструкции по источникам, проверки и поисковые настройки остаются внутри Hermes.
Сохраняем права сотрудника
При делегировании вместе с вопросом нужно сохранить информацию о том, кто его задал. Иначе корпоративный поиск не сможет определить, какие документы разрешено показать этому сотруднику.
Для пользователя это обычный вход через корпоративный аккаунт. Дальше система передает между компонентами подтвержденные сведения о пользователе, чтобы поиск выполнялся с учетом его прав.
При этом доступ к самому hermes_research и доступ к документам проверяются отдельно. Подключение нового агентного интерфейса не должно расширять права сотрудника на корпоративные материалы.
Передаем задачу и ждем результат
После подключения агента как инструмента остается практический вопрос: как дождаться исследования, которое занимает больше времени, чем обычный запрос к API?
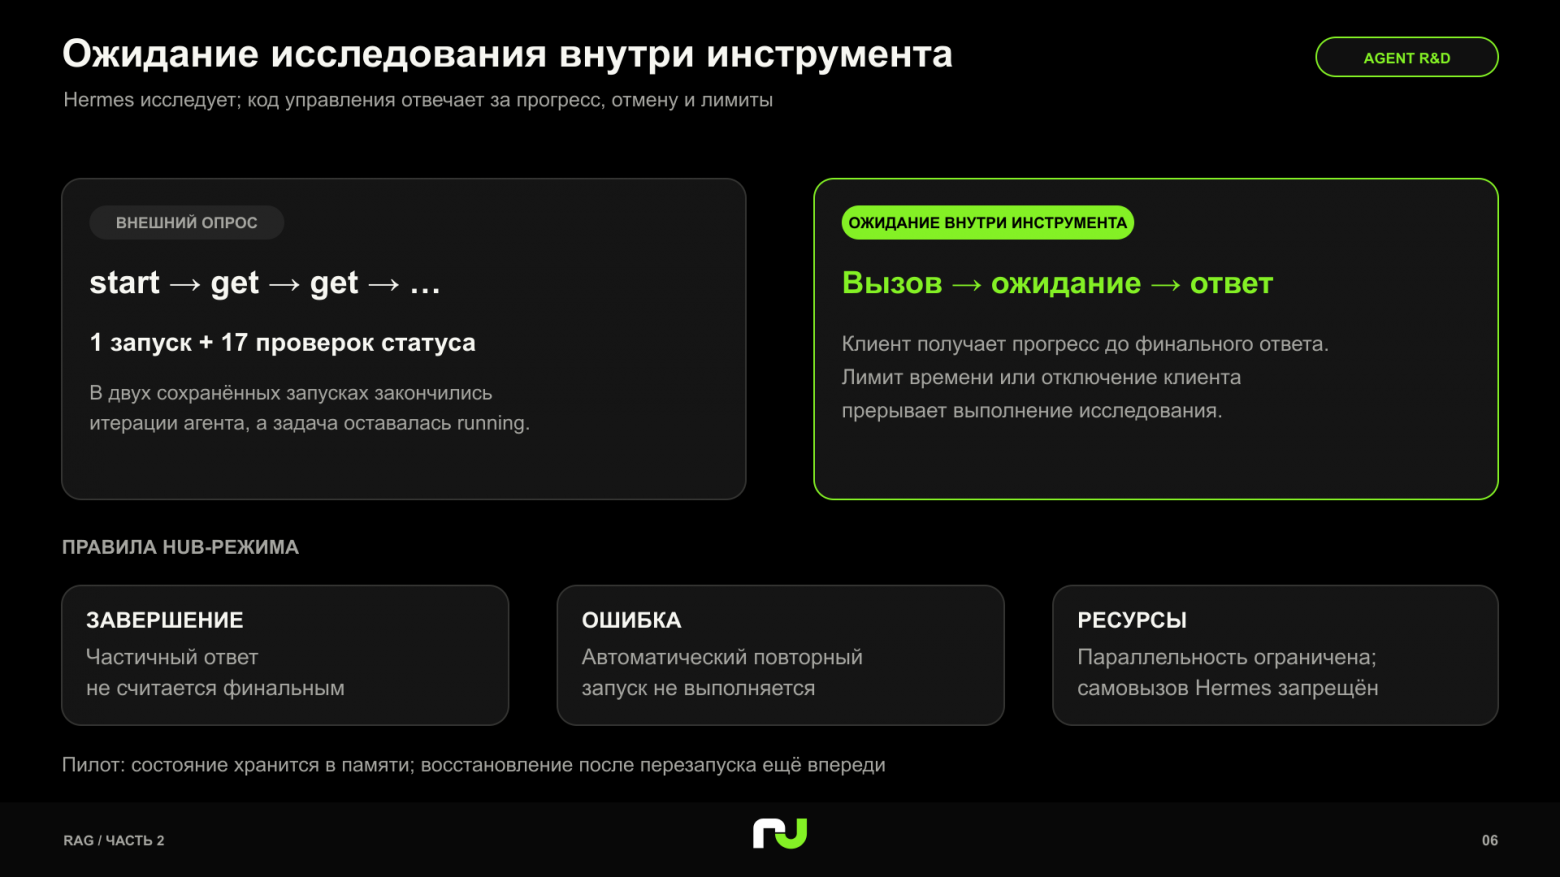
Мы попробовали две обертки над Hermes. Первая — start/get/stop: позволяет запустить исследование, проверить его состояние и остановить выполнение. Вторая — hermes_chat: вызывает инструмент и ждет готового ответа.
В двух сохраненных запусках первого варианта внешний агент потратил один вызов на запуск и ещё 17 на проверку состояния. После этого закончился лимит итераций, а исследование все еще возвращало running.
Для нас это стало аргументом в пользу того, чтобы обычное ожидание выполнять внутри инструмента. Повторная проверка статуса расходует шаги внешнего агента, хотя новой информации для решения пользовательской задачи может не появляться.
Синхронный вариант избавлял от такого опроса, но тоже требовал обработки ошибок. В двух сессиях с содержательным ответом результат получили со второй попытки. Эти запуски помогли определить обязанности компонентов, а не измерить универсальное преимущество одного интерфейса.
В Hub-режиме закрепили следующие правила:
прогресс передается до появления итогового ответа;
у исследования есть ограничение по времени;
отключение клиента или истечение срока отменяет работу;
частичный ответ не считается завершенным;
ошибка адаптера не запускает новое исследование автоматически.
Для пилота ограничили число одновременных исследований и запретили внутреннему Hermes вызывать собственный hermes_research через Hub.
Состояние задач в этом варианте хранится в памяти. Долговременное хранение и восстановление после перезапуска — отдельный следующий этап.
Так распределилась ответственность: Hermes выполняет исследование, адаптеры передают запрос и результат, а код управления выполнением отвечает за ожидание, отмену и ограничения ресурсов.
Что получилось
За две статьи мы прошли путь от улучшения поиска по Confluence до подключения корпоративных знаний к агентам и доставке этого решения до пользователей. По ходу работы выяснилось, что качества поисковой выдачи недостаточно: нужно учитывать права конкретного сотрудника, добирать доступные документы после фильтрации и правильно обрабатывать длительные исследования, чтобы внешний агент не тратил все свои шаги на ожидание.
В итоге у нас получилось два способа работы с корпоративными знаниями: прямой поиск и исследование через Hermes. При этом правила доступа, работа с Confluence и Jira и логика выполнения остаются внутри наших сервисов. Другим агентам достаточно подключиться к нужному интерфейсу — переносить и заново настраивать всю эту систему для каждого клиента не придется.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.