Шардирование подождёт: что сделать, когда база тормозит
Привет, Хабр! Я Михей, пишу на Go, собираю свои системы и рассказываю, где они ломались, пока не заработали. Сегодня про базу, которую слишком рано записывают в виноватые.
Когда сервис начинает тормозить, у кого-то первая мысль одна: база не вывозит, пора шардировать. Знакомо? А между «тормозит» и «шардируем» на деле лежит несколько шагов, которые стоят заметно дешевле. Про них почему-то вспоминают в последнюю очередь.
Теорию пересказывать не стал. Я прогнал всё на стенде и записал, сколько каждый шаг реально даёт, чтобы ты не гадал. Сначала разберём, что делать заранее, чтобы до беды не дошло. Потом, что делать, если база уже тормозит. Все примеры на PostgreSQL 16, все цифры мои, условия замера описаны рядом. Там, где я что-то не мерил, я так и пишу.
Что внутри
как за пять минут понять, что именно тормозит: один запрос, поток запросов или ожидание;
пять типовых ошибок с ценой в замерах: запросы в цикле, новое соединение на каждый запрос,
COUNT(*)на чтении, вызов внешнего сервиса внутри транзакции, лишний индекс;лестница из семи шагов до шардирования и чек-лист.
1 Сначала диагноз
Фраза «база тормозит» на деле прячет три разные ситуации, и лечатся они по-разному.
Один тяжёлый запрос. Он читает всю таблицу, сортирует на диске или тянет лишнее. Лечится индексом или переписыванием.
Много быстрых запросов. Каждый быстрый, но их тысячи в секунду. Лечится сокращением их числа: кэш, пул соединений, один запрос вместо цикла.
Ожидание. Запросы короткие, но стоят в очереди за блокировкой, а процессор базы почти свободен. Лечится изменением способа обновления данных.
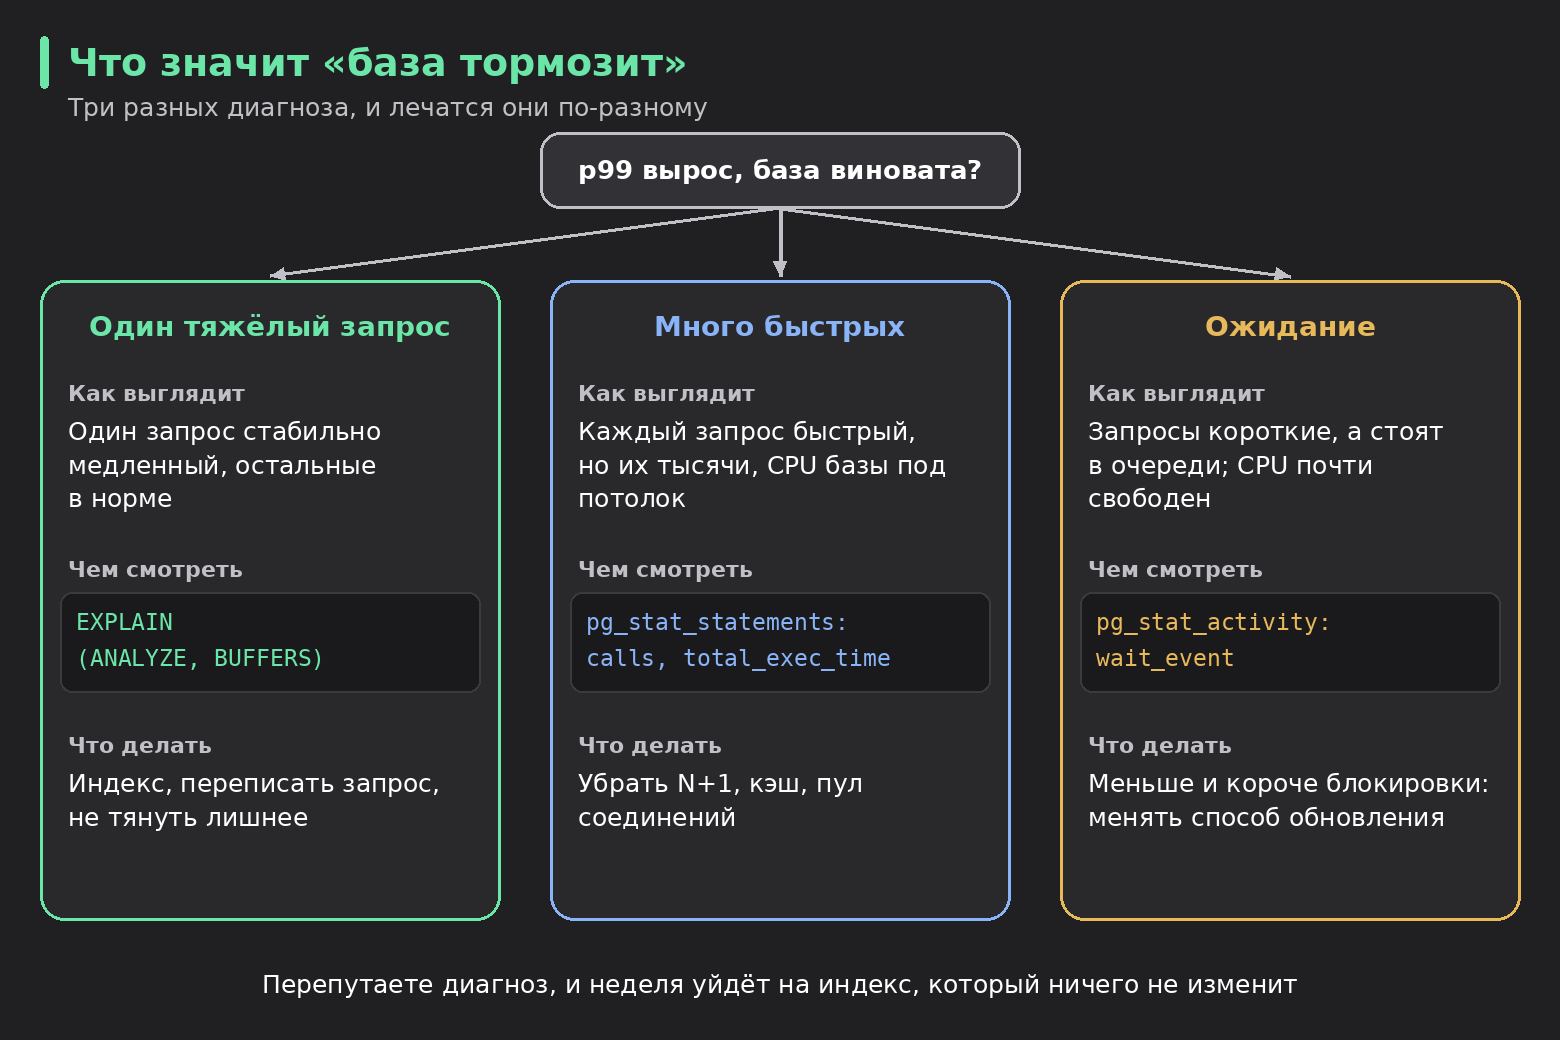
Рис. 1. Три диагноза и чем их отличать друг от друга
Если их спутать, можно неделю делать индекс, который ничего не изменит. Поэтому первый вопрос такой. Сколько запрос длится в приложении и сколько в самой базе? Если разница большая, сначала смотри не только в базу: время могли съесть сеть, пул соединений или очередь внутри приложения.
Давай разберёмся, чем это отличать. Для диагноза хватает трёх инструментов. Тяжёлый запрос показывает EXPLAIN (ANALYZE, BUFFERS). Поток мелких запросов виден в pg_stat_statements, если отсортировать его по числу вызовов и суммарному времени. Ожидание видно в pg_stat_activity, там написано, чего именно ждёт каждая сессия. Готовые запросы для всех трёх случаев лежат под спойлером.
Запросы для диагностики и как включить pg_stat_statements
Расширению нужна библиотека при старте сервера. В postgresql.conf добавь shared_preload_libraries = 'pg_stat_statements', перезапусти сервер и один раз выполни в нужной базе CREATE EXTENSION pg_stat_statements;. Без этих двух шагов запрос ниже упадёт с «relation does not exist».
Топ запросов по суммарному времени:
SELECT calls,
       round(total_exec_time::numeric, 1) AS total_ms,
       round(mean_exec_time::numeric, 2)  AS mean_ms,
       left(query, 60)                    AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
Чего ждут сессии прямо сейчас:
SELECT state, wait_event_type, wait_event, count(*)
FROM pg_stat_activity
WHERE datname = current_database()
GROUP BY 1, 2, 3
ORDER BY 4 DESC;
Кто кого блокирует:
SELECT pid, wait_event_type, wait_event,
       pg_blocking_pids(pid) AS blocked_by, left(query, 45) AS query
FROM pg_stat_activity
WHERE backend_type = 'client backend' AND pid <> pg_backend_pid();
2 Много быстрых запросов: три ошибки, которые дёшево не делать
Запрос в цикле (N+1). Допустим, нужно показать страницу из 100 постов с именем автора у каждого. Самый простой способ достать посты одним запросом, а потом на каждый пост сходить за автором отдельным. Каждый такой запрос мгновенный, в среднем 0,027 мс, и в pg_stat_statements он выглядит безобидно. Но вызовов у него 145 800, а у запроса за постами 1 458. Ровно в сто раз больше. Страница целиком собирается за 16,4 мс. Тот же результат одним JOIN занимает 0,76 мс, это в 22 раза быстрее. Но это на сокете внутри одной машины, где дороги до базы почти нет. Поэтому я повторил замер с базой и клиентом в разных контейнерах и добавил сетевую задержку между ними (она эмулирована, настоящую сеть между серверами я не гонял). Результат такой:
задержка 0,5 мс: цикл 79 мс,
JOIN1,4 мс, разница в 58 раз;задержка 1 мс: цикл 135 мс,
JOIN1,9 мс, разница в 72 раза;задержка 2 мс: цикл 241 мс,
JOIN2,9 мс, разница в 82 раза.
Чем дальше база от приложения, тем сильнее бьёт цикл: каждому из ста дополнительных запросов за авторами достаётся своя дорога туда и обратно, а JOIN платит за неё один раз.
SELECT p.id, p.title, a.name
FROM posts p JOIN authors a ON a.id = p.author_id
WHERE p.id BETWEEN 1000 AND 1099;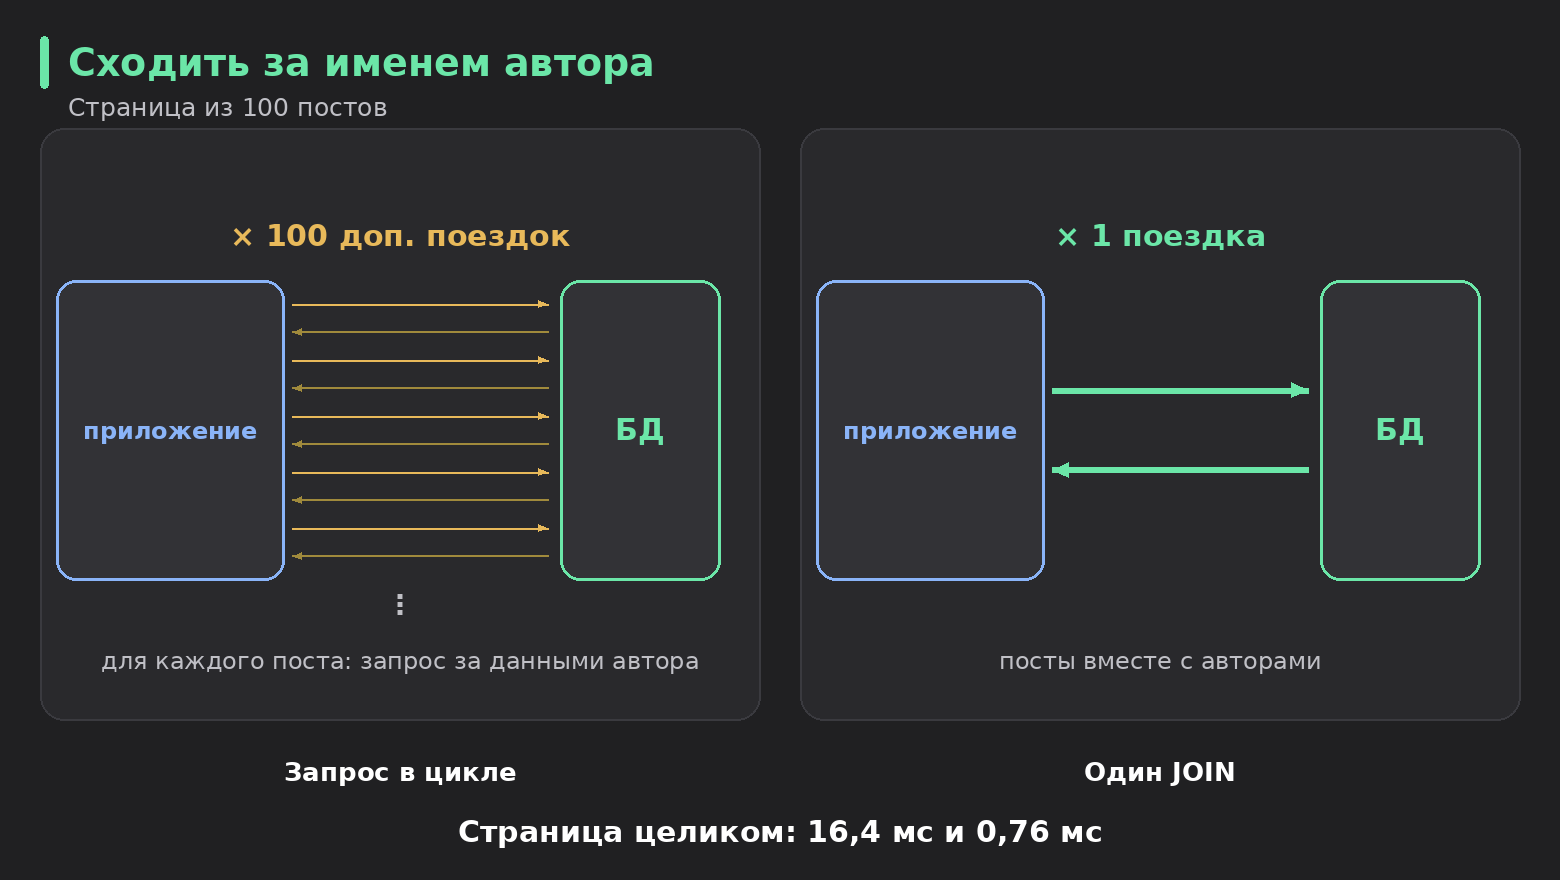
Рис. 2. Сто поездок за одним именем против одной поездки за всей страницей
Новое соединение на каждый запрос. Подключение к PostgreSQL создаёт отдельный процесс на стороне сервера, и это не бесплатно. Я прогнал SELECT 1 на 10 клиентах в двух режимах. Постоянные соединения дали 28 933 запроса в секунду, а соединение на каждый запрос дало всего 337. Это в 86 раз меньше. Средняя задержка 0,35 мс против 29,6 мс. С эмулированной сетью картина та же по смыслу, но цифры другие: при задержке 2 мс постоянные соединения дают 4 561 запрос в секунду, новое соединение на каждый запрос 179. Разница сжимается до 25 раз, потому что теперь и постоянные соединения упираются в сеть. Но и 25 раз за то, что ты просто не держишь пул, это дорого. Лечится пулом соединений в приложении, а при сотнях клиентов имеет смысл поставить перед базой пулер вроде PgBouncer. Я мерил цену самого подключения, а PgBouncer отдельно не гонял.
COUNT(*) на каждом показе. Очень хочется показывать число голосов через SELECT count(*) FROM votes WHERE card_id = .... На десятке голосов этого не видно. Я заполнил таблицу миллионом голосов за одну карточку, и count(*) стал занимать около 52 мс. Получается 19,3 показа в секунду. Если число лежит готовым в карточке, показов 6 393, это в 331 раз больше.
В cards для этого есть колонка votes. Когда приходит голос, база добавляет единицу к готовому числу. На странице карточки читаем уже его, а не считаем миллион строк заново:
UPDATE cards SET votes = votes + 1 WHERE id = 42;Обычно одной строки на карточку хватает. Но если в одну карточку одновременно прилетает очень много голосов, она становится очередью: запись блокирует строку на время обновления. Тогда счётчик можно разложить на несколько строк, как монеты по ячейкам в кассе. Я взял 16 ячеек. Каждый голос попадает в случайную, а на странице мы складываем все 16. Это не единственный правильный размер. Шестнадцати строк уже хватает, чтобы запросы реже сталкивались, а на чтении всё ещё нужно сложить только 16 чисел. На стенде для одной горячей карточки вышло 4 816 голосов в секунду против 1 144 с одним счётчиком, в 4,2 раза больше. Для обычной карточки это не нужно, там готового числа в одной строке достаточно. Зато карточка перестаёт каждый раз пересчитывать миллион голосов, чтобы показать то же число, что и минуту назад)
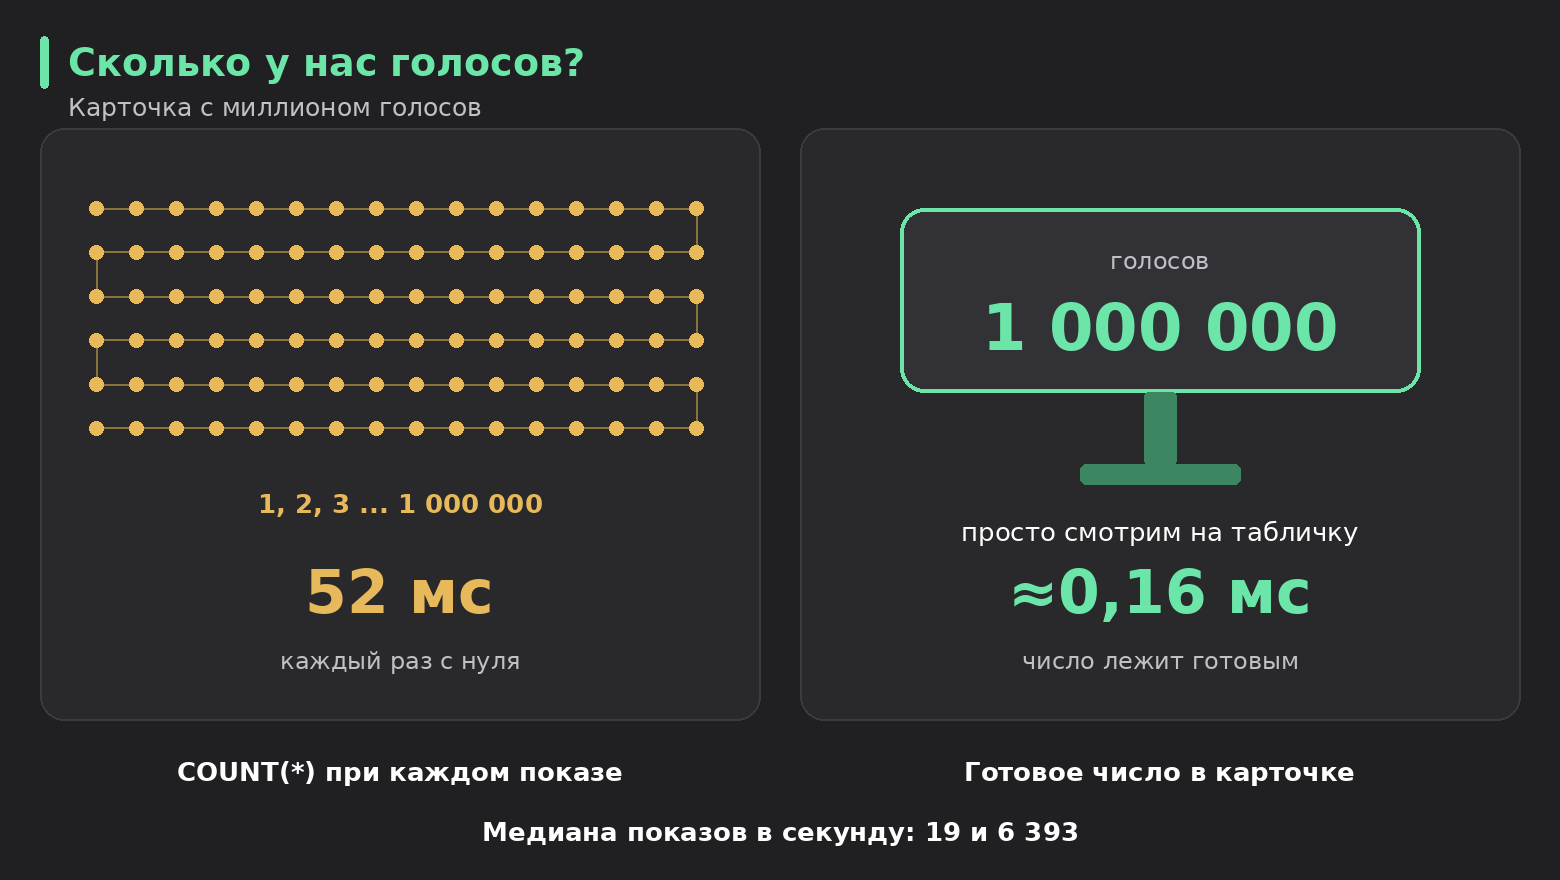
Рис. 3. Пересчитывать каждый раз или смотреть на готовое число
3 Один тяжёлый запрос: индекс и сколько он стоит
Возьмём таблицу votes_log на 2 млн строк (100 МБ) и запрос «голоса за карточку за последние 7 дней». Без индекса Postgres читает всю таблицу. С индексом (card_id, created_at) он сразу идёт к голосам нужной карточки за нужный период.
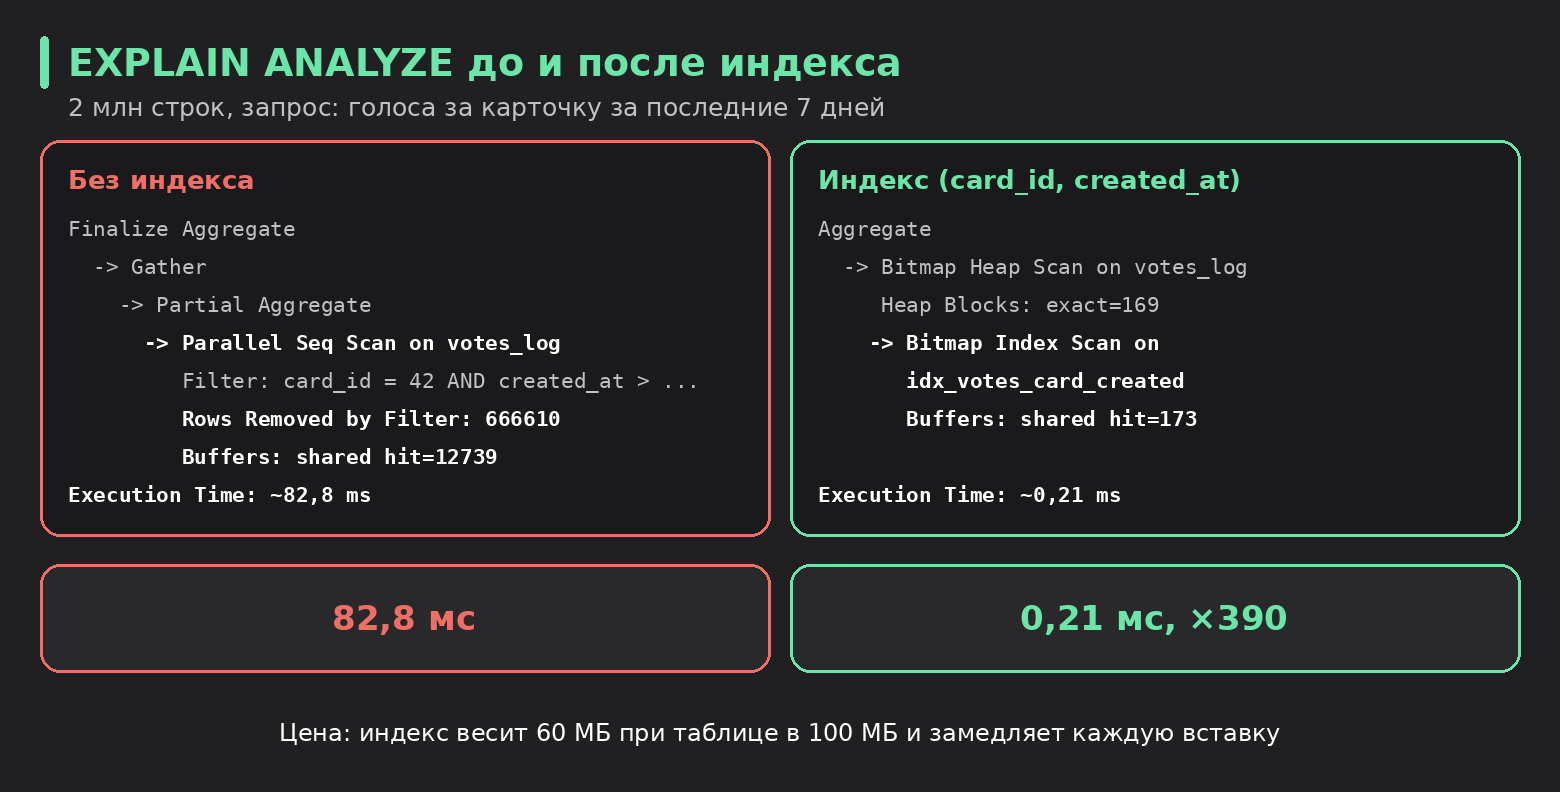
Рис. 4. Один и тот же запрос без индекса и с индексом (медиана из 5 запусков каждого)
Медианы получились 82,8 мс против 0,21 мс, разница примерно в 390 раз. Эту цифру лучше не брать как константу. В другой серии на такой же таблице тот же план с индексом выполнялся за 1,2-1,8 мс, и выигрыш там был примерно в 50 раз. У тебя к тому же другая таблица, другой запрос и другое количество данных в памяти. Надёжно только то, что это десятки миллисекунд против единиц и долей миллисекунды.
Цена у индекса тоже есть. Он весит 60 МБ при таблице в 100 МБ, и каждая вставка обновляет ещё и его. В тесте на 4 клиентах вставка в эту таблицу с индексом получилась медленнее на 2,5-13% (три пары прогонов, по медианам 4 231 против 4 093 вставки в секунду). Для одного индекса это немного. Но если наставить десяток «на всякий случай», почувствуешь и запись, и память. Поэтому я ставлю индекс под запрос, который реально часто выполняется и реально медленный, и сначала смотрю EXPLAIN.
4 Ожидание: блокировки
Самый неприятный случай выглядит так: запросы короткие, процессор базы свободен, а всё стоит. Чаще всего причина в блокировке строки, которую кто-то держит слишком долго. В pg_stat_activity это видно сразу. Одна сессия держит строку, вторая её ждёт.
 pid  | state  | wait_event_type | wait_event    | blocked_by
 6300 | active | Timeout         | PgSleep       | {}
 6307 | active | Lock            | transactionid | {6300}
У ожидающей сессии в wait_event стоит Lock / transactionid, а pg_blocking_pids прямо называет виновника. Теперь смотрим, что виновник делает так долго.
Вызов внешнего сервиса внутри транзакции. Строка блокируется до конца транзакции. Если внутри ещё и поход куда-то на 50 мс (платёжка, почта, другой сервис), все остальные, кому нужна эта строка, встают за тобой в очередь. Я смоделировал это паузой в 50 мс на 50 клиентах и одной горячей строке. Пауза внутри транзакции дала 19 операций в секунду и задержку 2,6 секунды. Та же пауза до транзакции дала 931 операцию в секунду и задержку 54 мс. Разница в 49 раз от одной перестановки строк. Всё медленное и внешнее я делаю до BEGIN или после COMMIT, а внутри оставляю только короткую запись. Обращение к платёжке при этом никуда не делось, оно просто переехало на две строки выше)
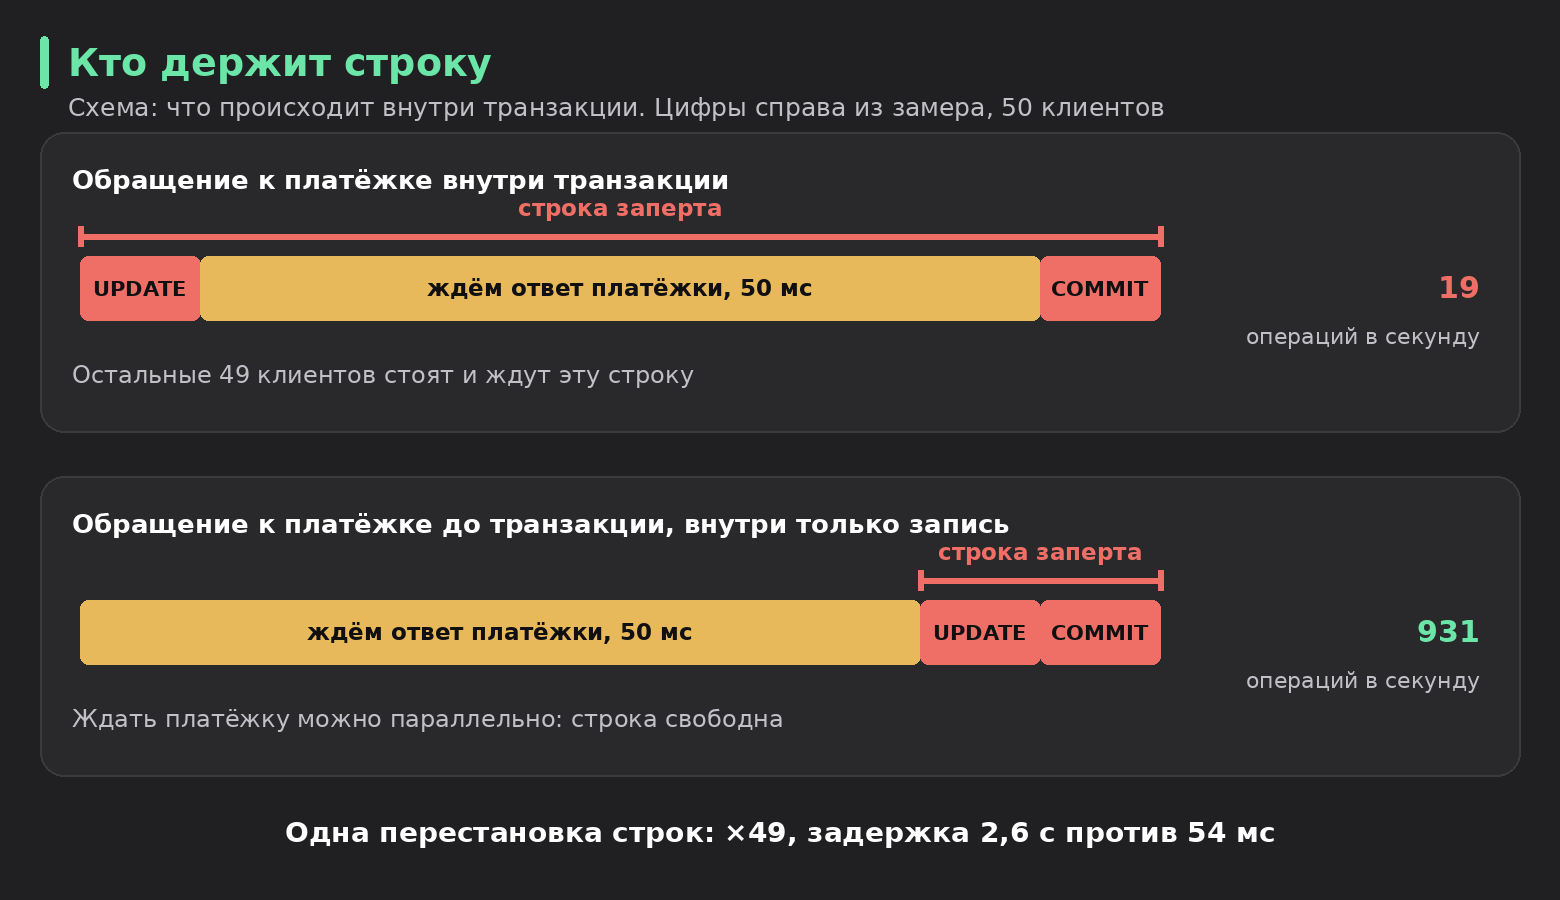
Рис. 5. Пока внутри транзакции идёт обращение к платёжке, строка заперта для всех остальных
5 Когда ничего из этого не помогло
Если ничего из этого не помогло, я иду по лестнице снизу вверх. Каждая ступень дороже предыдущей, и на каждой есть шанс остановиться.
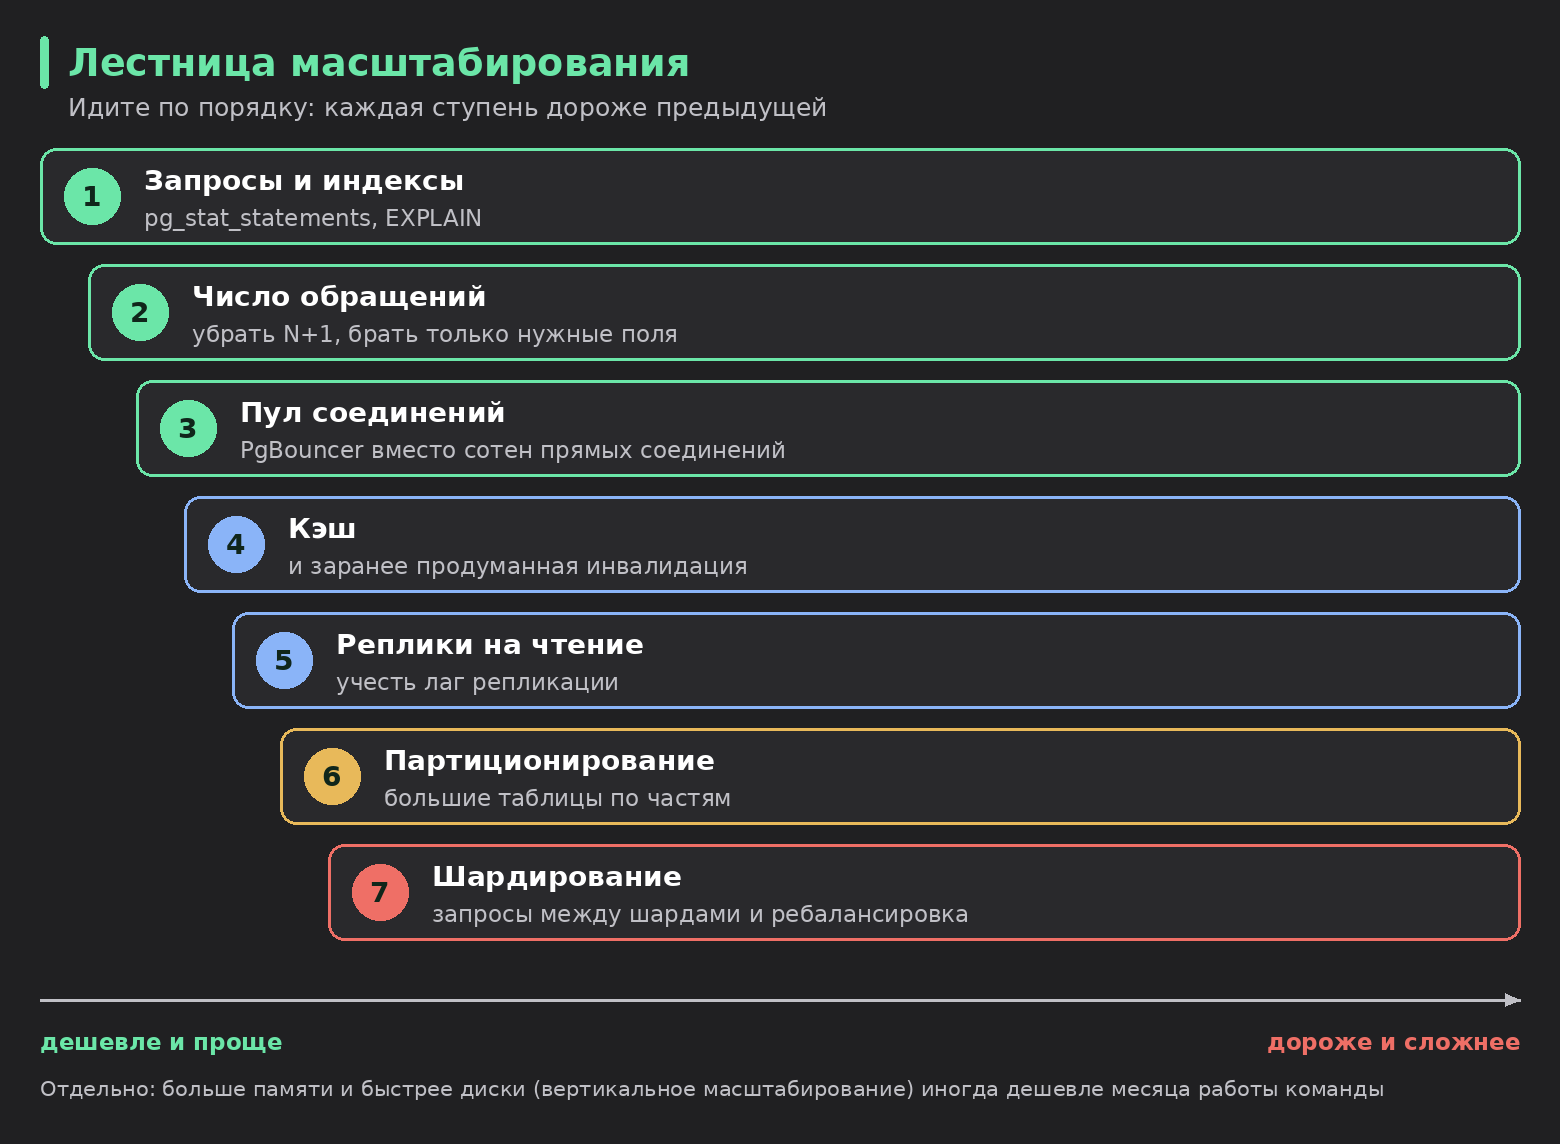
Рис. 6. От дешёвого к дорогому
Две ступени требуют пояснения. Реплики на чтение разгружают основную базу, но у репликации есть лаг (его я не замерял, это известное свойство асинхронной репликации). Пользователь только что записал данные и не видит их на следующей странице. Шардирование снимает предел одной машины, но приносит запросы между шардами, сложные транзакции и ребалансировку при росте. Дёшево оно не бывает. Отдельно стоит вертикальное масштабирование. Больше памяти и быстрее диски иногда обходятся дешевле месяца работы команды над архитектурой.
Кэш, реплики, партиционирование и шардирование я здесь специально не разбирал. Это уже отдельные решения с другими компромиссами и проверками. Поэтому разберу их отдельно в рамках следующих статей: когда они действительно нужны, как их выбирать и на что смотреть до запуска.
6 Типовые ошибки
Индекс на каждое поле. На рис. 4 индекс дал ускорение на порядки, но весит 60% размера таблицы и замедлил вставки на единицы процентов (до 13% в худшем прогоне). Лишние индексы занимают память и тормозят запись.
Внешний вызов внутри транзакции. Одна перестановка строк дала разницу в 49 раз.
COUNT(*)на каждом показе. На миллионе голосов один подсчёт занял около 52 мс. Храни готовое число и обновляй его при голосе.Шардирование раньше времени. Сначала пройди дешёвые ступени лестницы.
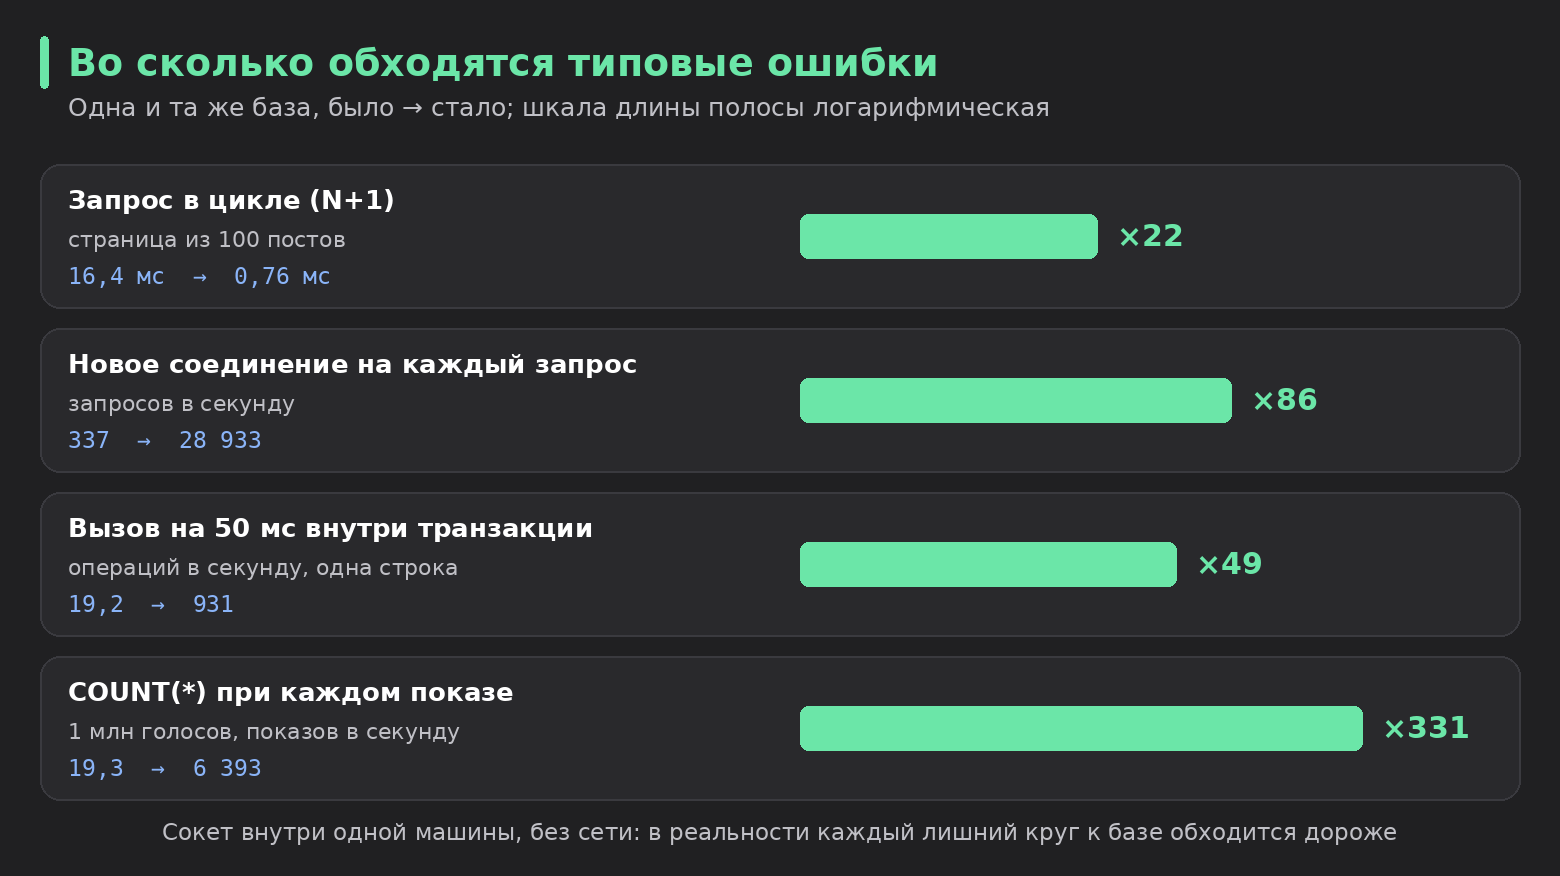
Рис. 7. Было и стало на одной и той же базе; сокет внутри одной машины, без сети (в сети разрыв у цикла и соединений другой, цифры в тексте)
7 Чек-лист
Чтобы до беды не дошло:
Если на странице есть связные данные, доставай их одним запросом через
JOIN, а не отдельным запросом для каждой строки.Держи пул соединений и не подключайся на каждый запрос.
Всё медленное и внешнее делай вне транзакции.
Ставь индексы под реальные медленные запросы и проверяй их через
EXPLAIN.Не считай
COUNT(*)на каждом показе, храни готовое число.
Если база уже тормозит:
Сравни время запроса в приложении и в базе.
Открой
pg_stat_statementsи посмотри, что вызывается чаще всего и что съело больше всего времени.На подозрительном запросе запусти
EXPLAIN (ANALYZE, BUFFERS).Если запросы быстрые, а ответ медленный, смотри
pg_stat_activityиpg_blocking_pids.После каждой ступени из 5 главы снова замерь время ответа и проверь исходную причину: тяжёлый запрос, число запросов или ожидание. Если проблема остаётся, переходи к следующей ступени.
8 Итоги
«Тормозит» это три разных диагноза, и начинать нужно с правильного. Большинство проблем из этой статьи лечится привычками. Один запрос вместо цикла, короткая транзакция, индекс под конкретный запрос и готовое число вместо пересчёта. Шардирование стоит в самом конце лестницы.
Всё это часть моего пути: собираю системы, проверяю, экспериментирую и записываю выводы. Остальным я делюсь так же на своем сайте: https://miheev.su
А как у вас? Какую из этих ошибок встречали в продакшене и чем это закончилось? Расскажите в комментариях.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.