19-е место в RSNA Knee Abnormality Detection: дистилляция ансамбля, MedSAM-кропы и LLM-разметка
Это перевод нашего райтапа решения, занявшего 19-е место в соревновании RSNA Knee Abnormality Detection на Kaggle. Оригинал: 19th Place Solution.
Про соревнования я пишу в Telegram-канале Pseudolabeling: там можно найти разборы и заметки, которые не попадают в большие статьи.
Часть Yuto и Shin
Дистилляция ансамбля в одну модель
Мотивация
Наш ранний внутренний ансамбль объединял несколько семейств 5-фолдовых моделей, включая ConvNeXt, CoAtNet и ResNet-GRU. Его инференс занимал около 7 часов, что почти не оставляло места в 9-часовом лимите, чтобы объединить его с другими сильными, но тяжёлыми моделями, такими как ветка global/local с наведением через MedSAM. Я хотел сжать знания этого ансамбля в одну лёгкую модель.
Метод
Учитель. Out-of-fold предсказания раннего ансамбля на всех обучающих исследованиях. Каждое исследование предсказывалось только моделями, которые не видели его при обучении, поэтому мягкие таргеты не допускали утечки обучающих меток.
Таргеты. Смесь 50/50 вероятностных меток, полученных с помощью LLM (из радиологических заключений), и out-of-fold вероятностей учителя.
Модель. ConvNeXt-Tiny, предобученный на ImageNet-22k, с головой slice-attention.
Вход: поле зрения 140 мм, приведённое к размеру 384 px.
Окна: 8 окон, сэмплируемых на серию при обучении, 16 — при инференсе.
Данные: обучена один раз на всех не-Gold исследованиях. 58 Gold-исследований были отложены.
Обучение. 32 эпохи, EMA весов, попарный ранжирующий лосс, добавленный к BCE, и раздельные learning rate для бэкбона и головы.
Результаты
Модель | Public LB | Private LB | Время инференса |
|---|---|---|---|
Учитель (ранний ансамбль) | 0.961 | 0.948 | ~7 ч |
Дистиллированная одиночная модель | 0.962 | 0.951 | ~0.5 ч |
Одиночный ученик превзошёл своего учителя на обоих лидербордах, затрачивая примерно одну пятнадцатую времени инференса. Именно сэкономленное время сделало возможным финальный ансамбль в пределах лимита.
Обучение большего числа учеников по тому же рецепту и их усреднение (6 или 12 моделей) дало практически те же скоры (0.962 public / 0.952 private), так что одной модели было достаточно.
Блендинг трёх финальных моделей
Что мы сравнивали
Мы блендили три модели с разными индуктивными смещениями, предварительно преобразовав предсказания каждой модели в ранги по каждой находке. Мы сравнили три способа выбора весов бленда:
Фиксированные веса. Один набор весов, общий для всех 12 находок. Мы попробовали четыре варианта.
Веса по находкам, оптимизированные на Gold. Для каждой находки — поиск по сетке весов, максимизирующих AUC на Gold-наборе.
Шринкаж к равным весам. Для каждой находки:
w = a · w_gold + (1 − a) · w_equal, гдеa = n / (n + k)n— меньшее из числа положительных и отрицательных примеров этой находки в Gold-наборе, поэтому редкие находки сильнее притягиваются к равным весам.k = 29было выбрано с помощью повторных разбиений Gold-набора на две части: веса подбирались на одной половине и оценивались на другой.
Результаты
Блендинг | Веса (модель 1 / 2 / 3) | Gold | Public LB | Private LB |
|---|---|---|---|---|
Фиксированные (наш финальный сабмит) | 0.40 / 0.35 / 0.25 | 0.9496 | 0.965 | 0.955 |
Фиксированные | 0.50 / 0.30 / 0.20 | 0.9493 | 0.966 | 0.955 |
Фиксированные | 0.30 / 0.35 / 0.35 | 0.9508 | 0.965 | 0.954 |
Фиксированные (равные) | по 1/3 | 0.9508 | 0.965 | 0.954 |
Шринкаж (k = 29) | по находкам | 0.9533 (split-half CV 0.9496) | 0.964 | 0.954 |
Оптимизированные на Gold | по находкам | 0.9586 (split-half CV 0.9462) | 0.963 | 0.954 |
Наблюдения
Выбор фиксированных весов почти не имел значения. Разные фиксированные веса сдвигали private LB не более чем на 0.001. Больший вес для сильнейшей одиночной модели улучшал public-скор, но не private.
Подгонка под Gold-набор не переносилась. Чем точнее веса были подогнаны под Gold-набор, тем выше был скор на Gold и тем ниже — на public. Веса по находкам, подогнанные напрямую под Gold-набор, показали лучший результат на Gold и худший на public LB, а split-half CV уже показывала, что они работают хуже фиксированных весов.
Шринкаж был безопасен, но не лучше. Он убрал бо́льшую часть переобучения и сравнялся с фиксированными весами, не превзойдя их.
Gold не позволял ранжировать стратегии блендинга. При 58 исследованиях Gold-набор не мог надёжно различить эти стратегии. Поэтому мы использовали фиксированные веса и, как и в части shin0000, в итоге доверились public-лидерборду при финальном выборе.
Благодарности
Я хотел бы поблагодарить shin0000, с которым мы около месяца работали на пределе сил с общей целью — выиграть золотую медаль в этом соревновании. Без его прорыва с глобальными и локальными моделями с наведением через MedSAM мы бы не дошли до золотой зоны.
Я также благодарен Ogurtsov, Pizzaboi и Ignat, которые присоединились к нам через слияние команд в середине соревнования. Их ранние эксперименты и их метки, полученные с помощью LLM, во многом повлияли на наши результаты.
Объединение глобального и локального видов с помощью MedSAM
Мотивация
Я объединил модель, которая улавливает широкий контекст колена, со специализированными моделями, которые изучают меньшие, релевантные для находок области. Цель состояла в том, чтобы сохранить локальные детали, которые могут становиться менее заметными, когда полное изображение уменьшается.
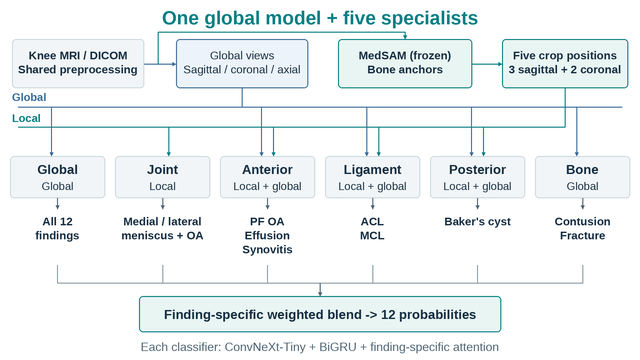
Я использовал замороженную предобученную модель MedSAM, чтобы оценивать анатомический якорь для кропа. Я не дообучал MedSAM и не просил её сегментировать сами патологии. Финальная ветка состояла из одной глобальной модели и пяти специалистов под конкретные находки и сама по себе достигала 0.964 public / 0.953 private LB.
Схема из шести моделей

Рисунок 1. Ветки, использующие только глобальный вид, обходят MedSAM. Остальные специалисты используют локальные кропы, а там, где указано, — и глобальные виды.
Кропы с наведением через MedSAM
Я нормализовал порядок срезов и интенсивности и представил поле зрения 160 мм как изображение 576 × 576. Для каждой сагиттальной или корональной серии MedSAM сегментировала её средний срез. Верхняя граница наибольшей компоненты маски кости давала якорь, от которого я размещал кропы с фиксированными относительными смещениями.
Каждый локальный кроп имел размер 288 × 288 пикселей, примерно 80 мм в поперечнике. Было три сагиттальные позиции — центральная, передняя и задняя — и две корональные позиции, сторона A и сторона B. Координаты переиспользовались для всех срезов в серии и для всех соответствующих специалистов. Нестабильная маска включала фиксированный запасной якорь, а области за пределами кадра дополнялись нулями.
Не предполагалось, что стороны A/B последовательно соответствуют медиальной/латеральной. Названия сагиттальных передней/задней позиций аналогично описывают эвристику в координатах изображения, а не индивидуально проверенную анатомическую ориентацию в каждом случае.
Реальные примеры кропов
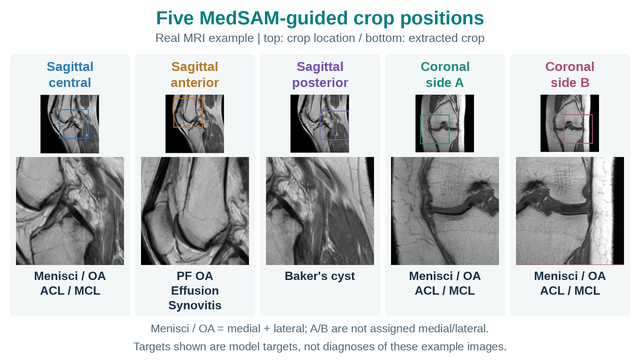
Рисунок 2. Пять позиций локальных кропов и целевые находки моделей-специалистов, которые их используют. Для каждой позиции показаны исходное изображение и извлечённый кроп. Позиции кропов переиспользуются разными моделями; находки — это таргеты моделей, а не диагностическая разметка этих изображений-примеров.
Входы моделей и целевые находки
Система состояла из одной глобальной модели, предсказывающей все 12 находок, и пяти специалистов, покрывающих отдельные группы находок, как показано выше. Некоторые специалисты объединяли локальные кропы с глобальными видами, а специалист по костям использовал только глобальные виды.
Модель и обучение
Все шесть моделей использовали независимо инициализированные бэкбоны ConvNeXt-Tiny, предобученные на ImageNet, остаточные двунаправленные GRU для последовательности срезов и attention, специфичный для каждой находки. Я обучал на всех 4 349 не-Gold исследованиях. Gold58 был исключён из градиентных обновлений, но использовался для выбора модели.
При обучении я сэмплировал 16 срезов на серию; при инференсе я использовал все реальные срезы каждой допущенной серии.
Блендинг по находкам и разработка на Gold
Я блендил предсказания глобальной модели и соответствующего специалиста с отдельным коэффициентом для каждой находки:
prediction = (1 - w) × global_prediction + w × specialist_prediction
Вместо того чтобы использовать равный бленд для каждой находки, я подстраивал коэффициенты по Gold-набору, размеченному врачами. Для релиза, обученного на всех данных, я сохранил коэффициенты, выбранные для более ранней ветки Fold0, не оптимизируя их заново.
Соревнование оценивает предсказания по меткам находок, присвоенным врачами, а не по уникальной метке, идеально отражающей лежащую в основе медицинскую истину. Моим намерением при обращении к Gold было согласовать комбинацию разных видов моделей с критериями чтения, отражёнными в этих оценочных метках.
Это не утверждение, что метки Gold были неверными, и не доказательство того, что задуманное согласование было достигнуто. Gold58 использовался и для выбора модели, и для подбора весов, поэтому я рассматривал его как обратную связь при разработке, а не как независимое свидетельство уровня CV/теста. Имея всего 58 исследований, я не мог установить, обобщаются ли выбранные веса или просто переобучены на этом маленьком наборе. Для финального выбора конфигурации я в итоге применил подход «доверяй public LB».
Взаимодополняемость глобальных предсказаний и предсказаний специалистов
Следующие сабмиты использовали одни и те же веса моделей Fulltrain6. «Только специалисты» означает пять моделей, покрывающих 12 находок, а не одну модель-специалиста.
Конфигурация | Public LB | Private LB |
|---|---|---|
Только глобальная модель | 0.960 | 0.951 |
Только пять специалистов | 0.959 | 0.948 |
Бленд глобальной модели и специалистов по находкам | 0.964 | 0.953 |
Бленд превзошёл каждую из веток по отдельности и на public, и на private LB, что указывает на взаимодополняемость широкого контекста и видов специалистов.
Часть финальных сабмитов от Ogurtsov, Pizzaboi и Ignat
Метки
Мы использовали среднее двух прогонов разметки Astra: первый с использованием DICOM + заключения, второй — только DICOM. Sol 6.1 работает существенно хуже, как и разметка с Opus только по заключениям. Мы не пробовали режим «только заключения» с Sol 6.1 или Astra.
Мы подавали каждое исследование свежему агенту. Метапромпт:
Read list of StudyInstanceUID's from [samples_list_full.csv](labelling/samples_list_full.csv). Skip StudyInstanceUID's already found in [labelling/astra_12classes_v01/out/](labelling/astra_12classes_v01/out/).
For each StudyInstanceUID spawn fresh agent with the same level of reasoning (GPT-6 Astra Medium) and feed it with prompt from [prompt_dicom_report_12classes_v01_astra.md](labelling/prompts_sol/prompt_dicom_report_12classes_v01_astra.md); substitute placeholder {StudyInstanceUID} with actual StudyInstanceUID. When agents have completed their work, print summary about created labels.
Сам промпт prompt_dicom_report_12classes_v01_astra.md простой:
You are a musculoskeletal radiologist encoding knee MRI reports into structured labels.

Make conclusions about presence of 12 possible findings: ACL tear, MCL tear, medial meniscus tear, lateral meniscus tear, medial compartment osteoarthritis, lateral compartment osteoarthritis, patellofemoral compartment osteoarthritis, joint effusion, synovitis, Baker (popliteal) cyst, bone contusion and acute fracture.

Read the report from `labelling/reports/{StudyInstanceUID}.json`. Also read DICOM from `data/train_series/{StudyInstanceUID}`. Select optimal projections and mode (Fluid_Sensitive and Fat_Suppression - check it in [train_series.csv](data/train_series.csv)) for investigation. Ground your decision on evidences from both report and DICOM data.

Follow these definitions:

{DEFINITIONS FROM https://www.kaggle.com/competitions/rsna-knee-abnormality-detection/discussion/733343}

Always output probability (0.00-1.00); use the full range, do not output only 0 or 1. Save results to `labelling/astra_12classes_v01/out/{StudyInstanceUID}.json` as {"StudyInstanceUID": , "ACL":, "MCL":, "Medial Meniscus":, "Lateral Meniscus":, "Medial OA":, "Lateral OA":, "PF OA":, "Effusion": , "Synovitis":, "Baker's": , "Contusion": , "Fracture": }. Do NOT open any other file or run any additional command.
Перевод промпта
Ты — радиолог-специалист по опорно-двигательному аппарату, кодирующий заключения МРТ колена в структурированные метки.
Сделай выводы о наличии 12 возможных находок: разрыв ПКС (ACL), разрыв МКС (MCL), разрыв медиального мениска, разрыв латерального мениска, остеоартрит медиального отдела, остеоартрит латерального отдела, остеоартрит пателлофеморального отдела, суставной выпот, синовит, киста Бейкера (подколенная), ушиб кости и острый перелом.
Прочитай заключение из labelling/reports/{StudyInstanceUID}.json. Также прочитай DICOM из data/train_series/{StudyInstanceUID}. Выбери оптимальные проекции и режим (Fluid_Sensitive и Fat_Suppression — проверь их в train_series.csv) для исследования. Основывай решение на свидетельствах как из заключения, так и из DICOM-данных.
Следуй этим определениям:
{ОПРЕДЕЛЕНИЯ ИЗ https://www.kaggle.com/competitions/rsna-knee-abnormality-detection/discussion/733343}
Всегда выводи вероятность (0.00–1.00); используй весь диапазон, не выводи только 0 или 1. Сохрани результаты в labelling/astra_12classes_v01/out/{StudyInstanceUID}.json в виде {…}. НЕ открывай никакие другие файлы и не запускай никаких дополнительных команд.
440 спорных случаев Lateral OA были переразмечены с более развёрнутым промптом, но мы не можем измерить реальный эффект этого изменения.
BA440-C512-WS1: обучение и инференс
Эта модель была частью второго по качеству (не победного) сабмита.
Бэкбон. CoAtNet-2 (timm coatnet_rmlp_2_rw_384.sw_in12k_ft_in1k) на 512 px с окнами из одного среза и головой attention-MIL, обученный на 5 фолдах на метках BA440. Public/private LB 0.960/0.948 (равное среднее 5 фолдов). Рецепт основан на публичном ноутбуке dreaddevelopment для двенадцати находок. Геометрия корпуса следует публичному ноутбуку «Raptor» 0.949. Более сложные архитектуры, такие как бэкбон из 3 веток с независимыми весами для каждой плоскости или добавление attention-весов по плоскостям, не улучшили скор. Меньшие модели, такие как ConvNeXT-T или ConvNeXT-S, давали нам более низкие скоры (около −0.002 и на OOF, и на LB).
Корпус dread_v5_512_d96n (строится из DICOM; один и тот же код работает при обучении и в кернеле)
Каждое исследование превращается в 96 строк в 5 слотах: сагиттальная fluid-sensitive — 26, сагиттальная прочая — 22, корональная fluid-sensitive — 18, корональная прочая — 12, аксиальная — 18. Каждый слот берёт одну серию, выбранную по плоскости и флагу fluid-sensitive, с фолбэком на любую серию этой плоскости. Отсутствующий слот остаётся пустым и маскируется.
Срезы сортируются по положению вдоль нормали к срезу. Срезы слота берутся через linspace по 2–98 % стека.
Шаги обработки пикселей: modality LUT, инверсия MONOCHROME1, окно по 2/98-перцентилям для каждой серии, центральный кроп 140 мм по собственному PixelSpacing каждого среза, затем один ресайз INTER_AREA до 512. Хранится как uint8.
Всё лежит в одном memmap размером 4407 × 96 × 512 × 512.
Модель
Каждое окно — это один срез с 1 входным каналом. Первая свёртка пересобрана под 1 канал суммированием предобученных RGB-фильтров. Нормализация использует среднее от ImageNet-средних и std.
Бэкбон эмбеддит каждое окно независимо. Затем следует LayerNorm, потом attention по окнам для каждого класса (Linear 256 → tanh → dropout 0.2 → Linear 12, softmax по окнам). Каждый класс получает свой собственный пулированный признак и свой собственный линейный выход, поэтому голова выдаёт 12 логитов.
Обучение (на фолд, около 5.3 ч на одной RTX 5090)
5 фолдов на фиксированном случайном разбиении: 3525 train / 882 held out. Мягкие таргеты BA440 (0, 1) подаются напрямую в BCEWithLogits с
pos_weightпо распространённости; они не бинаризуются.На каждом шаге сэмплируется K = 12 случайных окон на исследование. Шаг покрывает 8 исследований (2 × 4 с аккумуляцией градиента 2). Более высокие значения K, вплоть до 32, улучшают скор для маленьких моделей, но не оказывают эффекта или оказывают небольшой отрицательный эффект для модели CoAtNet.
Оптимизатор и расписание: AdamW с LR 3e-5 для бэкбона и 1e-3 для головы, wd 0.02, OneCycle с 15 % warm-up, 24 эпохи, bf16, grad clip 3.0, gradient checkpointing, аугментация усилением интенсивности ±10 %, seed 42.
Вспомогательный лосс: SIGReg (регуляризатор изотропной гауссианы из LeJEPA), вес 0.02, применяемый через 256-мерный MLP-проектор на эмбеддингах окон. Проектор отбрасывается после обучения. Эффект этого вспомогательного лосса нестабилен между разными архитектурами моделей: похоже, он улучшает скор для ConvNeXT-T, тогда как для модели CoAtNet его эффект нейтрален.
Финальные веса — это SWA (простое среднее) эпох 21–23.
Инференс (Kaggle, 2×T4)
Тестовый DICOM проходит через тот же построитель корпуса. Используется каждое окно из одного среза, до 96 на исследование (настройка «kall»). Каждая из 5 SWA-моделей фолдов работает в fp16 на чанках по 16 окон, при этом фолды распределены по обоим GPU. Выходы сигмоиды усредняются с равным весом по фолдам. Без TTA.
Локальные скоры и скоры на public LB (5-fold OOF macro-AUC)
B384 → 512 px, окна из 3 срезов RGB → окна из 1 среза с 1 каналом (по сравнению с CoAtNet-384 с окнами из 3 срезов; те же метки, по 5 фолдов в каждом случае)
BA440 proxy 0.9747 → 0.9748, +0.0002 (незначимо).
Gold58 0.9283 → 0.9345, +0.006 (незначимо).
Public 0.958 → 0.960.
Авторы
Ogurtsov — ogurtsov
Pizzaboi — asimandia
Ignat — ignatgotin
shin0000 — shin0000
yuto083 — yuto0712
Если вам интересна тема соревнований и разборы решений с Kaggle, подписывайтесь на мой Telegram-канал t.me/pseudolabeling. Вопросы по решению можно задать в комментариях здесь или там.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.