Индекс поисковика Brave — отдельный вход в ответы нейросетей: как за несколько минут проверить, есть ли в нём ваш сайт
Индекс поисковика Brave — отдельный вход в ответы нескольких нейросетей: Brave продаёт доступ к нему ИИ-компаниям и сам называет Perplexity среди клиентов. Если страница не выходит в Brave Search, этим сервисам её взять неоткуда, и в их ответы она может не попасть, как бы хорошо ни стояла в Google и Яндексе. В замерах видимости в ответах ИИ-моделей я сохраняю, на какие источники Perplexity ссылается в каждом ответе, и эти логи удобно сверять с выдачей Brave. Сама проверка занимает несколько минут: одну страницу смотрят вручную, список — запросом к Brave Search API.
Что за индекс Brave и почему его покупают ИИ-компании
Индекс Brave — собственная база страниц поисковика Brave Search. Доступ к нему Brave продаёт через Search API: программа отправляет поисковый запрос и получает выдачу в формате JSON. ИИ-сервису такая выдача нужна для grounding, то есть опоры ответа на найденные страницы: сервис ищет страницы по вопросу пользователя и строит ответ по ним вдобавок к тому, что ИИ-модель знает сама. Размер индекса Brave называет сам: в августе 2026 года это было больше 40 млрд страниц, независимого подсчёта нет.
2 ноября 2026 года New York Times подала иск против Brave. Газета утверждает, что Brave копировал контент издателей и продавал его ИИ-компаниям, в том числе как данные для grounding. Это утверждения истца, решения суда нет.
Берёт ли Perplexity источники из индекса Brave
Точно известно одно: Brave сам называет Perplexity среди клиентов. На странице About компания пишет, что Search API используют Cohere, Mistral, Perplexity и You.com, цитату приводит No Hacks. В иске NYT названы пять ИИ-компаний, которым Brave якобы поставляет данные: Anthropic, Perplexity, Mistral, xAI и Cohere; ни одна из них не ответчик. Подтверждений от самих Perplexity, Mistral и Cohere в открытых источниках нет. Поэтому формулировка осторожная: страница, которой нет в Brave, может не попасть в ответы этих сервисов.
Свою нишу можно проверить самому: собрать ссылки-источники из ответов Perplexity на вопросы ваших клиентов и прогнать их через site: в Brave Search или скриптом с API. Совпадение с Brave ничего не докажет, ту же страницу мог найти и другой поисковик. Зато видно, есть ли в Brave ваши страницы рядом с теми, на которые Perplexity уже ссылается. Какие поисковики стоят за разными нейросетями, я разбирал отдельно: Claude, ChatGPT и Алиса AI берут источники из разных поисковиков.
Как найти свою страницу в Brave Search вручную
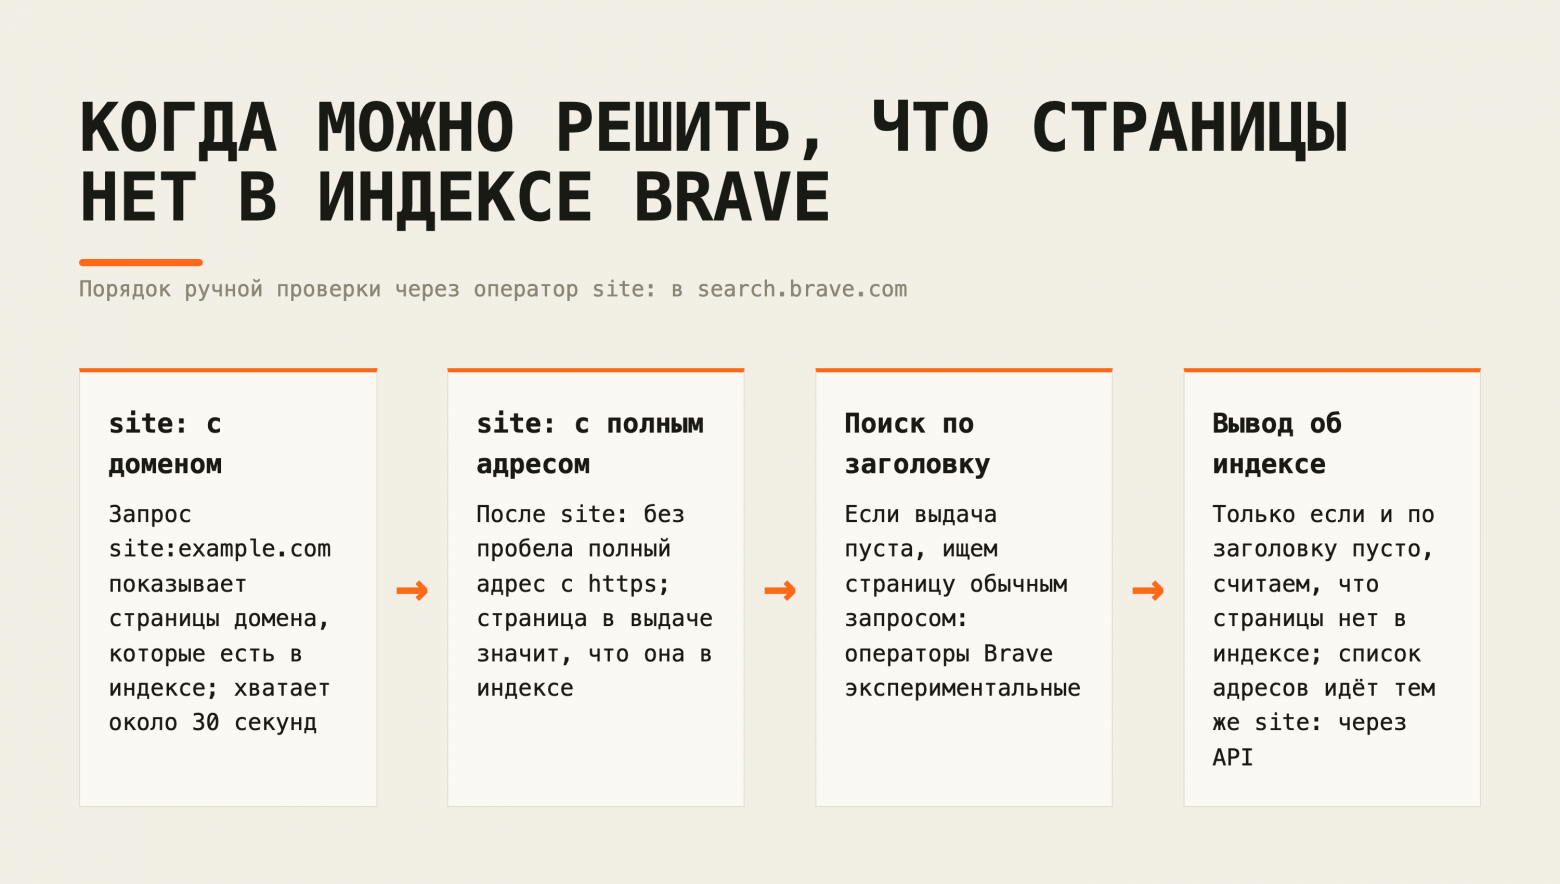
Вручную страницу ищут в search.brave.com оператором site: с адресом:
Запрос
site:example.comпоказывает страницы домена, которые есть в индексе, тот самый, что продаёт Brave. На это уходит около 30 секунд.Для одной страницы после site: без пробела ставят полный адрес с https, как в адресной строке:
site:https://example.com/blog/page/. Страница в выдаче — значит, она в индексе (Lab Leaders).Поддомены
site:example.comохватывает все сразу. Чтобы смотреть один, пишутsite:blog.example.com(документация Brave).Описание под ссылкой стоит прочитать. Brave может показывать сохранённую копию: автор разбора Search Engine Journal нашёл свой сайт с описанием главной, которое сам поменял за несколько часов до этого.
Пустая выдача — ещё не приговор: документация Brave называет операторы поиска экспериментальными. Прежде чем решить, что страницы нет, поищите её обычным запросом по заголовку.
Brave Search API проверяет список страниц по одному запросу на адрес
Для списка удобнее Brave Search API: скрипт отправляет на каждый адрес запрос site: и смотрит, вернулась ли страница. Запрос web search — GET на https://api.search.brave.com/res/v1/web/search с параметром q, ключ передают в заголовке X-Subscription-Token. Оператор site: пишут прямо внутри q, отдельного параметра для него нет (документация).
С февраля 2026 года тариф Search стоит $5 за 1000 запросов. Отдельного бесплатного тарифа нет, зато в каждый план входят бесплатные кредиты на $5 в месяц, это примерно 1000 запросов. Условие у кредитов одно: указать Brave Search API как источник на своём сайте или в разделе о проекте. Сайт на 300 страниц — 300 запросов, так что небольшой сайт укладывается в бесплатные кредиты с запасом.
import os, sys, time
import requests

ENDPOINT = "https://api.search.brave.com/res/v1/web/search"
KEY = os.environ["BRAVE_API_KEY"]
PAUSE = 1.1  # секунд между запросами, с запасом

def norm(url):
    return url.split("#")[0].rstrip("/")

def in_brave(page_url):
    r = requests.get(
        ENDPOINT,
        params={"q": f"site:{page_url}"},
        headers={"X-Subscription-Token": KEY, "Accept": "application/json"},
        timeout=20,
    )
    r.raise_for_status()
    results = r.json().get("web", {}).get("results", [])
    return any(norm(x.get("url", "")) == norm(page_url) for x in results)

for line in open(sys.argv[1], encoding="utf-8"):
    page = line.strip()
    if page:
        status = "есть" if in_brave(page) else "нет в выдаче"
        print(f"{status}\t{page}")
        time.sleep(PAUSE)
Сохраните код в файл, а адреса страниц — в текстовый файл: один полный адрес с https на строку. Ключ доступа выдаёт кабинет Brave Search API. Перед запуском в том же окне терминала запишите ключ в переменную окружения BRAVE_API_KEY: это именованная настройка, из которой скрипт берёт ключ, чтобы он не лежал в самом коде. Запускают скрипт обычной командой для программ на Python, а после имени файла со скриптом через пробел пишут путь к файлу со списком адресов: скрипт сам прочитает его, больше ничего вводить не нужно. Библиотеку requests нужно установить заранее. Скрипт сравнивает адреса строго и отбрасывает только якорь и слэш в конце. Если Brave хранит страницу под другим адресом, она получит статус нет в выдаче: такие строки стоит открыть вручную. Статус назван осторожно, потому что операторы у Brave экспериментальные и пустой ответ ещё не значит, что страницы нет в индексе. Пауза в 1,1 секунды поставлена с запасом; если API начнёт отвечать ошибкой, увеличьте её.
Почему Brave Search не находит страницу сайта
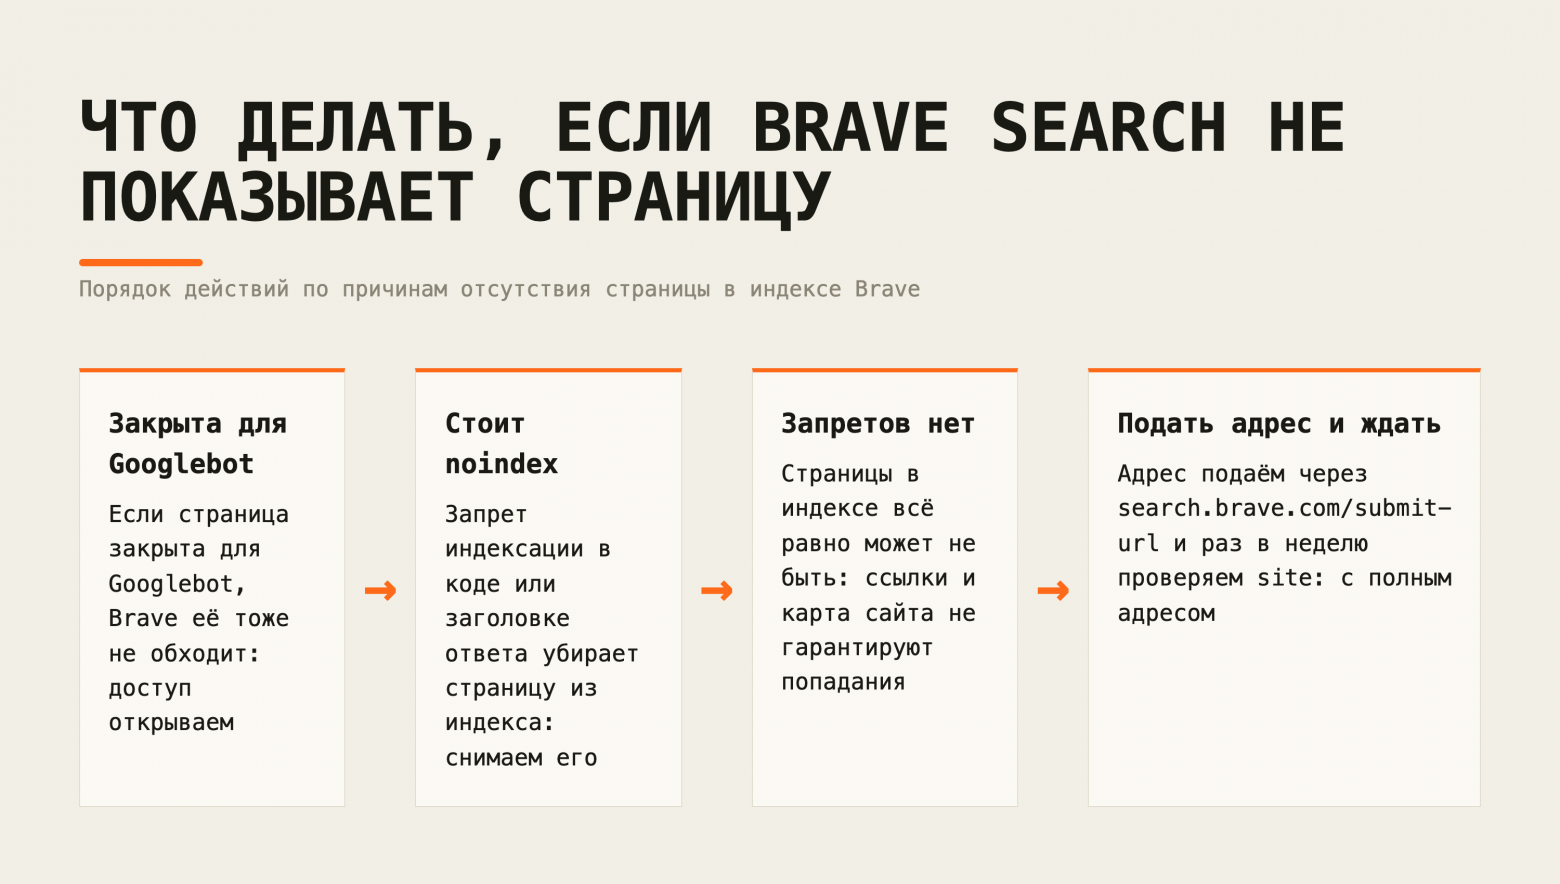
Первое, что стоит проверить, — закрыта ли страница для Google. У робота Brave нет собственного имени в правилах доступа, по которому его можно отличить от других, и если страница закрыта для Googlebot, Brave её тоже не обходит. Отдельное правило для Brave в robots.txt не написать: имени у робота нет. Из индекса Brave страницу убирает запрет индексации noindex, который стоит в коде страницы или в заголовке ответа сервера; robots.txt он для этого не использует. Так что список проверок тот же, что для Google: запреты в robots.txt и noindex на нужных страницах.
Если запретов нет, страницы в индексе всё равно может не оказаться. Краулер Brave частично питается данными пользователей браузера Brave, которые включили Web Discovery Project, а по умолчанию эта опция выключена. Ссылки и карта сайта попадания в индекс не гарантируют: у Lab Leaders на 31 августа 2026 года в индексе было 35 адресов из 143, всего 24%, хотя ссылки на страницы были, а карта сайта отдавалась. Для сайта со ссылками и картой сайта это неожиданно мало.
Как добавить страницу в индекс Brave, если её там нет
Сначала снимают причину: закрытие для Googlebot или noindex. Потом подают адреса через форму search.brave.com/submit-url. В справке Brave она упомянута для повторного обхода и удаления страниц. Lab Leaders по своей практике пишет, что форма бесплатная, работает без регистрации и ставит адреса в очередь на обход; подавать советуют по одному адресу страницы. В документации Brave про приём новых адресов такого нет.
В кейсе Lab Leaders индексация за десять недель выросла с 24% до 99% адресов, на 9 ноября это 295 из 299. Адреса подавали через форму и каждую неделю сверяли индекс. Контрольной группы не было, поэтому сколько дала подача, а сколько пришло бы само, неизвестно.
Что в этих данных неточно. Открытых замеров того, насколько полно Brave покрывает русскоязычные сайты, нет, а кейс с ростом до 99% — один сайт. Связь Perplexity, Mistral и Cohere с Brave держится на словах самого Brave и на иске NYT, и у этих сервисов могут быть другие поставщики поиска.
Проверять сайт только в Яндексе и Google уже мало: индекс Brave стал отдельным входом в ответы нескольких нейросетей, и его надо проверять так же, как привычные поисковики. Если сайта нет в Brave, никакая работа над текстами не поможет попасть в ответы, которые строятся на этом индексе.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.