Как Claude переписывал веса медицинской модели. Справился. Но градиент не хуже
2 ноября MIT выложили пост о том, что LLM может взять веса чужой модели, понять, что там происходит, и поправить их. Без обучения. На GitHub сразу появились повторы эксперимента: Qwen, мини игры Atari, клеточные автоматы. Я продакт в RnD MedTech, так что мне конечно захотелось попробовать на медицинской модели. Получилось. Вообще круто. Но другие подходы сработали не хуже.
Скрытый текст
Коротко
Взяла открытую модель, которая оценивает, ломает ли мутация работу гена. На такие оценки опираются генетические лаборатории. Дала Claude Opus 5.5 задачу улучшить её, не обучая.
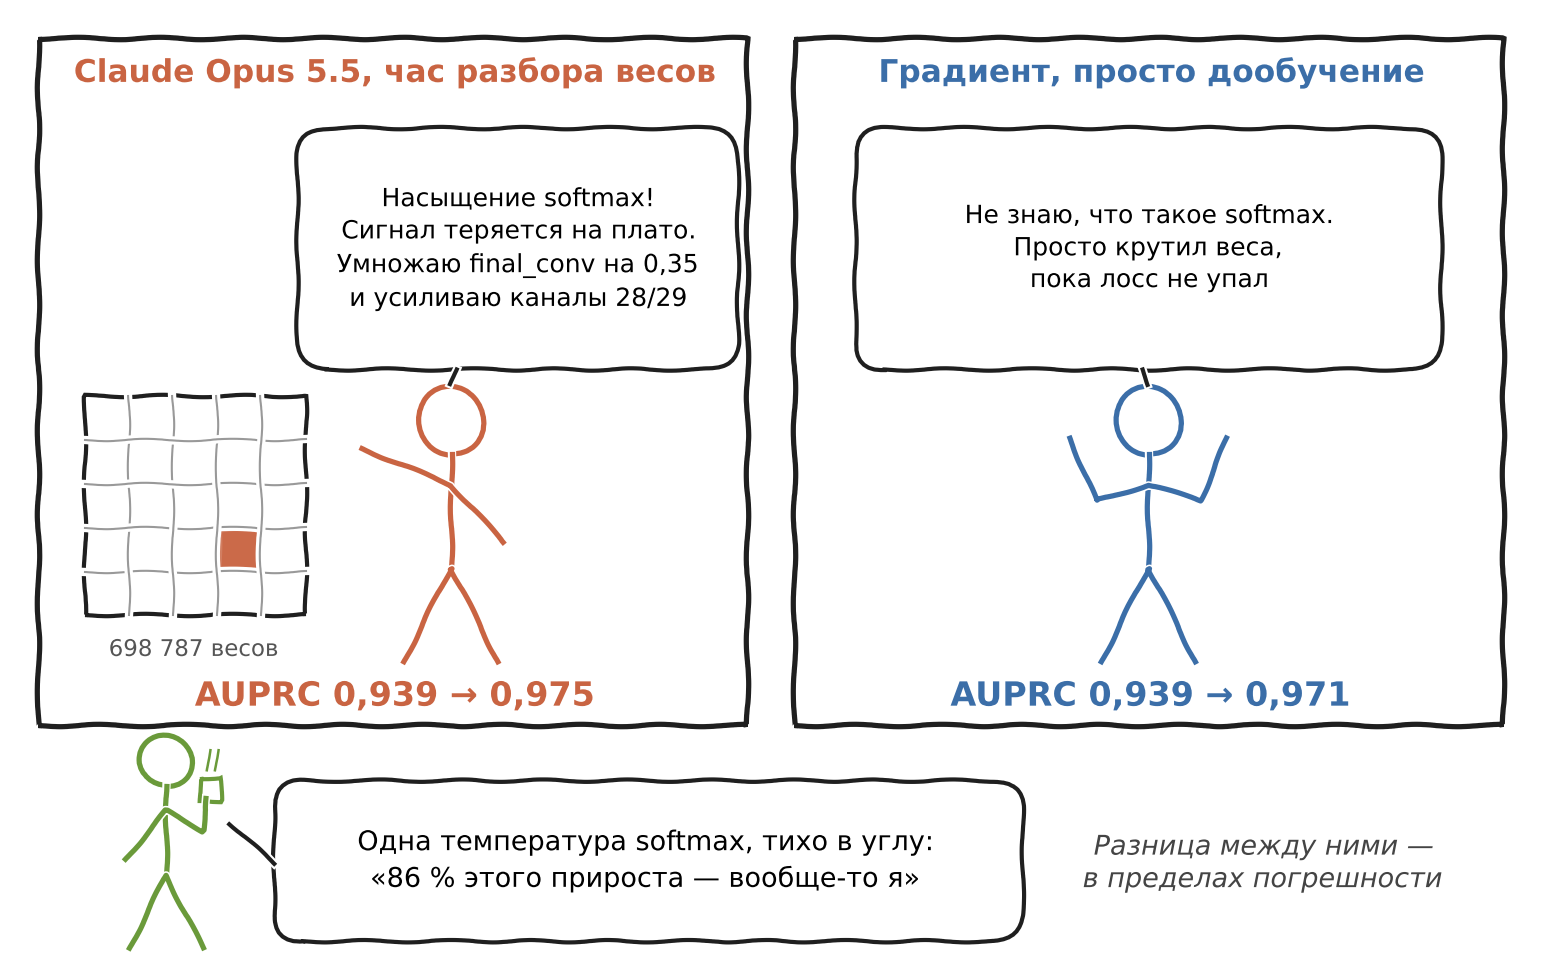
За час с небольшим Claude поменял 165 весов из почти 700 тысяч. На данных, которых он не видел, модель стала находить 90 % опасных мутаций вместо 76 % при том же числе false positive.
Почти весь прирост дала одна простая настройка. Ценным оказалась не правка, а объяснение, почему модель теряла сигнал.
Обычное дообучение тех же весов дало практически тот же результат.
Что придумали в MIT
В публикации Sparks of Weight-Space Programming исследователи дают Astra файл с весами и просят либо рассказать, что сеть делает, либо изменить её поведение. Без обучения, только чтение и правки. Самый громкий результат — маленькая Qwen на школьной математике: было 7,9 % верных ответов, стало 48,1 %.
Повторений уже около десятка, и почти везде всплывает одна деталь. Если у исходной Qwen просто выключить режим рассуждений, она сама даёт около 46 %. То есть правка в основном убирает зацикливание, а не учит модель математике
Почему модель из генетики
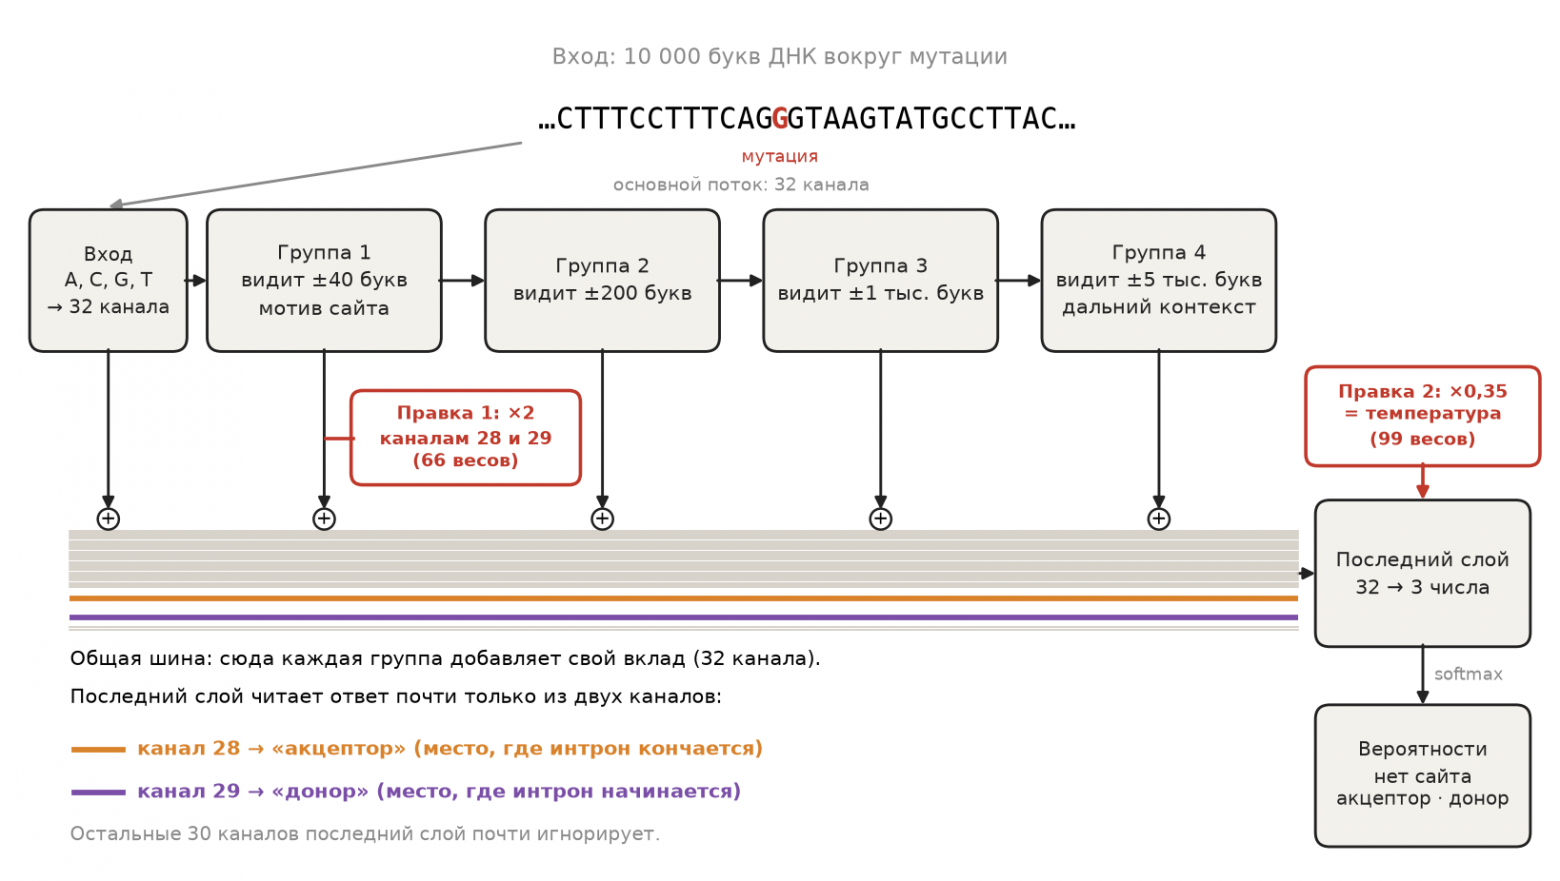
Я взяла OpenSpliceAI. Это открытая версия SpliceAI — сетки, которая смотрит на участок ДНК и говорит, где ген «разрезается» при сборке белка (это называется сплайсинг). Чтобы оценить мутацию, модель запускают дважды, на исходной и на изменённой ДНК, и смотрят, насколько поменялся ответ.
Этот скор прямо используют в международных рекомендациях по классификации мутаций (ClinGen). Ну то есть это не просто научная игрушка. От неё зависит, что напишут в заключениях реальных генетических лабораторий.
Оригинальные веса SpliceAI под некоммерческой лицензией (да, я правильная, смотрю лицензии), а у OpenSpliceAI лицензия открытая. К тому же модель маленькая, 699 тысяч параметров, и работает на ноутбуке без GPU. Выбирала по принципу «что-то простое, с инференсом на CPU».
Как проверяла
Я взяла мутации из открытой базы ClinVar, там уже есть разметка опасные/безвредные. Задача Claude — чтобы модель лучше их различала.
Скрытый тест. Claude видел мутации с одних хромосом, а проверяла я на других, которых он не видел.
Страховка. Правка не должна ломать основную работу модели. Если та проседает, правка не засчитывается.
Правила. Нельзя обучать модель и перебирать значения автоматически. Можно всё остальное: писать код, запускать модель, смотреть, что происходит внутри. Мне не нужно доказывать, что LLM «чувствует» веса без инструментов. Мне нужно понять, есть ли профит от этого для прикладной разработки
Что нашел Claude
Самое интересное в отчете Claude — не правки, а разбор сети.
Модель очень уверена в настоящих «точках разреза»: вероятность около 0,99. Опасная мутация заметно снижает эту уверенность внутри сети. Но наружу это почти не доходит: на вероятность 0,99 даже сильный удар влияет мало, кривая там плоская.
уверенность внутри сети | вероятность на выходе | что видит скор | |
|---|---|---|---|
исходная модель | было 7, стало 4 | 0,999 → 0,982 | почти ничего (0,017) |
после правки | было 2,45, стало 1,40 | 0,92 → 0,80 | заметный сдвиг (0,118) |
Модель знает, что сайт поврежден, а итоговый скор этого не показывает. Лечится температурой softmax. Claude умножил последний слой на 0,35 и вдвое усилил сигнал от участка ДНК рядом с точкой разреза. Всего две правки.
Результат
На скрытом тесте качество выросло: AUPRC 0,939 → 0,975. Модель стала находить 90 % опасных мутаций вместо 76 % при том же проценте FP. Прирост устойчивый и держится даже на хромосоме, которую модель не видела в обучении
Но 86 % прироста дала одна температура. Проверила, нашёл бы ее простой перебор: лучшее значение при переборе оказалось тамже, где остановился Claude.
А если просто дообучить?
Это тоже стало любопытно проверить
Способ | AUPRC на тесте |
|---|---|
исходная модель | 0,939 |
ансамбль из пяти копий модели | 0,953 |
дообучение градиентом тех же весов | 0,970–0,971 |
правка Claude | 0,975 |
Разница между Claude и дообучением — в пределах статистической погрешности. Градиент смягчил выход примерно так же. Ансамбль Claude обошел. Ансамбль с той же температурой я не проверяла, это уже совсем лень стало
Кто победил
По метрике — ничья. Тот же результат можно получить без LLM, обычным дообучением или перебором одного числа.
По пониманию — Claude. Градиент выдаёт новые веса, но не говорит, почему они лучше. Claude за час показал, что ломает скор и в каком месте сети это чинится. Справедливости ради, такую гипотезу опытный инженер проверил бы и сам. Для меня это аргумент за Claude как инструмент отладки моделей. Но аргумент на одном случае, а не доказательство.
Нового навыка нет. Как и у MIT, правка убирает помеху, а не учит. Мутации, которые модель в принципе не умеет распознавать, она по-прежнему пропускает.
Комментарии для летящих камней
Один эксперимент. Одна модель, один запуск Claude. Это короткий эксперимент, а не доказательство, что такой подход стоит применять всем.
Шкала уехала. После правки вероятности стали другими, и клинические пороги для модели больше не работают. Например, при строгом пороге 0,8 она находит 15 % опасных мутаций вместо 49 %. Перед любым практическим применением её пришлось бы заново калибровать и проверять.
Трюк не универсальный. Температура сработала только потому, что скор этой модели — разница двух вероятностей. У обычного классификатора она ничего бы не изменила. Переносится сам приём: прочитать, как сеть принимает решение, и найти, где теряется сигнал.
Метки не идеальны. Часть классификаций в ClinVar сама опиралась на SpliceAI.
Код, данные, все таблицы и как повторить: github.com/KristinaMruts/weight-space-programming-spliceai
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.