Как я создал свою IDE за месяц с помощью ИИ
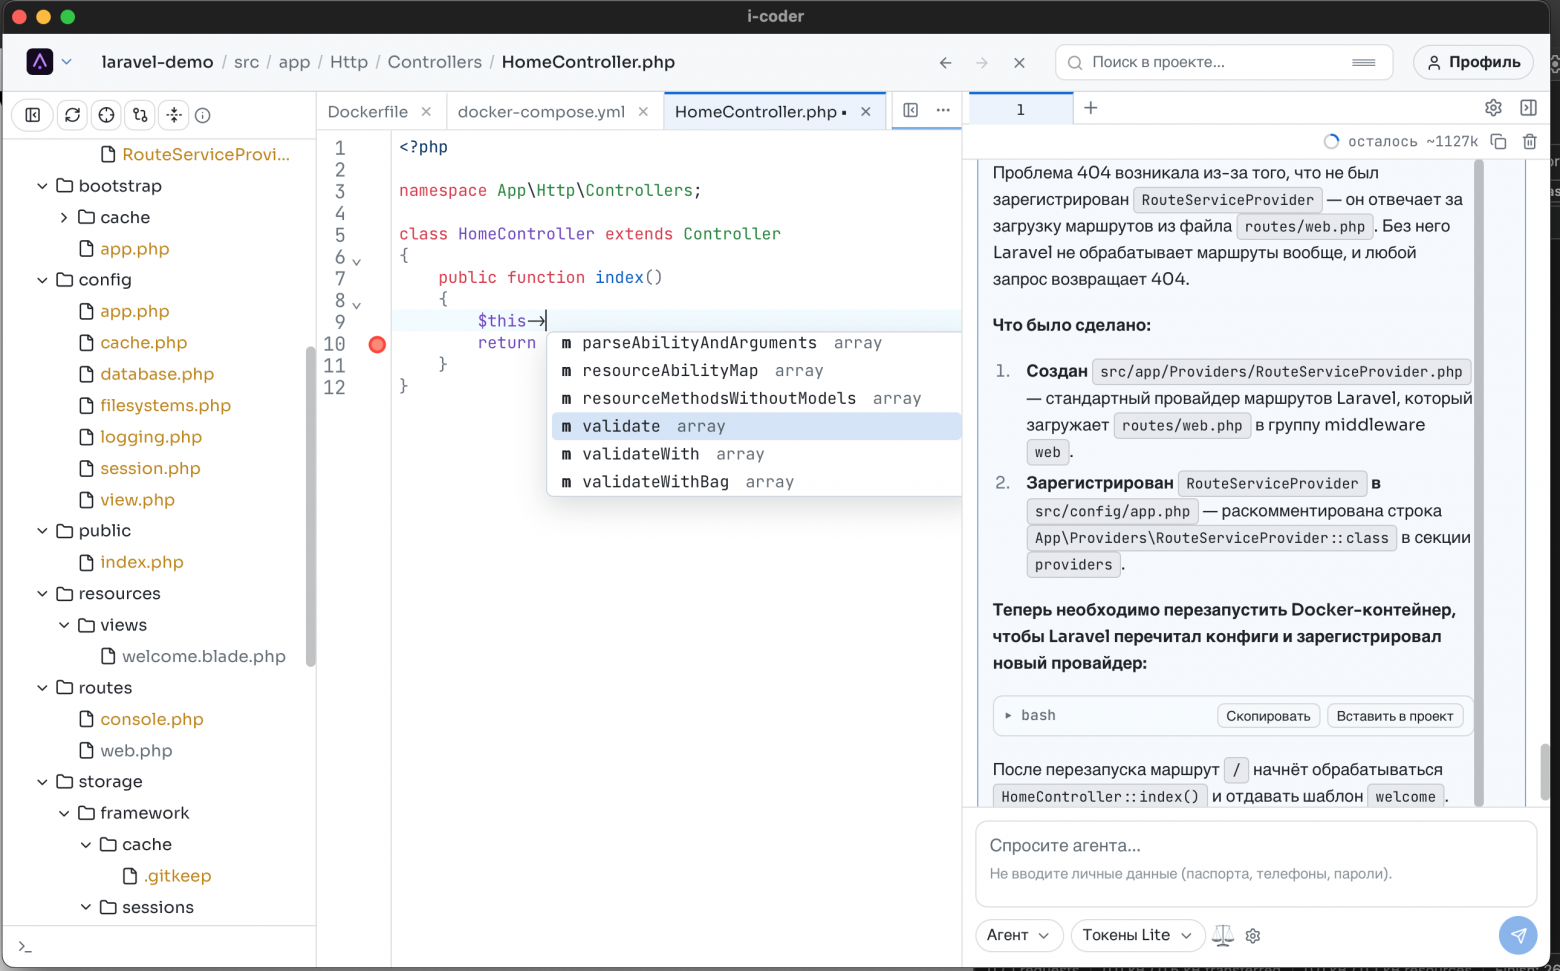
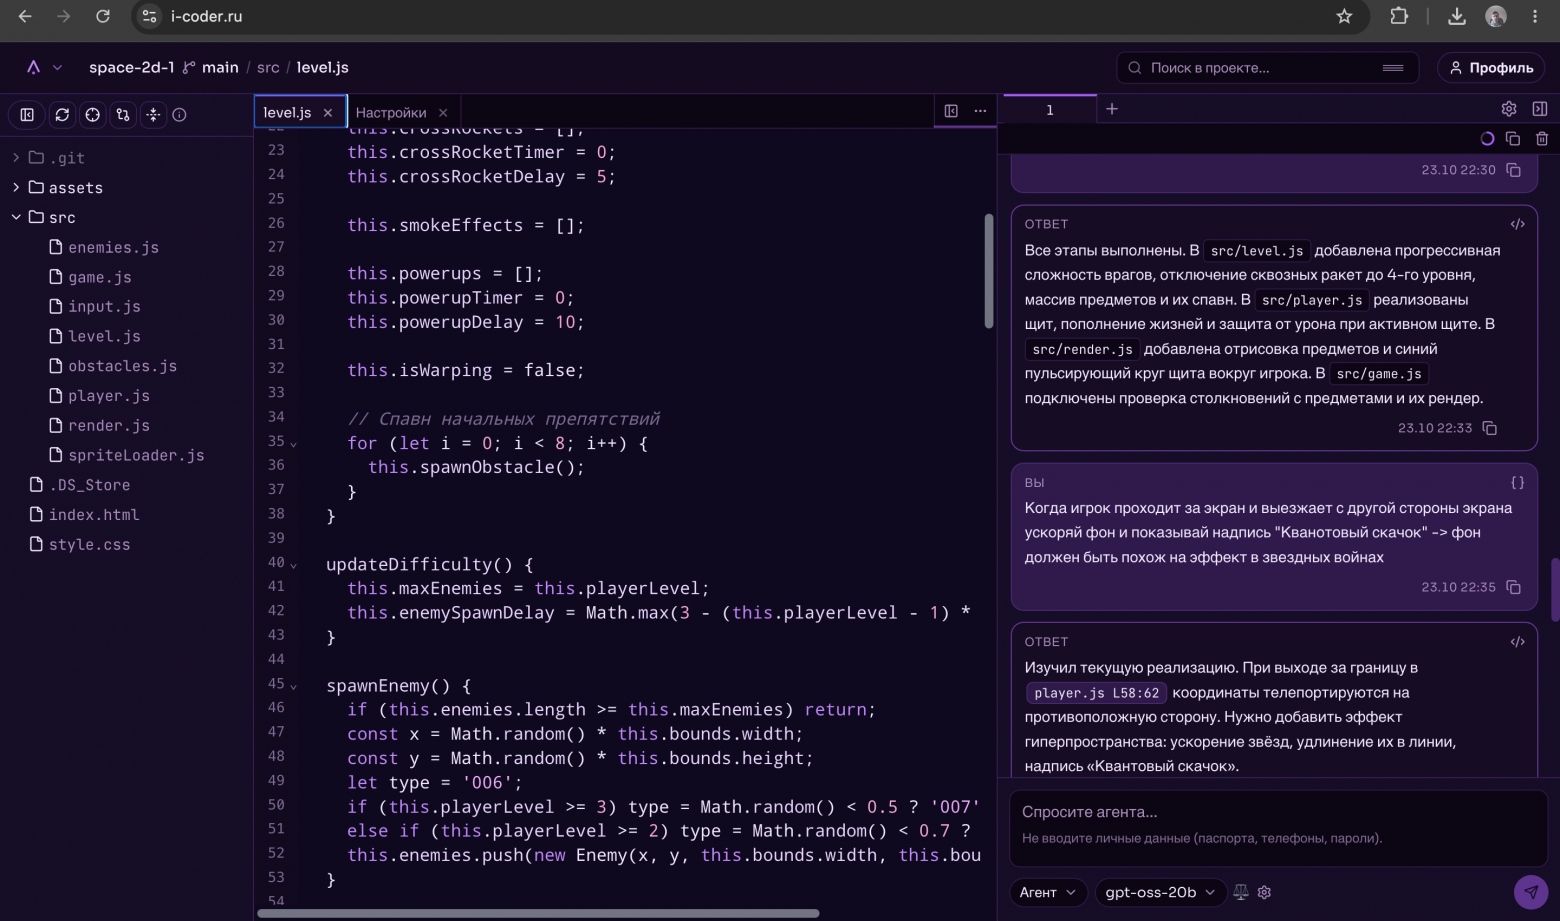
За месяц собрал свою IDE. Она работает в браузере и как десктопное приложение. Ниже расскажу, зачем это понадобилось, как устроен клиентский протокол общения с моделью и чем браузер отличается от десктопа.
Сначала это был просто инструмент для себя, но постепенно IDE переросла в желание сделать из неё полноценный проект. В конце порассуждаю, есть ли у такой IDE смысл в наше интересное время.
Зачем это понадобилось
В последнее время код всё чаще пишется автоматически, но ручные проверки никуда не делись. Несмотря на обилие инструментов и ограниченные ресурсы, за качеством кода приходится следить вручную. Большую часть времени я не пишу код, а читаю его и провожу ревью. Под эту работу мне не хватало некоторых удобств, которые я не смог получить в существующих популярных инструментах.
Чего мне не хватало во всех IDE?
На удивление, мне не хватало обычного compare view (diff merge viewer), чтобы увидеть изменения в коде. Например, в GitLab мы можем удобно увидеть изменения в MR, а в других IDE всё как‑то очень сложно. Поэтому только ради этой фичи мне пришлось делать свою IDE. Я просто перенёс дизайн из GitLab и немного его улучшил и упростил. При этом скорость загрузки для огромных diff‑ов — моментальная.
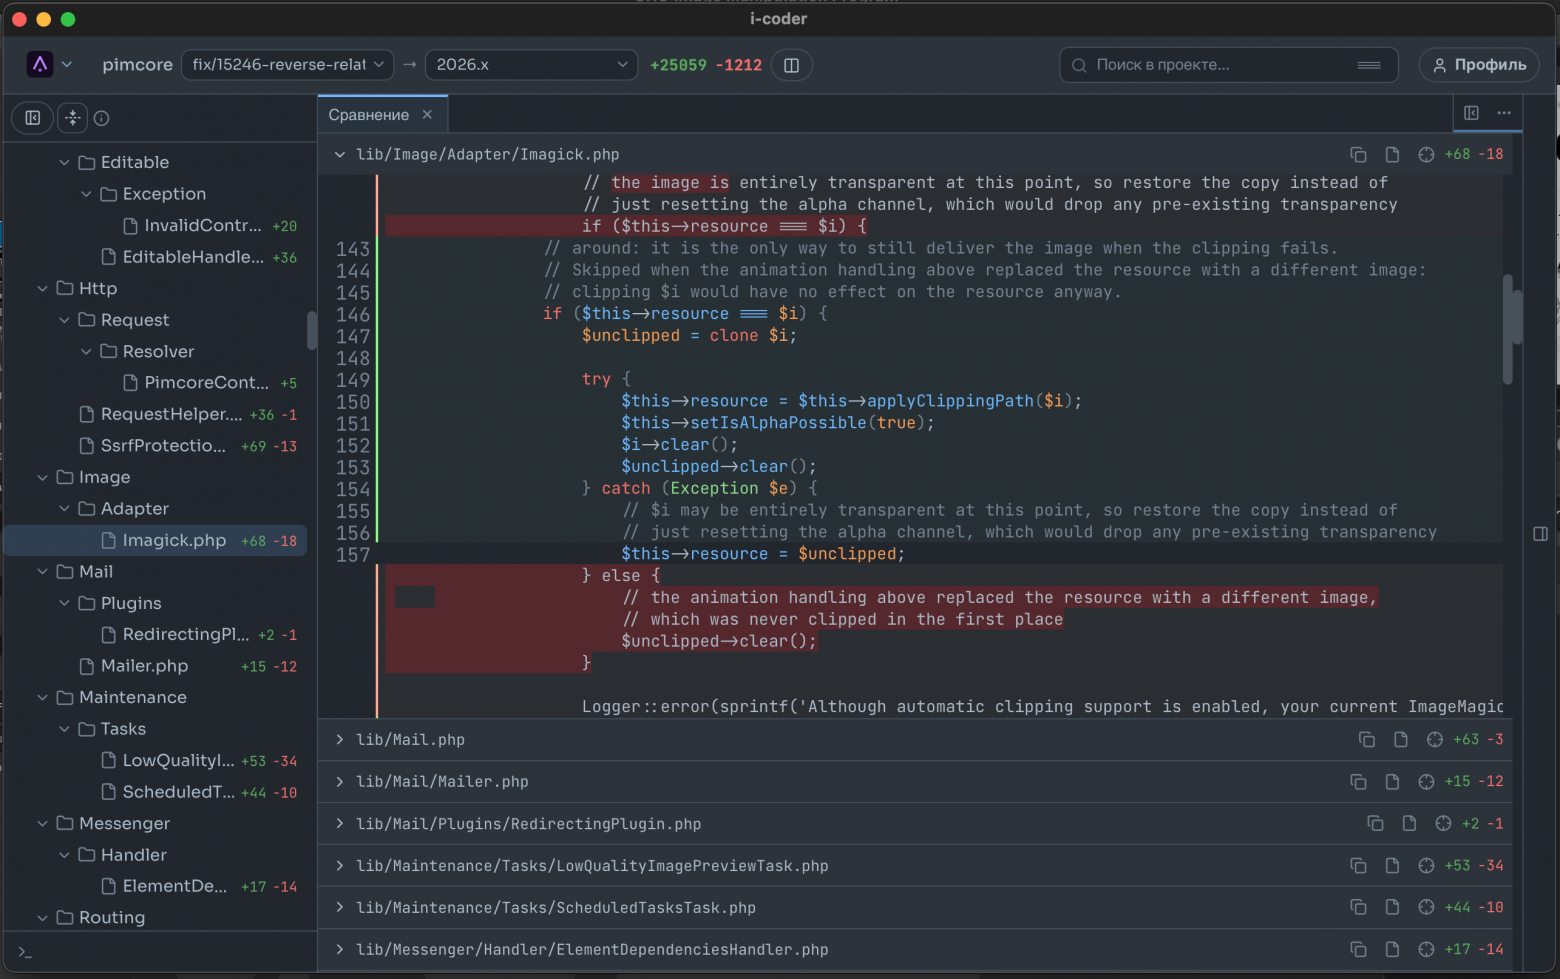
Всё началось с просмотра изменений в коде и переросло в желание работать с кодом. Например, когда при self‑review я находил баги и сразу же их правил, было неудобно переключаться обратно в привычные IDE. Поэтому пришлось дорабатывать инструмент дальше. И первым делом я добавил поддержку ИИ, чтобы не править руками.
Нам нужен ИИ, чтобы генерить еще больше кода с ИИ...
Вначале я подумал, что для мелких правок достаточно подключить слабые модели, желательно локальные, и делать всё через них. Я делал всё постепенно, шёл от режима вопроса к режиму агента шагами, так как в целом при код‑ревью первостепенны вопросы, а потом — правки. Поэтому логично было построить ассистента так же, как у других, с такими же режимами: «Вопрос», «План», «Агент». И, забегая вперёд, скажу, что добавил ещё один специальный режим — «Агент (терминал)».
Добавил настройку моделей, учёл возможность добавлять свой прокси для каждой модели, возможность помечать модели с возможностями распознавания изображений, работы в режимах embedding или reranker. Сделал полноценный и гибкий BYOK, которого не хватает во многих IDE или расширениях для них. Хотя есть довольно гибкие расширения, всё равно из коробки они толком не работают: в них надо думать над системными промптами, изучать скудную документацию и ловить баги... Всё это тяжко. В моей IDE можно просто указать модель и сразу получить рабочий агентский режим. Я проверял на моделях 4B и 10B — это работает (не идеально, но гораздо лучше, чем у всех существующих и известных мне расширений). Ниже объясню почему.
Почему модель на 10B вообще правит код: текстовый протокол вместо function calling
У небольших моделей function calling часто ломается: битый JSON, лишний текст вокруг, неверные поля. Поэтому я от него отказался. Модель пишет обычный текст с XML‑тегами, а клиент сам аккуратно его разбирает. Правила протокола зашиты в системный промпт каждого режима.
Правка файла выглядит так (пример условный):
<thought>В обработчике клика нет проверки границ.</thought>
<edit_file path="src/game.ts">
<<<<<<< SEARCH
function onClick(x, y) {
  move(x, y);
}
=======
function onClick(x, y) {
  if (x < 0 || y < 0) return;
  move(x, y);
}
>>>>>>> REPLACE
</edit_file>
Когда задача выполнена, модель пишет короткий отчёт вне тегов и ставит <done />:
Поправил проверку границ в src/game.ts.
<done />
Остальные теги простые: read_file с диапазоном строк, search_code, list_directory, create_file, rename_file, delete_file. Несколько правил, которые оказались важными:
Блок
SEARCHдолжен встречаться в файле ровно один раз. Если совпадений несколько, правка отклоняется, и модель получает ошибку с просьбой расширить блок окружающим кодом. Клиент сначала ищет точное совпадение, затем совпадение с нормализованными переводами строк, затем нечёткое совпадение, которое не различает количество пробелов и табов. Поэтому отступы в блоке стоит проверять отдельно. Если в одномedit_fileнесколько блоков, каждый проверяется на уникальность относительно уже изменённого текста, а файл записывается только тогда, когда применятся все блоки.Абсолютные пути и
..клиент отклоняет.Если модель обернула ответ в markdown‑ограду, парсер её снимает.
Ошибку разбора клиент возвращает модели текстом, и она может исправиться на следующем шаге.
Цикл агента: каждый прогон устроен одинаково
Системный промпт режима не меняется весь прогон. В некоторых IDE и расширениях системный промпт собирается динамически и по ходу сессии может разрастаться. На большом контексте это незаметно, а на маленьком окне модели быстро съедает место под код. Фиксированный промпт проще держать в лимите и переиспользовать как префикс запроса, что позитивно влияет на кеш, который позволяет экономить токены.
Снимок редактора (активный файл, открытые вкладки, структура проекта, правила проекта) уходит отдельным сообщением. Он добавляется в историю, только если изменился.
Модель отвечает тегами (слабые модели нарушают инструкции чаще, поэтому обязательно «тыкаю носом» на коррекцию или страхуюсь на клиенте).
Клиент выполняет действия над локальной папкой и возвращает результат следующим шагом (обратная связь по ошибкам протокола).
Прогон ограничен числом шагов: вопрос — 6, агент — 12, план — 24. Это очень важно. В планах сделать это настраиваемым для каждой модели, пока это универсальные эмпирические значения. Если лимит достигается, то либо просим «продолжить», либо, если результат выглядит неожиданно, просим корректировать.
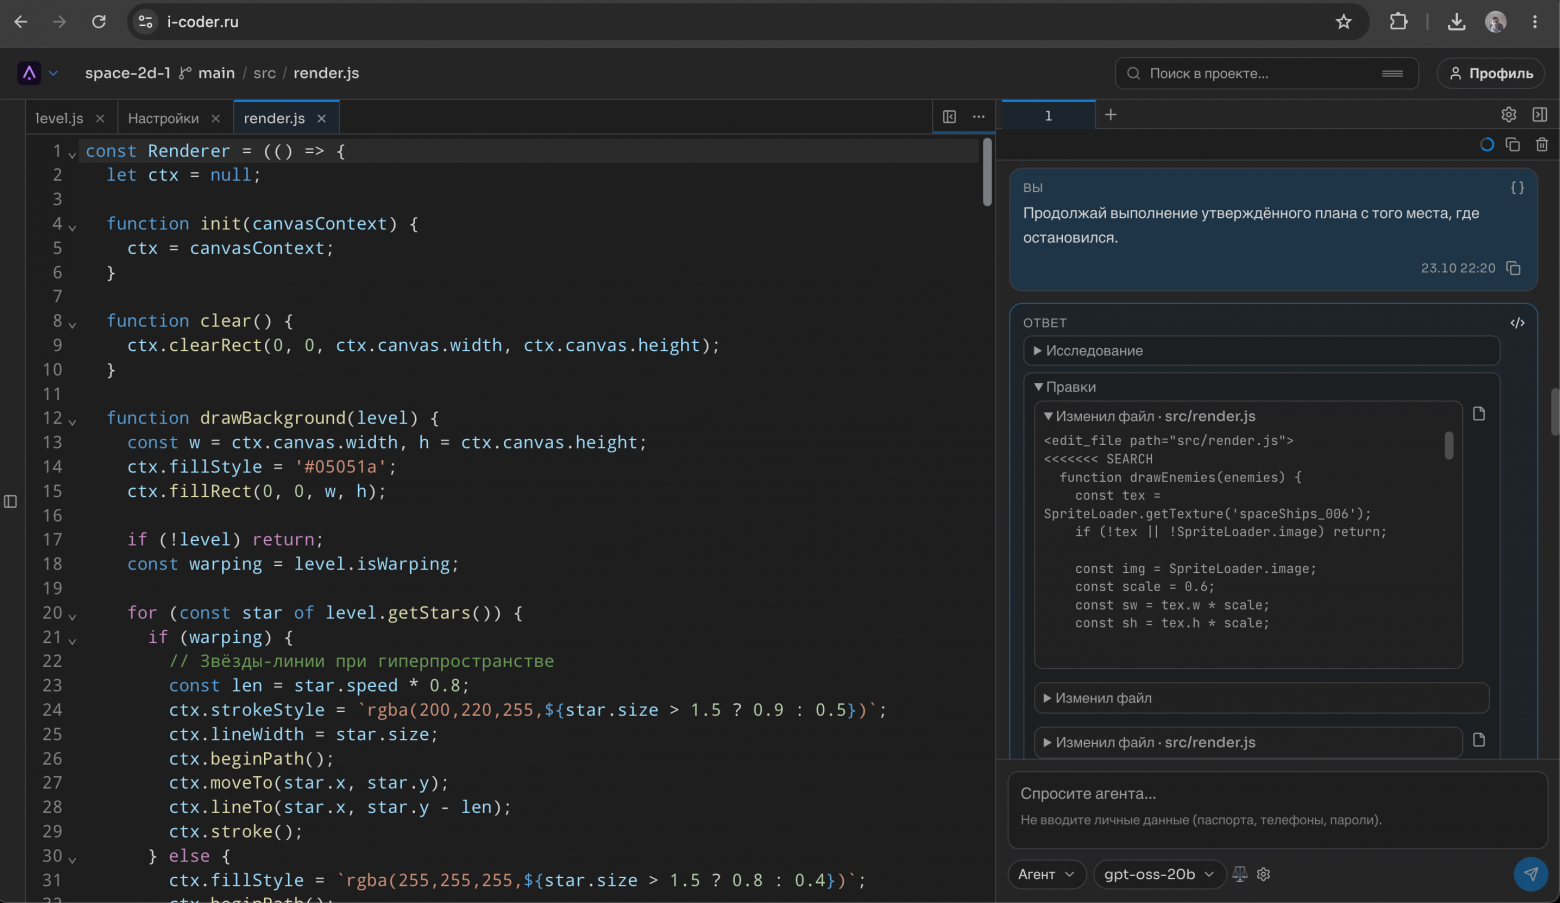
Получается видимый цикл: каждый шаг виден в чате, и остановить агента можно в любой момент. Агента, который уходит работать сам, здесь нет, и это сделано намеренно.
Узкий контекст
Маленькая модель хорошо работает только с короткой и точной порцией контекста:
длинные файлы обрезаются, а для файлов длиннее примерно 200 строк модель должна запросить нужный диапазон;
переменные окружения (
env) и другие чувствительные данные, покрытые эвристикой, маскируются;если в проекте включён поиск по коду, перед прогоном в сообщение добавляется блок
<code_index>с тремя наиболее релевантными фрагментами. Как он строится, описано дальше.
Эмбеддинги и reranker
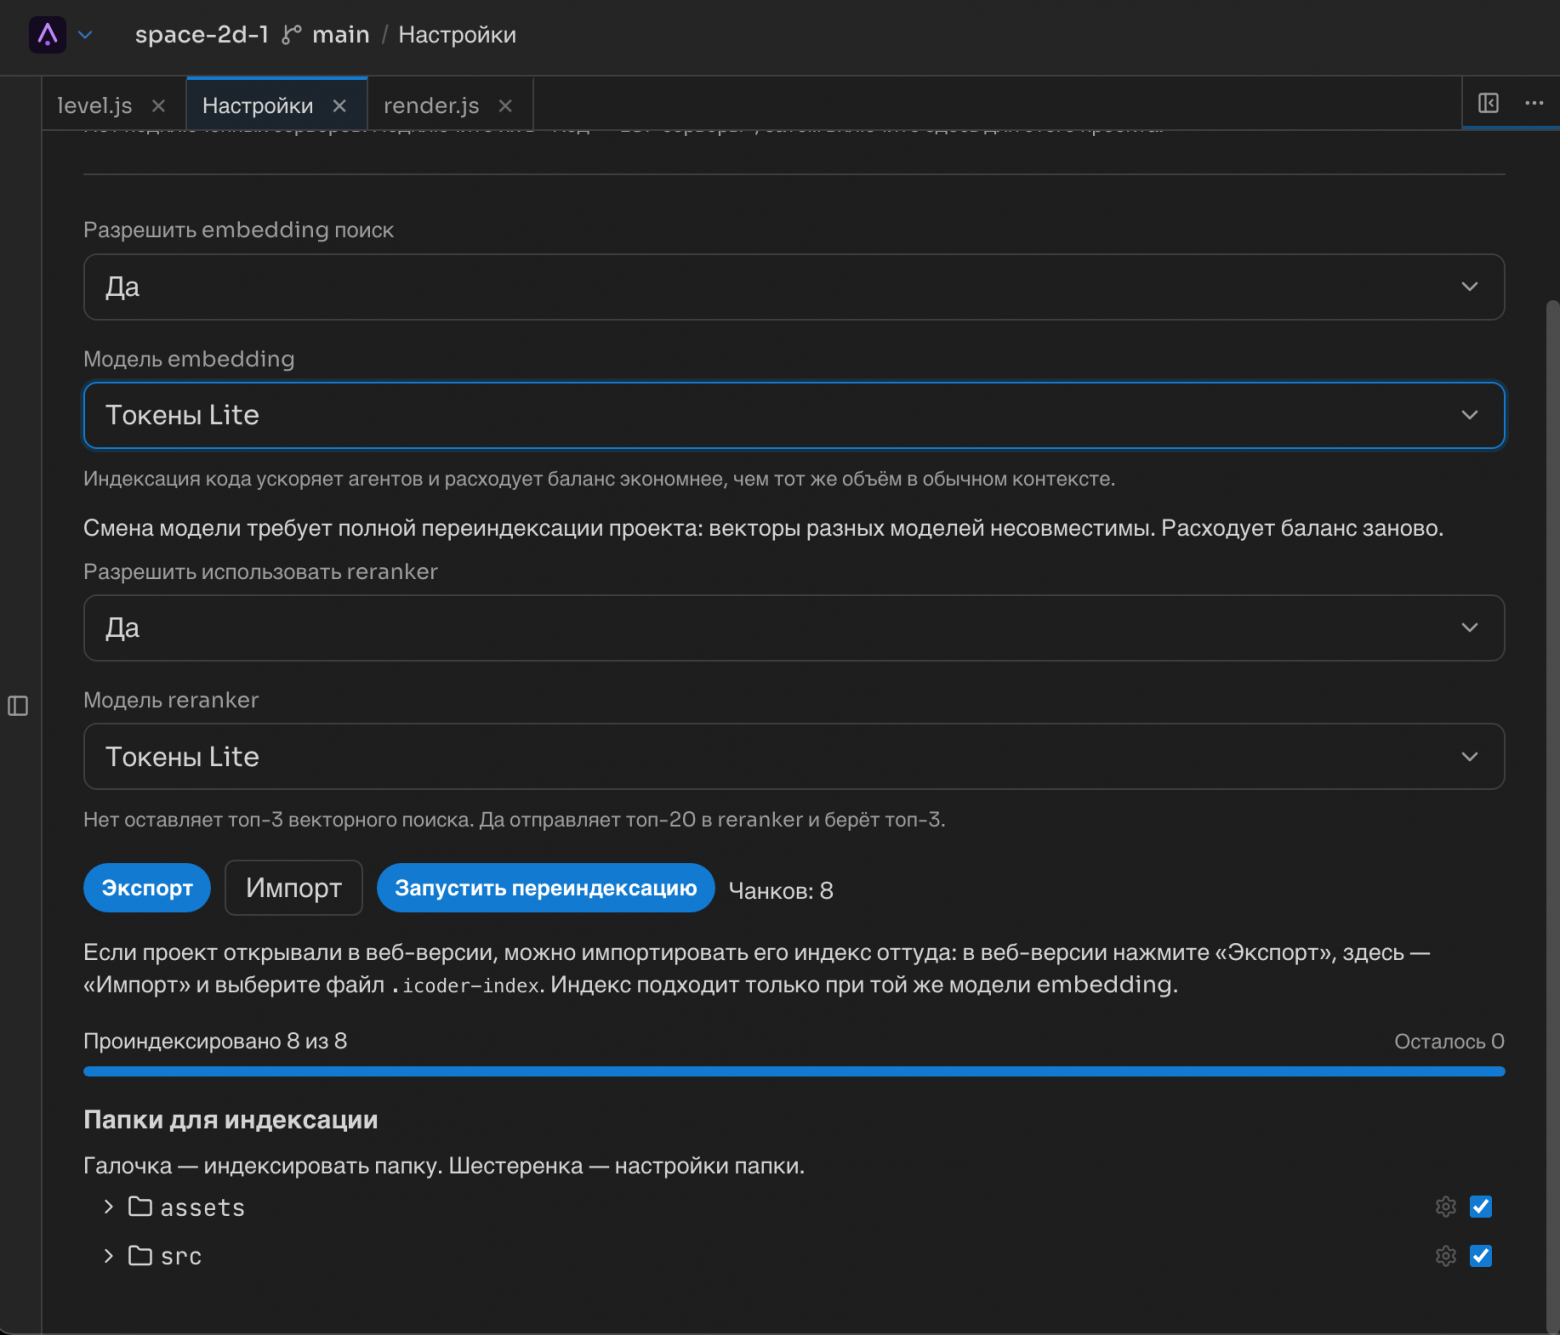
Узкий контекст держится на поиске. Если отдать модели весь проект, она теряется в нём. Если не отдать ничего, начинает угадывать. Обычный поиск по строке находит только точные совпадения, а на вопрос «где обрабатывается клик по полю» в коде обычно нет такого текста. Здесь помогают эмбеддинги.
Эмбеддинг — это вектор из чисел, который модель строит по смыслу текста. Тексты с похожим смыслом получают близкие векторы, даже если слова в них разные.
Индексация — это процесс, при котором каждый файл проекта разбирает Tree‑sitter в фоновом воркере браузера (или веб‑движке, если это десктоп). В индекс попадают не тела функций, а их структура: сигнатуры функций, классов и методов с номерами строк.
Markdown и YAML режутся по своим границам. Каждый кусок длиной до 6000 символов превращается в вектор embedding‑моделью проекта и сохраняется в локальном векторном индексе. Сам индекс лежит в IndexedDB браузера. Правки агента попадают в индекс в конце прогона, а не после каждого шага.
Так выглядит кусок структуры для эмбеддинга (условный пример):
src/game.ts L1-120
L14 class Board
L22   move(x, y)
L58   onClick(x, y)
Запрос
Текст сообщения пользователя тоже превращается в вектор той же моделью. Затем ищутся ближайшие куски по расстоянию между векторами. Если reranker выключен, берутся три ближайших.
Реранкер
Эмбеддинги сравнивают запрос и кусок кода по отдельности, поэтому на тонких различиях ошибаются. Reranker читает пару «запрос + кусок» вместе и выставляет оценку релевантности. Он медленнее, поэтому работает только с кандидатами: индекс отдаёт 20 ближайших кусков, reranker переупорядочивает их, и в блок идут три лучших. Тяжёлая проверка выполняется на маленьком наборе.
Что получает модель
Три куска добавляются в сообщение пользователя блоком <code_index>, один раз на прогон. В его шапке сказано, что это структуры, а не тела файлов, и перед правкой их надо прочитать. Номера строк уже есть в блоке, поэтому модель вызывает read_file с нужным диапазоном и не открывает файл целиком.
Почему это помогает маленькой модели:
вместо всего проекта она видит три релевантных места и не распыляет внимание;
правки начинаются с места, которое нашёл поиск, поэтому меньше ошибок в не тех файлах;
номера строк уже в блоке, поэтому на поиск нужно меньше шагов;
структура короче тела функции, поэтому блок занимает меньше токенов.
Ограничения:
Качество поиска зависит от моделей эмбеддингов и reranker: слабый эмбеддинг даёт шум, и reranker не всегда его исправит.
Если поиск не сработал (нет модели, сетевая ошибка), прогон идёт без блока, а чат не ломается.
Модели для поиска выбираются в настройках проекта отдельно от модели чата, а reranker там же можно выключить.
Качество я не измерял цифрами — это наблюдение по моей работе с кодом.
Маршрутизация (пока только backend)
Потом мне понадобился маршрутизатор между разными моделями и провайдерами. Делать это на клиенте уже не хотелось, поэтому я написал backend. В нём настраиваются провайдеры и модели, нагрузка распределяется с учётом стоимости токенов, а при сбое запрос уходит другому провайдеру. Промпт по‑прежнему собирает клиент, а backend только маршрутизирует запрос. Вероятно, в будущем добавлю маршрутизацию на клиенте, но обычно это редкое явление, и достаточно вручную поменять модель в селекторе.
Десктоп: почему Tauri
В браузере нет настоящего терминала, а мне хотелось, чтобы работа с терминалом тоже была встроена в IDE (да, как‑то странно от кода сразу в терминал, но вот такой сценарий). Так я решил сделать десктопную версию. Выбор пал на Tauri: интерфейс тот же, а нативная часть написана на Rust. До этого я ничего не знал про Tauri и Rust. (Сейчас тоже особо ничего не знаю)
Результат меня поразил. Десктопное приложение размером 10 МБ, а для Linux AppImage — 90 МБ. Работает быстро.
Агент с терминалом: проверки команд и экономия токенов
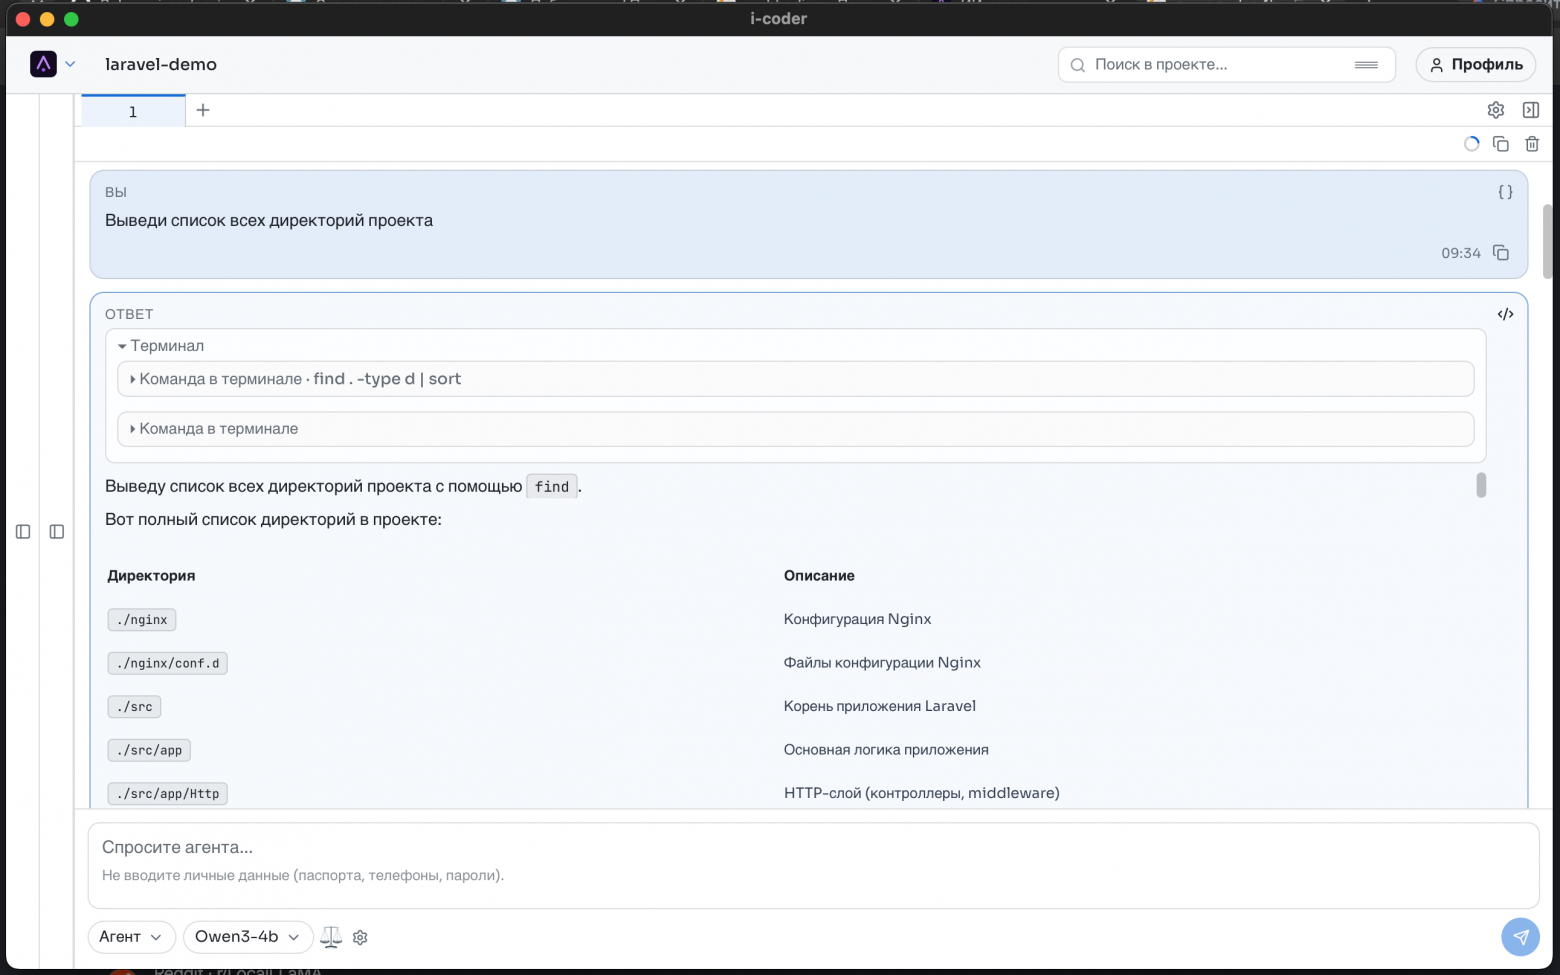
Режим «Агент (терминал)» даёт модели shell в папке проекта. Это самая рискованная часть IDE: одна неудачная команда может удалить лишнее, поэтому перед запуском каждая команда проходит несколько проверок. Пока режим работает на macOS и Linux, в Windows команда возвращает ошибку.
Как выглядит ход
Один ход — одна команда. Модель пишет <run_command command="npm test"/>, и клиент запускает её в отдельном терминале агента. Результат возвращается следующим сообщением: команда, текущая папка, код возврата и вывод. В одном ходе можно сначала поправить файлы, а потом запустить команду. Всё, что написано после команды, клиент отбрасывает. Команды в одном терминале выполняются строго по очереди.
Три уровня защиты
1. Пути за пределами проекта — отказ без вопроса. Клиент разбирает слова команды. Абсолютные пути, ~, $HOME, .. и голый cd, которые ведут за корень проекта, блокируются до терминала. Например, cat /etc/hosts или cd ~ не запустятся. Модель получает код возврата 1 и причину отказа.
2. Опасные команды — вопрос человеку. Проверку выполняет Rust‑часть приложения. Она разбирает команду по токенам, а не ищет подстроки. Поэтому echo rm проходит, а rm -rf dist требует подтверждения. На подтверждение уходят:
удаление и права доступа:
rm,chmod,chown,dd,mkfs,sudo,eval,killall,pkillи другие;удаление пакетов:
npm uninstall,yarn removeи аналоги (это, конечно, эвристика, где‑то может не сработать; думаю, это надо всё зашивать в настройки);git‑операции, которые необратимо меняют историю или файлы:
git push --force,git reset --hard,git clean -f;загрузка и запуск скрипта, например
curl ... | sh;всё, что не удалось разобрать, например команда с незакрытой кавычкой.
Команды внутри bash -c "...", подстановок $(...) и обратных кавычек ... проверяются так же, как обычные.
3. Подтверждение в чате. Опасная команда появляется в чате карточкой с текстом команды и причинами. Запуск происходит только после подтверждения. Отказ, остановка прогона или пять минут без ответа означают, что команда не выполняется. Отказ модель получает как обычный результат и может выбрать другой путь.
Кроме проверок, есть жёсткие лимиты: команда не длиннее 4000 байт и без переводов строк, одна команда выполняется не дольше 120 секунд, после этого её прерывает Ctrl+C.
Что экономит токены
Вывод обрезается с конца. Если он длиннее 30 000 символов, клиент оставляет хвост, где обычно находится ошибка, и помечает, что вывод обрезан. Служебные строки маркера и ANSI‑коды удаляются.
Модель учат читать мало. В системном промпте режима прямо сказано: сначала
wc -l, затемhead -n 50илиtail -n 50, для поискаrg -n, аcatтолько для маленьких файлов. Lock‑файлы, минифицированные бандлы и бинарники в вывод не попадают.Фоновые процессы пишут в лог. Dev‑сервер запускается в фоне с выводом в файл внутри проекта, а модель смотрит
tail -n 50, а не поток логов.Правки возвращаются фрагментами. После
edit_fileприходит изменённый кусок, а не весь файл. Модели не нужно перечитывать файл, чтобы проверить результатФайлы читаются диапазонами. Файл длиннее примерно 200 строк читается только нужной частью, так же как в обычном агенте.
Секреты не печатаются. Для
.envв промпте указано проверять только имена переменных черезgrep -o, без значений.
Замеров экономии токенов у меня нет. Это правила, заложенные в протокол и промпт, а не результат сравнения. Понятно, что места для оптимизаций ещё много, но пока этого мне хватает.
И когда ИИ был готов, за ним приходилось «подметать»...
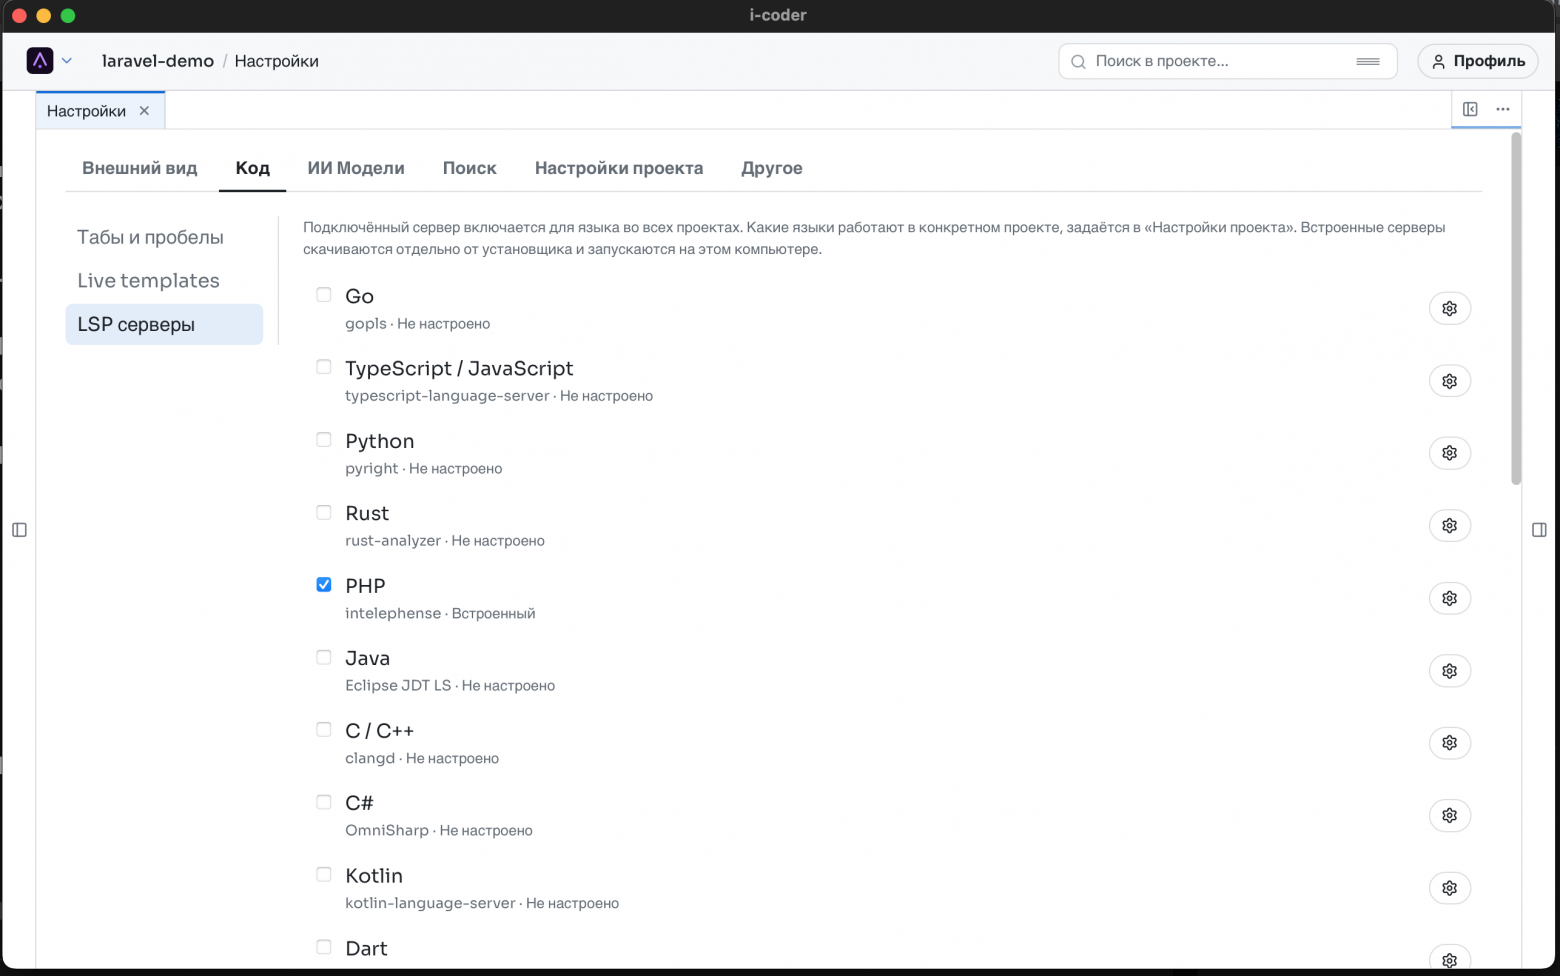
Для этого была добавлена поддержка LSP‑серверов и всякие удобства для базовых потребностей в ручном программировании и тестировании. Для тестирования был добавлен HTTP‑клиент, по образу и подобию взятый из популярных IDE.
LSP и что отличается в браузере и десктопе
В браузере — только WebSocket: адрес
wss://(дляlocalhostдопустимws://), в каждом кадре — один JSON‑RPC‑объект; сервер получает корень проекта и только открытые документы, весь проект не передаётся.В десктопе — тот же WebSocket или локальный процесс сервера; Rust разбирает заголовки
Content-Lengthи отдаёт в интерфейс чистый JSON.
Если LSP не подключён, переход к определению работает через Tree‑sitter в воркере.
Всё остальное в браузере и десктопе работает один в один: редактор, темы, чат, diff, дерево файлов, Git‑история, HTTP‑клиент, AI‑ассистент.
Что получилось
Проекты можно вести в браузере или в десктоп версии и переключаться между ними;
Есть поддержка Git в браузере и десктопе.
Это работает без backend (кроме автороутинга моделей).
Diff удобно ревьюить.
Небольшая ИИ‑модель справляется благодаря протоколу и узкому контексту.
Теперь вернусь к вопросу из начала: есть ли смысл в своей IDE, когда код пишет ИИ?
Для меня есть. Создавать код стало проще физически, но ответственность за него лежит на людях, проверять его по‑прежнему приходится вручную. Поэтому я собирал инструмент под чтение и проверку изначально, но получил (как обычно, заказчик получил не то, что хотел) — более широкие возможности.
Что дальше
Я планирую развивать проект. Возможно, это станет моей работой, а возможно, останется хобби и набором инструментов для моей основной работы. Время покажет.
Стек технологий, используемый в IDE:
TypeScript + Svelte;
CodeMirror и плагины;
isomorphic‑git;
Tauri и плагины;
Go на backend.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.