Новая статья: AMD EPYC Venice 9006: до 256 ядер на сокет без оглядки на дефицит DRAM
Вместе с EPYC Venice 9006 компания AMD предлагает не только свои самые производительные серверные платформы, но широкий перечень CPU, рассчитанных на самые разные нагрузки — от решений с максимальной плотностью (2 × 256С/512T) до энергоэффективных систем с широкими возможностями I/O и памятью LPDDR5
Главная особенность семейства EPYC 9006 (Venice) — наличие до 256 ядер на сокет, что на треть больше, чем у предшествующего поколения EPYC 9005 (Turin), при этом показатели IPC выросли на 20 %, а тактовые частоты стали выше. В числе особенностей — новая подсистема I/O PCIe 6.0 и более чем двукратное увеличение пропускной способности памяти. Также следует отметить обновлённую микроархитектуру Zen 6 и переработанную архитектуру системы на кристалле (SoC).
Кроме того, AMD разделила линейку на несколько семейств для различных задач, используя два основных типа сокетов. Возвращаются модели с увеличенным объёмом кеш-памяти (Venice-X), а также появилась версия Verano с поддержкой памяти LPDDR5X. Новая серия охватывает гораздо более широкий спектр задач и представляет собой, пожалуй, самый амбициозный шаг в развитии линейки EPYC со времен перехода на архитектуру с отдельным кристаллом I/O — решение, которое позволило процессорам EPYC 7002 (Rome) совершить настоящий прорыв.
Источник изображений: AMD
В процессорах EPYC 9006 используются микроархитектуры Zen 6 и Zen 6c. Они практически идентичны и не требуют какой-либо специальной программной оптимизации для работы друг с другом, но ориентированы на разные сегменты рынка и целевые показатели производительности.
Ядра Zen 6c оптимизированы для обеспечения высокой плотности размещения и занимают меньше площади на кристалле, тогда как ядра Zen 6 рассчитаны на достижение более высоких тактовых частот. В компактных ядрах Zen 6c отсутствует поддержка технологии 3D V-Cache, а рабочие частоты несколько ниже, чем у «классических» ядер Zen 6 — это позволило разместить больше ядер на ограниченной площади кремниевого кристалла.
Первоначально было объявлено, что флагманский чип EPYC 9686F будет поставляться с пиковой частотой 5,0 ГГц, но, как оказалось, его частота ещё выше — 5,3 ГГц. Почти вся линейка чипов для разъёма SP7 получила повышение тактовой частоты — примерно до +100 МГц больше по сравнению с предварительными спецификациями AMD.
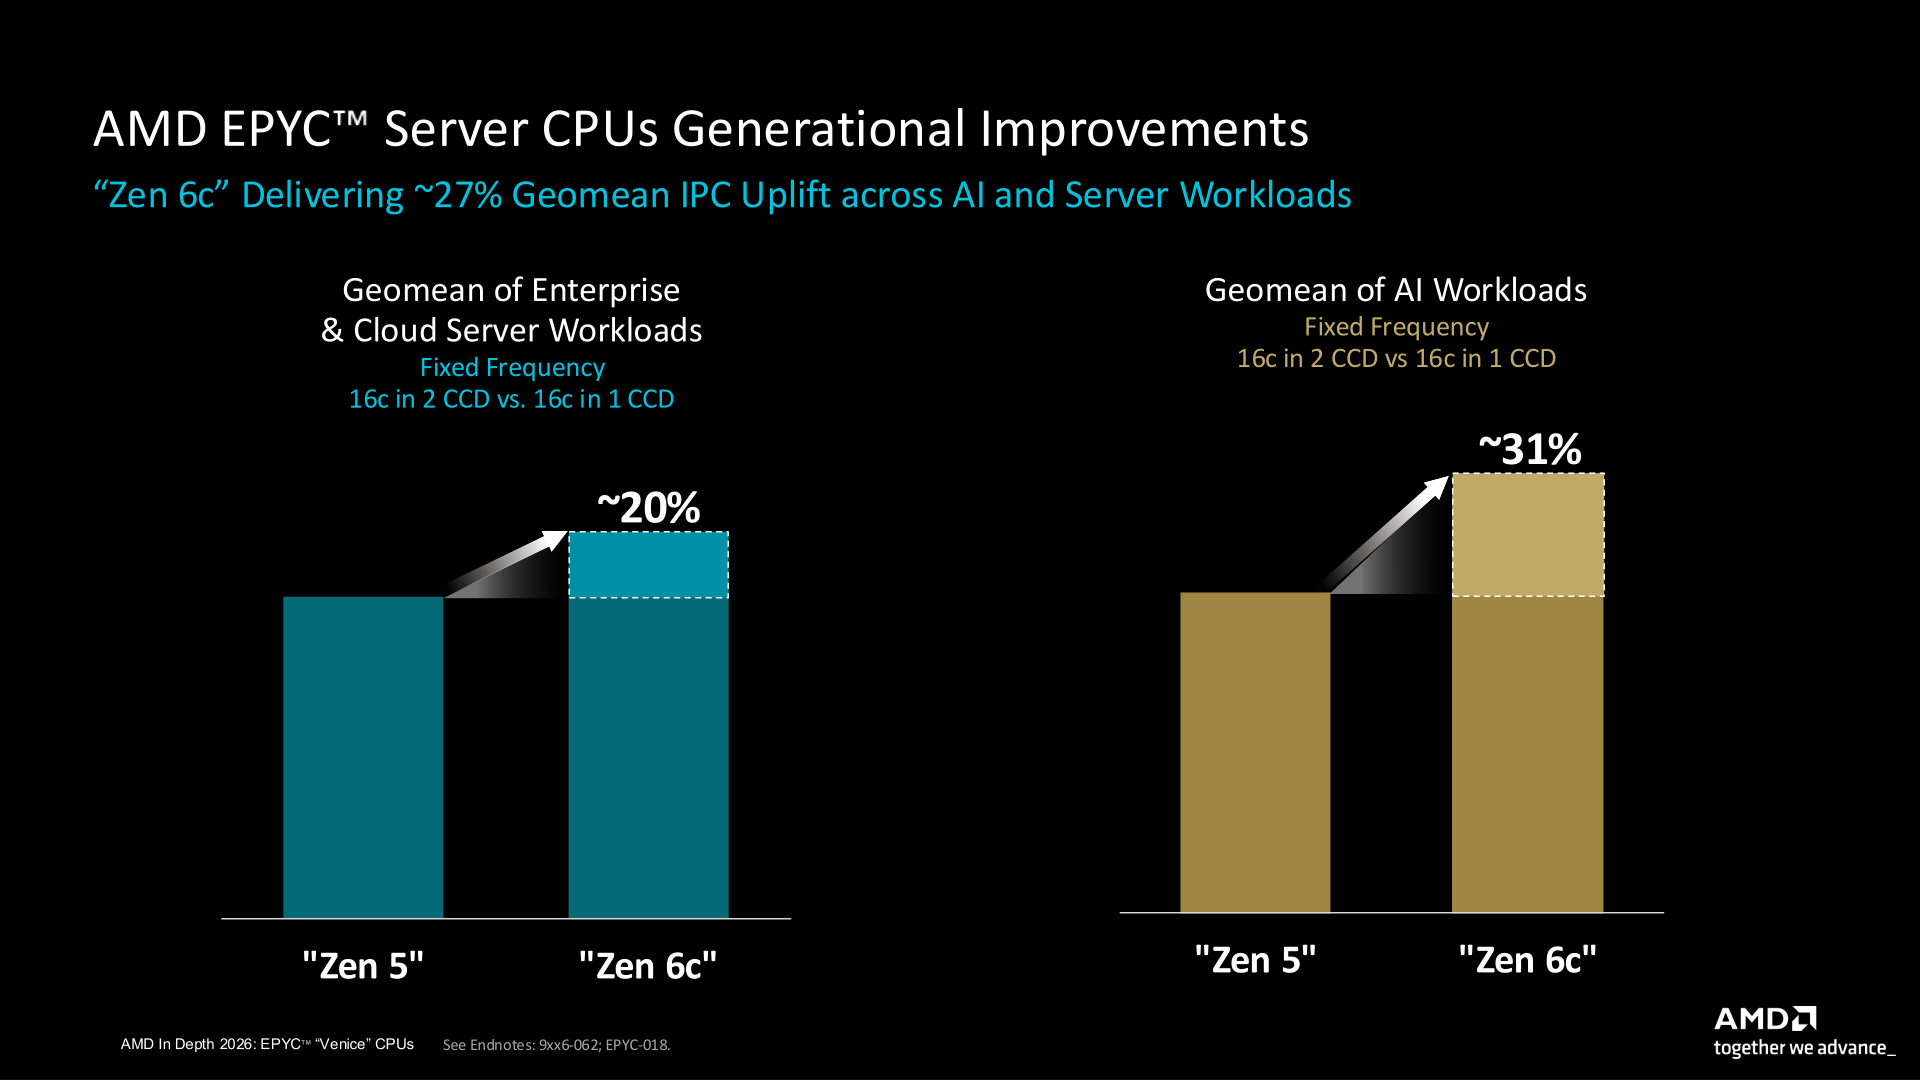
Для микроархитектуры Zen 6 компания AMD заявляет о 20-% приросте показателя IPC по сравнению с Zen 5. В зависимости от конкретной задачи, такой прирост IPC в корпоративных (серверных) нагрузках станет одним из самых весомых улучшений в истории микроархитектуры Zen.
Ещё более впечатляющий рост IPC — на 31 % — заявлен в задачах, связанных с ИИ. Это стало возможным благодаря улучшениям в системе команд (ISA) Zen 6: компания добавила новые инструкции, которые особенно эффективны при выполнении ИИ-нагрузок.
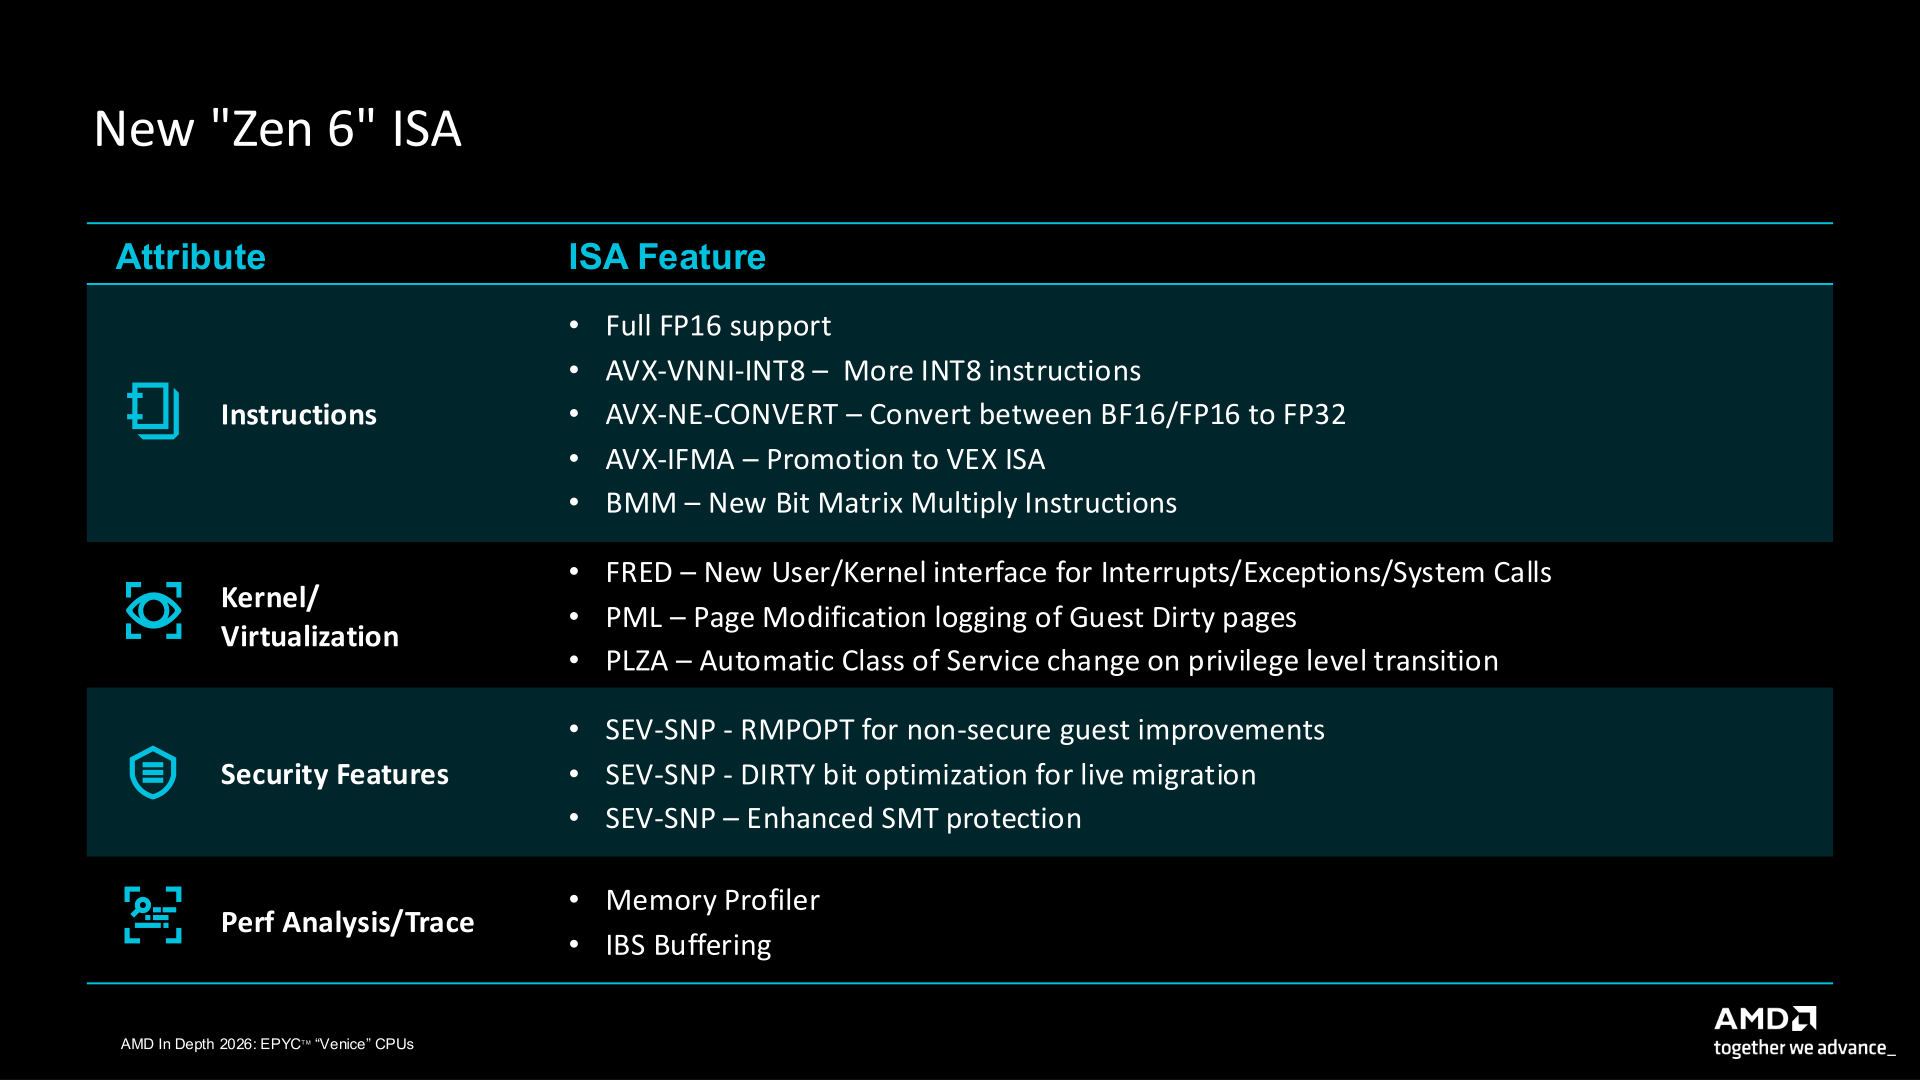
В частности, появились дополнительные команды AVX для INT8, преобразования форматов, а также целочисленные FMA-операции — технология, впервые представленная компанией Intel. Кроме того, блоки AVX получили полноценную поддержку формата FP16. Благодаря этому Zen 6 может выполнять интенсивные вычисления в формате FP16 столь же эффективно, как и операции с форматами FP32 и FP64. Наконец, AMD добавила в набор инструкций AVX-512 новую команду для матричного умножения битовых данных, что позволит дополнительно ускорить выполнение специфических побитовых матричных операций.
Также был добавлен ряд других новых инструкций, не влияющих напрямую на производительность и предназначенных для иных задач. В их число входят три новые инструкции уровня ядра (kernel instructions), предназначенные для виртуализации; наиболее примечательной из них является FRED (Flexible Return and Event Delivery — «гибкий механизм возврата и доставки событий») — новый для AMD интерфейс, обеспечивающий переходы между различными уровнями привилегий ядра.
Кроме того, для разработчиков, стремящихся максимально эффективно использовать возможности чипов на базе архитектуры Zen 6, AMD подготовила несколько новых инструментов. Среди них стоит выделить появление буферизации для механизма выборки на основе инструкций (instruction-based sampling). Также было уделено внимание работе с памятью: добавлен новый профилировщик памяти.
Следует отметить, что внимание во многом было уделено не наращиванию ресурсов, а оптимизациям, которые позволяют эффективнее нагружать имеющиеся аппаратные блоки работой и получать более высокий показатель IPC путём обработки более широкого окна инструкций.
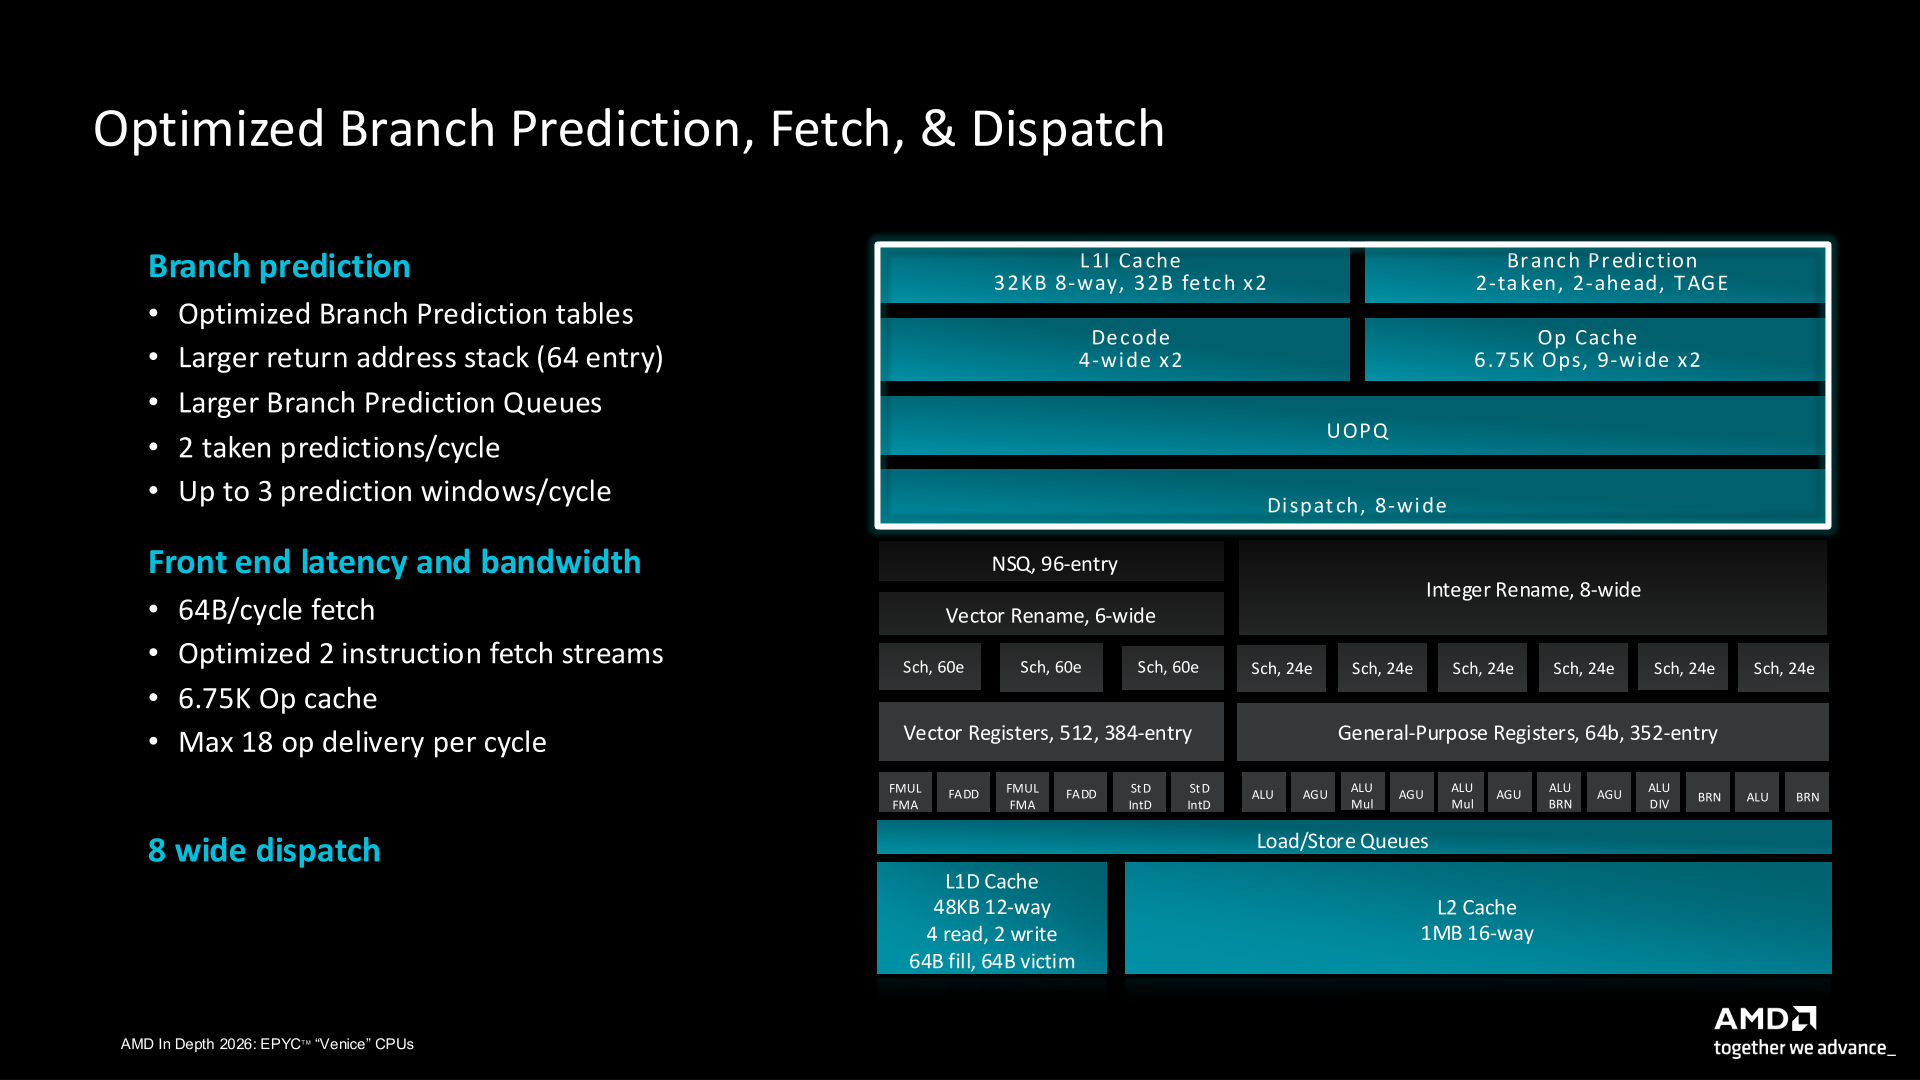
Это увеличенный кеш микроопераций (Op-cache), расширенный стек адресов возврата, увеличенные планировщики для целочисленных операций и операций с плавающей запятой (FP/INT) и многое другое. В частности, общий объём кеша микроопераций вырос с 6 тыс. до 6,75 тыс. инструкций (на 13 %), а его пропускную способность — с 12 до 18 операций за такт (вместо прежней конфигурации «2 блока по 6 инструкций» теперь используется схема «2 блока по 9 инструкций»). Что касается планировщика инструкций, то здесь радикальной переработки не было, но внимание разработчики уделили механизму планирования целочисленных операций.
Они сохранили ширину конвейера в 8 операций за такт на стадиях переименования (Rename), диспетчеризации (Dispatch) и завершения (Retire), унаследованную от архитектуры Zen 5. Вместе с тем планировщик был разделён на 6 отдельных блоков, каждый из которых вмещает 24 инструкции; таким образом, AMD перешла к распределённой стратегии планирования. Эти 6 блоков не идентичны: 2 из них (48 записей) отведены исключительно для операций ALU, а остальные 4 (96 записей) являются общими — они используются как для арифметических операций, так и для генерации адресов (AGU). Для сравнения: в архитектуре Zen 5 планировщик AGU имет фиксированный размер в 56 записей, а планировщик ALU — 88 записей.
Вместе с тем общее количество слотов, отведённых исключительно под ALU, сократилось, что позволяет планировщику AGU занимать большую часть окна планирования в тех случаях, когда это наиболее эффективно. Это изменение направлено не только на то, чтобы планировать больше инструкций, но и на повышение гибкости этого процесса, благодаря чему были сокращены простои аппаратных ресурсов.
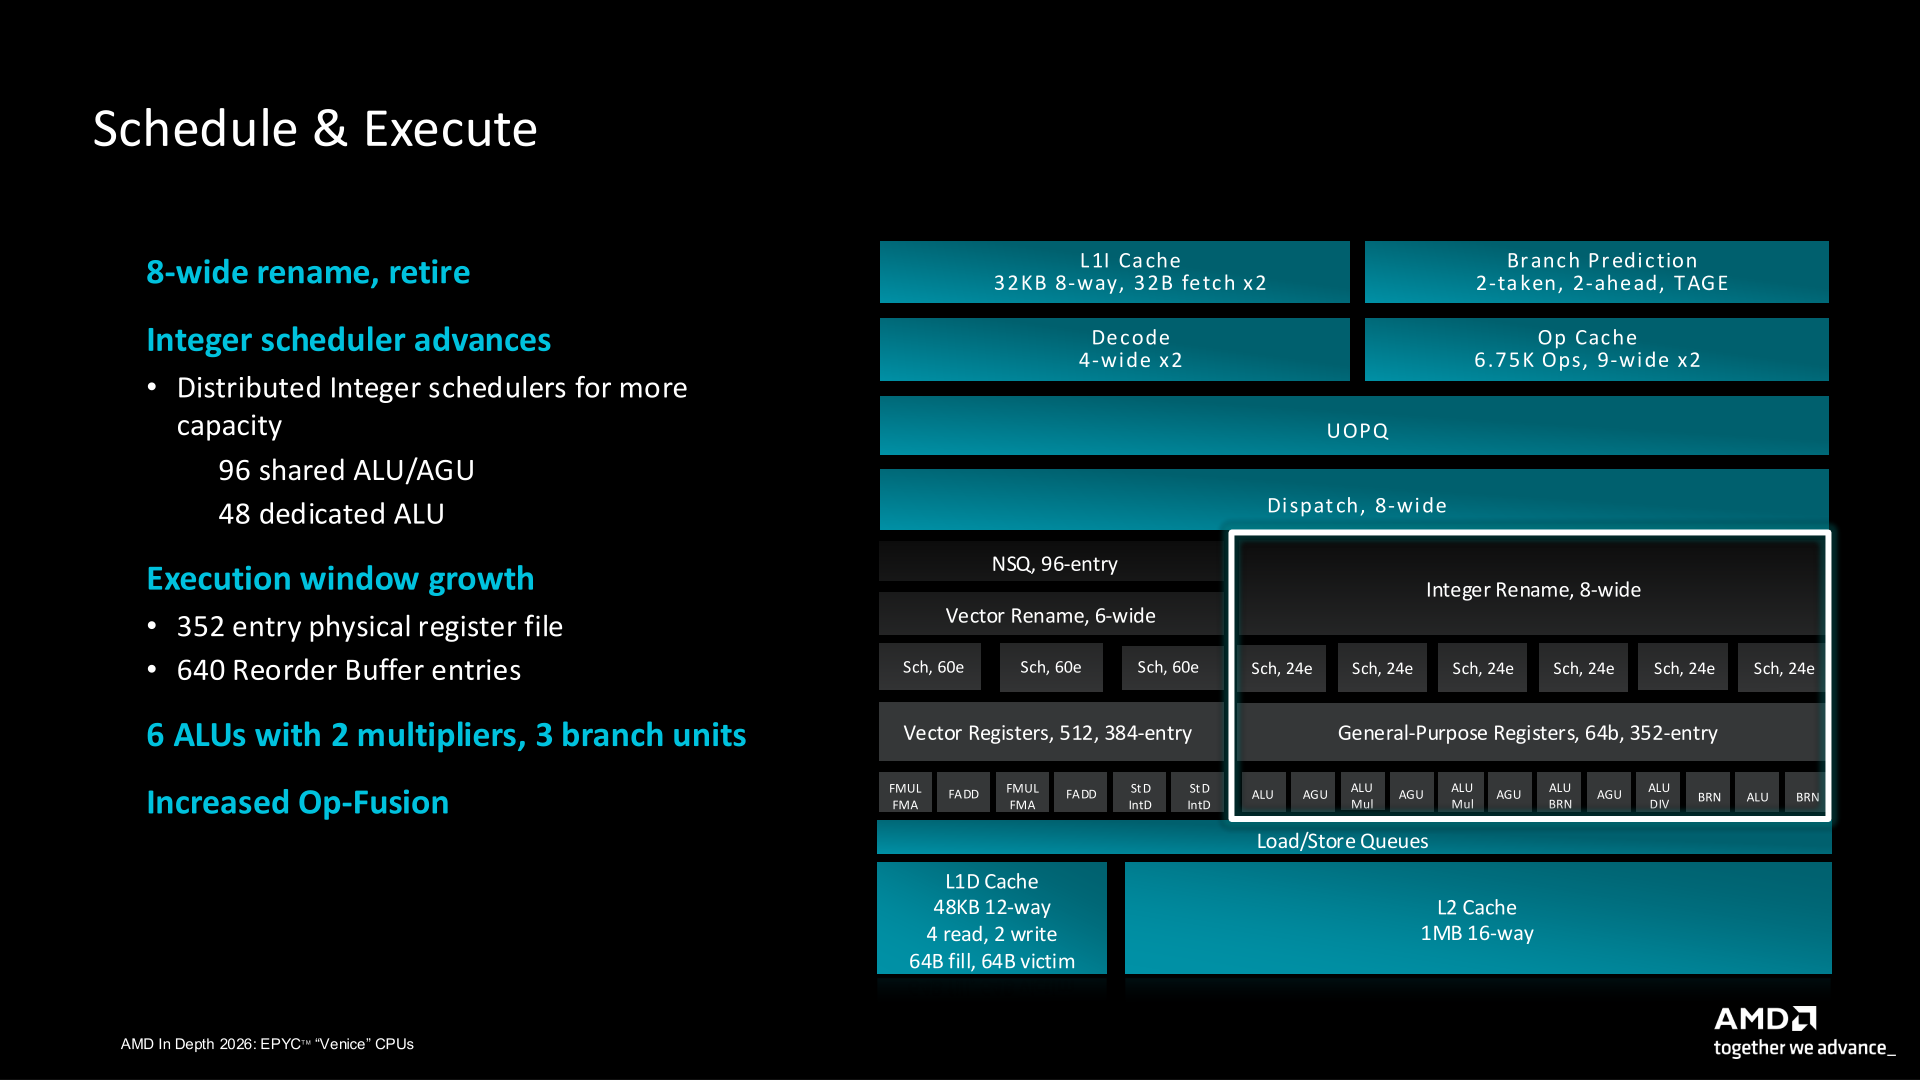
Также было расширено окно исполнения инструкций. Буфер переупорядочивания (ROB) в Zen 6 увеличен с 448 до 640 записей (+43 %). Это позволяет извлекать больше параллелизма на уровне команд благодаря анализу более длинной последовательности инструкций. В то же время сократилась конкуренция между инструкциями за физические регистры (PRG), количество записей в PRG-файле увеличено с 240 до 352 (+47 %). По заявлению AMD, также были внесены изменения, позволяющие чаще объединять операции внутри процессорного ядра, хотя конкретные детали этих доработок не раскрываются.
В FPU-блоке по-прежнему используются три планировщика инструкций, расположенные после блока переименования регистров (способного обрабатывать 6 инструкций за такт), однако теперь каждый из этих планировщиков вмещает 60 записей — против 32 в архитектуре Zen 5. Хотя AMD не добавила в бэкенд процессоров Zen 6 новые конвейеры, компания внесла ряд корректировок, изменив распределение типов инструкций, которые могут обрабатываться каждым из конвейеров.
Что касается AVX/ИИ, то теперь 4 ALU-конвейера могут выполнять инструкции VNNI-INT8, что вдвое больше, чем в Zen 5. При этом конвейеров, поддерживающих форматы INT16 и BF16, по-прежнему 2, так что данное улучшение ориентировано именно на операции INT8. Вместе с тем базовые характеристики исполнительных конвейеров (backend), включая количество каналов для стандартных комбинированных (fused) инструкций и их задержки (latency), остались без изменений.
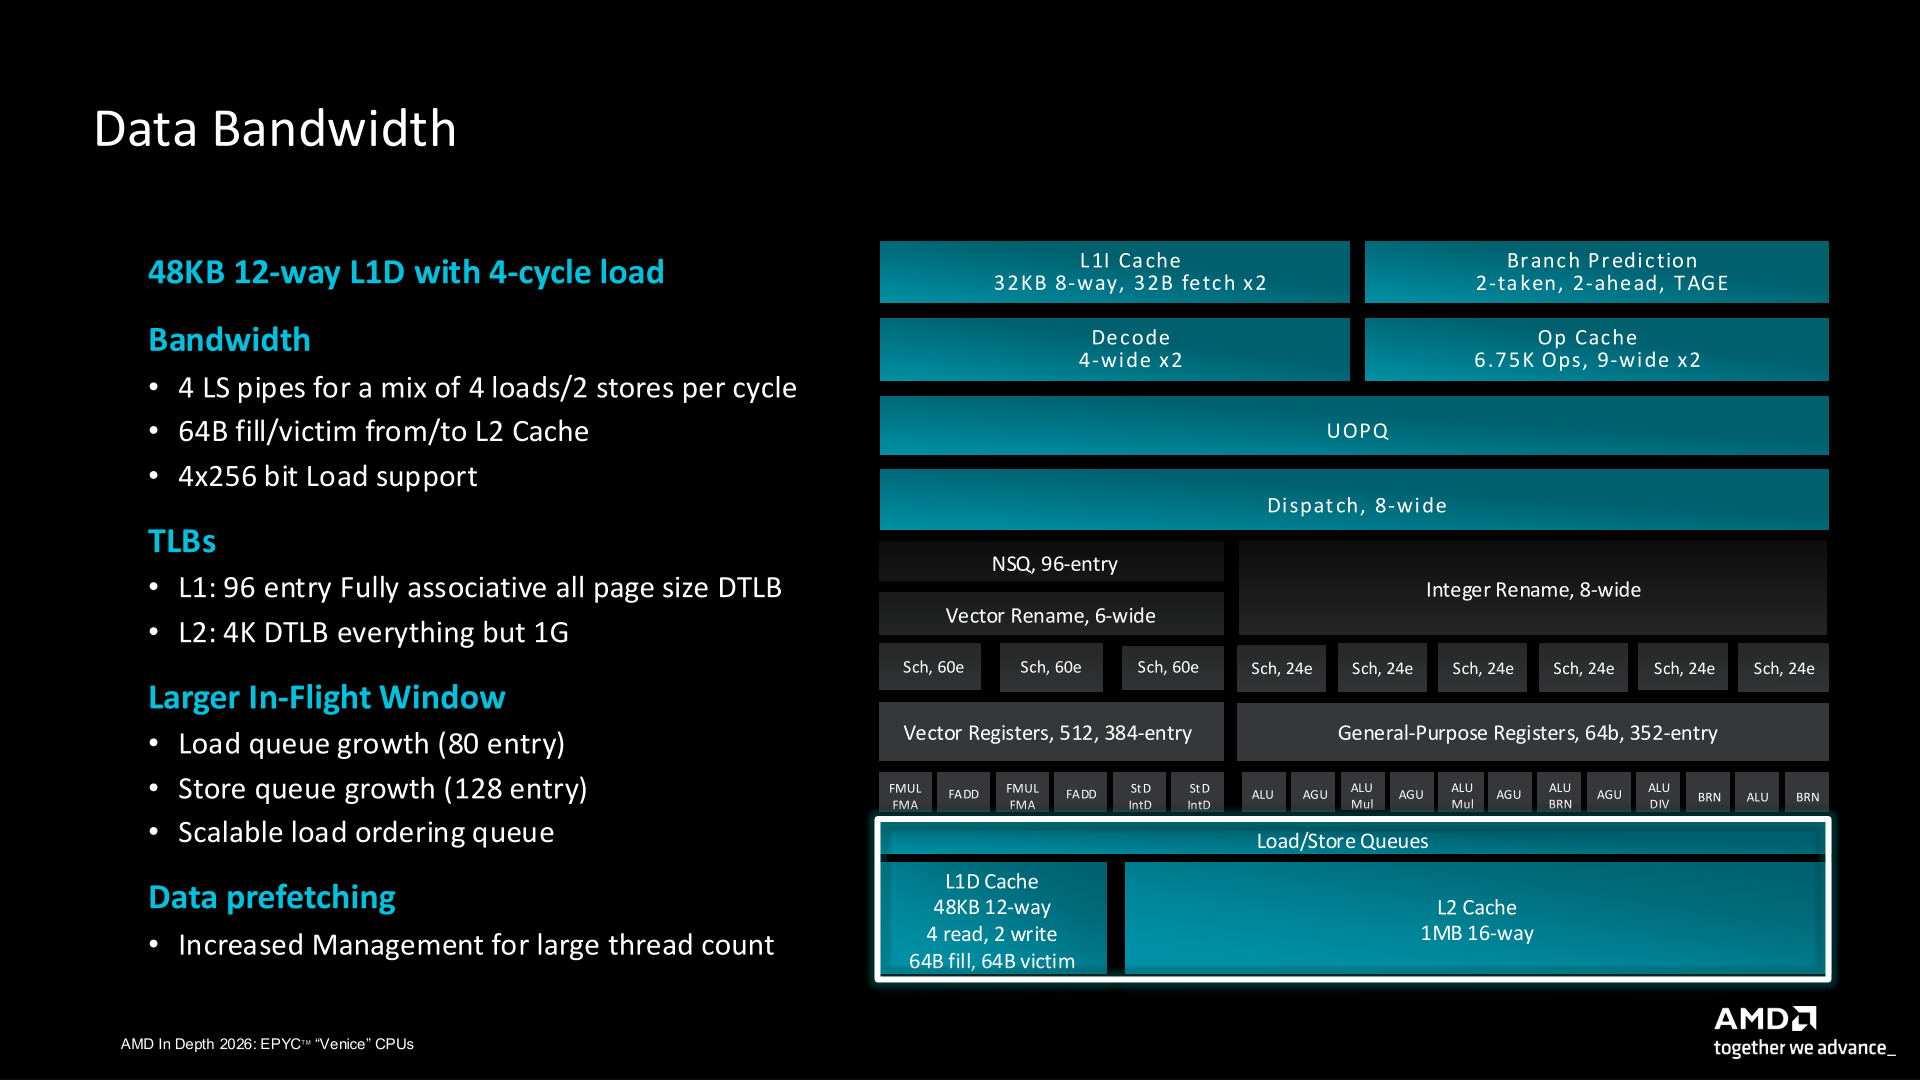
Для обеспечения их работы предусмотрены усовершенствованные блоки загрузки/сохранения (load/store units) и буферы трансляции (TLB). AMD сохранила 4 канала загрузки/сохранения, способных обрабатывать до 4 операций загрузки или 2 операций сохранения за такт. Теперь система способна выполнять 4 операции загрузки за такт, при условии, что размер каждой из них составляет 256 бит (в Zen 5 — 2 операции). В остальном общая пропускная способность осталась на уровне 1024 бит за такт — столько же было в Zen 5 при выполнении 512-битных операций загрузки (2 × 512 бит).
Также были увеличены очереди для блоков загрузки/сохранения: размер очереди загрузки вырос с 64 элементов в Zen 5 до 80, а размер очереди сохранения — со 104 до 128 элементов. Кеш-память данных L1 такая же, как в Zen 5: объём составляет 48 Кбайт, ассоциативность — 12-канальная, а задержка при операциях загрузки — 4 такта. Пропускная способность между различными уровнями кеша тоже не изменилась — кеш-память L1 заполняется со скоростью 64 байта за такт, а кеш-память L2 получает данные из L3 со скоростью 32 байта за такт.
Как уже отмечалось, AMD значительно увеличила объём кеш-памяти L3 в своих компактных чиплетах. Теперь на каждое ядро в составе CCD (Core Complex Die) архитектуры Zen 6c приходится 4 Мбайт кеша L3 — столько же, сколько в CCD архитектур Zen 5 и Zen 6. Помимо количества ядер и площади кристалла, единственным существенным различием между этими двумя типами CCD остаётся максимальная проектная частота, причём разница в этом показателе также сокращается. Для компактных CCD Zen 6c максимальная частота теперь составляет 4,1 ГГц (у предыдущего поколения — 3,7 ГГц), у CCD Zen 6 — 5,3 ГГц. Также удвоилось количество ядер в одном CCD — с 16 у Zen 5c до 32.
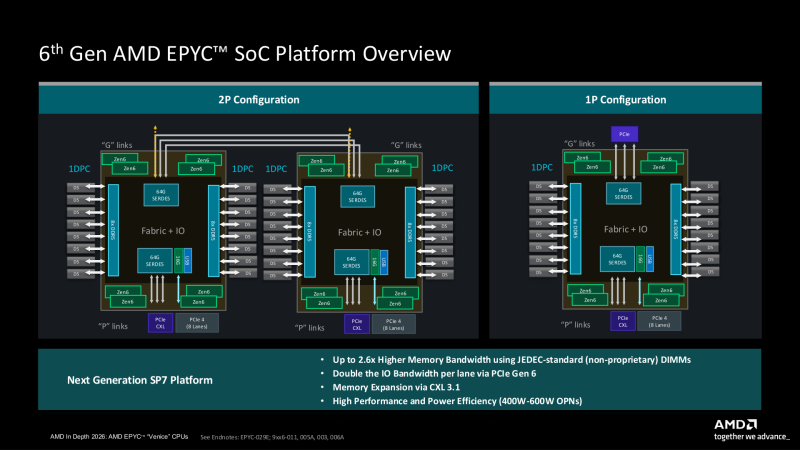
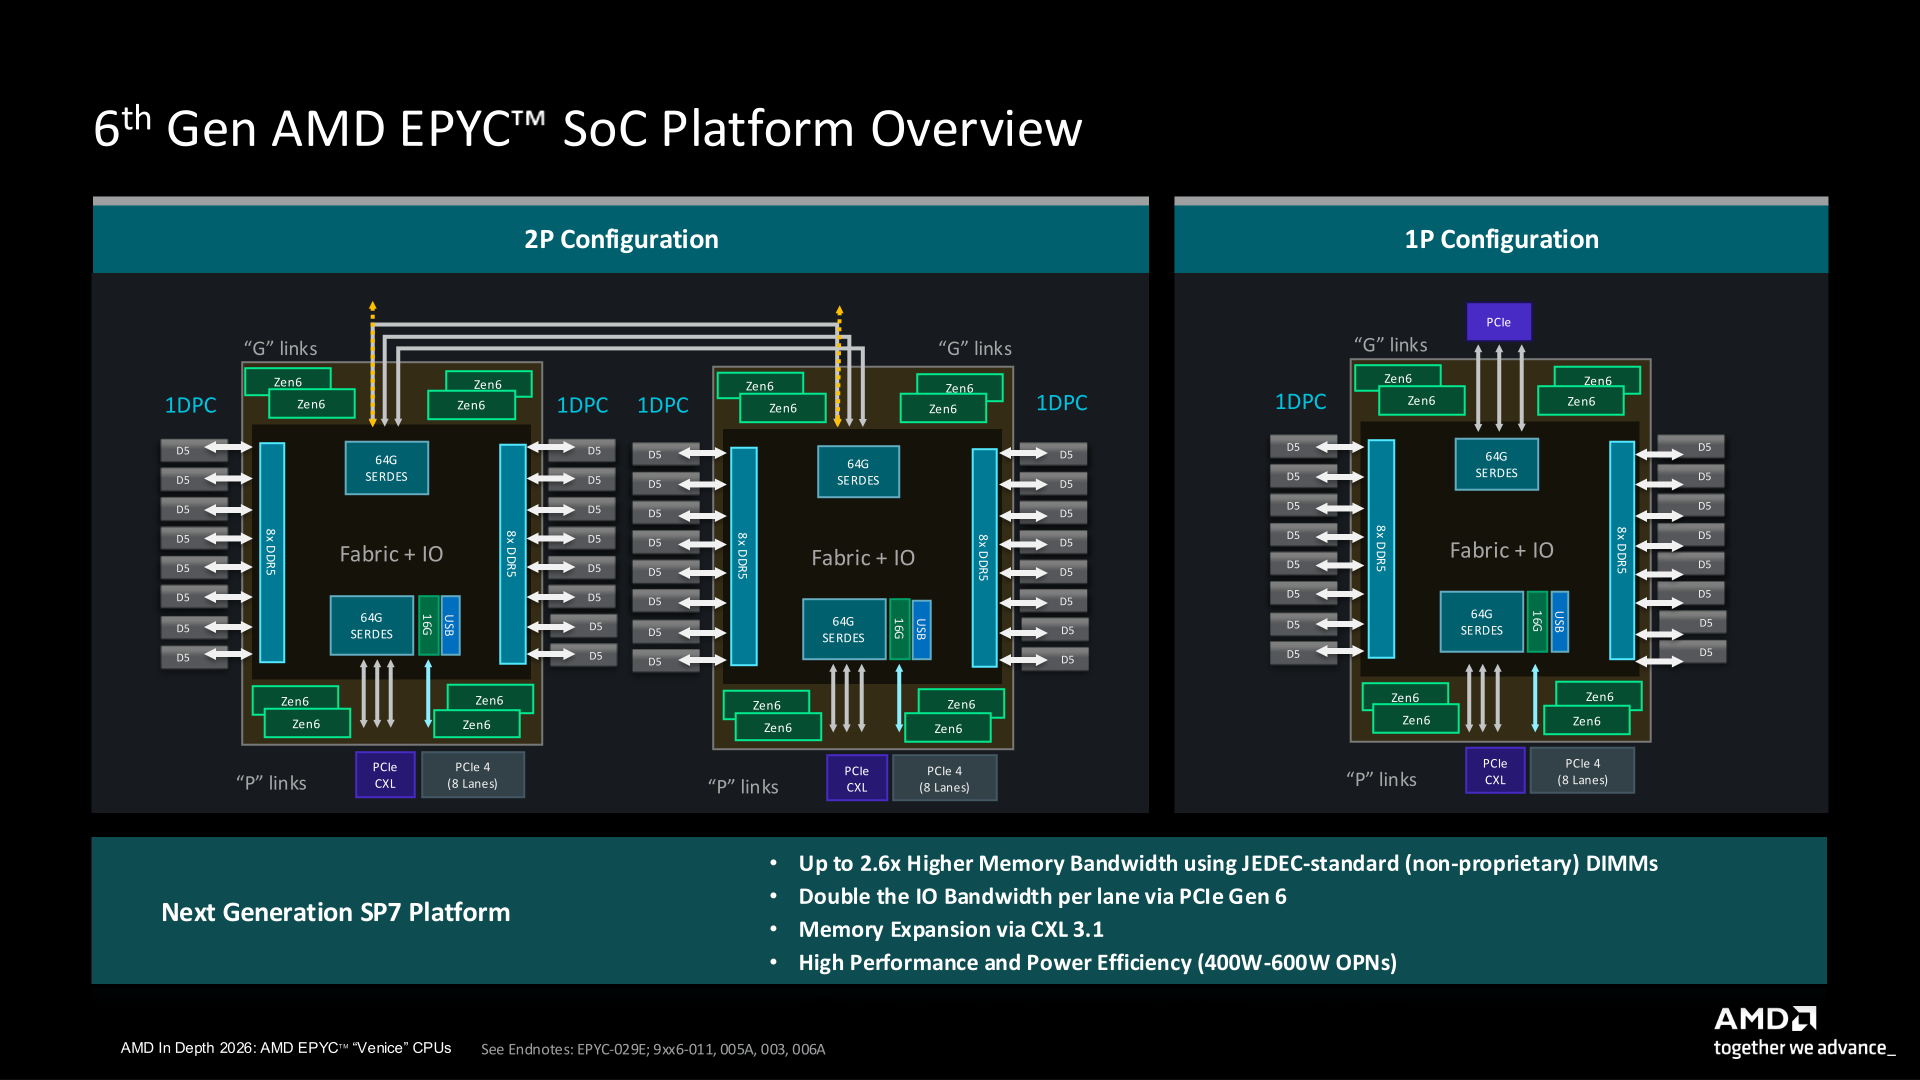
Также получил изменения кристалл ввода-вывода — I/O Die (IOD). В него входят контроллеры памяти, контроллеры PCIe, модуль безопасности (RoT), а также интерфейс Infinity Fabric (XGMI), обеспечивающий выделенный канал связи с серверными ускорителями AMD. Хотя общая концепция IOD осталась прежней, AMD разработала совершенно новый кристалл, изготовленный по 6-нм техпроцессу TSMC. В результате платформа Venice получила целый ряд новых технологий, позволяющих обеспечить вычислительные ядра Zen 6 необходимыми ресурсами I/O.
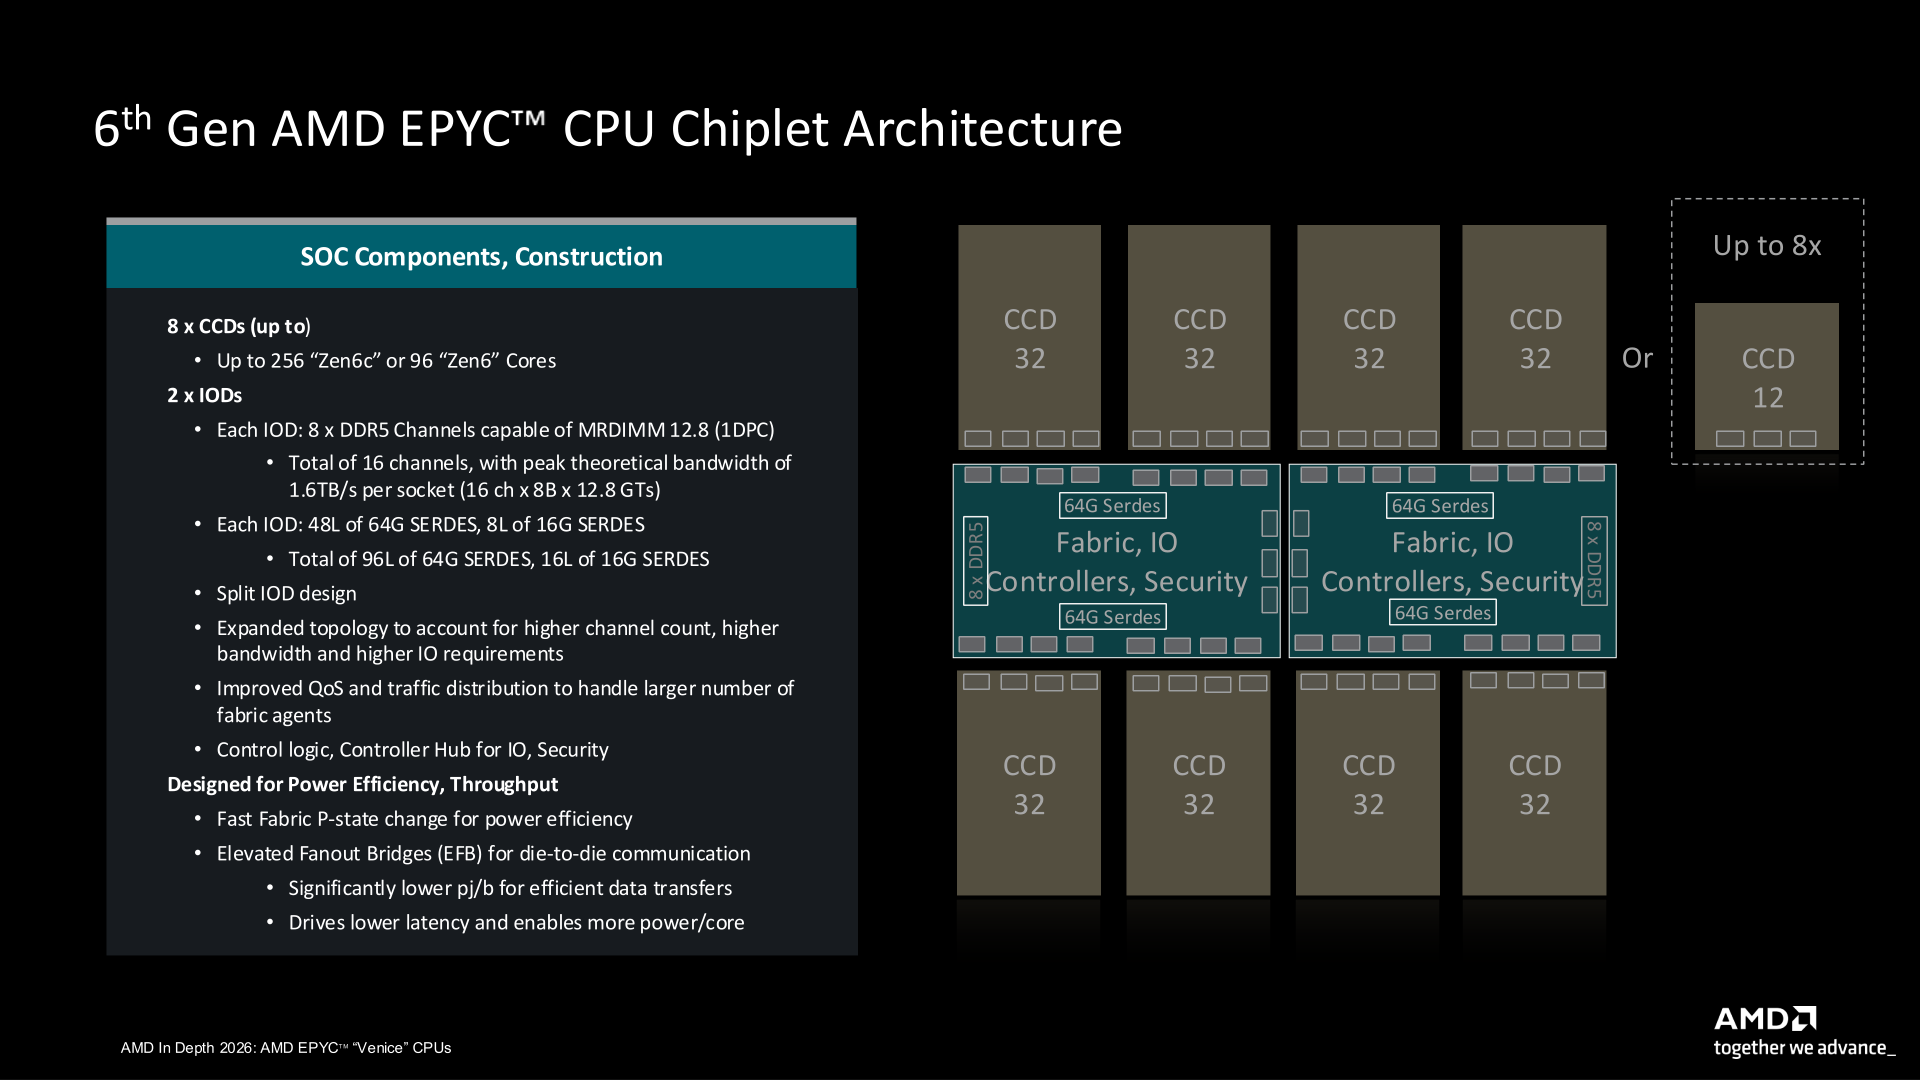
Самое значительное изменение заключается в том, что IOD разделили на два кристалла. По сравнению с IOD процессоров Turin, в IOD для платформы Venice SP7 улучшили подсистему памяти. Несмотря на то, что в отрасли в целом по-прежнему используется DDR5, компания AMD разработала для Venice гораздо более мощный и быстрый контроллер памяти. Новый IOD поддерживает 8 каналов DDR5 со скоростью передачи данных до 8000 МТ/с или модули памяти MRDIMM второго поколения со скоростью 12 800 МТ/с (в конфигурации 1DPC). Это первая платформа AMD с поддержкой MRDIMM. Таким образом, по сравнению с Turin, пропускная способность памяти на один канал удвоилась.
Получив два кристалла IOD в одном корпусе, процессор Venice SP7 располагает в общей сложности 16 каналами памяти. В наиболее производительной конфигурации это обеспечивает пропускную способность 1,6 Тбайт/с на один сокет с поддержкой до 8 Тбайт RAM. Стоит отметить, что AMD официально предлагает лишь конфигурацию 1DPC, поэтому варианты с 32 модулями DIMM для Venice SP7 не предусмотрены.
В этом поколении также изменилось максимально допустимое количество кристаллов CCD, поддерживаемых одним IOD. Если в Turin можно было разместить 16 CCD, то в Venice один IOD поддерживает до 4 таких кристаллов, что в сумме дает 8 CCD на один процессор. Соответственно, AMD увеличила скорость передачи данных между IOD и CCD, чтобы обеспечить эффективную работу возросшего числа вычислительных ядер. В частности, на каждые 8 ядер процессора приходится один порт SDP (Scalable Data Port) с пропускной способностью 32 байта за такт.
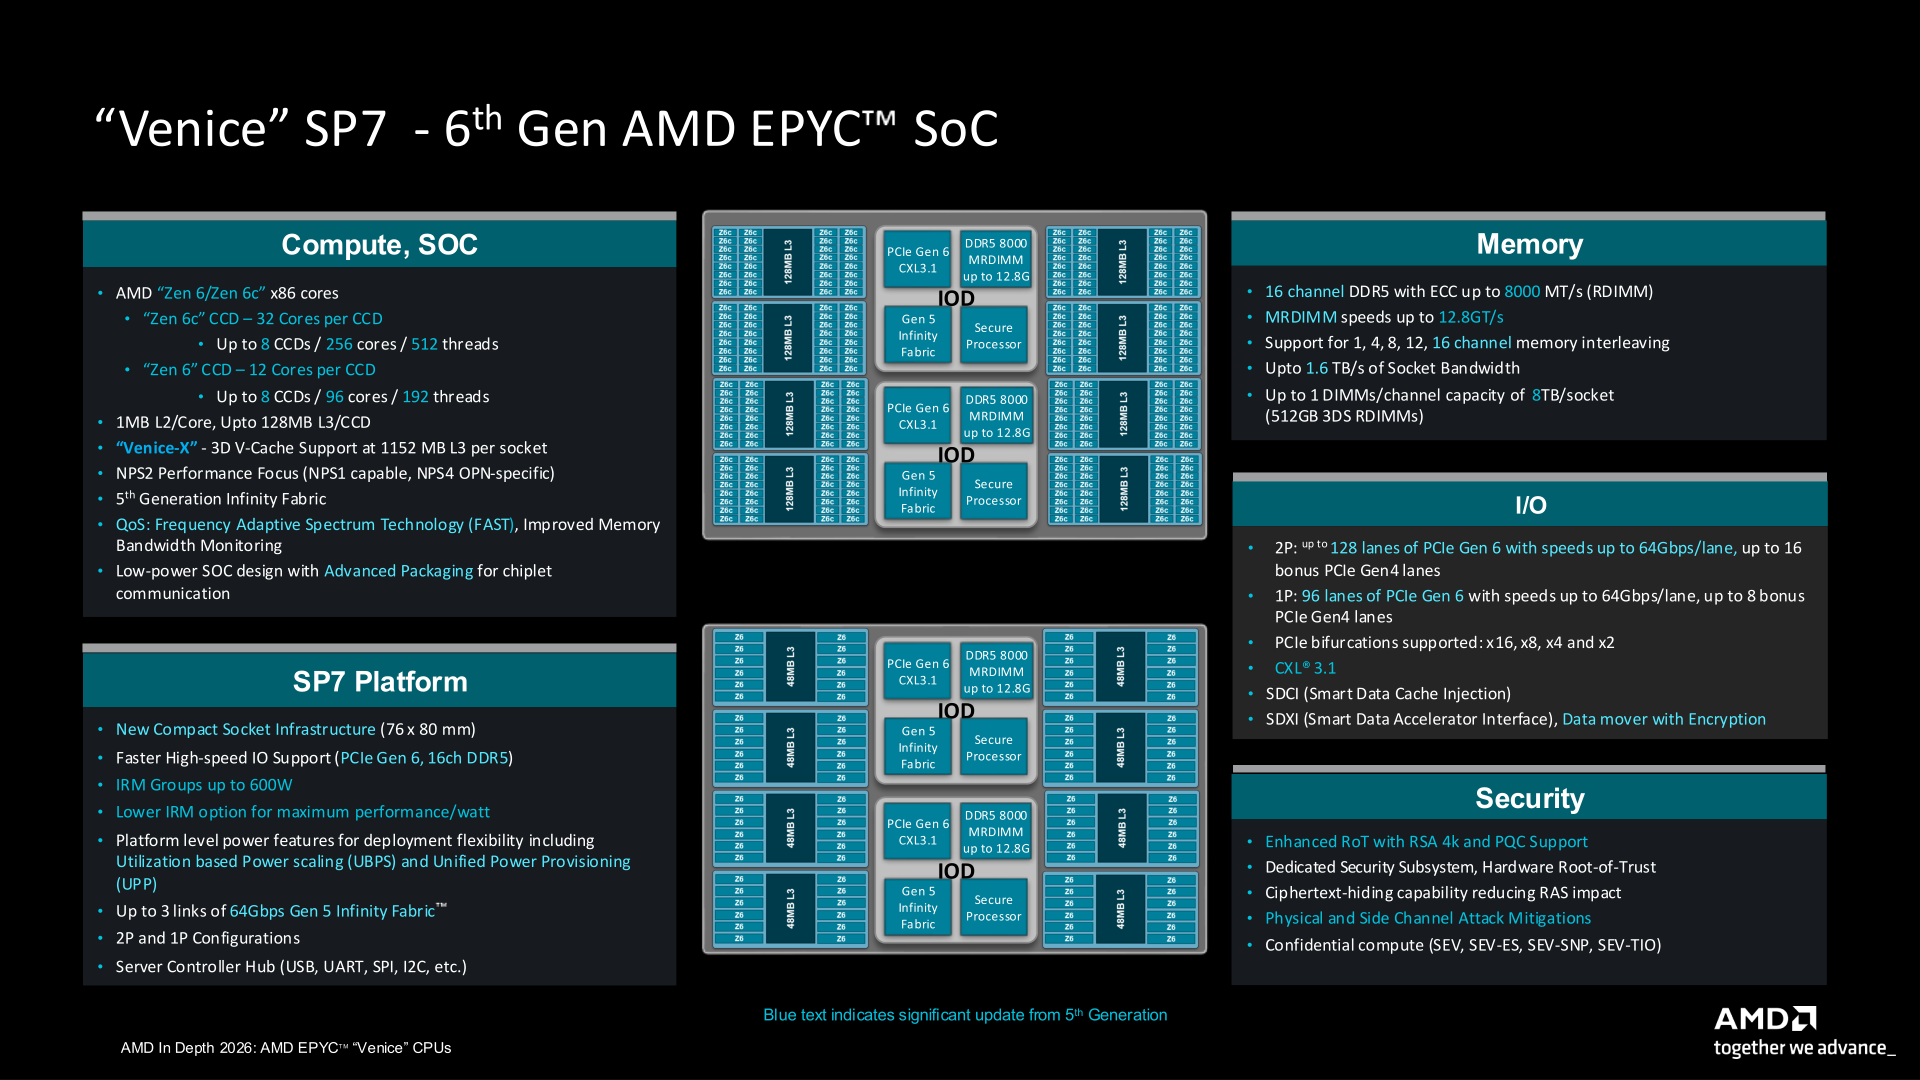
Что касается внешних устройств, новый IOD обеспечивает значительное увеличение пропускной способности интерфейсов благодаря поддержке стандартов PCIe 6.0 и CXL 3.1. Один кристалл IOD процессора Venice SP7 оснащён 48 блоками 64G SERDES, которые отвечают за работу обновлённых линий PCIe, а также 8 блоками 16G SERDES для других целей. В совокупности это даёт для чипа с разъёмом SP7 максимум 96 линиq PCIe 6.0, а также 8 «дополнительных» линий PCIe 4.0 для прочих нужд.
Также AMD существенно модернизировала технологию корпусирования, используемую для соединения CCD и IOD, отказавшись от применения традиционных органических подложек (2D-компоновка) в пользу комбинации технологии 2,5D-упаковки Elevated Fan-out Bridge (EFB) и кремниевых мостов.
Кристаллы IOD теперь соединяются с CCD посредством небольших кремниевых мостов (аналог EMIB от TSMC), благодаря чему CCD располагаются вплотную к IOD. Размещение кристаллов в непосредственной близости и передача сигналов через кремниевый интерпозер позволили AMD существенно снизить энергозатраты (в пересчете на пДж/бит) при обмене данными между кристаллами. Также это уменьшает задержки благодаря сокращению расстояния и использованию более быстрого интерконнекта. Хотя с другой стороны, это усложняет корпусирование и требует на него больше затрат.
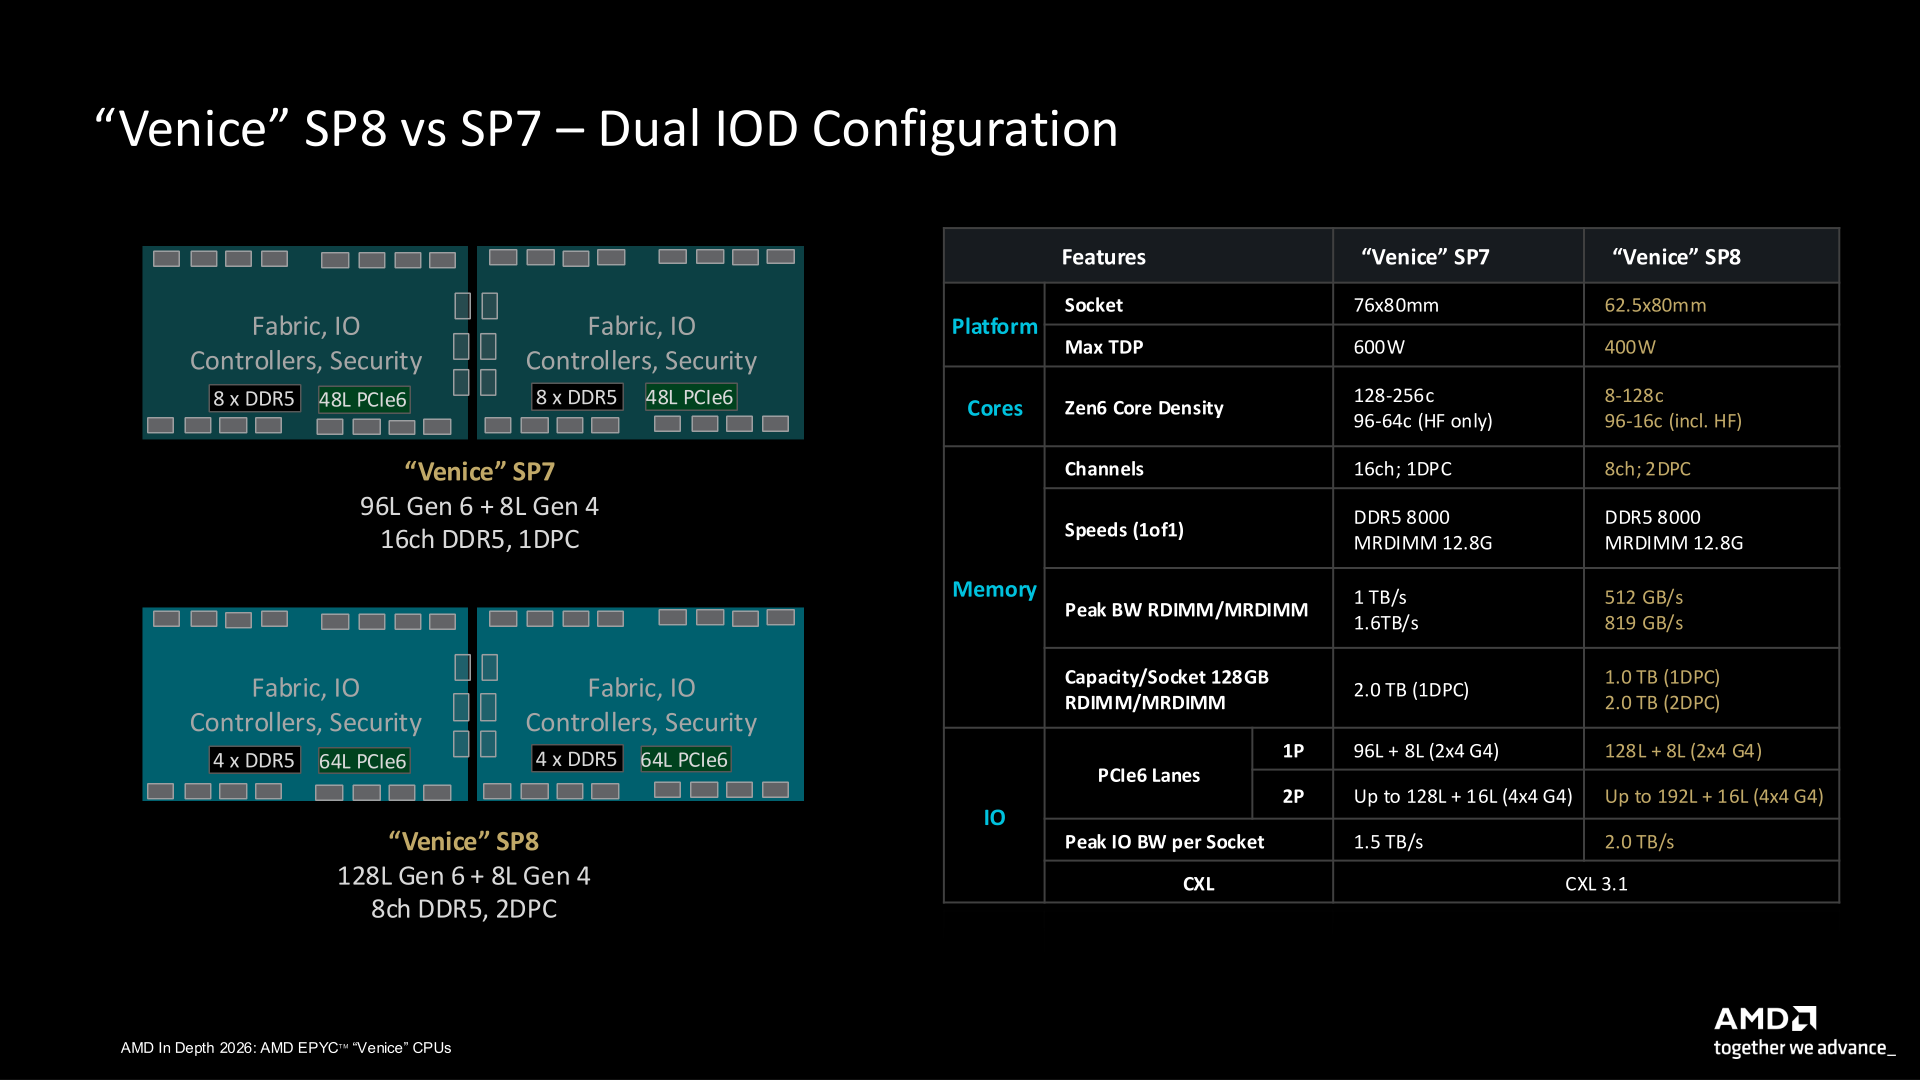
В свою очередь, для Venice с разъёмом SP8 был разработан отдельный, более компактный кристалл IOD, который, несмотря на уменьшенные размеры, тоже получил два кристалла в одном корпусе. При этом данный IOD спроектирован с меньшим акцентом на пропускную способность памяти и с бо́льшим упором на пропускную способность внешних интерфейсов I/O. В Venice SP8 количество каналов DDR5 сокращено с 16 до 8, что уменьшает пропускную способность памяти вдвое, но позволяет использовать конфигурацию 2DPC (правда, суммарный объём тот же, что у Venice SP7). Точно так же поддерживаются модули DDR5-8000 RDIMM и DDR5-12800 MRDIMM (1DPC).
Потеря в пропускной способности памяти у Venice SP8 компенсируется увеличенным количеством линий PCIe. Каждый кристалл IOD предоставляет 64 линии PCIe 6.0/CXL 3.1, что в сумме составляет 128 линий в односокетной (1S) конфигурации. Это на 32 линии (2 root-порта) больше, чем у Venice SP7. То есть интерфейс CXL 3.1 с поддержкой PCIe 6.0 масштабируется до 96 линий на сокет в системе SP7 и до 128 линий на сокет в системе SP8. При этом каждая конфигурация x16 обеспечивает «сырую» пропускную способность до 128 Гбайт/с с задержкой, соответствующей одному переходу в рамках архитектуры NUMA.
Платформа Venice SP7 может использоваться как в одно-, так и в двухсокетной конфигурации. Как и в случае с поколением Turin, переход на двухсокетную схему требует выделения части линий PCIe от каждого процессора: они переназначаются в качестве линий xGMI, обеспечивающих обмен данными между двумя процессорами. При таком объединении двух чипов обычно задействуется по 32 линии PCIe от каждого из них. В результате для подключения периферийных устройств остается 128 линий PCIe 6.0 (по 64 линии на каждый процессор).
Также можно увеличить пропускную способность канала между чипами Venice SP7, пожертвовав еще одним блоком из 16 линий PCIe (то есть третьим root-портом). Это позволяет довести эквивалентную пропускную способность канала между процессорами до уровня 48 линий PCIe/xGMI, оставляя 96 линий (по 48 на каждый процессор) для других целей I/O.
В связи с дефицитом памяти и её растущей стоимостью, в платформе Venice испльзуется ряд технологий памяти, призванных помочь операторам снизить издержки, связанные с использованием DRAM. Во-первых, обеспечена поддержка стандарта CXL, который актуальной версии 3.1 предоставляет широкие возможности для расширения памяти. Операторы могут использовать имеющиеся у них модули памяти DDR4 и DDR5 RDIMM, устанавливая их в специальные расширители CXL, что дает возможность нарастить общий объём доступной серверу памяти. Также с этой целью используются разработки компании MEXT, приобретённой AMD в июне, которая позволяет с помощью программных инструментов эффективно увеличить объём доступной памяти.
Если вы заметили ошибку — выделите ее мышью и нажмите CTRL+ENTER. | Можете написать лучше? Мы всегда рады новым авторам.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.