«Ты моя скотина…» и другие аэрогрильные песни: как нейросети различают звуки и генерируют музыку
Всего за неделю трек DJ NARODNII «Ты моя…» взорвал интернет: под него сняли более 150 тыс. видео. Сам автор называл песню иронией над некачественной ИИ-музыкой, её слушателями и всей ситуацией с ИИ-контентом в целом. Интересно, что пародия на шаблонный нейротрек сама стала самым обсуждаемым нейротреком осени и получила прозвище «гимн аэрогриля».
Чтобы понять, почему так вышло, нужно разобраться, как нейросеть воспринимает и воспроизводит звук, из чего собирает мелодию, вокал и почему её музыка звучит узнаваемо.
Что случилось: от стеба к «гимну»
Песня построена на контрасте: приторная поп-мелодия, гладкий «нейросетевой» вокал и текст, состоящий из грубых обращений к возлюбленной. По замыслу автора, это пародия на шаблонные ИИ-треки с сахарными мелодиями и незамысловатыми текстами о любви.
Аудитория поняла трек по-разному. Некоторые действительно приняли его всерьез, а другие разглядели в нем ту самую метаиронию и дисс на любителей безвкусной нейромузыки. По крайней мере, автор в комментариях согласился с такой трактовкой. Были и те, кто обвинил песню в романтизации насилия и унижении женщин: люди стали жаловаться на трек стриминговым сервисам. Автор ответил критикам, что не нужно переносить вымышленные художественные образы на реальную жизнь.
По поводу «гимна аэрогриля» — такое прозвище трек получил от слушателей. Дело в том, что аэрогриль превратился в мем: с ним ассоциируется жизнь обывателя, который ездит на китайском авто, живет в ипотечной новостройке, покупает одежду на маркетплейсах, делает репосты в надежде выиграть роллы… и слушает ИИ-песни вроде «Ты не бойся ночи» и «Ты моя скотина». Эта унылая и заурядная, по мнению пользователей интернета, жизнь стала объектом высмеивания, поэтому она часто встречается в пародиях и мемах.
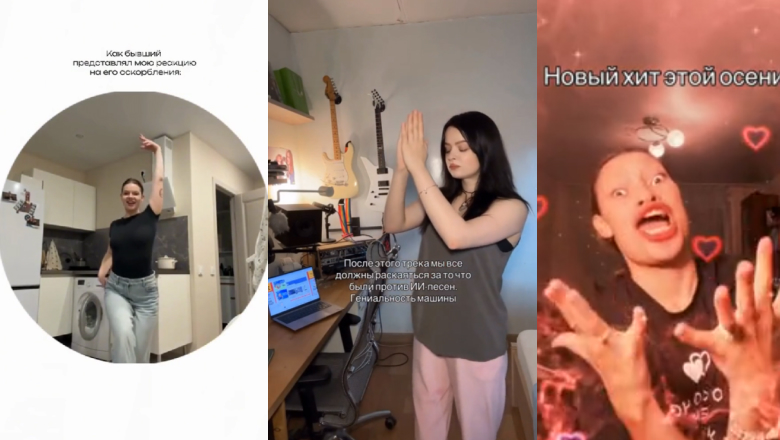
У трека есть предшественник: слушатели называют его новым хитом после «Не бойся ночи», другой нейросетевой песни, которая разошлась по соцсетям раньше. У автора есть и другие ИИ-треки на основе мемов. Получается, автор хотел высмеять формулу нейропесни и тем самым доказал, что она работает. Чтобы понять, что это за формула, спустимся на уровень звука.
Нейромузыка в цифрах
Несколько цифр, которые объясняют, почему вирусный нейротрек сейчас уже никого не удивляет.
По данным оператора Yota, в 2026 году трафик на музыкальные нейросети вырос больше чем на 20%, а проведённое в них время на 45% год к году.
В феврале 2026 года Suno сообщила о более чем 2 млн платных подписчиков и $300 млн годовой регулярной выручки.
В июле 2026 года Suno встроила генерацию песен в iMessage на iPhone: на волне тренда, когда пользователи превращают переписки в песни, текст или голосовое сообщение можно сразу превратить в трек прямо в чате.
Как нейросеть воспринимает звук
Звук — это последовательность чисел
Для компьютера звук — это колебания давления, записанные как последовательность чисел. CD-качество означает 44 100 измерений в секунду на каждый канал. Минута стереозаписи — это больше 5 млн чисел. Работать с таким потоком напрямую неудобно: последовательность огромная, а соседние значения почти ничего не говорят о том, что звучит, нота это, согласная или удар барабана.
Спектрограмма: звук как картинка
Первый шаг почти любой аудионейросети — превратить звук в спектрограмму. Запись режется на короткие перекрывающиеся окна, и для каждого окна считается, какие частоты в нём звучат и с какой силой. Получается картинка: по горизонтали время, по вертикали частота, яркость показывает громкость.
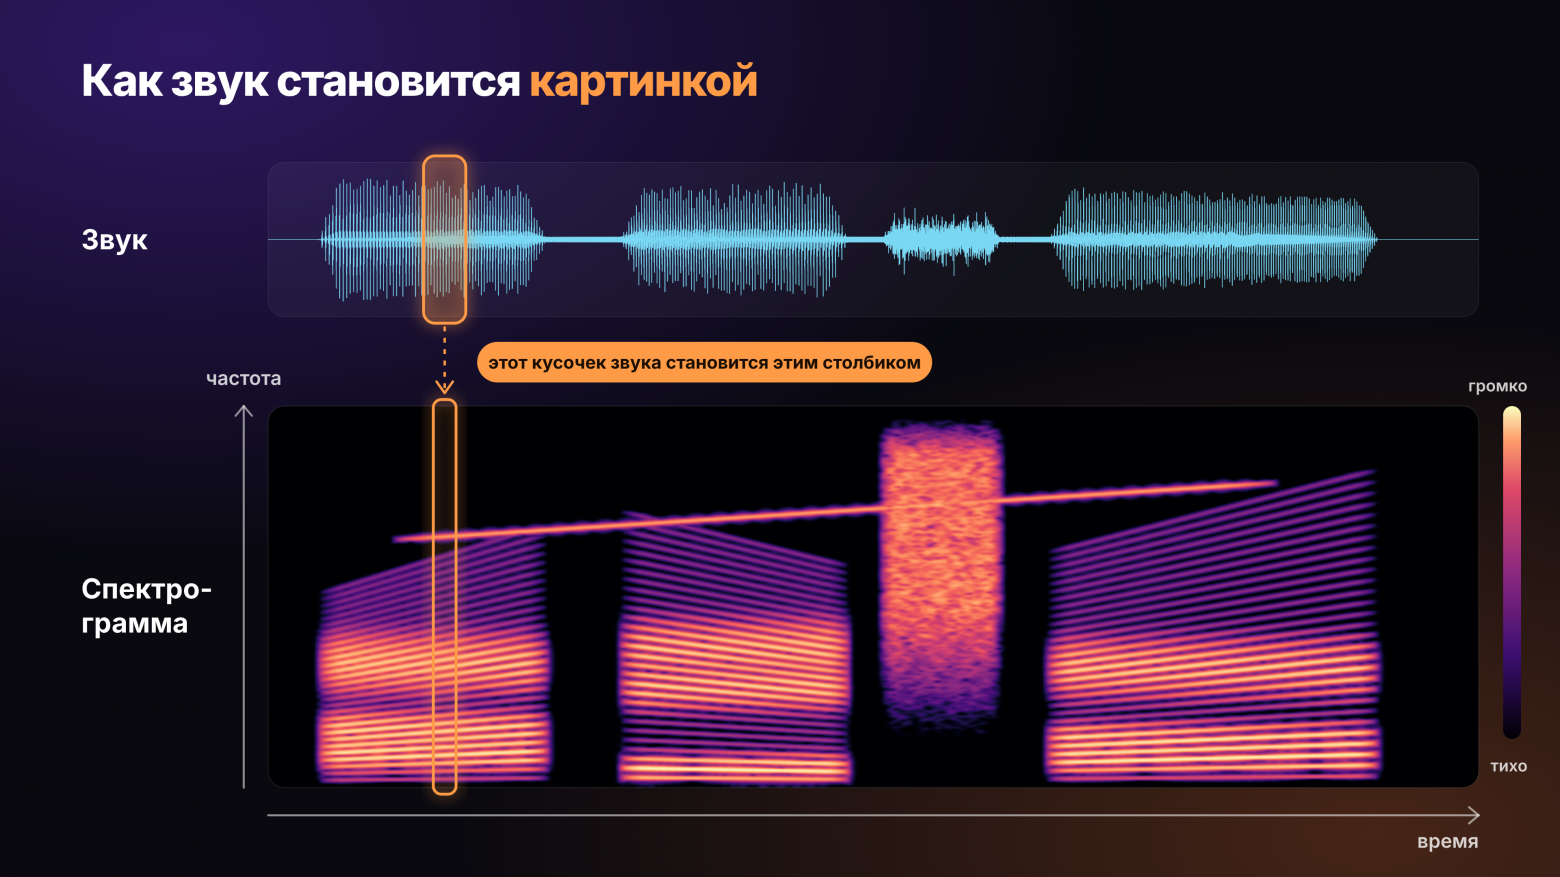
Частоты обычно переводят в мел-шкалу. Она повторяет устройство человеческого слуха: разницу между 200 и 300 Гц мы слышим отчётливо, а между 10 000 и 10 100 Гц почти не замечаем. Мел-шкала растягивает низкие частоты и сжимает высокие, чтобы модель тратила внимание там же, где его тратит ухо.
Так устроена, например, модель распознавания речи Whisper от OpenAI, вышедшая в сентябре 2022 года. Она обучена на 680 000 часах аудио с расшифровками. Звук передискретизируется до 16 кГц и превращается в лог-мел-спектрограмму из 80 каналов, с окнами по 25 миллисекунд и шагом 10 миллисекунд. Дальше трансформер работает с этой картинкой почти так же, как модели компьютерного зрения работают с изображениями.
Аудиотокены: звук как текст
Для генерации музыки одной спектрограммы мало: из неё сложно восстановить качественный звук. Поэтому генеративные модели используют нейросетевые аудиокодеки. Кодек сжимает звук в последовательность дискретных кодов — аудиотокенов, — а потом умеет восстановить из них звук.
Один из первых таких кодеков, SoundStream, Google представила в 2021 году. Ключевая идея в нём — остаточное векторное квантование (residual vector quantization): первый уровень кодов описывает звук грубо, второй кодирует то, что первый упустил, третий — остаток второго, и так далее. Чем больше уровней, тем точнее звук.
Когда звук превращён в токены, к нему можно применить ту же технику, что и к тексту: обучить трансформер предсказывать следующий токен. Языковая модель предсказывает следующее слово, музыкальная — следующий фрагмент звука.
Как звук связывают со словами
Чтобы модель понимала запрос «грустная поп-песня с женским вокалом», нужна связь между звуком и текстом. Для этого обучают отдельные модели, которые помещают аудио и его описание в общее пространство векторов: похожие по смыслу звук и текст оказываются рядом. Google для MusicLM обучала такую модель, MuLan, на саундтреках 44 млн онлайн-видео и их текстовых описаниях. Stable Audio от Stability AI использует для той же задачи текстовый энкодер CLAP.
Как нейросеть сочиняет музыку
Подход 1: предсказание аудиотокенов
Jukebox от OpenAI в 2020 году показала, что нейросеть может генерировать музыку с вокалом в заданном жанре и стиле исполнителя. Модель обучили примерно на 1,2 млн песен, но генерация одной минуты аудио занимала больше девяти часов вычислений.
MusicLM от Google в начале 2023 года сделала подход практичным. Её обучили на 280 000 часах музыки и выстроили иерархию токенов:
аудио-текстовые токены MuLan задают связь с описанием;
семантические токены, 25 в секунду, описывают крупную структуру композиции: ритм, гармонию, развитие;
акустические токены SoundStream, 600 в секунду, отвечают за тембр и мелкие детали звука.
Одна серия трансформеров генерирует семантические токены, вторая по ним — акустические, а декодер SoundStream превращает их в звук. MusicLM выдавала 30-секундные клипы с частотой 24 кГц.
Похожая трёхступенчатая схема есть в открытой модели Bark, которую сама компания Suno выпустила в апреле 2023 года под лицензией MIT. Первый трансформер переводит текст в семантические токены, второй превращает их в «грубые» акустические токены (первые два уровня кодека), третий восстанавливает все восемь уровней. Bark рассчитана в первую очередь на речь, но умеет генерировать музыку, фоновые шумы и невербальные звуки вроде смеха и вздохов.
Подход 2: диффузия
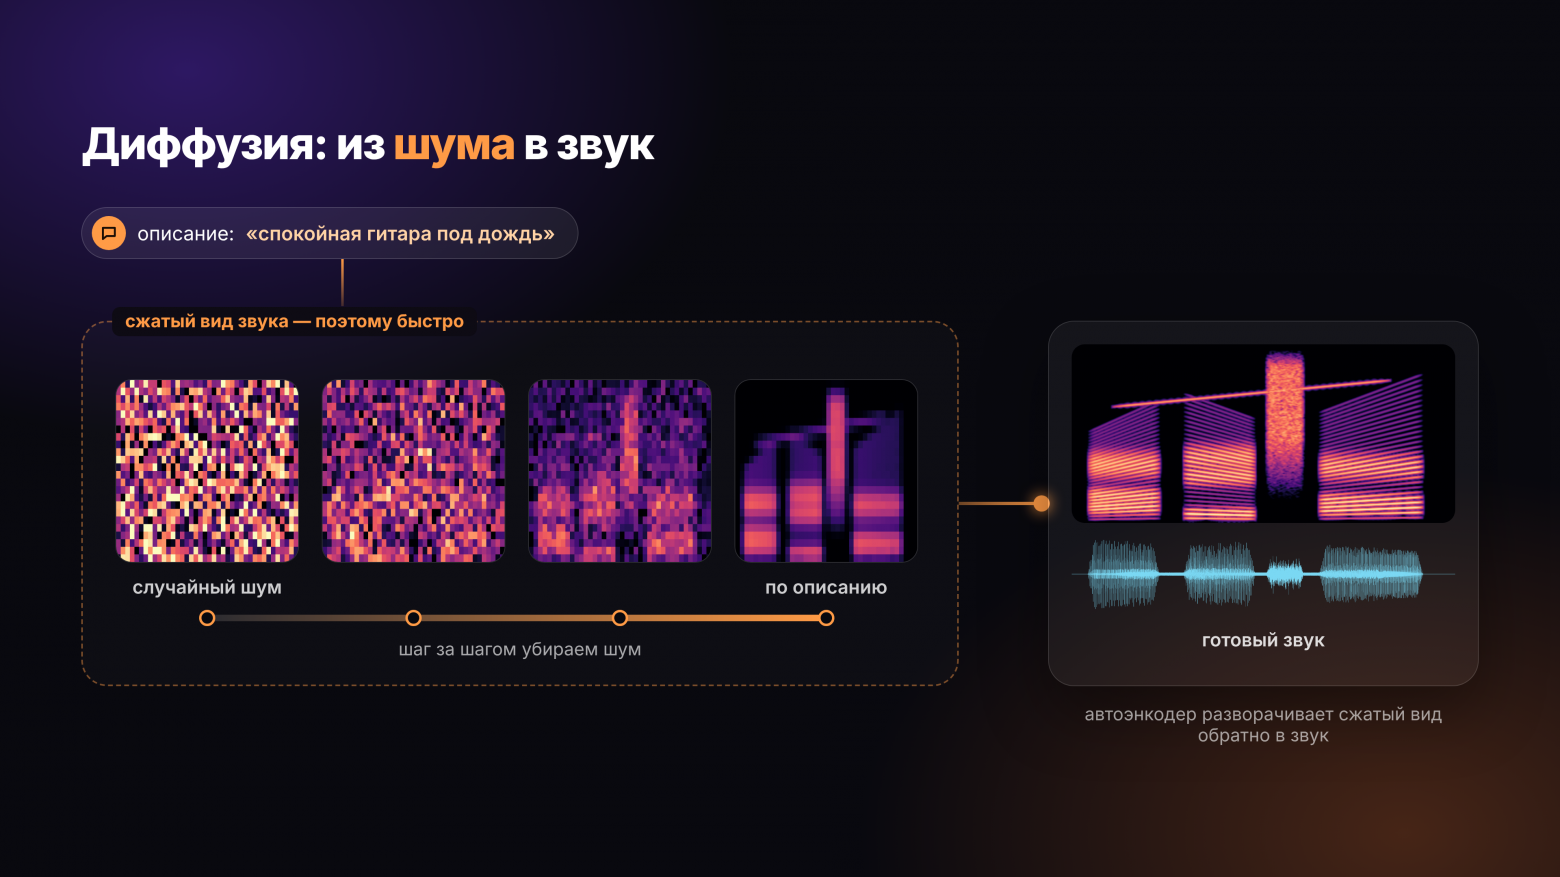
Второй путь пришёл из генерации изображений. Диффузионная модель начинает со случайного шума и шаг за шагом убирает его, двигаясь к звуку, который соответствует описанию. Чтобы это было быстро, диффузия работает не с самим звуком, а с его сжатым представлением в латентном пространстве автоэнкодера.
Stable Audio от Stability AI построена именно так: вариационный автоэнкодер, текстовый энкодер CLAP и диффузор на 907 млн параметров. Модель обучена на более чем 800 000 аудиофайлов общей длительностью больше 19 500 часов, лицензированных у библиотеки AudioSparx. По данным разработчиков, она генерирует 95 секунд стереозвука с частотой 44,1 кГц меньше чем за секунду на ускорителе A100. Отдельная находка — кондиционирование по времени: модели сообщают, с какой секунды начинается фрагмент и какой длины должен быть трек, поэтому она умеет строить вступление и концовку, а не обрывать музыку на полуслове.
Что известно про Suno
Архитектуру своих коммерческих моделей Suno не раскрывает. Публичная информация ограничивается Bark и описаниями возможностей. Судя по тому, что модель одновременно генерирует вокал с внятным текстом и аранжировку, в ней сочетаются оба подхода: языковое моделирование токенов для структуры и текста и что-то вроде диффузионного уточнения для качества звука. Но это реконструкция по косвенным признакам, а не документированный факт.
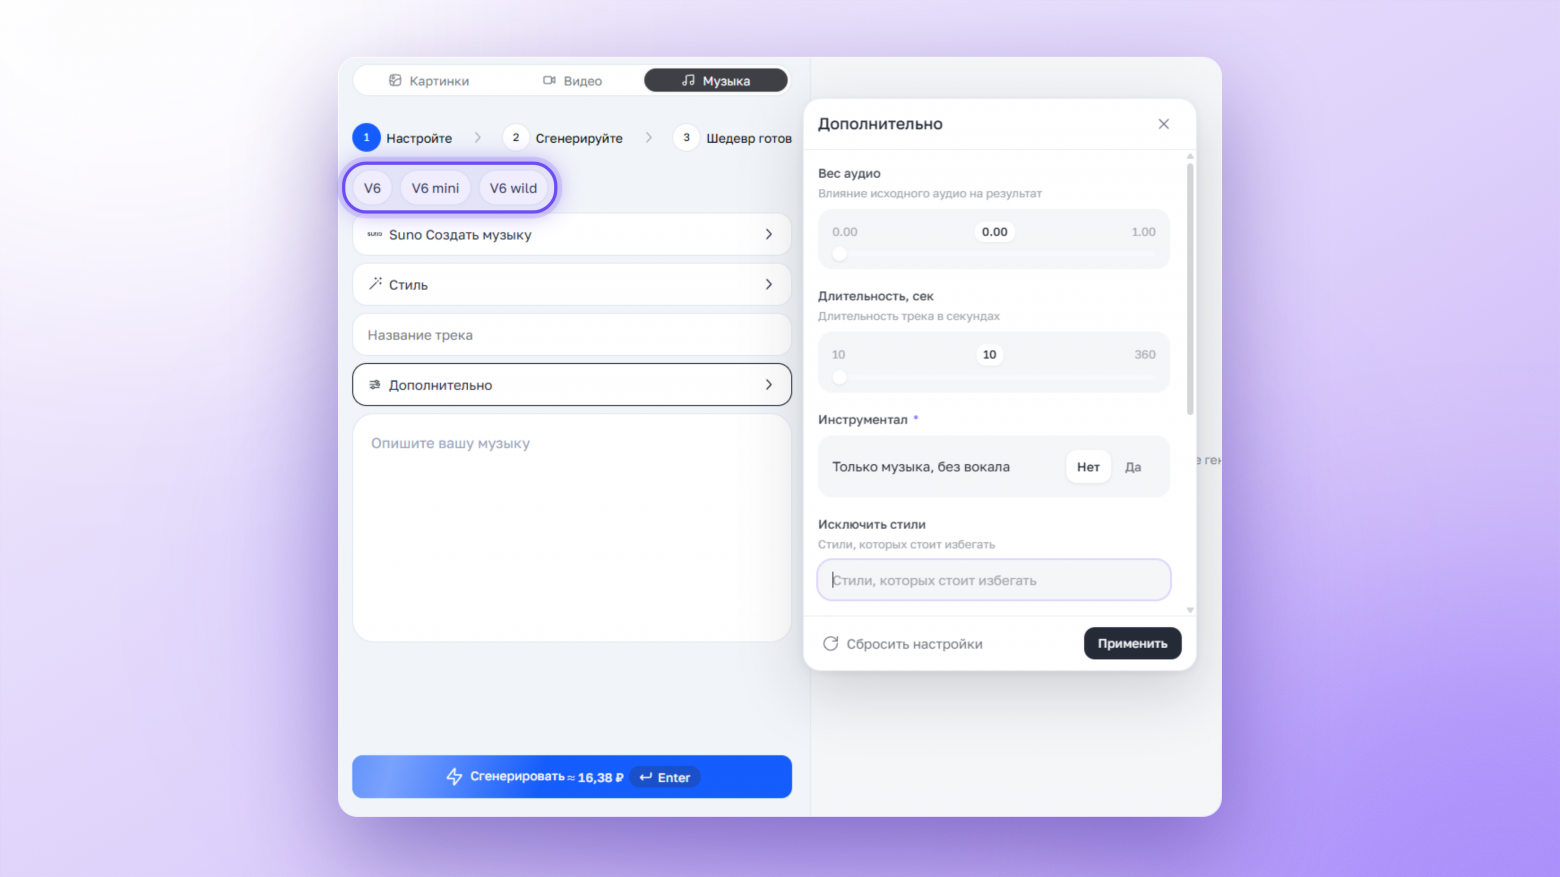
Зато известно, что умеет актуальная версия. Семейство v6 состоит из трёх моделей: флагманской v6, более непредсказуемой v6-wild и быстрой v6-mini, доступной бесплатно. В v6 можно переписать отдельную секцию трека или одну строку текста без перегенерации всей песни, собрать мэшап из нескольких своих треков и взять риф по таймкоду. На вход модель принимает текст, аудио, изображение, видео или их комбинацию.
Важный практический вывод из обоих подходов: Suno и аналоги не склеивают готовые сэмплы. Они генерируют новый звуковой сигнал, токен за токеном или шаг за шагом очищая шум.
Почему нейромузыка звучит «так»
У нейротреков есть узнаваемый звук, и это прямое следствие того, как они устроены.
Усреднённость
Текстовый запрос «русская поп-баллада» превращается в вектор, который смещает вероятности: на каждом шаге модель выбирает то, что статистически типично для жанра. Получается музыка, похожая на весь жанр сразу и ни на одну песню в отдельности. Сильные неожиданные решения — смена тональности, необычный ритм, рискованная гармония — статистически маловероятны и появляются редко, если их прямо не попросить.
Безупречный вокал
ИИ-голос обучен на огромном количестве записей, где пение в основном чистое и правильное. Он не срывается, не фальшивит, не дышит не вовремя. Именно эта безупречность слушатель воспринимает как «пластик»: в живом исполнении мелкие неточности и есть характер.
Русский вокал
Пользователи регулярно замечают, что русский вокал у музыкальных нейросетей звучит менее естественно, чем английский: ударения в целом правильные, но разговорная интонация и тонкая фонетика теряются. Состав обучающих данных Suno не раскрывает, поэтому причину можно только предполагать. Наиболее вероятное объяснение — англоязычной музыки в любом крупном аудиокорпусе намного больше. Для фоновых роликов в соцсетях этого качества обычно хватает, для полноценного релиза часто нет.
Парадокс трека DJ NARODNII в том, что все эти недостатки сработали на него. Пародия держится на узнаваемом нейросетевом звучании.
Формула вирусного нейротрека
По волне нейрохитов 2026 года видны общие черты.
В музыкальных генераторах описание стиля и текст песни задаются отдельно. Стиль удобнее описывать на английском, потому что именно такими тегами размечена большая часть обучающих данных, а текст пишется на нужном языке. Пример описания стиля для сладкой поп-пародии:
Russian pop ballad, sugary synth melody, glossy female vocal, slow tempo 85 bpm, soft drum machine, dreamy reverb, catchy chorus, radio-friendly 2010s sound
И для противоположного эффекта, когда нужен «живой» звук:
Lo-fi indie rock, male vocal with slight rasp, imperfect timing, live drums, room ambience, warm analog tape saturation, intimate and raw
Обратите внимание на «imperfect timing» и «slight rasp» во втором примере: прямые указания на неидеальность — один из немногих способов увести модель от «пластикового» звучания.
Как создать нейротрек в России
Подписку Suno на официальном сайте оплатить из России напрямую не получится: нужна зарубежная карта. А флагманские v6 и v6-wild доступны только на платных тарифах Pro и Premier.
В SpeShu.AI Suno работает в одном окне с ещё 300 с лишним нейросетями: в ней можно генерировать песни и продлевать готовые треки. Оплата идёт за фактическое использование, баланс пополняется в рублях через СБП. Удобно и то, что в одном окне есть текстовые модели: черновик текста песни можно написать в ChatGPT или Claude и сразу отправить в музыкальный генератор, не переключаясь между сервисами.
Гайд «Как выжать 1000% из текстовых нейросетей» пригодится на этапе текста песни. Хороший трек начинается с хорошего текста, а текстовые нейросети пишут его намного лучше, если правильно поставить задачу: задать размер, рифмовку, настроение и запретить банальные рифмы.
Частые ошибки
Описывать стиль слишком общо
Запрос «красивая песня про любовь» даст максимально усреднённый результат. Указывайте жанр, темп, тип вокала, инструменты, эпоху звучания и настроение.
Не размечать структуру текста
Без меток куплета, припева и бриджа модель сама решает, где что петь, и часто повторяет не тот фрагмент. Размечайте текст явно, тогда припев будет звучать как припев.
Ждать идеальный трек с первой генерации
Результаты одного и того же запроса сильно различаются. Обычно делают несколько вариантов и берут лучший, а в v6 можно перегенерировать только неудачную секцию.
Копировать стиль конкретного исполнителя
Многие сервисы не принимают имена артистов в описании стиля, а трек, слишком похожий на чужую песню, рискует получить претензию от правообладателя. Описывайте звучание словами: жанр, эпоха, тембр.
Публиковать без маркировки
Скрытое использование ИИ подрывает доверие аудитории, а площадки всё чаще требуют помечать сгенерированный контент. Указывайте использование нейросетей в описании релиза.
Забывать о содержании
Провокационный текст может принести охваты, но и волну обвинений, и жалобы на трек. Кейс «Ты моя…» показывает: ирония считывается не всеми, и за смысл отвечает автор, а не нейросеть.
Заключение
Нейросеть «слышит» звук как спектрограмму или последовательность аудиотокенов, сочиняет музыку, предсказывая токены или очищая шум, а звучит узнаваемо потому, что выбирает статистически типичное для жанра. Трек «Ты моя…» задумывался как насмешка над этой типичностью и стал её лучшей иллюстрацией: усреднённая мелодия, безупречный вокал и мемный текст сложились в формулу, которая работает именно потому, что узнаётся с первых секунд.
Технология сделала музыку дешёвой и быстрой, но смысл, контекст и ответственность по-прежнему остаются за человеком. Поэкспериментировать с Suno и текстовыми моделями в одном окне можно в SpeShu.AI. По промокоду HABRSPESHUAI действует бонус 15% к сумме пополнения.
Частые вопросы
Как нейросеть создаёт музыку?
Сначала звук переводится в понятный модели вид: спектрограмму или последовательность аудиотокенов через нейросетевой кодек. Затем модель либо предсказывает следующий токен, как языковая модель предсказывает слово, либо постепенно очищает шум до нужного звука, как генераторы изображений. Готовые сэмплы при этом не склеиваются.
Как работает Suno?
Архитектуру коммерческих моделей Suno не раскрывает. Известно, что компания выпустила открытую модель Bark с трёхступенчатой генерацией аудиотокенов, а актуальное семейство v6 вышло в сентябре 2026 года и умеет перегенерировать отдельные секции и строки трека.
Почему нейросетевые песни звучат одинаково?
Модель выбирает то, что статистически типично для заданного жанра, поэтому результат похож на «средний» трек. Неожиданные музыкальные решения маловероятны, если их прямо не попросить. Безупречный вокал без мелких неточностей тоже воспринимается как искусственный.
Почему русский вокал в нейросетях звучит хуже английского?
Состав обучающих данных компании не раскрывают, но англоязычной музыки в крупных корпусах обычно намного больше. Поэтому ударения модель ставит в целом правильно, а разговорная интонация и тонкая фонетика русского языка передаются хуже.
Можно ли публиковать песни, созданные нейросетью?
Да, но правила зависят от тарифа сервиса и площадки, где вы публикуете трек. Стоит проверить условия коммерческого использования в выбранном тарифе, не копировать стиль конкретных исполнителей и указывать использование ИИ в описании релиза.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.