Нафиг NVIDIA! Часть 2. Запустил 8 нейросетей на FPGA за $50 — и упёрся в DDR3
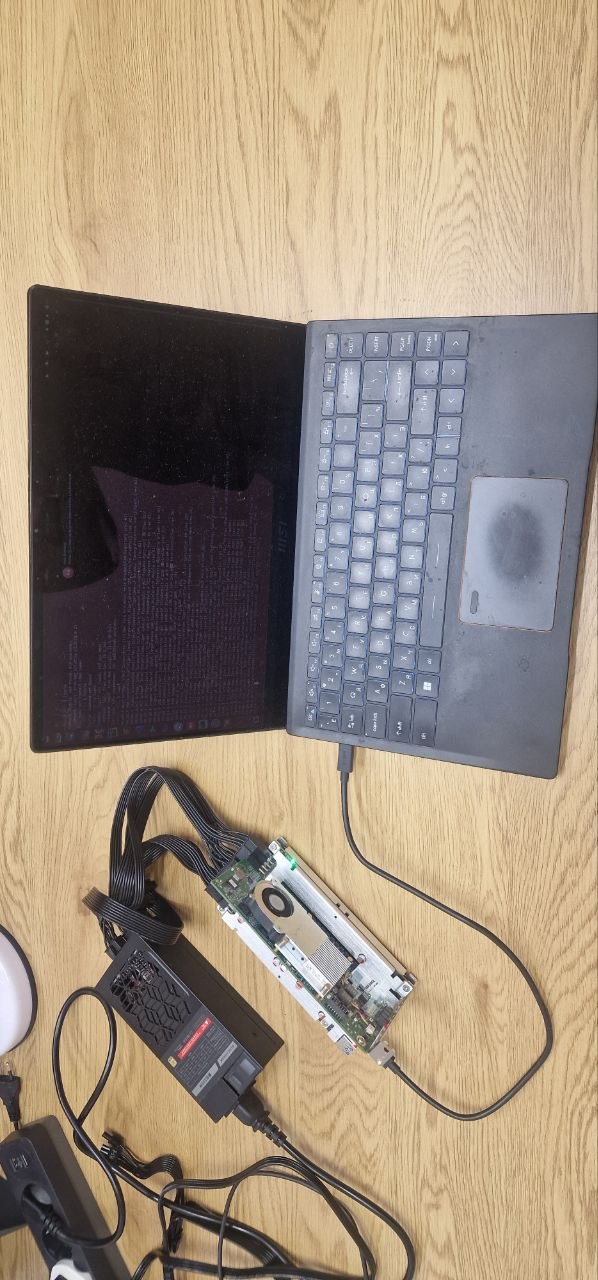
В первой части я рассказал, как запустил Qwen на списанной FPGA-плате за $50 с открытым TPU (openTPU). Комментаторы справедливо заметили: это больше анонс, чем статья. Где сборка, где кристалл, где замеры, почему 133 МГц, где КЕДР?
Мы с Вами соберем прошивку в Vivado, раскрасим кристалл по модулям, разложим 9,7 ватта по блокам и прогоним 165 запусков восьми языковых моделей. Главный результат оказался не тем, которого я ждал: матрица из 512 умножителей выдаёт 121 GOPS из 136,5 возможных, а при генерации текста ей достаётся меньше четверти - потому что память DDR3 работает на 94 % своего предела и быстрее подвезти веса просто не может.
Коротко
Железо: Inspur YPCB-00338, Kintex-7 XC7K480T-2, 2 × 2 ГиБ DDR3-1066, PCIe Gen2 x8.
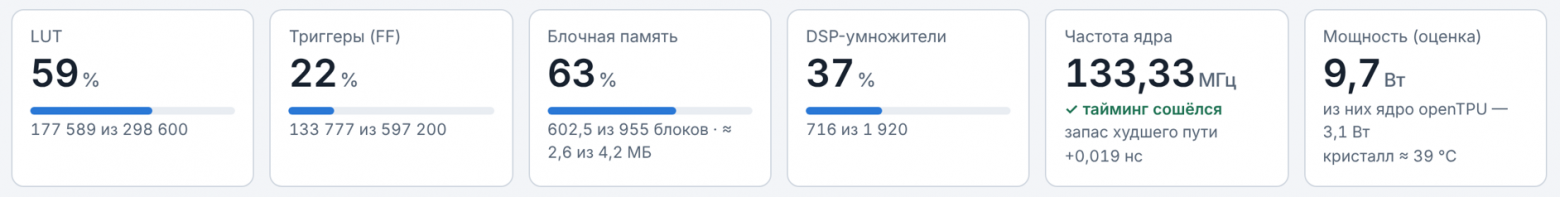
Моя сборка в Vivado: ядро 133,33 МГц, запас по таймингу 19 пикосекунд (я адепт положительного
ШСЛАКА, мало ли кто с отрицательными работает). Занято 59 % LUT, 63 % BRAM, 37 % DSP, 76 % слайсов.Проверка на плате: 138 аппаратных тестов, три прогона подряд. 165 запусков LLM, все завершились успешно.
Скорость: Qwen3.5-2B - 12,5 ток/с, Qwen3-0.6B - 35, LFM2.5-230M - 95 (веса 4 бита).
Узкое место: при генерации, DDR3 загружена на 92–96 %. Поэтому PCIe x1 вместо x8 почти ничего не меняет (кроме загрузки в память из компа), а 4-битные веса вместо 8-битных ускоряют в 1,4-1,8 раза.
По итогам опроса Вы больше всего хотели сборку с нуля (59 %) и устройство TPU (51 %), дальше - грабли (37 %), стоимость (35 %) и сравнение моделей (29 %). Всё это есть, в таком порядке, чтобы шло от железа к цифрам.
Пссс…⚡ Для тех, кто быстрый, как Flash, Куда прыгать:
Ну а кто засел надолго и хочет нырнуть полностью погнали) ↓
1. Железо и почём нынче эксперимент с КЕДРом?
Плата
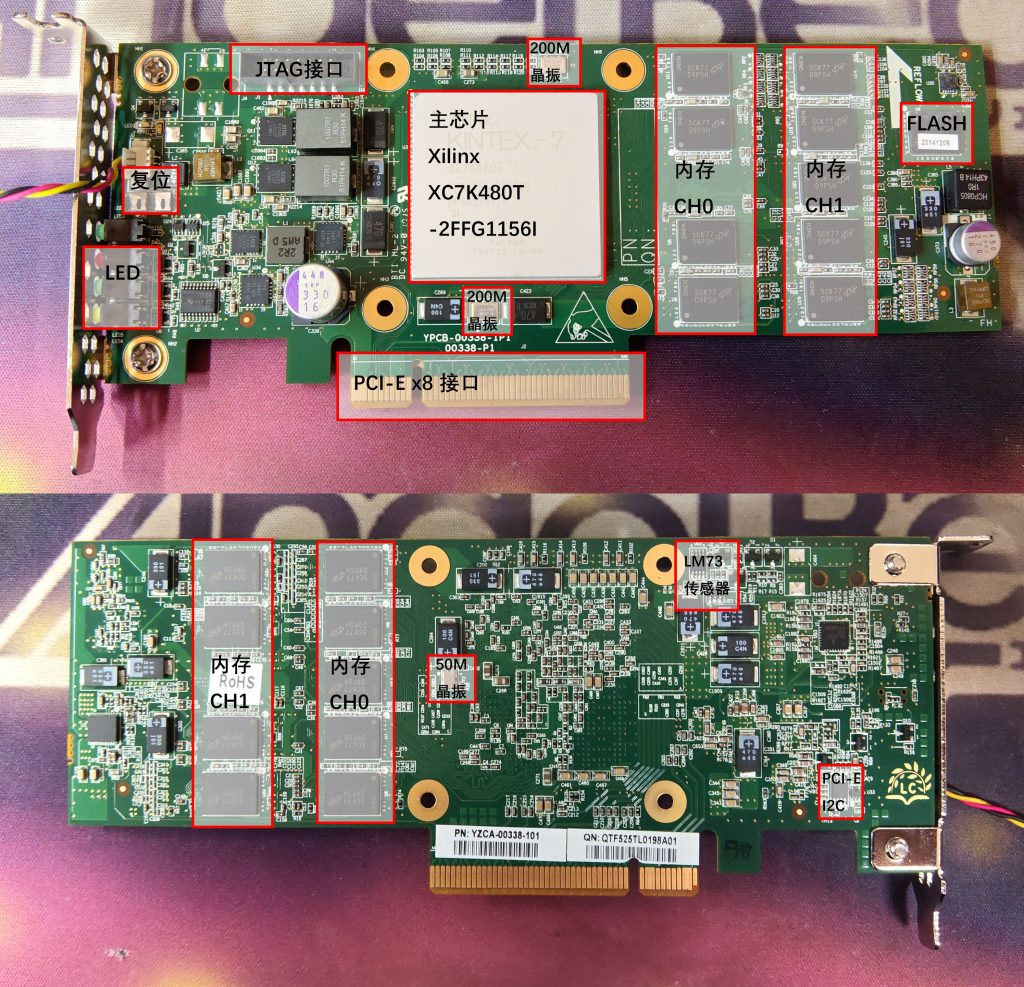
Inspur YPCB-00338 - это какая-то списанная карточка, сливают ее на нашем любимом AliExpress и eBay. Для наших целей в ней три важные вещи:
Kintex-7 XC7K480T-2 (алмазик) - 299 тыс. LUT, 1920 умножителей DSP48E1, 955 блоков памяти по 36 Кбит (~ 34 Мбит на всём кристалле).
Два канала DDR3-1066 (теперь и ты алмазик) по 2 GB, каждый шириной 64 бита данных плюс 8 бит ECC. ECC защищает от ошибок, но к скорости ничего не добавляет: полезных бит 64.
PCIe x8, по которому плата разговаривает с компьютером.
34 Мбит памяти на кристалле - это ни о чём для LLM: даже Qwen3-0.6B в 4 битах весит в сотню раз больше. Значит, веса живут в DDR3, и, забегая вперёд, именно DDR3 определит скорость, Вы это и так знаете, не буду умничать.
Стенды
Плата побывала в нескольких компьютерах - получилось сравнить разные PCIe.
Стенд | Что это | PCIe |
|---|---|---|
ПК | Windows, Intel Core i9-14900KF, 64GB DDR, 4T SSD, Vivado 2024.2.2 | - |
A | Бука для нот (Notebook), Ubuntu 24.04, плата снаружи через USB4 с туннелем PCIe (TH3P4G3), 16GB DDR, 2T SSD, i7-1185G7, блок питания (METALFISH Black Diamond 550M), кабель USB4 Type-C (в комплекте с TH3P4G3) | Gen2x1(Gen2x4) |
B | MINISFORUM MS-A2, Ubuntu 22.04, плата в слоте, AMD Ryzen 9 9955HX, 64GB DDR, 2T SSD | Gen2x8 |
Все замеры в статье - со стенда B, где плата работает на полной скорости PCIe.
Сколько стоит
$50 из заголовка - цена самой платы ( сам чип, как подметили в комментариях к прошлой статье, стоит дорого). Указываю цены за которые сам урвал.
На Aliexpress лучше искать XC7K480T и смотреть по фото и другим, конечно могут и болт прислать, у меня такое как-то было :xD.
Полный стенд дороже:
Что | Цена |
|---|---|
Плата YPCB-00338 | ~$50 |
Доставка | от 0 до бесконечности (у меня ~$10 вышла) |
JTAG-программатор: | ~$40 |
USB4 с туннелем PCIe (для конфигурации А) | ~$140 |
Блок питания (для конфигурации А) | ~$85 |
ПК | был |
Итого ~$100, если плата в слоте (плата 50 + доставка 10 + JTAG 40). Для стенда A через USB4 - ещё ~$225 на адаптер и блок питания.
Отдельный подводный камень - TH3P4G3 при прошивке платы (будет пропадать устройство PCIe) будет выключать питание платы, соответственно плату прошить не получится, так что не рекомендую для этого проекта (может как-то и можно отключить это, но честно не копался).
2. Собираем с нуля прошивку для камня
Что внутри прошивки
В Vivado собирается не только TPU. Прошивка - это четыре подсистемы на одном кристалле:
Ядро openTPU на Verilog: матрица, векторный блок, рабочая память, DMA, квантизатор, секвенсор.
Мост PCIe - IP-блок Xilinx XDMA.
Два контроллера DDR3 из проекта LiteDRAM вместо привычного Xilinx MIG. Внутри работает маленький процессор RISC-V (VexRiscv) - он при старте сам калибрует задержки DDR3. То есть на кристалле рядом с TPU крутится ещё и процессор, который нужен только для того, чтобы договориться с памятью.
Обвязка: мост от ядра к двум каналам памяти, регистры управления, аппаратный журнал событий.
Сборка
git clone https://github.com/FeSens/openTPU.git
cd openTPU
git checkout 8eaa480
Ревизию фиксирую специально: репозиторий живой, и на свежем main цифры могут отличаться.
Перед стартом необходимо установить Vivado 2024.2 или выше ( не проверял, могут возникнуть нюансы).
На Windows всё делает один PowerShell-скрипт - создаёт проект, генерирует IP, синтезирует, разводит и пишет bitstream :
run_vivado.ps1
param(
    [int]$DDR = 1066,
    [int]$JOBS = 8,  # как нагрузить процессор
    [int]$MCOLS = 4,
    [int]$VPU_CL = 2,
    [int]$LANES = 8,
    [int]$ACT_ROWS = 0,
    [int]$DSTEP = 1,
    [double]$CORE_MHZ = 0,
    [int]$PCIE_GEN = 2,
    [switch]$FAST,
    [switch]$ImplOnly,
    [string]$IMPL_STRATEGY = "",
    [string]$BUILD_ID = "00000000",

    # Измени этот путь под свою установку
    [string]$Vivado = "C:\Xilinx\Vivado\2024.2\bin\vivado.bat"
)

$ErrorActionPreference = "Stop"

$here = Split-Path -Parent $MyInvocation.MyCommand.Path
$root = (Resolve-Path (Join-Path $here "..\..")).Path
$out  = Join-Path $root "build\vivado"

if ($DDR -ne 1066) {
    throw "DDR3-$DDR is unsupported. LiteDRAM is generated for DDR3-1066."
}

if ($ACT_ROWS -eq 0) {
    $ACT_ROWS = $MCOLS
}

if ($CORE_MHZ -eq 0) {
    if ($FAST) {
        $CORE_MHZ = 100
    } else {
        $CORE_MHZ = 133.33
    }
}

if (!(Test-Path $Vivado)) {
    throw "Vivado not found: $Vivado"
}

New-Item -ItemType Directory -Force -Path $out | Out-Null

# Environment read by create_project.tcl / bd_native.tcl / build.tcl
$env:PCIE_GEN = "$PCIE_GEN"

if ($FAST) {
    $env:OTPU_FAST = "1"
} else {
    $env:OTPU_FAST = "0"
}

# Optional IP cache
$cache = Join-Path $env:LOCALAPPDATA "openTPU\vivado-ip-cache"
New-Item -ItemType Directory -Force -Path $cache | Out-Null
$env:OTPU_IP_CACHE = $cache

$createTcl = Join-Path $here "vivado\create_project.tcl"
$buildTcl  = Join-Path $here "vivado\build.tcl"

Write-Host ""
Write-Host "openTPU Vivado build"
Write-Host "-------------------"
Write-Host "Root       : $root"
Write-Host "Output     : $out"
Write-Host "DDR        : $DDR"
Write-Host "CORE_MHZ   : $CORE_MHZ"
Write-Host "MCOLS      : $MCOLS"
Write-Host "VPU_CL     : $VPU_CL"
Write-Host "LANES      : $LANES"
Write-Host "ACT_ROWS   : $ACT_ROWS"
Write-Host "DSTEP      : $DSTEP"
Write-Host "PCIe Gen   : $PCIE_GEN"
Write-Host "FAST       : $FAST"
Write-Host ""

if (!$ImplOnly) {

    Write-Host "=== CREATE PROJECT ==="

    & $Vivado `
        -mode batch `
        -nojournal `
        -log (Join-Path $out "create_project.log") `
        -source $createTcl `
        -tclargs `
            $DDR `
            $out `
            $MCOLS `
            $CORE_MHZ `
            $BUILD_ID `
            $VPU_CL `
            $LANES `
            $ACT_ROWS `
            $DSTEP

    if ($LASTEXITCODE -ne 0) {
        throw "Vivado create_project failed: $LASTEXITCODE"
    }

    Write-Host ""
    Write-Host "=== FULL BUILD ==="

    & $Vivado `
        -mode batch `
        -nojournal `
        -log (Join-Path $out "build.log") `
        -source $buildTcl `
        -tclargs `
            $out `
            $JOBS `
            "full" `
            $IMPL_STRATEGY

} else {

    Write-Host "=== IMPLEMENTATION ONLY ==="

    & $Vivado `
        -mode batch `
        -nojournal `
        -log (Join-Path $out "build_impl.log") `
        -source $buildTcl `
        -tclargs `
            $out `
            $JOBS `
            "impl" `
            $IMPL_STRATEGY
}

if ($LASTEXITCODE -ne 0) {
    throw "Vivado build failed: $LASTEXITCODE"
}

Write-Host ""
Write-Host "================================"
Write-Host "DONE"
Write-Host "Bitstream: $out\otpu.bit"
Write-Host "MCS      : $out\otpu.mcs"
Write-Host "Reports  : $out\reports"
Write-Host "================================"
Кладём run_vivado.ps1 (текст - под спойлером ниже) в папку boards\ypcb-00338.
Нужно изменить этот путь под папку где находится Vivado - 17 строчка ( [string]$Vivado = “C:\Xilinx\Vivado\2024.2\bin\vivado.bat”).
Запускаем всё разом (создание проекта, синтез, имплементацию) и ждёмс (зависит от мощности вашей машины).
cd boards\ypcb-00338
Set-ExecutionPolicy -Scope Process -ExecutionPolicy Bypass
Unblock-File .\run_vivado.ps1
.\run_vivado.ps1
Bypass разрешает запуск скачанного скрипта без подписи, и только в текущем окне.
Параметры конфигурации: DDR = 1066, MCOLS = 4 (четыре колонки матрицы по 128 ячеек), LANES = 8 (дорожки векторного блока), CORE_MHZ = 133.333, PCIE_GEN = 2.
Этап | Что происходит |
|---|---|
Создание проекта Vivado и IP | блок-дизайн, XDMA, генерация IP |
Синтез | RTL → нетлист |
Размещение и оптимизация | place, phys_opt |
Трассировка | route |
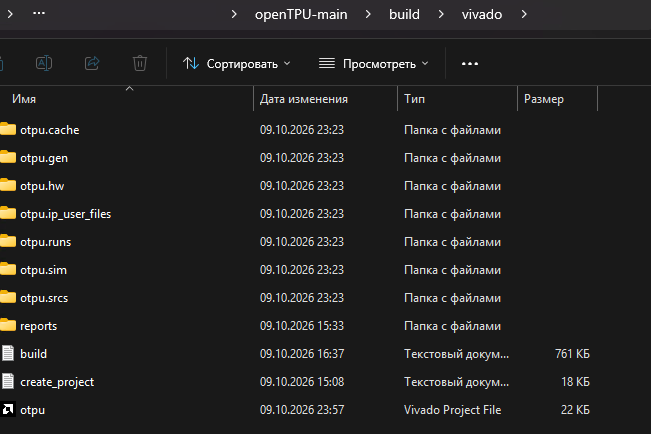
Проект будет лежать в папке build\vivado.
После того как скрипт завершится откроем файл проекта в этой папке с расширением *.xpr.
У меня так :
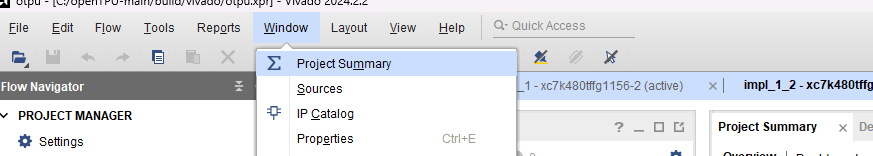
После открытия, переходим в Project Summary:
Вот так выглядит окно успеха, разводка завершилась, тайминг сошёлся
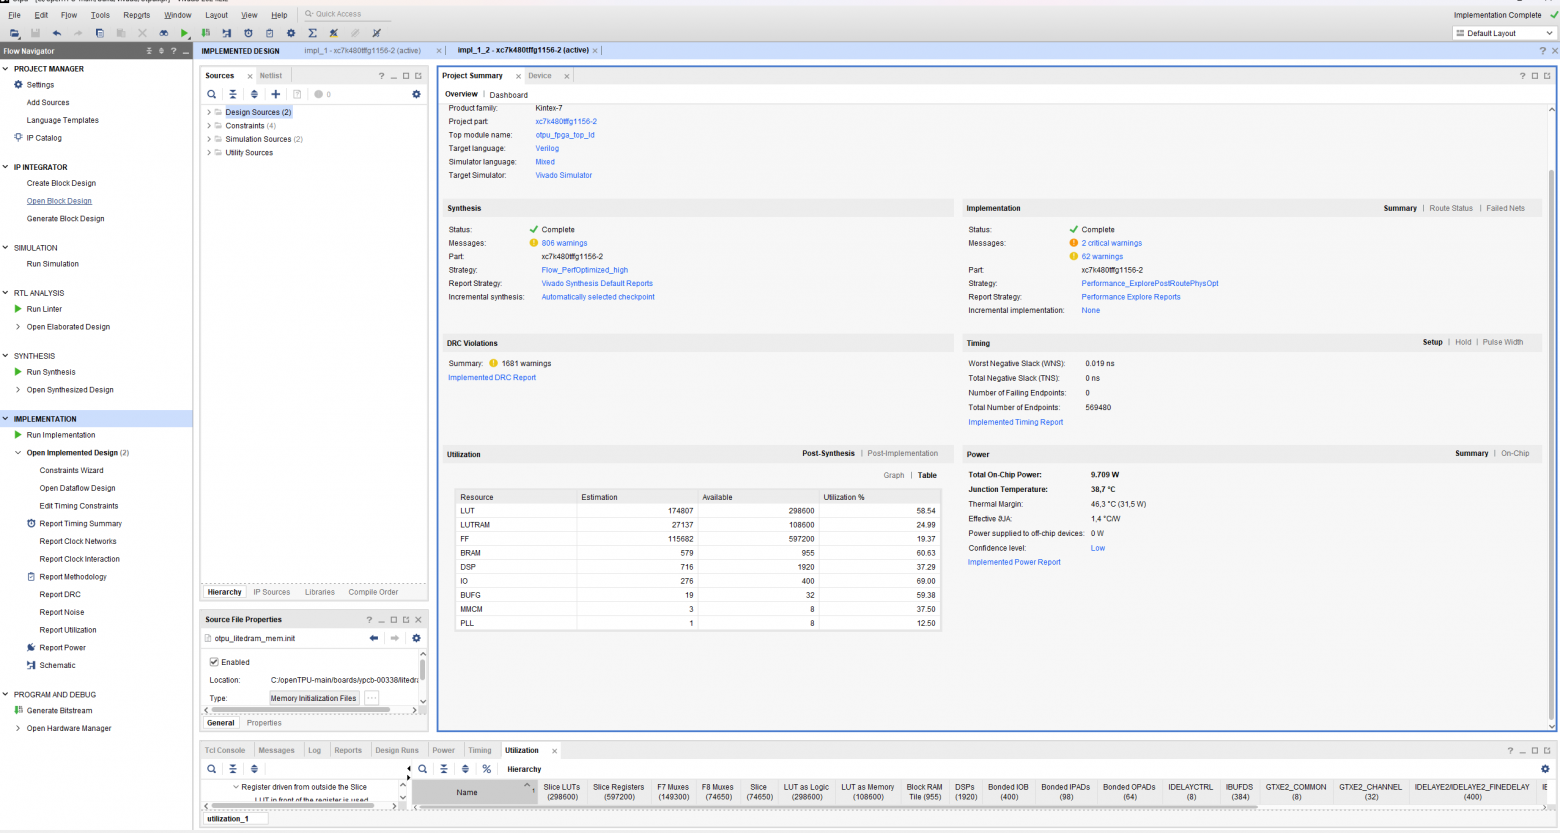
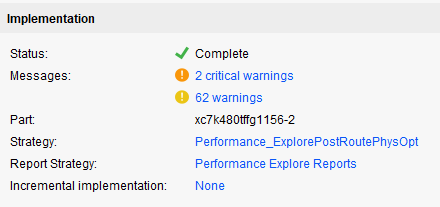
Запас 19 пикосекунд (0.019ns) - 0,25 % такта. Почему так впритык, разберу в разделе про кристалл.
Далее нажмем на кнопку Generate Bitstream (для создания прошивки во временную память ПЛИС) и ждем ( успех будет отмечен там же такой же галочкой )
После еще одного успеха, сгенерируем файл прошивки для FLASH. Нажимаем Generate Memory .... в Tools:
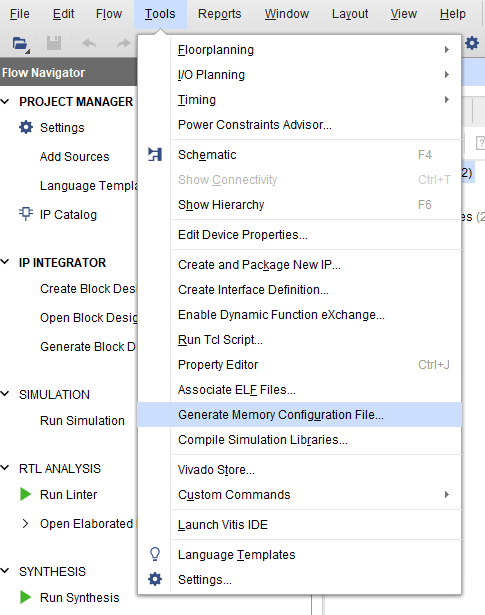
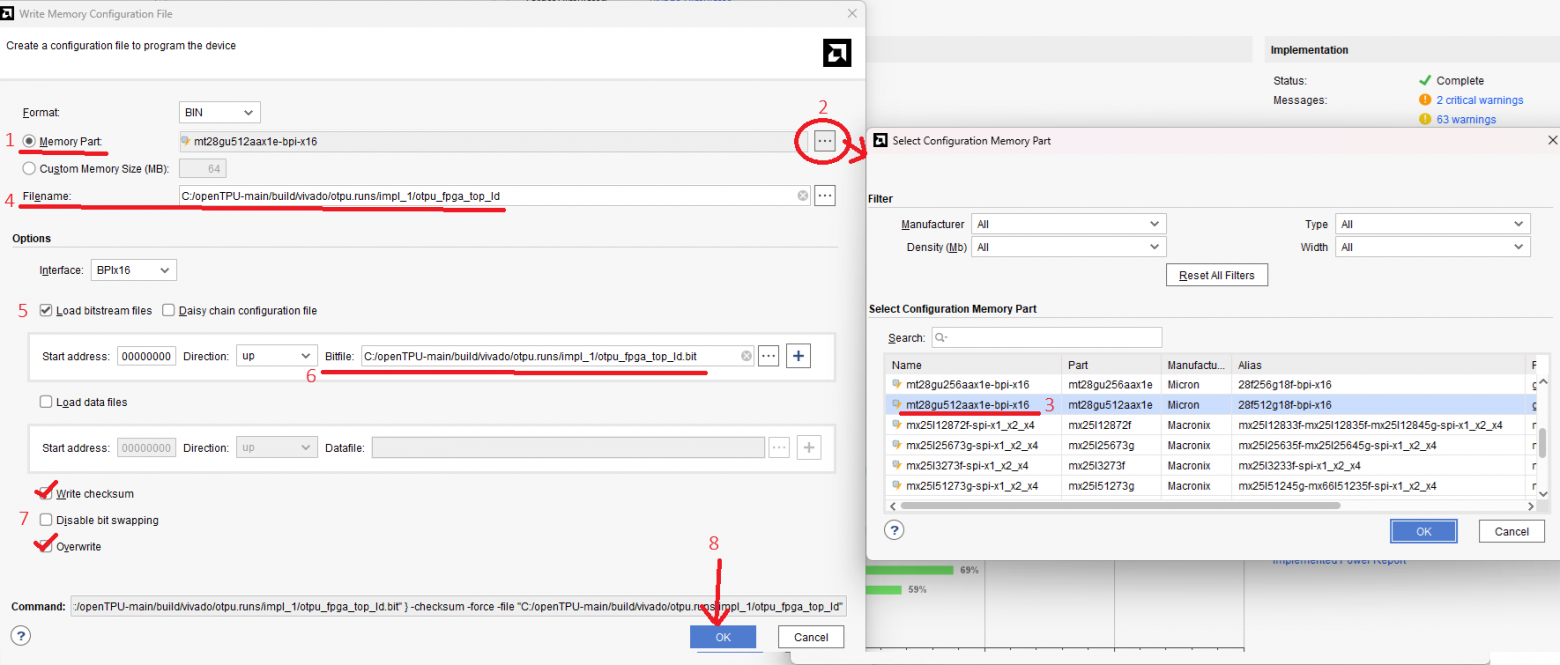
№ | Действие |
|---|---|
1-3 | Выбираем тип конфигурационной Flash-памяти: Memory Part → … → |
4 | Указываем путь для сохранения новой прошивки FLASH. Удобно сохранить в |
5–6 | Включаем Load bitstream files и выбираем ранее сгенерированную прошивку временной памяти (у меня |
7 | Для надёжности включаем Write checksum и Overwrite. Disable bit swapping оставляем выключенным. |
8 | Нажимаем OK - Vivado создаёт файл прошивки для записи во Flash. |
Далее пойдем шить камень
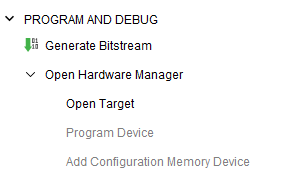
Нужно указать что есть FLASH:
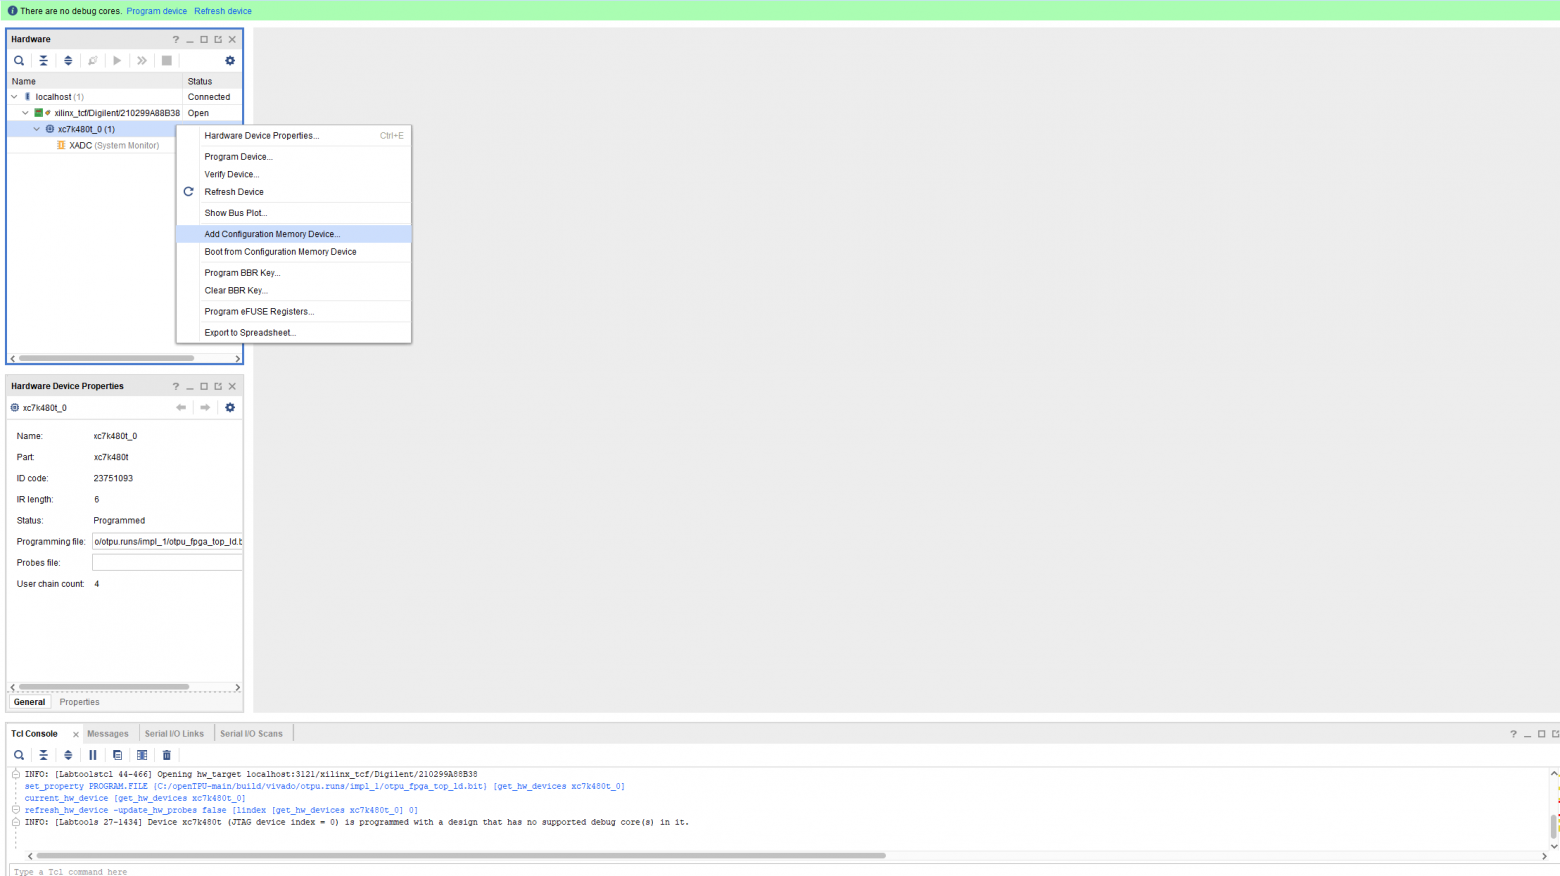
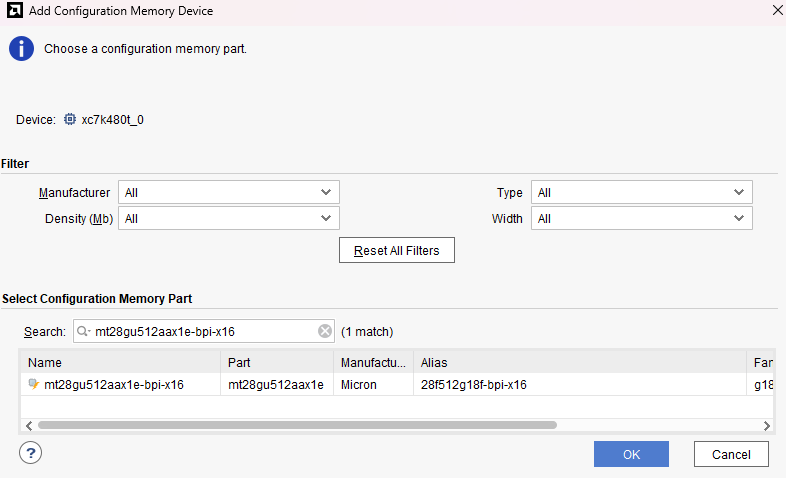
Когда спросит "хотим ли мы прошить" жмём да, чё спрашиваешь)
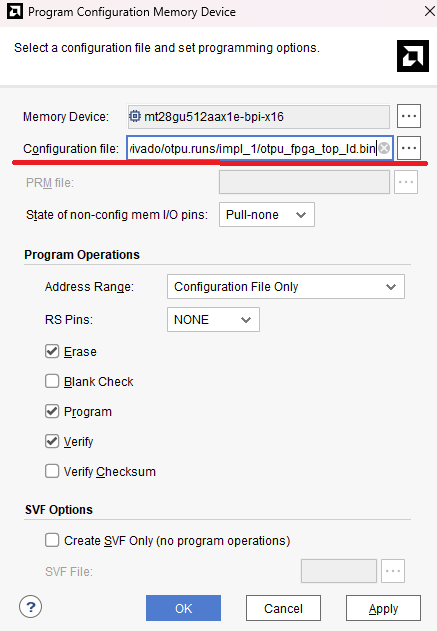
Указываем файл прошивки для FLASH ранее созданный (у меня build/vivado/otpu.runs/impl_1/otpu_fpga_top_ld.bin ).
Ждем завершения успеха)
3. Linux, драйвер и первая проверка
Перезагружаем компьютер, в который вставлена плата. Можно и без перезагрузки - удалить устройство и пересканировать шину:
sudo modprobe -r xdma
echo 1 | sudo tee /sys/bus/pci/devices/0000:07:00.0/remove
echo 1 | sudo tee /sys/bus/pci/rescan
Расчехляем ssh и подключаемся к другой машине куда непосредственно вставлена плата (если плата вставлена в другой комп).
Проверим что жива и дом не сгорел:
sudo lspci -vv | grep -E 'Xilinx'
Плата представляется ускорителем вычислений - на хайпе и гордая).
Если плата вставлена в другую машину повторяем скачивание проекта:
git clone https://github.com/FeSens/openTPU.git
cd openTPU
git checkout 8eaa480
Файл setup_opentpu.sh
#!/usr/bin/env bash
# openTPU hardware bring-up only: no LLM checkpoint download or inference.
set -Eeuo pipefail

PROJECT="$(pwd -P)"
RESET_VENV="${RESET_VENV:-1}"
VERBOSE="${VERBOSE:-1}"
DRIVER_URL="https://github.com/Xilinx/dma_ip_drivers.git"
PROJECT_URL="https://github.com/FeSens/openTPU.git"

mkdir -p "$PROJECT/logs" "$PROJECT/drivers" "$PROJECT/benchmarks" "$PROJECT/.local"
LOG="$PROJECT/logs/setup_$(date +%Y%m%d_%H%M%S).log"
exec > >(tee -a "$LOG") 2>&1
export PYTHONUNBUFFERED=1
export PS4='+ [${BASH_SOURCE##*/}:${LINENO}] '
[[ "$VERBOSE" == 1 ]] && set -x
trap 'rc=$?; set +x; printf "\nERROR: step failed on line %s (exit %s)\nLOG: %s\n" "$LINENO" "$rc" "$LOG" >&2' ERR
step() { printf '\n========== %s ==========\n' "$*"; }
die() { echo "ERROR: $*" >&2; exit 1; }

step 'Environment and project location'
echo "PROJECT=$PROJECT"; date -Is; uname -a
[[ "$PROJECT" != / && "$PROJECT" != "$HOME" ]] || die 'Run inside a dedicated openTPU directory, not / or HOME.'
command -v sudo >/dev/null || die 'sudo is required'
# A directory containing an unrelated project is not overwritten.
if [[ ! -f "$PROJECT/pyproject.toml" || ! -d "$PROJECT/opentpu" ]]; then
  if [[ -n "$(find "$PROJECT" -mindepth 1 -maxdepth 1 ! -name logs ! -name drivers ! -name benchmarks ! -name .local ! -name setup_opentpu_universal.sh ! -name setup.sh -print -quit)" ]]; then
    die 'Directory is not an openTPU checkout and is not empty. Run in an empty directory or an existing openTPU checkout.'
  fi
  step 'Install required packages for source checkout'
  sudo apt-get update
  sudo apt-get install -y git ca-certificates
  temp_checkout="$(mktemp -d)"
  git clone --depth 1 "$PROJECT_URL" "$temp_checkout/openTPU"
  cp -a "$temp_checkout/openTPU/." "$PROJECT/"
  rm -rf -- "$temp_checkout"
fi
[[ -d "$PROJECT/opentpu" && -f "$PROJECT/pyproject.toml" ]] || die 'openTPU sources not found'
if git -C "$PROJECT" rev-parse --is-inside-work-tree >/dev/null 2>&1; then
  git -C "$PROJECT" rev-parse HEAD || true
  git -C "$PROJECT" status --short || true
fi

step 'Host packages'
sudo apt-get update
sudo apt-get install -y build-essential make gcc git rsync pciutils kmod python3 python3-venv python3-pip "linux-headers-$(uname -r)"

step 'Detect Xilinx PCIe device automatically'
mapfile -t xilinx_devices < <(lspci -Dnnd 10ee: | awk '{print $1}')
((${#xilinx_devices[@]} > 0)) || die 'No Xilinx PCIe devices found (vendor 10ee). Check power, bitstream and PCIe enumeration.'
printf 'Xilinx devices found:\n'; lspci -Dnn -d 10ee:
if [[ -n "${PCI_BDF:-}" ]]; then
  BDF="$PCI_BDF"
  [[ "$BDF" == 0000:* ]] || BDF="0000:$BDF"
else
  # Prefer the openTPU/ XDMA endpoint ID 10ee:7028; otherwise accept only a unique Xilinx endpoint.
  mapfile -t preferred < <(lspci -Dnnd 10ee:7028 | awk '{print $1}')
  if ((${#preferred[@]} == 1)); then
    BDF="${preferred[0]}"
  elif ((${#xilinx_devices[@]} == 1)); then
    BDF="${xilinx_devices[0]}"
  else
    die 'Several Xilinx devices found. Rerun with PCI_BDF=0000:BB:DD.F ./setup_opentpu_universal.sh'
  fi
fi
[[ -d "/sys/bus/pci/devices/$BDF" ]] || die "PCI device $BDF does not exist"
echo "SELECTED_PCI_BDF=$BDF"
lspci -nnk -s "$BDF"; lspci -vv -s "$BDF" | grep -E 'LnkCap:|LnkSta:|Region [0-9]:' || true
for item in vendor device subsystem_vendor subsystem_device current_link_speed current_link_width max_link_speed max_link_width; do
  file="/sys/bus/pci/devices/$BDF/$item"; [[ -r "$file" ]] && printf '%s=' "$item" && cat "$file"
done

step 'Get XDMA sources inside the project'
DRIVER_REPO="$PROJECT/drivers/dma_ip_drivers"
if [[ ! -f "$DRIVER_REPO/XDMA/linux-kernel/xdma/Makefile" ]]; then
  if [[ -f "$HOME/dma_ip_drivers/XDMA/linux-kernel/xdma/Makefile" ]]; then
    mkdir -p "$DRIVER_REPO"
    rsync -a "$HOME/dma_ip_drivers/" "$DRIVER_REPO/"
  else
    [[ ! -e "$DRIVER_REPO" || -z "$(ls -A "$DRIVER_REPO" 2>/dev/null)" ]] || die "Driver directory $DRIVER_REPO contains unrelated files"
    git clone "$DRIVER_URL" "$DRIVER_REPO"
  fi
fi
[[ -f "$DRIVER_REPO/XDMA/linux-kernel/include/libxdma_api.h" ]] || die 'Missing XDMA header include/libxdma_api.h'

step 'Compile driver on local filesystem (source remains in project)'
# Kernel module builds frequently fail on SMB shares: use a local temp build tree.
BUILD_ROOT="$(mktemp -d "${TMPDIR:-/tmp}/opentpu-xdma.XXXXXXXX")"
trap 'rc=$?; set +x; echo "Exit $rc; log: $LOG" >&2; [[ -n "${BUILD_ROOT:-}" && -d "$BUILD_ROOT" ]] && rm -rf -- "$BUILD_ROOT"; exit "$rc"' EXIT
rsync -a --exclude='.git' "$DRIVER_REPO/" "$BUILD_ROOT/dma_ip_drivers/"
cd "$BUILD_ROOT/dma_ip_drivers/XDMA/linux-kernel/xdma"
make clean
make -j"$(nproc)" KCFLAGS="-I$(realpath ../include)"
[[ -s xdma.ko ]] || die 'xdma.ko not created'
modinfo ./xdma.ko | grep -E '^(filename|vermagic|description):' || true
[[ "$(modinfo -F vermagic ./xdma.ko)" == "$(uname -r) "* ]] || die 'Built module vermagic does not match running kernel'
mkdir -p "$PROJECT/drivers/modules/$(uname -r)"
cp -f ./xdma.ko "$PROJECT/drivers/modules/$(uname -r)/xdma.ko"

step 'Load compiled XDMA (no reboot, no flash programming)'
if [[ -L "/sys/bus/pci/devices/$BDF/driver" ]]; then
  active_driver="$(basename "$(readlink -f "/sys/bus/pci/devices/$BDF/driver")")"
  [[ "$active_driver" == xdma ]] || die "Selected board is bound to $active_driver; refusing to replace it automatically"
fi
if lsmod | awk '$1=="xdma" {found=1} END {exit !found}'; then
  sudo modprobe -r xdma || die 'XDMA in use, stop programs that access /dev/xdma* and retry'
fi
sudo insmod "$PROJECT/drivers/modules/$(uname -r)/xdma.ko" poll_mode=0
sleep 2
lspci -nnk -s "$BDF"
ls -l /dev/xdma* || true
mapfile -t udev_nodes < <(compgen -G '/dev/xdma*_user' || true)
((${#udev_nodes[@]} >= 1)) || die 'No /dev/xdma*_user. Inspect kernel log.'
DEVICE="${DEVICE:-${udev_nodes[0]%_user}}"
[[ -c "${DEVICE}_user" && -c "${DEVICE}_h2c_0" && -c "${DEVICE}_c2h_0" ]] || die "Missing DMA nodes for $DEVICE"
echo "SELECTED_XDMA=$DEVICE"
sudo dmesg | tail -45 || true

step 'Create Python environment inside project'
cd "$PROJECT"
VENV="$PROJECT/.venv"
# SMB/CIFS can break virtual environments (symlinks, executable permissions).
# Never silently relocate .venv outside the project.
if [[ -L "$VENV" ]]; then
  rm -- "$VENV"
elif [[ -e "$VENV" && "$RESET_VENV" == 1 ]]; then
  [[ -d "$VENV" ]] || die "Unexpected .venv path: $VENV"
  rm -rf -- "$VENV"
fi
if [[ ! -x "$VENV/bin/python" ]]; then
  python3 -m venv --copies "$VENV" || die "Cannot create .venv on this filesystem; mount with Linux-compatible permissions or use a local checkout"
fi
[[ -x "$VENV/bin/python" ]] || die "Python in $VENV is not executable (SMB mount may be noexec)"
"$VENV/bin/python" -m pip install -U pip setuptools wheel transformers tokenizers safetensors sentencepiece protobuf torch  https://download.pytorch.org/whl/cpu
"$VENV/bin/python" -m pip install -e "$PROJECT"
export PATH="$VENV/bin:$PATH"
command -v otpu-selftest; command -v otpu-diag; command -v otpu-smi

step 'Software CLI smoke checks'
otpu-diag --help >/dev/null
otpu-selftest --help >/dev/null
otpu-smi --help >/dev/null

step 'FPGA board diagnostics (no model / no LLM)'
otpu-diag --dev "$DEVICE"

step 'SUCCESS: board bring-up complete, no LLM downloaded or executed'
echo "Project: $PROJECT"
echo "PCIe FPGA: $BDF"
echo "XDMA: $DEVICE"
echo "Venv: $VENV"
echo "Log: $LOG"
echo 'No Qwen model was downloaded, loaded or launched.'
Для ленивых (то есть для себя) я написал setup_opentpu.sh . Он ставит зависимости, сам находит плату на шине, собирает драйвер XDMA под текущее ядро, поднимает Python-окружение и в конце гоняет диагностику. Модели не качает и плату не прошивает.
Учтите: драйвер он подгружает через insmod, так что после перезагрузки или обновления ядра скрипт надо запустить снова. Если нужно навсегда - в openTPU есть sudo otpu-setup, он ставит драйвер через DKMS.
При этом он не скачивает языковые модели, не запускает LLM-инференс и не прошивает FPGA.
Что делает скрипт по шагам:
Шаг | Действие | Что происходит |
|---|---|---|
1 | Подготовка проекта | Определяет текущую папку, создаёт |
2 | Установка зависимостей | Устанавливает компилятор GCC, Make, Git, Python, заголовки текущего ядра Linux и инструменты для работы с PCIe. |
3 | Поиск FPGA | Автоматически ищет устройства Xilinx по PCI Vendor ID |
4 | Получение драйвера XDMA | Скачивает исходники драйвера из |
5 | Компиляция драйвера | Собирает |
6 | Подключение драйвера | Выгружает ранее (если был ) загруженный модуль |
7 | Создание Python-окружения | Создаёт |
8 | Проверка утилит | Проверяет доступность |
9 | Аппаратная диагностика | Запускает |
10 | Сохранение результатов | Записывает подробный журнал выполнения в |
Запускаем скрипт:
bash ./setup_opentpu.sh
Ждем окончания снова успеха)


Диагностика: 138 из 138
Убедимся, что работает всё. Для этого в openTPU есть otpu-diag: он гоняет PCIe, регистры, оба канала памяти, каждую инструкцию ускорителя и программы на всех блоках сразу. На стенде B я прогнал его трижды подряд:
Раздел | PASS | FAIL | SKIP | INFO |
|---|---|---|---|---|
Платформа: PCIe, драйвер, ID, калибровка DDR3 | 9 | 0 | 1 | 0 |
Регистры | 7 | 0 | 0 | 0 |
I²C и датчики | 4 | 0 | 0 | 1 |
Память: оба канала DDR3 | 11 | 0 | 0 | 0 |
Инструкции, бит в бит с симулятором | 103 | 0 | 0 | 0 |
Программы на всех блоках | 4 | 0 | 0 | 0 |
Итого | 138 | 0 | 1 | 1 |
Прогон - 3,3 секунды, три раза одинаково. Плата ответила своим ID 0x4f545055 - это «OTPU» в ASCII. 103 программы - по одной на каждый вариант каждой инструкции - посчитали то же, что программный симулятор, бит в бит. Счётчик тактов не врёт: 20 млн итераций - 300 мс по плате и 301 мс по часам компьютера.
DMA на стенде B: запись на плату 2,76 ГБ/с, чтение 1,91 ГБ/с - 69 % потолка линии Gen2 x8. У автора - 2,98 ГБ/с. Через USB4 на стенде A было 0,30 ГБ/с.
4. Как устроен TPU внутри
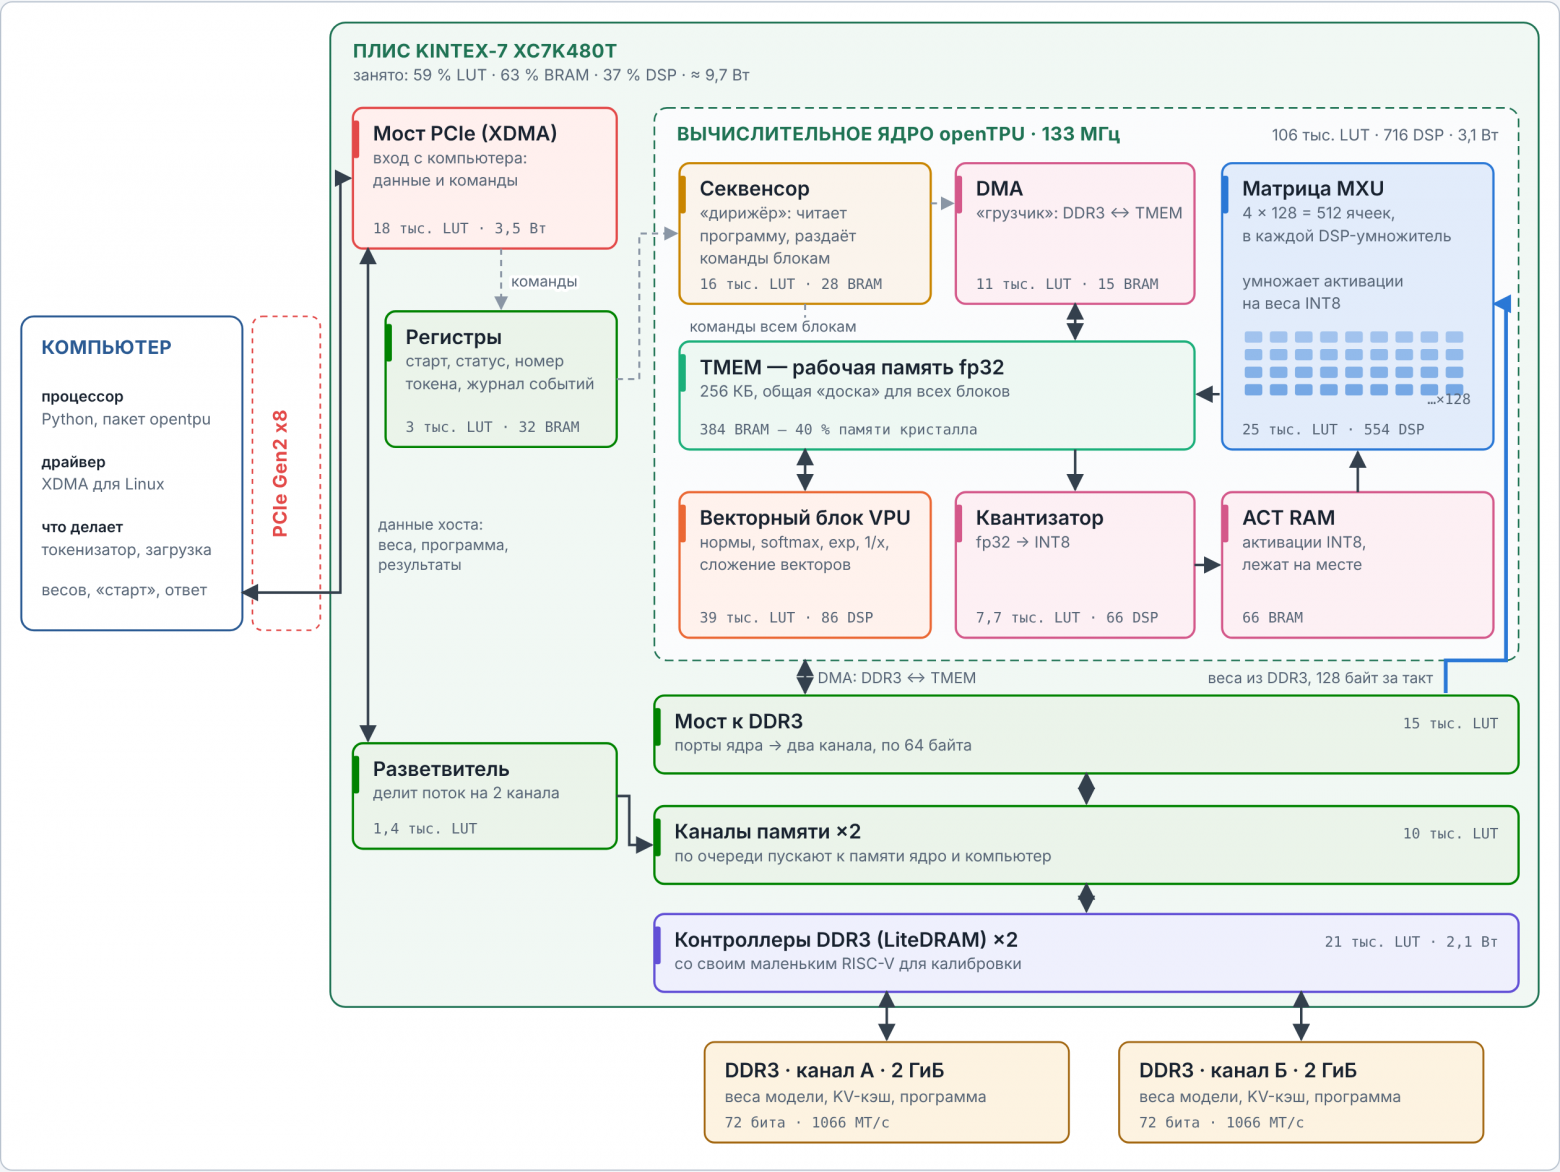
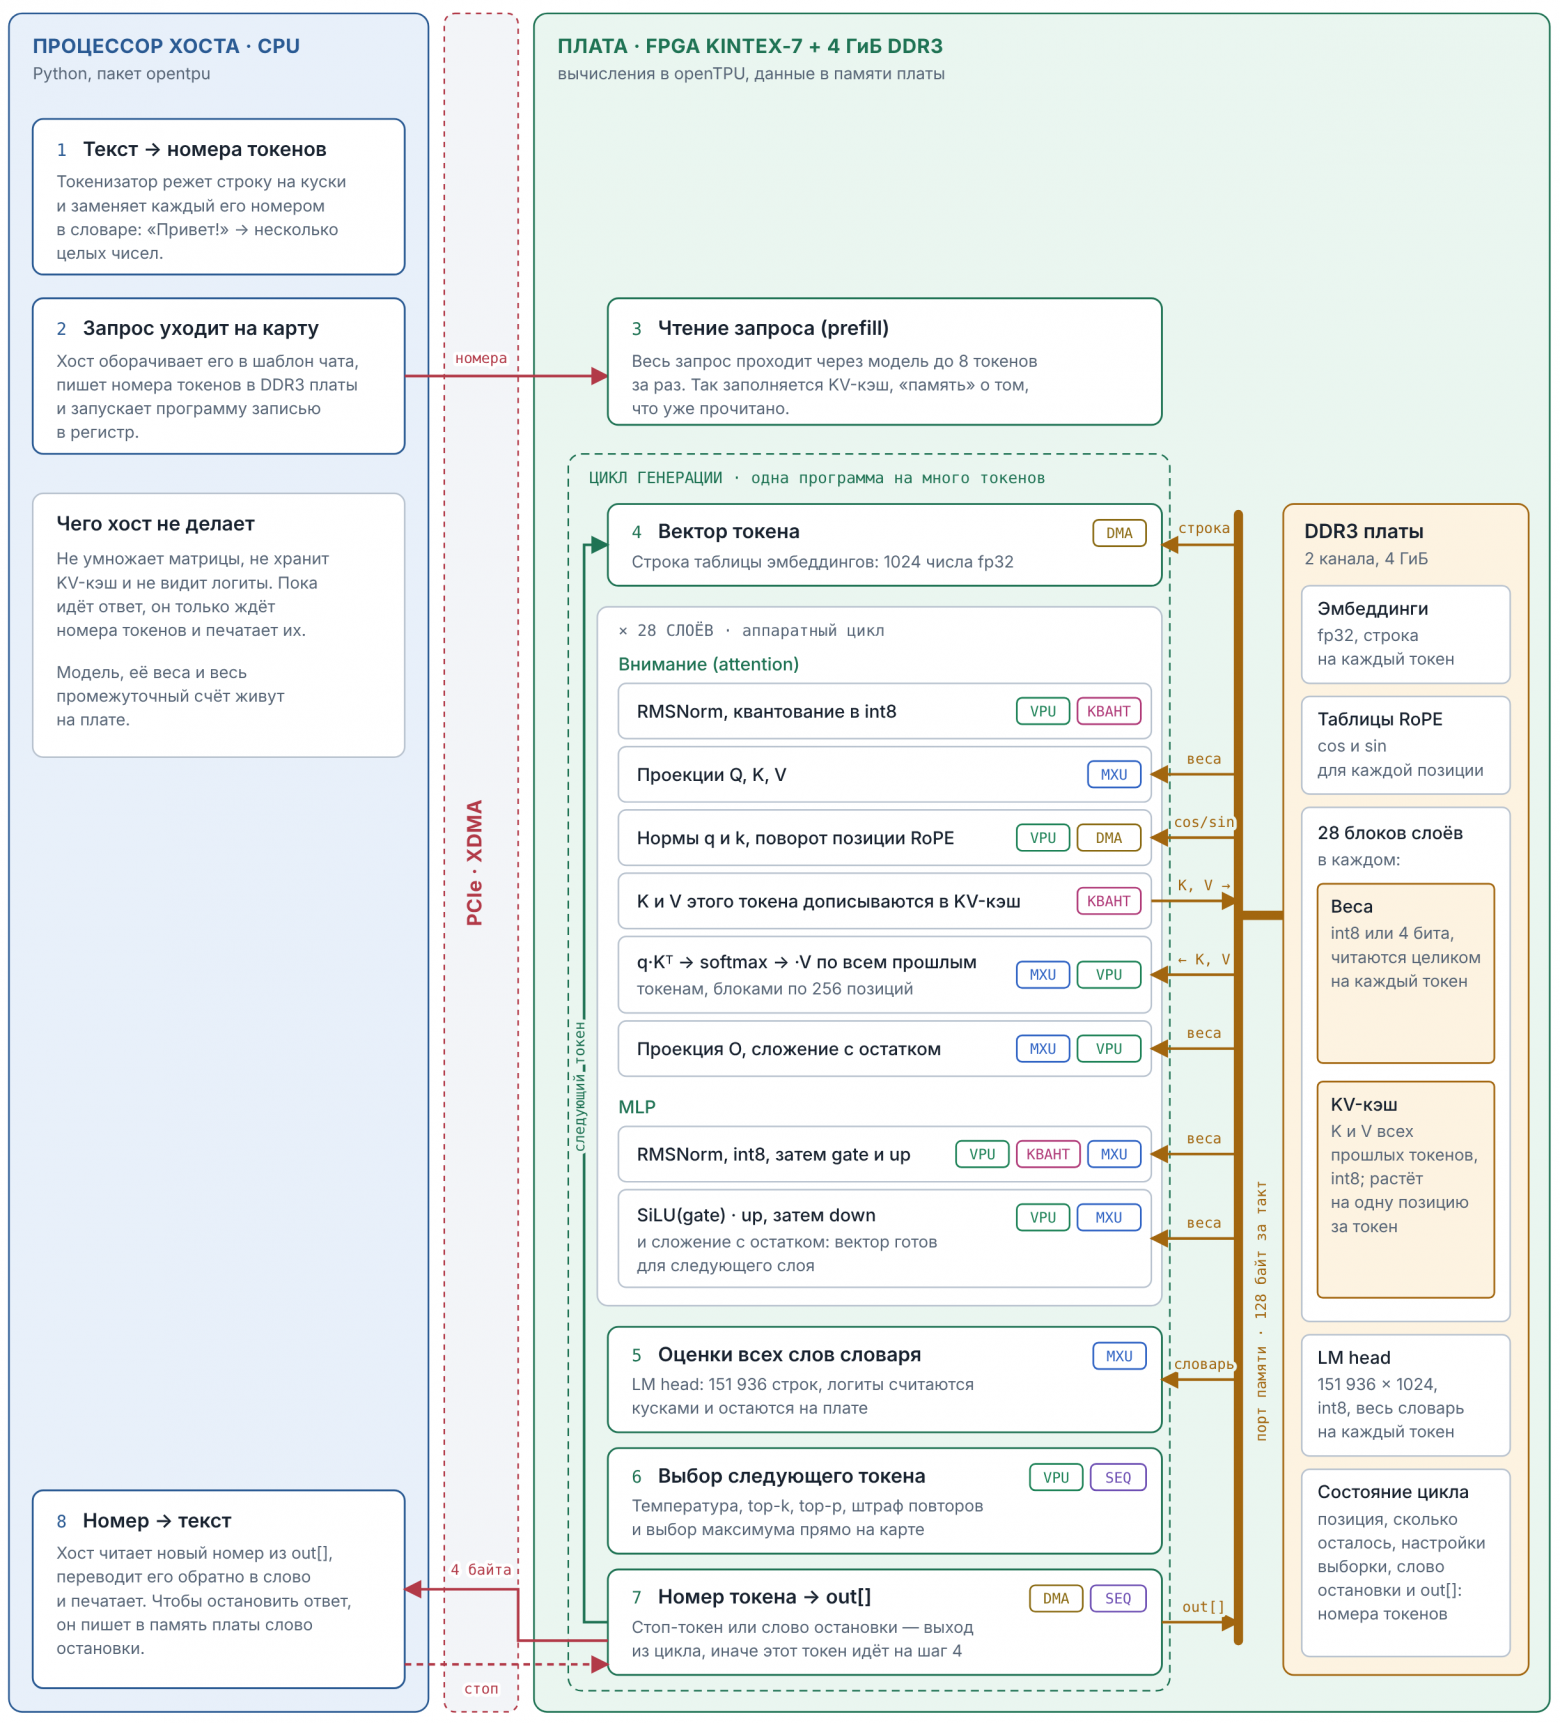
Схема упрощённая, но всё главное на ней есть. Снаружи - компьютер: он готовит модель, через PCIe и мост XDMA кладёт веса и программу в DDR3 платы и даёт команду «старт». Дальше работает само ядро, и в нём шесть блоков:
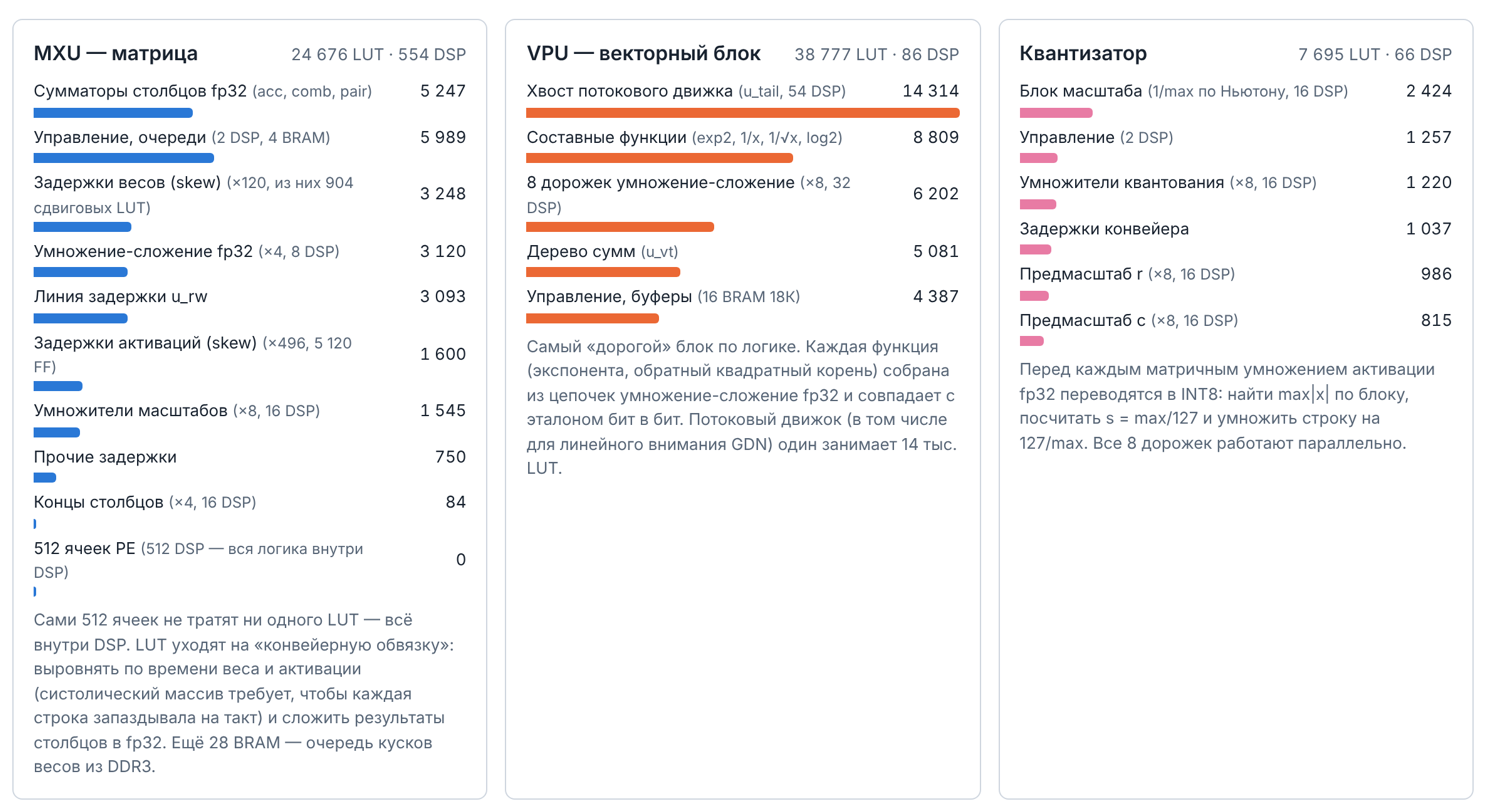
Секвенсор - дирижёр. Читает программу, раздаёт команды остальным и следит, чтобы никто не прочитал то, что ещё не записано. На одно дирижирование ушло 16 тыс. LUT.
DMA - грузчик. Таскает данные между DDR3 и рабочей памятью. Это не XDMA: тот возит данные с компьютера, а этот работает внутри ядра.
TMEM - общая доска на 256 КиБ fp32, через которую блоки передают друг другу результаты. Физически она занимает 384 блока BRAM, потому что хранится в шести копиях - почему, расскажу ниже.
VPU - 8 дорожек fp32 для всего, что не умножение матриц: нормы, softmax, экспонента, обратный корень. Самый толстый блок ядра по логике - 39 тыс. LUT.
Квантизатор - сжимает fp32 в INT8 и кладёт в ACT RAM, откуда их берёт матрица.
MXU - матрица 4 × 128 = 512 ячеек, весь блок - 554 DSP. Активации берёт из ACT RAM, веса - потоком прямо из DDR3, результат пишет в TMEM.
Рядом - дорога к памяти: мост от ядра к двум каналам, разветвитель для запросов с компьютера и два контроллера LiteDRAM с тем самым VexRiscv.
И одна цифра, на которой держится вся вторая половина статьи. Веса в матрицу приходят по 1024 бита за такт: 128 байт × 133,33 МГц = 17,07 ГБ/с. А два канала DDR3-1066 дают в пике 2 × 8 байт × 1066 млн = 17,06 ГБ/с. Совпадение до сотых не случайно: порт сделан ровно под память. Запомните эту цифру.
Что происходит внутри TPU на уровне RTL
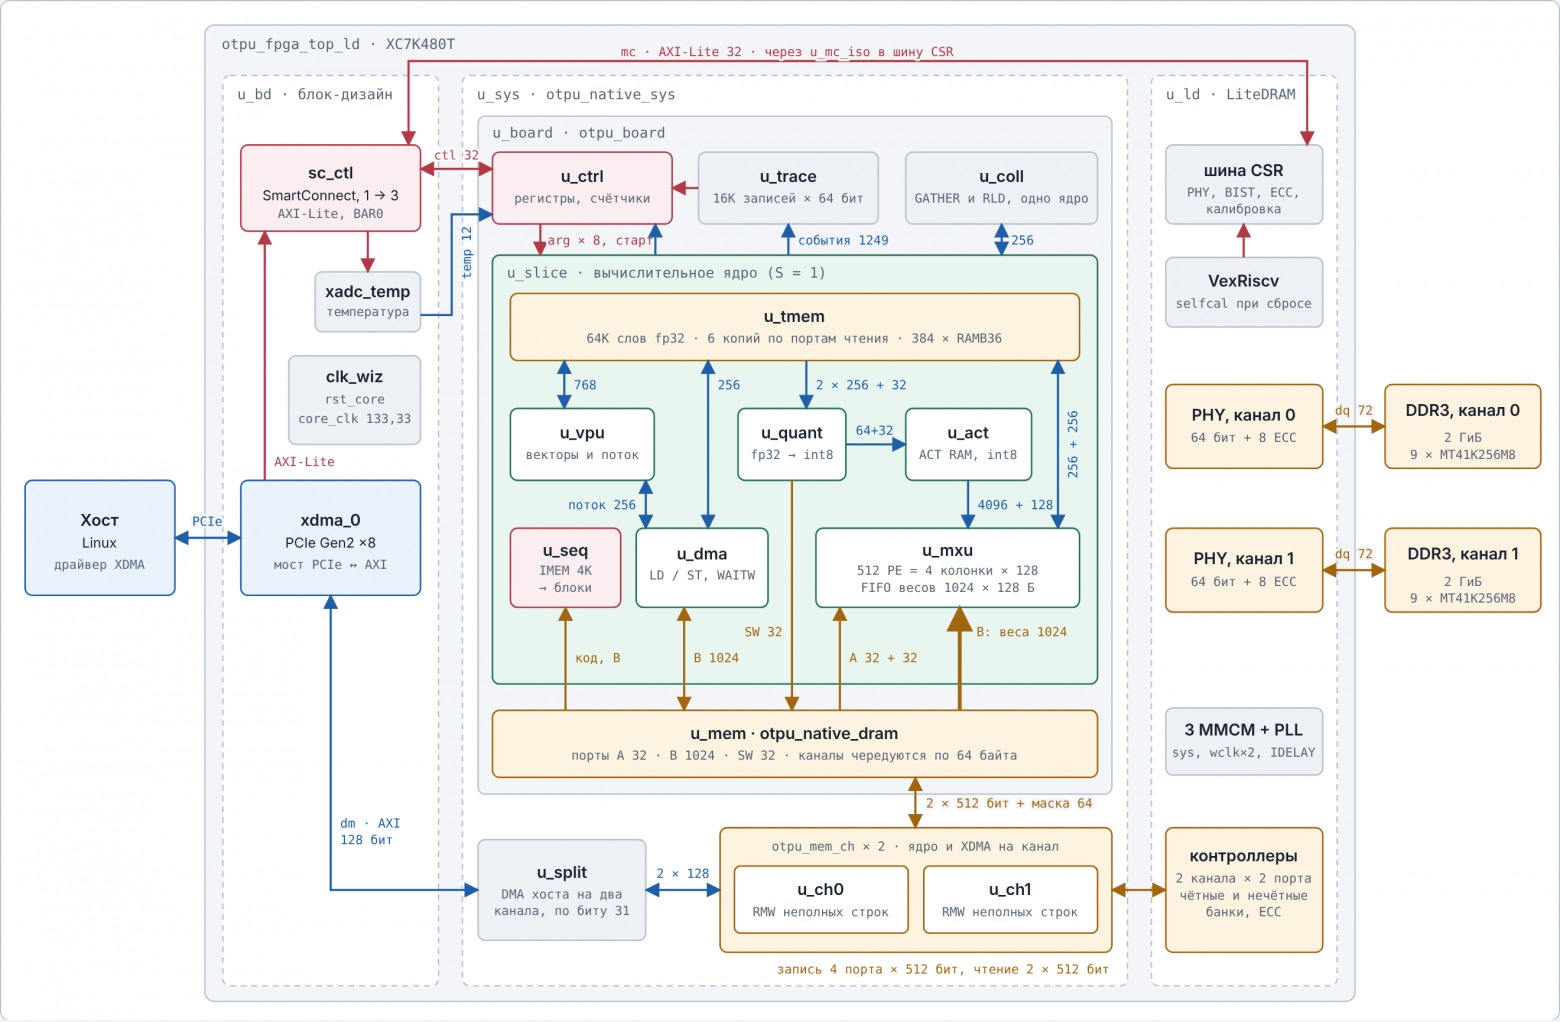
Если посмотреть глубже, архитектура openTPU состоит из нескольких подсистем.
Подсистема | Основные модули | Назначение |
|---|---|---|
PCIe и управление |
| Принимают команды компьютера, обеспечивают доступ к регистрам и передают данные через PCIe Gen2 ×8. |
Мониторинг и диагностика |
| Аппаратный журнал событий, счётчики и измерение температуры FPGA. |
Вычислительное ядро |
| Объединяет секвенсор, рабочую память, DMA, VPU, квантизатор и MXU. |
Секвенсор |
| Читает программу из памяти инструкций на 4096 слов и управляет выполнением команд. |
Рабочая память |
| Хранит промежуточные результаты FP32: 64 тысячи слов, логически 256 КиБ. Для нескольких параллельных портов чтения используется шесть физических копий. |
Векторные вычисления |
| Выполняет арифметику FP32, в том числе операции нормализации и сложные функции. |
Квантизатор |
| Преобразует FP32 в INT8 и сохраняет активации для матричного вычислителя. |
Матричный вычислитель |
| Содержит 512 вычислительных элементов и принимает веса по 1024-битному интерфейсу. |
Внутренний доступ к памяти |
| Маршрутизируют запросы ядра к двум каналам DDR3, включая обработку неполных записей. |
Разделение host DMA |
| Распределяет обращения XDMA между двумя каналами памяти. |
Контроллеры DDR3 |
| Управляют физическими интерфейсами памяти, калибровкой и ECC. |
Внешняя память | DDR3 канал 0 и канал 1 | Два независимых канала по 2 ГиБ, каждый с 64 битами данных и 8 битами ECC. |
Компьютер режет текст на токены и отправляет на плату. Дальше всё на FPGA: все 28 слоёв (на схеме - Qwen3-0.6B), в каждом нормы, проекции Q, K, V, внимание и MLP, плюс KV-кэш в той же DDR3. В конце LM head считает оценки для всех слов словаря, и выбирается следующий токен - в зависимости от режима на карте или на хосте. Компьютеру остаётся превратить номер обратно в текст.
Главное: на каждом токене веса по PCIe не ходят, они уже лежат в DDR3 платы. Поэтому, забегая вперёд, PCIe x1 вместо x8 скорость генерации почти не изменил.
5. Что получилось на кристалле
В комментариях просили показать настоящий floorplan и подсветить ядро.
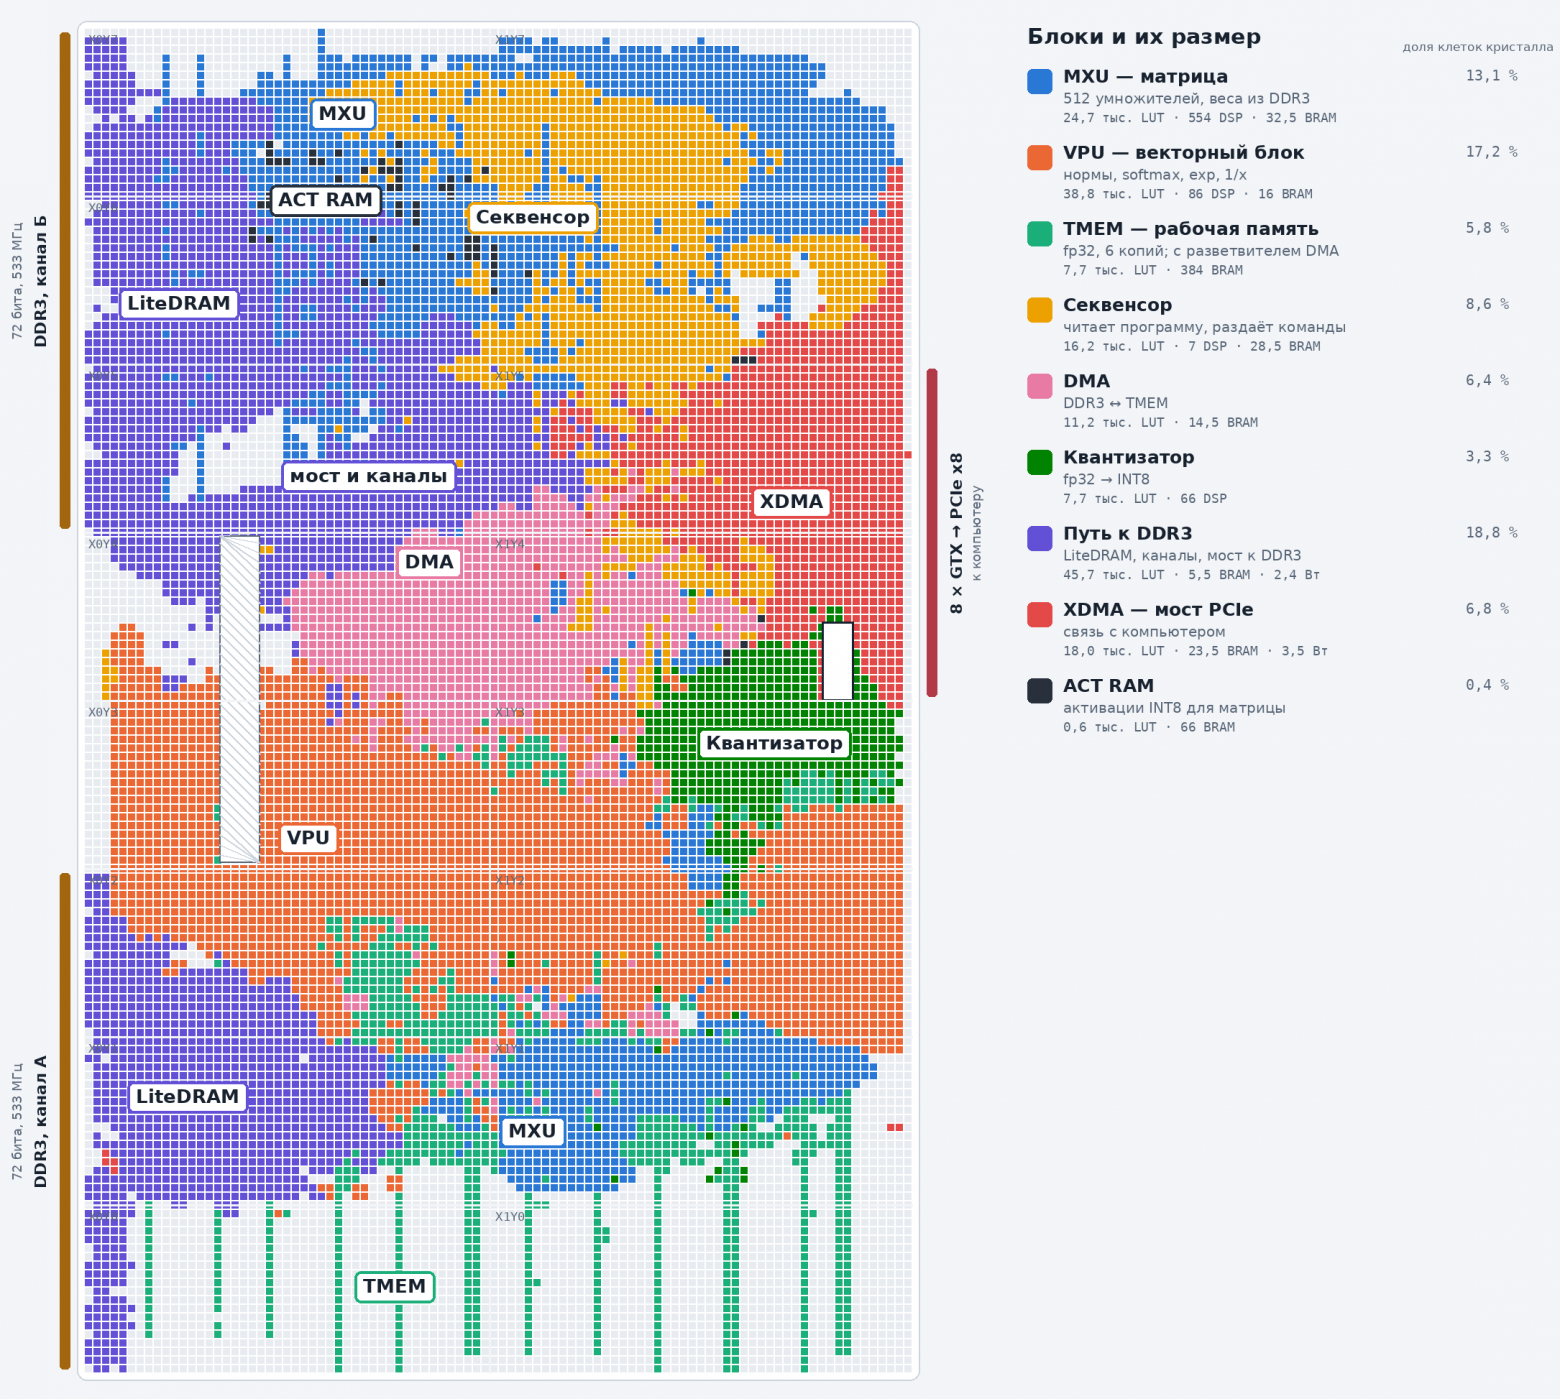
Размещение после разводки в Vivado. Кристалл разбит на мелкие клетки; клетка окрашена по модулю, который занимает её больше всего. Серые клетки - свободная логика или только провода.
Ни одного аккуратного прямоугольника. Матрица растянулась на несколько областей кристалла - туда, где колонки DSP. TMEM легла вдоль колонок BRAM. Контроллеры DDR3 прижались к ножкам памяти, XDMA - к трансиверам PCIe. Vivado раскладывает модуль не кучкой, а туда, где есть нужные ему ресурсы, и потом всё это соединяет проводами через полкристалла. Отсюда и 19 пикосекунд - но об этом чуть ниже.
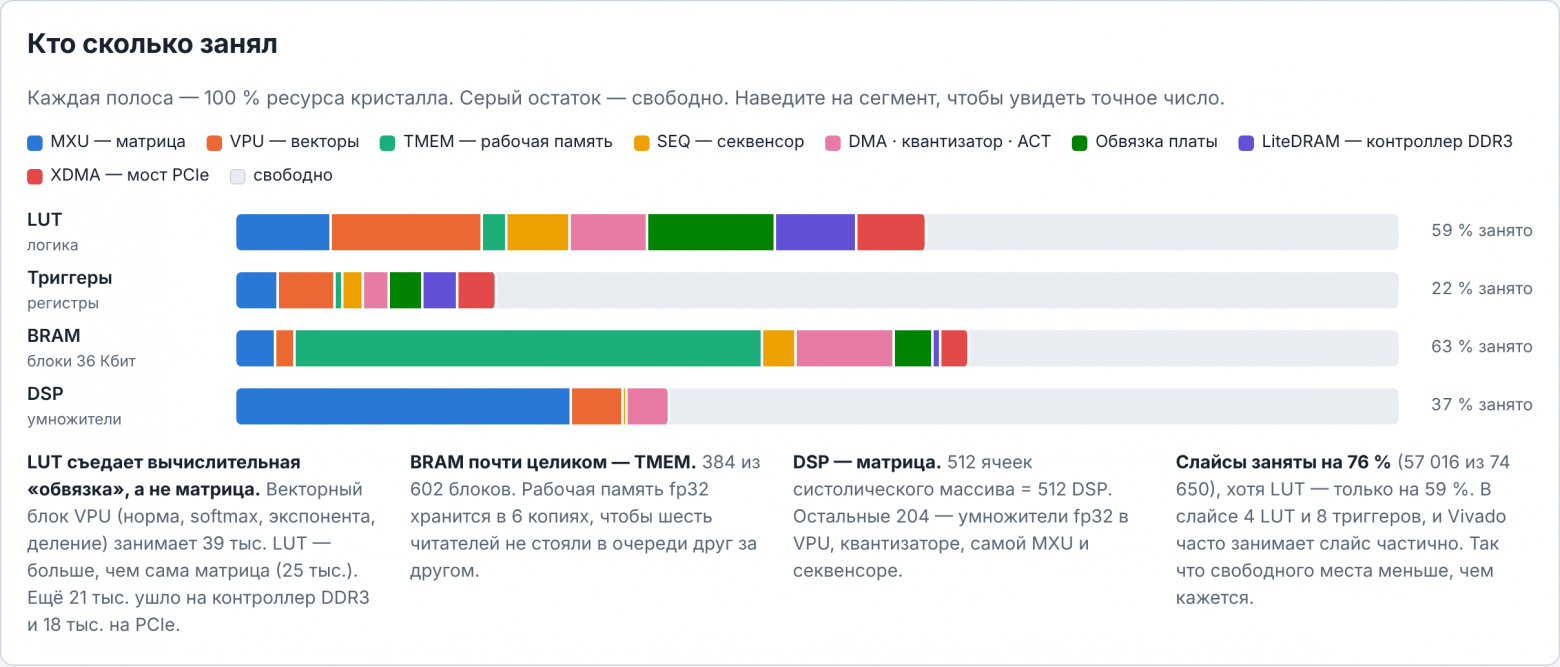
Кто сколько занял
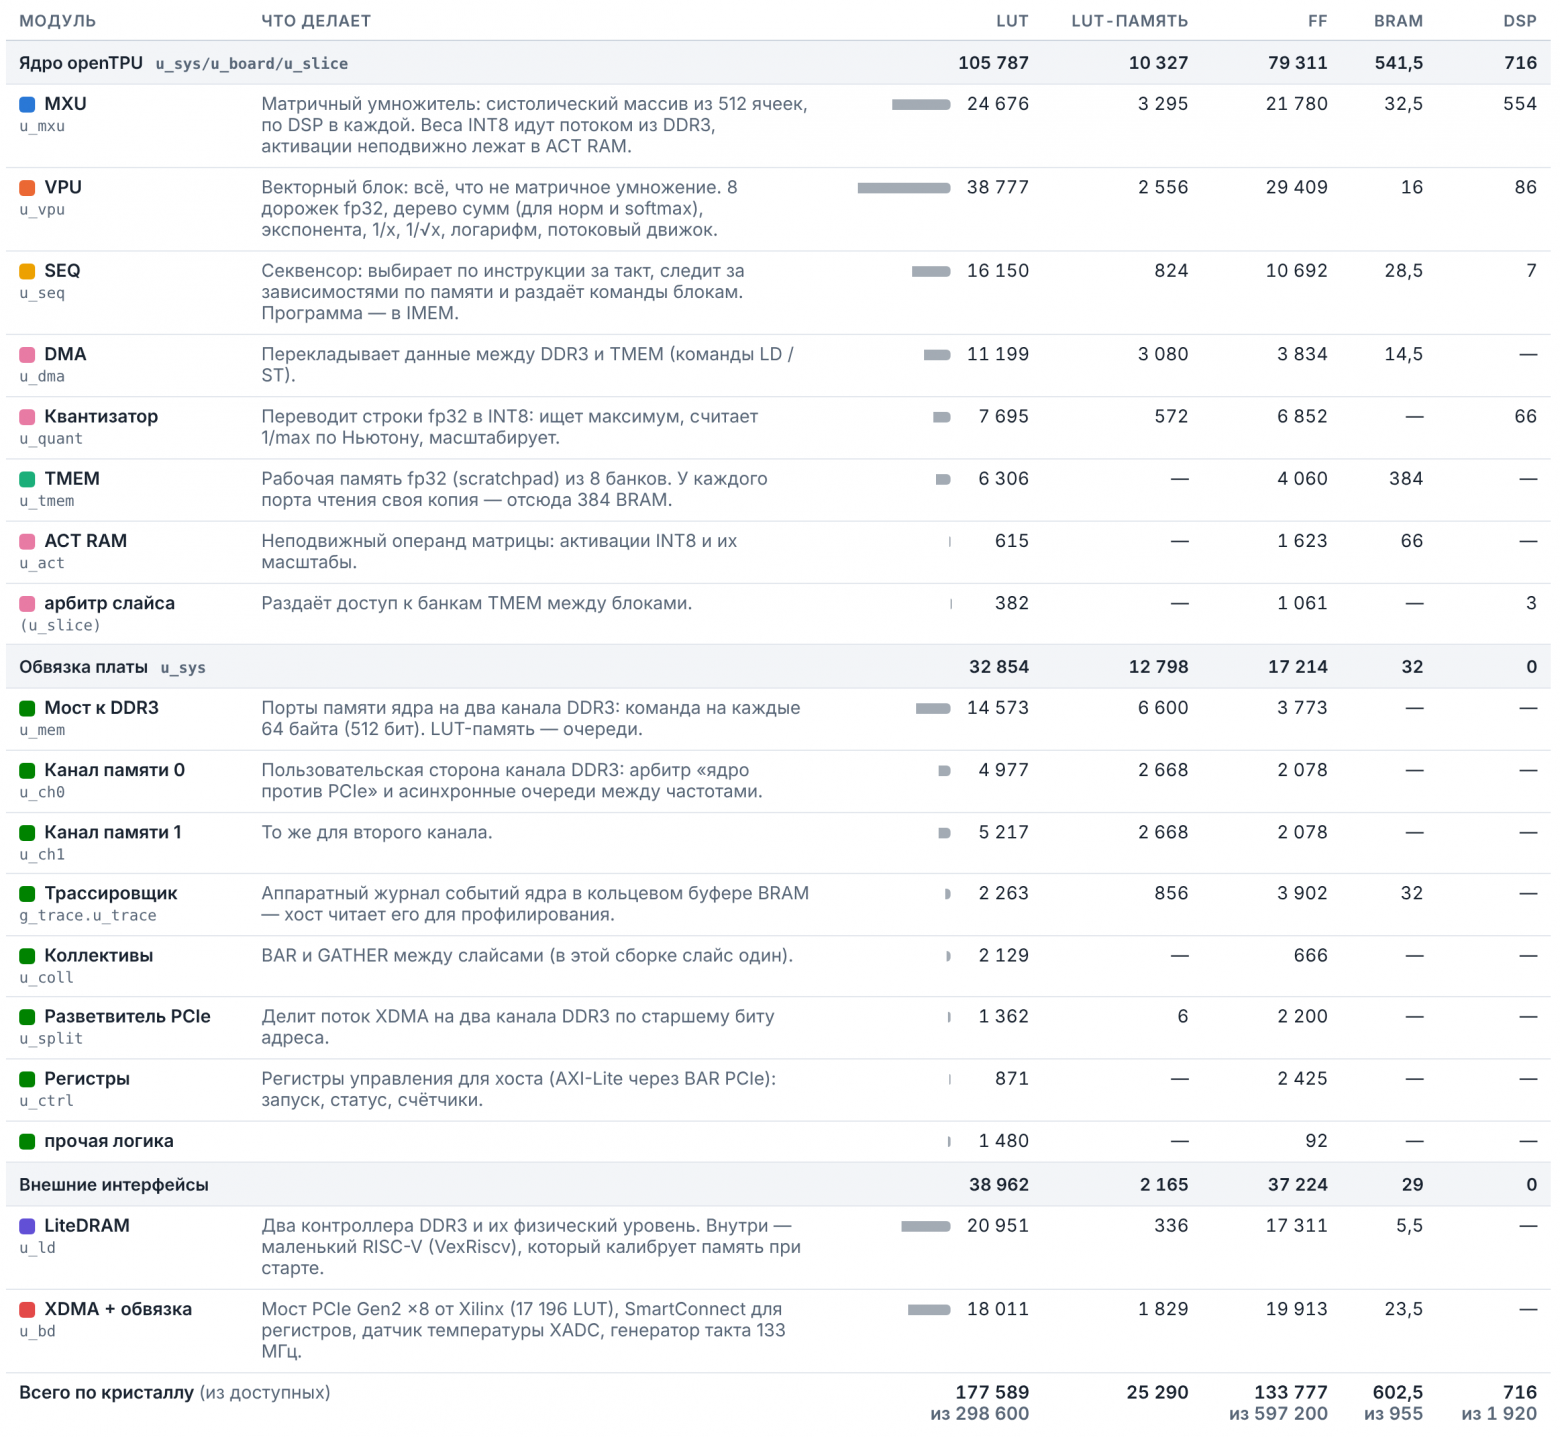
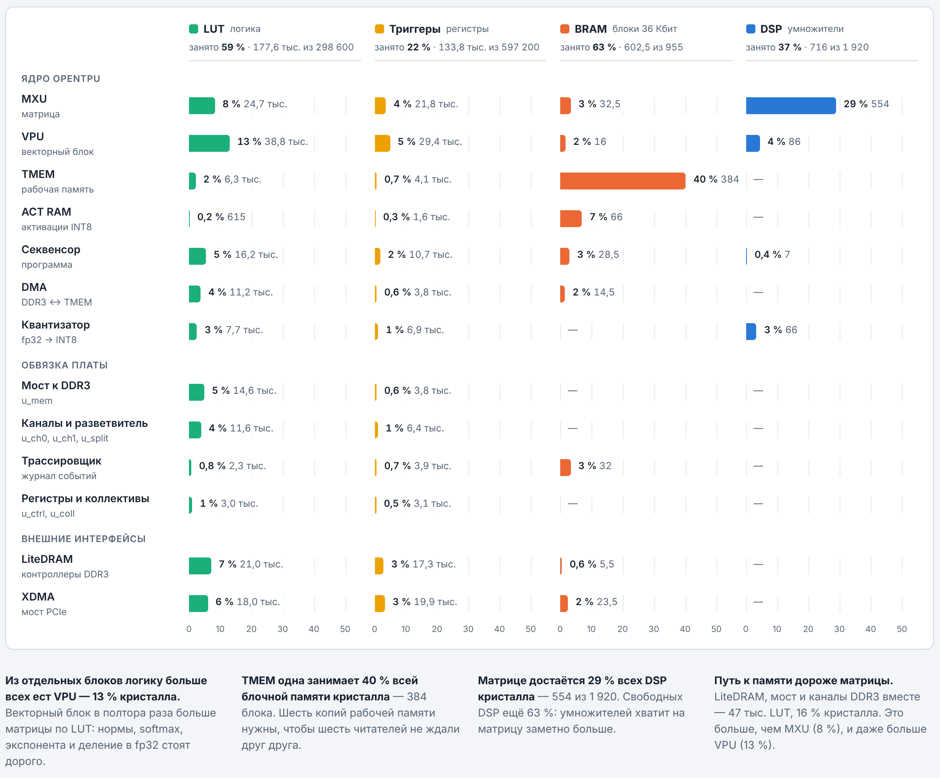
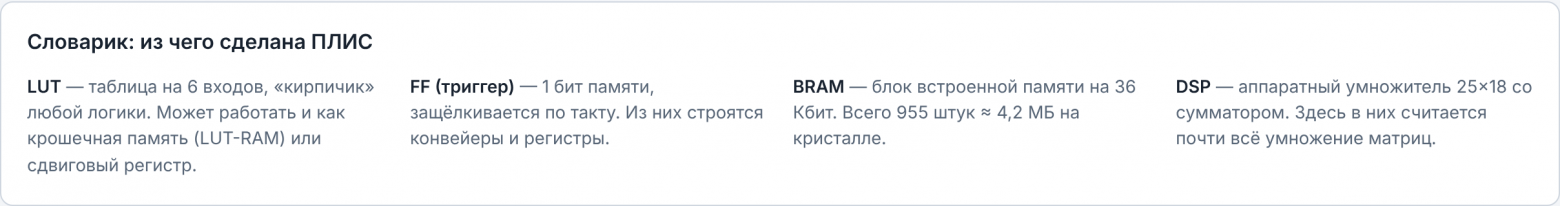
BRAM считаю в эквивалентах блоков по 36 Кбит: блок на 18 Кбит - половинка, отсюда дробные числа.
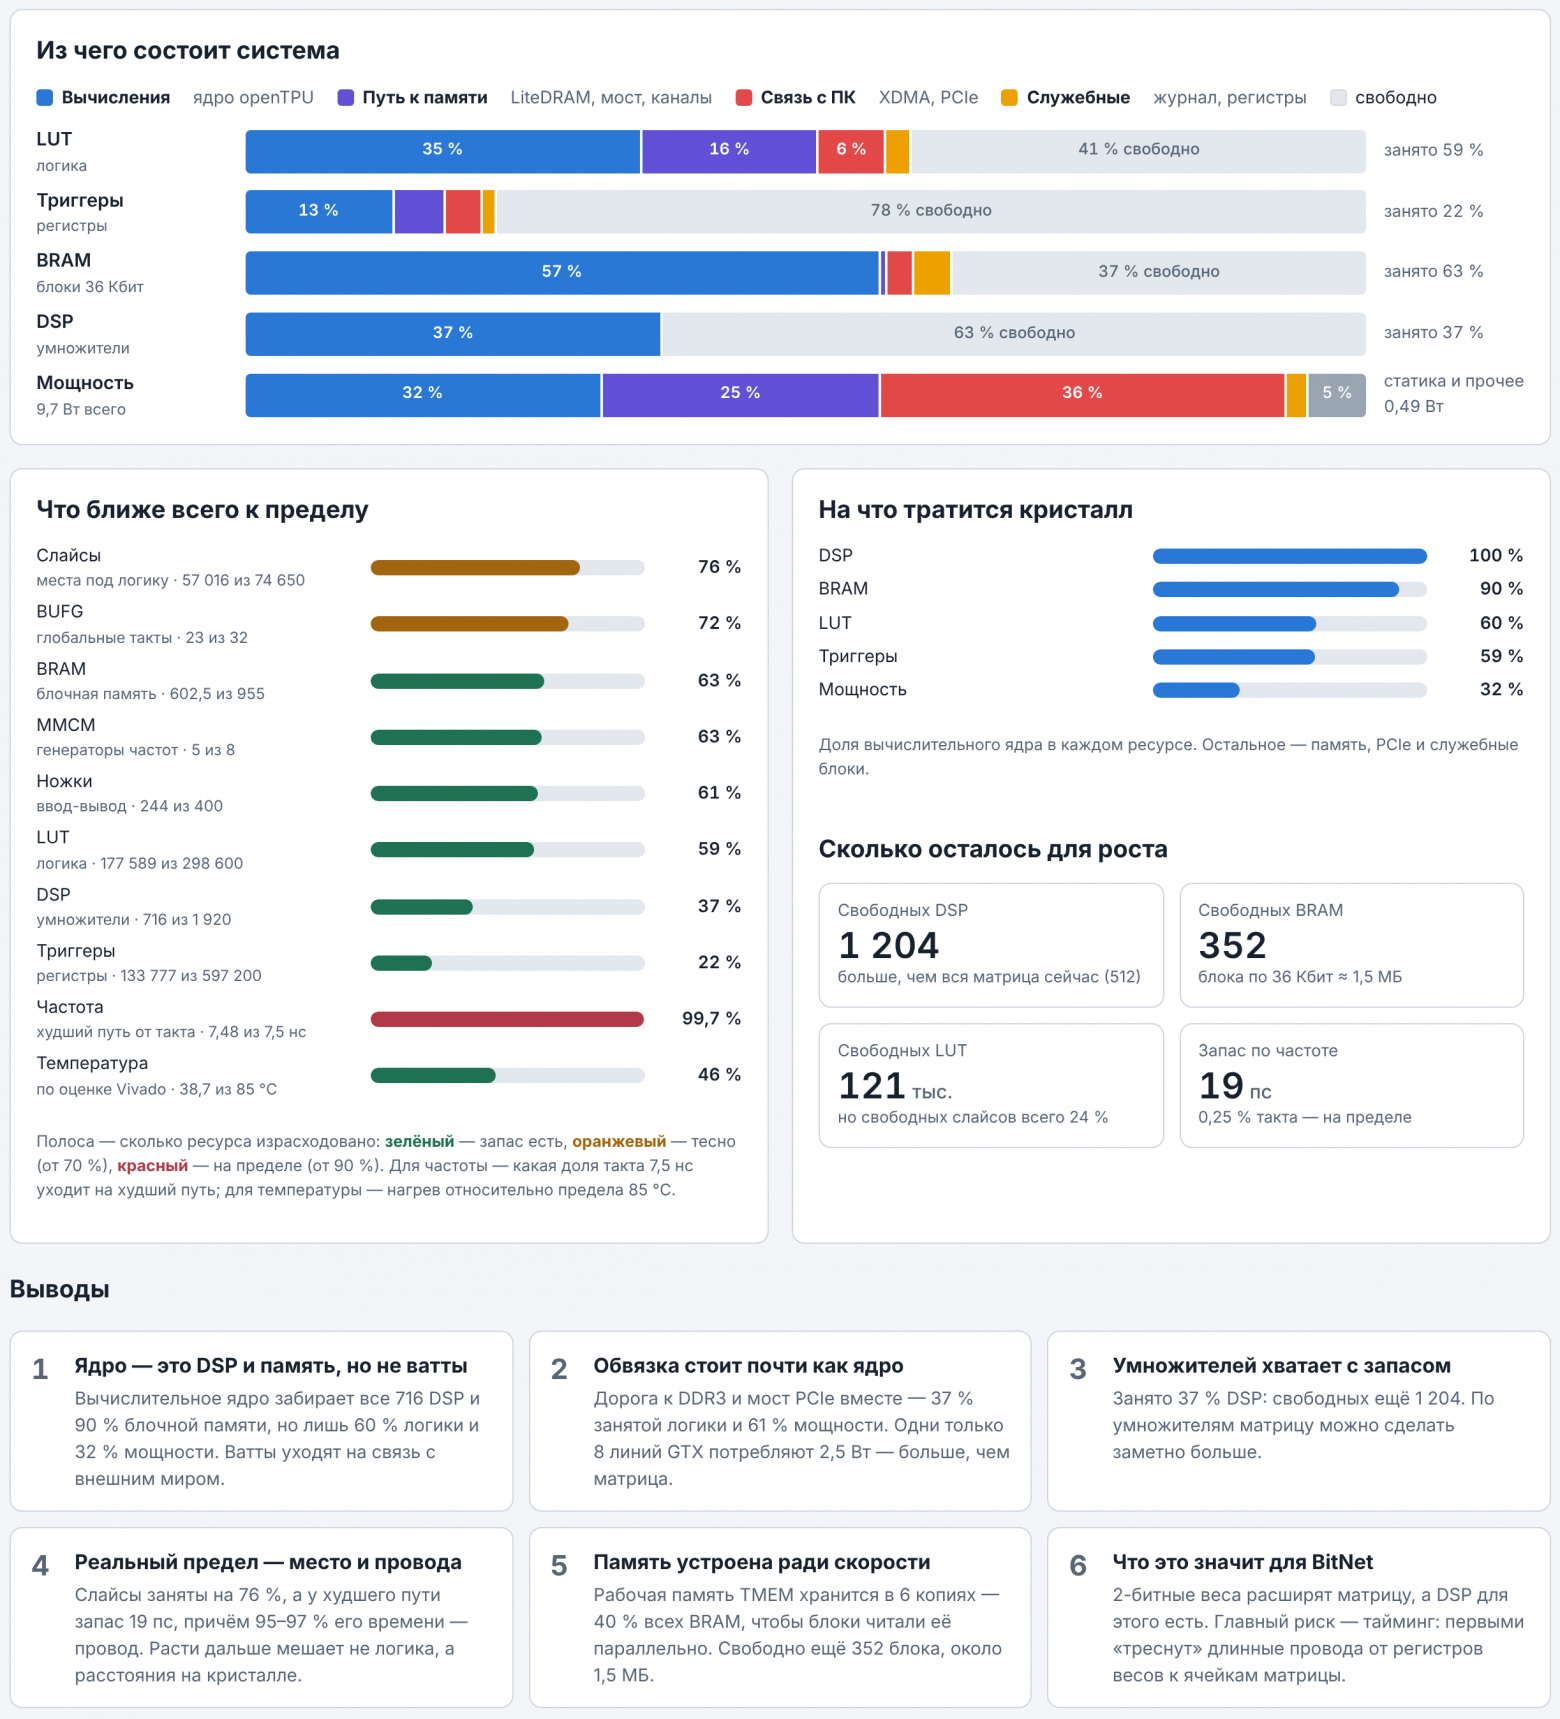
Самый дорогой блок по логике - векторный, а не матрица. VPU - 39 тыс. LUT, в полтора раза больше MXU. Сами 512 ячеек матрицы не тратят ни одного LUT: вся их логика внутри DSP. А экспонента, обратный корень и деление в fp32 собраны из цепочек умножение-сложение - и совпадают с эталоном бит в бит, но стоят дорого.
Рабочая память съела 40 % всех BRAM кристалла. 384 блока. Данные TMEM хранятся в шести копиях, чтобы шесть читателей не стояли в очереди друг за другом: блоки BRAM двухпортовые, и параллельное чтение покупается копиями.
Дорога к памяти дороже матрицы. LiteDRAM, мост и каналы DDR3 - 47 тыс. LUT, 16 % кристалла. Матрица - 8 %.
И ещё: слайсы заняты на 76 %, хотя LUT - на 59 %.
«Свободно 40 %» - иллюзия, места меньше, чем кажется.
Кто съел мои ватты? Куда, по оценке Vivado, уходят 9,7 ватта
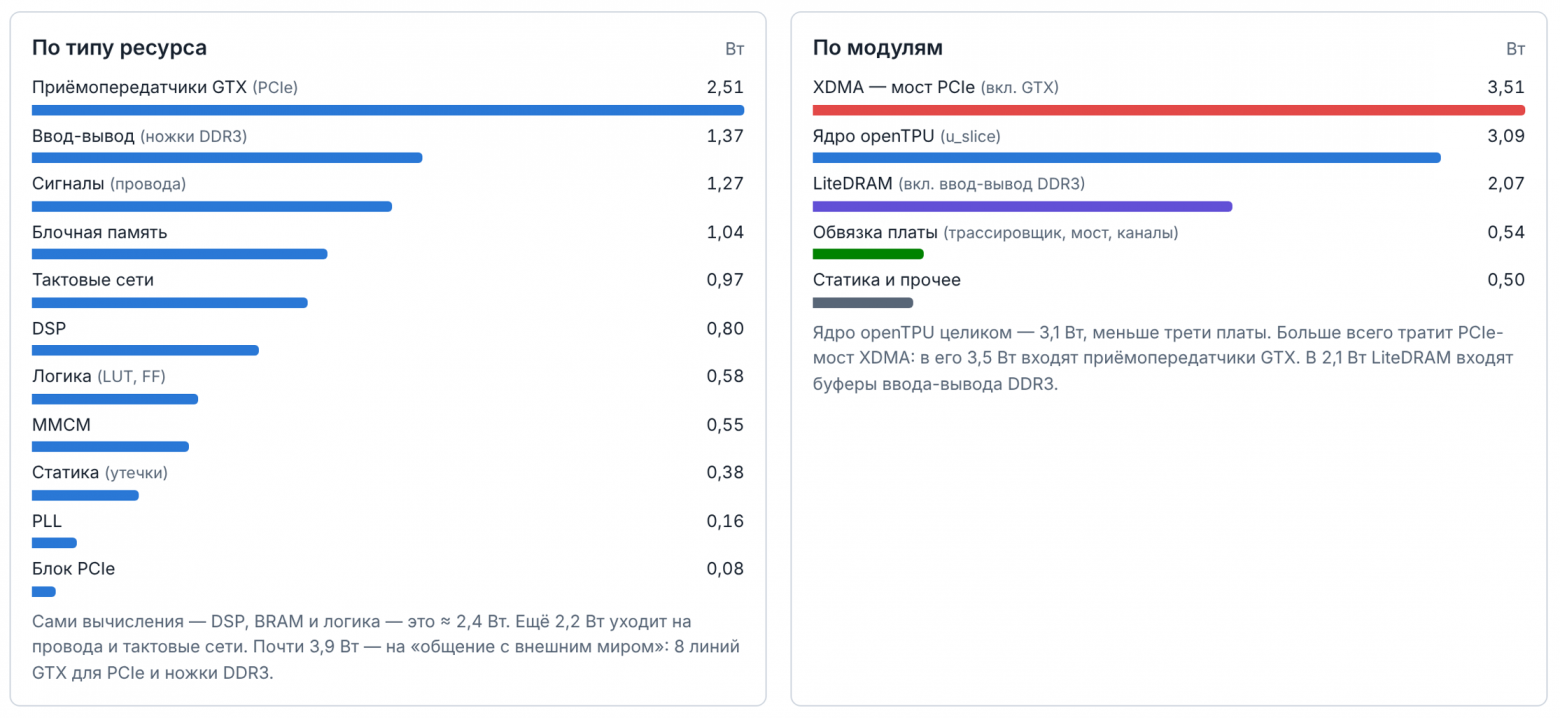
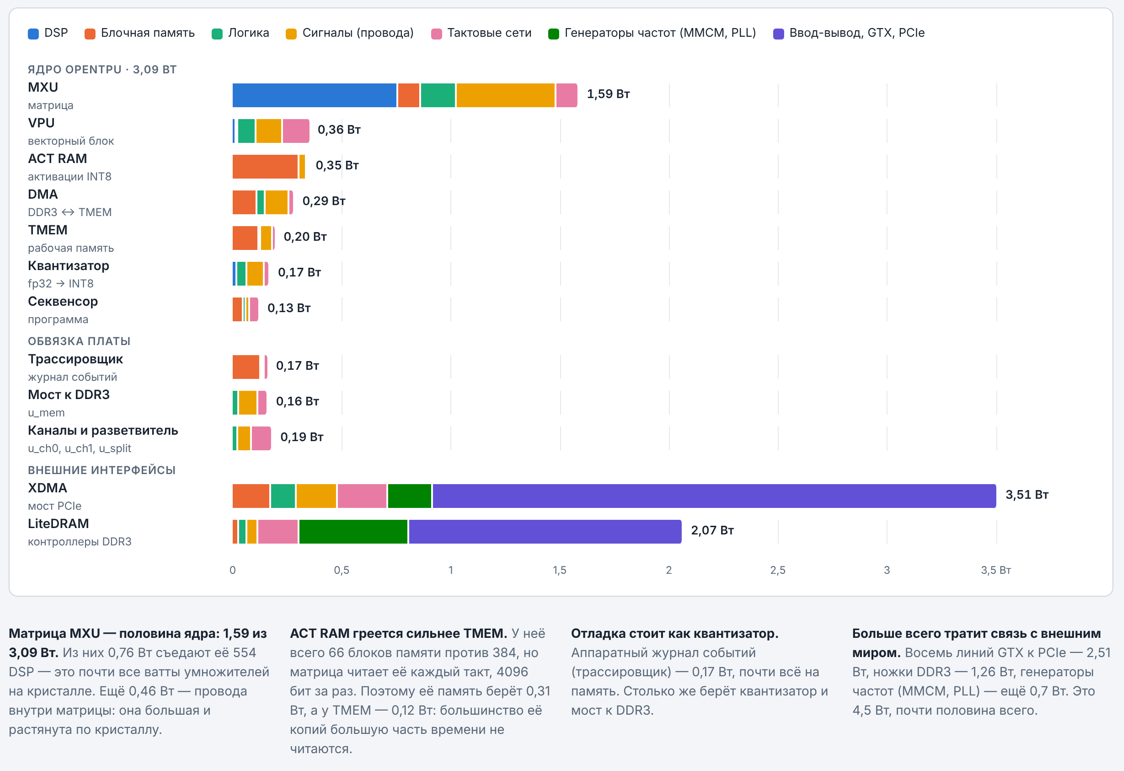
Это оценка Vivado без реальной активности сигналов (Confidence: Low), а не ваттметр. Но картина показательная:
Ядро openTPU - 3,1 Вт, меньше трети. Половину ядра берёт матрица: 1,59 Вт, из них 0,76 - её DSP.
Связь с внешним миром - почти половина всего. Восемь линий GTX для PCIe - 2,5 Вт, ножки DDR3 - 1,3 Вт, генераторы частот - 0,7 Вт. Мост PCIe целиком оценён в 3,5 Вт - больше всего ядра.
Отладка стоит как квантизатор. Аппаратный журнал событий берёт 0,17 Вт. Выключается параметром сборки
TRACE_DEPTH = 0.
Микросхемы DDR3 и потери на преобразователях питания в оценку не входят, так что 9,7 Вт - это кристалл, а не плата.
133 МГц и 19 пикосекунд
В комментариях писали, что 133 МГц для Kintex-7 - «вообще не частота» и надо раскладывать логику в конвейер. Я открыл худшие пути.
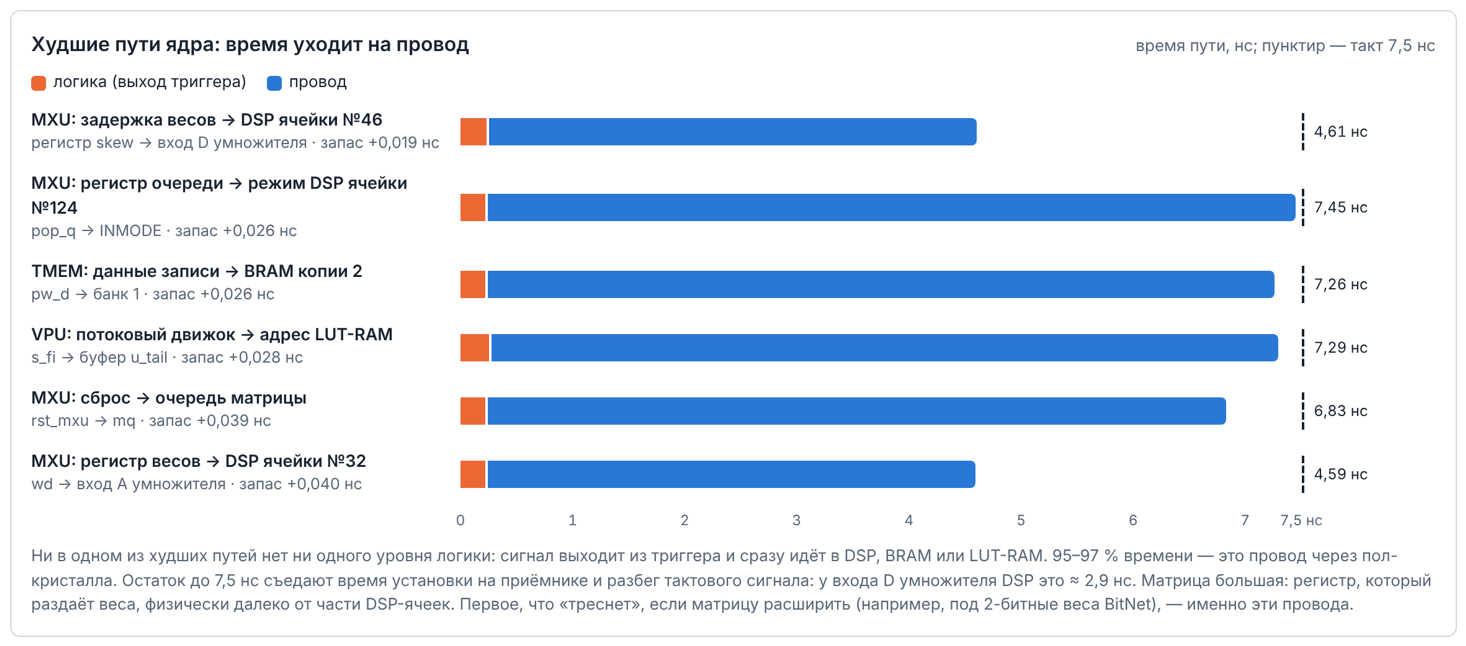
В шести худших путях ядра нет ни одного уровня логики. Сигнал выходит из триггера и сразу идёт во вход DSP, BRAM или LUT-RAM - и 95–97 % времени занимает провод. Например, регистр задержки весов → вход умножителя ячейки № 46: 4,61 нс, из них 4,37 нс - дорога через кристалл.
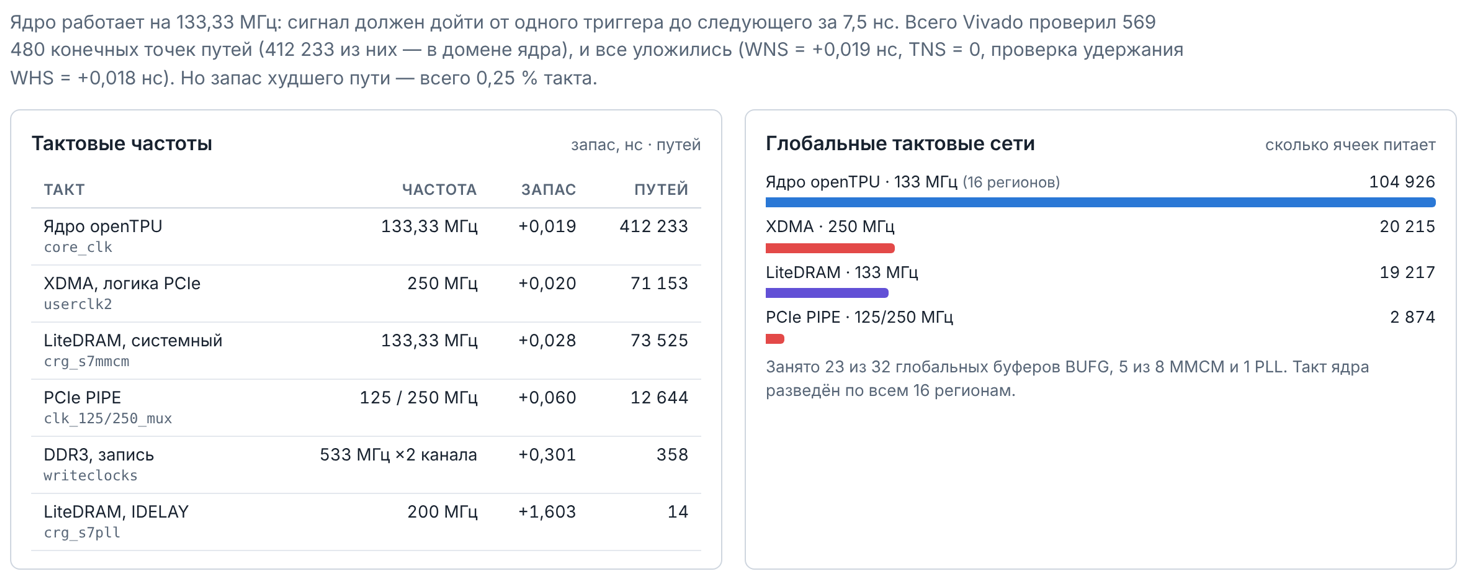
То есть упирается не в сложность логики, а в расстояния: матрица большая, и регистр, раздающий веса, физически далеко от части ячеек. Добавить ступеней в арифметический конвейер - не очевидное лекарство: поднимать частоту пришлось бы через размещение, дублирование и перерегистрацию сигналов. Но главное - для генерации одной частоты мало: порт весов уже равен пику DDR3, и без более широкой памяти быстрее не станет. Это видно и в замерах ниже.
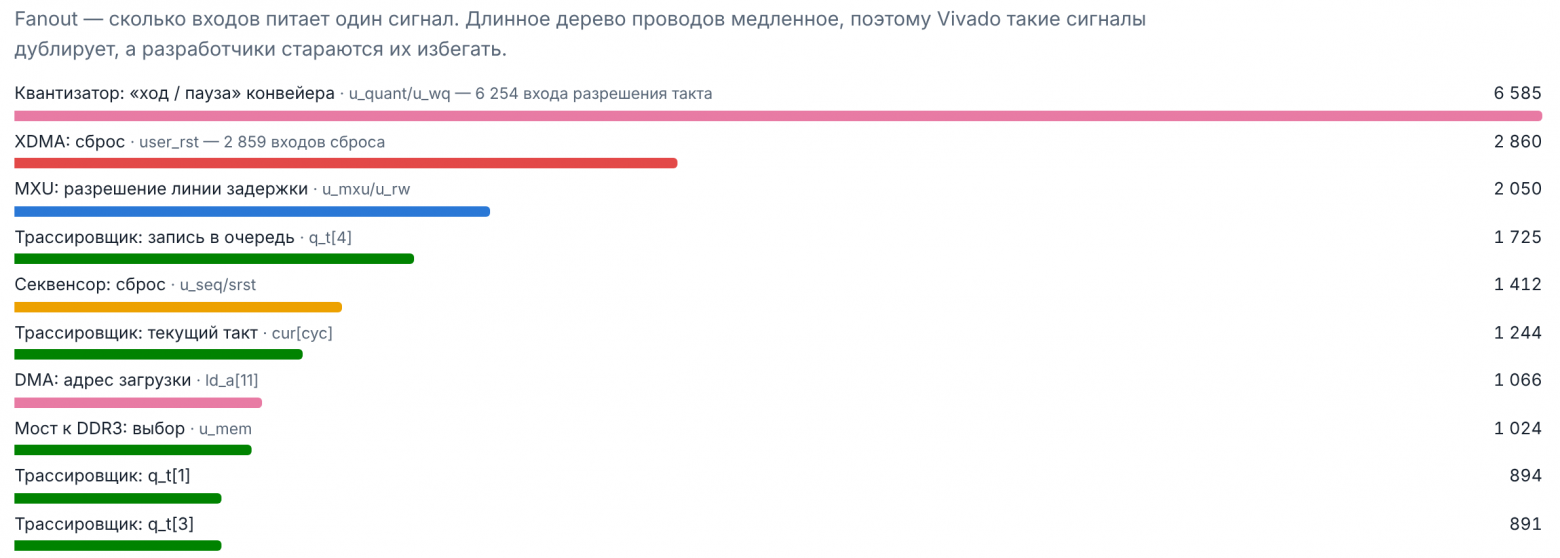
Вторая беда - ветвление. Рекордсмен - сигнал «стоп/ход» конвейера квантизатора: он заходит на 6 585 входов. Чтобы раздать его по кристаллу за один такт, Vivado строит целое дерево копий и буферов. Тайминг он не сломал, но если матрицу расширять, такие деревья вырастут первыми.
6. Погоняем модельки ?
Сначала самую лёгкую - устал уже:
hf download LiquidAI/LFM2.5-230M \
  --local-dir models/LFM2.5-230M
otpu-chat \
--backend board \
--model lfm2 \
--wformat fp4 \
--head-format int8 \
--greedy \
--max-new 64 \
--prompt "What is an FPGA? Answer in three sentences."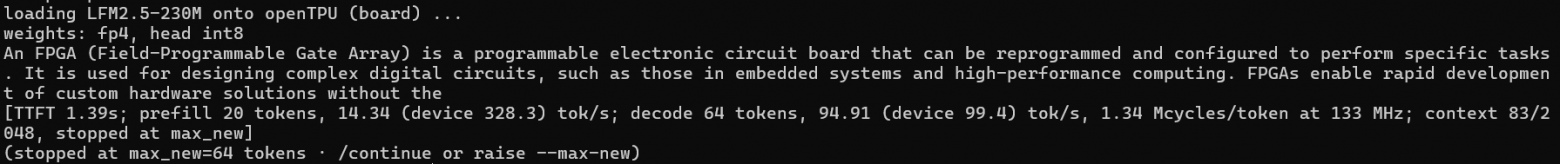
И плата ответила - УСПЕШИЩЕ, товарищи!!!!
Результат: 94,91 токена/с с учётом хоста и 99,4 токена/с по аппаратным счётчикам FPGA. Время до первого токена - 1,39 секунды. На каждый токен ядро тратит в среднем 1,34 млн тактов при 133 МГц.
Можно и с чатиком
cd ~/OTPU_habr/openTPU
source .venv/bin/activate

otpu-chat \
  --backend board \
  --dev /dev/xdma0 \
  --model lfm2 \
  --wformat fp4 \
  --head-format int8 \
  --greedy \
  --cap 2048 \
  --max-new 256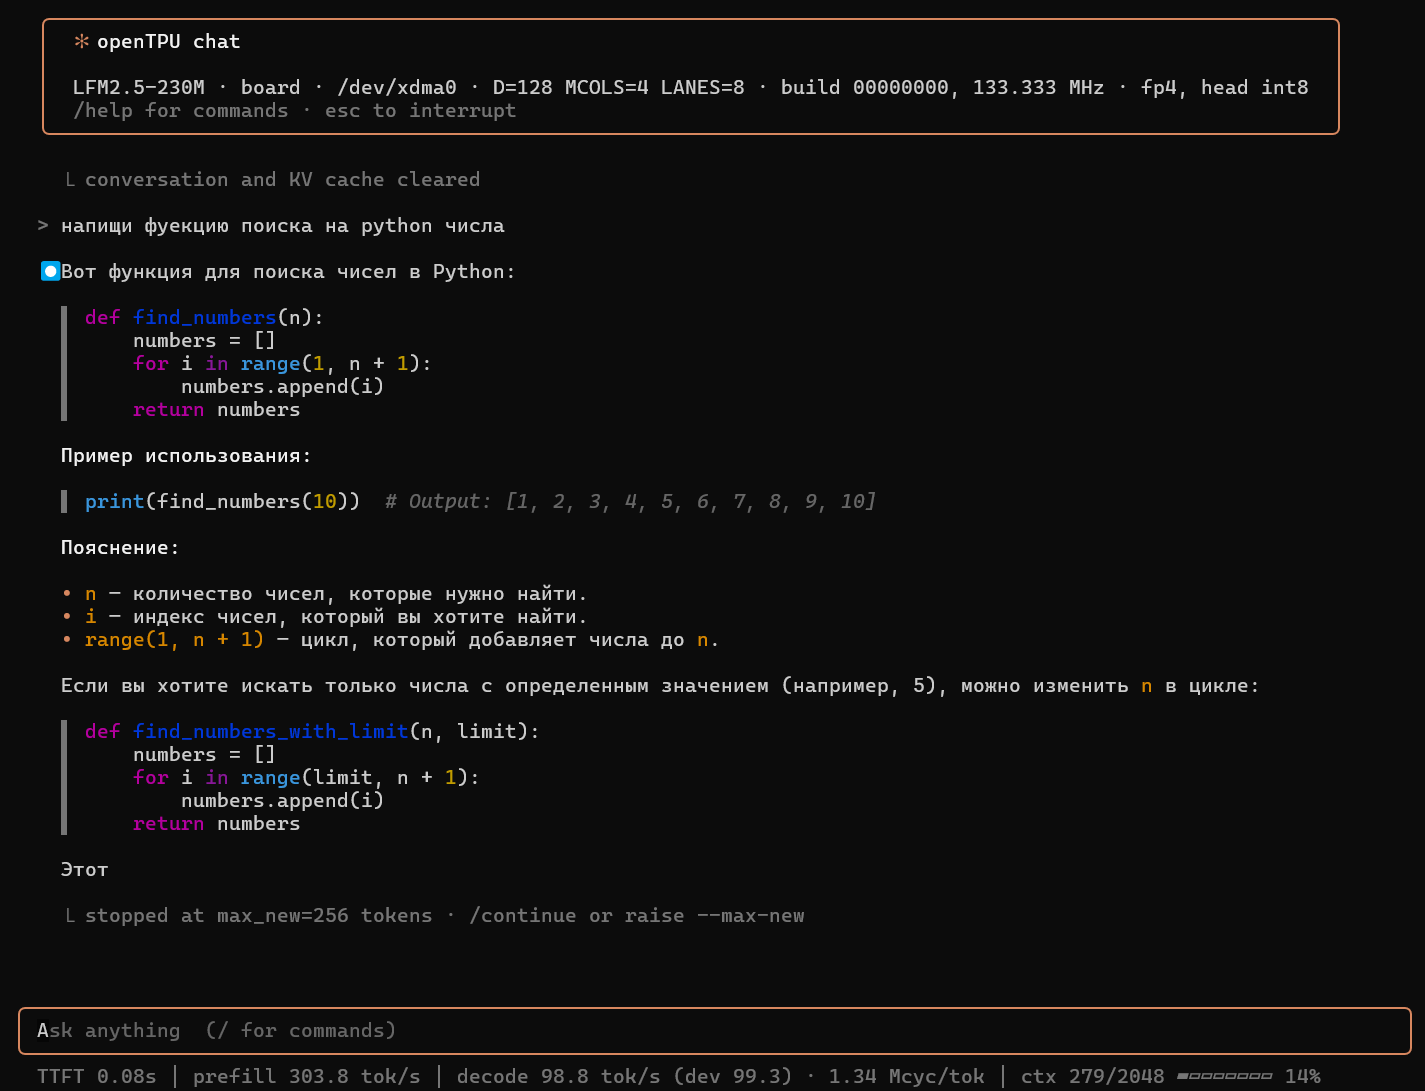
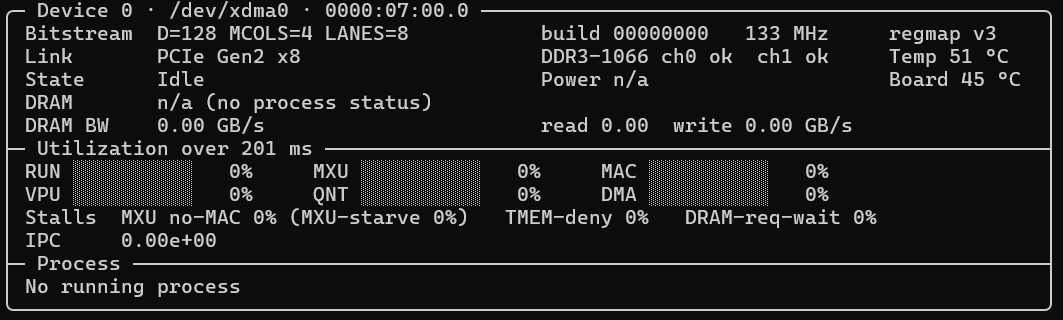
А так выглядит otpu-smi во время генерации - счётчики берутся из самой платы:
Один запуск ничего не говорит об ограничениях. Поэтому серия:
8 моделей от 230 млн до 4 млрд параметров: LFM2.5-230M, Qwen3-0.6B, Qwen3.5-0.8B, Qwen3.5-2B, LFM2-2.6B, SmolLM3-3B, Phi-4-mini, Qwen3.5-4B;
2 формата весов - 4 бита (FP4) и int8, LM head везде int8;
11 сценариев: промпт от 33 до 824 токенов, генерация от 64 до 1024, контекст 512 / 1024 / 2048, повтор «на тёплую».
bench_all_opentpu.py
#!/usr/bin/env python3
"""openTPU Kintex-7 comprehensive benchmark: serial, resumable, non-destructive.
Uses otpu-chat + native otpu-smi --json -l 0.5. Does NOT flash or change RTL.
"""
import argparse, csv, datetime, hashlib, json, os, pathlib, platform, re, shlex, shutil, signal, subprocess, sys, time

ROOT = pathlib.Path.home() / 'openTPU-main'
# Actual folder names already used by this project. Case insensitive resolution also supported.
MODELS = [
 ('lfm230','LFM2.5-230M','dense'), ('qwen06','Qwen3-0.6B','dense'),
 ('qwen08','Qwen3.5-0.8B','dense'), ('qwen17','Qwen3-1.7B','experimental'),
 ('qwen2','Qwen3.5-2B','dense'), ('lfm26','LFM2-2.6B','dense'),
 ('smol3','SmolLM3-3B','dense'), ('phi4','Phi-4-mini-instruct','dense'),
 ('qwen4','Qwen3.5-4B','dense'), ('gemmaE2','gemma-4-E2B-it','special'),
 ('gemmaE4','gemma-4-E4B-it','special'), ('lfm8','LFM2.5-8B-A1B','moe'),
]
# Only model/format pairs known to fit in card's 4GiB image or supported by the project.
# "default" lets openTPU choose its model-specific mixed layout (Gemma).
FP4_FORMATS = [('fp4','int8')]
INT8_OK = {'lfm230','qwen06','qwen08','qwen2','lfm26','smol3','phi4'}
FP4_ONLY = {'qwen4','qwen17','lfm8'}
TTFT = re.compile(r'TTFT\s+([\d.]+)s;')
PREFILL = re.compile(r'prefill\s+(\d+)\s+tokens,\s+([\d.]+)\s+\(device\s+([\d.]+)\)\s+tok/s')
DECODE = re.compile(r'decode\s+(\d+)\s+tokens,\s+([\d.]+)\s+\(device\s+([\d.]+)\)\s+tok/s,\s+([\d.]+)\s+Mcycles/token')
NUM = (int,float)
FIELDS = ['id','model','group','scenario','wformat','head_format','prompt_target_words',
 'actual_prefill_tokens','cap','max_new','repeat','status','exit_code','elapsed_s',
 'ttft_s','prefill_wall_tps','prefill_device_tps','decode_tokens','decode_wall_tps',
 'decode_device_tps','mcycles_per_token','cache_files_before','cache_files_after',
 'cache_bytes_before','cache_bytes_after','smi_samples','smi_active_samples',
 'smi_running_time_s','dram_read_gbs','dram_write_gbs','dram_total_gbs',
 'dram_read_peak_gbs','dram_write_peak_gbs','mxu_busy_pct','mxu_mac_pct',
 'vpu_busy_pct','qnt_busy_pct','dma_busy_pct','tmem_deny_pct','dram_wait_pct',
 'mxu_starve_pct','temperature_mean_c','temperature_max_c', 'power_mean_w',
 'error','folder']
COUNTER_KEYS = ('RUNNING','MXU_BUSY','MXU_MAC','VPU_BUSY','QNT_BUSY',
                'DMA_BUSY','TMEM_DENY','DRAM_WAIT','MXU_STARVE')

def now(): return datetime.datetime.now().isoformat(timespec='seconds')
def jsondump(path,obj):
    tmp=path.with_suffix(path.suffix+'.tmp')
    tmp.write_text(json.dumps(obj,ensure_ascii=False,indent=2,default=str),encoding='utf-8')
    tmp.replace(path)
def models_present(root):
    base=root/'models'
    if not base.exists():return {}
    candidates={p.name.lower():p for p in base.iterdir() if p.is_dir()}
    return {key:candidates.get(name.lower()) for key,name,_ in MODELS}
def valid_checkpoint(p):
    if not p or not (p/'config.json').is_file(): return False
    return bool(list(p.glob('*.safetensors')) or list(p.glob('*.bin')))
def cache_snapshot(path):
    try:
        return {'files':sum(1 for p in path.rglob('*') if p.is_file()),
                'bytes':sum(p.stat().st_size for p in path.rglob('*') if p.is_file())}
    except (OSError,PermissionError): return {'files':None,'bytes':None}
def iter_json(path):
    dec=json.JSONDecoder()
    if not path.exists():return
    with path.open('r',errors='replace') as f:
        buf=''
        while True:
            data=f.read(262144)
            if data:buf+=data
            pos=0
            while pos<len(buf):
                while pos<len(buf) and buf[pos].isspace():pos+=1
                if pos==len(buf):break
                try: obj,end=dec.raw_decode(buf,pos)
                except ValueError:break
                pos=end
                if isinstance(obj,list):
                    for item in obj:
                        if isinstance(item,dict):yield item
                elif isinstance(obj,dict):yield obj
            buf=buf[pos:]
            if not data:break

def telemetry(path):
    rec=list(iter_json(path)); utilrows=[]
    for r in rec:
        u=r.get('util') or {}
        if not isinstance(u,dict):continue
        # running is a status AT sample end; RUNNING fractional utilization detects
        # sub-500ms kernel launches and is more reliable for LLM token-by-token decode.
        run=u.get('RUNNING')
        sec=(r.get('sample') or {}).get('seconds')
        if isinstance(run,NUM) and run>0 and isinstance(sec,NUM) and sec>0:
            utilrows.append((r, float(sec)*float(run)))
    out={'smi_samples':len(rec),'smi_active_samples':len(utilrows),
         'smi_running_time_s':round(sum(w for _,w in utilrows),5)}
    # Weighted average for active device-cycle metrics. Each r['util'][k] is a
    # wall-time fraction over sampling period; dividing by RUNNING gives percent
    # of cycles running, clipped only for occasional sampling noise.
    run_s=out['smi_running_time_s']
    if run_s>0:
        for k in COUNTER_KEYS[1:]:
            vals=[]
            for r,w in utilrows:
                u=r['util']; sec=r['sample']['seconds']
                if isinstance(u.get(k),NUM): vals.append((float(u[k])*sec, w))
            if vals:
                val=100*sum(x for x,_ in vals)/sum(w for _,w in vals)
                out[k.lower()+'_pct']=round(val,3)
        for source,target in [('dram_rd_gbs','dram_read_gbs'),
                              ('dram_wr_gbs','dram_write_gbs'),
                              ('dram_gbs','dram_total_gbs')]:
            vals=[]
            for r,w in utilrows:
                val=r.get(source)
                if isinstance(val,NUM): vals.append((float(val)*r['sample']['seconds'],w))
            if vals:out[target]=round(sum(v for v,_ in vals)/sum(w for _,w in vals),4)
    for source,target in [('dram_rd_gbs','dram_read_peak_gbs'),
                          ('dram_wr_gbs','dram_write_peak_gbs')]:
        vals=[r[source] for r,_ in utilrows if isinstance(r.get(source),NUM)]
        if vals:out[target]=round(max(vals),4)
    temps=[r.get('temp_c') for r in rec if isinstance(r.get('temp_c'),NUM)]
    if temps:
        out['temperature_mean_c']=round(sum(temps)/len(temps),3)
        out['temperature_max_c']=round(max(temps),3)
    # Power is optional and not available with --no-i2c on some cards.
    power=[r.get('power') for r in rec if isinstance(r.get('power'),NUM)]
    if power:out['power_mean_w']=round(sum(power)/len(power),3)
    return out

def prompt_words(n):
    # Repeated meaningful English text. "n" is an approximate WORD target,
    # NOT a guaranteed token count; the device's actual prefill count is recorded.
    base=('Explain field programmable gate arrays, matrix multiplication, neural network '
          'inference, quantized weights, memory bandwidth, PCI Express, and streaming '
          'computations. Discuss real hardware bottlenecks with practical examples. ')
    words=(base*max(1, (n//20)+2)).split()
    return ' '.join(words[:n]) + ' Continue with a detailed technical explanation.'

def matrix(selected,profile,format_test,include_moe):
    # Stable deterministic order, group by MODEL to reuse host quant cache.
    for key,name,group in MODELS:
        if key not in selected:continue
        if group=='moe' and not include_moe:continue
        forms=[(None,None)] if group=='special' else list(FP4_FORMATS)
        if group=='special' and key=='gemmaE2':forms=[('fp4','int8'),('fp4','fp4')]
        if format_test and key in INT8_OK:forms.append(('int8','int8'))
        for wf,hf in forms:
            label=(wf or 'default')+'_'+(hf or 'default')
            # quick=2 tests/model, standard=6-8 tests/model, full=14+ tests/model
            scenarios=[('baseline',64,256,1024,1),('warm',64,256,1024,2)]
            if profile in ('standard','full'):
                scenarios += [('short_prefill',16,256,1024,1),
                              ('long_prefill',128,256,1024,1),
                              ('short_decode',64,64,1024,1),
                              ('long_decode',64,512,1024,1)]
            if profile=='full':
                scenarios += [('prefill_128',128,256,1024,1),
                              ('prefill_512',512,256,2048,1),
                              ('decode_1024',64,1024,2048,1),
                              ('cap_512',64,256,512,1),
                              ('cap_2048',64,256,2048,1)]
            for typ,words,new,cap,repeat in scenarios:
                yield {'id':f'{key}_{label}_{typ}','key':key,'model':name,'group':group,
                       'scenario':typ,'wformat':wf or 'default',
                       'head_format':hf or 'default','prompt_target_words':words,
                       'cap':cap,'max_new':new,'repeat':repeat}

def terminate(proc):
    if proc is None or proc.poll() is not None:return
    try:proc.send_signal(signal.SIGINT);proc.wait(timeout=3)
    except (OSError,subprocess.TimeoutExpired):
        proc.terminate()
        try:proc.wait(timeout=4)
        except subprocess.TimeoutExpired:proc.kill();proc.wait()

def benchmark(case,root,folder,env,args,path):
    row={k:v for k,v in case.items() if k in FIELDS}; row['folder']=str(folder)
    model_dir=path[case['key']]
    if not valid_checkpoint(model_dir):
        row.update(status='missing',error='Missing complete checkpoint/config; no download is attempted')
        return row
    folder.mkdir(parents=True,exist_ok=True)
    cmd=[str(root/'.venv/bin/otpu-chat'),'--backend','board','--dev',args.device,
         '--model',str(model_dir),'--cap',str(case['cap']), '--max-new',
         str(case['max_new']),'--greedy','--prompt',prompt_words(case['prompt_target_words'])]
    if case['wformat']!='default':cmd.extend(['--wformat',case['wformat']])
    if case['head_format']!='default':cmd.extend(['--head-format',case['head_format']])
    meta={'command':cmd,'started_at':now(), 'env':{k:env.get(k) for k in
          ('OTPU_IMAGE_CACHE','OTPU_DMA_CHUNK_KIB','OPENBLAS_NUM_THREADS')},
          'checkpoint':str(model_dir)}
    jsondump(folder/'command.json',meta)
    cb=cache_snapshot(pathlib.Path(env['OTPU_IMAGE_CACHE']))
    row['cache_files_before']=cb['files'];row['cache_bytes_before']=cb['bytes']
    start=time.monotonic(); smi=None
    try:
        with (folder/'smi.json').open('w',buffering=1) as sf, \
             (folder/'smi.stderr.log').open('w') as se, \
             (folder/'chat.log').open('w',buffering=1) as cf:
            smi=subprocess.Popen([str(root/'.venv/bin/otpu-smi'),'--dev',args.device,
                                  '--no-i2c','--json','-l',str(args.interval)],
                                 cwd=root,env=env,stdout=sf,stderr=se)
            time.sleep(min(0.2,args.interval))
            try:
                result=subprocess.run(cmd,cwd=root,env=env,stdout=cf,
                                      stderr=subprocess.STDOUT,timeout=args.timeout)
                row['exit_code']=result.returncode
                row['status']='ok' if result.returncode==0 else 'failed'
            except subprocess.TimeoutExpired:
                row.update(status='timeout',exit_code=-1,error='otpu-chat timed out')
            finally:terminate(smi)
    except Exception as e:
        terminate(smi)
        row.update(status='failed',error=repr(e))
    row['elapsed_s']=round(time.monotonic()-start,3)
    ca=cache_snapshot(pathlib.Path(env['OTPU_IMAGE_CACHE']))
    row['cache_files_after']=ca['files'];row['cache_bytes_after']=ca['bytes']
    content=(folder/'chat.log').read_text(errors='replace') if (folder/'chat.log').exists() else ''
    for regex,keys in ((TTFT,['ttft_s']),
                       (PREFILL,['actual_prefill_tokens','prefill_wall_tps','prefill_device_tps']),
                       (DECODE,['decode_tokens','decode_wall_tps','decode_device_tps','mcycles_per_token'])):
        mat=regex.search(content)
        if mat:
            for k,v in zip(keys,mat.groups()):row[k]=int(v) if k in ('actual_prefill_tokens','decode_tokens') else float(v)
    try:row.update(telemetry(folder/'smi.json'))
    except Exception as e:row['error']=(row.get('error','')+'; SMI parse: '+repr(e))
    if row.get('status')=='ok' and not row.get('decode_tokens'):
        row['status']='no_metrics';row['error']='Process returned 0 but decode metrics not found; check chat.log'
    jsondump(folder/'result.json',row)
    return row

def main():
    ap=argparse.ArgumentParser(description=__doc__)
    ap.add_argument('--root',type=pathlib.Path,default=ROOT)
    ap.add_argument('--device',default='/dev/xdma0')
    ap.add_argument('--profile',choices=['quick','standard','full'],default='standard')
    ap.add_argument('--models',nargs='+',default=['lfm230','qwen06','qwen08','qwen2','lfm26','smol3','phi4','qwen4'],
                    help='Short model IDs; see --list')
    ap.add_argument('--include-moe',action='store_true')
    ap.add_argument('--all-formats',action='store_true',help='Enable INT8 comparison where known')
    ap.add_argument('--timeout',type=int,default=1800)
    ap.add_argument('--interval',type=float,default=0.5)
    ap.add_argument('--output',type=pathlib.Path)
    ap.add_argument('--list',action='store_true')
    ap.add_argument('--dry-run',action='store_true')
    args=ap.parse_args();root=args.root.expanduser().resolve();paths=models_present(root)
    valid_ids={k for k,_,_ in MODELS}
    invalid=set(args.models)-valid_ids
    if invalid:ap.error('Unknown model IDs: '+', '.join(sorted(invalid)))
    if args.list:
        for k,n,g in MODELS:print(f'{k:10} {g:14} {"READY" if valid_checkpoint(paths[k]) else "MISSING":8} {n}')
        return
    if not args.include_moe and 'lfm8' in args.models:
        ap.error('For MoE add --include-moe (pool generation and offload may be slow)')
    cases=list(matrix(set(args.models),args.profile,args.all_formats,args.include_moe))
    print('Planned:',len(cases),'tests (sequential).')
    if args.dry_run:
        for i,c in enumerate(cases,1):print(f'{i:3} {c["id"]}: cap={c["cap"]} new={c["max_new"]} words={c["prompt_target_words"]}')
        return
    for binary in ('otpu-chat','otpu-smi'):
        if not (root/'.venv/bin'/binary).exists():ap.error('Missing '+binary+' in '+str(root/'.venv/bin'))
    # --device is a logical XDMA prefix; Linux creates /dev/xdma0_user,
    # /dev/xdma0_h2c_0, /dev/xdma0_c2h_0 (not /dev/xdma0).
    device_prefix = pathlib.Path(args.device)
    if not device_prefix.exists():
        required = [pathlib.Path(args.device + suffix)
                    for suffix in ('_user', '_h2c_0', '_c2h_0')]
        missing = [str(path) for path in required if not path.is_char_device()]
        if missing:
            ap.error('XDMA device nodes missing: ' + ', '.join(missing))
    env=os.environ.copy()
    env.setdefault('OTPU_IMAGE_CACHE',str(pathlib.Path.home()/'otpu-qcache'))
    env.setdefault('OTPU_DMA_CHUNK_KIB','1024')
    env.update(OPENBLAS_NUM_THREADS='1',MKL_NUM_THREADS='1',OMP_NUM_THREADS='1')
    out=(args.output or root/'benchmarks'/'llm'/('all_'+datetime.datetime.now().strftime('%Y%m%d_%H%M%S'))).expanduser().resolve()
    out.mkdir(parents=True,exist_ok=True)
    inventory={'created_at':now(),'hostname':platform.node(),'platform':platform.platform(),
               'python':sys.version,'profile':args.profile,'device':args.device,
               'model_directories':{k:str(v) if v else None for k,v in paths.items()},
               'quant_image_cache':env['OTPU_IMAGE_CACHE'],'dma_chunk_kib':env['OTPU_DMA_CHUNK_KIB'],
               'cases_planned':len(cases),'notes':[
                   'Native otpu-smi JSON; RUNNING util fraction detects sub-interval kernels.',
                   'DRAM/MXU active-cycle estimates exclude idle intervals; no phase tagging.',
                   'Prompts specified by words; actual tokens taken from otpu-chat log.',
                   'FP4 cache persists across invocations; every process may reupload board image.',
                   'Temperature includes host quantization/loading time; I2C power disabled.',
                   'Missing metrics are blank, never zero-filled.']}
    jsondump(out/'manifest.json',inventory)
    results={}
    if (out/'results.jsonl').exists():
        for line in (out/'results.jsonl').read_text().splitlines():
            try:r=json.loads(line);results[r['id']]=r
            except (ValueError,KeyError):pass
    for i,case in enumerate(cases,1):
        if case['id'] in results:
            print(f'[{i}/{len(cases)}] SKIP completed {case["id"]}',flush=True)
            continue
        print(f'[{i}/{len(cases)}] {now()} {case["id"]}',flush=True)
        row=benchmark(case,root,out/case['id'],env,args,paths)
        results[case['id']]=row
        with (out/'results.jsonl').open('a') as f:f.write(json.dumps(row,ensure_ascii=False)+'\n')
        with (out/'summary.csv').open('w',newline='') as f:
            w=csv.DictWriter(f,FIELDS,extrasaction='ignore');w.writeheader()
            for c in cases:
                if c['id'] in results:w.writerow(results[c['id']])
        jsondump(out/'summary.json',[results[c['id']] for c in cases if c['id'] in results])
        print('     ',row['status'],row.get('decode_wall_tps','—'),'tok/s',
              'DDR3 RD',row.get('dram_read_gbs','—
                                '),'GB/s',
              'Tmax',row.get('temperature_max_c','—'),'C',flush=True)
        if row['status']=='timeout':
            print('Timeout: stopping suite to avoid hardware/driver issues. Resume with same --output.',file=sys.stderr)
            break
    print('Results:',out,flush=True)
if __name__=='__main__':main()
Запуск:
python bench_all_opentpu.py \
  --root "$PWD" \
  --device /dev/xdma0 \
  --profile full \
  --all-formats \
  --timeout 1800 \
  --interval 0.5 \
  2>&1 | tee bench_165.log
Итого 165 запусков, все завершились успешно, 3 часа 16 минут. Скорость считал по счётчикам тактов самой платы, загрузку блоков и памяти каждые полсекунды снимал otpu-smi.
Оговорка: «без ошибок» значит, что все запуски отработали и выдали текст. Побитовое совпадение с эталоном я проверял на уровне инструкций (103 теста выше), а не для каждого из 165 ответов.
Скорость генерации
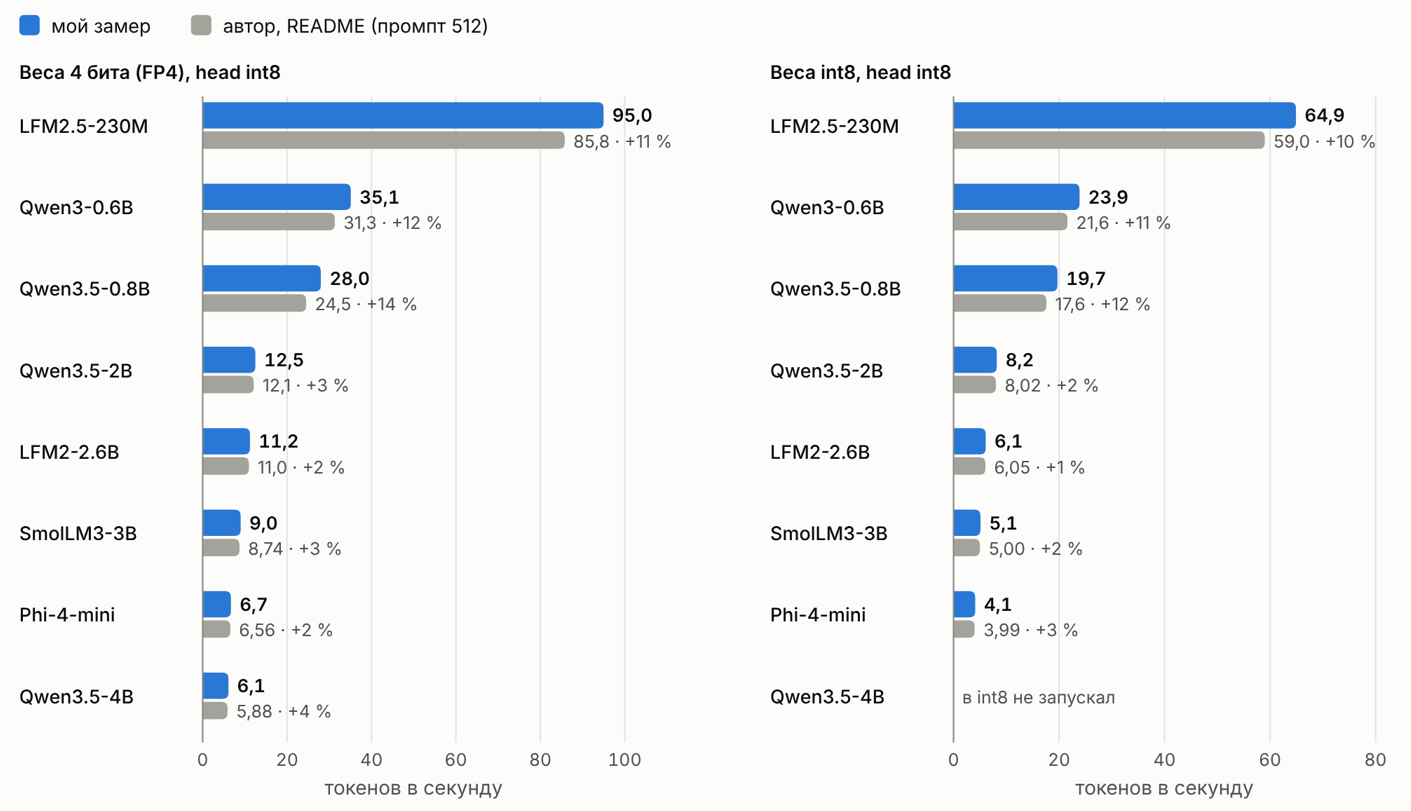
Скорость - по счётчику тактов платы (device), то есть без накладных расходов хоста; у автора взяты тоже device-цифры. С хостом выходит чуть меньше: у Qwen3.5-2B 12,40 против 12,5. Промпт около 770 токенов, 256 токенов генерации; у автора промпт 512 и 64 токена, а строки его таблицы, как он сам пишет, сняты на разных образах прошивки.
Так что это проверка сопоставимости, а не соревнование. На всех 15 конфигурациях мои цифры на уровне авторских или немного выше: на больших моделях +1…4 %, на маленьких +10…14 %.
Размер контекста 512, 1024 или 2048 на скорость не влияет. Длинная генерация (1024 токена вместо 256) у Qwen3.5-2B не меняет ничего, у маленькой Qwen3-0.6B даёт минус 5 %: растущий KV-кэш заметен только на фоне лёгких весов.
Почему именно такие цифры: потолок памяти
При генерации каждого токена плата читает из памяти все веса модели. Значит:
токенов в секунду ≤ скорость памяти ÷ байт, прочитанных на токен
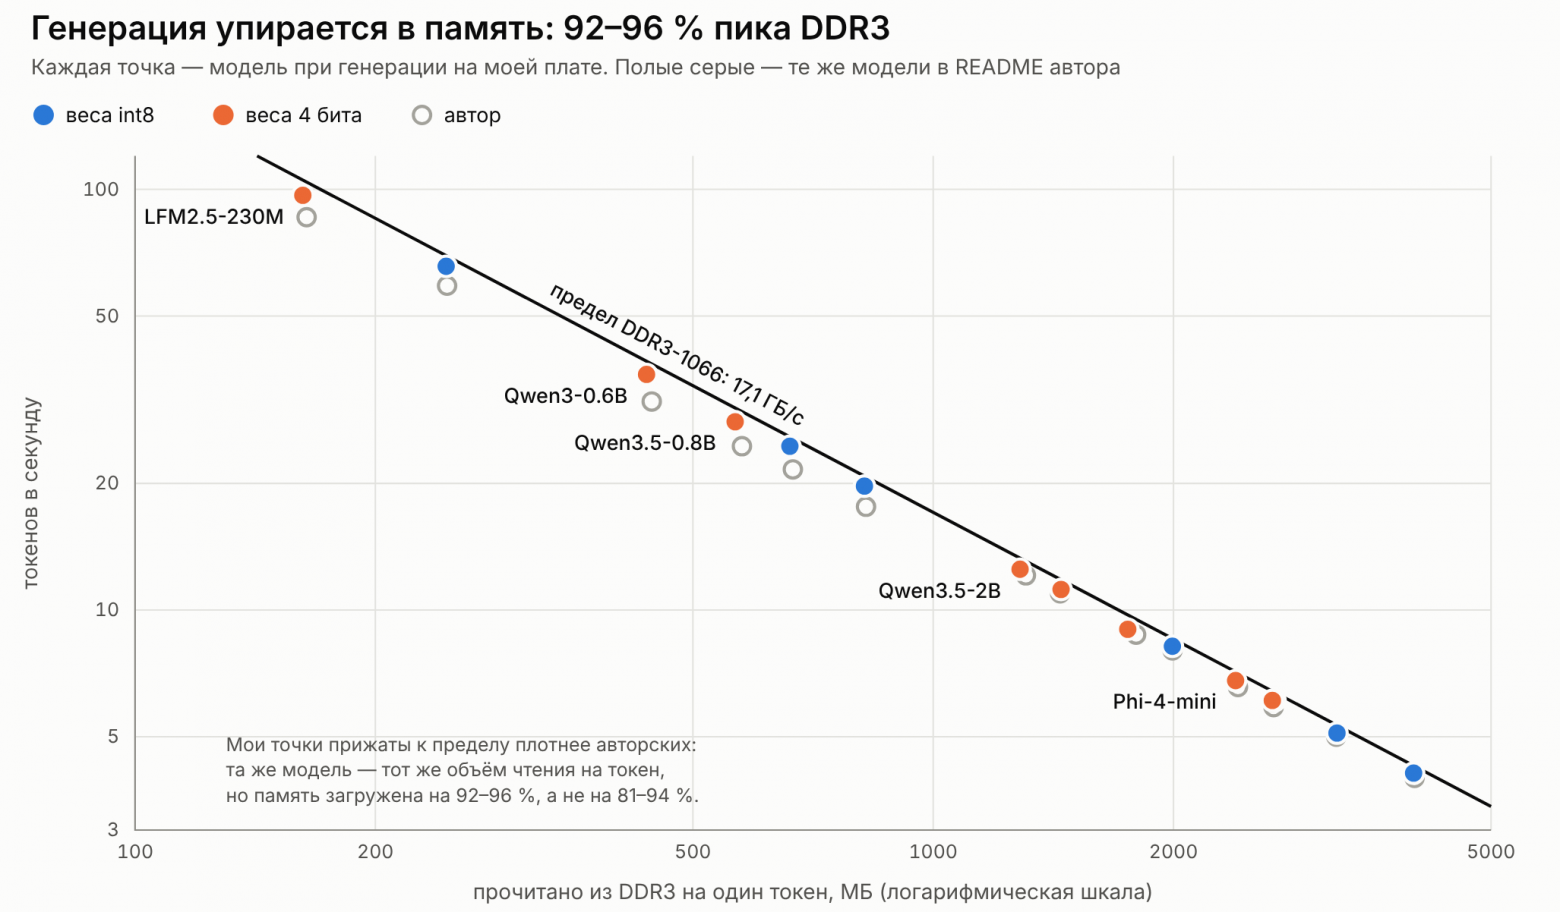
Счётчики платы это подтверждают. При генерации DDR3 загружена на 92-96 % пика: от 15,7 ГБ/с у самой маленькой модели до 16,4 ГБ/с у Phi-4-mini в int8. Qwen3.5-2B в 4 битах читает 1,29 ГБ на токен при 16,1 ГБ/с - отсюда 12,5 ток/с. Все 15 точек ложатся вдоль одной линии:
Отсюда же видно, почему 4 бита быстрее int8 не в два раза, а в 1,4-1,8: LM head остаётся в int8, плюс масштабы и KV-кэш. Скорость меняется ровно во столько раз, во сколько меняется объём чтения на токен.
А матрица в это время занята 99,9 % тактов, из них 82–93 % действительно умножает, и ждёт данных всего 0,1-2,8 %. Противоречия нет: память и матрица работают конвейером, матрица не простаивает - просто каждого веса хватает ровно на одно умножение.
На что способна сама матрица: 121 GOPS
Чтобы отделить матрицу от памяти, я отдельно гонял умножение int8 разных размеров: M строк активаций на матрицу весов N × N, по пять повторов, каждый результат сверялся с эталоном на CPU.
benchmark_gemm_fpga.py
#!/usr/bin/env python3
"""Real-board openTPU GEMM benchmark. No LLM, no RTL simulation, no bitstream change.

Uses runtime.compile_kernel() -> ISA assembler -> Board.load_program()/run().
Counts device cycles from hardware R_CYCLES; separately measures host wall time.
"""
import argparse
import csv
import json
import math
import sys
import time
from pathlib import Path

import numpy as np

from opentpu import isa as I
from opentpu import language as ol
from opentpu.host.board import Board, XdmaTransport, device_config
from opentpu.runtime import Input, Output, Weight, compile_kernel


@ol.jit
def gemm(x, w, out):
    # x[M,K] * w[N,K].T -> y[M,N]; W8A8, block-quantized MXU.
    q = ol.quantize(ol.load(x))
    ol.store(out, ol.dot(q, w))


def main():
    ap = argparse.ArgumentParser(description=__doc__)
    ap.add_argument('--dev', default='/dev/xdma0')
    ap.add_argument('--sizes', default='128,512,1024,2048', help='N=K sizes, multiples of D=128')
    ap.add_argument('--rows', default='1,4,8', help='M rows')
    ap.add_argument('--repeats', type=int, default=5)
    ap.add_argument('--max-rel-error', type=float, default=0.08,
                    help='Relative L2 norm error vs fp32 NumPy (quantized W8A8)')
    ap.add_argument('--out', default=None, help='Results directory')
    a = ap.parse_args()
    if a.repeats < 1:
        ap.error('--repeats must be >= 1')
    root = Path(a.out or ('benchmarks/gemm_' + time.strftime('%Y%m%d_%H%M%S')))
    root.mkdir(parents=True, exist_ok=True)
    csv_path = root / 'results.csv'
    config_path = root / 'board.json'
    sizes = [int(v) for v in a.sizes.split(',')]
    rows = [int(v) for v in a.rows.split(',')]
    print('openTPU physical FPGA GEMM', flush=True)
    print(f'Device: {a.dev}; Results: {root}', flush=True)

    with Board(XdmaTransport(a.dev)) as board:
        info = board.info()
        # Restrict *host-side staging image* to 16 MiB, not physical installed DRAM.
        # The actual board keeps its full DDR3; our data and code occupy only this area.
        cfg = device_config(info, DRAM_BYTES=16 << 20)
        core_hz = info['core_khz'] * 1000
        config_path.write_text(json.dumps({
            'device': a.dev, 'core_hz': core_hz, 'D': cfg.D, 'MCOLS': cfg.MCOLS,
            'LANES': cfg.LANES, 'DRAM_BYTES_host_image': cfg.DRAM_BYTES,
            'sizes': sizes, 'rows': rows, 'repeats': a.repeats,
            'note': 'GOPS assumes 2 operations per MAC; W8A8 quantized GEMM'
        }, indent=2))
        if not info['calibrated']:
            raise RuntimeError('DDR3 not calibrated')
        print(f"Core {core_hz/1e6:.3f} MHz, D={cfg.D}, MCOLS={cfg.MCOLS}, "
              f"LANES={cfg.LANES}; ECC calibrated={info['calibrated']}", flush=True)
        print('FPGA locked. Compiling and running hardware GEMM...', flush=True)
        fieldnames = ('M,N,K,repetition,core_cycles,core_ms,host_run_ms,readback_ms,ops,gops_device,rel_l2_error,max_abs_error,verified').split(',')
        failures = 0
        with csv_path.open('w', newline='') as f:
            writer = csv.DictWriter(f, fieldnames=fieldnames)
            writer.writeheader()
            for N in sizes:
                K = N
                if K % cfg.D or N % cfg.D:
                    raise ValueError(f'N,K must be multiples of D={cfg.D}')
                for M in rows:
                    if M <= 0 or M > 8:
                        raise ValueError('M must be 1..8 for this small-TMEM test')
                    rng = np.random.default_rng(1000000 + M * 10000 + N)
                    x = rng.normal(size=(M, K)).astype(np.float32)
                    w = (rng.normal(size=(N, K)) / np.sqrt(K)).astype(np.float32)
                    t_compile = time.perf_counter()
                    compiled, images = compile_kernel(
                        gemm, cfg, x=Input(x), w=Weight(w, shard=0, fmt='int8'),
                        out=Output((M, N)))
                    instructions = I.assemble(compiled.programs[0])
                    # Program stored outside the runtime's data image, inside 16 MiB.
                    program_addr = 12 << 20
                    program_bytes = len(instructions) * 4
                    if program_addr + program_bytes > cfg.DRAM_BYTES:
                        raise RuntimeError('Program exceeds reserved DRAM image')
                    # The runtime's allocations start at 0 and stay below 8 MiB for these sizes.
                    # Host image includes initialized zeros for ECC-safe subsequent reads.
                    if (8 << 20) > program_addr:
                        raise RuntimeError('Invalid layout')
                    if np.any(images[0][8 << 20:program_addr]):
                        raise RuntimeError('Data image crosses 8 MiB region; reduce N/K')
                    board.write(0, images[0][:8 << 20])
                    board.load_program(program_addr, instructions)
                    result_addr = compiled.layout.params['out'][1]
                    if result_addr + M * N * 4 > (8 << 20):
                        raise RuntimeError('Output exceeds initialized 8 MiB')
                    ref = x @ w.T
                    print(f'M={M:2d}, N=K={N:4d}: compiled in '
                          f'{time.perf_counter()-t_compile:.2f}s, program {len(instructions)//8} instr',
                          flush=True)
                    for rep in range(1, a.repeats + 1):
                        t0 = time.perf_counter()
                        stats = board.run()
                        host_s = time.perf_counter() - t0
                        t1 = time.perf_counter()
                        got = board.read(result_addr, M * N * 4).view(np.float32).reshape(M, N).copy()
                        read_s = time.perf_counter() - t1
                        err = float(np.linalg.norm((got-ref).astype(np.float64)) /
                                    max(float(np.linalg.norm(ref.astype(np.float64))), 1e-12))
                        abserr = float(np.max(np.abs(got-ref)))
                        valid = bool(np.isfinite(got).all() and err <= a.max_rel_error)
                        failures += not valid
                        cycles = int(stats['cycles'])
                        ops = 2 * M * N * K
                        device_s = cycles / core_hz
                        gops = ops / device_s / 1e9 if cycles else float('nan')
                        writer.writerow(dict(M=M, N=N, K=K, repetition=rep, core_cycles=cycles,
                            core_ms=round(device_s*1e3,6), host_run_ms=round(host_s*1e3,6),
                            readback_ms=round(read_s*1e3,6), ops=ops,
                            gops_device=round(gops,6), rel_l2_error=round(err,7),
                            max_abs_error=round(abserr,7), verified=int(valid)))
                        f.flush()
                        print(f'  #{rep}: {cycles} cycles, {device_s*1e3:.3f} ms device, '
                              f'{gops:.3f} GOPS, error={err:.5f}, '
                              f"{'PASS' if valid else 'FAIL'}", flush=True)
    print(f'\nResults CSV: {csv_path}; mismatches: {failures}')
    return 1 if failures else 0


if __name__ == '__main__':
    try:
        sys.exit(main())
    except Exception as e:
        print(f'ERROR: {type(e).__name__}: {e}', file=sys.stderr)
        raise
Запуск:
cd ~/OTPU_habr/openTPU
source .venv/bin/activate

python benchmark_gemm_fpga.py \
  --dev /dev/xdma0 \
  --sizes 128,512,1024,2048 \
  --rows 1,4,8 \
  --repeats 5 \
  2>&1 | tee gemm_test.log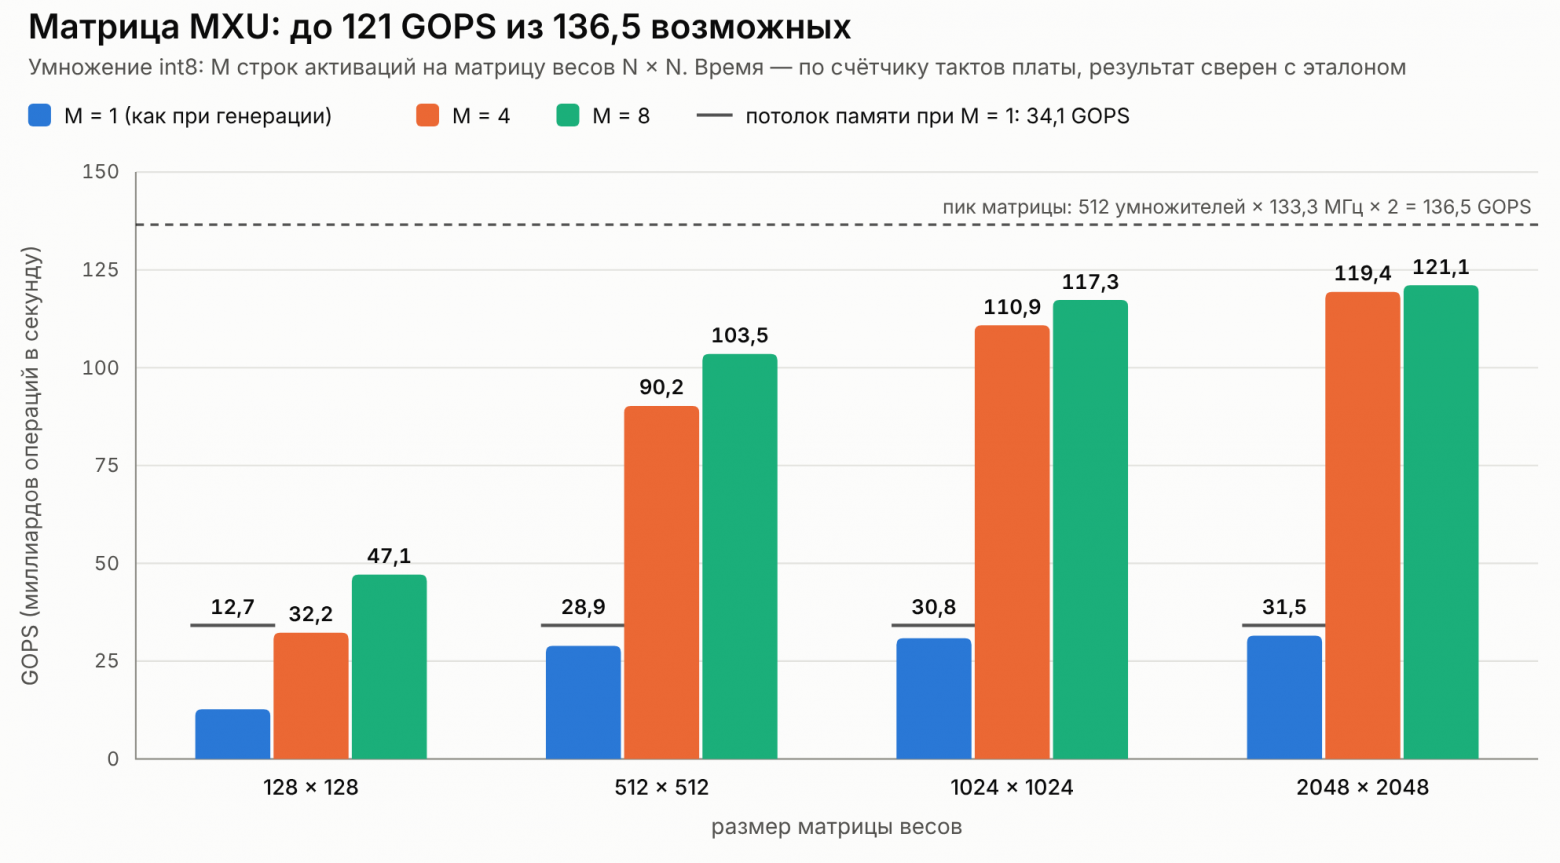
GOPS, умножение и сложение - две операции.
Пик матрицы - 512 умножителей × 133,33 МГц × 2 = 136,5 GOPS. На 2048 × 2048 при M = 8 получилось 121,1 - 89 % пика. Для FPGA за $50 это очень прилично.
Генерация токена - это случай M = 1: одна строка активаций, каждый вес используется один раз. Веса приходят по 128 байт за такт, то есть 17,07 ГБ/с × 2 операции = 34,1 GOPS - потолок, сколько умножителей ни ставь. Получено 31,5, 92 % от него. Значит, при генерации матрица может выдать не больше четверти своего пика.
Prefill обрабатывает сразу много токенов - тот же вес используется для нескольких строк, - поэтому он в 2,5–3,5 раза быстрее генерации.
Ошибка относительно эталона - 0,9 % во всех 60 прогонах. Это квантование int8, а не сбой.
PCIe почти не влияет на генерацию.
Это не универсальное свойство ускорителей. Если модель не помещается в память платы и эксперты или слои подгружаются с хоста, PCIe снова становится узким местом.
Чем больше модель, тем дольше подготовка и загрузка
Температура
Кристалл в простое - 58 °C, за три часа нагрузки - 59–65 °C, максимум 65,2 °C. Датчик на самой плате - 52 °C. Vivado для сравнения обещал 38,7 °C, но его модель считает при 25 °C вокруг и заданном обдуве - реальный датчик честнее.
7. ИТОГО
Если коротко, вот что я вынес из этой части.
Умножители - не главное. Из 1920 DSP занято 37 % - их хватило бы ещё на две такие матрицы. Но слайсы заняты на 76 %, BRAM - на 63 %, а запас по таймингу - 19 пикосекунд. Добавить DSP легко, развести и прокормить их - нет.
Обвязка стоит как ядро. Вычислительное ядро - это 35 % всех LUT кристалла и 32 % расчётной мощности. Дорога к DDR3 - ещё 16 % LUT и 25 % мощности, PCIe - всего 6 % LUT, но 36 % мощности. Интерфейсы вместе съедают почти вдвое больше ватт, чем вычисления (оценка Vivado, не ваттметр).
Генерация упирается в память. Матрица умеет 121 GOPS, но при генерации ей дают меньше четверти: DDR3 и так работает на 92–96 %.
На моей плате веса едут к матрице по двум каналам DDR3 через половину кристалла - отсюда и 17 ГБ/с потолка. Индустрия бьётся ровно с этим же, только масштабом побольше, и вариантов у неё по сути три.
Подвинуть память к вычислителю. Это HBM: память ставят стопкой прямо рядом с кристаллом, а шина у неё шириной в тысячи бит, а не 64, как у моей DDR3. Ещё дальше - класть память прямо у вычислительных блоков и собирать всё это в 3D.
Сделать всё одним куском. Cerebras выпиливает чип размером с целую кремниевую пластину: память раскидана по всей пластине, и данным почти не надо никуда уезжать с кристалла. Нет плат, нет разъёмов, нет моих 2,5 Вт на трансиверы PCIe.
Сделать провод дешевле. Шире, быстрее, меньше джоулей на бит. Тут уже фотоника: свет между чипами, а потом и внутри них.
Бесплатно ничего не бывает. Плотнее - значит, горячее и сложнее развести. HBM поднимает потолок, но не убирает его. Оптика экономит на проводах, но добавляет своих накладных расходов. Данные всё равно надо возить - вопрос только, как далеко и почём.
По сути это та же «стена памяти», в которую процессоры упираются уже лет тридцать. Просто теперь в неё упираются не четыре ядра CPU, а тысячи умножителей сразу. Идеал понятен: бесконечная память прямо у каждого вычислителя, без задержек и почти бесплатная по энергии. Физика не даст. Кэши, HBM, 3D, пластины целиком, фотоника - это всё способы подобраться к нему поближе.
Для меня главное в этой части - что всё это теперь не теория. Я пощупал стену памяти руками: от размещения модулей на кристалле до счётчиков платы и токенов в секунду. Есть цифры, есть узкие места и есть что проверять дальше. И если когда-нибудь дело дойдёт до своего КЕДРа, начинать его придётся не с вопроса «сколько поставить умножителей», а с вопроса «как подвезти к ним данные».
8. Что дальше
BitNet b1.58. Раз всё упирается в байты на токен, 2-битные веса - самый прямой путь: они в 4 раза легче int8. В 4 раза быстрее не станет - останутся голова, активации, KV-кэш, - но потолок поднимется заметно. RTL и тесты готовы, осталось собрать и прогнать на плате.
Хост-сторона openTPU. Как компьютер рулит картой, что на самом деле ходит по PCIe и куда уходят секунды до первого токена - хочу разобрать отдельно.
YOLO на той же плате - просто потому что интересно.
BCU1525. Лежит плата на Virtex UltraScale+ VU9P с 64 ГБ DDR4 - совсем другая память. Интересно, куда сдвинется потолок.
Где-то в далёком будущем - КЕДР, куда же без него.
Если есть идеи, что ещё прогнать на плате, - пишите в комментариях.
Спасибо Felipe Sens Bonetto за openTPU - редкий проект, в котором можно пройти путь от Python до физического кристалла. И спасибо комментаторам первой части: без ваших вопросов я бы не полез ни в floorplan, ни в счётчики платы.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.