Мой блокчейн‑индексатор врал мне, а я не замечал
Встречали ли вы в базе события из блоков, которых никогда не существовало? Код записи в порядке. Диск тоже в поряде. Но блокчейн просто передумал. Сервис самый обычный: Go, логи смарт‑контрактов по RPC, PostgreSQL, API наружу. Никто не ждет от него сюрпризов.
Первым отстрелились реорганизации. Оказывается, блок, который ты уже отдал клиентам как подтверждённый, цепочка может выкинуть и переписать историю задним числом. Потом дошло до RPC‑провайдера: ему все почему‑то доверяют по умолчанию, и напрасно.
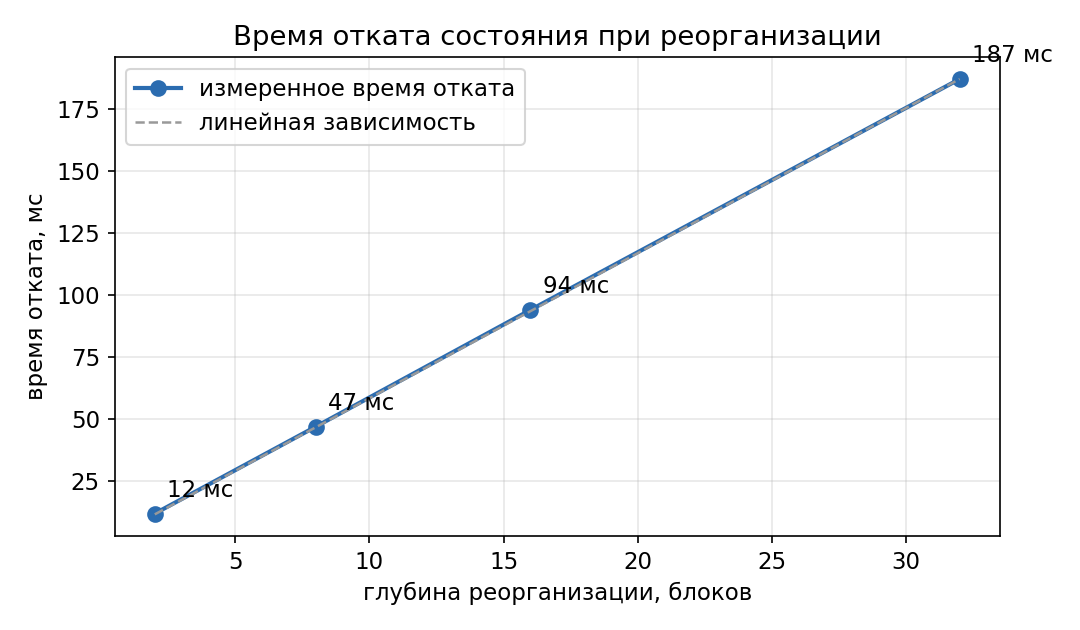
Откат на 32 блока теперь занимает 187 миллисекунд. Ответы провайдера я проверяю криптографически. Аналитика ускорилась в 13 раз. Ниже как я до этого дошел и что показал прогон по миллиону реальных блоков Ethereum.
Проблема первая: блокчейн может передумать
В Proof‑of‑Stake сетях последние блоки пересобираются постоянно. Валидатор предложил блок, сеть увидела, а через пару секунд консенсус взял другую ветку, и блока нет. Со всеми транзакциями и событиями. Это называется реорганизация. Для сети — обычное дело, так устроен консенсус. Плохо то, что об этом редко вспоминают, пока не наступят.
Мой индексатор тупо опрашивал ноду, увидел блок, записал события, пошёл дальше. И так раз в несколько секунд. Потом сеть откатывает три последних блока, а он не знает. В базе лежат события из блоков, которых больше нет, а сверху пишутся события из новой ветки. Отсюда дубли и «осиротевшие» записи, аналитика расходится с тем, что в сети на самом деле. Если поверх таких данных висят алерты или автоматика, они срабатывают на то, чего не было.
Классика жанра — ждать N подтверждений. Блок считается надёжным, когда поверх него достроили ещё N. Способ рабочий, только грубый, глубину берут с потолка. Но даже угаданная глубина не спасает от другого. Откуда вы знаете, что ваша нода вообще показывает актуальную цепочку? Отстающая реплика провайдера может часами отдавать устаревшую ветку, и все N подтверждений честно посчитаются по реальности, которой нет.
Проблема вторая — доверие к RPC‑провайдеру
Вторая неприятность тоньше. Индексатор получает от ноды заголовок блока и пачку логов и просто принимает их как есть. А ведь в заголовке Ethereum‑блока уже лежит всё для самостоятельной проверки — хеш предыдущего блока и корни деревьев Меркла‑Патриси, transactionsRoot и receiptsRoot. Если провайдер вернёт урезанный или подменённый набор событий, по ошибке или намеренно, клиент без верификации этого просто не заметит.
Для пет‑проекта сойдёт и так. Для системы, на чьих данных принимают решения, нет. Я поставил себе три требования. Хранилище всегда содержит ровно одну непрерывную цепочку. Ни одна запись не принадлежит отменённому блоку. Каждая запись подтверждена криптографически, а не доверием к источнику. Как это реализовано — расскажу дальше.
Стенд — миллион блоков и управляемые аварии
Взял миллион блоков Ethereum mainnet через публичный RPC и прогоняю их через самописный эмулятор RPC. Он отдает блоки с нужной задержкой и в нужную секунду подменяет хеш родительского. Мой сервис этого не замечает. Для него это настоящая реорганизация глубиной от 2 до 32 блоков. Синтетику мерить не стал, как‑то глупо. Глубину 32 выбрал с запасом, не жалко.
Зависший веб‑сокет гадкий. Соединение формально живое, но данных нет, и долго непонятно, то ли в сети тишина, то ли ты смотришь в мертвый сокет. Но решается просто таймаутом. Сценарии я гонял по очереди, по 30 прогонов каждый. Дальше разброс переставал ужиматься, а ночь подходила к концу.
В тестах я просто подключаю эмулятор вместо транспорта, код не трогаю. Так вышло, потому что индексатор на Go выстроен по Чистой архитектуре, а ядро с бизнес‑логикой не знает ни про RPC, ни про конкретную СУБД. И по базе мониторинг на prometheus + grafana
Откат за 187 миллисекунд
Каждый новый блок я сверяю с предыдущим. Хеш из моей базы должен совпасть с родительским в новом заголовке. Обычно все сходится, запись уходит в хранилище и курсор едет дальше. Если не сходится, то начинается работа конечного автомата из трех состояний — Syncing, Finalized и ReorgDetected.
Не совпал — автомат переключается в ReorgDetected и ползет назад по цепочке, сравнивая хеши с локальными, пока не найдет последний общий блок. Потом одна транзакция с изоляцией serializable сносит все, что записано выше этой точки, и синхронизация продолжается уже по новой ветке. Serializable я взял не из педантизма, реорганизация не должна наполовину пережить падение процесса. За процессом отдельно следят теги сети safe и finalized. Блок, окончательно подтвержденный beacon chain, помечается неизменяемым и из зоны отката выпадает. Счетчик «подожди N блоков» я так и выкинул.
Время прогонов выглядит так
Два блока откатились за 12 мс, восемь откатились за 47 мс, шестнадцать — за 94 мс, тридцать два — за 187 мс. Зависимость строго линейная, значит, квадратичных сюрпризов внутри нет, ни пересборки индексов, ни полного перечитывания таблиц. Прикиньте масштаб! Блок в Ethereum рождается раз в 12 секунд, а самая глубокая штатная реорганизация откатывается примерно за полтора процента этого интервала.
Идемпотентность
Проще всего было сделать запись повторяемой. Каждое событие в сети уникально идентифицируется тремя вещами: в каком блоке оно случилось (block_hash), в какой транзакции этого блока (tx_hash) и каким по счёту логом внутри транзакции (log_index). Последнее важно, потому что один контракт в одной транзакции может выстрелить одно и то же событие несколько раз, а транзакция в блоке одна, и без номера лога эти копии не отличить. Я объявил эту тройку уникальным индексом и пишу всё через UPSERT. Прислали тот же лог второй раз — ничего не изменилось. Так я закрыл целый класс сбоев. Повторная доставка после retry, переподключение WebSocket, дубли после реорганизации, всё это теперь безвредно.
Таблицу порезал на партиции по 100 000 блоков, это примерно две недели истории Ethereum. Польза двойная. Аналитика сканирует только актуальные партиции, а откат при реорганизации трогает последнюю.
-- Уникальный ключ события
CREATE UNIQUE INDEX idx_events_unique
ON events (block_hash, log_index, tx_hash);

-- Фильтрация по адресу контракта и диапазону блоков
CREATE INDEX idx_events_address_block
ON events (contract_address, block_number DESC);

-- Поиск по темам событий
CREATE INDEX idx_events_topic
ON events USING gin (topics);
Таблицу порезал на партиции по 100 000 блоков, это примерно две недели истории Ethereum. Польза двойная. Аналитика сканирует только актуальные партиции, а откат при реорганизации трогает последнюю.
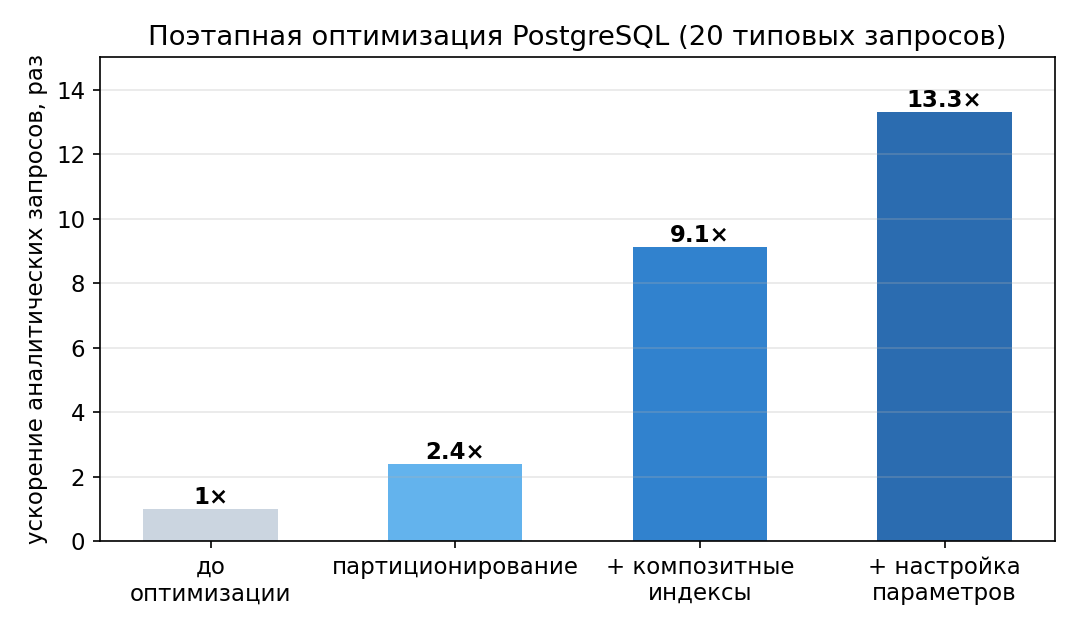
Эффект мерил на 20 типовых аналитических запросах. Партиционирование дало 2,4 раза, композитные индексы ещё 3,8, а последние 1,3 принесла настройка трёх параметров PostgreSQL. work_mem — это сколько памяти выделяется на одну операцию сортировки или хеша, пока не придётся сбрасывать промежуточный результат на диск. effective_cache_size — подсказка планировщику, сколько у машины памяти под кэш страниц, от неё зависит, будет ли планировщик вообще рассматривать индексные планы. random_page_cost — сколько стоит случайное чтение страницы относительно последовательного, на SSD его принято снижать, иначе планировщик трусливо выбирает полное сканирование. Итого 13,3 к исходной схеме. Признаю, ждал, что главным будет партиционирование, а вышло наоборот. Объём данных, которые типичный запрос с фильтром по времени реально читает, упал в 47 раз. Индексы съели 23% от объёма данных, для боевой системы это нормально.
Не доверяй, а проверяй
Связность заголовков я уже проверяю на каждом блоке, это та самая проверка parentHash из раздела про откат. Логи же верифицирую отдельно, своей контрольной суммой. После того как декодировал все события блока, я сворачиваю их хеши операцией XOR, это поразрядное «исключающее ИЛИ». Удобно оно тем, что результат не зависит от порядка операндов. Порядок мне нельзя гарантировать, разные эндпоинты порой отдают один и тот же набор логов в разной последовательности, и свёртка, чувствительная к порядку, ловила бы ложные тревоги.
// Контрольная сумма пакета логов одного блока
func checksum(logs []types.Log) common.Hash {
    var acc [32]byte
    for _, l := range logs {
        h := crypto.Keccak256Hash(
            l.TxHash.Bytes(),
            binary.BigEndian.AppendUint32(nil, uint32(l.Index)),
            l.Address.Bytes(),
        )
        for i := range acc {
            acc[i] ^= h[i]
        }
    }
    return acc
}
Полученную сумму сверяю с корнями receiptsRoot и transactionsRoot, которые лежат прямо в заголовке блока. Сошлась — значит, провайдер отдал именно те события, которые реально есть в блоке. Не сошлась — либо данные повреждены, либо подменены, блок перезапрашиваю у другого эндпоинта.
Контрольные суммы я кэширую в Redis, ключом служит block_hash, так что повторная проверка блока уже ничего не стоит. Платят за всё это несколько дополнительных RPC‑вызовов на блок да одна свёртка Keccak256, той самой хеш‑функцией, на которой держатся адреса Ethereum. На фоне сетевых задержек эти миллисекунды просто теряются.
Если падает сеть
Если вдруг у провайдера лег вебсокет, можно заметить по графику. Сервис и не умрет — пока один канал дышит, второй держит лавку. Каналов, кстати, два. Основной — подписка на заголовки через вебсокет, блоки прилетают почти мгновенно. Запасной — обычный поллинг по HTTP раз в 12 секунд, как раз под средний интервал между блоками. Сокет умер — включается поллинг, а между попытками растет экспоненциальная задержка. Секунда, потом две, потом четыре. Плюс случайный разброс до 25% в обе стороны. Без него клиенты, упавшие одновременно, вернулись бы к ноде ровно в такт и долбили бы ее все разом.
Со стенда. Я рвал соединение пачками и лил 5 xx. Сервис вставал сам в 98,7% случаев, в среднем за 8,4 секунды. Полтора процента упирались в лимит попыток — туда я уже лез по алерту, руками. По скорости конвейер держит 100 блоков в секунду, P95 не выше 134 мс, то есть девятнадцать блоков из двадцати приходят быстрее этой планки. Выше сотни буфер заполняется, и задержка растет уже не линейно — с 134 мс до секунд хватает одного шага нагрузки.
Итог
Если собрать все в одну фразу: индексатор, который не умеет ничего в реорганизации — это не генератор правдоподобной лжи. Конечный автомат с откатом к общему предку закрывает вопрос, и стоит это 187 мс на самую глубокую реорганизацию.
«Ждать N подтверждений» больше не буду. От глубокой реорганизации такая эвристика не спасает, от отстающей ноды — тем более. Теги финальности safe/finalized решают ту же задачу строго, потому что глубину определяет протокол.
И еще про доверие к RPC‑провайдеру. Хеш‑цепочка и контрольные суммы логов стоят почти ничего, зато «надеюсь, данные настоящие» превращается в «данные проверены». Проверять дешевле, чем надеяться.
Что дальше. Хочу прикрутить TLA+ — язык, в котором описываешь систему, а инструмент перебирает состояния и ищет контрпримеры, — и доказать, что автомат из раздела про откат без дырок. Плюс прогнать все под пиковой нагрузкой mainnet, буфер‑то пока не резиновый.
А у вас как? Как бы вы ловили реорганизации, как выбирали бы глубину подтверждения?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.