Хостинг стёр мой VPS вместе с базой: как я переезжал после взлома Beget
Во вторник, в шесть вечера, я опубликовал в канал анонс новой статьи и пошёл проверить сервер. SSH не отвечал. Сайт не отвечал. Ping терял все пакеты. Я проверил с восьми точек мира через check-host: Москва, Германия, Швеция, США. Везде таймаут.
Сам я в тот момент сидел в интернете нормально, Хабр и Telegram открывались. Значит, умер не мой канал, а сервер. Чуть позже пришли новости: в ночь на 2 ноября хостинг Beget взломали, и данные облачных VPS уничтожены. Мой сайт, два бота и мониторщики к тому моменту лежали уже полтора дня, а реклама в Директе всё это время исправно водила людей в пустоту.
Это разбор того, что у меня пропало, что спасло и на какие грабли я наступил, пока поднимал всё заново. Отдельная часть про сюрприз нового сервера: с него не открылись ни Telegram API, ни API модели, и старый сервер, как выяснилось, работал просто по везению.
Что случилось у хостинга
По сообщению самого Beget, злоумышленники получили доступ к управляющему контуру инфраструктуры и запустили обнуляющие скрипты. В облаке (VPS, S3, Kubernetes) данные утрачены, бинарные бэкапы VPS тоже. Сохранились файловые копии, но клиентам их пока не выдают: каждый из более чем тысячи серверов проверяют вручную (новость на Хабре, Коммерсант, Ведомости).
Ждать файловую копию я не стал. Сроков никто не обещал, а сайт с рекламой простаивать не должен.
Что было на сервере и что пропало
На одном VPS (2 ядра, 4 ГБ) жили:
сайт студии и форма заявок;
бот-консультант в Telegram и в MAX (Python, aiogram, FastAPI, PostgreSQL, Redis, всё в Docker Compose, перед ними Caddy);
мониторщик заказов с бирж и мониторщик новостей для каналов;
приложение для цеха другого проекта и VPN-туннель третьего.
Что | Итог |
|---|---|
Код бота, сайта, конфиги выкладки | цел: лежал у меня локально |
Ключи и токены | целы, но засвечены: копия была в |
База: заявки, пользователи, история мониторщиков | потеряна: копий вне сервера не было |
DNS домена | у того же Beget, панель недоступна |
С базой мне повезло в одном: живых заявок там почти не было, большинство тестовые. История мониторщика новостей пропала целиком, и вот это жалко, я собирался по ней писать.
Первым делом — ключи
Beget сам рекомендовал считать скомпрометированным всё, что лежало на серверах. Даже если данные никто не скачивал, проверить это я не могу. Поэтому до любой выкладки:
токен Telegram-бота —
/revokeу @BotFather;токен бота MAX — перевыпуск на платформе для партнёров;
ключ API модели — новый в консоли, старый удалить;
секреты вебхуков и пароль базы — новые, их всё равно генерирует скрипт.
Новые ключи я проверил до выкладки: getMe у Telegram и MAX, список моделей у API. Мелочь, но если вписать неработающий токен, потом долго ищешь, почему молчит бот.
Новый сервер за вечер, потому что выкладка была скриптом
Это то, что меня спасло. Ещё в октябре я сложил выкладку в один скрипт с шагами: подготовка сервера, генерация .env, сайт, бот, проверка. Тогда это казалось лишней формальностью. В аварию весь переезд свёлся к нескольким командам:
bash deploy.sh <ip> <домен> setup   # Docker, ufw (22/80/443), вход только по ключу
bash deploy.sh <ip> <домен> env     # .env: токены с моей машины по stdin, секреты генерируются на сервере
bash deploy.sh <ip> <домен> site
bash deploy.sh <ip> <домен> bot     # сборка, миграции на пустой базе, запуск
bash deploy.sh <ip> <домен> check   # страницы, healthz, закрытые служебные пути
Новый VPS я взял у другого провайдера, в Москве, на 8 ГБ: на нём снова будут жить все три проекта, а на старых 4 ГБ было впритык. SSH-ключ тоже новый: открытая часть старого лежала в authorized_keys на взломанной машине.
Миграции прошли на пустой базе с первой до восьмой, контейнеры поднялись. Осталось направить домен.
DNS, когда панель регистратора лежит
Домен зарегистрирован в том же Beget, его DNS тоже там. Основная панель не открывалась. Выручила отдельная страница управления DNS, которую Beget поднял как раз для таких случаев (новость): вводишь домен, проходишь капчу, получаешь код на почту администратора домена и правишь A-записи.
У записи стоял TTL 600 секунд, и публичные резолверы Google и Яндекса быстро начали отдавать новый адрес. А сайт не открылся.
Причина нашлась в логе Caddy. Он попросил сертификат у Let’s Encrypt сразу при старте, когда домен ещё смотрел на мёртвый адрес. Проверка, естественно, не прошла, и Caddy ушёл в повтор с растущей паузой. После перезапуска контейнера сертификаты выпустились за минуту. Вывод на будущее: сначала DNS, потом запуск веб-сервера, или хотя бы перезапуск после смены записей.
Тестовая заявка с сайта дошла карточкой в рабочий чат MAX, я закрыл её кнопкой. Сайт, форма и MAX-бот снова работали. Telegram и модель — нет.
Сюрприз: с нового сервера не видно Telegram и модели
Вот что показал curl с нового сервера:
api.anthropic.com   403  {"type":"forbidden","message":"Request not allowed"}
api.telegram.org    000  (таймаут 20 с)
platform-api2.max.ru  отвечает
habr.com              отвечает
API модели отказывает этой сети по географии, Telegram Bot API не отвечает вовсе. На старом сервере оба работали, и я принимал это как должное. Видимо, у старого адреса была другая репутация. Строить продакшен на везении конкретного IP было ошибкой, просто раньше она не проявлялась.
Сначала я попробовал готовые конфиги коммерческого VPN, которым пользуюсь на рабочем компьютере. На сервере обычный WireGuard не завёлся: к прямому узлу рукопожатие не проходило вовсе, через их российский узел проходило, но полезный трафик не шёл. Похоже, без их приложения и его варианта протокола эти конфиги с российского сервера бесполезны.
В итоге я сделал проще и надёжнее: арендовал самый маленький VPS в Нидерландах (1 ядро, 1 ГБ, 613 ₽ в месяц) и вынес на него только исходящие запросы бота к Telegram и к модели. Сайт, MAX, база и всё остальное работают напрямую, как раньше.
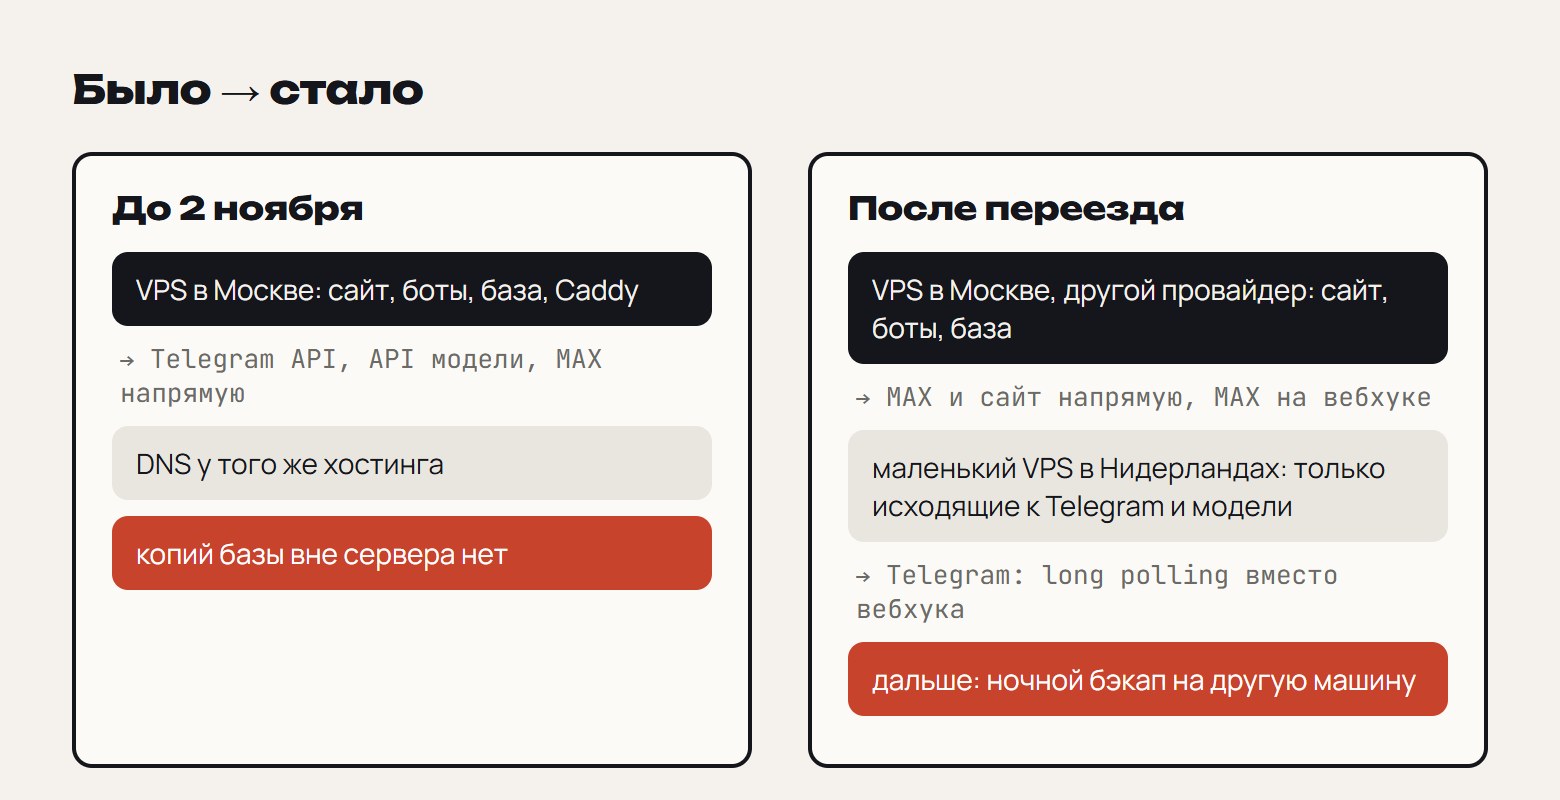
Со стороны бота это одна настройка и две строки. Прокси задаётся переменной окружения, и если её нет, бот ходит напрямую:
# config.py
outbound_proxy: str | None = None   # http://host:port — для Telegram и модели; MAX ходит напрямую
# клиент модели: прокси только для него, остальные httpx-клиенты не трогаем
from anthropic import AsyncAnthropic, DefaultAsyncHttpxClient

client = AsyncAnthropic(
    api_key=settings.anthropic_api_key, timeout=60, max_retries=1,
    http_client=DefaultAsyncHttpxClient(proxy=settings.outbound_proxy) if settings.outbound_proxy else None,
)
# aiogram: своя сессия с прокси (нужен пакет aiohttp-socks)
from aiogram.client.session.aiohttp import AiohttpSession

bot = Bot(
    token=settings.bot_token,
    default=DefaultBotProperties(parse_mode=ParseMode.HTML),
    session=AiohttpSession(proxy=settings.outbound_proxy) if settings.outbound_proxy else None,
)
Можно было выставить HTTPS_PROXY на весь контейнер, SDK модели его подхватывает сам. Я не стал: тогда через Нидерланды пошли бы и запросы мониторщиков к российским сайтам, а им зарубежный адрес ни к чему.
Telegram без вебхука
После этого бот достучался до Telegram, setWebhook прошёл. А сообщения не приходили. getWebhookInfo всё объяснил:
pending_update_count: 7
last_error_message:   Connection timed out
Исходящие запросы теперь шли, но входящие от серверов Telegram до российского адреса не доходили. Семь сообщений висели в очереди у Telegram.
Решение — забирать обновления самому, long polling через тот же прокси. MAX при этом остаётся на вебхуке, у него с входящими всё в порядке. Раньше режим был общий на оба мессенджера, поэтому я разделил его:
# config.py
bot_mode: Literal["webhook", "polling"] = "webhook"
telegram_mode: Literal["webhook", "polling"] | None = None   # только Telegram; MAX остаётся на вебхуке

@property
def telegram_transport(self) -> str:
    return self.telegram_mode or self.bot_mode
# main.py, запуск Telegram
if settings.telegram_transport == "polling":
    # pending updates сохраняем: те семь сообщений должны дойти
    await bot.delete_webhook(drop_pending_updates=False, request_timeout=15)
    polling_task = asyncio.create_task(
        dp.start_polling(bot, allowed_updates=allowed, handle_signals=False),
        name="telegram-polling",
    )
Одна деталь при переключении: delete_webhook(drop_pending_updates=True), который часто пишут в примерах для локального запуска, выбросил бы накопившиеся сообщения. Я оставил их, и бот разобрал очередь сразу после старта. Ответ на одно сообщение так и не ушёл: этот пользователь к тому времени бота заблокировал.
Ещё одно решение из октября здесь пригодилось. Запуск Telegram у меня обёрнут так, что его падение не роняет форму на сайте и MAX: бот пишет в лог «Telegram недоступен» и пробует снова раз в несколько минут. Поэтому, пока я разбирался с Telegram, сайт и MAX спокойно работали.
Сколько стоили три с половиной дня
Самая обидная часть — реклама. Кампания в Директе прошла модерацию как раз 2 ноября и начала показываться в день аварии. Сайт её не волновал.
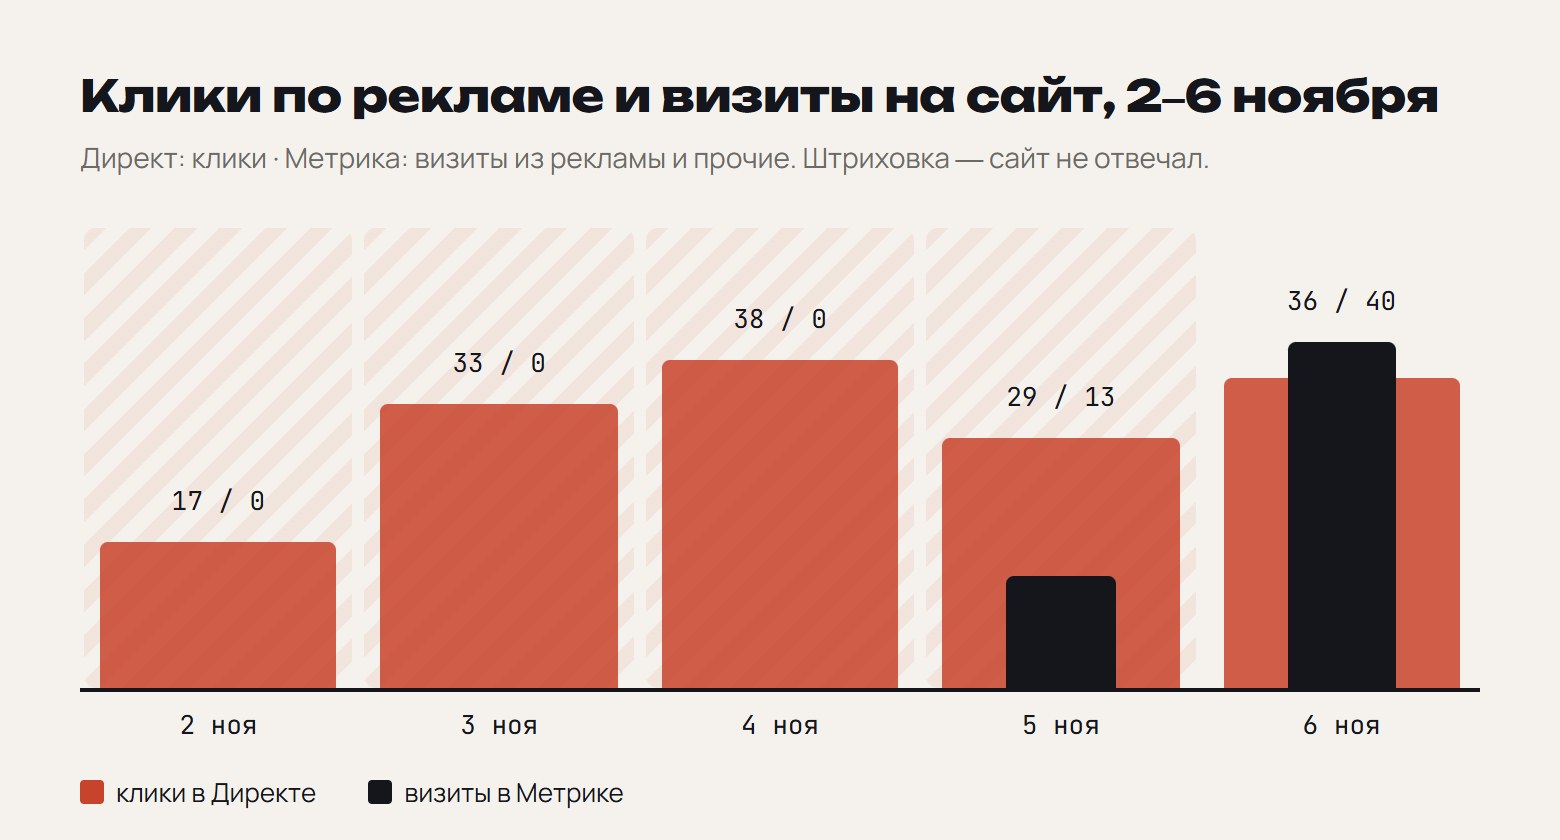
День | Расход | Клики | Визиты в Метрике |
|---|---|---|---|
2 ноября | 315 ₽ | 17 | 0 |
3 ноября | 604 ₽ | 33 | 0 |
4 ноября | 647 ₽ | 38 | 0 |
5 ноября | 423 ₽ | 29 | 13 (сайт поднялся вечером) |
6 ноября | 717 ₽ | 36 | 40 |
Около 1 900 ₽ из 2 700 ушли на клики, которые упирались в неработающий сайт. О паузе я подумал ещё во вторник, но отложил: рассчитывал переехать быстро. Переезд занял двое суток.
Зато 6 ноября, в первый полный день работы, пришла первая живая заявка с рекламы. Так что сама связка работает, просто ей нужен живой сервер.
Что бы я сделал иначе
Бэкап базы вне сервера, каждую ночь. У меня его не было, и это главная потеря. Теперь это первая задача:
pg_dumpпо расписанию на другую машину.Код в git с удалённым репозиторием, а не только в синхронизируемой папке. Мне повезло, что локальная копия была полной.
DNS у другого провайдера, не у того, где сервер. Если хостинг лежит целиком, домен должен оставаться в моих руках. Мне помогла аварийная страница Beget, но рассчитывать на такое нельзя.
Внешний мониторинг с уведомлением. Я узнал о падении через полтора дня, и то случайно. Проверка
/healthzс другого сервера раз в пять минут сберегла бы и время, и деньги на рекламе.Пауза рекламы сразу, как только сайт не отвечает. Вручную, но в тот же час.
Проверять при выборе хостинга, открываются ли с него нужные API, и держать прокси для внешних запросов в одной настройке. При переезде тогда меняется одна строка.
Сейчас сайт, форма, оба бота и мониторщики снова работают. Ночной бэкап базы — следующее, что я делаю.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.