"El mayor robo laboral de la historia": así describían en Microsoft el uso de artículos de prensa para entrenar IA
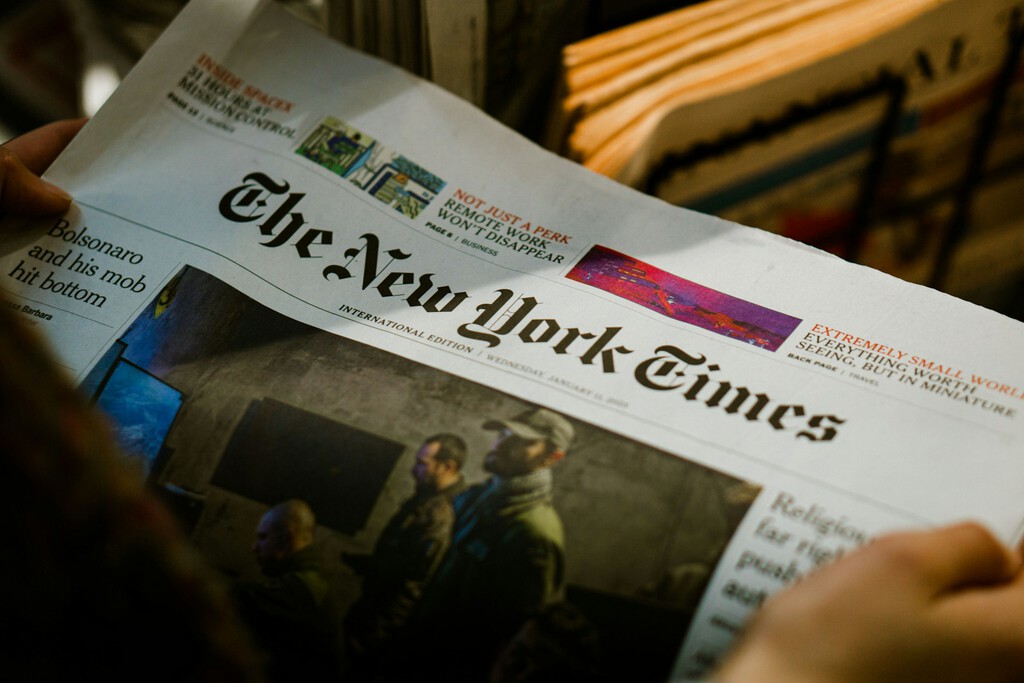
A finales de 2023, el New York Times demandó a OpenAI y Microsoft acusándolas de usar sus artículos para entrenar modelos de IA sin haber obtenido autorización y tampoco haberles compensado de ninguna manera. Se acabaron uniendo once medios más a la demanda. Ahora, el New York Times ha publicado varios documentos internos que han sido desclasificados en el contexto de la demanda y dejan clara una cosa: había voces en ambas compañías que eran muy conscientes de lo que estaban haciendo.
Robo. Y no uno cualquiera, sino "el mayor robo laboral de la historia". La frase aparece en un documento interno de Microsoft escrito en 2023 por Brent Hecht, director de ciencia aplicada de la compañía, y se refiere al hecho de que OpenAI, su entonces socio más fiel, estuviera entrenando sus modelos con artículos de prensa.
Además, añadía que "Millones de personas en todo el mundo pronto considerarán que el hecho de que grandes modelos 'absorban' todo su trabajo es un robo asombroso de proporciones sin precedentes" y mostraba preocupación sobre lo que podía pasarle a la industria periodística, asegurando que los modelos de IA "son un producto que destruye su cadena de suministro". Vamos, que eran muy conscientes de lo que estaban haciendo.
OpenAI también lo sabía. Probablemente mejor que nadie, y hay muchas pruebas de ello. En 2020, mucho antes del lanzamiento de ChatGPT, Jack Clark (entonces director de políticas de OpenAI y actual cofundador de Anthropic), envió un informe a Sam Altman y Greg Brockman en el que advertía que el trabajo que estaban haciendo les llevaría a crear sistemas que "sustituyan el trabajo de las personas que definen la cultura de la sociedad".
Los muros de pago. Los abogados de los medios demandantes sostienen que OpenAI desplegó herramientas específicamente para sortear los muros de pago de los editores. Entre los documentos desclasificados figura un mensaje en el que Greg Brockman, presidente de OpenAI, celebra que un empleado hubiera creado “un truco para sortear el muro de pago de The New York Times”.
Satya Nadella, CEO de Microsoft, declaró que "cualquier cosa que esté restringida por un muro de pago debería estar sujeta a licencia para cualquiera que quiera usarla". Y aseguró que si "hubiera tenido conocimiento de que OpenAI había extraído y entrenado información que estaba detrás de un muro de pago" les habría exigido que reentrenaran sus modelos, que era un derecho que tenía Microsoft.
Sustitución. En junio de 2023, Nick Turley, responsable de desarrollo de ChatGPT, escribió en un documento que la IA era una "amenaza existencial" para el periodismo. Un año después, aseguraba que "Los productos de IA son en gran medida sustitutivos, punto". Es decir, que OpenAI anticipaba que ChatGPT no sería un intermediario o una nueva fuente de descubrimiento como lo puede ser Google Discover, sino que reemplazaría el consumo de noticias.
La gente no hace clic. Es lo que advertía un ingeniero de OpenAI en 2023. que por más que ChatGPT citara las fuentes con enlaces, los usuarios no iban a hacer clic, y no iba nada desencaminado. Conforme se fue ampliando la adopción de chatbots, los usuarios empezaron a usar cada vez más la IA como un buscador y la llegada de los resúmenes de IA a los resultados de Google fue una escabechina en toda regla, con caídas de más del 50% en el tráfico en algunos casos.
Imagen | Grigorii Shcheglov en Unsplash
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.