Основы глубокого обучения. Часть 2
Всем привет! Эта статья является второй в серии статей про основы глубокого обучения. В прошлой части я рассказал много интересного и полезного новичкам, так что рекомендую перечитать тот пост. В этой части мы разберём подробнее свёрточные нейронные сети.
Разберём свёрточные нейронные сети (CNN), которые являются результатом адаптации структуры нейронной сети к определённым характеристикам данных.
Что такое свёрточная нейронная сеть?
Свёрточные нейронные сети были созданы для распознавания образов. Основная задача этой архитектуры состояла создании сети, в которой начальный слой извлекает локальные признаки,а последующие слои объединяют их в признаки более высокого уровня.
При использовании этого подхода фундаментальная задача распознавания образов сводится к функциям обнаружения признаков, то есть способным определять наличие или отсутствие на изображении локальных визуальных элементов. При этом она должна понимать, что элемент есть вне зависимости от его расположения.
Для достижения этой пространственной независимости при обнаружении признаков нейроны в сетях CNN используют общие веса.
В контексте распознавания образов функцию, которую реализует нейрон, можно считать механизмом обнаружения визуальных признаков.
Например, нейроны в первом скрытом слое сети получают на вход набор пиксельных значений, в случае присутствия в них определенной закономерности (локального визуального элемента) сильно активируются.
То, что функция, реализованная нейроном, определяется его весами, означает: два нейрона с одинаковым сочетанием весов реализуют одну и ту же функцию (механизм обнаружения признаков).
Если у двух нейронов разные входные данные (рецептивные поля), то вместе они себя ведут подобно механизму обнаружения признаков их общего набора данных, при наличии хоть в одном наборе признака,то он активируется.
Основные операции для CNN

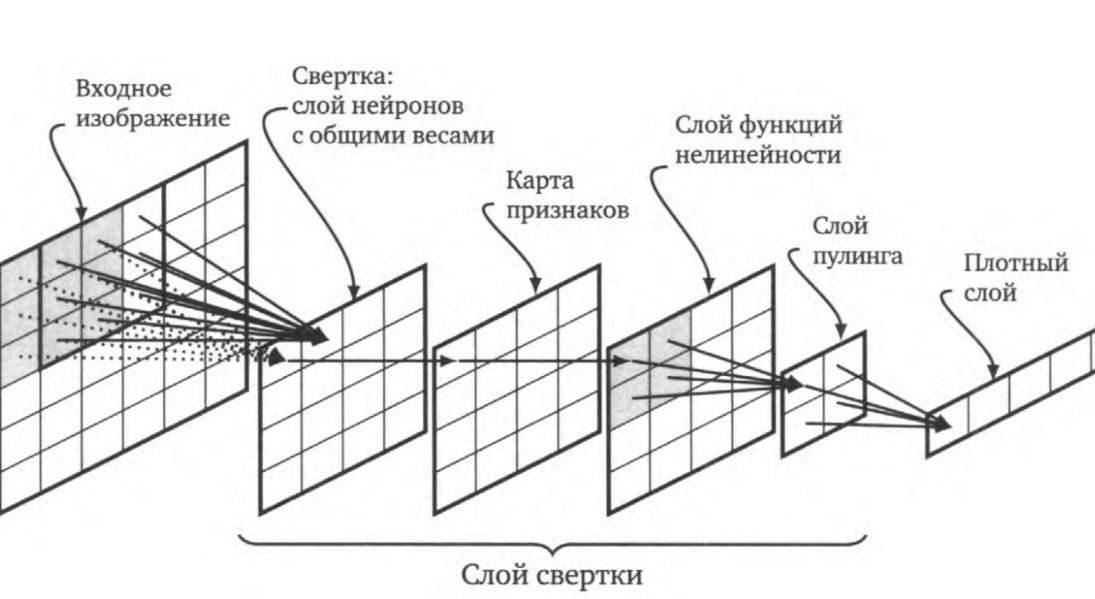
На рисунке выше проиллюстрированы разные этапы обработки, которые часто можно встретить CNN.
Матрица размером 6x6 в левой части представляет изображение, которое подаётся на вход сети. Справа от ввода находится матрица размером 4x4, представляющая слой нейронов, которые вместе прочёсывают изображение в поисках конкретного локального признака. Каждый из них соединен со своим рецептивным полем изображения размером 3х3, все они применяют к своему вводу одну и ту же матрицу весов 3х3.
Здесь рецептивные поля пересекаются, потому что имеют сдвиг равный единице, сдвиг является тут гиперпараметром (его выбирает сам человек).
По сути реализуется операция свёртки, мы последовательно применяем одну и ту же матрицу весов (матрицу свёртки или ядро) к различным частям входных данных. Результатом скалярного умножения матриц является число, которое мы записываем в одну из ячеек карты признаков.
Следует обратить внимание, что операция свёртки не включает в себя нелинейную функции активации, её применим позже.
После заполнения карты признаков применяется нелинейная функция активации к её элементам.
Операция пуллинга (объединения)
После того как свёрточный слой нашёл признаки (например, края, углы, текстуры), приступаем к пуллингу.
Что делает пуллинг?
Уменьшает размерность карты признаков.
Делает сеть устойчивее к небольшим смещениям и искажениям изображения.
Выделяет самые важные признаки из каждой области.
По сути мы делим нашу карту признаков на квадраты меньшего размера (это называется окном пуллинга). Для каждого квадрата берём максимальное значение (Max Pooling) или среднее значение (Average Pooling) и записываем его в новую, уменьшенную карту.
Обычно свёртку, применение нелинейной функции активации и пуллинг называют слоем свёртки и этих слоёв может быть большое количество, но в итоге мы получаем плотный или полносвязный слой.
Все нейроны плотного слоя принимают на вход выходы всех нейронов предыдущего слоя и именно плотный слой генерирует окончательный ответ.
Реализуем свёрточную нейронную сеть на практике
Начинается всё с получения изображений цифр и целевых значений для них из датасета mnist. Про это я объяснял ранее, поэтому акцентировать внимание особо не буду.
Матрица labels хранит у нас в каждой строке (номер строки - номер изображения) значение 1, в том столбце, номер которого есть целевое значения для этого изображения. Аналогично с test_labels.
Далее реализуем нужные нам функции и их производные. Метод np.sum складывает у нас по первой оси (считаем с 0) и сохраняет размерность нашей исходной матрицы (keepdims). Была таблица со строками, он просуммировал по столбцам и на выходе выдал матрицу (n,1), где в каждой строке сумма всех элементов этой строки до суммы.
Далее задаём для нашего удобства нужные нам константы. num_kernels — это количество фильтров (разных весов, которыми мы будем проходить изображение повторно, всего 16 раз).
import numpy as np
from keras.datasets import mnist
np.random.seed(1)

(x_train, y_train),(x_test,y_test) = mnist.load_data()
images, labels = (x_train[0:1000].reshape(1000,28*28)/255, y_train[0:1000])
one_hot_labels = np.zeros((len(labels),10))
for i,j in enumerate(labels):
	one_hot_labels[i][j] = 1

labels = one_hot_labels
test_images = x_test.reshape(len(x_test),28*28)/255
test_labels = np.zeros((len(y_test),10))
for i,j in enumerate(y_test):
	test_labels[i][j] = 1

def tanh(x): return np.tanh(x)

def tanh2deriv(output): return 1 - output**2

def softmax(x):
	temp = np.exp(x)
	return temp/np.sum(temp, axis=1, keepdims=True)

alpha, iteration = 0.2, 300
batch_size = 128
pixels_per_image, num_labels = (784,10)

input_rows, input_cols = (28,28)
kernel_rows, kernel_cols = (3, 3)
num_kernels = 16 #количество не нейронов в слое, а количестве различных слоёв свёртки (фильтров)

hidden_size = ((input_rows - kernel_rows +1)*(input_cols - kernel_cols +1)) * num_kernels # кол-во нейронов в слое умножаем на кол-во слоёв свёртки
kernel_weight = 0.02*np.random.random((kernel_rows * kernel_cols, num_kernels)) - 0.01
weight_2 = 0.2*np.random.random((hidden_size,num_labels)) - 0.1
Далее считаем hidden_size (количество ядер, считывающих изображение с учётом всех фильтров). Именно такое количество значений поступит на вход каждому нейрону в полносвязном слое, а их 10.
Заполняем случайными числами от -0,01 до 0,01 веса ядер, в итоге kernel_weight содержит 9 строк (вес для конкретного пикселя из 9) и 16 столбцов (фильтры). Напомню, что при свёртке мы применяем одну и ту же матрицу весов (или вектор) к нашей части изображения (рецептивному полю), то есть не надо использовать разные столбцы (фильтры) для разных частей (рецептивных полей) одного изображения. Нужно сначала пройтись одним фильтром по всему изображению, потом другим.
Под конец мы заполняем весовую матрицу для плотного или полносвязного слоя (26*26*16, 10). Каждый нейрон этого слоя принимает выходы ядер всех фильтров.
Функция для разрезания изображения на рецептивные поля
Так как ядро должно считывать не всё изображение сразу, а только его часть, то реализуем функцию, которая разрежет все поступающие изображения.
def get_image_section(layer, row_from, row_to, col_from, col_to):
	section = layer[:,row_from:row_to, col_from:col_to]
	return section.reshape(-1,1,row_to-row_from, col_to-col_from)
Тут использую срезы, в начале получается матрица (трёхмерный тензор), в которой по строкам сохранились все изображения, по первой и второй оси мы уменьшили длину изображения. Перед возвратом значения мы изменим размерность. Аргумент -1 говорит, чтобы питон сам посчитал нужное значение (там будет 128, размер батча изображений), далее ставим новую ось, где будет только одна ячейка (о ней расскажу ниже по коду), а далее наши 3 строки и 3 столбца (9 пикселей рецептивного поля).
Прямое распространение
Начинается всё с главного цикла итераций, проходимся по всему набору изображений за каждую итерацию. Паралельно считаем количество правильных решений нашей модели.
Внутри нас встречает второй цикл, мы одновременно будем прогонять только пакет изображений из 128 штук.
Далее берём 128 изображений и все их приводим к размерности 28 на 28. Получаем тензор 128 на 28 на 28. При помощи нашей функции, которую описал выше, нарезаем изображения на рецептивные поля 3 на 3 и вставляем их в список.
Но тут важно заметить, что в конце мы получим список, в котором будет 26*26 тензоров (столько рецептивных полей в изображении), у которых по нулевой оси будет 128 ячеек для выбора изображения, для которого хотим посмотреть рецептивное поле, а по первой стоит 1 (канал, которая нам потребуется для конкатенации ниже), и по второй и третьей оси будут 9 пикселей нашего рецептивного поля.
Выходит нам нужно их склеить так, чтобы рецептивные поля шли по порядку, сначала для первого изображения потом для второго и тд. Это делает функция np.concatenate(sects, axis=1). Она каждый наш тензор в списке склеит по первой оси и мы получим теперь не список, а один тензор, где по нулевой оси будет 128 изображений, по первой 676 (26*26) рецептивных полей этого изображения, по третьей и четвертой 9 пикселей.
Для удобства в конце мы изменим размерность на 128*676 на 9. Теперь у нас строки это номера рецептивных полей, первые 676 относятся к первому изображению и тд, а столбцы пиксели.
Теперь подадим наш входной слой нейронной сети и посчитаем результат первого слоя, для этого перемножим нашу матрицу с рецептивными полями (128*676 на 9) на матрицу весов ядер (9 на 16) и применим функцию активации tanh. Но также изменим размерность для удобства перед полносвязным слоем, получим матрицу, где 128 строк (картинки), а столбы взвешенные суммы. Не забываем защищаться от переобучения и применяем дропаут.
for j in range(iteration):
	corrent_cnt = 0
	for i in range(int(len(images)/batch_size)):
		batch_start, batch_end = (i*batch_size, (i+1)*batch_size)
		layer_0 = images[batch_start: batch_end]
		layer_0 = layer_0.reshape(layer_0.shape[0],28,28)
		sects = list()
		for row_start in range(layer_0.shape[1] - kernel_rows +1):
			for col_start in range(layer_0.shape[2] - kernel_cols +1):
				sect = get_image_section(layer_0,row_start,row_start + kernel_rows, col_start, col_start+kernel_cols)
				sects.append(sect)
		expanded_input = np.concatenate(sects,axis=1)
		es = expanded_input.shape
		flattened_input = expanded_input.reshape(es[0]*es[1],-1) #получили матрицу 676*128 на 9 где строки номера отрезков картинок а столбцы пиксели и первые 676 относятся к первому изображению и тд
		kernel_output = flattened_input.dot(kernel_weight) #получили 676*batch_size на 16 где по строкам взвешанная сумма для конкретного поля а столбцы фильтр
		layer_1 = tanh(kernel_output.reshape(es[0],-1)) #сделали матрицу где строки 128 картинки а столбцы значения взвешанных сумм
		droupout = np.random.randint(2, size=layer_1.shape)
		layer_1 *= 2*droupout
		layer_2 = softmax(layer_1.dot(weight_2))

		for k in range(batch_size):
			labelset = labels[batch_start+k:batch_start+k+1]
			_inc = int(np.argmax(layer_2[k:k+1]) == np.argmax(labelset))
			corrent_cnt += _inc
На выходе первого слоя получили матрицу (128 на 676*16).
Далее считаем значение на выходе после второго слоя (полносвязного в данном случае). Перемножаем матрицу layer1 на веса полносвязного слоя. Получим матрицу 128 на 10, где строки — это изображение, а столбцы — результат нейрона полносвязного слоя (если первый столбец, то насколько цифра похожа на 1). Применяем softmax и считаем сколько раз модель правильно определила.
Обратное распространение
Начнём с подсчёта дельты для выходного слоя. Так как мы использовали в качестве функции потерь перекрёстную энтропию, то дельта это a - t (результат модели минус истина), но как и в прошлый раз, так как мы обрабатываем пакетами поделим на количество образцов в пакете, чтобы усреднить дельты в дальнейшем.
Получим по 128 дельт (от каждого образца из пакета по одной) на каждый нейрон из 10. Далее считаем дельту для первого слоя, это есть взвешенная сумма дельт слоя после на веса (матрицу весов транспонируем, чтобы как раз и умножать дельты разных нейронов на соответствующие нужному нейрону первого слоя веса), умноженная на производную da/dz каждого нейрона первого слоя (у нас это слой свёртки).
Не забываем применить дропаут и с помощью градиентного спуска обновляем веса. Для выходного слоя это просто транспонирования матрица значений после первого слоя умноженная на дельту выходного слоя.
Тут мы транспонируем выход первого слоя layer_1, так как в слой 2 нам приходило 128 векторов по 26*26*16 взвешенных сумм и тем самым мы умножим вектор из 128 выходов нейрона первого слоя на вектор из 128 дельт. В итоге получим матрицу (26*26*16, 10), иаким образом мы усреднили нашу дельту, поэтому в начале и делили на размер пакета.
А теперь самое сложное, просто так посчитать на сколько изменить вес для первого слоя не выйдет, мы уже перемешали дельты относительно входных пикселей, надо их вернуть в нужное состояние.
layer_2_delta = (layer_2 - labels[batch_start:batch_end])/batch_size
layer_1_delta = layer_2_delta.dot(weight_2.T)*tanh2deriv(layer_1)
layer_1_delta *= droupout

weight_2 -= alpha*np.dot(layer_1.T,layer_2_delta)
#l1d_reshape = layer1_delta.reshape(kernel_output.shape)
# es[0] - батч (128), es[1] - количество патчей (676)
l1d_reshape = layer_1_delta.reshape(es[0], es[1], num_kernels).reshape(-1,num_kernels)
k_update = flattened_input.T.dot(l1d_reshape)
kernel_weight += alpha*k_update
Тестируем модель после каждого прохода по обучающей выборке (итерации)
Теперь протестируем нашу модель. Не забываем отключить дропаут при тестировании.
test_correct_cnt = 0
for i in range(len(test_images)):
	layer_0 = test_images[i:i+1]
	layer_0 = layer_0.reshape(layer_0.shape[0],28,28)
	sects = list()
	for row_start in range(layer_0.shape[1] - kernel_rows +1):
		for col_start in range(layer_0.shape[2] - kernel_cols +1):
			sect = get_image_section(layer_0,row_start,row_start + kernel_rows, col_start, col_start+kernel_cols)
			sects.append(sect)
	expanded_input = np.concatenate(sects, axis=1)
	es = expanded_input.shape
	flattened_input = expanded_input.reshape(es[0]*es[1],-1)
	kernel_output = flattened_input.dot(kernel_weight)
	layer_1 = tanh(kernel_output.reshape(es[0],-1))
	layer_2 = softmax(layer_1.dot(weight_2))
	test_correct_cnt += int(np.argmax(layer_2) == np.argmax(test_labels[i:i+1]))
print(f"I{j}: Test-acc: {test_correct_cnt/float(len(test_images))} Train-acc: {corrent_cnt/float(len(images))}")
В итоге наша модель достигла точности на тестовой выборке более 86% уже на 14 итерации.
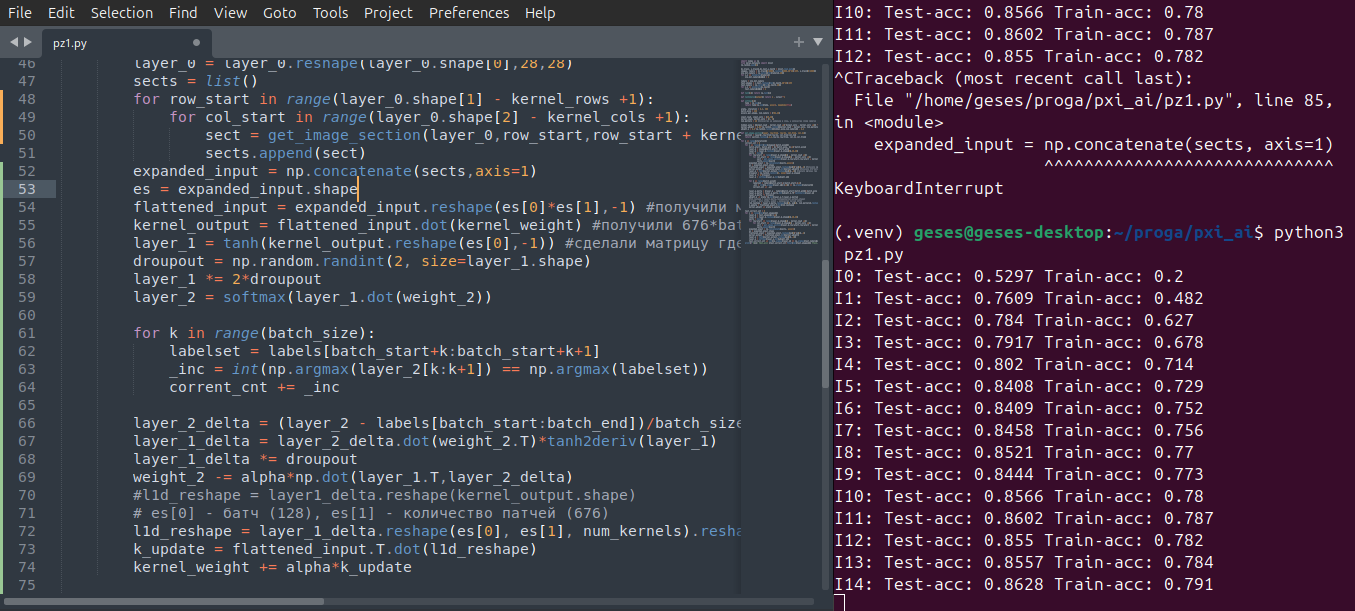
Хочу сказать, что это лишь пример и многое в нём можно улучшить и ускорить. Например, тестирование необязательно проводить по одному изображению, как и подсчёт верно угаданных изображений. Поэтому пробуйте делать своё, опираясь на этот базовый пример.
Пишите в комментарии об найденных ошибках и задавайте вопросы. Нужно ли делать 3 часть?
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.