Как встроить AI-агентов в разработку: требования, архитектура и контроль качества
Сейчас ходит много споров о том, будут ли нужны разработчики в эпоху вайб кодинга или нет. Даже среди разработчиков популяризируется мнение, что они стали теперь “мясным прокси” между задачами и ИИ.
Внедрение ИИ в разработку часто начинается с простого требования: используйте агентов и выпускайте фичи быстрее. Но довольно быстро возникают вопросы: кто проверяет, как агент понял задачу, какие решения можно ему доверить и как убедиться что новая фича не сломала существующие? В своих проектах я столкнулся и с быстрым получением работающего результата, и с регрессиями и с многочасовыми циклами работы агента. На этих примерах попробую разобрать, какие требования, ограничения и проверки нужны для работы с агентами и как этот опыт можно использовать в команде и немного затрону как смещается роль разработчиков в эпоху ИИ агентов.
Мой опыт Вайб-кодинга
Прежде чем приступить к основной части статьи, должен отметить что я сам увлекаюсь вайб-кодингом в пет проектах. Собственно в рамках эксперимента сделал небольшие игры:
https://pocket-circuit.atreides07.chatgpt.site/
https://lunarx.atreides07.chatgpt.site/
https://xenodrift.atreides07.chatgpt.site/
Сделал скилл для портирования старых игр на Samsung TV:
https://github.com/Atreides07/port-samsung-tv-games
В этих пет-проектах я ставил задачи агенту и оценивал получившийся игровой опыт. Это была ограниченная проверка: отдельного аудита кода, архитектуры и тестов я не проводил. Эти эксперименты показывают возможность быстро получить работающий продукт, но это не значит что такие проекты готовы к длительному сопровождению. В качестве примера можно взять Xenodrift который переделывал несколько раз и при дальнейших изменениях переставали соблюдаться ранее принятые решения и возникали регрессии, а часть фич игры просто исчезала. Избежать этих проблем можно было через фиксацию требований и проверку их соблюдения:
Как требования влияют на решение агента:
После некоторого времени разработки проектов через такой вайб кодинг может сложиться впечатление что на код, и на его качество можно забить.
Вопреки расхожему мнению, вайб кодинг не означает что код и архитектура будет низкого качества, как пример сделал демо банковского приложения:
https://github.com/Atreides07/DemoBank - Решение было сгенерировано за пару дней с нуля и представляет собой пример банковского приложения на Flutter (без серверной части, только клиентское приложение но присутствует демоснтрационный http клиент). Код генерировали агенты, я же ставил требования к производительности, возможности повторному использованию фич и требованиям к дизайне системе, а так же в организации проверки результата.
Я задавал требования к производительности, повторному использованию фич и дизайн-системе, а также организовывал проверку результата и специально не задавал какая должна быть архитектура, структура и т.д. и в итоге получилась следующее:
Модульная слоистая архитектура по фичам — feature-first, с принципами Clean Architecture и ports-and-adapters.
Фичи: счета, история, аналитика, штрафы и другие услуги выделены в пакеты.
Слои: UI отображает данные, Cubit управляет сценарием, репозитории работают с API и кешем.
Домен: модели, денежные правила и общие контракты отделены от Flutter, HTTP и SQLite.
DI: зависимости передаются через конструкторы и собираются в оболочках приложений.
Состояние UI: BLoC/Cubit с однонаправленным потоком данных.
Это практическая адаптация Clean Architecture: UI и API-адаптер могут находиться в одном feature-пакете, отдельные use case-классы для простых вызовов не создаются.
По структуре пакетов получилась следующие зависимости:
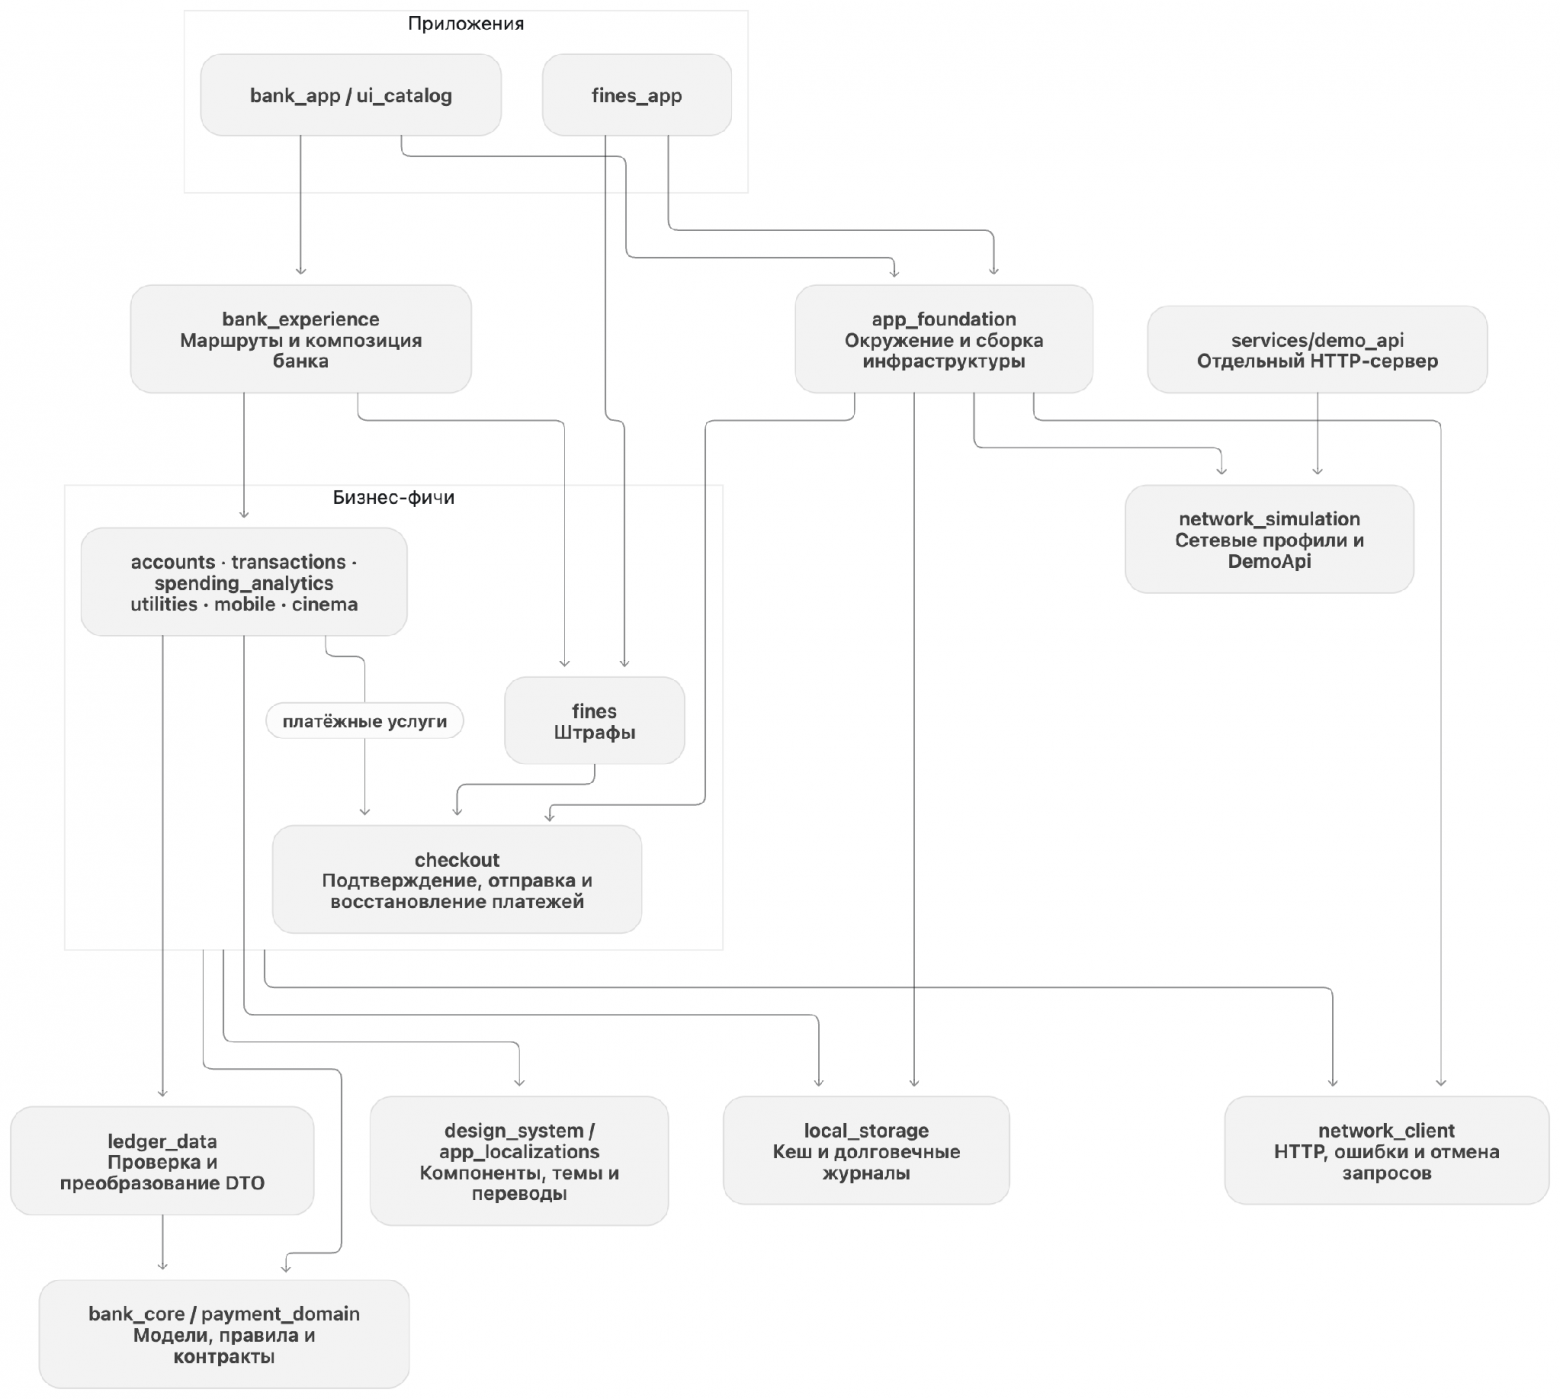
Например одно из требование было то, что фича “оплата штрафов” так же должна работать в самостоятельном приложении с общей дизайн системой и кодовой базой. Как результат, оплата штрафов и основное банковское приложение используют одну и ту же фичу оплаты штрафов, но при этом не тянет с собой лишние зависимости.
Взял этот кейс с выделением фичи в отдельное приложение, так как несколько лет назад в одном из проектов подобный кейс выделения фичи в моноприложение принесло бизнесу очень много денег, намного больше чем фича была в составе супераппа.
В качестве примера так же визуализировал архитектуру отдельно взятой фичи – “история операций”:
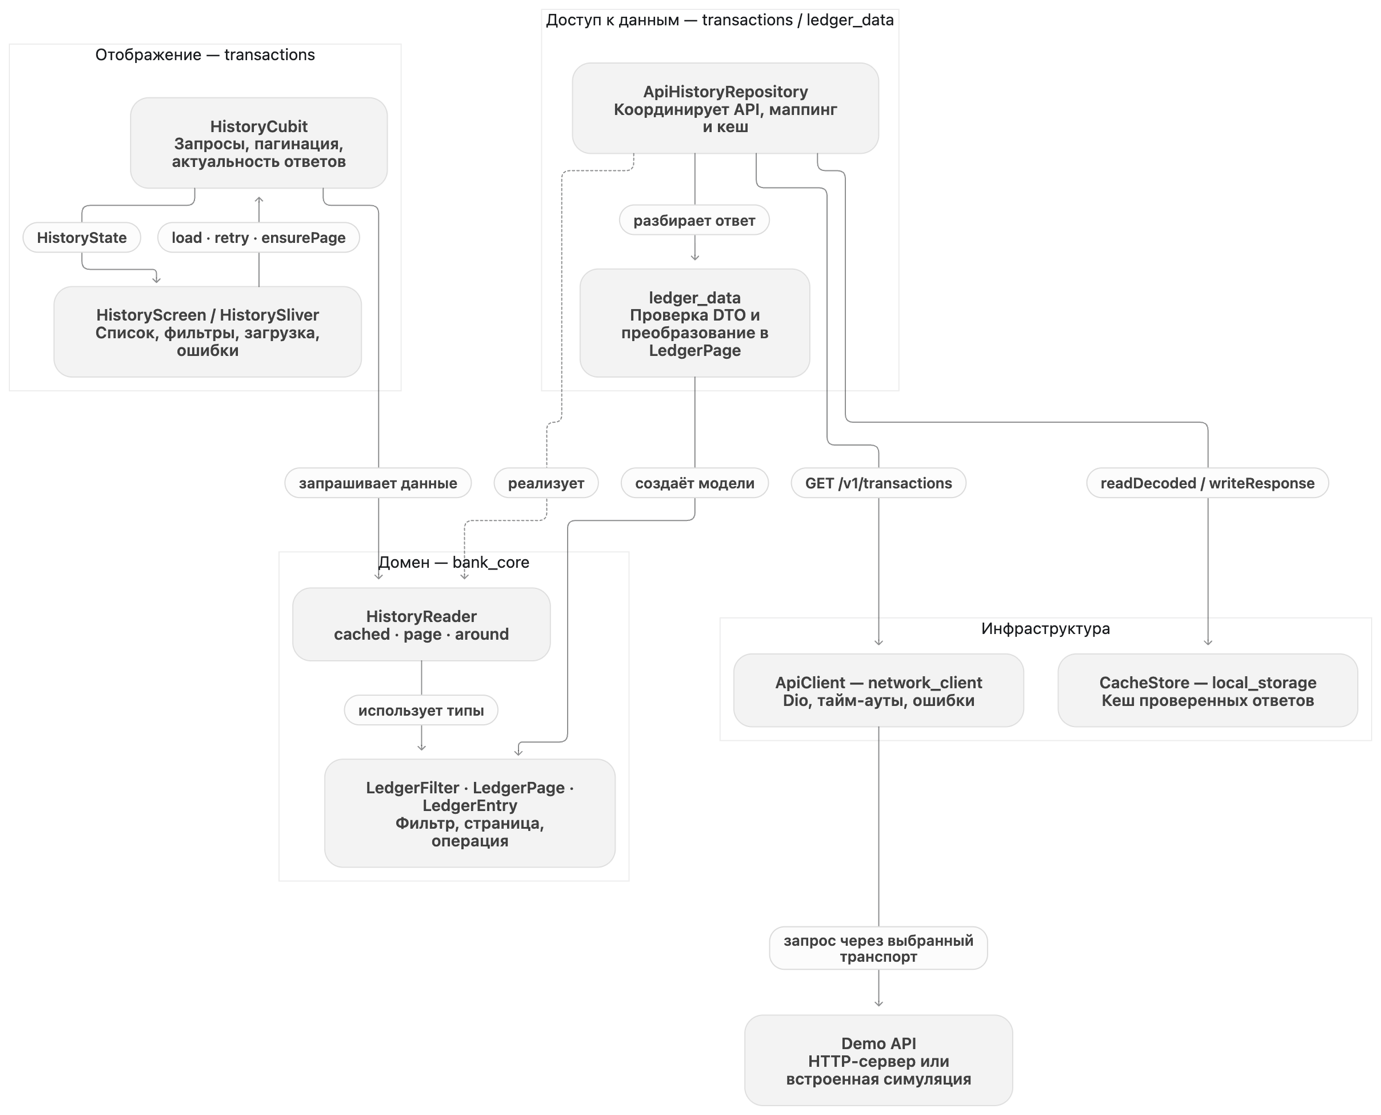
Для этого демонстрационного проекта я явно допускал отдельные заглушки и упрощения.
При этом в сетевом слое учтено идемпотентность, логика retry, защита от применения устаревшего ответа после изменения фильтра и т.д. и т.п.
Дизайн система тоже была скомпонована таким образом, что теперь страницы можно верстать декларативно, практически без необходимости указывать отступы и размеры. Компонуя компоненты друг за другом.
Одним из моих требований была плавная работа интерфейса на недорогом Android-устройстве. Производительность проверялась на физическом realme RMX3760 с экраном 60 Гц. Для минутной контрольной прокрутки истории из 12 000 операций использовался критерий: менее 1% кадров сверх бюджета 16,7 мс. В зафиксированном прогоне этот показатель составил 0,25% при симуляции API. Эти результаты относятся к конкретному устройству и сценарию; отдельные медленные кадры сохранялись. Методика, результаты и ограничения проверки описаны в отчёте о проверке производительности.
Конечно это слишком маленький проект, есть еще к чему придраться в плане качества. И архитектура в больших проектах может быть на несколько порядков сложнее, но главное что все это можно настраивать как прямыми указаниями, так еще и нефункциональными требованиями к системе.
В более серьезных проектах разработку можно вести через спецификацию и инструменты вроде OpenSpec (мой выбор на текущий момент) вместе c Grill-With-Docs (почти все меняют его под свои задачи) помогают создавать архитектурные решения (ADR) и спецификации для того чтобы агент мог генерировать качественный код и архитектуру. Есть масса готовых альтернатив с такими же целями: GitHub Spec Kit, Spec Kitty, BMAD Method, Kiro и т.д.
Но это все не бесплатно по времени и важно понимать что:
ИИ не дает мгновенный результат
При обсуждении внедрения ИИ я часто сталкиваюсь с ожиданием, что текстовое описание задачи сразу превратится в готовое изменение, зачастую приводя в пример сервис Lovable и его аналоги. На практике нужно учитывать время на сбор и уточнение требований, реализацию, проверки и исправления.
В случае DemoBank распределение времени получилось следующим:
≈27 часов 13 минут - суммарная работа Codex над ответами и решениями, включая команды, сборки, проверки и прогон тестов.
Особенно много времени ушло на прогон тестов производительности на телефоне с Android за 10 тыс. рублей.
≈19 часов 20 минут - фактически занятое время, если пересекающуюся работу агентов учитывать один раз.
Это без учета моих затрат по времен и (около 2-3 часов)
Даже этот небольшой пример показывает что быстрая генерация кода только один из этапов процесса, для команды полезнее измерять время от постановки задачи до принятого изменения, включая ревью и доработки.
Так все таки, если все таки может писать тесты, проектировать архитектуру, писать качественных код, где тут нужен разработчик?
Качество кода и процессов разработки.
Требование “используйте ИИ и выпускайте изменения быстрее” само по себе не определяет новый порядок работы. Команде необходимо понимать, кто проверяет трактовку требований, кто принимает техническое решение и какие проверки обязательны перед слиянием. Например, агент может реализовать функцию, которая успешно проходит существующие тесты, но нарушает бизнес сценарий не отраженный в них. Разбор такой ошибки должен приводить к конкретному изменению процесса: уточнению требований, добавлению проверки или пересмотру порядка приемки. Ответственность за принятое изменение остается у команды независимо от того, кто написал код.
До появления ИИ мне приходилось руководить разработчиками которые просили писать все требования сразу. Потребность в понятных требованиях нормальна. Но даже подробная постановка задачи не устраняет неоднозначности, противоречия и последующие изменения. Разработчику необходимо уметь замечать их и обсуждать последствия с бизнесом.
При работе с ИИ это особенно заметно: агент способен реализовать выбранную трактовку задачи, включая ошибочную. Поэтому важно проверить исходные предположения до того, как они превратятся в большой объем кода. Часть работы по реализации можно отдать агенту, однако в команде при этом должна сохраняться ответственность за смысл требований, технические ограничения и приемку результата. Для этого можно использовать тот же OpenSpec: оформить цель изменения, требования, сценарии поведения и технические решения в связанных документах. До начала реализации разработчик может проверить как агент понял задачу, какие предположения сделал и какие вопросы остались открытыми. Такой подход позволит обсуждать конкретную трактовку требований до того, как они закрепятся в коде. Эти обязанности могут распределяться между разработчиками, аналитиками, тестировщиками и владельцами продукта.
Не единственная, но важная роль разработчиков заключается в том, что теперь должны вместе с бизнесом выстроить качественные процессы разработки.
При работе с агентами команде нужно явно распределить ответственность за постановку задач, технические ограничения и приемку изменений. Один человек может совмещать несколько ролей, но для каждого решения должен быть понятный ответственный.
Например владелец продукта и аналитику согласуют ожидаемое поведение. Ответственный за модуль проверяет влияние изменения на его контракты и органичения. Разработчик организует работу агента и разбирает результат. Команда определяет, какие доказательства достаточны для приемки.
Под AI Harness я здесь понимаю рабочее окружение агента: контекст проекта, доступные инструменты, ограничения действий, автоматические проверки и порядок передачи результата человеку.
Для отдельной задачи агенту нужны цель, критерии приемки, затронутые модули, применимые решения и способ проверки результата. При параллельной работе необходимо отдельно координировать изменения общих контрактов, схем данных и инфраструктуры. Изолированные ветки помогают разделить работу, но не устраняют смысловые конфликты между решениями.
Правила и контекст также требуют владельца. Изменения интерфейсов и архитектурных решений должны сопровождаться обновлением соответствующих документов в том же изменении, иначе следующая задача начнется с устаревших предположений.
Quality Gate.
Вопреки расхожему мнению, качество кода и качество проекта в эпоху ИИ имеют гораздо большее значение чем раньше. По мере роста объема кодовой базы, автоматические проверки имеют гораздо более важнее значение. За карьеру мне доводилось видеть много проектов с низким качеством покрытия тестами, но тем не менее годами могли держать более менее достойное качество кода и проекта за счет медленной вдумчивой разработки и проектированию кодовой базы по принципам SOLID/DDD даже без TDD. Однако SOLID, DDD и TDD решают разные задачи проектирования и разработки, но применение архитектурных принципов не заменяют проверку поведения системы.
Проверки от которых зависят принятия изменений, должны запускаться автоматически и обязательными для слияния. Просьба в промпте “запусти тесты” может помогать агенту, но не обеспечивает выполнение этого условия.
Необходимо выстроить цикл разработки в котором Quality Gate является частью этого цикла.
Например цикл может выглядеть таким образом:
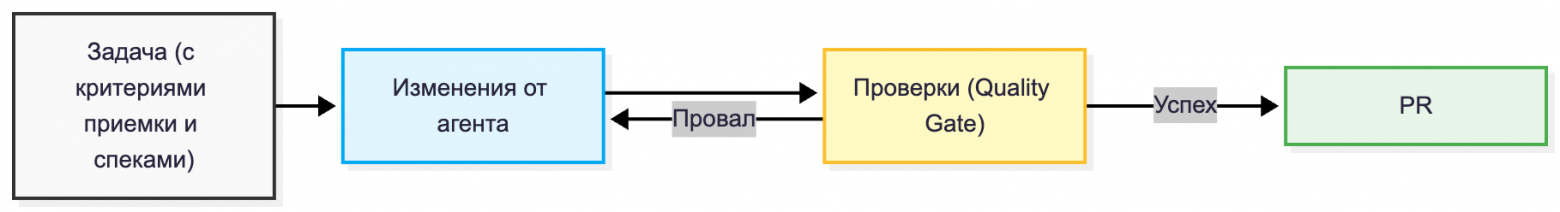
В одном из моих проектов цикл работы агента продолжался 40 часов, пока я не остановил его вручную. Этот случай показал, что условие “продолжай до успешного прохождения проверок” требует дополнительных ограничений. Для такого цикла нужно заранее определить бюджет времени и расходов, а так же условия остановки. Например, повторение одной и той же ошибки без новых результатов должен приводить к разбору причины. При остановке агент должен сообщить, какие проверки не проходят и какие способы исправления уже попробовал.
Если цикл был принудительно остановлен до достижения результата, надо провести анализ причин и внести изменения в процесс. Возможно неверно понял задачу, возможно не смог прочитать карту проекта или карта была не актуализирована. Возможно выбранная модель исполнитель оказалась слишком слабой для выбранной задачи. Но вместо того что-бы каждый раз вручную вносить правки надо думать как исправить исходную проблему чтобы агент больше не совершал таких ошибок. Ожидаемые результаты следует выводить из согласованных бизнес требований, контрактов и инвариантов.
Проблема больших кодовых баз, или нужен ли большой контекст?
При работе с большой кодовой базой агенту нужно находить относящиеся к задаче компоненты, контракты и ограничения. Увеличение контекстного окна расширяет объем доступной информации, но само по себе не гарантирует ее правильного использования. Например, исследование Lost in the Middle ( https://arxiv.org/abs/2307.03172 )показало зависимость качества ответов от положения нужной информации в контексте на изученных моделях и задачх. Поэтом полезно проверять насколько конкретный агент справляется с задачами вашего проекта. Карта модулей, актуальные контракты и связанные ADR помогают собрать контекст для конкретного изменения. Их ценность определяется тем, позволяют ли они находить нужную информацию и учитывать ограничения.
При работе с агентами полезно заранее определить, где находится актуальное описание каждого аспекта системы. Например, API-контракт можно хранить в TypeSpec, а OpenAPI, справочную документацию и клиентский код получать генерацией. Тогда изменение параметра или формата ответа вносится в один источник, а согласованность производных артефактов проверяется в CI.
ADR при этом хранит обоснование архитектурного решения и ссылку на контракт. Если решение пересмотрено, прежняя запись помечается как superseded и связывается с новой. Это помогает агенту отличать действующие ограничения от истории проекта.
Однако формального описания API недостаточно для проверки всех гарантий. Например, обязательный ключ идемпотентности можно описать в контракте, а отсутствие повторного возврата денег необходимо проверять отдельным сценарием. Поэтому агенту нужны актуальный контракт, применимые решения и проверяемые требования к поведению.
Если агент упустил важный ADR или бизнес правило, нужно разобраться в причине: документ мог не попасть в контекст, противоречить другим указаниям или оказаться недостаточно конкретным. После этого можно исправить подбор контекста, уточнить документацию или добавить автоматическую проверку соответствующего ограничения.
Работа с архитектурой и доменами:
Продолжая пример выше, бывает случаи когда агент может принять неверное архитектурное решение. Например, допустим ситуацию что в интернет магазине выделили модуль Управления Заказами (заказы, позици, условия отмены) и модуль Платежи (платежи, защита от повторов, возвраты, взаимодействие с платежным провайдером и т.д.), в случае если карта проекта плохо прописана, агент может принять решение что имя на руках API платежного сервиса можно из модуля Управления Заказами напрямую вызвать API платежного сервиса для отмены, что будет черевато, тем что в журналы платежного модуля не попадут возвраты с соответствующими финансовыми убытками и/или другими неприятностями для бизнеса. Такой костыль может случиться даже если у вас явно прописан контекст.
И здесь, весь ваш опыт проектирования по DDD может пригодиться для того что бы разделять домены. Кроме того, можно и нужно прописывать ограничение в цикл разработки с ревью другой моделью, но еще лучше использовать готовые инструменты:
Архитектурные правила можно закреплять автоматическими проверками. Например разрешить модулю заказов обращаться к публичному интерфейсу модуля платежей, но запретить зависимости от API платежной системы. Такие правила проверяются средствами конкретного языка и инструментами анализа архитектур (например ArchUnit, ArchUnitNET, dependency-cruiser и т.д.). Необходимость включить соответствующий модуль в реализацию повышает шансы что ADR и контекст выбранного модуля так же попадет в контекст агента.
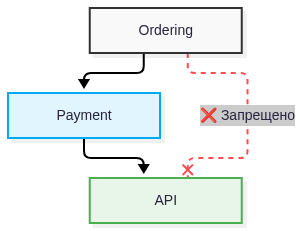
Однако здесь важно понимать границы проверки. Например запрет зависимости между модулями сам по себе не обнаружит прямой HTTP запрос к платежному провайдеру через общий сетевой клиент. Поэтому полезно разделить ограничения: Структурная проверка для контроля допустимых зависимостей, настройки доступа для ограничения возможности обращаться к провайдеру, тесты поведения чтобы проверить что возврат проходит через предусмотренный сценарий и в журнале платежного модуля появляется соответствующая запись.
Поэтому архитектурное ревью должно охватывать зависимости, поведение системы и актуальность описывающих их документов.
С чего начать?
Если хотите внедрить ИИ в существующий большой проект с накопленным легаси, имеет смысл начать с ограниченного класса задач - например, небольших доработок в одном модуле. На них можно настроить цикл работы: постановку задачи, реализацию агентом, автоматические проверки и ревью. Не менее важно договориться в команде, кто уточняет требования, кто принимает технические решения и какие проверки обязательны перед слиянием. Для агентского цикла также нужны ограничения по времени и расходам.
Поэтому, по моему опыту, качественное внедрение ИИ в команды с выстроенными процессами разработки проходит менее болезненно: уже есть актуальная документация, автоматические проверки и понятный порядок приёмки изменений. Если этого нет, первое время разработка может даже замедлиться, поскольку часть усилий придется направить на подготовку проекта и настройку процесса.
В некоторых проектах внедрение агента без требований к качеству создает иллюзию ускорения за счет быстрой генерации кода: новые функции появляются быстрее, но вместе с ними накапливаются незамеченные регрессии, а последующие изменения требуют всё больше времени.
Поэтому результат внедрения стоит оценивать по полному времени от постановки задачи до принятого изменения, затратам на исправления и качеству выпущенного продукта.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.