نموذج ذكاء اصطناعي يحل لغزاً كيميائياً قد يسرّع اكتشاف الأدوية
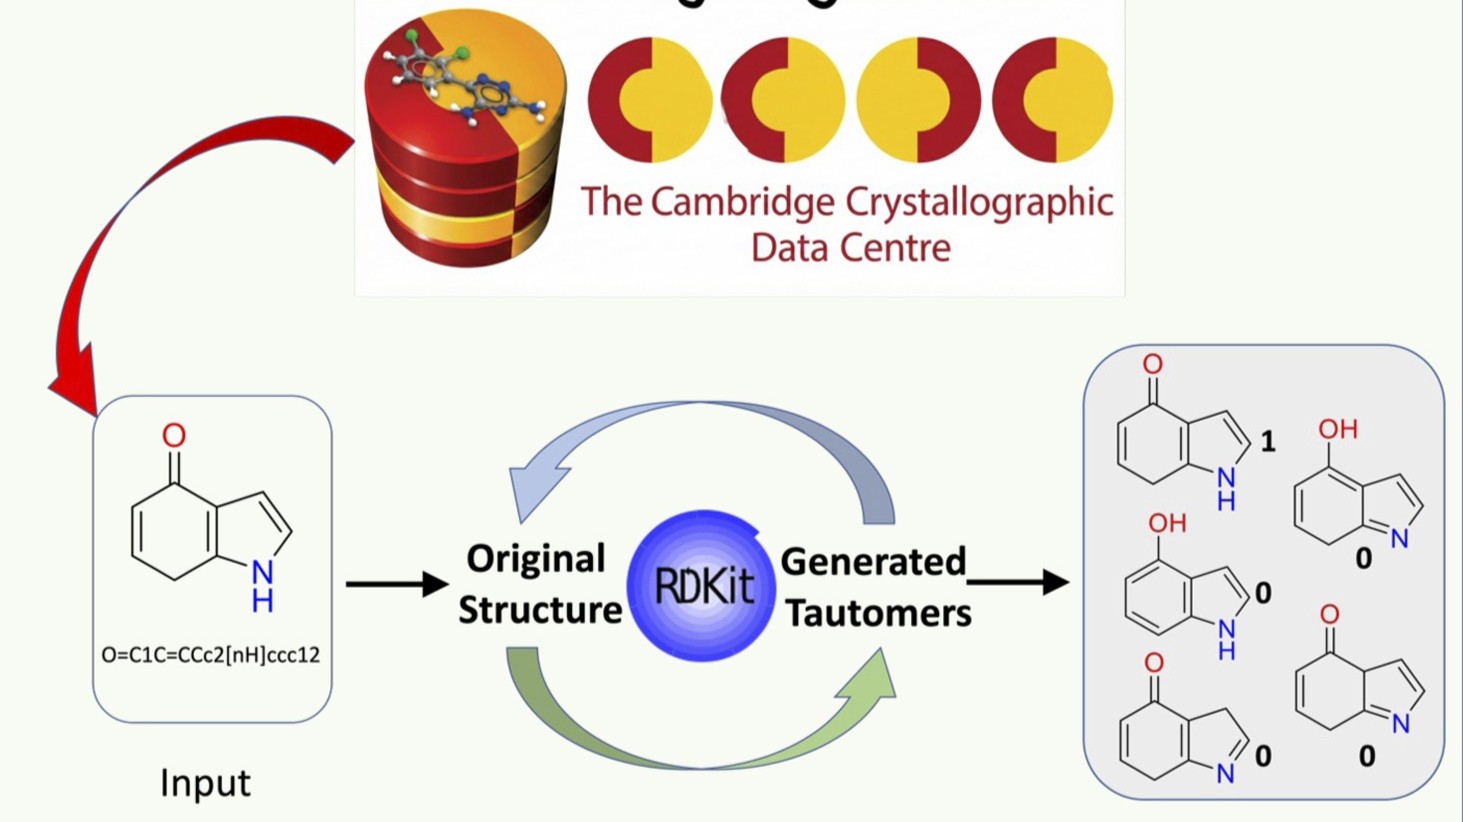
طور باحثون بجامعة نيويورك في الولايات المتحدة، نموذج ذكاء اصطناعي يستطيع التنبؤ بالشكل الكيميائي الأكثر استقراراً لجزيئات شبيهة بالأدوية، في خطوة ربما تساعد على تصميم عقاقير أكثر دقة، وتحسين النماذج الحاسوبية المستخدمة في اكتشاف الأدوية.
وقال الباحثون إن النموذج الذي يعتمد على التعلم العميق، يمكنه تحديد الموضع الأكثر ترجيحاً لذرات الهيدروجين داخل الجزيء، وهي تفاصيل صغيرة على المستوى الذري كانت تشكل لغزاً كيميائياً يغير، بصورة كبيرة، طريقة ارتباط الدواء بالبروتين المستهدف داخل الجسم.
وأفادت الدراسة المنشورة في دورية Chemical Science التابعة للجمعية الملكية للكيمياء، بأن الكثير من الجزيئات المستخدمة في تطوير الأدوية توجد في أكثر من صورة كيميائية متقاربة تعرف باسم "التوتومرات"، وفي هذه الحالة تنتقل ذرة هيدروجين من موضع إلى آخر داخل الجزيء، مع حدوث تغير مصاحب في ترتيب الروابط الكيميائية.
ورغم أن هذا الاختلاف يبدو محدوداً، إلا أنه قد يؤثر في قدرة الجزيء على الارتباط بالبروتين الذي يستهدفه الدواء، وبالتالي في التنبؤ بفاعليته وسلوكه.
وقال الباحث الرئيسي في الدراسة، يينجكاي تشانج، أستاذ الكيمياء بجامعة نيويورك، إن اختيار الشكل الصحيح للجزيء يمثل خطوة مهمة في النمذجة الجزيئية، واكتشاف الأدوية القائم على دراسة البنية ثلاثية الأبعاد للبروتينات.
لكن تحديد هذا الشكل ليس سهلاً، لأن كثيراً من الطرق التجريبية المستخدمة لتحديد البنية الجزيئية لا تستطيع رؤية ذرات الهيدروجين بدقة كافية.
تحتوي "قاعدة بيانات البروتينات" العالمية على أعداد ضخمة من التراكيب ثلاثية الأبعاد للبروتينات والجزيئات المرتبطة بها، ويُعتمد عليها على نطاق واسع في أبحاث الأدوية.
لكن معظم هذه البنى تُحدد باستخدام تقنيات مثل "حيود الأشعة السينية" (X-Ray Diffraction)، التي لا تكون دقتها عادة كافية لتحديد موقع ذرات الهيدروجين بصورة موثوقة، ولذلك يضطر العلماء في كثير من الحالات إلى استنتاج موضع الهيدروجين، ومن ثم تحديد الشكل الكيميائي المحتمل للجزيء.
أما استخدام الحسابات القائمة على ميكانيكا الكم لمقارنة جميع الأشكال المحتملة، فيحتاج إلى قدر كبير من القدرة الحاسوبية والوقت، ما يجعله مكلفاً عند فحص ملايين المركبات المرشحة.
كما أن نماذج التعلم الآلي السابقة كانت تعاني من محدودية البيانات التجريبية المتاحة، إذ تضم مجموعات البيانات التقليدية بضع مئات فقط من الجزيئات المعروفة أشكالها المستقرة.
مليون حالة لتدريب النموذج
للتغلب على هذه المشكلة، لجأ الباحثون إلى "قاعدة بيانات كامبريدج البنيوية" التي تضم عدداً ضخماً من التراكيب البلورية عالية الدقة لجزيئات صغيرة، ويمكن في كثير منها تحديد مواضع ذرات الهيدروجين.
واستخرج الباحث الأول للدراسة، شياولين بان، بيانات لأكثر من 1.1 مليون حالة توتومرية، لتكوين مجموعة تدريب أكبر كثيراً من قواعد البيانات المستخدمة سابقاً.
استخدم الباحثون هذه البيانات لتدريب "شبكة عصبية بيانية"، وهي نوع من نماذج التعلم العميق مصمم للتعامل مع البيانات التي ترتبط عناصرها بعضها ببعض، كما يحدث بين الذرات والروابط داخل الجزيئات.
وبحسب الدراسة، يستطيع النموذج التنبؤ بالشكل الأكثر استقراراً مباشرة من الرسم الكيميائي ثنائي الأبعاد للجزيء، دون حاجة إلى معرفة بنيته ثلاثية الأبعاد، أو إجراء حسابات معقدة باستخدام ميكانيكا الكم.
أخطاء محتملة في قواعد البيانات
اختبر الباحثون النموذج على 5075 جزيئاً مرتبطاً ببروتينات، ومسجلاً في قاعدة بيانات تستخدم على نطاق واسع في أبحاث اكتشاف الأدوية.
وحدد النموذج 126 حالة، أي نحو 2.5% رجَّح فيها الباحثون أن الشكل الكيميائي المسجل للجزيء ليس الأكثر استقراراً.
وعندما أعاد النموذج تعيين الشكل المحتمل لهذه الجزيئات، ظهرت أنماط أكثر منطقية للروابط الهيدروجينية بينها وبين البروتينات المحيطة بها.
وأكد الباحثون أن ذلك لا يعني وجود خطأ في البنية التجريبية للبروتينات نفسها، وإنما يشير إلى أن الطريقة التي جرى بها تمثيل الشكل الكيميائي للجزيء المرتبط بالبروتين قد تحتاج إلى المراجعة.
وفي إحدى الحالات، توقع النموذج انتقال ذرة هيدروجين إلى موضع مختلف عن ذلك المسجل أصلاً، ما أدى إلى تكوين روابط هيدروجينية إضافية مع أجزاء قريبة من البروتين.
يمكن أن يؤدي تحديد الشكل الصحيح للجزيء إلى تحسين التنبؤ بمدى ملاءمته لموقع الارتباط داخل البروتين، وهي خطوة أساسية في تصميم الأدوية باستخدام الحاسوب.
كما قد يحسّن ذلك دقة عمليات "المحاكاة الديناميكية الجزيئية" التي يستخدمها الباحثون لمتابعة كيفية حركة الدواء والبروتين وتفاعلهما مع مرور الوقت.
وقال تشانج إن هذه المحاكاة تعتمد على تحديد مواقع ذرات الهيدروجين والروابط الكيميائية بصورة صحيحة، وإن اختيار شكل غير صحيح للجزيء قد يغير التفاعلات والحركات التي تتنبأ بها النماذج.
وأتاح الباحثون النموذج في صورة أداة مفتوحة المصدر تحمل اسم "Tautomer-Predictor"، ويمكن استخدامها لفحص مكتبات ضخمة من المركبات الكيميائية.
وفي اختبار للأداء، تمكنت الأداة من تحليل نحو 4.6 مليون مركب خلال 3.2 ساعة باستخدام عقدة حاسوبية واحدة مزودة بمعالج رسوميات.
وقال الباحثون إن الأداة لا تستبدل الاختبارات التجريبية، أو الحسابات الكيميائية الدقيقة، لكنها قد توفر وسيلة سريعة لترتيب ملايين المركبات، وتصحيح تمثيلها الكيميائي، قبل استخدامها في مراحل أكثر تكلفة من عملية اكتشاف الدواء.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.