Учёт клиентов в обычной таблице: почему одна строка на человека ломается через месяц и как разложить данные по-кодовски
Я более 15 лет в партнёрском бизнесе и за это время видел, наверное, сотню попыток навести порядок в контактах. Почти все начинаются одинаково: человек открывает таблицу, пишет в первой колонке имя, во второй телефон, в третьей «статус», в четвёртой «комментарий». Через месяц таблица превращается в кладбище: в комментариях каша из дат, статусы противоречат друг другу, один и тот же человек записан трижды.
В прошлый раз на Хабре я писал о том, как описывать сам разговор через состояния. Сегодня о другом слое: о том, как устроить сами данные, чтобы таблица для учёта работы с клиентами не ломалась от собственного роста. Ответ на этот вопрос старше любой CRM.
Три симптома того, что схема уже не тянет
Прежде чем разбирать решение, зафиксирую симптомы. Их три, и они узнаются мгновенно.
Первый — «Иван 2». Человек не хочет терять историю старой записи, но и работать в ней уже нельзя, поэтому он заводит копию и продолжает в ней. Через полгода в таблице три Ивана, и никто уже не помнит, какая запись живая.
Второй — комментарий как свалка. В свободное поле пишут всё подряд: «перезвонил 12-го», «перезвонил 12.10», «сказал перезвонить после отпуска». Дата внутри свободного текста — это не дата, её нельзя отсортировать, отфильтровать или сравнить с сегодняшним днём. Она существует только для того, кто её писал.
Третий — статус, который противоречит истории. Статус «думает» стоял с сентября, а в комментариях видно, что человек месяц как пропал. Статус перезаписывается, история остаётся в чужой голове, и через пару недель противоречить начинает уже сама таблица.
Все три симптома — не вопрос дисциплины. Это следствие схемы: в одной строке записаны факты разных типов, и у каждого из них своё время жизни, которого строка не выдерживает.
Откуда растёт проблема одной строки
В 1970 году Эдгар Кодд опубликовал в Communications of the ACM статью «A Relational Model of Data for Large Shared Data Banks». Из неё выросли реляционные базы данных и идея нормализации: каждый факт должен храниться в одном месте, а связи между фактами описываются ключами, а не копированием.
Полная нормализация по всем канонам — занятие для проектировщика баз данных. Но для личной таблицы хватает одного её принципа: разделить факты по времени жизни. Кто этот человек — факты, которые не меняются или меняются редко. Что с ним происходило — факты, которых много и которые только накапливаются.
Таблица «одна строка на человека» смешивает оба типа с первого дня. Первых фактов на человека один набор, вторых много. Когда для событий нет места, люди начинают дописывать их в комментарий, перезаписывать статус или заводить нового человека «Иван 2», чтобы не испортить историю. Ломается не таблица — ломается попытка записать растущий список событий в строку, рассчитанную на один снимок состояния.
Минимальная схема: два листа
Для начала достаточно двух листов.
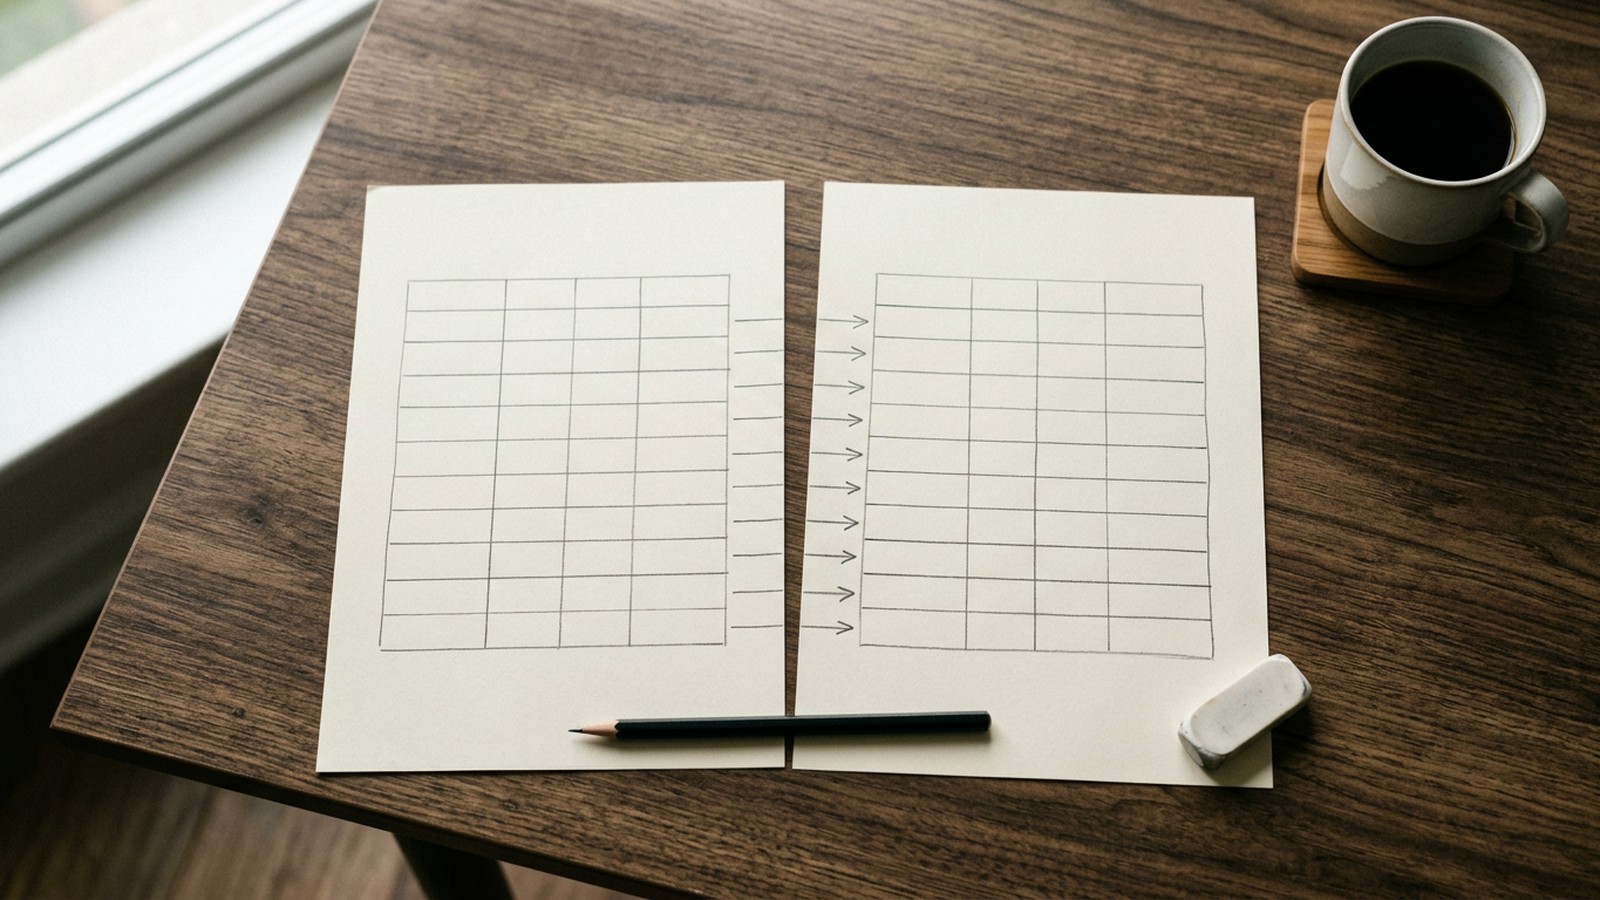
Первый лист «люди»: одна строка на человека, у каждого свой номер. Здесь только то, что не меняется или меняется редко: имя, откуда пришёл, где с ним общаемся. Если появляется ещё одно неизменяемое поле вроде города, оно добавляется сюда, и только сюда.
Второй лист «касания»: одна строка на каждое событие. Номер человека, дата, что произошло, какой следующий шаг и когда. Ни имени, ни телефона: они уже записаны в первом листе, и второй их не повторяет.
Ключевое здесь номер человека во втором листе. Он связывает события с человеком, и именно он — то, чего не хватает таблице «одна строка на человека». Текущее состояние человека вычисляется из последнего касания, а не хранится отдельно и не перезаписывается. Вопрос «а чем всё закончилось» всегда имеет ответ, потому что история не перезаписывалась — она дописывалась.
События вместо оценок
Отдельно про колонку «что произошло». Самая частая ошибка — писать туда оценки: «тёплый», «хороший контакт», «почти готов». Оценка — это не событие: её нельзя посчитать, с ней нельзя сравнить две недели между собой.
Событие — это то, что произошло и что видно со стороны: «написал первый раз», «ответил», «спросил про условия», «договорились созвониться в четверг», «не вышел на созвон». Каждое из них неделимо и не перезаписывается. Оценку при желании можно вывести из последовательности событий; обратная операция невозможна — из статуса «думает» историю не восстановишь.
Посчитаем, во что обходится дублирование
Возьмём условный пример: у вас 50 человек в работе, с каждым в среднем 6 событий за пару месяцев. В схеме из двух листов это 50 строк в первом и 50 × 6 = 300 строк во втором, и каждое имя записано ровно один раз.
Теперь представим, что вы ведёте всё в одном листе и каждое событие записываете новой строкой с полным набором полей, чтобы ничего не потерять. Получается те же 300 строк, но имя, телефон и источник повторены 300 раз вместо 50. Если человек сменил номер или вы ошиблись в имени, исправлять нужно в 6 местах, и достаточно пропустить одно, чтобы получить двух «разных» людей. При 50 людях это 250 лишних копий одних и тех же данных, каждая из которых может разойтись с остальными.
Здесь обычно возражают: у меня не 50 человек, а пять, я всё помню. Возражение честное, но схема из двух листов не стоит ничего даже при пяти людях — одна колонка с номером не делает таблицу сложнее. А переезжать с растущей кучи дублей на нормальную схему потом уже никто не будет: именно в этот момент у человека кончается время.
Проверка на практике: один запрос
Когда события лежат отдельно, на главный вопрос отвечает простая выборка. Для таблицы, выгруженной в SQLite, «что у меня висит и что делать сегодня» выглядит так:
SELECT p.name,
       (SELECT t.what_happened FROM touches t
         WHERE t.person_id = p.id ORDER BY t.touch_date DESC LIMIT 1) AS last_event,
       (SELECT t.next_step FROM touches t
         WHERE t.person_id = p.id ORDER BY t.touch_date DESC LIMIT 1) AS next_step
FROM people p;
Если у человека заполнен следующий шаг — он в работе. Если последний запрос состоялся три недели назад, а следующего шага нет — он в тишине, и никакой статус этого не скроет. В электронной таблице тот же список делается сводной или фильтром за пару минут: скрыть строки без следующего шага, отсортировать по дате.
Одно поле, которое обязательно
Если упростить всё до одного правила, то у каждого касания должен быть заполнен следующий шаг с датой. Не «думает», не «тёплый», а конкретное действие: «написать в четверг с материалом по его вопросу». Без этого поля таблица превращается в архив, а не в инструмент: она помнит прошлое, но ничего не говорит о том, что делать завтра.
Фильтр по этому полю и есть ваш список дел на день. Это та же логика, которую в отраслевой литературе называют follow-up: не помнить всё в голове, а видеть, кому и когда пора вернуться.
Как переехать со старой таблицы за один вечер
Хорошая новость: начинать с чистого листа не нужно. Старая таблица — уже источник данных, просто разобрать её надо один раз.
Схема переезда простая: каждая строка становится строкой листа «люди» и получает номер. Дубли склеиваются по телефону или почте — обычно их видно сразу. Комментарий разбирается на события: у каждого упоминания в тексте появляется дата и формулировка события, а если даты в тексте нет, берётся дата последней правки строки — точность здесь менее важна, чем сам факт переноса. Старый статус превращается в последнее событие и дальше живёт в истории, а не в отдельной колонке.
После переезда старый лист остаётся как архив, но работать вы уже в двух новых. Дольше всего занимает не механика, а решение по каждой сомнительной записи: жить ей или склеиваться с соседней. Но это решение всё равно пришлось бы принимать, и лучше один раз, чем каждый месяц заново.
Где таблица перестаёт справляться
Два листа работают, пока вы ведёте всё один. Когда появляется команда, нужны права доступа, история изменений и связи между людьми, которые таблица держит плохо: два человека, одновременно правящие один лист, затирают друг друга.
Но даже тогда модель данных остаётся той же: люди отдельно, события отдельно, связь по ключу. CRM — это ровно эта схема плюс интерфейс, напоминания и права. Если вы понимаете, как данные должны лежать, вы разбираетесь в любой CRM за час и не покупаете её вслепую. Меняется инструмент, а не принцип.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.