[Перевод] Сегфолт в glibc, 345 тысяч утёкших сокетов и 474 тысячи соединений за полминуты: шесть багов в одной цепочке
По выходным мы часто проводим работы в сети. Во время каждой из них шкаф с оборудованием может потерять связь на 15–25 минут. Наша внутренняя инфраструктура на Kafka должна переживать такие разрывы и переподключаться, когда связь вернётся. Несколько месяцев этого года она не переживала: процессы падали с segfault, теряли сотни тысяч сокетов или умирали от внезапного потока в полмиллиона TCP-соединений.
Расследование выявило шесть багов: в glibc, в нашем сетевом стеке на OCaml, в Async, в клиенте Kafka и в запускалке задач. Два из них прожили больше десяти лет.
glibc. Одиннадцатилетний баг: если повторная инициализация резолвера не удалась, он остаётся в состоянии, при котором следующий DNS-запрос роняет процесс с segfault.
Наша библиотека сокетов теряет UDP-сокет, когда
bindпадает из-за нехватки эфемерных портов.Async, наша опенсорсная библиотека конкурентности, получил регрессию четырнадцатилетней давности: таймаут в
Tcp.connect_sockперестал покрывать DNS-резолвинг, и попытка соединения, застрявшая на разрешении имени, никогда не истекает.Цикл повторов запросов в нашем клиенте Kafka отсчитывает таймаут, но не прерывает саму попытку.
Загрузка адресов брокеров в клиенте Kafka дублирует параллельные запросы: клиенты находят брокеров через внутренний сервис обнаружения, и одновременные запросы об одном и том же адресе делают каждый свой поиск, включая DNS.
Миграция запускалки задач тихо перестала применять наши переопределения лимита файловых дескрипторов, и лимит упал в восемь раз.
Каждый баг прятался за предыдущим: расследование падения вскрыло утечку, а исправление утечки показало всплеск соединений при восстановлении. Рассказ идёт в том порядке, в каком мы их находили. В конце есть несколько выводов, но в основном это была увлекательная история, и мне хотелось ею поделиться.
Действующие лица
История проходит через много слоёв, поэтому сначала немного контекста.
Kafka-релеи и мониторы consumer-групп. Это два наших вспомогательных процесса вокруг Kafka: релеи копируют сообщения между кластерами, мониторы consumer-групп следят за тем, как далеко продвинулись группы потребителей. На одном хосте работают десятки таких процессов (в одном из инцидентов ниже на машине было 79). Каждый держит пулы живых соединений со множеством брокеров, и вверх, и вниз по потоку, и постоянно обновляет метаданные брокеров и заново разрешает имена хостов, пока меняются состав кластера и лидеры партиций. Поэтому даже в спокойный день на машине открыто очень много сокетов и идёт непрерывный поток DNS-запросов.
Два независимых DNS-пути. Код на OCaml у нас разрешает имена двумя способами, и один процесс обычно использует оба:
Резолвер glibc через
{Core,Async}_unix: этоUnix.Host.getbynameи родственные функции, которые в итоге вызываютgethostbyname_rиз glibc в пуле потоков Async.dns-lib, наш собственный DNS-клиент на OCaml, которым, среди прочего, пользуется слой обнаружения сервисов. Он создаёт собственные UDP-сокеты и общается с серверами имён напрямую.
Троттлинг DNS в Async. Несколько лет назад некоторые наши серверы мониторинга упали во время очередных сетевых работ: DNS-резолвинг заблокировал весь пул потоков Async, пока DNS был недоступен. После этого Async поставил все DNS-запросы через glibc за ограничитель с лимитом в половину пула. Теперь, когда DNS болен, запросы стоят в очереди и не отнимают потоки у всего остального. В отличие от пути через glibc, dns-lib через этот ограничитель не проходит.
Эфемерные порты принадлежат всей машине. Диапазон на этих хостах стандартный для ядра: net.ipv4.ip_local_port_range = 32768 60999. Это 28 232 порта на все процессы сразу. Когда они кончаются, bind(0.0.0.0:0) начинает падать с EADDRINUSE.
Два DNS-пути ведут себя при разрыве сети по-разному. Теперь посмотрим, как сбой выглядит вживую.
Акт I. Падения
В апреле несколько релеев и мониторов consumer-групп упали с segfault прямо во время работ и оставили core-дампы. Стек везде выглядел одинаково:
#0  0x00007ffff3e07ed7 in sock_eq () from /lib64/libresolv.so.2
#1  0x00007ffff3e08bb7 in __res_context_send () from /lib64/libresolv.so.2
#2  0x00007ffff3e067dd in __res_context_query () from /lib64/libresolv.so.2
#3  0x00007ffff3e06e76 in __res_context_querydomain () from /lib64/libresolv.so.2
#4  0x00007ffff3e0745f in __res_context_search () from /lib64/libresolv.so.2
#5  0x00007fffea6023c0 in gethostbyname3_context () from /lib64/libnss_dns.so.2
#6  0x00007fffea602ecf in _nss_dns_gethostbyname_r () from /lib64/libnss_dns.so.2
#7  0x00007ffff434fa53 in gethostbyname_r@@GLIBC_2.2.5 () from /lib64/libc.so.6
#8  0x000000000bfbc12e in caml_unix_gethostbyname (name=<optimized out>) at gethost.c:161
Процесс падал внутри DNS-резолвера glibc, в функции sock_eq, на разыменовании нулевого указателя:
Program received signal SIGSEGV, Segmentation fault.
#0  0x00007ffff3e07ed7 in sock_eq (a1=0x7fffca3ffdcc, a2=0x0) at res_send.c:1453
1453		if (a1->sin6_family == a2->sin6_family) {
glibc прочитала нулевой адрес сервера имён: a2 равен 0x0.
Баг одиннадцати лет от роду
Сначала немного анатомии резолвера. Публичный массив statp->nsaddr_list[] хранит исходный список серверов имён, но его тип — sockaddr_in, то есть только IPv4. Чтобы поддержать IPv6-серверы и не менять раскладку этой структуры (от неё зависят старые бинарники), glibc держит рядом отдельно выделенную расширенную копию, statp->_u._ext.nsaddrs[]. Это массив указателей sockaddr_in6 *, способный хранить оба семейства, со своим счётчиком statp->_u._ext.nscount. Копия строится лениво, а в __res_context_send при каждой отправке сверяется с публичным списком (приложение может переписать nsaddr_list между вызовами). Цикл проверки исходит из допущения: если nscount != 0, то каждый элемент nsaddrs[] до nscount — валидный указатель. Пробегая по списку, он вызывает sock_eq для каждого nsaddrs[ns].
В core-дампе это допущение оказалось нарушено:
(gdb) p statp->nscount
$1 = 3
(gdb) p statp->_u._ext.nscount
$2 = 3
(gdb) p statp->_u._ext.nsaddrs[0]
$3 = (struct sockaddr_in6 *) 0x0     # nscount says 3, but the pointers are NULL
(gdb) p statp->_u._ext.nsaddrs[1]
$4 = (struct sockaddr_in6 *) 0x0
(gdb) p statp->_u._ext.nsaddrs[2]
$5 = (struct sockaddr_in6 *) 0x0
nscount == 3, но все три указателя в nsaddrs нулевые. Цикл проверки вызывает sock_eq(&valid, NULL) и падает.
Поиск по такой сигнатуре приводит к багу glibc 23005, и сначала он кажется точным совпадением: та же функция, тот же нулевой a2, то же место падения в res_send.c, и механизм подходит. Когда __res_context_send не может выделить память под приватную копию nsaddr_list, он может оставить после себя нули и упасть при следующем вызове. Исправление — пара строк обработки ошибки.
Это исправление вошло в glibc 2.28, и в используемой нами версии оно уже было.
Значит, это не наш баг!
В итоге мы докопались до коммита glibc 2015 года (затронуты glibc с 2.22 по 2.43). Он перенёс признак «кэш валиден» из _u._ext.nsinit в _u._ext.nscount. Из __res_iclose убрали очистку nsinit, а соответствующую очистку nscount не добавили:
@@ -621,8 +604,6 @@ __res_iclose(res_state statp, bool free_addr) {
                                statp->_u._ext.nsaddrs[ns] = NULL;
                        }
                }
-       if (free_addr)
-               statp->_u._ext.nsinit = 0;
 }
Получается, что __res_iclose может занулить указатели в nsaddrs[] и оставить nscount ненулевым.
Нужная нам вызывающая функция — res_init. Он закрывает состояние с free_addr = true и сразу вызывает __res_vinit, чтобы построить его заново:
  else if (_res.nscount > 0)
    __res_iclose (&_res, true); /* Close any VC sockets.  */
  ...
  return __res_vinit (&_res, 1);
Баг срабатывает, только если __res_vinit не удался: например, fopen("/etc/resolv.conf") вернул EMFILE при исчерпании файловых дескрипторов, или malloc отказал при нехватке памяти. Тогда res_init возвращается, уже разобрав старое состояние и не построив новое: nsaddrs[] = NULL, а nscount = 3. Следующий gethostbyname в этом потоке падает с segfault.
Воспроизведение
На C это воспроизводится в три шага: один раз разрешить имя, урезать лимит дескрипторов, чтобы повторная инициализация не смогла отработать, и разрешить имя ещё раз.
int main() {
  gethostbyname("host-a.example.com");           // works, initializes resolver

  struct rlimit rl;
  getrlimit(RLIMIT_NOFILE, &rl);
  rl.rlim_cur = 3;
  setrlimit(RLIMIT_NOFILE, &rl);                 // now re-init can't open resolv.conf

  res_init();                                    // fails halfway, corrupts state
  gethostbyname("host-b.example.com");           // segfault
}
В {Core,Async}_unix мы res_init сами обычно не вызываем, а вот dns-lib вызывает. Хотя он выполняет DNS-запросы сам, на OCaml, для разбора /etc/resolv.conf он обращается к res_init из glibc. Так что порча резолвера возникает от сотрудничества двух библиотек в одном потоке ОС:
Async_unixуспешно выполняет запрос через glibc (инициализирует_res).dns-libвызываетres_init, тот падает из-за нехватки дескрипторов или памяти и портит_res.Async_unixвыполняет ещё один запрос через glibc в том же потоке и получает segfault.
Загвоздка в том, что третий шаг должен попасть в тот же рабочий поток Async, что и второй (состояние резолвера у каждого потока своё). В проде это вопрос везения: Async раскидывает работу In_thread по пулу из 50 потоков. Но мы можем это форсировать и надёжно воспроизвести падение на OCaml, если сжать пул до одного потока:
let host = "host-a.example.com" in
let%bind async_result1 = Unix.Host.getbyname host in
let%bind () = Scheduler.yield_until_no_jobs_remain () in
Debug.eprint_s [%message "async result 1" (async_result1 : Core_unix.Host.t option)];
let old_limit = Core_unix.RLimit.get Core_unix.RLimit.num_file_descriptors in
Core_unix.RLimit.set
  Core_unix.RLimit.num_file_descriptors
  { old_limit with cur = Limit 3L };
let%bind () = Scheduler.yield_until_no_jobs_remain () in
let%bind dns_lib_result = Dns_lib.resolve host in
Debug.eprint_s
  [%message "dns lib result" (dns_lib_result : Core_unix.Inet_addr.t list Or_error.t)];
let%map async_result2 = Unix.Host.getbyname host in
Debug.eprint_s [%message "async result 2" (async_result2 : Core_unix.Host.t option)]
$ ./repro.exe
("async result 1"
 (async_result1
  (((name host-a.example.com) (aliases ()) (family Inet)
    (addresses (192.0.2.65))))))
("dns lib result"
 (dns_lib_result (Error "DNS: No nameservers found! Check /etc/resolv.conf")))
("async result 2" (async_result2 ()))

$ ASYNC_CONFIG='((max_num_threads 1))' ./repro.exe
("async result 1"
 (async_result1
  (((name host-a.example.com) (aliases ()) (family Inet)
    (addresses (192.0.2.65))))))
("dns lib result"
 (dns_lib_result (Error "DNS: No nameservers found! Check /etc/resolv.conf")))
Segmentation fault (core dumped)
EXIT STATUS 139
Мы завели баг, а наше исправление уже принято в glibc и вышло в 2.44: теперь res_init аккуратно обрабатывает сбой и не оставляет после себя наполовину инициализированный резолвер.
Оказалось, что это касается не только Kafka. Когда мы поискали в истории core-дампов ту же сигнатуру sock_eq/libresolv, выяснилось, что годами она роняла несвязанные системы по всей фирме: торговые приложения, исследовательские задачи, другую инфраструктуру и даже Chrome.
Для воспроизведения нужна была нехватка дескрипторов или памяти. Баг glibc объяснял падение, но не то, почему res_init вообще не удался. Ответ дали следующие работы.
Акт II. Утечка файловых дескрипторов
Во время следующих работ в мае система мониторинга хостов пометила мониторы consumer-групп, у которых занято больше 90% лимита в 32 768 дескрипторов, и счётчик продолжал расти. В этот раз ничего не упало, но что-то явно утекало. По lsof рост шёл за счёт UDP-сокетов:
$ lsof -P -p 44126 | wc -l
30607
$ lsof -P -p 44126 | rg UDP | wc -l
30469
Тридцать тысяч UDP-сокетов в одном процессе. И это не обычные привязанные сокеты: lsof показывал их как голые записи sock с protocol: UDP, то есть сокеты, созданные, но так и не привязанные.
Утечка в связке «сокет, затем bind»
Поиски привели к нашей библиотеке сокетов, которая создаёт UDP-сокет и затем привязывает его:
let file_descr = socket ~kind:SOCK_DGRAM in
...
Core_unix.bind file_descr ~addr:bind_to;
Если bind бросает исключение (скажем, EADDRINUSE, потому что кончились эфемерные порты), оно уходит вверх, а file_descr так и не закрывается. Каждый неудачный bind оставляет открытым один непривязанный UDP-сокет.
Утечку мы воспроизвели без обращения к сети, подменив bind через LD_PRELOAD: шим заставляет UDP-привязки к wildcard-адресу падать.
int bind(int fd, const struct sockaddr *addr, socklen_t len) {
  // ... if this is a UDP bind to 0.0.0.0:0 ...
  errno = EADDRINUSE;
  return -1;
}
Под этим шимом монитор consumer-групп после каждой неудачи открывает новый дескриптор:
LD_PRELOAD: failing UDP bind(0.0.0.0:0) fd=20
LD_PRELOAD: failing UDP bind(0.0.0.0:0) fd=21
LD_PRELOAD: failing UDP bind(0.0.0.0:0) fd=22
...
LD_PRELOAD: failing UDP bind(0.0.0.0:0) fd=100
Если пересобрать с исправлением, при том же внедряемом сбое переиспользуется один и тот же дескриптор (fd 20, fd 20, fd 20, …): утечки нет.
А в воспроизведении bpftrace показал, что сокеты создаёт dns-lib. Тот самый путь dns-lib, который вызывал res_init в падении glibc.
Кто исчерпывает эфемерные порты?
Для утечки нужно, чтобы bind падал, а падает он, когда эфемерные порты кончились. Данные sar с машины рассказывают половину этой истории:
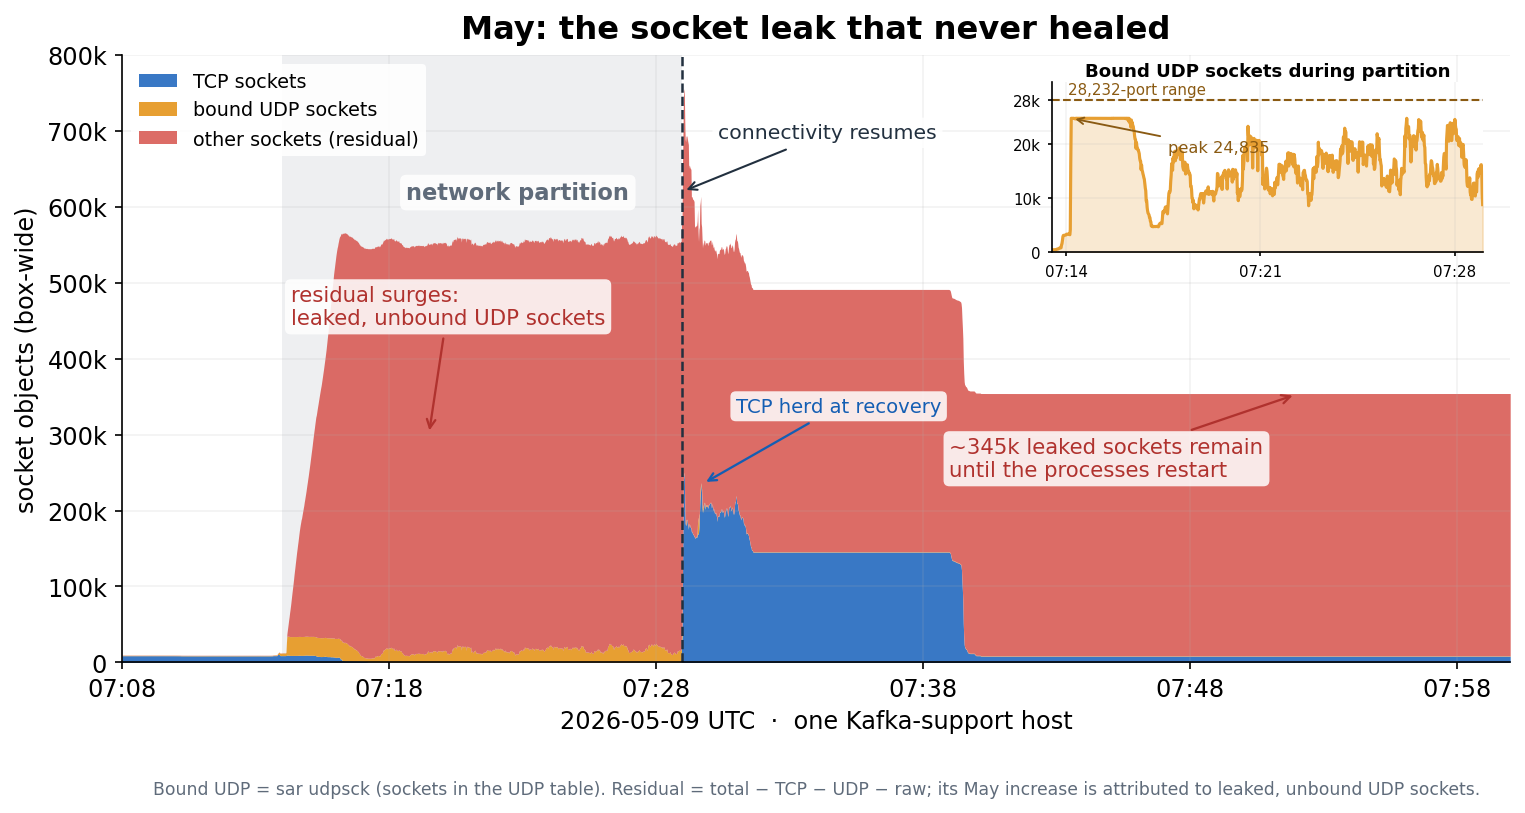
На графике три фазы:
Во время разрыва привязанные UDP-сокеты упираются в жёсткий потолок: их 24 835, и дальше число держится ровно на этом значении, секунда за секундой, при эфемерном диапазоне в 28 232 порта. При этом общее число сокетов переваливает за 580 000. В остатке между общим числом и рядами TCP и привязанных UDP есть и другие семейства сокетов, но рост почти целиком даёт тот самый класс созданных и непривязанных UDP-сокетов. (
udpsckвsarсчитает только привязанные сокеты из UDP-таблицы; осиротевшие всё равно видны вtotsck.)При восстановлении растёт число TCP-сокетов. К этому вернёмся в акте III.
После всё возвращается к норме, кроме общего числа сокетов: оно выходит на плато в 354 195 и остаётся там, примерно на 345 000 выше исходных 9 497. Этот стойкий прирост и есть найденная утечка. Связь восстановилась, а машина так и не пришла в себя: плато держалось и через два дня, пока процессы не перезапустили.
Прикидка на салфетке делает исчерпание правдоподобным: около 28 тысяч эфемерных портов на примерно 79 процессов Kafka — это лишь порядка 358 портов на процесс. dns-lib опрашивает 3 сервера имён параллельно. Много одновременных запросов dns-lib на процесс не нужно, чтобы выпить общий пул досуха. Пока он пуст, каждый неудачный UDP bind теряет ещё один сокет.
Эта утечка и даёт ту нехватку дескрипторов, из-за которой res_init падает и срабатывает баг glibc. Syslog поймал это напрямую, в DNS-запросе, у которого bind на 0.0.0.0:0 вернул EADDRINUSE:
"DNS query failed" (addr 127.0.0.1:53)
(Unix.Unix_error "Address already in use" bind "((fd 20) (addr (ADDR_INET 0.0.0.0 0)))")
Так объяснились утечка и падение, но не сам спрос на DNS, исчерпавший эфемерные порты. Ответа на этот вопрос у нас не было до июля.
Акт III. Лавина соединений
Мы выкатили исправления для glibc и библиотеки сокетов. Во время очередных плановых работ в июле два релея упали, дойдя до лимита дескрипторов:
(monitor.ml.Error
 (Unix.Unix_error "Too many open files" getpwuid_r 16429)
 ...)
В sar на этот раз росли TCP-соединения, причём всплеск пришёлся на восстановление, во время разрыва его не было:
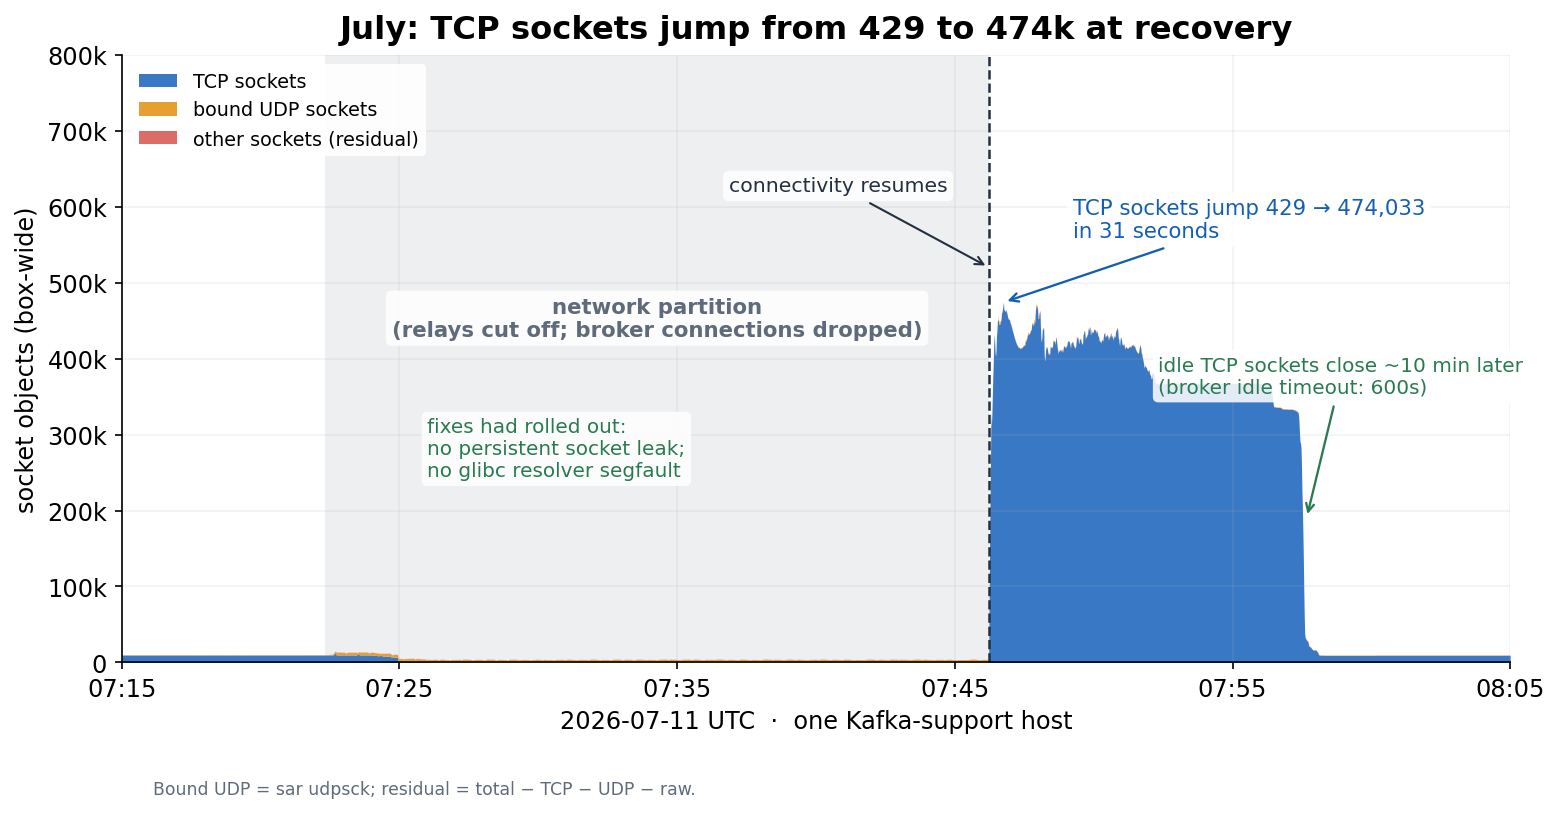
За 24 минуты разрыва TCP-соединения схлопываются: релеи не достают до брокеров, соединения обрываются, и счётчик замирает у нуля. (Обратите внимание на оранжевую линию: привязанные UDP-сокеты во время разрыва понемногу растут, что согласуется с DNS-повторами. К этой подсказке мы ещё вернёмся.) Отсутствие стойкого остатка согласуется с исправлением библиотеки сокетов. Затем, в тот самый момент, когда в 07:46:14 коммутатор возвращается, число TCP-соединений за полминуты вырастает с 429 до пика в 474 033 и только потом медленно спадает. Два релея оказались у лимита в 32 768 дескрипторов на процесс и умерли.
Это было похоже на хрестоматийный thundering herd: все, кто был заблокирован во время сбоя, просыпаются одновременно. Оставался вопрос, почему при восстановлении соединений получается намного больше, чем нужно релеям в обычной работе. Избыток дали три взаимодействующих поведения.
Соединения, переживающие свои таймауты
У брокеров Kafka есть «purgatory»: на некоторые запросы ответа нет, пока не выполнится условие или не истечёт таймаут, и поскольку ответы приходят по порядку, такой запрос по сути блокирует соединение. Чтобы избежать блокировки очереди, наш клиент ведёт пул соединений: на каждый блокирующий запрос он берёт простаивающее соединение или открывает новое (о purgatory в Kafka):
let obtain_connection t ~context =
  remove_closed_idle_connections t;
  match Doubly_linked.remove_first t.idle_connections with
  | Some connection -> Send_result.Deferred.return connection
  | None -> (* open a new connection *) ...
В документации этого модуля прямо сказано, что он рассчитывает на дисциплинированных вызывающих, у которых не слишком много блокирующих запросов в полёте одновременно. В нормальных условиях вызывающие дисциплинированны, но сбой меняет то, как долго запросы остаются в полёте.
Запросы идут через цикл повторов с таймаутом:
let create ~time_source ~timeout ~context deferred =
  match%map Timeout.with_timeout ~time_source timeout deferred with
  | `Result result -> Result result
  | `Timeout -> Timeout { timeout; context }
Когда цикл повторов сообщает о таймауте, он не отменяет исходный deferred. Попытка соединения продолжает выполняться в фоне. Во время разрыва цикл считает, что каждая попытка истекла, и идёт дальше, но все эти «брошенные» попытки живы и всё ещё ждут возможности открыть соединение.
Таймауты, не покрывающие DNS
Сами по себе эти попытки не закончатся. Открытие соединения начинается с DNS-запроса, и в Async_unix.Tcp.connect_sock таймаут его не покрывает:
where_to_connect.remote_address ()   (* DNS resolution: not covered by timeout *)
>>= fun address ->
let timeout = Time_source.Event.after time_source ... in
Таймаут и interrupt начинают отсчёт только после того, как remote_address () вернул адрес. Сам DNS-запрос никто не прерывает. Во время разрыва ограничитель DNS в Async ставит эти запросы в очередь.
Мы заглянули в историю кода в нашем внутреннем монорепозитории, и код был не всегда таким. В январе 2012 года рефакторинг Async, выделивший connect_sock_gen ради поддержки Unix-сокетов, вынес разрешение имени за пределы таймаута, видимо случайно: в соседних коммитах нет обсуждения этой смены семантики. Четырнадцать лет этого никто не замечал: обычно DNS отвечает настолько быстро, что покрывает ли его таймаут, на практике не видно.
Сложите три факта вместе, и лавина объяснена. Во время разрыва каждый релей с его примерно 1 500 consumer-групп продолжает повторять запросы. Каждый повтор запускает попытку соединения. Каждая попытка «истекает» в цикле повторов, но её DNS-запрос остаётся в очереди ограничителя. Очередь растёт весь сбой. Когда коммутатор возвращается, ограничитель разгребается быстро, все накопившиеся запросы разрешаются почти разом, и каждая из давно брошенных попыток наконец открывает соединение и отдаёт его в пул.
Числа сошлись
Именно это превратило правдоподобную версию в уверенную. По логам:
Разрыв длился с 07:22:19 до 07:46:14, то есть 1 435 секунд.
Один неудачный цикл запроса занимал около 80 секунд, значит в сбой поместилось примерно 18 циклов.
У релеев около 1 500 consumer-групп.
18 × 1 500 = 27 000 попыток соединения.
Логи сервисов показали 27 898 попыток соединения на одном выжившем релее и 27 786 на другом. Вскоре после восстановления мониторинг хостов насчитал на этих же процессах 27 927 и 28 099 открытых дескрипторов соответственно. Затем соединения спали примерно через десять минут после восстановления, что совпадает с дефолтом Kafka connections.max.idle.ms в 600 секунд. Это и есть обрыв справа на графике.
Тот же механизм виден на майском графике как небольшой бугорок с подписью «TCP herd at recovery» (TCP там достиг 249 288 и около 25 секунд держался выше 200 000). В мае его заглушила история с утечкой сокетов, и ни один процесс до лимита дескрипторов не дошёл, поэтому на него никто не обратил внимания.
Вероятный ответ на вопрос акта II
Этот же шторм повторов подсказывает ответ на вопрос, оставшийся открытым в акте II: откуда взялся всплеск UDP?
Соблазнительно сказать, что UDP-всплеск — это просто DNS для этих TCP-соединений, но его масштаб так не объяснить. Поиск имён брокеров идёт по пути Async_unix / glibc, а тот ограничен: запросы встают в очередь и не растут неограниченно. Остаётся путь без ограничителя.
Наша лучшая версия: один и тот же шторм повторов кормил два разных DNS-пути:
Соединения с брокерами разрешают имена через glibc, во время разрыва стоят в очереди за ограничителем DNS в Async и превращаются в лавину TCP при восстановлении (акт III).
Поиск сервиса обнаружения устроен иначе. Вместо статических списков для начальной загрузки наши клиенты находят брокеров, спрашивая внутренний «сервер метаданных»: небольшой сервис на OCaml, который знает, какие брокеры отвечают за какие топики. Адрес самого этого сервиса ищется через наш слой обнаружения сервисов, который работает на
dns-libи обходит ограничитель, поэтому во время разрыва он молотит без всяких тормозов. Эта половина вызывает у нас меньше уверенности (мы так и не смогли задним числом полностью установить майский спрос), но, скорее всего, именно она была главным источником давления UDP во время разрыва, исчерпавшего эфемерные порты и запустившего утечку сокетов (акт II) и, в свою очередь, падение в glibc (акт I).
Комментарий в загрузчике этого пути обнаружения («CR-someday» по нашей терминологии: известное улучшение, отложенное на потом) уже описывал этот риск:
(* CR-someday: Cache pending requests so that concurrent requests don't get
   sent to the metadata server multiple times looking for the same information,
   crowding the server. ... *)
Это даёт правдоподобную общую первопричину для UDP-ветки, хотя, в отличие от TCP-ветки, напрямую проверить её задним числом мы не смогли.
Почему это началось в апреле
Строго говоря, не в апреле. После работ в августе 2025 года один релей остался держать 145 тысяч непривязанных UDP-сокетов: это та самая утечка сокетов, которую мы разобрали следующим маем. Мы его перезапустили и пошли дальше. Необъяснимый рост памяти у релеев во время разрывов сети тоже годами был источником рутинной возни. Присмотреться по-настоящему мы решили, только когда сбои превратились в segfault в апреле.
Изменился наш лимит файловых дескрипторов. Вспомогательные процессы Kafka работали с мягким лимитом 262 144, заданным переопределениями в /etc/security/limits.d. Когда мы перевели одну из внутренних запускалок задач на пользовательские сервисы systemd, её новый путь запуска перестал применять эти переопределения. Задачи, запущенные ею, получали лимит по умолчанию для пользовательских сервисов systemd на наших хостах: 32 768. Он упал в восемь раз, и никто этого не заметил. Мы считали 32 768 нормой, потому что это и так большое число.
Миграция началась на 10% боевых машин в конце марта, включая ту самую Kafka-машину, на которой случился segfault, и в мае расширилась на все боевые машины. Регрессия задела и другие системы, использующие ту же запускалку и те же переопределения лимитов. Это расследование позволило перехватить запланированное падение лимита у некоторых из них, прежде чем изменение вступило в силу на большинстве их редко перезагружаемых хостов.
Как всё сходится
Каждый инцидент начинался с одного и того же: сетевой разрыв, из-за которого DNS зависал, пока циклы повторов Kafka продолжали стрелять.
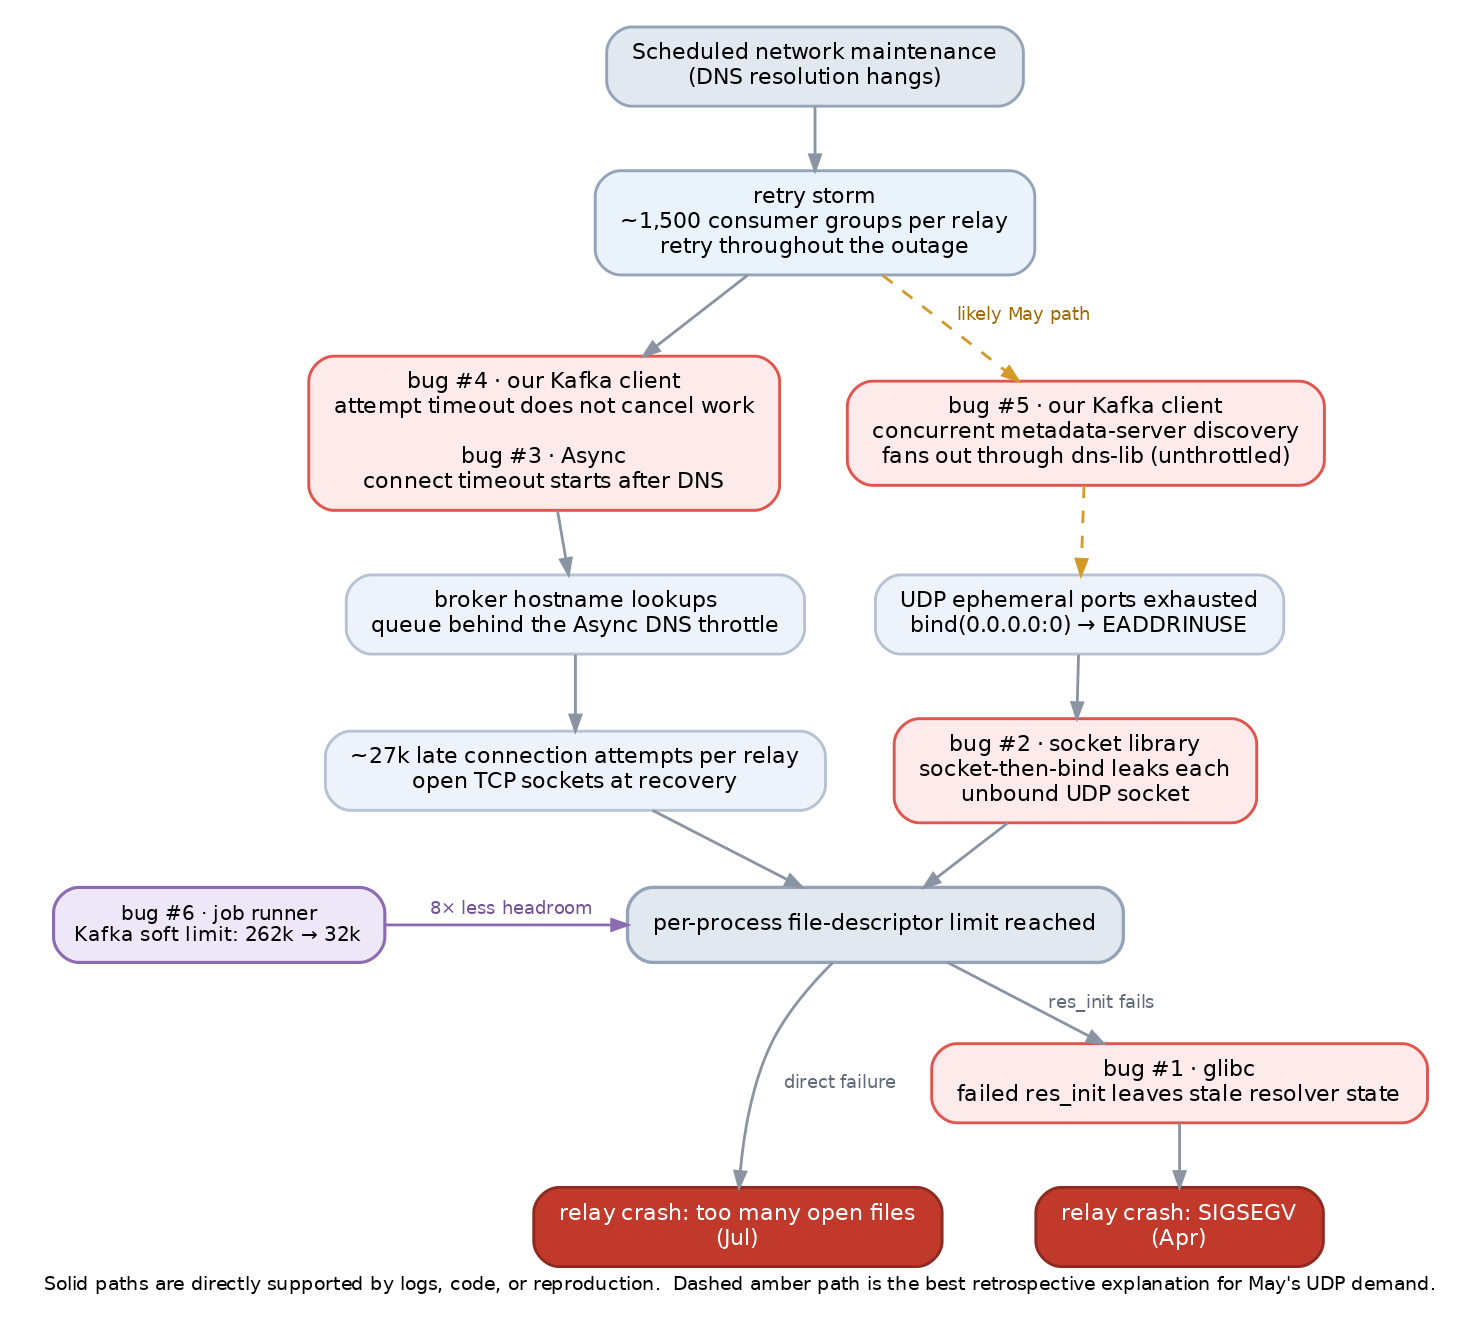
Баги №2–5 создают или удерживают сокеты, баг №6 снижает порог. Обе ветки сходятся на исчерпании дескрипторов, которое либо ломает процесс напрямую, либо запускает баг №1.
Три расследования понадобились потому, что мы всё время заходили в этот граф с листа. В акте I мы нашли segfault и могли сказать только «что-то создало нехватку дескрипторов». В акте II нашли утечку и могли сказать только «что-то вызвало всплеск спроса». Акт III наконец вскрыл шторм повторов наверху: он объяснил TCP-ветку и дал нашу лучшую версию для необъяснённого до того UDP-спроса.
Исправления
Единственного «главного» исправления нет: каждое закрывает цепочку на своём слое.
В glibc res_init теперь корректно обрабатывает неудачную повторную инициализацию и не оставляет наполовину инициализированный резолвер (upstream, вышло в 2.44). В нашей библиотеке сокетов неудачный bind теперь закрывает созданный сокет. В Async таймаут Tcp.connect_sock теперь покрывает DNS-резолвинг (исправление войдёт в наш следующий публичный релиз на GitHub), так что попытка, застрявшая на разрешении имени, возвращается к дедлайну, а запоздавший DNS-ответ больше не открывает TCP-соединение, которого никто не ждёт, хотя сам запрос в glibc Async отменить не может. В нашем клиенте Kafka цикл повторов теперь отменяет истёкшую блокирующую попытку и чистит связанную с ней работу по соединениям, а загрузчик кэширует запросы адресов, уже находящиеся в полёте, так что параллельные запросы делят один общий поиск. Мы также проверили остальных, кого задела миграция запускалки задач, и исправили их, вернув прежние лимиты.
Выводы
Несколько вещей, которые я заберу из этой истории:
Таймаут не означает отмену. Наш клиент Kafka переставал ждать каждую попытку, но оставлял её выполняться, а
Tcp.connect_sockзапускал таймаут только после DNS-резолвинга. Добавляя таймаут, проверяйте, покрывает ли он ту операцию, которая способна зависнуть, и может ли запоздалое завершение всё равно съесть ресурсы или дать побочные эффекты.Делайте многошаговую подготовку атомарной по отказам и тестируйте пути отказов напрямую.
res_initразрушал рабочее состояние резолвера до того, как строил новое; наша библиотека сокетов создавала сокет раньше, чем привязывала его. Оба случая сбоили на полпути и оставляли за собой ресурсы или состояние. Воссоздавать настоящий сетевой разрыв для проверки этих путей не нужно:setrlimitзаставилres_initпадать, шимLD_PRELOADзаставилbindвозвращатьEADDRINUSE, а пул Async из одного потока сделал детерминированной последовательность из двух библиотек.Заставьте гипотезу предсказывать число. Теория TCP-лавины предсказывала около 18 циклов повторов на 1 500 consumer-групп, то есть 27 000 попыток соединения. Это совпало с числом в логах, с числом дескрипторов и с десятиминутным спадом, следующим из idle-таймаута Kafka. Та же дисциплина отсеяла наше первое объяснение UDP-всплеска.
Моделируйте ресурсы на том уровне, где они общие. Лимиты дескрипторов действовали на процесс, а пул эфемерных UDP-портов был общим на весь хост. Каждый процесс по отдельности выглядел разумно, но их суммарный спрос исчерпал ресурс всей машины. Посекундная история сокетов в
sarпозволила восстановить картину спустя недели.«Старый и широко распространённый» не всегда значит «правильный». Баг glibc из 2015 года живёт в широко развёрнутых релизах, а регрессия Async из 2012-го сидит в одной из самых вызываемых у нас функций. Оба пережили годы, потому что спокойные условия никогда не вызывали их срабатывания. Не давайте мысли «ну не в glibc же баг» остановить вас перед чтением исходников на слой ниже вашего кода. Это просто код. Иногда он ошибается.
Избыточность дала нам время на любопытство. Каждый инцидент был переживаем, поэтому мы могли восстанавливать затронутые процессы и разбираться, не гадая под давлением. Этот запас позволил проследить один сбой резолвера через выделение сокетов, ограничитель DNS, повторы Kafka и лимиты процессов, пока вся цепочка не сложилась.
Кстати, это был мой второй баг в glibc с тех пор, как я пришёл в компанию. Надеюсь, на какое-то время последний.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.