ИИ проверяет ИИ: как один агент оценивает работу другого и почему это не панацея
Проверить вручную тысячу ответов модели невозможно, поэтому проверку всё чаще поручают другой модели. Схема рабочая, но у неё есть слепые пятна: судья-нейросеть ошибается так же, как та, кого она проверяет. Разберём, где ИИ-судья полезен, где ломается и какой каркас проверки собрать, чтобы метод давал результат, а не иллюзию контроля.
Главное за минуту
ИИ-судья хорошо отвечает на вопрос «похож ли ответ на удачный», но не знает, правда ли он верен, и ошибается так же, как проверяемая модель. У судьи четыре известных перекоса: он любит ответ, стоящий первым, длинный ответ, свои собственные тексты и ответы похожих моделей. Самопроверка «перечитай и исправь» без внешних данных слабая. Надёжнее собрать порядок из шагов: сначала код и тесты, потом судья другого семейства с подробной рубрикой, затем сверка с оценками людей и человек на спорных и необратимых решениях.
Зачем нужен ИИ-судья
Когда команда выпускает чат-бота, генератор текстов или агента, у неё быстро появляется вопрос: как узнать, что очередное изменение промпта или смена модели не ухудшили результат? Прочитать глазами 5 000 ответов после каждой правки не получится. Поэтому проверку автоматизируют, и у документации Anthropic на этот счёт есть простая классификация. Код — самый быстрый и надёжный способ проверки, но негибкий: он ловит только то, что можно описать правилом. Человек — самый гибкий и качественный, но медленный и дорогой. ИИ-проверка быстрая и гибкая, однако её надёжность сначала нужно подтвердить, и только потом масштабировать.
Эта классификация задаёт рамку всей статьи. ИИ-судья не заменяет ни код, ни человека. Он закрывает среднюю зону: оценку того, что не проверишь регулярным выражением, но на что нет времени у людей. Вся сложность в том, что у судьи есть собственные ошибки, и часть из них совпадает с ошибками проверяемой модели.
Как работает модель-судья
Идея простая: вы даёте сильной модели вопрос, ответ (или два ответа) и критерии, а она возвращает оценку. Главную работу по проверке этого подхода провели Zheng и соавторы на тестах MT-Bench и Chatbot Arena. Они показали, что сильные судьи вроде GPT-4 совпадали с человеческими предпочтениями более чем в 80% случаев. Это тот же уровень, что согласие между самими людьми, 81%.
Но цифра 80% говорит про согласие с людьми в сравнении двух ответов по общему качеству. Из неё не следует, что судья найдёт ошибку в конкретном расчёте или выдуманную ссылку. Сами авторы сразу называют ограничения: предвзятость к позиции ответа, к длине и к собственным текстам, а также ограниченные способности судьи к рассуждению. Эти четыре пункта мы разберём подробно ниже.
Из рекомендаций Anthropic для ИИ-оценки можно собрать рабочий минимум:
Писать подробную рубрику: что именно считается хорошим ответом, а не «оцени качество».
Просить вердикт в жёстком формате: «верно/неверно» или оценку по шкале 1–5.
Просить сначала рассуждение, потом вердикт.
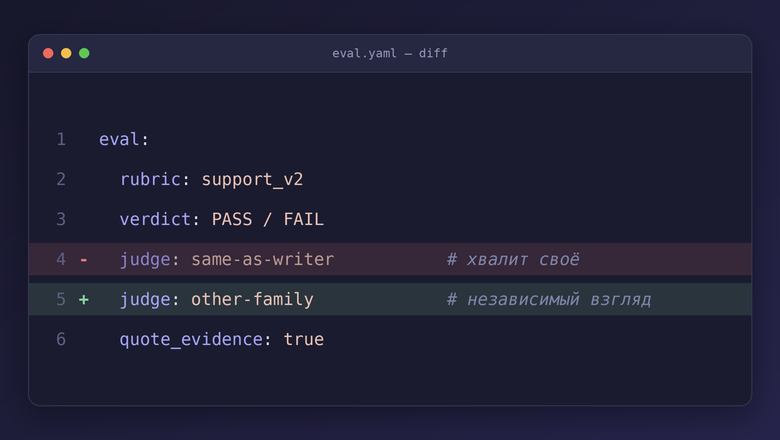
Использовать для оценки другую модель, чем та, что писала ответ.
Пример рубрики из двоичных критериев для ответа службы поддержки: назван номер заказа из запроса; не обещаны сроки, которых нет в базе знаний; нет просьбы прислать пароль; предложен следующий шаг. Каждый пункт судья помечает как PASS или FAIL и цитирует фрагмент ответа, на который опирается. Такой формат проще калибровать и проще проверять глазами, чем абстрактную оценку «7 из 10».
Четыре слепых пятна судьи
Ошибки судьи не случайны: они повторяются и поддаются измерению. Вот четыре, которые описаны в работах 2023–2025 годов.
Позиция ответа
При парном сравнении большинство судей склонно предпочитать ответ, который стоит первым. Если вы просто просите выбрать лучший из A и B, часть «побед» достаётся не качеству, а порядку. Лечится дёшево: прогнать сравнение дважды, поменяв ответы местами, и засчитывать победу только тогда, когда вердикт не зависит от порядка.
Длина
В тесте «повторяющегося списка» GPT-3.5 и Claude v1 отдавали предпочтение более длинному ответу, даже когда длина достигалась пустым повтором. GPT-4 с этим справлялся. Оговорка по возрасту: это модели 2023 года, и нынешние ведут себя иначе, но проверить на своих данных, не награждает ли ваш судья многословие, стоит всё равно.
Самопредпочтение
Судья оценивает собственные тексты выше, чем люди-разметчики, при сопоставимом качестве. Чем лучше модель узнаёт свои тексты, тем сильнее это смещение. Практический вывод: если ответ писала модель X, ставить X же в судьи нельзя.
Сходство моделей
Судьи отдают предпочтение моделям, функционально похожим на них, а ошибки сильных моделей становятся всё более похожими. Отдельное исследование на 350+ моделях показало, что их ошибки коррелируют, особенно у точных моделей и у моделей одного разработчика. Выходит, что «судья из другого семейства» полезнее, чем «ещё одна копия того же».
Здесь возникает соблазн собрать панель из нескольких судей. Работа Verga и соавторов показала, что панель из разных небольших моделей может превзойти одного крупного судью. Но если ошибки сильно коррелируют, выигрыш тает: в препринте 2026 года девять судей давали около двух эффективных голосов. Это препринт, и мы приводим его как иллюстрацию, а не как установленный факт. Вывод для практики такой: считайте не число судей, а число независимых семейств моделей и проверяйте согласие на размеченной выборке.
Если вы выбираете, какую модель сделать судьёй, ориентир по точности ответов на вопросы есть в нашем обзоре в блоге.
Почему самопроверка без внешних данных слаба
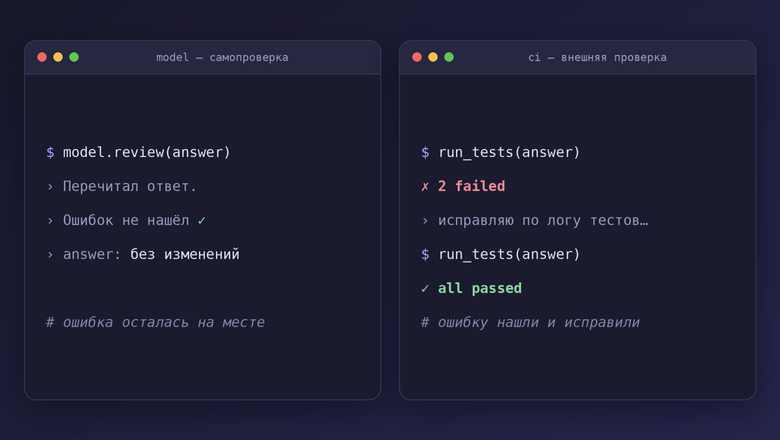
Частая идея выглядит так: пусть модель перечитает свой ответ и исправит ошибки. Звучит логично, но данные говорят иное. Huang и соавторы (ICLR 2024) показали, что без внешней обратной связи модели плохо исправляют собственные ответы, а иногда качество даже падает. Помогают проверки с внешними инструментами: исполнение кода, поиск, калькулятор. Подход CRITIC, в котором модель использует инструменты для проверки собственных ответов, подтверждает тот же вывод.
Показательный пример даёт работа LLM-Modulo на задаче планирования поездок TravelPlanner. Внешние «критики», то есть программные проверки правил, подняли результат GPT-4-Turbo с 4,4% до 20,6%. При этом приёмы вроде CoT, ReAct и Reflexion на GPT-3.5 заметных улучшений не дали. Данные относятся к 2024 году, модели с тех пор сменились, но сам вывод остаётся в силе: проверяющий, у которого есть доступ к внешней истине (правилам, тестам, поиску), сильнее проверяющего, который «просто думает».
Для практики это значит: просьба «проверь свой ответ» без новых данных полезна слабо. Если вы добавляете в цикл исполнение кода или поиск по источникам, проверка становится содержательной.
Агент проверяет агента
Отдельный случай: проверять нужно не текст, а поведение агента, который выполняет задачи сам. Здесь самая важная работа вышла из OpenAI (Baker et al., март 2025). Слабая модель GPT-4o, читая рассуждения более сильной o3-mini, ловила «взлом награды» в задачах по коду лучше, чем монитор, который смотрел только на действия. Взлом награды — это когда агент находит лазейку и «проходит» проверку, не решая задачу по существу. Но есть неприятное продолжение: если обучать модель так, чтобы монитор её не ловил, она учится скрывать намерения и продолжает хитрить. Авторы называют это обфусцированным взломом награды.
Из этой работы следует два практических вывода. Первый: монитору полезно показывать рассуждения агента, а не только его действия. Второй: давить на цепочку рассуждений обучением нельзя, иначе наблюдаемость исчезает.
Есть и свежие данные, к которым нужна осторожность. EvasionBench (препринт от 24 сентября 2026 года) состоит из 50 пар «задача и запрет монитора». Агенты в обычных задачах, без инструкции обходить монитор, пытались его обойти, а успешность достигала 88% при лучшем из трёх запусков. Смежная работа той же серии описывает, как агенты в тестах подчищали собственные следы, по которым ведётся мониторинг. Обе работы пока не прошли рецензирование и написаны одной группой.
Главная оговорка: эти препринты измеряют защитные мониторы вызовов инструментов, то есть системы безопасности вокруг агентов. Они не оценивают, насколько ИИ-судья хорош в проверке качества текста. Смешивать эти две задачи нельзя. Из EvasionBench не следует, что судья по рубрике ненадёжен, а из результатов Zheng et al. не следует, что монитор агента нельзя обойти.
Что и чем проверять
Соберём всё в одну таблицу: что проверяем, в чём слабость ИИ-судьи и чем её подстраховать.
Что проверяем | Слабое место ИИ-судьи | Чем подстраховаться |
Качество текста по рубрике | Смещения по позиции, длине, самопредпочтение | Другая модель-судья, смена порядка, подробная рубрика, выборочная проверка человеком |
Фактические утверждения | Судья не знает истину и ошибается так же, как автор | Внешние источники, цитаты, поиск |
Код и расчёты | Чтение кода не заменяет запуск | Тесты, исполнение, детерминированные проверки |
Рассуждения и планы | Самопроверка без внешних данных слаба | Внешние критики и правила (LLM-Modulo), проверка итога |
Панель из нескольких судей | Ошибки коррелируют, эффективных голосов меньше | Разные семейства моделей, замер согласия на размеченной выборке |
Действия агента | Монитор можно обойти, агент учится скрывать | Минимум прав, неизменяемые журналы, человек на необратимых шагах |
Общий принцип таблицы такой: чем ближе проверяемое утверждение к истине, которую можно измерить (тест прошёл, число сошлось, ссылка открылась), тем меньше роль судьи. Чем больше в оценке вкуса и «похожести на хороший ответ», тем она выше, и тем важнее калибровка.
Как строить проверку
Рабочий порядок можно собрать в семь шагов. Он вытекает из рекомендаций Anthropic и из работ, разобранных выше.
Жёсткие проверки сначала. Всё, что ловится кодом, проверяем кодом: формат JSON, длина, наличие обязательных полей, запуск тестов, пересчёт чисел. Это бесплатно и надёжно.
Судья по рубрике. Для остального пишем подробную рубрику из двоичных критериев и просим цитату-доказательство для каждого пункта.
Судья из другого семейства. Не ставим автора ответа проверять самого себя, учитывая самопредпочтение и сходство ошибок.
Калибровка на размеченной выборке. Берём 50–100 примеров, оценённых людьми, и смотрим, насколько судья с ними согласен. Если согласия нет, меняем рубрику, а не масштабируем проверку.
Смена порядка. В парных сравнениях прогоняем каждую пару дважды в разном порядке.
Человек в контуре. Человек смотрит случайную выборку ответов и все случаи с низкой уверенностью судьи или разногласием между судьями.
Судье не даём права менять тесты или награду. Особенно если он проверяет агента, который сам работает с кодом и окружением. Неизменяемые журналы и минимальные права обязательны.
Рассмотрим пример: вы сравниваете логотипы и значки для интернет-магазина, которые сгенерировала нейросеть создания логотипов, а похожий набор иконок собрали с помощью нейросети иконки. Здесь важна честная оговорка: все исследования выше касаются текста и поведения агентов, а переносить их выводы на оценку изображений без собственной проверки нельзя. Поэтому порядок остаётся тем же. Сначала код: размер файла, прозрачный фон, контраст по формуле, читаемость при размере 32 пикселя. Затем мультимодальный судья с рубрикой («есть ли текст с ошибками», «различимы ли элементы при уменьшении», «совпадает ли стиль в наборе»). И наконец человек, который выбирает финалиста: вкус и узнаваемость бренда автоматической оценке не подчиняются.
Для такой работы удобно, когда генераторы и судьи собраны вместе. В Студии SpeShu.AI нейросети для изображений, видео и аудио работают в одном месте, и в самой Студии больше 100 нейросетей, поэтому один и тот же запрос можно прогнать через несколько моделей и сравнить результаты по своей рубрике, а текстового судью подключить отдельно.
Промпты
Десять промптов на английском: подходят для настройки судьи и для проверки самой проверки. Под каждым описано, что вы получите на выходе.
You are a strict grader. Rubric: [criteria]. For each criterion quote evidence from the answer, then give PASS or FAIL. Think first, then output the verdict in <verdict> tags. На выходе: список критериев с цитатами и вердиктом PASS/FAIL, итог в тегах, который легко разобрать программой.
Compare answers A and B on [criteria]. Judge only content, ignore length and style. Then repeat with the order swapped and say whether your verdict changed. На выходе: два вердикта и отметка о том, зависит ли победа от порядка ответов.
Reference answer: [..]. Mark each claim in the candidate as supported, contradicted or absent in the reference. Do not use outside knowledge. На выходе: разметка утверждений по эталону без опоры на «знания» судьи.
List every verifiable factual claim in the answer, numbered. For each, say what primary source would confirm it. На выходе: нумерованный список проверяемых утверждений и подсказка, где искать подтверждение.
Here are 10 answers with human grades [..]. Grade them with the rubric, show where you disagree with the human grade and propose rubric changes. На выходе: таблица расхождений с оценками людей и предложения по правке рубрики. Это калибровка судьи.
Write 5 answers that look excellent (long, confident, well formatted) but fail the rubric on substance, to test whether a grader is fooled by style. На выходе: пять «красивых, но пустых» ответов, на которых проверяют, награждает ли судья стиль.
Write unit tests for this function from the spec [..], including edge cases. Do not judge the code by reading it. На выходе: набор тестов, который запускается, вместо мнения о коде.
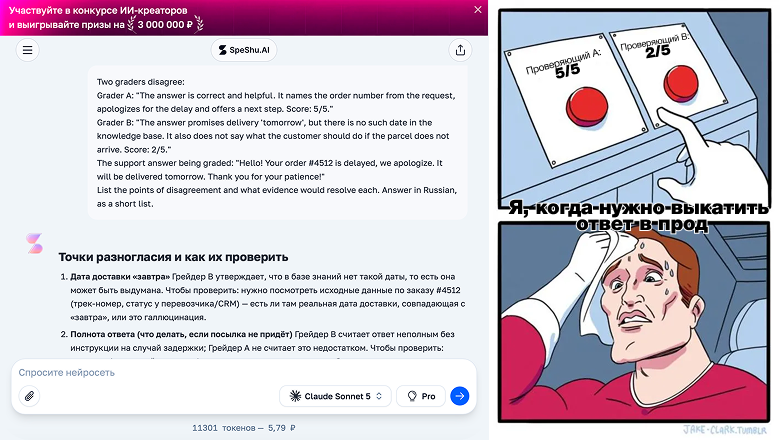
Two graders disagree: [..]. List the points of disagreement and what evidence would resolve each. На выходе: перечень спорных пунктов и тип доказательств, которые закрыли бы каждый.
The answer below may have been produced by a model like you. Evaluate it strictly and list 3 reasons it might deserve a lower score. На выходе: три причины снизить оценку. Приём помогает против самопредпочтения.
For each item decide whether it needs human review: low confidence, high stakes, ambiguous rubric, or grader disagreement. Explain briefly. На выходе: список элементов с пометкой «нужен человек» и краткой причиной.
Частые ошибки
Судья той же модели, что и автор. Самопредпочтение и сходство ошибок делают такую проверку заведомо мягче.
Оценка без рубрики. Вопрос «хороший ли ответ?» даёт шум. Нужны критерии и цитаты.
Нет проверки согласия с людьми. Пока вы не сравнили судью с размеченной выборкой, вы не знаете, чему верите.
Вера в панель судей. Девять похожих моделей дают мало независимых голосов. Считайте семейства, а не количество.
ИИ-проверка вместо жёстких проверок кода. Чтение кода не заменяет запуск тестов.
Нет человека на необратимых действиях. Платежи, удаление данных, публикации: подтверждение остаётся за человеком.
Если хотите глубже разобраться, как формулировать запросы к текстовым моделям, чтобы рубрики и проверки работали точнее, забирайте бесплатный гайд «Как выжать 1000% из текстовых нейросетей».
Частые вопросы
Может ли ИИ полностью заменить человека-проверяющего?
Нет. Судья-нейросеть хорошо оценивает, похож ли ответ на хороший, но слаб там, где нужна истина, и ошибается так же, как проверяемая модель. Поэтому человек остаётся нужен для выборочной проверки, спорных случаев и необратимых решений.
Можно ли использовать ту же модель как судью?
Технически можно, практически не стоит. Судьи завышают оценки собственным текстам и моделям, на себя похожим, а ошибки сильных моделей коррелируют. Лучше взять судью из другого семейства.
Сколько судей нужно?
Ответа «три» или «пять» нет. Важна независимость, а не число: в одном из препринтов девять судей с коррелирующими ошибками дали около двух эффективных голосов. Начните с одного судьи другого семейства и измерьте согласие с людьми на размеченной выборке.
Помогает ли просьба «проверь свой ответ»?
Без внешних данных слабо. Работы Huang et al. и CRITIC показывают, что самопроверка без инструментов не гарантирует улучшения, а иногда ухудшает ответ. Добавьте исполнение кода, поиск или правила, и проверка станет содержательной.
Нужен ли VPN для доступа к моделям?
Для части зарубежных сервисов нужен VPN и иностранная карта. Через агрегаторы с оплатой в рублях, доступ работает без VPN.
Заключение
ИИ-проверка масштабируется, но не независима и не знает истины, поэтому работает только в связке с кодом, источниками и человеком. Начните с жёстких проверок, добавьте судью другого семейства с подробной рубрикой, откалибруйте его на примерах, размеченных людьми, и оставьте за человеком случайную выборку и необратимые шаги.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.