Базовая настройка DGX Spark
Счастливым страдальцам владельцам Спарков посвящается...
Перво-наперво — мега-респект героям китайского так называемого коммунистического труда (DeepSeek, Qwen, GLM, Kimi). Только благодаря их моделям этот мини-ящик стал реально полезным инструментом, несмотря на весь инженерный срам ниже.
Знал бы я всё это полгода назад — сэкономил бы кучу киловатт, нервов от внезапных ночных отключений и часов созерцания температурных графиков. Рецепт универсальный: для любого движка и любого числа нод.
1. Вырезаем лишний жир (Headless)
Первым делом гасим графическую оболочку, чтобы десктоп даже не думал стартовать:
sudo systemctl set-default multi-user.targetОтправляем на мороз системный мусор:
disable:bluetooth,cups,cups-browsed,avahi-daemon,ModemManager,apport,dgx-dashboard,dgx-dashboard-admin,multipathd,rsyslog.mask:snapd,packagekit,nvidia-dgx-telemetry,nvidia-dgx-sol,udisks2(он дергается через D-Bus, поэтому обычныйdisableего не удержит).PipeWire глушим через
systemctl --user maskна сами сервисы и их сокеты.Сюрпрайз: OTA-апдейты прошивки любят молча возвращать часть этого зоопарка к жизни.
Главное: не вздумайте делать
apt purge --auto-removeрабочему столу! Пакетnvidia-system-station-coreнамертво завязан наubuntu-desktop. "Очистка" снесет платформенные пакеты Spark (конфиги fstab, серийную консоль, GRUB) — в dry-run системе захотелось выпилить 1078 пакетов. Оставляем десктоп в покое, приmulti-user.targetон физически не грузится. Офис и пасьянсы вычищайте точечно и строго без флага автоудаления.
2. Лимит GPU: 1800 МГц
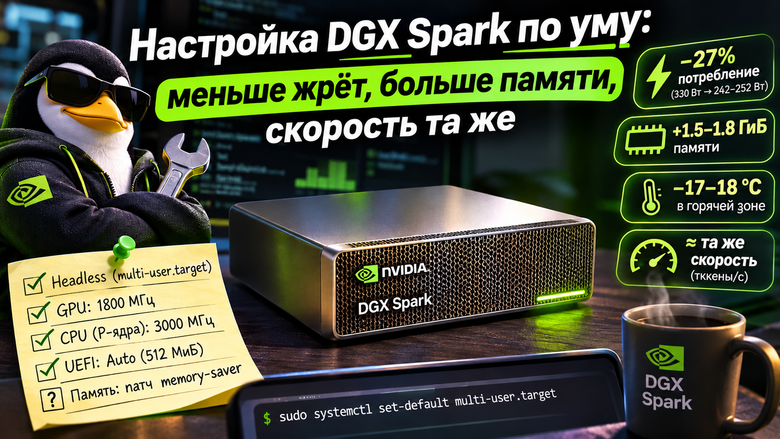
Декод у нас наглухо уперся в пропускную способность памяти. Все мегагерцы выше 1800 МГц просто греют комнату и мотают счетчик. Падать сильно ниже нельзя — просядет скорость префилла, поэтому 1800 МГц — идеальный оптимум: потребление двух нод падает с 330 Вт до 242–252 Вт без потери токенов/с.
3. Лимит CPU: 3000 МГц только на P-ядрах (Cortex-X925)
Кто бы мог подумать, что у Спарка с ядрами - неплохая diversity (как это по-русски? А! Разнообразие!). Движки инференса намертво лочат 2–3 потока на быстрых ядрах в яростном цикле spin-wait: вместо нормального сна они постоянно долбят GPU запросами ради экономии микросекунд. Ядро молотит на максимуме и жрёт питание впустую.
Фиксим частоту P-ядер на 3000 МГц: пропускная способность та же, минус 8–12% по потреблению, а самая горячая зона остывает на 17–18 °C. Ниже 2808 МГц (максимум E-ядер A725) опускать нельзя — шедулер начнет перекидывать горячие потоки на медленные ядра, что отрицательно скажется на производительноси.
4. Прошивка OTA2610+: забираем халявные 1.5 ГиБ
Память под дисплей в UEFI наконец-то сделали настраиваемой: вместо дефолтных 2 ГБ ставим режим Auto (512 МиБ в headless) прямо из ОС (чё серьёзно? не надо клаву с монитором подрубать и в течении одной секунды вспоминать что жать - Esc, Delete, F2... Прямо из ОС?! Это точно инженеры из Nvidia?). Освободившиеся 1.5 ГиБ падают в общую системную память.
5. Ядро со страницами 64K: битва за память
Переход с 4K-страниц на 64K режет накладные расходы Linux на структуры памяти с ~2 ГБ до ~128 МБ.
Но тут вступает драйвер NVIDIA UVM: под каждую крошечную 256-байтную таблицу страниц видеочипа он отжирает целую страницу в 64 КБ. В итоге вместо экономии получаем потерю ~3.25 ГБ. Отдельный фейспалм инженерам NVIDIA: угробить гигабайты на собственной коробке с унифицированной памятью своим же драйвером.
Патч memory-saver пакует таблицы страниц и возвращает чистыми +1.8 ГиБ относительно дефолтного 4K ядра. А есть ли подвох? Таки да: Secure boot и патчик - несовместны.
Вывод: переходить на линксовое ядро вида XXX-nvidia-64k НЕ надо (пока). Да или...
6. Жор в простое — скрытый грабёж
Один Спарк с загруженной моделью и поднятым сетевым линком ConnectX-7 в холостом режиме сжирает ~50 Вт от розетки. Причем около 20 Вт жрет исключительно сетевуха CX7: ASPM выключен в прошивке, энергосбережения для 200G нет, Wake-on-LAN не завезли. Для сравнения: Mac Studio мирно спит на 10 Вт. Единственное нормальное решение — тушить через poweroff и вешать на умную розетку.
Конфиги systemd
Два примитивных костыля юнита (дядя Фёдор Парето жмёт руку):
отдыхай, GPU
/etc/systemd/system/spark-gpu-clock-cap.service (в связке с /etc/default/gpu-clock-cap, где прописано GPU_MAX_MHZ=1800):
[Unit]
Description=GB10 fixed MHz GPU clock cap
Wants=nvidia-persistenced.service
After=nvidia-persistenced.service
StartLimitIntervalSec=0

[Service]
Type=oneshot
EnvironmentFile=/etc/default/gpu-clock-cap
ExecStart=/usr/bin/nvidia-smi -pm 1
ExecStart=/usr/bin/nvidia-smi -lgc 0,${GPU_MAX_MHZ}
ExecStop=/usr/bin/nvidia-smi -rgc
RemainAfterExit=yes
Restart=on-failure
RestartSec=5
TimeoutStartSec=60
TimeoutStopSec=30

[Install]
WantedBy=multi-user.target
не парься, CPU
/etc/systemd/system/spark-cpu-clock-cap.service (в связке с /etc/default/cpu-clock-cap, где заданы CPU_X925_CORES=5-9,15-19 и CPU_X925_MAX_MHZ=3000):
[Unit]
Description=GB10 fixed MHz CPU clock cap (P-cores, Cortex-X925)
After=nv-cpu-governor.service
StartLimitIntervalSec=0

[Service]
Type=oneshot
EnvironmentFile=/etc/default/cpu-clock-cap
ExecStart=/usr/bin/cpupower -c ${CPU_X925_CORES} frequency-set -u ${CPU_X925_MAX_MHZ}MHz
ExecStop=/usr/bin/cpupower -c ${CPU_X925_CORES} frequency-set -u 3900MHz
RemainAfterExit=yes
Restart=on-failure
RestartSec=5
TimeoutStartSec=60
TimeoutStopSec=30

[Install]
WantedBy=multi-user.target
Риторический аппендикс: Ода 256-битной шине и гениям сегментации
Глядя на всю эту конструкцию, очень хочется найти того маркетолога или топ-менеджера, который продавил 256-битную шину для GB10, заглянуть ему прямо в глаза и спросить: «Ну и как тебе спится по ночам? Бонус не жмёт?».
Память / интерфейс | Железка | ПСП | Объём |
|---|---|---|---|
HBM3e | NVIDIA B200 / B300 (в составе GB300) | до 8 ТБ/с на GPU | 180 ГБ¹ / 288 ГБ |
GDDR7 (512 бит) | RTX 5090 | 1,792 ТБ/с | 32 ГБ |
Унифицированная память Apple² | Mac Studio M5 Ultra | 1,2 ТБ/с | до 512 ГБ |
Унифицированная память Apple² | Mac Studio M3 Ultra | 819 ГБ/с | до 512 ГБ |
Унифицированная память Apple² | M4 Max, старшая конфигурация | 546 ГБ/с | до 128 ГБ |
LPDDR5X (256 бит) | DGX Spark, GB10 | 273 ГБ/с | 128 ГБ |
LPDDR5X (256 бит) | Strix Halo, Ryzen AI Max+ 395 | 256 ГБ/с | до 128 ГБ |
¹ Для B200 NVIDIA также указывает 192 ГБ как номинальную максимальную ёмкость Blackwell.
² Apple не публикует в официальных спецификациях тип памяти и ширину её физического интерфейса.
HBM сюда не светила из-за дефицитного и запредельно дорогого CoWoS, а GDDR7 потребовала бы штук 50 чипов, превратив компактную коробку в мангал. Выбрали LPDDR5X ради 128 ГБ и теплопакета в 140 Вт. Но почему всего 256 бит? Apple на той же памяти спокойно выжимает до 819 ГБ/с широченной шиной на 512–1024 бит.
Всё банально: если бы Спарку насыпали хотя бы 500–800 ГБ/с, он бы сожрал продажи корпоративных DGX Station и RTX Pro. В итоге выдали огрызок на 273 ГБ/с. Чип упирается в память, реальный декод болтается около жалких ~50 токенов/с на такт для MoE-моделей (10B активных весов в FP4), а пользователи вынуждены городить огород с TP2/TP3 по сети ConnectX-7 просто ради того, чтобы банально сложить пропускную способность нескольких коробок.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.