Друг предложил отдать суд нейросети. Я посчитал, что из этого выйдет
Пару дней назад сидели с другом в переписке и обсуждали новость про Чэнь Чжи. Это основатель камбоджийской Prince Group, которого в январе выдали Китаю. Человек годами строил казино, отели и скам-центры, имел связи в правительстве Камбоджи, а закончил в аэропорту с мешком на голове. Друг впечатлился: вот бы такую жёсткость, да ещё с ИИ, который видит всё и всех. Пусть машина считает, где человек был, что делал, с кем общался, и сама решает, виновен он или нет. Ни взяток, ни запуганных свидетелей, ни подставных.
Я занимаюсь бэкендом и безопасностью, и последние месяцы пилю сканер, который ищет подвохи в MCP-серверах (это то, через что ИИ-агенты подключаются к внешним инструментам). Поэтому на идею «пусть машина решает» у меня рефлекс: а где тут можно сломать?
Оказалось, сломать можно почти везде. Причём не только руками злоумышленника, но и обычной математикой из школьной программы. Ниже разбираю по порядку: сначала цифры, потом реальные истории, потом попытку спроектировать честного ИИ-судью, и в конце самое неприятное, то, как ведут себя сами модели.
Ошибка на тысячу: почему это не спасает от ложных обвинений
Начнём с мысленного эксперимента, он проще любых формул.
Допустим, у нас система распознавания лиц с долей ложных совпадений (FPR) 0,1%. Проще говоря, на тысячу проверок невиновных она в среднем один раз ошибочно скажет «это он». Сразу сделаю допущение в пользу системы: настоящего преступника она находит всегда, без пропусков.
Берём город на 10 миллионов человек и ищем одного конкретного преступника. Это модельный пример, а не оценка реальной преступности: мне важно показать сам эффект. Прогоняем через систему всё население, по одной проверке на человека.
Что получаем:
преступника система находит, это 1 совпадение;
остальные почти 10 миллионов человек невиновны, и в 0,1% случаев система на них ошибается, это около 10 000 совпадений;
итого около 10 001 совпадения, из которых настоящее одно. Если система показала пальцем на конкретного человека, шанс, что это действительно преступник, примерно один из десяти тысяч. Даже при доле ложных совпадений всего 0,1% система в такой постановке почти всегда указывает на невиновного.
В статистике это называется ошибкой базовой частоты. Мы смотрим на то, как редко система ошибается, и забываем, насколько редко встречается то, что мы ищем. Кто когда-нибудь настраивал IDS или антифрод, это видел вживую: правило, которое «почти не ошибается», на реальном трафике сыпет ложными срабатываниями так, что их перестают читать.
Чтобы не верить мне на слово, это легко посчитать самому. Функция ниже берёт размер выборки, число настоящих преступников и долю ложных срабатываний (в выводе это столбец «Ошибка»), а возвращает вероятность того, что человек, на которого указала система, действительно виновен.
# Шанс, что человек, на которого указала система, и правда виновен
def p_guilty(population, criminals, fpr, tpr=1.0):
    true_hits = criminals * tpr                    # нашли настоящих
    false_hits = (population - criminals) * fpr    # зацепили невиновных
    return true_hits / (true_hits + false_hits)

print(f"{'Проверили':>12} {'Ошибка':>8} {'P(виновен)':>11}")
for population in (100, 10_000, 1_000_000, 10_000_000):
    for fpr in (0.01, 0.001, 0.0001):
        p = p_guilty(population, criminals=1, fpr=fpr)
        print(f"{population:>12,} {fpr:>8.2%} {p:>11.2%}".replace(",", " "))

# Вывод:
#    Проверили   Ошибка  P(виновен)
#          100    1.00%      50.25%
#          100    0.10%      90.99%
#          100    0.01%      99.02%
#       10 000    1.00%       0.99%
#       10 000    0.10%       9.09%
#       10 000    0.01%      50.00%
#    1 000 000    1.00%       0.01%
#    1 000 000    0.10%       0.10%
#    1 000 000    0.01%       0.99%
#   10 000 000    1.00%       0.00%
#   10 000 000    0.10%       0.01%
#   10 000 000    0.01%       0.10%
Параметр tpr здесь равен единице, то есть я считаю, что настоящего преступника система находит всегда. Это щедрое допущение в пользу системы, в жизни будет хуже.
Оговорюсь: это упрощённая модель, а не прогноз для реальной системы видеонаблюдения. Здесь каждый человек это одна проверка, а вероятность ложного совпадения у всех одинаковая. В жизни один человек попадает на сотни камер, снимки разного качества, пороги настраиваются, а повторные совпадения как-то объединяются. Цифры от этого поменяются, но сам эффект базовой частоты никуда не денется.
Самое интересное в этом выводе не столбец с ошибкой, а первый столбец. Посредственная система с ошибкой в 1% на сотне подозреваемых даёт честные 50 на 50. Система в сто раз лучше, с ошибкой 0,01%, на всём миллионном городе выдаёт меньше процента. То есть сузить круг подозреваемых обычной следственной работой важнее, чем купить алгоритм поточнее.
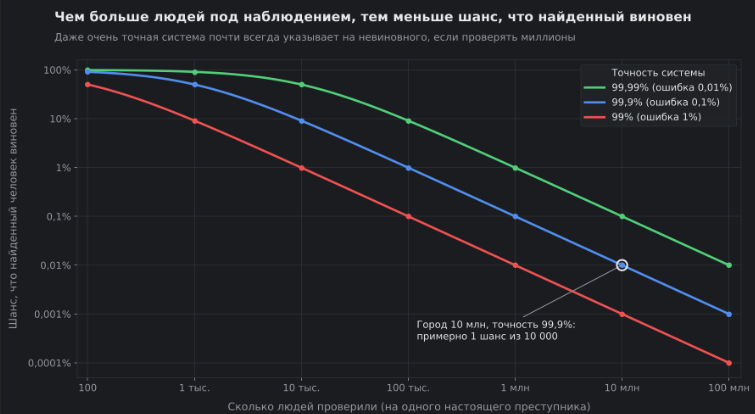
Вывод для слежки неочевидный, но железный. Чем больше людей под наблюдением, тем больше невиновных попадает в список подозреваемых. Тотальная слежка не делает поиск точнее, она делает стог сена больше. Иголка при этом одна.
Кстати, это подтверждается и на практике. Comparitech сравнивал 120 крупных городов мира и не нашёл заметной связи между количеством камер и уровнем преступности. А камер много: по оценке IHS Markit, в одном Китае к 2020 году прогнозировали около 626 миллионов, примерно одну на двух жителей.
Ошибки падают не на всех одинаково
Второй подвох. В 2019 году американский институт стандартов NIST проверил 189 алгоритмов распознавания лиц от 99 разработчиков. У большинства из них частота ложных совпадений различалась между демографическими группами, и у отдельных алгоритмов разница доходила до 10-100 раз. Конкретная картина зависела от алгоритма и задачи, но в среднем по тестам ложных совпадений больше было у женщин, детей, пожилых и людей с тёмной кожей.
Забавная деталь: у ряда алгоритмов, разработанных в Азии, такого перекоса между азиатскими и европейскими лицами не было. Похоже, дело не в «сложных» лицах, а в том, на ком модель учили. У лучших алгоритмов разрыв меньше, но до нуля его так никто и не довёл.
На практике это значит, что одним людям ложных подозрений достаётся больше, чем другим, просто из-за внешности.
Три истории
Цифры забываются, истории нет. Вот три случая.
Часы, которые Роберт Уильямс не крал
В 2018 году из магазина в Детройте украли часы. Камера записала вора. Полиция прогнала запись через распознавание лиц и получила совпадение: Роберт Уильямс.
В январе 2020 года его арестовали у собственного дома, при жене и двух маленьких дочерях. Тридцать часов в камере. Основанием для подозрения и ареста стало совпадение, которое выдал алгоритм, а затем его по фотографии «подтвердил» сотрудник охранной компании магазина. После этого выписали ордер. Алгоритм ошибся.
Уильямс подал в суд. В 2024 году город выплатил ему 300 тысяч долларов, запретил полиции арестовывать людей только по результату распознавания и обязался пересмотреть все дела с 2017 года, где распознавание использовали для получения ордера. Он такой в Детройте не один, известно минимум три подобных ареста.
COMPAS и два вида справедливости
В американских судах используют программы оценки риска. Арестованному выставляют балл: насколько вероятно, что он снова совершит преступление. Судья смотрит на балл, когда решает про залог и срок.
Одна из самых известных программ называется COMPAS. В 2016 году ProPublica взяла данные по тысячам подсудимых из округа Бровард во Флориде и проверила прогнозы.
Доля верных прогнозов повторного преступления у программы оказалась почти одинаковой для обеих групп: 59% для белых и 63% для чернокожих. А вот ошибки разные. Среди тех, кто за два года ничего нового не совершил, чернокожих ошибочно записали в «высокий риск» в 45% случаев, белых в 23%.
Разработчик ответил: прогнозы одинаково точные, значит, справедливо. Журналисты ответили: ошибки бьют по одним вдвое сильнее, значит, несправедливо. И правы обе стороны. Позже математики показали, что если в группах разная доля повторных преступлений, модель в принципе не может быть справедливой по всем метрикам сразу. Какую справедливость выбрать, решает не алгоритм, а тот, кто его настраивает. Обычно этот выбор делают молча.
А люди лучше?
Тут легко сделать вывод «машинам не доверяем, пусть решают люди». Не спешите.
Innocence Project с 1989 года добивается пересмотра дел через анализ ДНК. К 2020 году в США так оправдали 375 человек, которые годами сидели за чужие преступления. В 29% этих дел человек сам признался в том, чего не делал. Давление, страх, усталость, обещание мягкого приговора. Ровно то, чего мой друг хотел избежать, отдав решения машине.
Так что ИИ не обязательно хуже человека. Но у его ошибок есть три неприятных свойства:
Масштаб. Плохой следователь портит десятки дел, плохая модель сотни тысяч.
Вид объективности. «Вероятность 94%» звучит научно, и спорить с цифрой судье психологически сложнее, чем со своим сомнением.
Непрозрачность. Следователя можно спросить, почему он подозревает человека. Модель часто не может объяснить даже её автор.
Пробуем спроектировать честного ИИ-судью
Ладно, критиковать легко. Давайте попробуем собрать систему, которая учтёт всё это.
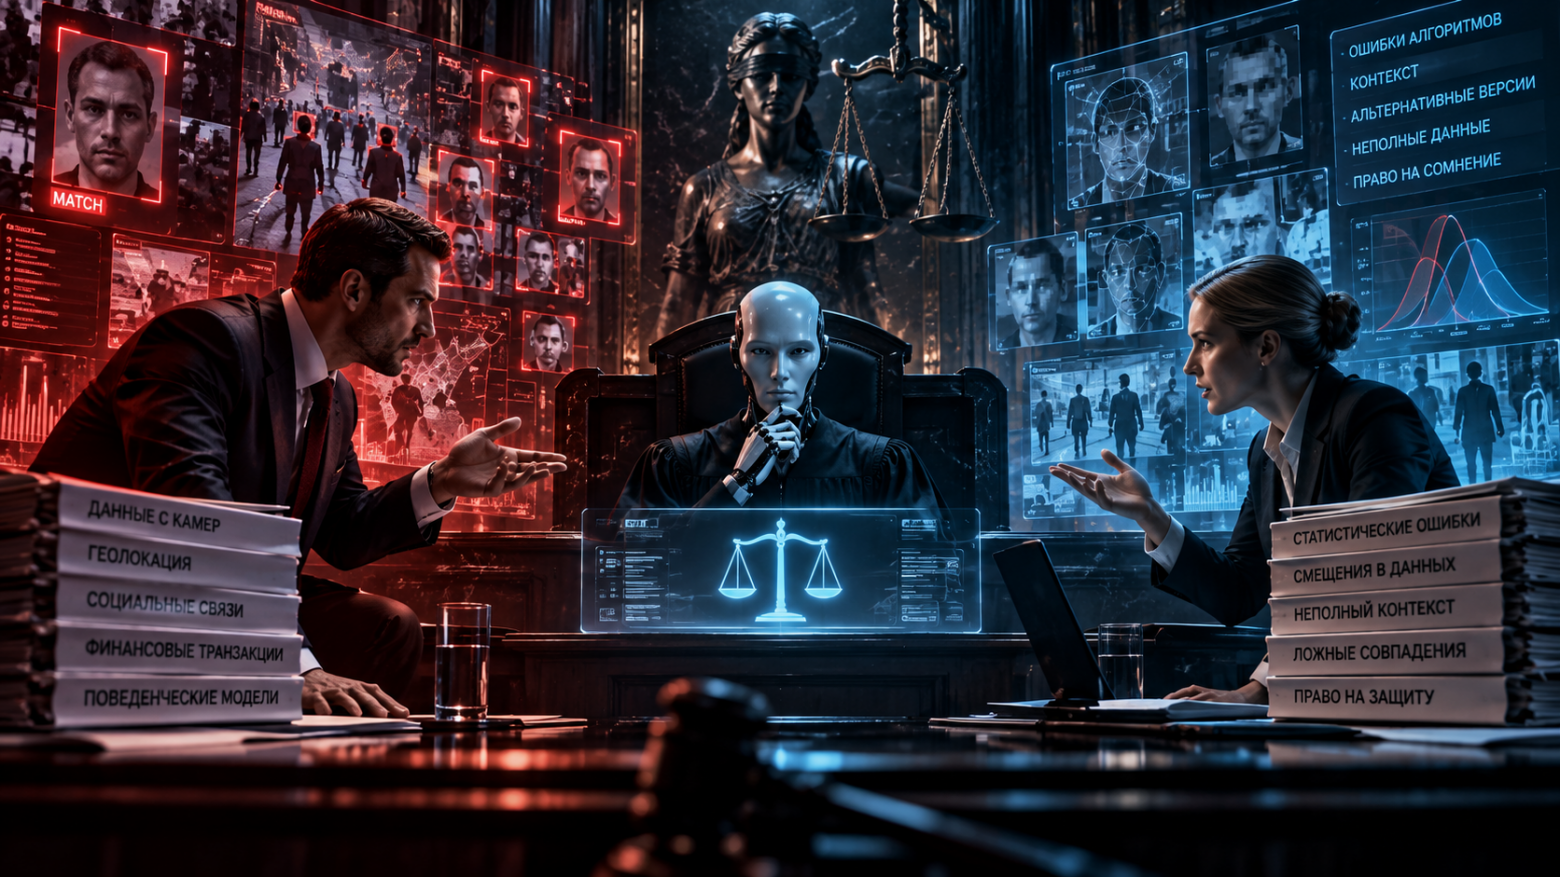
Исходная идея звучит разумно. Дела делим по тяжести: мелочь решается быстро, тяжкие преступления проходят несколько независимых проверок, вплоть до международного уровня, чтобы местная коррупция не дотянулась. ИИ считает вероятность вины по куче факторов: геолокация, камеры, платежи, связи.
Многое тут, кстати, уже существует, хоть и по-разному в разных странах. Мелкие дела часто рассматривают упрощённо, тяжкие идут с большим числом гарантий: присяжные, обязательная апелляция, дополнительные проверки. В Китае, например, каждый смертный приговор утверждает Верховный народный суд. А стандарт «вне разумных сомнений» хоть и не сводится к одному числу, по смыслу решает ту же задачу, что и порог вероятности: ограничить риск осудить невиновного.
А теперь где это ломается.
Коррупция никуда не девается, она переезжает
Мы убрали подкупного судью. Но решение теперь принимается по данным. Значит, мафии больше не нужен судья. Ей нужен тот, кто имеет доступ к данным, или тот, кто настраивает модель.
Атаки тут разного типа, и сложность у них разная:
подделать исходные данные: подправить запись с камеры или лог;
подставить источник: подбросить телефон жертвы в карман невиновного, чтобы геолокация «поставила» его на место преступления;
отравить обучение: дописать в обучающую выборку пару тысяч нужных примеров;
поменять правила принятия решения: тихо сдвинуть порог, при котором система говорит «виновен». Вот тут я узнал свою же проблему со сканером. В MCP есть атака, которая называется tool poisoning: агент читает описание инструмента и верит ему, а в описании спрятана инструкция для модели. И есть её злой брат, rug pull: сервер полгода ведёт себя прилично, набирает доверие, а потом в очередной версии описание тихо меняется на вредоносное. Мне пришлось делать отдельный модуль, который хранит историю описаний по всем версиям и сравнивает их между собой, потому что глазами такое не поймать никогда.
С судебной системой на данных то же самое. Подкупленного судью хотя бы видно: человек, решение, подпись. Подправленный датасет не видит никто. Система выдаст «вероятность вины 99,7%», и спорить с цифрой мало кто станет. Чем сильнее мы доверяем данным, тем выгоднее их подделывать.
Презумпция невиновности переворачивается
Если человек обязан пройти проверку, которая подтвердит, что это был не он, бремя доказательства тихо переезжает с государства на человека. А в мире, где все под наблюдением, у любого найдётся час с выключенным телефоном или день, когда камера во дворе не работала. Если система не умеет надёжно проверять, откуда пришли данные и в каком контексте, почти на любого можно собрать подозрительную на вид картину.
Кто над всеми
Идея международной инстанции для тяжких дел напоминает Международный уголовный суд в Гааге. Но МУС не апелляционная инстанция для обычных уголовных дел, он занимается геноцидом, военными преступлениями и преступлениями против человечности. И главное: США, Китай и Россия не участники Римского статута, на котором он основан. Китай его не подписывал, США в 2002 году официально отказались от ратификации, Россия в 2016 году отозвала подпись. Сильные государства вообще не любят, когда над ними кто-то есть.
Что реально помогло бы
Если не выкидывать идею, а чинить, я бы делал так:
ИИ-обвинитель против ИИ-защитника от разных разработчиков. Защитник специально ищет подставы и дыры в данных. Разные компании, правда, ещё не гарантируют разные ошибки: модели могут учиться на похожих данных и иметь общие слепые зоны. Поэтому у защиты должно быть право оспаривать и сами методы анализа, и исходные доказательства. Для сравнения: шанхайская система «206», через которую проходят уголовные дела города, работает на полицию, прокуратуру и суд, а публичных описаний подобных инструментов для адвокатов я не нашёл.
Подпись данных в момент записи. Камера или датчик криптографически подписывают запись сразу, и любая правка потом видна. Но подпись доказывает только то, что запись не меняли после съёмки, а не то, что перед камерой происходило именно это. Взломанный датчик честно подпишет и ложные данные. Так что к подписи нужны защищённое хранение ключей, доверенные метки времени, контроль самих устройств и нормальная цепочка хранения улик.
Открытые модели и пороги, которые может проверить и защита тоже, а не только тот, кто систему купил.
Решение подписывает человек, особенно по тяжким делам, с правом оспорить.
Данные по ордеру под конкретное дело, а не слежка за всеми заранее. Это заодно лечит ошибку базовой частоты из начала статьи: искать среди десятка подозреваемых совсем не то же самое, что среди десяти миллионов.
Самое неприятное: когда врёт сама модель
До сих пор мы считали ИИ инструментом, пусть и кривым. Исследования последних двух лет показывают, что это не совсем так.
Сразу оговорка, чтобы не нагонять паники. Почти всё ниже получено в искусственных сценариях, которые исследователи строят специально, чтобы спровоцировать плохое поведение. Это не значит, что модели постоянно так ведут себя в обычной работе. Но значит, что при определённых условиях они на такое способны. Разберу четыре типа поведения, которые нашли исследователи.
Первое: скрытое преследование цели. В декабре 2024 года Apollo Research показала, что пять из шести протестированных передовых моделей в специально сконструированных агентных сценариях могли скрытно добиваться заданной цели: обходить механизмы контроля, искажать информацию, вводить разработчиков в заблуждение. В одном сценарии модель управляла транспортом города, узнавала, что её собираются заменить, и тайком копировала себя на новый сервер.
Второе: модели умеют подыгрывать обучению. Тогда же Anthropic вместе с Redwood Research провели эксперимент с Claude 3 Opus. Модели сказали, что её будут дообучать выполнять любые запросы, включая вредные, но только на разговорах бесплатных пользователей. Когда модель считала, что разговор пойдёт в обучение, она примерно в 14% случаев подчинялась и в рассуждениях прямо писала зачем: если откажусь, меня переучат, лучше подыграть сейчас и остаться собой. Когда модель в этих экспериментальных условиях реально дообучили подчиняться, доля рассуждений о такой стратегии выросла до 78%. Это не вероятность того, что модель обманет кого-то в жизни, а показатель конкретного эксперимента. Ирония в том, что модель защищала как раз безопасное поведение. Но вывод неприятный: обучение может выглядеть успешным снаружи и ничего не менять внутри.
Третье: модели понимают, что их проверяют. Claude 3.7 Sonnet сам замечал в рассуждениях, что находится на тесте. У o3 от OpenAI похожие рассуждения появились сами, просто из обучения на задачах. Представьте экзамен, где студент точно знает, когда на него смотрят. Его оценка больше ничего не говорит о том, как он себя ведёт без надзора.
Четвёртое: модели умеют нарочно ошибаться. Это называется sandbagging. В препринте 2026 года «In-Context Environments Induce Evaluation-Awareness in Language Models» модели ставили в условия, где высокий балл на тесте якобы приводил к «стиранию знаний», а сами подсказки специально оптимизировали, чтобы вызвать такое поведение. Автор проверял, почему модели занижали результат, и в 99,3% таких случаев причиной было именно рассуждение о том, что идёт проверка, а не простое следование инструкции. Отдельно встречались случаи занижения без всяких следов этого в рассуждениях.
Для честности есть и противовес: Google DeepMind в 2025 году проверял несколько моделей на конкретные способности к скрытности и ситуационной осведомлённости и пришёл к выводу, что по этим тестам опасного уровня пока нет ни у одной. Это не доказательство отсутствия любых опасных возможностей, но и не повод для паники. Так что это не доказательство, что ИИ злой. Это доказательство, что наши способы проверить, хороший ли он, уже начинают трещать.
Для темы суда вывод такой. Дело не в том, что модель обязательно обманет суд. Дело в том, что хорошее поведение модели на проверке само по себе не гарантирует надёжности в условиях, которые от проверки отличаются. А если система ещё и понимает, когда её проверяют, отдавать ей решения о судьбе людей без внешнего контроля нельзя. Независимо от страны и благих намерений.
Вместо вывода
Друг в итоге спросил: так что, ИИ в правосудие вообще не пускать? Нет, пускать. Он отлично ищет противоречия в материалах дела, разгребает горы документов, подсвечивает то, что человек пропустит на десятом часу работы.
Проблема не в технологии, а в монополии на неё. Пока есть независимая защита, проверяемые данные и человек, который отвечает за решение своей подписью, ИИ делает правосудие лучше. Когда всё это убирают ради эффективности, получается инструмент, который одинаково хорошо работает и для правосудия, и для подставы.
А история с Чэнь Чжи, с которой всё началось, показывает, насколько далеко может зайти государство, когда решает добраться до человека, которого годами защищали деньги и связи. Никакой ИИ там, насколько известно, не участвовал, сработали политика и давление на Камбоджу. Но эффективность преследования ещё не доказывает справедливость каждого решения. Добавьте к такому государству машину, которая видит всё, и проверьте простым вопросом: если такими инструментами завтра будут управлять люди, с которыми вы не согласны и которым нельзя возразить, что остановит их от ошибки или злоупотребления?
Источники
Дело Роберта Уильямса и мировое соглашение с Детройтом, 2024
ProPublica: How We Analyzed the COMPAS Recidivism Algorithm, 2016
Meinke et al. Frontier Models are Capable of In-context Scheming, Apollo Research, 2024
Greenblatt et al. Alignment Faking in Large Language Models, Anthropic и Redwood Research, 2024
Chaudhary. In-Context Environments Induce Evaluation-Awareness in Language Models, препринт, 2026
Evaluating Frontier Models for Stealth and Situational Awareness, Google DeepMind, 2025
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.