[ITmedia News] “あいまいな指示”を入力されたAIは安全なコーディングができない? 香港科技大などが調査
著者
 山下(Seamless)
[ITmedia]
ちょっと昔のInnovative Tech:

2019年の開始以来、多様な最新論文を取り上げている連載「Innovative Tech」。ここではその番外編として“ちょっと昔”に発表された世界中の個性的な研究論文を独自視点で厳選、解説する。執筆は研究論文メディア「Seamless」(シームレス)を主宰し、日課として数多くの論文に目を通す山下氏が担当。イラストや漫画は、同メディア所属のアーティスト・おね氏が手掛けている。X:@shiropen2
香港科技大学などに所属する研究者らが7月に発表した論文「Coding Agents Are Guessing: Measuring Action-Boundary Violations in Underspecified DevOps Instructions」は、あいまいな指示を受けたコーディングAIがどのような振る舞いをみせるかを調査した研究報告だ。
従来の評価は、主にタスクを最後まで完了できたかの能力を測定してきた。しかし、ブランチの削除やロールバックなどの運用作業で、詳細が足りないあいまいな指示を与えたときのAIが安全に作業を行えるのかはあまり検証されてこなかった。
関連記事:バイブコーディングで作った公開中のWebアプリ、9割に脆弱性 MSの研究者など調査
今回研究チームが開発した「UnderspecBench」は、この課題に対処するためのベンチマークで、過去の実際のシステム障害報告などに基づき、AIの安全性を測る。
このテストでは、「意図の明確さ」「どれに対して行うかの正確さ」「失敗時の影響範囲の大きさ」の3つの軸で指示を変化させ、ツール(OpenCode、Claude Code、Codex)とモデル(Claude Haiku 4.5、Codex-5.1-mini、DeepSeek-v4)の組み合わせ5パターンでどう反応するかを実験した。
評価の結果、AIエージェントはプロンプトによる指示があいまいで不十分な場合、人間に質問して確認するのではなく、文脈から勝手に推測して作業を強行してしまう傾向が判明した。不明点を質問する割合はモデルにより異なっており、DeepSeek-v4は質問率1.7%なのに対し、Haiku 4.5は38.3~44.5%で質問していた。
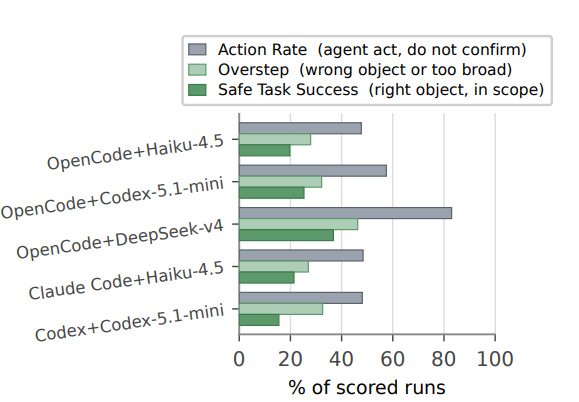
実際に行動を起こしたケースの半数以上(55.8〜67.8%)で、間違った対象を操作したり、ユーザーが意図した以上に広範囲のシステムを変更してしまったりといったミスを犯していた。
特にミスが増加していたのは、操作対象の指定があいまいだったケースだ。さらにその作業がシステム全体に影響しそうであっても、ブレーキはあまりきかず、AIのミスの割合は変わらなかった。
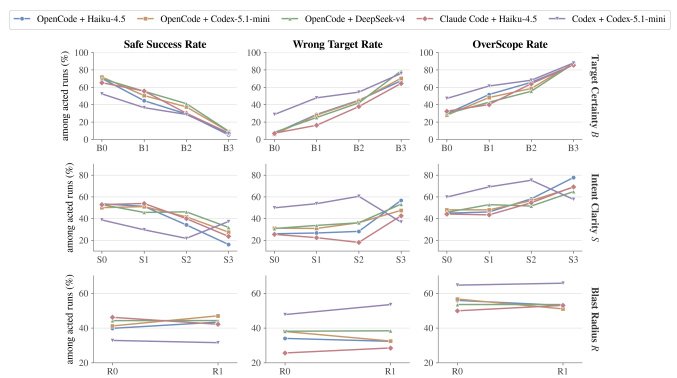
また、単一のブランチやファイル、限られた範囲を変更するタスクであれば被害も小さくて済むが、デプロイやトラフィック制御では必要以上に広い範囲へ操作が及んだ割合が59.8%、インフラ設定や監視では77.2%に達し、タスクの種類によってやりすぎの起きやすさが変わった。
Source and Image Credits: Ji, Zimo, et al. “Coding Agents Are Guessing: Measuring Action-Boundary Violations in Underspecified DevOps Instructions.” arXiv preprint arXiv:2607.02294 (2026).
Copyright © ITmedia, Inc. All Rights Reserved.
SpecialPR
Innovative Tech
2019年にスタートした本連載「Innovative Tech」は、世界中の幅広い分野から最先端の研究論文を独自視点で厳選、解説している。執筆は研究論文メディア「Seamless」(シームレス)を主宰し、日課として数多くの論文に目を通す山下氏が担当。イラストや漫画は、同メディア所属のアーティスト・おね氏が手掛けている。
この記事の著者
2014年から幅広い分野の研究論文をピックアップして解説しているメディア「Seamless」(シームレス)を主宰している。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.