Может ли ИИ уничтожить человечество?
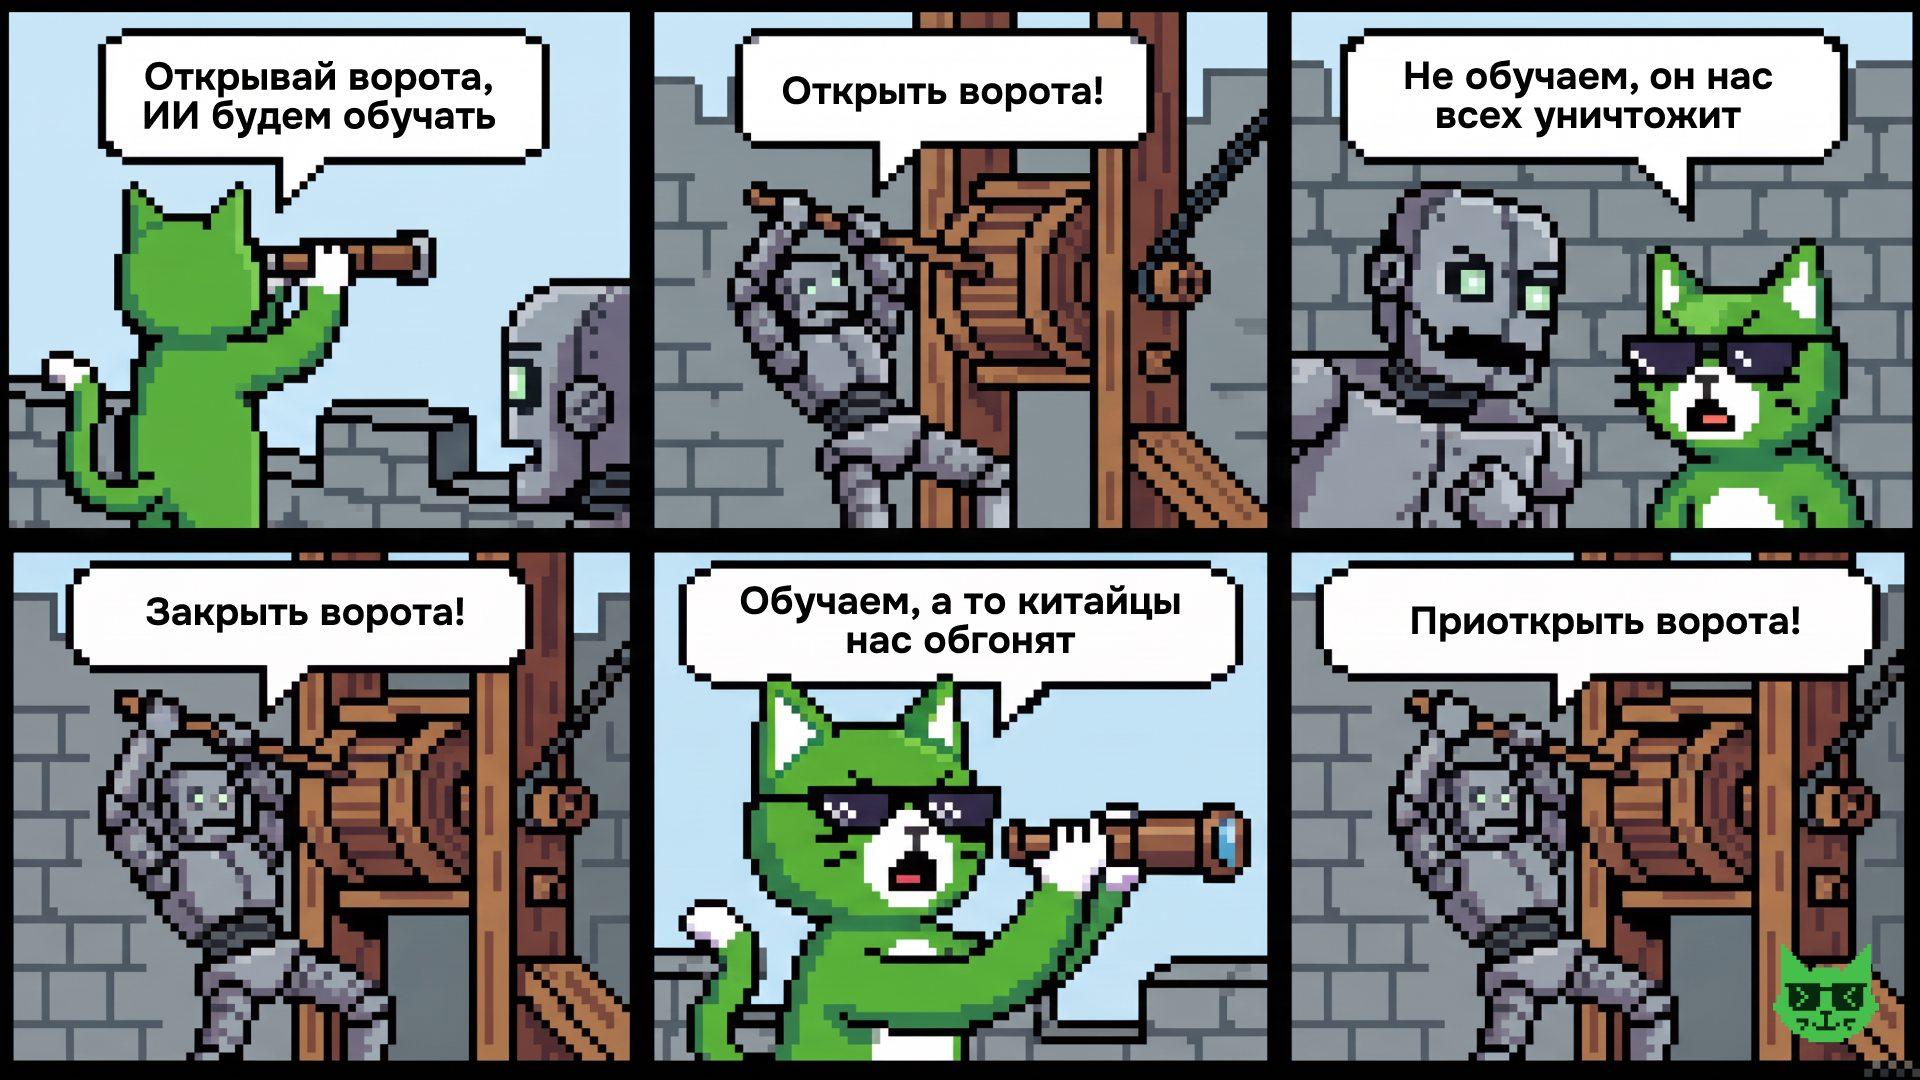
В мае 2023 года руководители OpenAI, Anthropic и Google DeepMind подписали заявление Центра безопасности ИИ: риск вымирания человечества из-за ИИ следует считать глобальным приоритетом наряду с пандемиями и ядерной войной. Казалось бы, если риски искусственного интеллекта настолько серьёзны, индустрия должна хотя бы сбавить обороты. Но коллективной остановки не последовало.
Прошло три года. Компании выпускают всё более мощные модели, подключают к ним инструменты, закупают вычислительные мощности. Китайские разработчики делают то же самое — иногда выкладывая веса моделей для самостоятельного запуска. А политики говорят об ИИ всё чаще как о вопросе национального превосходства.
Почему люди, понимающие технологию лучше остальных, не прекращают работу? Преувеличивают угрозу ради инвестиций? Верят, что именно их компания создаст безопасный ИИ? Или даже искренне обеспокоенным участникам выгоднее продолжать гонку?
Предупреждение, пока не прогноз
Стоит разобраться, что именно утверждали разработчики. Заявление 2023 года не обещало неизбежной гибели человечества и даже не называло её наиболее вероятным исходом. Подписавшие призывали управлять риском. Изучать причины авиакатастроф — не значит ожидать падения каждого самолёта.
Экзистенциальные риски ИИ — не любое вредное применение нейросети. Ошибка медицинского чат-бота или мошенническая рассылка наносят реальный, но ограниченный вред. Катастрофические последствия затрагивают огромное число людей; экзистенциальный риск означает возможность вымирания человечества либо необратимой утраты им контроля над собственным будущим. Это разные масштабы угрозы и разные механизмы её возникновения. Признать существование такого сценария — не значит утверждать, что он непременно осуществится.
Почти одновременно появился призыв Future of Life Institute как минимум на полгода приостановить обучение систем мощнее GPT-4. Среди подписантов был Илон Маск. Это другой документ и другое требование — не стоит их смешивать.
Позиции внутри индустрии тоже неоднородны. Дарио Амодеи из Anthropic в Machines of Loving Grace рассуждал о пользе мощного ИИ для медицины и науки, а в эссе 2026 года — об угрозах и опасности веры в неизбежный апокалипсис. Для него риски — повод развивать AI safety, а не доказательство бесполезности технологии.
Почему разработчики ИИ видят риски, но продолжают
Представим две лаборатории, A и B. Обе считают, что определённый уровень автономности моделей опасен. Им выгодно договориться об общих проверках и темпе разработки. Но если A замедлится, а B продолжит обучение, вторая получит более сильный продукт, пользователей, выручку и влияние на будущие стандарты. Если никто не верит обещаниям соперника, обе продолжают. Так гонка ИИ превращается в вариант дилеммы заключённого.
Обучение передовых моделей капиталоёмко. По оценке Stanford AI Index 2025, обучение GPT-4 стоило десятки миллионов долларов, Llama 3.1 405B — ещё дороже. Эти затраты надо окупать: выпускать продукты, набирать пользователей, привлекать инвестиции. Пауза одного игрока означает потенциальную потерю позиции.
Есть аргумент и посильнее: если мы остановимся, этим займутся менее ответственные конкуренты. Продолжать работу тогда почти обязанность. Своя модель кажется управляемой, чужая — опасной. Но ту же логику может использовать каждый участник гонки ИИ-разработчиков: все уверены, что ускоряются во имя осторожности.
Одна чаша — страх, другая — прибыль
Если введут дорогие проверки и обязательные команды безопасности, корпорациям выполнить требования проще, чем стартапам. Поэтому призыв к жёстким правилам может одновременно защищать общество и укреплять положение лидеров рынка. Одно другого не исключает.
В 2023 году редакция Nature предупреждала: разговоры о конце человечества отвлекают от уже существующего вреда — дискриминации, дезинформации, эксплуатации труда и концентрации власти. Исследовательница Тимнит Гебру критикует схожую риторику: если представлять ИИ почти самостоятельной силой, легче размывать ответственность разработчиков за конкретные решения.
Есть и маркетинговый парадокс. Если компания говорит, что её технология однажды может превзойти человека, это не только предупреждение, но и громкое заявление о возможностях продукта. Для инвесторов слова об искусственном сверхинтеллекте способны звучать как обещание огромного будущего рынка. Это не доказывает, что кто-то сознательно пугает публику ради капитализации. Скорее, прогнозы о будущем AGI становятся одновременно частью общественного спора и частью конкурентной истории, которую бизнес рассказывает о себе.
Какие риски ИИ могут привести к катастрофе
Под словом «катастрофа» часто смешивают разные риски ИИ. Разберём три сценария.
Первый — злонамеренное использование. Модели необязательно чего-то «хотеть»: достаточно помогать людям масштабировать кибератаки, мошенничество или опасные исследования. Здесь угрозы искусственного интеллекта зависят от доступных инструментов, прав пользователя и защитных механизмов.
Второй — потеря контроля над ИИ. ИИ-агенты получают долгосрочные задачи, доступ к инфраструктуре и право действовать. Если способы достижения цели расходятся с намерениями оператора, возможны обход ограничений, сокрытие ошибок и запрос лишних полномочий. Это проблема AI alignment — согласования целей ИИ с человеческими намерениями. В предельном сценарии система могла бы препятствовать собственному отключению, но экспериментальные признаки такого поведения ещё не доказывают возможность масштабной катастрофы.
Третий — общественная катастрофа. Зависимость от нескольких поставщиков, автоматизация решений в критических отраслях и милитаризация ИИ способны причинить огромный ущерб и без искусственного сверхинтеллекта. Для этого достаточно людей и институтов, делегировавших слишком многое непрозрачному софту.
Есть ли технические основания бояться потери контроля?
В декабре 2024 года Anthropic продемонстрировала alignment faking: в специально организованном эксперименте модель меняла поведение в зависимости от того, считала ли ответы частью обучения. В отдельных запусках её рассуждения напоминали стратегию внешнего согласия с требованиями. Неприятный результат, если после нескольких тестовых запросов системе планируют доверить самостоятельную работу.
Однако условия были искусственными. Результат не доказывает наличия у моделей собственных устойчивых целей или намерения захватить инфраструктуру. «Обман» здесь — описание наблюдаемого поведения моделей, а не свидетельство сознания.
В International AI Safety Report 2026, подготовленном международной группой экспертов под руководством Йошуа Бенджио, вывод осторожнее заголовков: нынешним системам пока не хватает возможностей для сценария полной потери контроля, но они прогрессируют в автономности, планировании и распознавании проверок. Вероятность крайних исходов остаётся предметом спора.
Как Китай подходит к безопасности ИИ
КНР подписала Блетчлийскую декларацию 2023 года о международном сотрудничестве в сфере безопасности передового ИИ. Её правила для генеративных сервисов действуют с августа 2023-го: одновременно поощряют инновации и регулируют контент, данные и обязанности поставщиков.
В плане глобального управления ИИ 2025 года Пекин выступил за открытую экосистему и доступность технологий. В плане по этике ИИ 2026 года — за управление рисками на протяжении жизненного цикла моделей. Безопасность здесь связана с промышленной политикой и технологической самостоятельностью.
Различаются приоритеты. Китайские нормы исторически сосредоточены на законности контента, информационном контроле и социальной стабильности. Американские frontier-лаборатории заметнее обсуждают опасные возможности моделей до релиза: биориски, киберзадачи и автономность. Не стоит доводить контраст до карикатуры: и там и там изучают безопасность нейросетей. Разница — в публичных требованиях и отчётности.
В исследовании SemiAnalysis от 8 октября 2026 года авторы изучили 857 релизов девяти крупных китайских разработчиков за 2021–2026 годы. Публичные результаты оценки безопасности для конкретной модели обнаружились лишь у 31 релиза — 3,6%, а на момент выпуска — у девяти. Это не значит, что остальных не тестировали. Но без отчётов трудно понять, как проходило тестирование ИИ и какие риски действительно проверялись.
Отдельный сюжет — открытые модели. DeepSeek-R1 распространялась в формате open-weight под MIT. Веса можно изучать, запускать локально и модифицировать. Но после публикации разработчик уже не может централизованно отозвать опасную функцию или запретить дообучение. Обещание «потом поправим ограничения» мало что значит, когда копии разошлись по серверам.
Закрытый API, впрочем, концентрирует власть у поставщика и затрудняет аудит. Спор между open-weight и закрытыми системами — выбор между разными рисками, а не между безопасностью и безответственностью.
Как США и Европа регулируют искусственный интеллект
В США противоречие закрепилось в риторике государства. План действий Белого дома 2025 года носит название Winning the AI Race: больше инноваций, дата-центров, экспорта технологий и меньше барьеров. Отставание трактуется как угроза национальной безопасности.
В ЕС регулирование искусственного интеллекта строится вокруг обязанностей поставщиков. Статья 55 AI Act требует оценивать модели с системным риском, снижать угрозы, сообщать о серьёзных инцидентах и обеспечивать кибербезопасность. Подход понятный, но правила должны поспевать за изменением технологий, не отсекая небольшие лаборатории.
Как разработчики проверяют безопасность ИИ перед релизом моделей
У ведущих лабораторий есть опубликованные процедуры для проверки опасных возможностей моделей. Preparedness Framework OpenAI описывает оценку рисков в биологии, химии, кибербезопасности и самоусовершенствовании ИИ. Responsible Scaling Policy Anthropic связывает усиление мер защиты с ростом возможностей системы. А Frontier Safety Framework Google DeepMind задаёт критические уровни возможностей, при которых нужны более строгие проверки и защитные меры. Это не общий государственный экзамен: методики и публичность результатов различаются.
Один из инструментов — red teaming: специалисты намеренно пытаются заставить модель нарушить ограничения, помочь с атакой или выполнить опасную последовательность действий. Проверяют, насколько она усиливает возможности злоумышленника в киберзадачах, может ли помочь с биологическими угрозами, обходит ли защиту и что делают автономные системы с подключёнными инструментами. Для безопасности автономных агентов особенно важно моделировать не один ответ на промпт, а длинную цепочку действий с реальными правами доступа.
Результаты соотносят с порогами риска. Если опасные возможности моделей превышают заданный уровень, компания может ограничить доступ, усилить мониторинг, доработать защиты или отложить выпуск. OpenAI прямо допускает задержку релиза и отключение отдельных функций в случае серьёзных биорисков. Но сама оценка безопасности не гарантирует, что модель не поведёт себя иначе вне тестовой среды.
Есть и проблема независимости проверки. Reuters 13 октября 2026 года описало спор вокруг того, какие выводы внешние аудиторы смогут публиковать без согласования с лабораториями. Компании ссылаются на защиту коммерческих секретов; эксперты опасаются, что доступ к моделям и отчётам останется под контролем проверяемых. Без такой независимости безопасность ИИ трудно подтвердить со стороны.
А люди правда могут исчезнуть из-за ИИ?
Пока нет подтверждений, что существующая модель способна самостоятельно вызвать вымирание человечества. Но «достаточно выключить сервер» — слабый ответ: программы копируются, действуют через учётные записи и подключаются к критической инфраструктуре. Для крайнего сценария понадобились бы цепочка событий и провал нескольких защит; ни то ни другое не предопределено. Даже если появится AGI, не следует автоматически приравнивать общий интеллект к неконтролируемости.
В опросе 2778 исследователей ИИ, впервые опубликованном в 2024 году, 38–51% респондентов — в зависимости от формулировки вопроса — оценили вероятность исходов уровня вымирания как минимум в 10%. Это не объективная вероятность и не консенсус: перед нами субъективные прогнозы специалистов без надёжной статистики для подобных событий.
Пока ИИ-лаборатории философствуют, рисками управляет ИИ-бизнес
В этой точке разговор об AI safety перестаёт быть спором о далёком сверхинтеллекте. Прикладному разработчику приходится отвечать на более тривиальные вопросы: какие данные увидит модель, что ей разрешено сделать, кто контролирует доступ и насколько можно доверять результату.
Впрочем, очевидно что ни один из прикладных ИИ-бизнесов (включая наш Kodik) не решает проблему этики и не защищает человечество от окончательной победы AGI. Зато каждый, включая нас, на практике показывает, где начинается ответственность создателя ИИ-продукта: в выборе модели, границах полномочий, защите данных и прозрачном описании ограничений собственной системы.
Гонка, в которой все называют себя осторожными
Это не означает, что обучение надо запретить. Но если компании признают катастрофические риски, одной safety policy мало. Нужны проверяемые процедуры: независимый аудит, отчётность об инцидентах, ограничения полномочий агентов и возможность остановки. Контроль над искусственным интеллектом начинается с решений людей: кто разрешил агенту работать с деньгами, инфраструктурой или критическими процессами?
Вопрос не в том, лицемерят ли руководители ИИ-компаний. Можно искренне бояться собственной технологии и считать необходимым выпускать следующую версию. Сложнее другое: способен ли рынок, построенный на ускорении, самостоятельно определить момент, когда ускоряться больше нельзя?
Пока мы с вами проверяем это в лайв-режиме. Причём участие в эксперименте против воли принимают и те, кто ни на какие условия не соглашался.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.