Эпизод 2. Подсмотрено у мозга: предсказание, азбука, план
Продолжаем решать интересную RL-задачу: агент должен сам научиться играть в Atari Frostbite по сырым видеокадрам, чтобы набрать 136k+ очков и одолеть SOTA модель MEME-200 [4]. Меня зовут Михаил Кочеров. Я занимаюсь этой задачей, потому что по ходу её решения можно лучше понять, как работает наш мозг. Как будто сама природа подкидывает проблемы и намекает на пути их решения, шепча “Загляни в себя, там все ответы”. Разобраться в работе нашего мозга — мой идефикс.
Во Frostbite нужно управлять эскимосом, собирать иглу, прыгая по льдинам, уворачиваться от врагов, тикает таймер замерзания. Для перехода на новый уровень эскимос должен зайти в собранный иглу. Игра непростая, в среднем после 2-х часов игры новичок набирает около 4 тысяч очков [5], это 2-3 пройденных уровня.
В прошлом эпизоде мы собрали простого агента на базе CNN и трансформера. Агент владеет базовыми механиками игры, набирает 779 очков, но не проходит даже первый уровень. При этом улучшения от дальнейших тренировок нет. Очевидно, что агент нащупал локальный минимум и застрял в нём. Его надо как-то вытолкнуть оттуда.
Предсказание будущего
Брейншторм с Джемини привёл к мысли, что для начала агенту надо сформировать в своём мозгу понятия, критичные для выполнения задачи. У него должны появиться, например, представления о состоянии иглу, наличия двери и т.д. Для этого заставим агента предсказывать будущее. Так делает и наш конкурент - модель DreamerV3 [3].
Логика следующая. Чтобы предсказывать будущее, нужно понимать физику происходящих процессов. Если я выроню чашку из руки, то она упадёт на пол и разобьётся. Тут есть модель: объекты, их отношения между собой, физика того, как всё это во времени развивается. Чтобы агент мог предсказать следующий кадр (будущее), он вынужден будет выработать внутренние понятия для объектов на сцене и то, как они взаимодействуют друг с другом. Что-то вроде внутреннего, скрытого языка. Чем дальше горизонт предсказания, тем мощнее и абстрактнее должен быть этот язык.
Машины предсказания
По большому счёту жизнь представляет собой среду обучения без учителя. Чтобы выжить и преуспеть в ней, человек с первых мгновений жизни начинает выстраивать модели, которые позволяют ему предвидеть будущее. И потом оттачивает эти модели до конца дней. Начинается всё с усвоения базовых физических законов (пример с чашкой) и далее всё к более абстрактным темам (философии, теология, космогония и т.д.). Это не метафора. В 1999 году Рао и Баллард в работе о predictive coding [6] показали, как это реализуется в зрительной коре мозга: вышестоящие уровни постоянно предсказывают активацию нижестоящих, а нижестоящие сообщают только ошибку расхождения.
Ошибка в предсказании не проблема. Она является важным триггером, который заставляет людей корректировать модели и узнавать что-то новое (что-то пошло не так, я должен выяснить почему). В награду получаем порцию дофамина - нейромедиатора, который кодирует ошибку предсказания награды [7]. Если предсказания работают безупречно, нам становится скучно. Поэтому вечная жизнь была бы смертельной мукой!
Можно сказать, что мы, люди — биологические машины предсказания, получающие кайф от узнавания нового.
Технически предсказание следующего кадра можно организовать так. На ходе T+0 на вход агенту поступают 4 кадра. Агент их переводит в 4 вектора скрытых состояний (латентов). Заставляем его ещё дополнительно формировать новый латент next_ob_latent и будем сопоставлять его с настоящим латентом кадра из следующего хода T+1. В начале next_ob_latent будет простым мусором, и штраф за несовпадение тоже будет большим. Но затем агент научится уменьшать этот штраф, и next_ob_latent станет близок к настоящему латенту следующего хода!
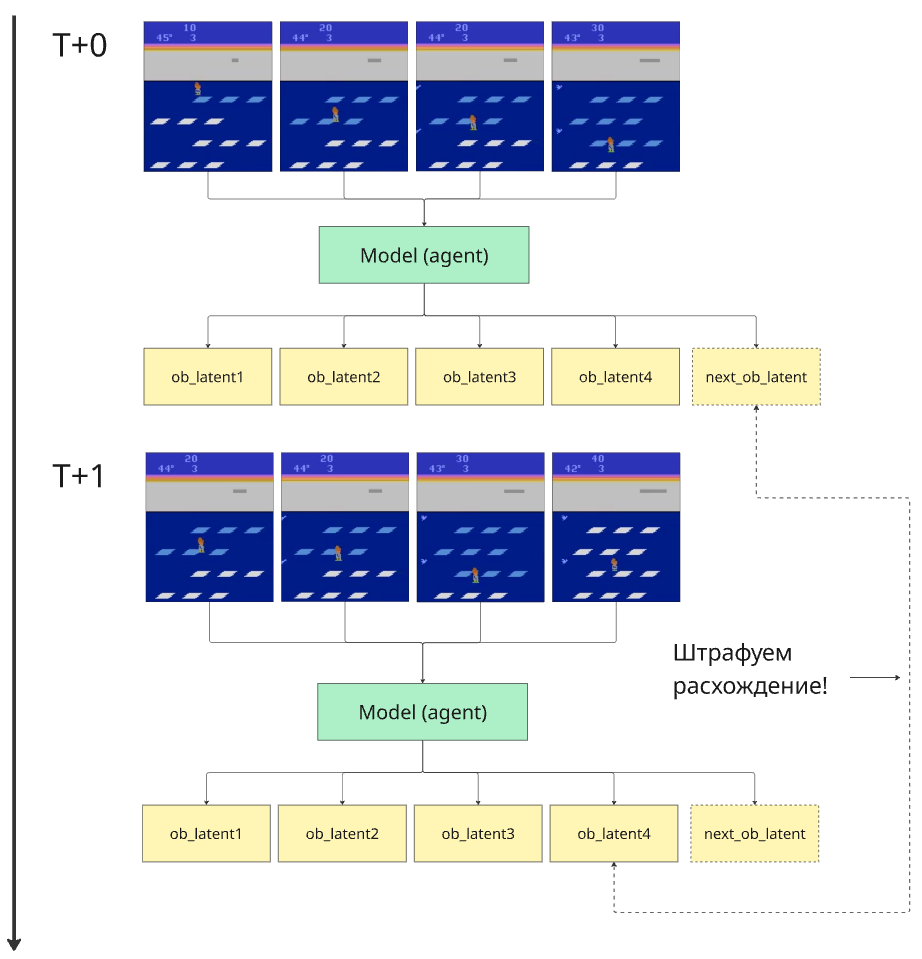
Собираем ноутбук 17e_ppo_tr_atari_mp_03 с логикой предсказания. Добавляем к общей функции потерь PPO новый предсказательный лосс prediction_loss.
# Combined losses
loss = pg_loss - ent_coef * entropy_loss + HP.ppo.vf_coef * v_loss

if HP.ppo.prediction_coef > 0.0:
    next_obs_emb = LS.agent.get_obs_emb(batch.next_obs.unsqueeze(1)).detach().squeeze(1)
    prediction_loss = F.mse_loss(agent_output.next_obs_emb, next_obs_emb)
    loss += HP.ppo.prediction_coef * prediction_loss
Делаем несколько запусков и видим, что чуда не произошло. На первой части траектории вроде было преимущество, но к концу оно растерялось. Агент вообще набрал меньше прежнего 697 vs 779 очков.
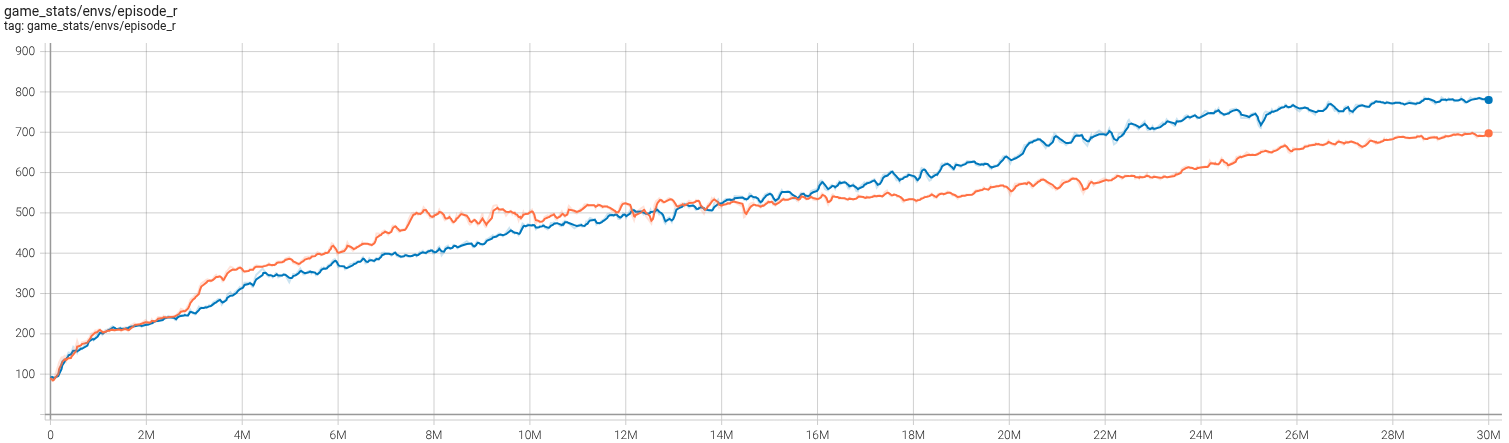
Ну и, разумеется, агент по-прежнему первый уровень не проходит. В принципе это было ожидаемо, так как предсказание будущего — это необходимое, но недостаточное условие для прорыва. Предсказание строит понятия (что такое иглу, дверь), но не повышает вероятность редкого события “зайти в дверь”. Поэтому критично каким-то образом повысить вероятность это события.
Азбучные истины
Когда человек начинает играть во Frostbite, то он сразу понимает, что нужно строить иглу и потом зайти в дверь. Это априорное знание. Потом человек очень быстро осваивается с конкретными механиками и идёт вперёд. Но это априорное знание не данность, его нет у человека при рождении. Человек на протяжении многих лет растёт, воспитывается и обучается. А так как среда у всех нас более менее одинаковая, то и общих знаний у нас много. Мы все с ходу понимаем, что иглу — это дом, дом — это хорошо, надо туда стремиться.
Если копнуть глубже, то можно увидеть, что всё обучение человека устроено примерно по одному лекалу. Создаются определённые условия, при которых нарабатываются полезные модели об окружающей действительности и максимизируются вероятности выбора конкретных линий поведения. Т.е. условия среды как бы неявно задают траекторию, по которой человек проходит самостоятельно и по ходу “майнит” знания. Родители ограждают малолетнего ребёнка от явных опасностей и создают условия для исследования базовых свойств окружающего мира. Школа через уроки и повторения протягивают учеников по отточенным траекториям — человек научается читать, писать, считать и т.д. В универе человек решает исследовательские и практические задачи, в ходе которых сами собой набираются профессиональные навыки и знания.
Лев Николаевич подтверждает
“Знание только тогда знание, когда оно приобретено усилиями своей мысли, а не памятью”. Л. Н. Толстой, “Круг чтения”
Ок. Следуя этой идее, мы хотим создать агенту такие тепличные условия, при которых требуемое поведение агента возникнет и закрепится с большой долей вероятности. В принципе для компьютерных игр это пустяк — знай, делай себе save/load в нужном состоянии. Полагаю, что без этой функции мало кто бы проходил длинные и сложные игры =)
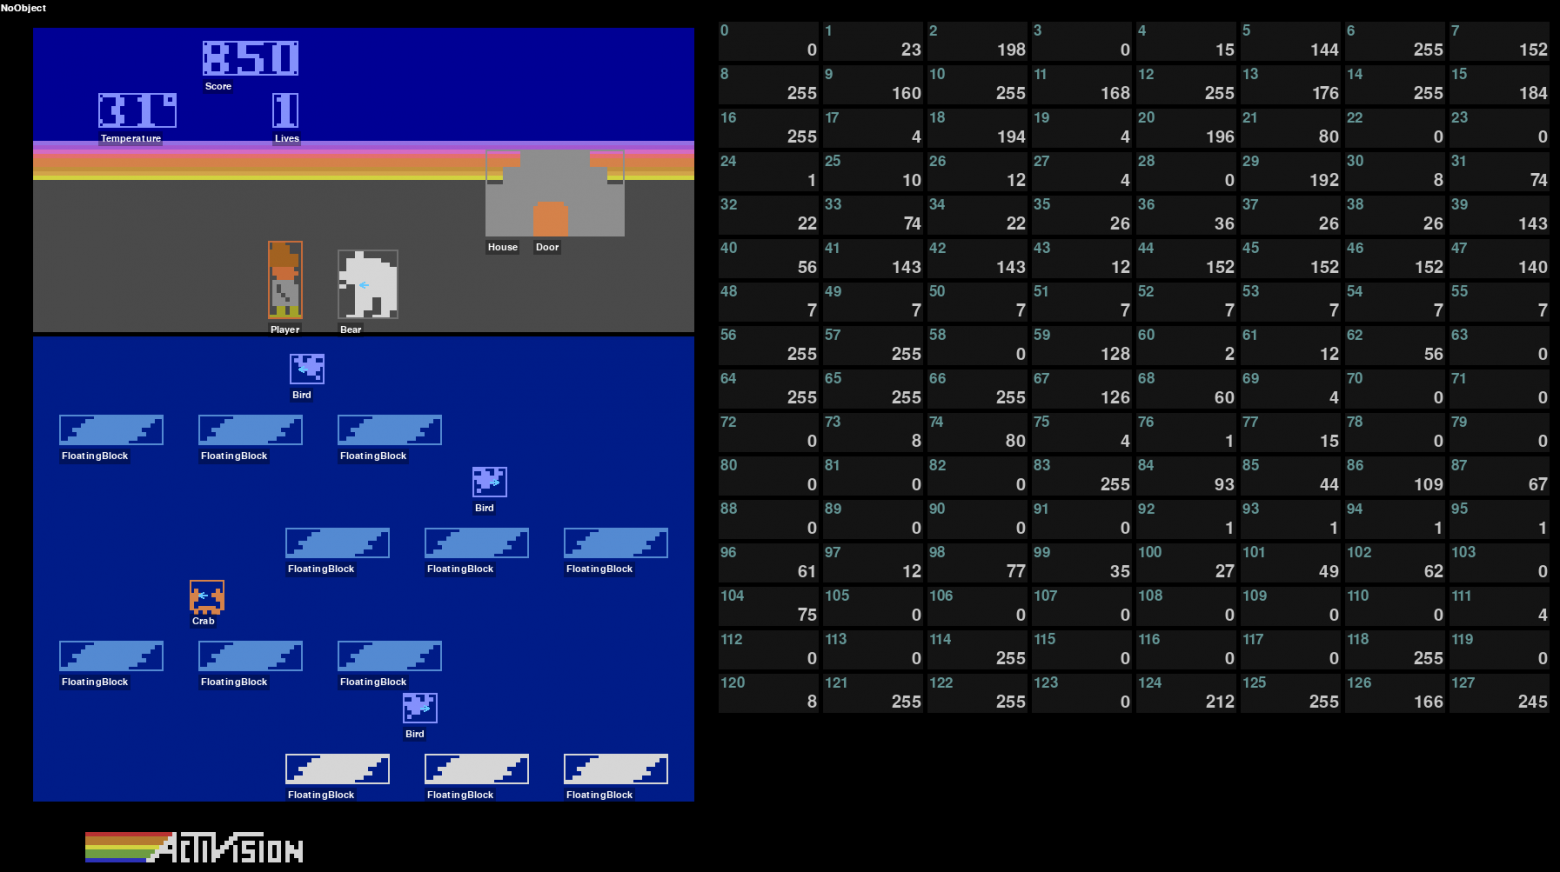
Проблема только в том, что используемый эмулятор Atari — Atari Learning Environment (ALE) — не имеет функции save/load из коробки. Изучение вопроса быстро приводит к проекту HackAtari [2] (https://github.com/k4ntz/HackAtari). В HackAtari можно напрямую работать с RAM эмулятора, чтобы создавать разные модификаторы игры. Например, можно сделать модификатор, который убирает гусей с экрана, или модификатор, который запускает игру с уже собранной иглу. Ребята даже сделали удобный GUI для этого.
128 байт RAM и латентный вектор
Для исчерпывающего описания того, что происходит в Frostbite достаточно всего 128 байт. Более того, не все ячейки памяти используются. Так или иначе номинально это даёт
возможных состояний или точек в 128-мерном пространстве. Но 99,999…% всех возможных точек невалидны, их вероятность равна 0. Т.е. у нас крайне разреженное пространство состояний. И вся игра — это переход между валидными точками. Прямо как звёзды в космосе. Забавно!
При этом размерность латентного вектора агента изначально была равна 384 float32. Получается, что мы сильно перестраховались, т.к. даже просто по количеству бит это x12, чем весь RAM эмулятора. Значит, можно смело снизить, например, до 256 (консервативно). Это ускорит обучение модели и снизит потребление памяти.
Но тут другая засада в скорости. Нативный ALE поддерживает параллелизацию батареи окружений через потоки (AtariVectorEnv), что позволяет использовать один GPU сразу для расчёта нескольких окружений и сбора траекторий из них. Когда окружений несколько десятков, выигрыш в скорости получается в разы. А вот параллелизация в HackAtari работает на уровне процессов (обычный питоновский multiprocessing под капотом AsyncVectorEnv), который сразу убивает выигрыш от использования GPU.
Короче, чтобы получить лучшее из двух миров, засучиваем рукава, форкаем ALE и портируем логику работы с модификаторами из HackAtari с питона на плюсы (https://github.com/kocherovms/Arcade-Learning-Environment/tree/de97778abdd51e0638f5992e7323933b30a2734f). Теперь у нас есть быстрое окружение с нужными модификаторами.
модификатор | что делает |
|---|---|
full_igloo | иглу полностью собран, дверь доступна |
one_remaining_igloo | остался последний кирпичик для сборки иглу |
three_remaining_igloo | не хватает 3-х кирпичиков для сборки иглу |
half_igloo | иглу собран наполовину |
bailey_right_at_the_igloo_door | эскимос стоит в створе двери |
bailey_very_near_igloo_door | эскимос рядом с дверью (рандом) |
bailey_near_igloo_door | эскимос недалеко от двери (рандом) |
bailey_near_center | эскимос в центре побережья (рандом) |
no_birds | нет летающих врагов (гусей) |
ice_inactive | все льдинки собраны |
С этими модификаторами можно создать условия, когда и иглу собрана, и агент стоит на берегу. Даже случайным блужданием агент должен нащупать, что нужно просто зайти в дверь, получить за эту награду и закрепить у себя в памяти такой крутой опыт!
А не читинг ли это?
Формально нет. Читингом было бы использование RAM напрямую. В нашем же сценарии агент по-прежнему видит сырые видеокадры и учится от них. Тут скорее речь идёт про curriculum или план обучения, который ускоряет целевой процесс.
Другое дело, что такой curriculum привязан к конкретной игре, и поэтому не масштабируется, что не есть хорошо. Но надо с чего-то начинать. Как говорится, сначала сделай, чтобы это работало, потом, чтобы быстро, ну и в конце, чтобы было красиво и универсально!
Собираем ноутбук 17e_ppo_tr_atari_mp_07, делаем несколько прогонов и получаем интересную пищу для размышлений.
Даже при уже готовом домике агент не соображает, что нужно в него идти, а продолжает прыгать по льдинам. Однако, когда агент стоит в створе двери, то он моментально забирается в иглу. Выходит, что он выучил, что такое собранный иглу и как в него заходить, но не понимает, как построить маршрут до иглу.
Можно, конечно, поиграться начальными условиями, попробовать разные положения агента, но это не масштабируется. Кажется, что агенту нужно добавить…
Горизонт планирования
Если задуматься о том, как сам играешь во Frostbite, то легко заметить, что мыслишь иерархически. Цели складываются как матрёшка друг в друга, от наиболее абстрактной к конкретной. На самом верху цель набрать как можно больше очков. Следовательно, надо пройти как можно больше уровней. Чтобы пройти уровень, надо зайти в иглу. Чтобы зайти в иглу, надо его собрать. Чтобы собрать, надо пропрыгать по льдинам в определённом порядке. Чтобы этот порядок выполнить, надо пройтись по конкретным точкам. Находясь в конкретной точке, надо увернуться от врага и сделать прыжок в нужную сторону. И так далее.
Агент же в текущей реализации действует реактивно, на рефлексах. У него нет замысла. Через каждые 4 кадра он как бы просыпается и выдаёт “Надо нажать такую-то кнопку”. Следующие 4 кадра — всё как с чистого листа (агент stateless). Связанности между действиями никакой, и если бы не плавное изменение сцены, то агент вдобавок к неспособности задумать и исполнить длинный сценарий ещё бы и дёргался очень сильно.
Есть целое направление Hierarchical Reinforcement Learning [1]: многоуровневое планирование там строят через иерархию навыков и подзадач, вдохновляясь тем, как решения на разных временных масштабах принимаем мы сами. Классический пример Feudal Networks [8]: «менеджер» задаёт цели, «воркер» их исполняет. Сложностей в реализации там добавляется будь здоров, и при этом ещё агент часто становится stateful (появляются рекурентные запчасти типа ячеек GRU или LSTM). А это сразу сильно замедляет и так небыстрое обучение. Поэтому хочется чего-то более лайтового, и чтобы агент оставался stateless.
На ум приходит следующая мысль. А что если заставить агента думать не одним действием, а чтобы он сразу выдавал план или цепочку действий? Например, 10 действий. Это где-то на полсекунды игрового времени, хватит, чтобы дотопать до иглу по берегу. План действий — это ещё не иерархическое мышление, но уже хотя бы и не рефлексивное. Чтобы оперировать цепочками агент будет вынужден планировать действия наперёд.
Два способа реализации плана действий.
N | способ | суть |
|---|---|---|
1 | план действий = обязаловка (commit) | агент слепо исполняет задуманный план, как будто закрывает глаза и действует по скрипту. Сильно ускорится раскатка (rollout), т.к. агента не надо дёргать на каждый шаг. Но если план очень длинный и сцена изменилась, то это может обернуться катастрофой |
2 | план действий = временная согласованность (temporal consistency) | агент по-прежнему принимает решение на каждом шаге среды, но мы требуем, чтобы его новые действия были согласованы с тем, что он хотел сделать несколько шагов назад. Требование мягкое — передумать не запрещается, но штрафуется |
Оба варианта рабочие. Я долго выбирал между двумя и остановился на втором. Главная причина — sample efficiency. Когда план есть обязаловка, то на порядок уменьшается объем данных для обучения. Вместо 10 шагов, на которых агент принимает решение и обучается, остаётся только один. Пришлось бы собирать больше данных, что растянуло бы обучение. При варианте с временной согласованностью мы не жертвуем собранными данными, т.к. решение всё равно принимается на каждом шагу.
Схема реализации плана действий с временной согласованностью несложная и выглядит так.
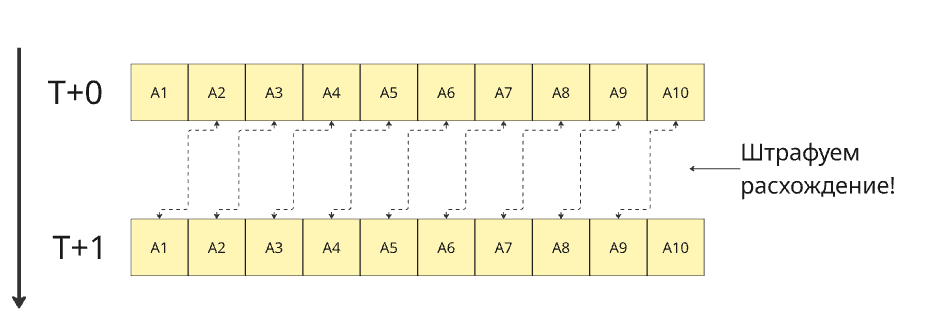
В PyTorch коде тоже всё незамысловато, просто расширяем общую функцию потерь PPO.
if is_temporal_action_plan_consistency_loss:
    # Take action plans of running only records and compare to next - demand that they should not drift far from each other
    b_running = ~b_dones.bool()
    temporal_action_plan_consistency_loss = F.mse_loss(new_action_plan_logits[b_running,1:], b_next_action_plan_logits[b_running,:-1])
...
# Combined losses
loss = (
    pg_loss
    + (HP.ppo.vf_coef * v_loss)
    + (HP.ppo.consistency_coef * temporal_action_plan_consistency_loss)
    + (HP.ppo.prediction_coef * prediction_loss)
    - (ent_coef * entropy_loss)
)
Как агент сможет удовлетворить требование согласованности на смежных шагах, если решение на каждом шаге принимается независимо, и между шагами никакая информация не передаётся (агент stateless)? Единственный способ — это выработать внутреннюю библиотеку типовых планов действий и связывать их с тем, что происходит на сцене. Что-то типа маппинга “состояние игры -> план действий”. Но это будет динамическая библиотека, которую агент сам ведёт и развивает без вмешательства извне. Отличный план!
Собираем ноутбук 17e_ppo_tr_atari_mp_10, запускаем, и … вот она первая победа! Агент сам прошёл и не один, а сразу два уровня! На табло 3500 очков, почти пятикратный рост по сравнению с достижением из первого эпизода (779 очков).
Честная оговорка
Справедливости ради надо отметить, что это лучший прогон из нескольких. Т.е. к стабильности и воспроизводимости есть вопросы, но это уже дело техники.
Не менее важным самой победы было выяснение - какая из запчастей обеспечивает результат? Абляционные эксперименты (отключение/включение в разных комбинациях PredictionHead, планов действий, curriculum) показали, что агент научается только, когда все три запчасти работают вместе. Т.е. важна синергия!
Выводы
В этом эпизоде случился качественный скачок. Агент смог преодолеть локальный минимум и понял, что нужно делать для наколачивания тысяч очков. Преодолеть застой помогли приёмы, подсмотренные у природы и собственного мозга. Но сработали они только в связке.
Биологический фактор | Как сделано в агенте | Что даёт |
|---|---|---|
мозг постоянно предсказывает будущее | отдельный | агент вырабатывает внутренний понятийный аппарат для описания явлений, критичных для решения задачи |
организм быстрее обучается при благоприятствующих условиях среды (scaffolding) | функция save/load для создания тепличных условий (азбука) | резко повышается вероятность обнаружения ходов, ведущих к большой награде |
мозг реализует иерархическое мышление и планирование | агент думает цепочкой действий | вырабатывается библиотека составных и стабильных реакций на конкретные условия, агент “не переобувается” каждые несколько миллисекунд |
Применительно к количественной цели набрать 136k+ очков мы продвинулись хорошо так вправо. Приятно, что количество параметров уменьшилось до 3,4 млн из-за снижения латентного пространства модели с 384 до 256.
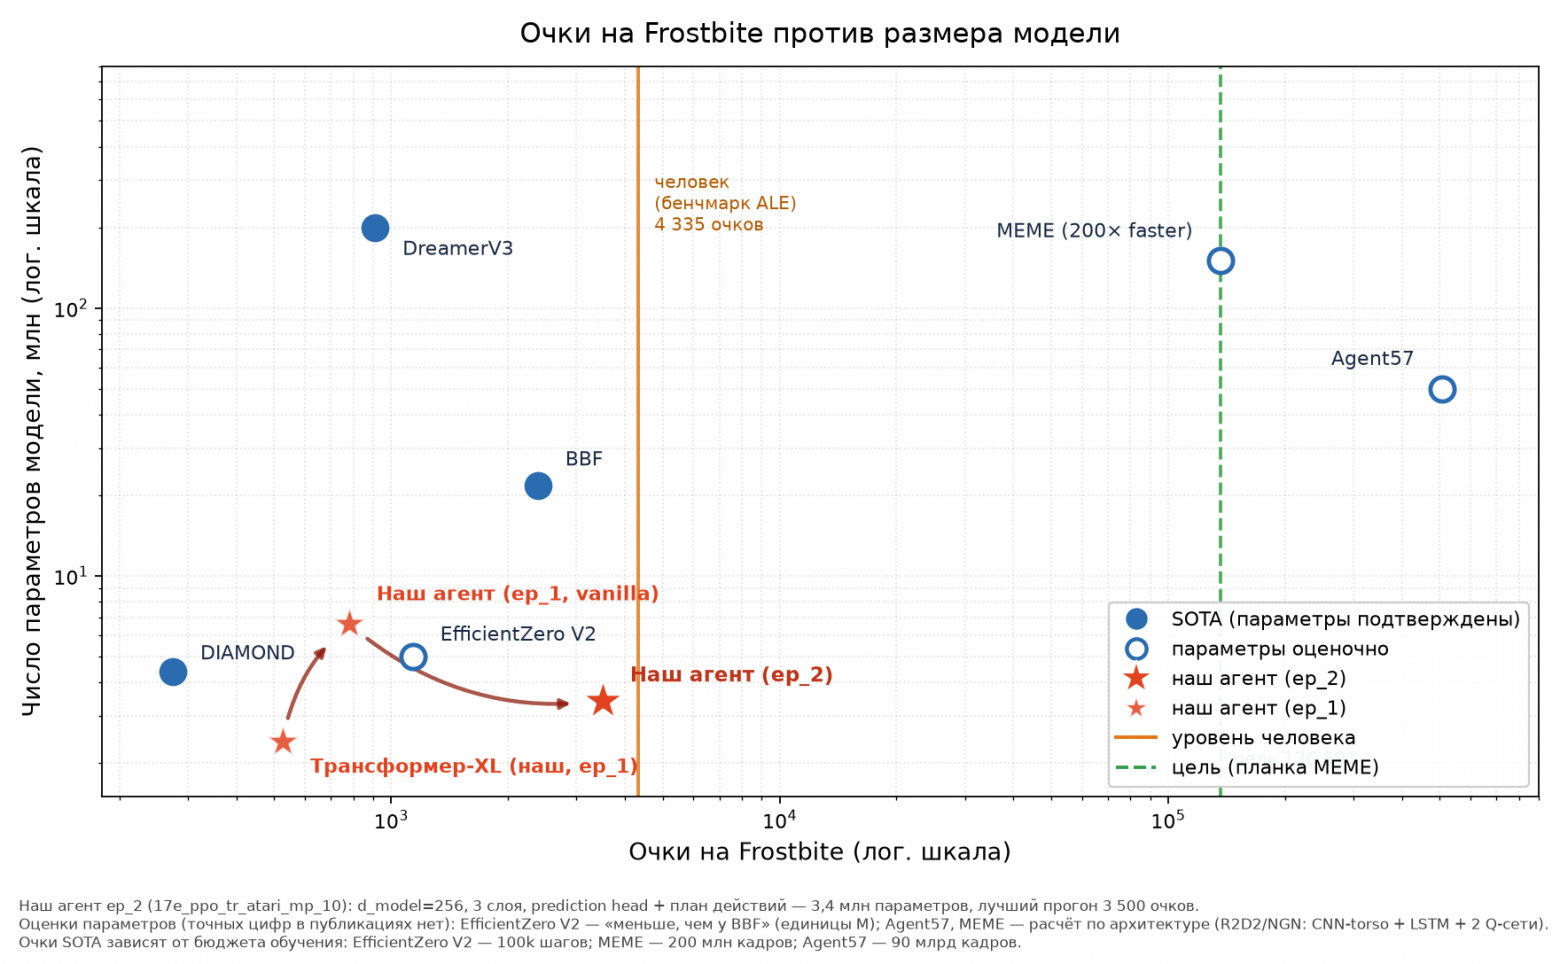
Следующим большим вызовом является прохождение 5-и уровней. На 5-ом уровне наступает полярная ночь, и палитра игры резко меняется, а по берегу носится злой медведь. Уровень будет сильно непохожим на предыдущие. Короче, агенту есть ещё чему поучиться!
Эпизод №1: https://habr.com/ru/articles/1100960/
Github: https://github.com/kocherovms/neurolab
Технические заметки: https://kocherovms.github.io/
Литература
Dayan P., Hinton G. E. Feudal Reinforcement Learning. — NIPS 5:271–278, 1993. papers.nips.cc/paper/1992/hash/d14220ee66aeec73c49038385428ec4c-Abstract.html
Delfosse Q., Blüml J., Gregori B., Kersting K. HackAtari: Atari Learning Environments for Robust and Continual Reinforcement Learning. — arXiv:2406.03997, 2024. arxiv.org/abs/2406.03997
Hafner D., Pasukonis J., Ba J., Lillicrap T. Mastering diverse control tasks through world models (DreamerV3). — Nature 640:647–653, 2025. arxiv.org/abs/2301.04104
Kapturowski S., Campos V., Jiang R., Rakićević N., van Hasselt H., Blundell C., Puigdomènech Badia A. Human-level Atari 200x faster (MEME). — arXiv:2209.07550, 2022. arxiv.org/abs/2209.07550
Machado M. C., Bellemare M. G., Talvitie E., Veness J., Hausknecht M., Bowling M. Revisiting the Arcade Learning Environment: Evaluation Protocols and Open Problems for General Agents. — JAIR 61:523–562, 2018. arxiv.org/abs/1709.06009
Rao R. P. N., Ballard D. H. Predictive coding in the visual cortex: a functional interpretation of some extra-classical receptive-field effects. — Nature Neuroscience 2(1):79–87, 1999. doi.org/10.1038/4580
Schultz W., Dayan P., Montague P. R. A neural substrate of prediction and reward. — Science 275:1593–1599, 1997. doi.org/10.1126/science.275.5306.1593
Vezhnevets A. S., Osindero S., Schaul T., Heess N., Jaderberg M., Silver D., Kavukcuoglu K. FeUdal Networks for Hierarchical Reinforcement Learning. — ICML 2017, PMLR 70:3540–3549. arxiv.org/abs/1703.01161
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.