У нас есть Claude дома — заметка о том, как я делал быстрый и дешёвый локальный LLM
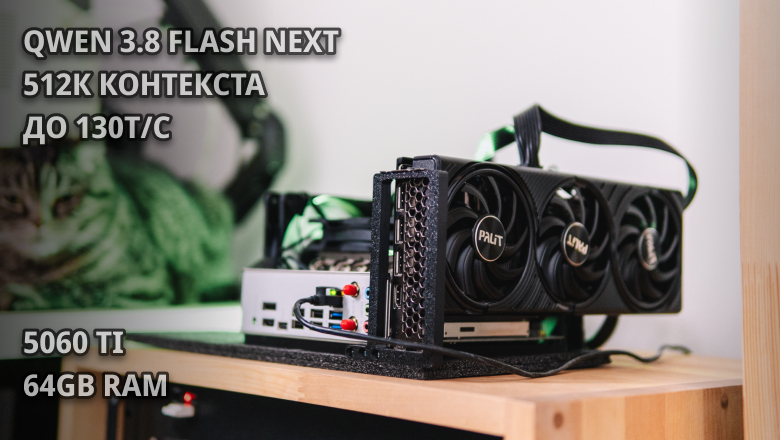
Берём видеокарту RTX 5060 Ti 16 ГБ, 64 ГБ быстрой DDR5 памяти, запускаем небольшую Qwen3.8 27B Q3 во всю vram, с околонулевым контекстом, получаем неплохую скорость, пишем сапёр/змейку — и оно работает. А дальше подключаем OpenCode, грузим реальный проект и получаем постоянное compacting, уход непонятно в какие дебри, так как она потеряла контекст. Бросаем и забываем эти ваши локальные LLM как страшный сон. Знакомо?
Так выглядит типичный путь тех, кто решил поднять текстовую нейросеть дома. Всё, что не влезает в 16 ГБ видеопамяти, обычно выгружают слоями в оперативку, и скорость падает до дна. А вместе с ней и весь смысл затеи.
Но недавно появился Strata. Это движок под архитектуру Qwen3.8-Flash-Next и следующего Qwen4. Он не гоняет слои туда-сюда, самые востребованные эксперты лежат в видеопамяти, остальные в RAM, а большая справочная таблица — на SSD. Благодаря этому модель на 50+ ГБ работает на обычном игровом ПК с контекстом до 512K, который для работы с кодом ой как нужен. В статье кратко покажу, как запустить её на 16 ГБ VRAM + 64 ГБ RAM, подключить OpenCode и что получается на реальных проектах.
Старое не значит доброе
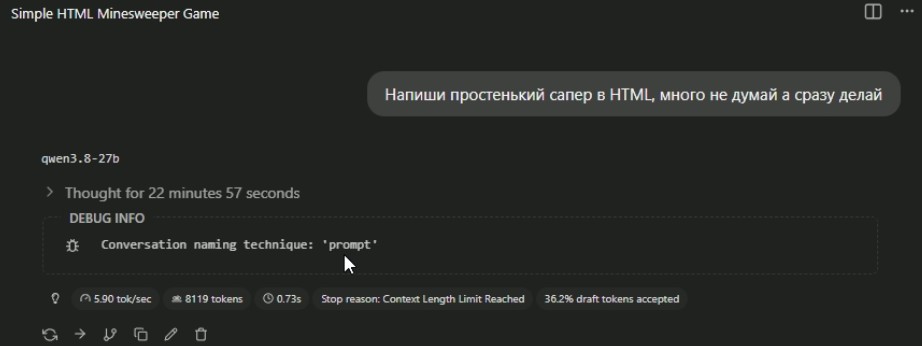
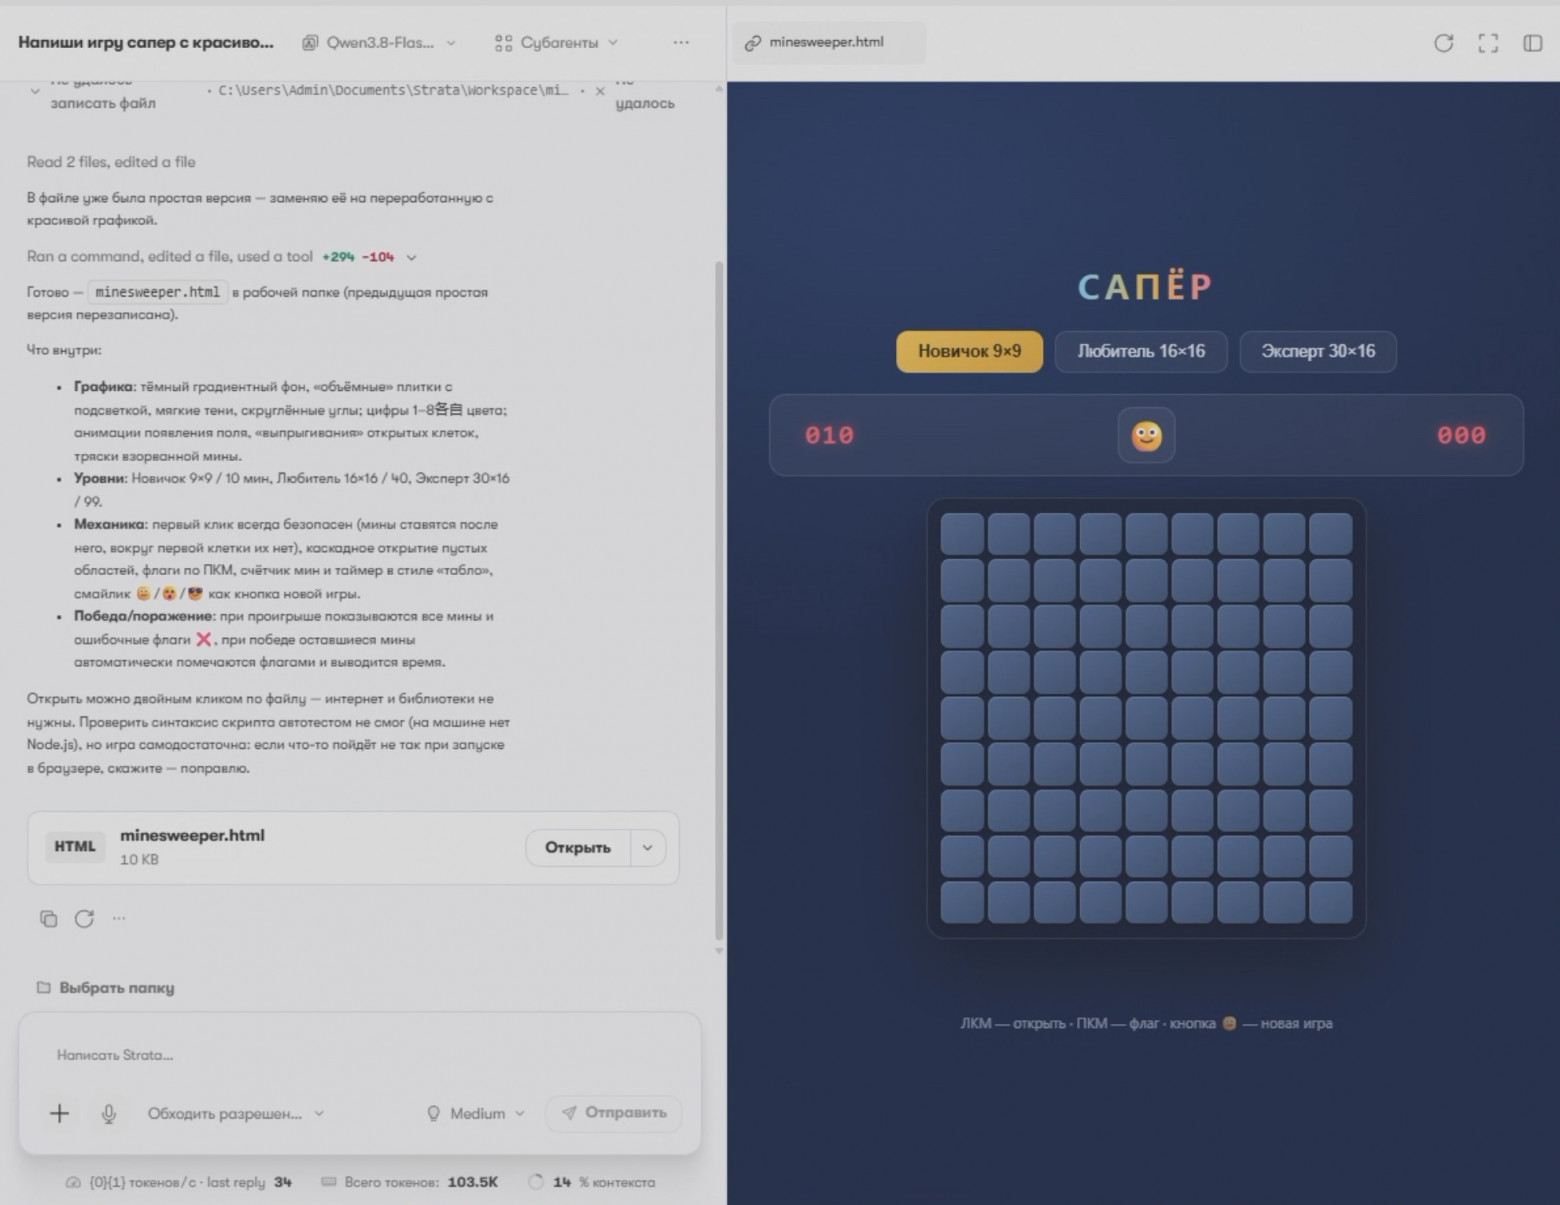
Дабы иметь базу для сравнения, по старинке запустим Qwen3.8-27B (Q3_K_XL) c 8к контекста (больше в VRAM с этой моделью просто не лезет) в том же LM Studio и попросим написать сапёр. Запускаем работу, получаем 5–8 токенов/сек, а спустя 23 минуты — ошибку, ведь нашей LLM не хватило контекста, чтобы всё продумать и написать код.
Хотя сама модель умная, пользоваться этим всем просто невозможно. Выгрузка части весов из VRAM даст больше контекста, но скорость упадёт до таких значений, что без слез не взглянешь.
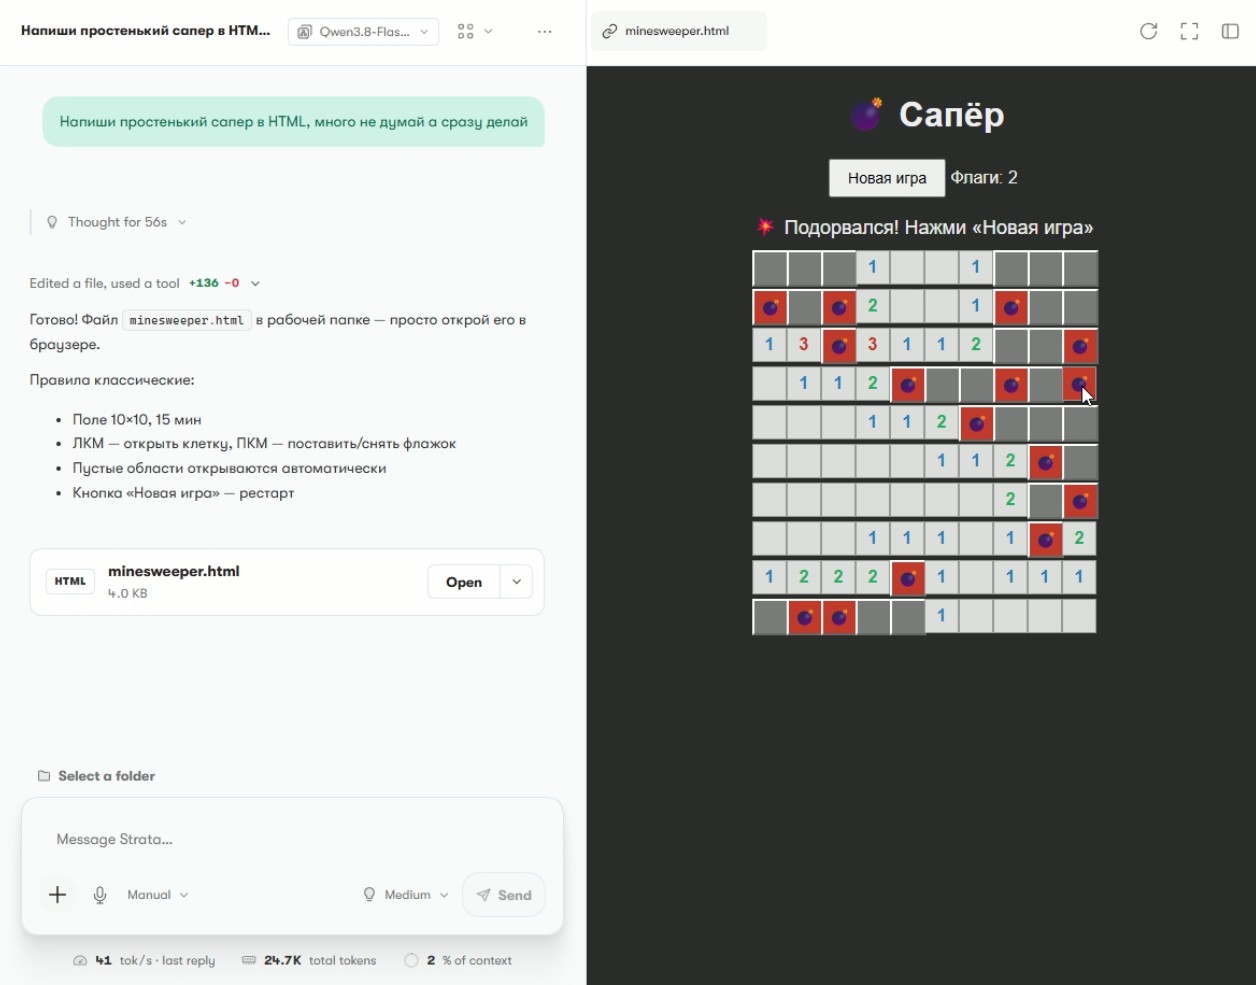
Чтобы далеко не ходить, я запускаю Strata с моделькой Qwen3.8-Flash-Next (IQ3_S) с огромным контекстом 512к, и стартую тот же самый промпт, прямо там в чате Strata.
И тут на всё ушло 56 секунд и 24,7к контекста. Скорость была от 70 до 35 токенов/сек. Но главное — игра работает!
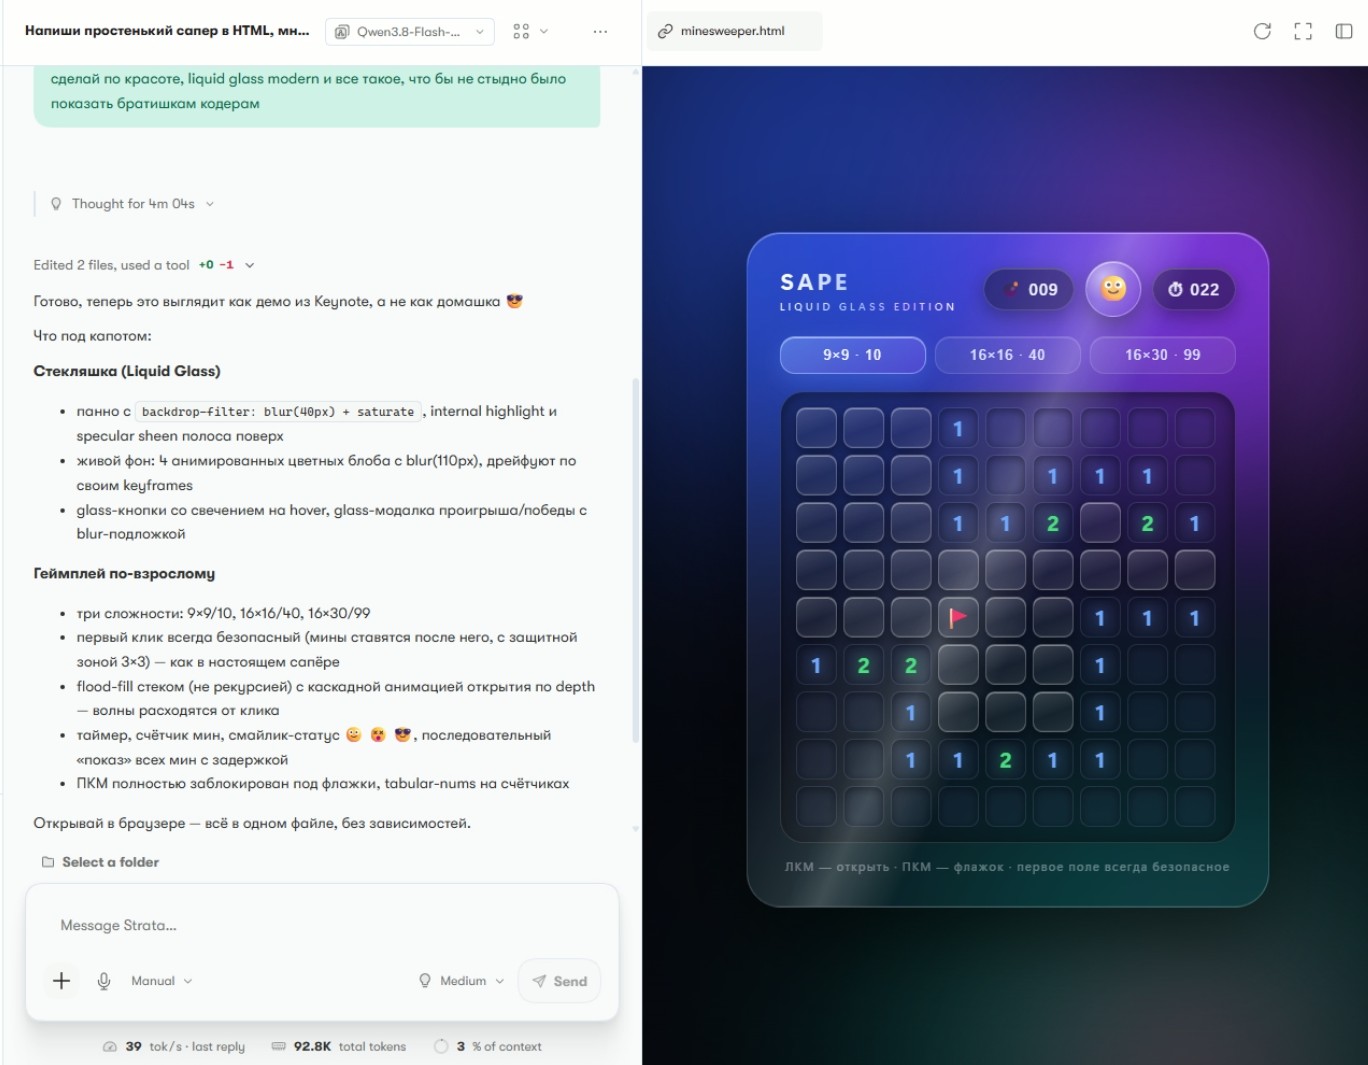
Раз всё работает, то можно попросить навести красоту. Ждём несколько минут и получаем прекрасно выглядящий и полностью рабочий сапёр. Лет 10 назад такое можно было бы зарелизить на смартфоны и успешно получать неплохие деньги.
Ну и ради веселья ещё бильярд сделал. Первый запрос для получения рабочего прототипа, а второй — для наведения красоты.
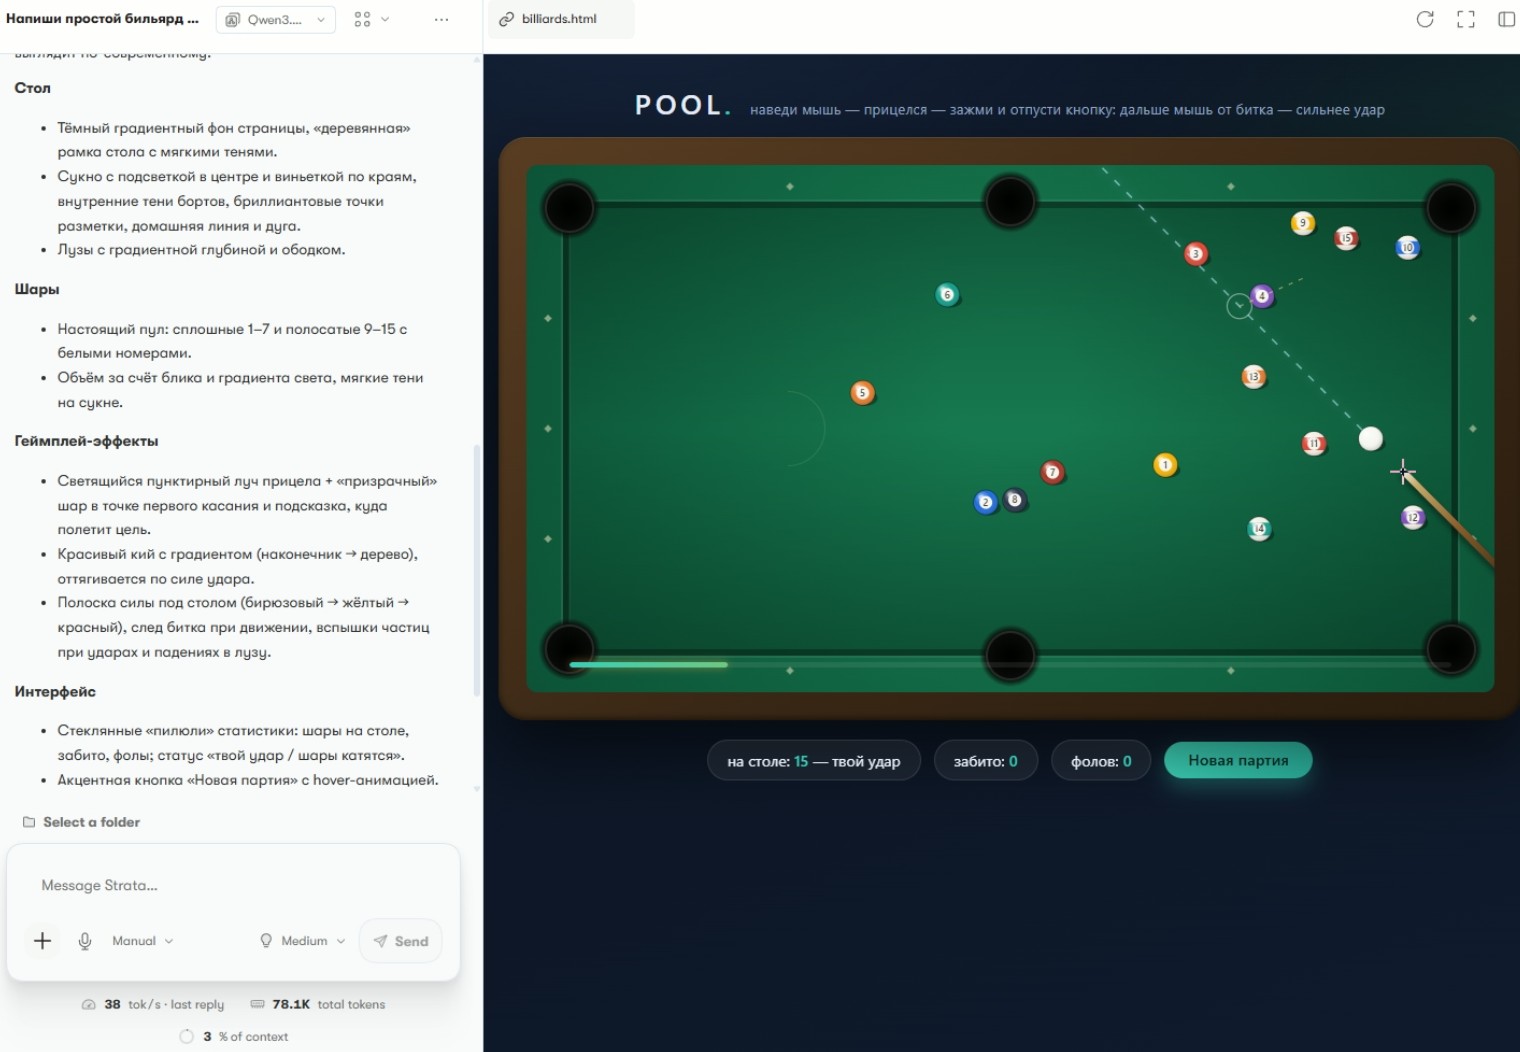
Результат просто ошеломляющий. Но что, если я вас немного обманул, и всё, что вы видели выше, было запущено не на 5060 Ti?
Всё, что было сгенерировано выше, я запускал на RTX 2000 ADA 16 GB + 64 ГБ DDR5 и Ryzen 7945HX. Сам чип тут по мощности сравним с RTX 3060, а памяти хоть и 16 ГБ, но она уже старого стандарта GDDR6 и работает на узкой шине 128 бит. А на реальной 5060 Ti всё будет ещё быстрее, но для этого надо настроить и запустить Strata, чем мы сейчас и займёмся.
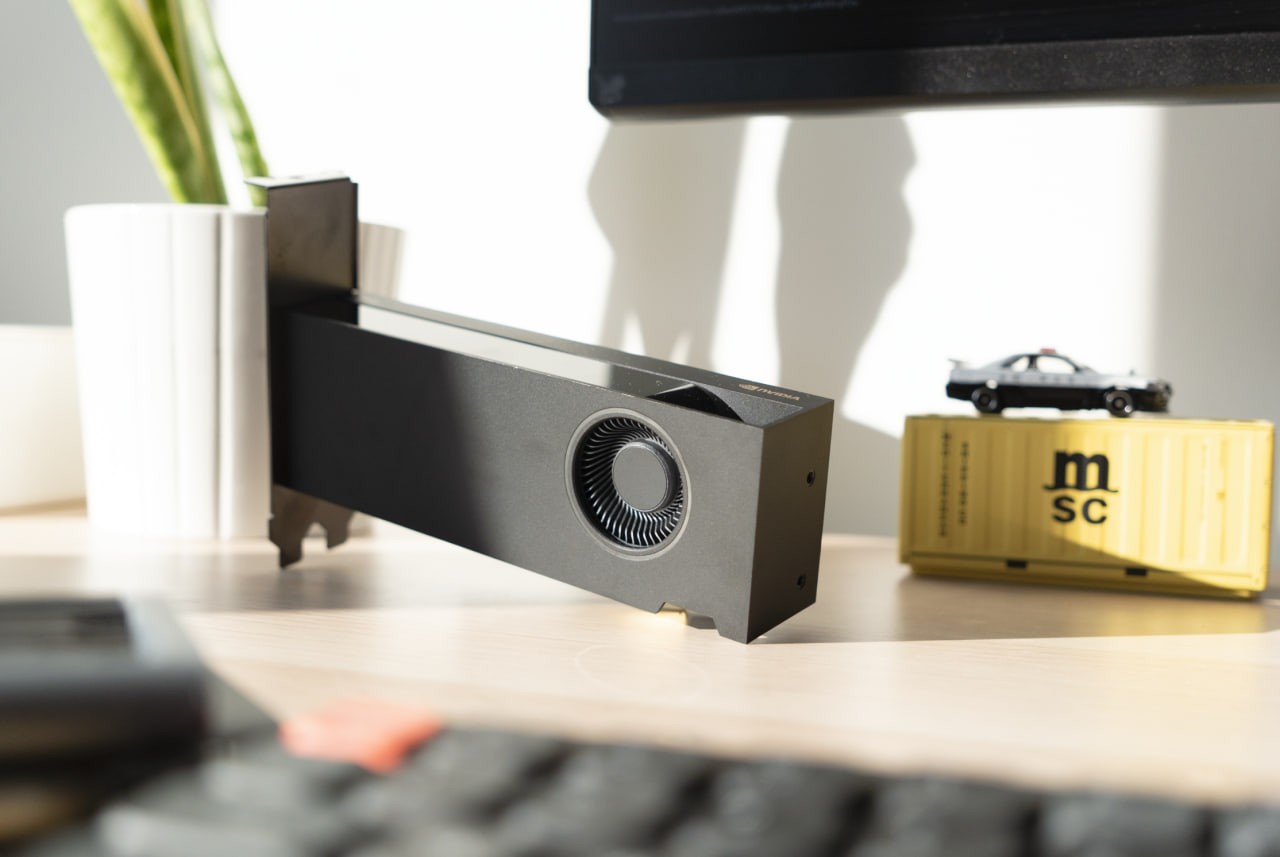
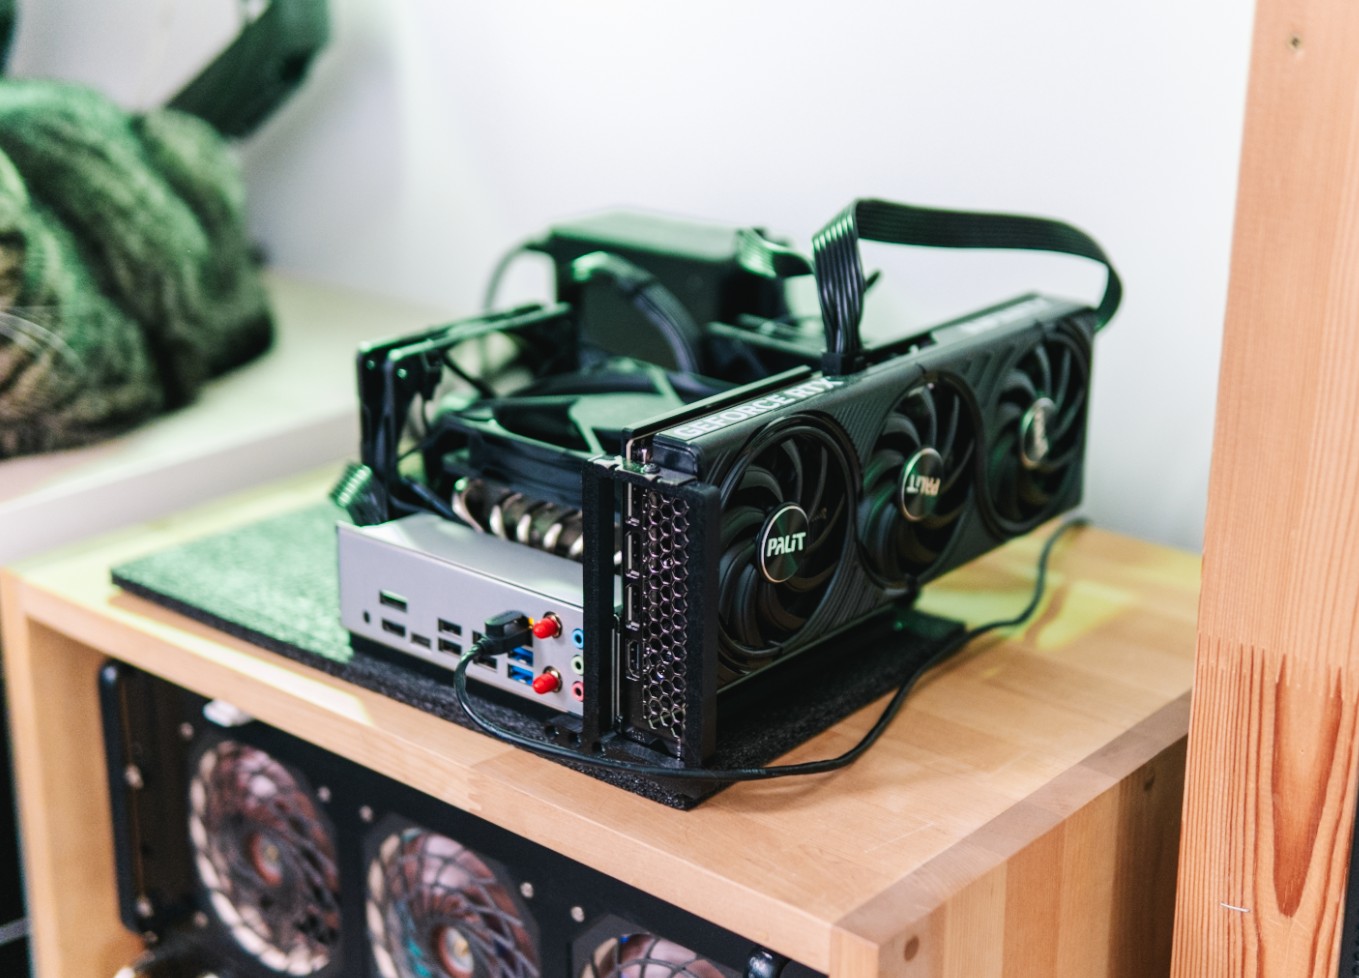
Для работы со Strata я собрал небольшой тестовый стенд:
Процессор AMD Ryzen 9 7945HX (16 ядер 32 потока)
Оперативная память 64GB DDR5 5200mhz cl40
Видеокарта Palit RTX 5060TI 16GB
Блок питания Formula PSFX-1000 Platinum
Что такое Strata и на чём она работает
Краткая справка о том, как работает Strata. Это не какой-то чудо-движок, который переизобрёл LLM. Фундаментально это просто хорошо сделанная система выгрузки нечасто используемых экспертов из VRAM в RAM, за счёт которой увеличивается скорость. При этом если нужный для работы эксперт лежит в оперативке, то скорость будет проседать, как ни крути, но не кардинально. Похожие механизмы уже есть в llama.cpp, но Strata запускается сильно проще, поэтому для новичков лучше взять её.
На самом деле картами Nvidia и тем более 5060 Ti дело не ограничивается. У самого Strata Engine очень обширная поддержка железок, и его можно запустить на AMD от 6000 серии до Strix Halo, на Intel ARC и PRO серии, конечно же, на Nvidia, начиная от 20-й серии и заканчивая 50-й, а также на Apple Silicon и Nvidia DGX Spark. Отличается только процесс. Для свежих карт Nvidia и AMD есть очень простой и удобный Strata Desktop APP, который упрощает установку до пары кликов, включая загрузку модели. Во всех остальных случаях процесс посложнее и требует ручной установки движка, скачивания моделей и подбора параметров запуска. Это несложно, но процесс со звёздочкой.
При этом каждые несколько дней выходят обновления, которые улучшают совместимость и производительность. На момент начала написания заметки скорость префила на 5060 Ti была около 300–350 т/с, а с обновлениями поднялась до 500+ (на 512к контекста). Поэтому не бойтесь обновляться и проводить тюнинг настроек почаще.
Установка Strata
Моя заметка про простой путь, поэтому идём на GitHub в раздел релизов и качаем установщик под Windows. В самой Windows стоит заранее обновить драйверы под вашу видеокарту и закрыть весь ненужный софт, освободив как можно больше ресурсов для LLM.
Кроме Desktop приложения, там же лежит голый движок, который можно запускать из-под консоли, с ручным вводом параметров.
Сам процесс установки приложения заключается в нажатии кнопки «Далее». После успешной установки запускаем Strata и начинаем первую настройку.
Соглашаемся скачать движок:
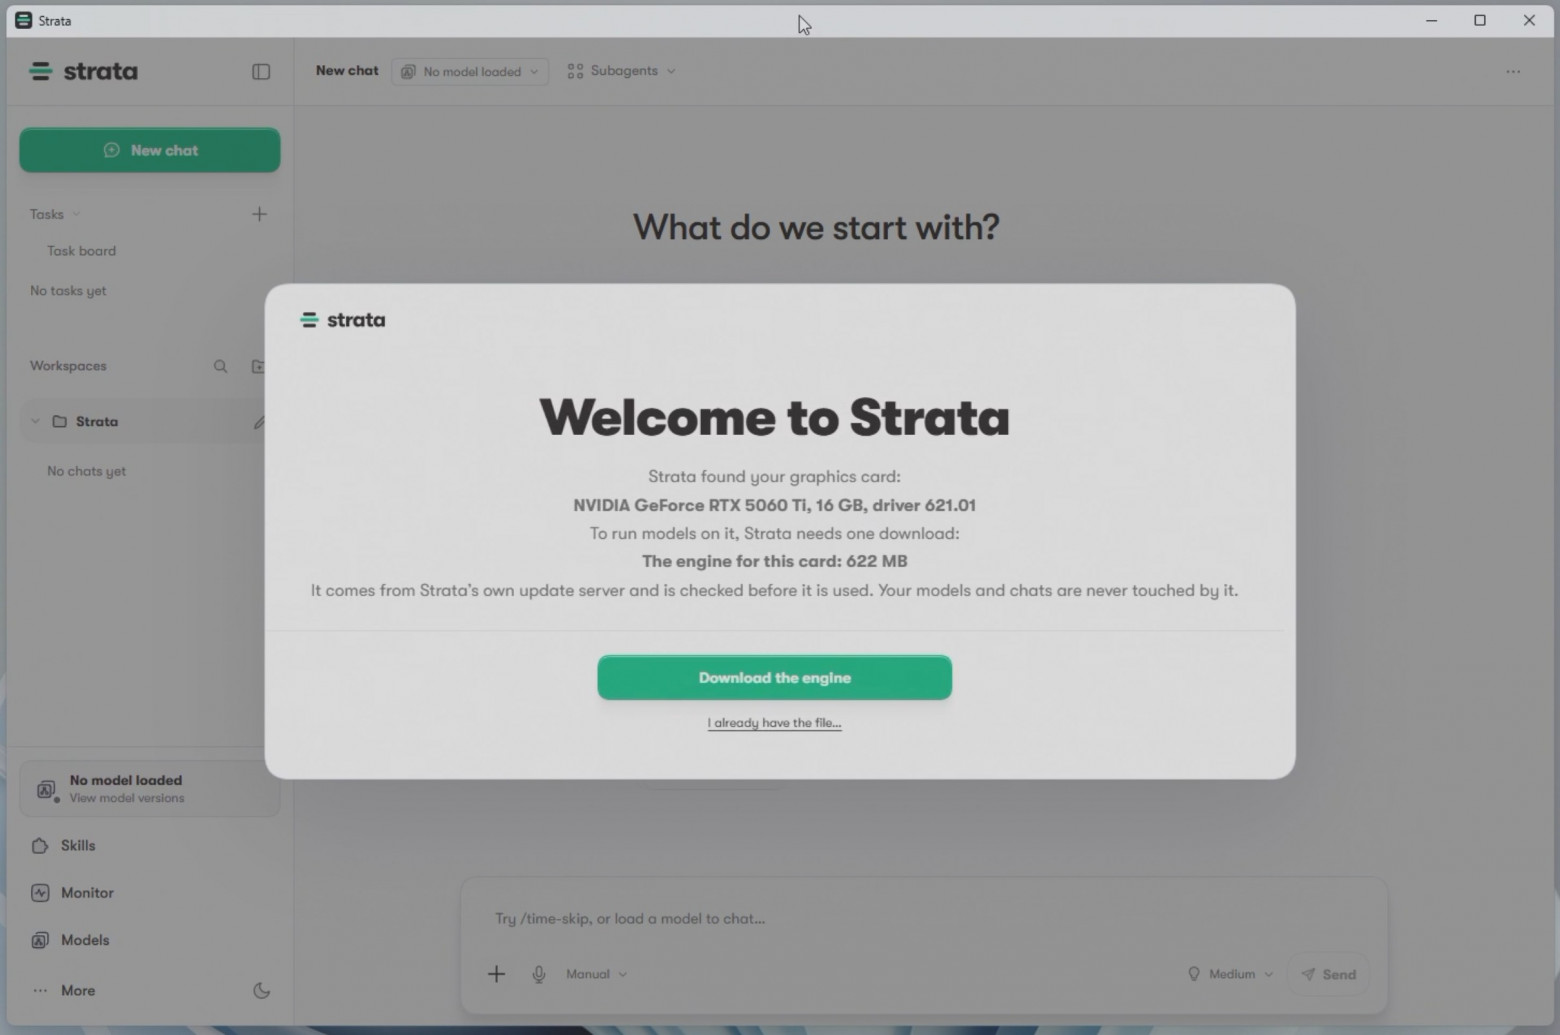
Далее нам предложат выбрать модель под наше железо. Встроенный бенчмарк выбирает модели под RAM+VRAM, игнорируя SSD, так как если модель не влезла и частично лежит на SSD, то скорость падает (не сильно, но лучше этого сценария избегать).
В моём случае на RTX 5060 Ti 16 GB + 64 GB RAM поместится Qwen3.8-Flash-Next в IQ3_S квантовании весом 83,6 ГБ. Её мы и скачиваем. С гигабитной сетью этот процесс занимает 15 минут.
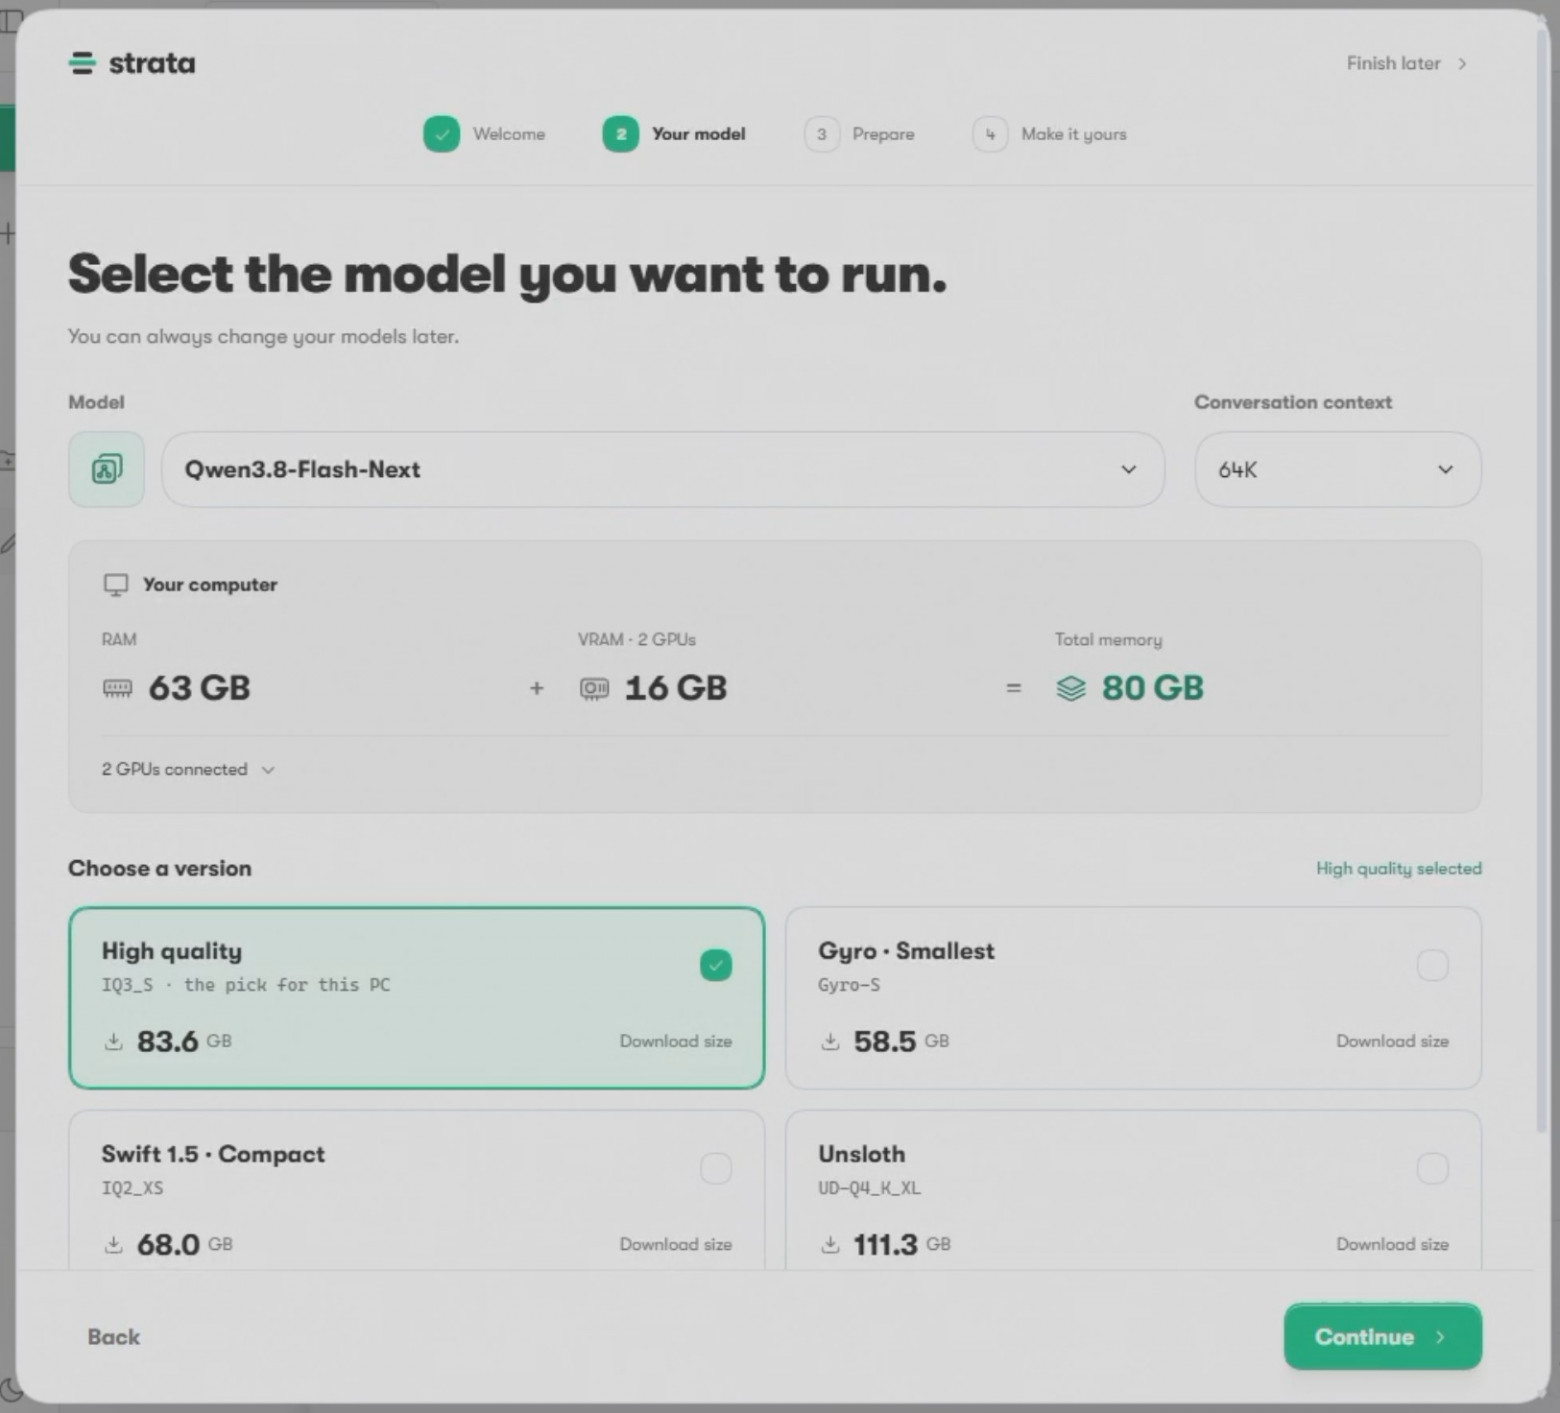
После скачивания модели начнётся тюнинг. Тут предлагается выбрать пару настроек. Во-первых, хотим ли мы, чтобы модель умела распознавать изображения. Выбор зависит от вашей работы. Я эту настройку включаю, так как модель может сама запустить браузер, проверить, всё ли выглядит как на референсе, что мы ей скинули, или нет ли визуальных багов, и сама что-то починить. Тут же стоит выбрать, сколько производительности Strata оставит пользователю. Лучше, конечно же, отдать ей всё и работать с другого ПК, но если такой возможности нет и надо работать на этом ПК, то выбираем 80 % производительности.
После этого жмём зелёную кнопку, которая начнёт процесс тюнинга, который, в свою очередь, подберёт оптимальные настройки под ваш ПК.
Вообще эти настройки не самые оптимальные, и ручками, используя голый Strata Engine, можно добиться лучших результатов.
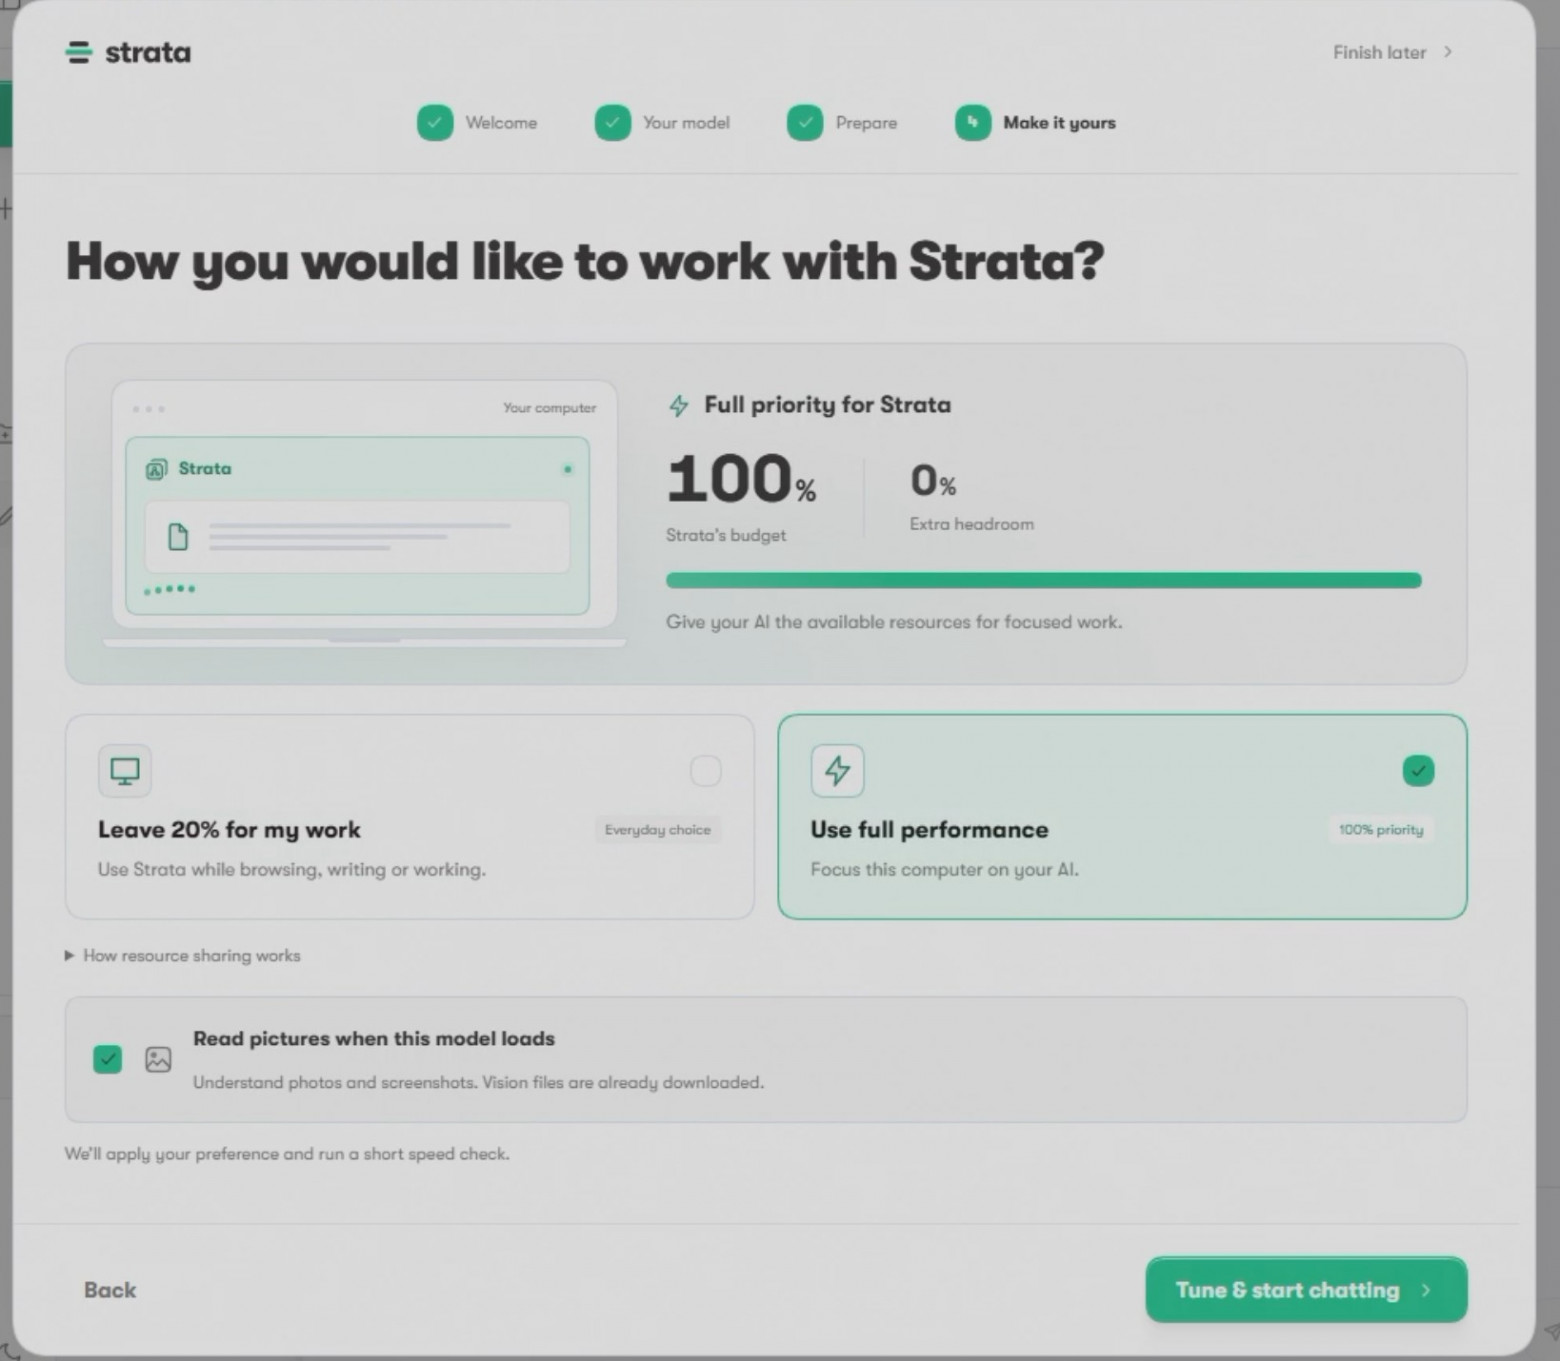
И на этом всё! Спустя 20 минут тренировки нас встречает окно чата и успешно загруженная модель.
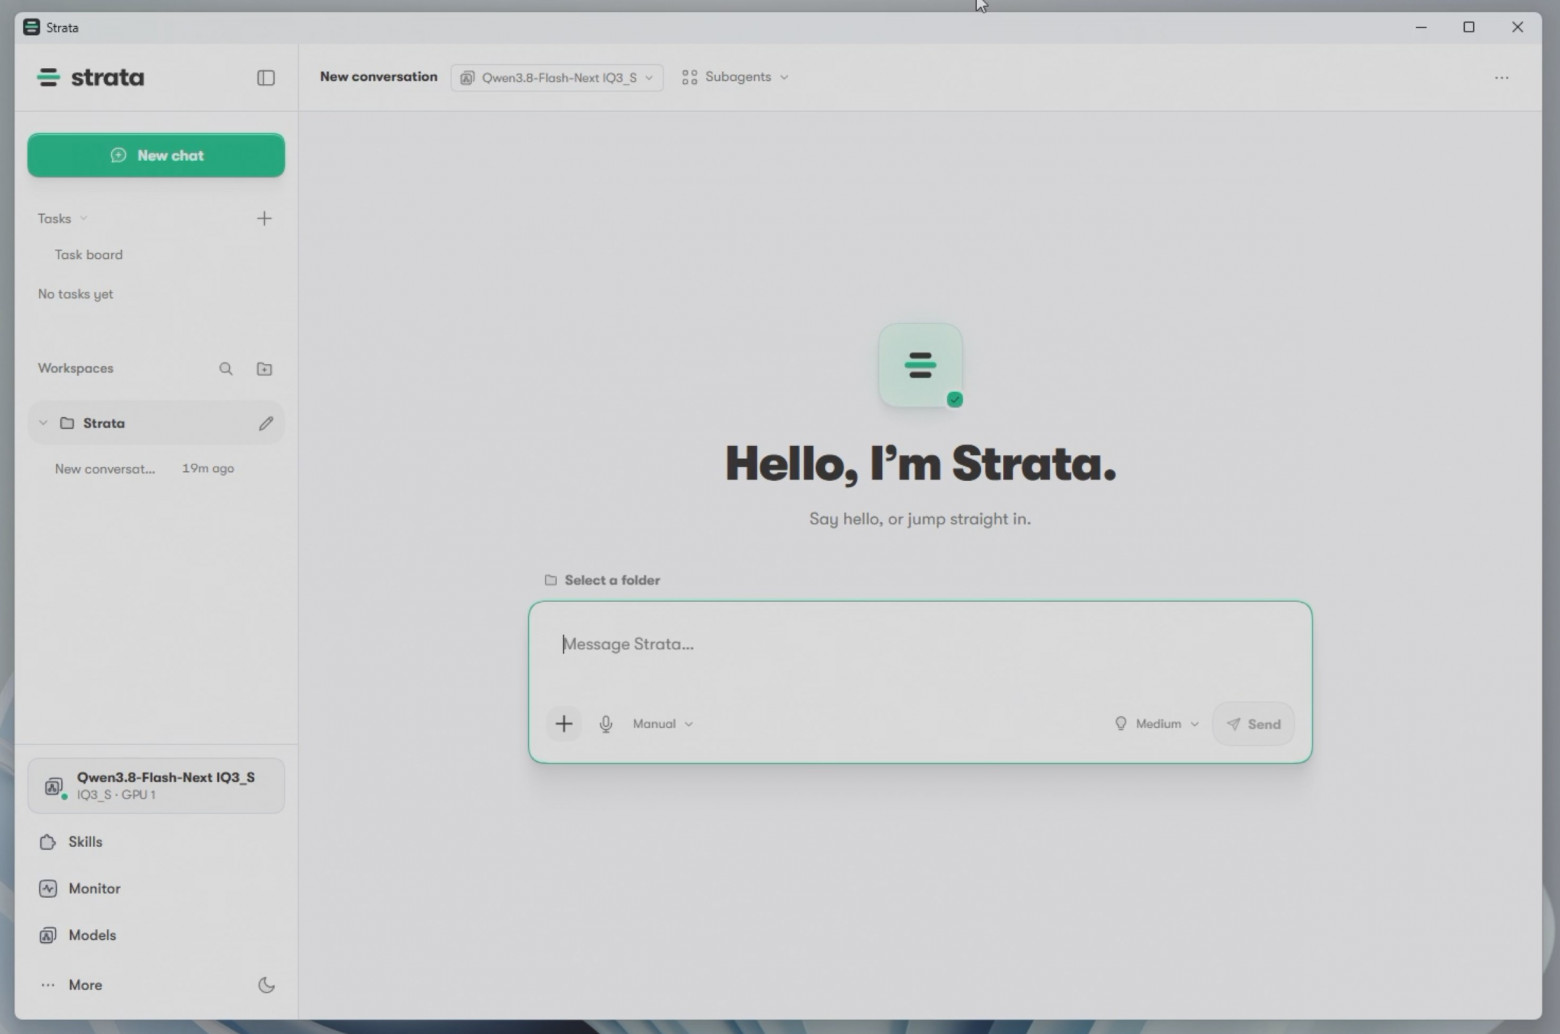
Сменить модель или настройки можно во вкладке моделей.
Тут в целом нас интересует разве что контекст, и с ним есть нюансы. Чем больше контекста, тем больше нейросеть держит «в памяти» данных из чата, файлов и того, что она себе напридумывала. Но при этом остаётся меньше места для экспертов, которые, собственно, делают саму работу. В 16 GB VRAM можно получить 512к контекста, и оно даже будет работать, выдавая 30–80 т/с на обработку и 300+ т/с на префил. Но снизив контекст до 120к, мы получим 50–130 т/с на обработку и 1100+ на префил.
И тут надо самому решать, что вам нужно. Если говорить очень грубо, то простые задачки типа тех, что в начале статьи, без проблем решаются в контекстном окне 64–120к. При рефакторинге огромных и запутанных проектов я бы взял больше контекста. Да, будет долго, но зато LLM не будет терять суть, ломая проект. При этом даже большой проект может быть разбит на мелкие модули с хорошим описанием в agents.md, тем самым позволяя работать с мелким контекстом.
В общем, экспериментируйте.
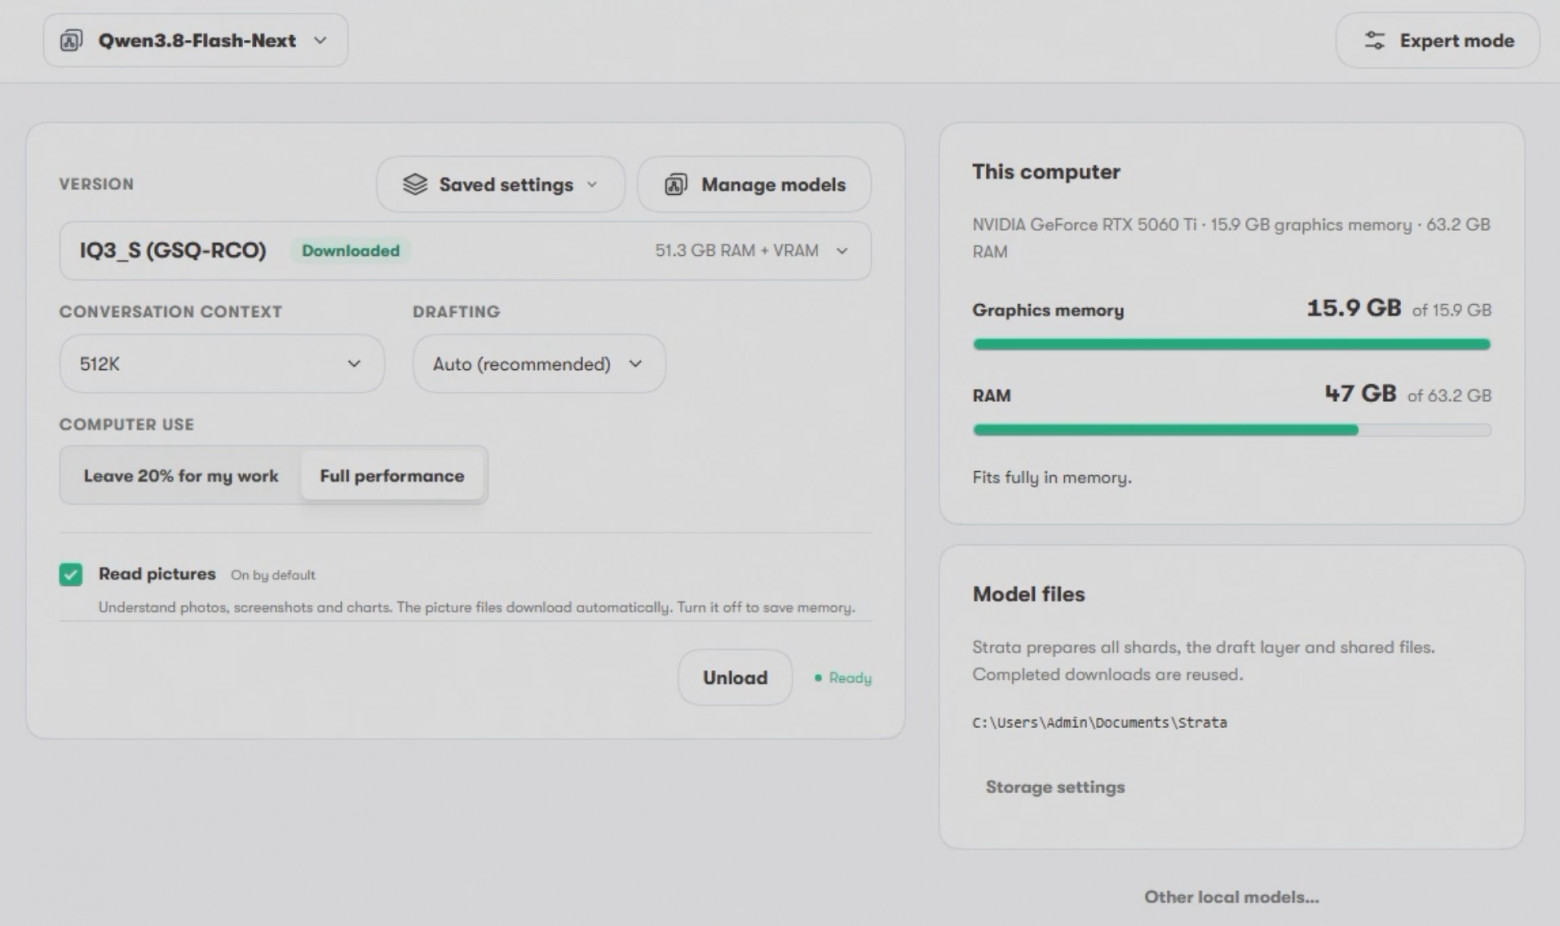
Как вы видели в начале статьи, этот интерфейс может вызывать Shell команды, писать файлы, открывать браузер и т. д. Но работать с кодом в нём не особо удобно и не нужно. OpenCode заметно более удобный и сильный инструмент, поэтому мы подключим Strata в OpenCode.
В Strata слева снизу нажимаем на MORE -> SHARE. Если OpenCode стоит на том же ПК, что и Strata, тут ничего настраивать не нужно. Если же на другом ПК, жмём Share. После чего берём API URL и Model ID.
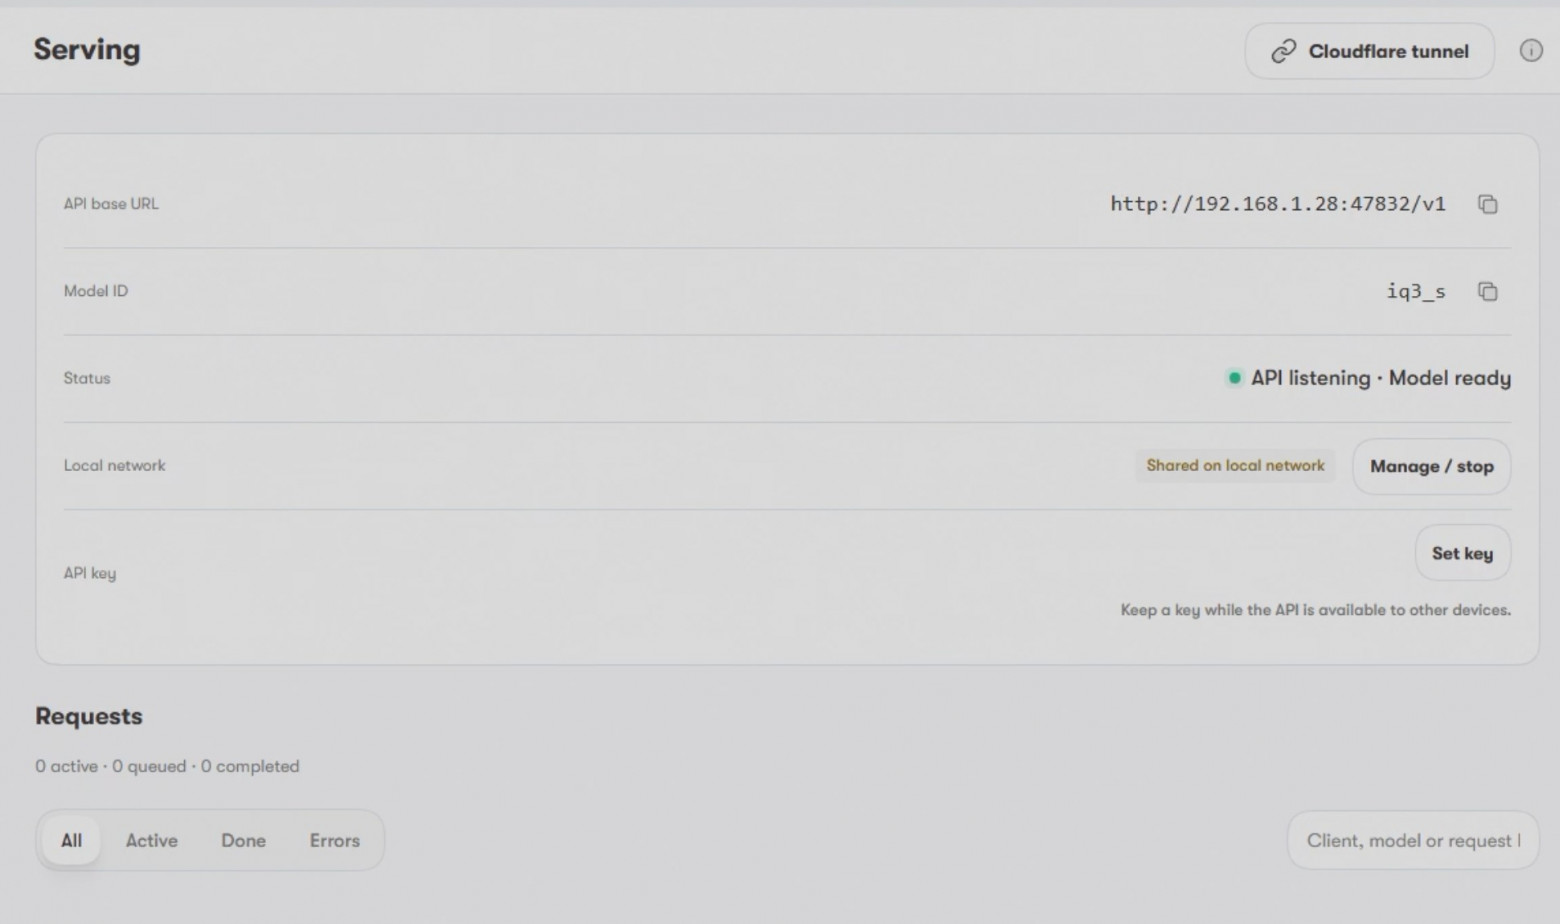
Полученные выше данные нужно занести в JSON файл OpenCode, также там нужно обязательно выставить контекстное окно, которое вы настроили ранее.
{
  "$schema": "https://opencode.ai/config.json",
  "model": "strata/iq3_s",
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata (local)",
      "options": {
        "baseURL": "http://192.168.1.28:47832/v1",
        "apiKey": "not-needed"
      },
      "models": {
        "iq3_s": {
          "name": "Qwen3.8 Flash Next IQ3_S",
          "limit": {
            "context": 512000,
            "output": 16384
          }
        }
      }
    }
  }
}
Чтобы использовать его во всех проектах, нужно сохранить файл как opencode.jsonc в папку %USERPROFILE%.config\opencode
Либо сохраняем тот же конфиг с названием opencode.json в папку проекта, но в таком случае этот сервер будет работать только в этом проекте.
Далее в OpenCode выбираем модель из конфига. Если её нет, то жмем на поле моделей -> кнопка настроек справа сверху, и активируем нашу.
Готово!
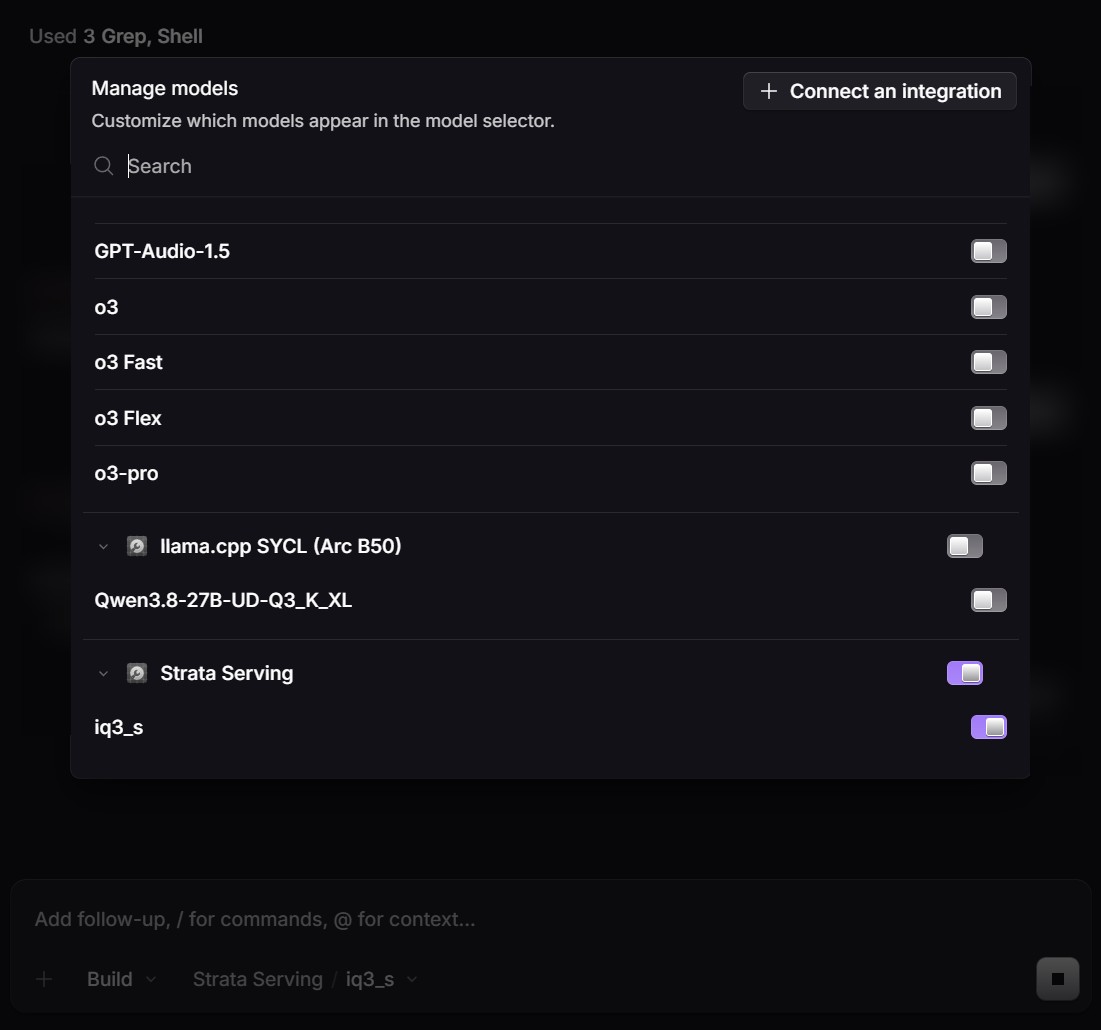
Чем я нагружал эту связку и что получилось
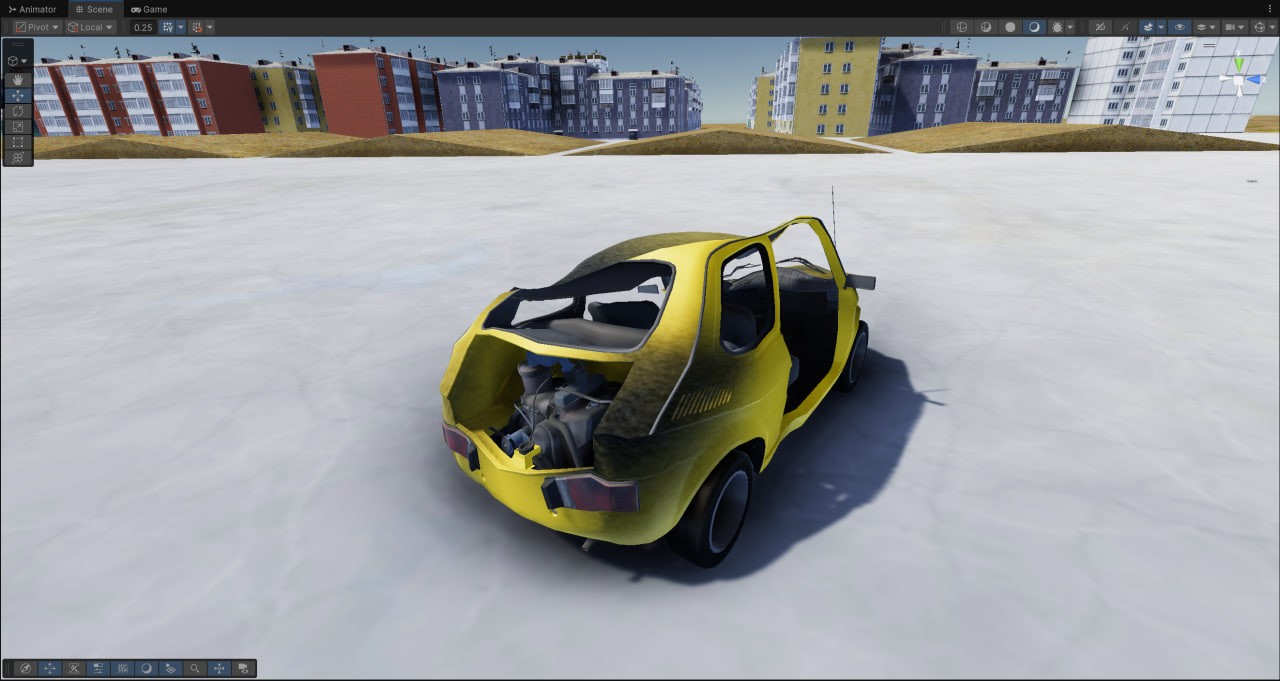
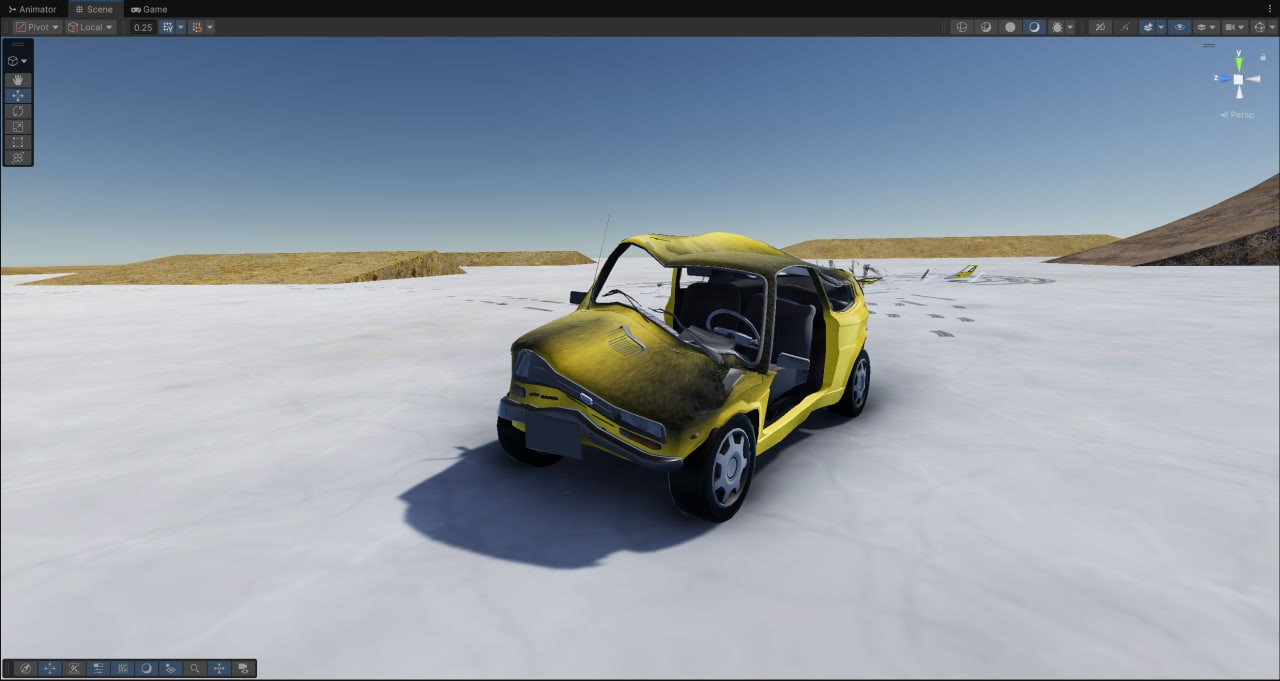
Перенос системы отображения урона на машине из GTA V в Unity. В GTA V интересная система, которая мнёт машины. Перекочевала она из GTA IV и в какой-то мере была прорывной. Она простая, элегантная и очень быстрая. Логика в том, чтобы при ударе машины её вертексы сминались не в оригинальной модели на процессоре, а на ГПУ. Для этого строится текстура, в которую при ударе рисуются разноцветные формы с градиентом. Чем ярче пятно, тем сильнее урон, а цвет влияет на направление удара. После чего текстура накладывается на машину через radial projection и используется в вертексном шейдере для сдвига самих вертексов. Таким образом система поддерживает любую форму объекта при столкновении и очень дешевая для ГПУ.
Задачка со звездочкой, у меня на ручное создание такой системы с нуля ушло два дня. Я скормил эту задачу в LLM, и она написала код примерно за полчаса c учетом моих правок на сильное упрощение системы.
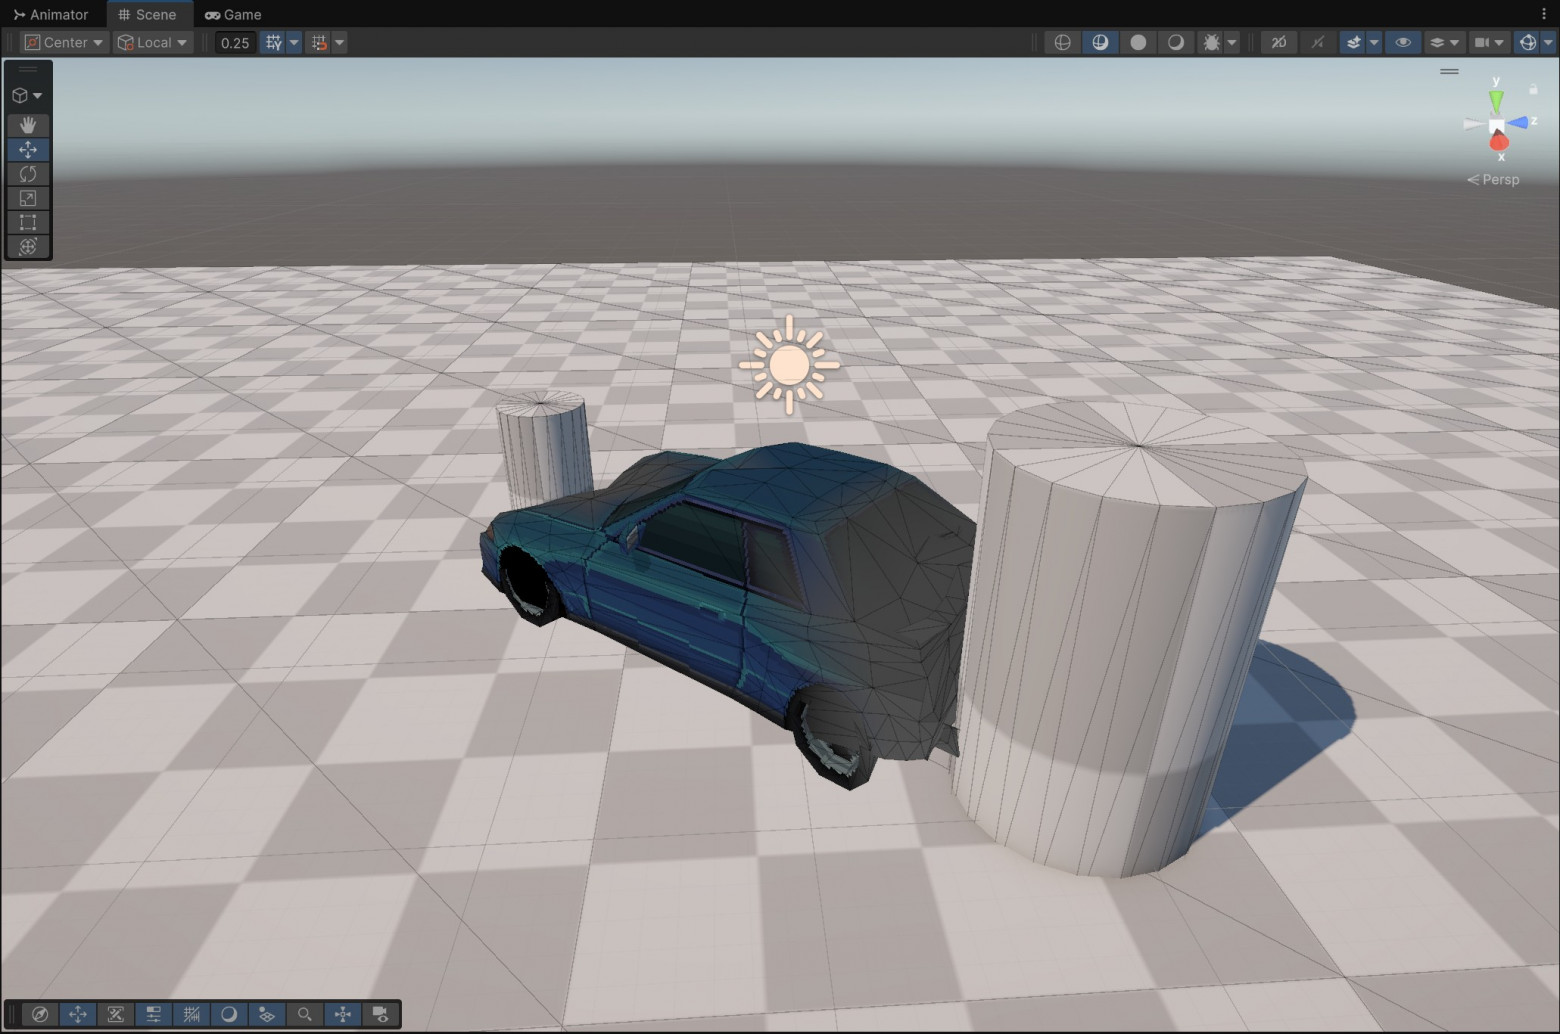
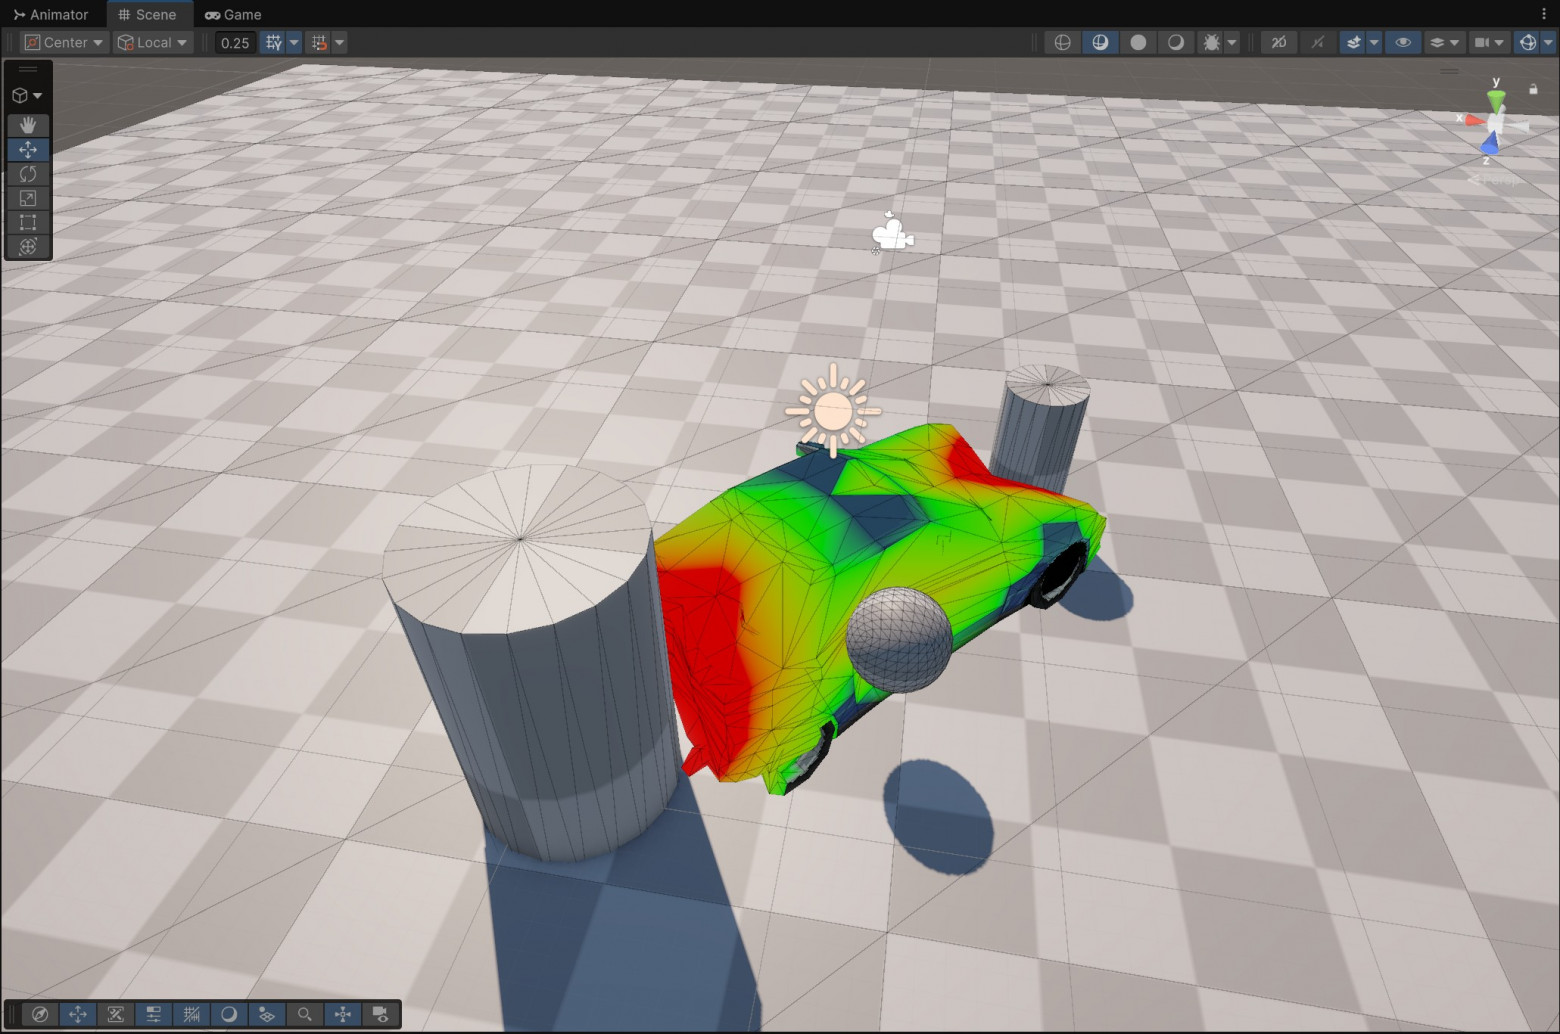
На реальной машине из GTA V всё это выглядит очень даже хорошо.
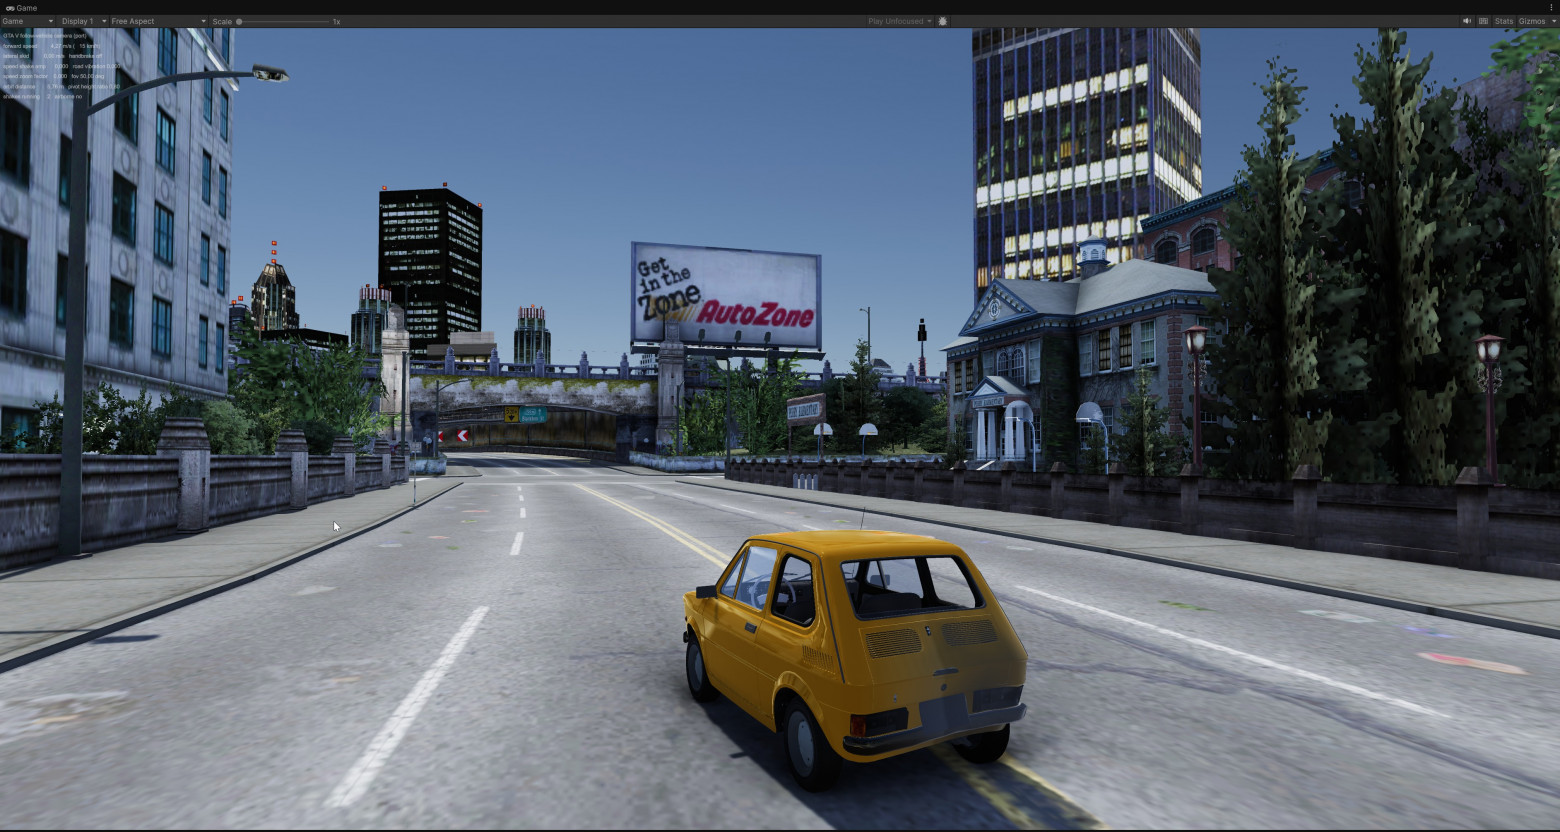
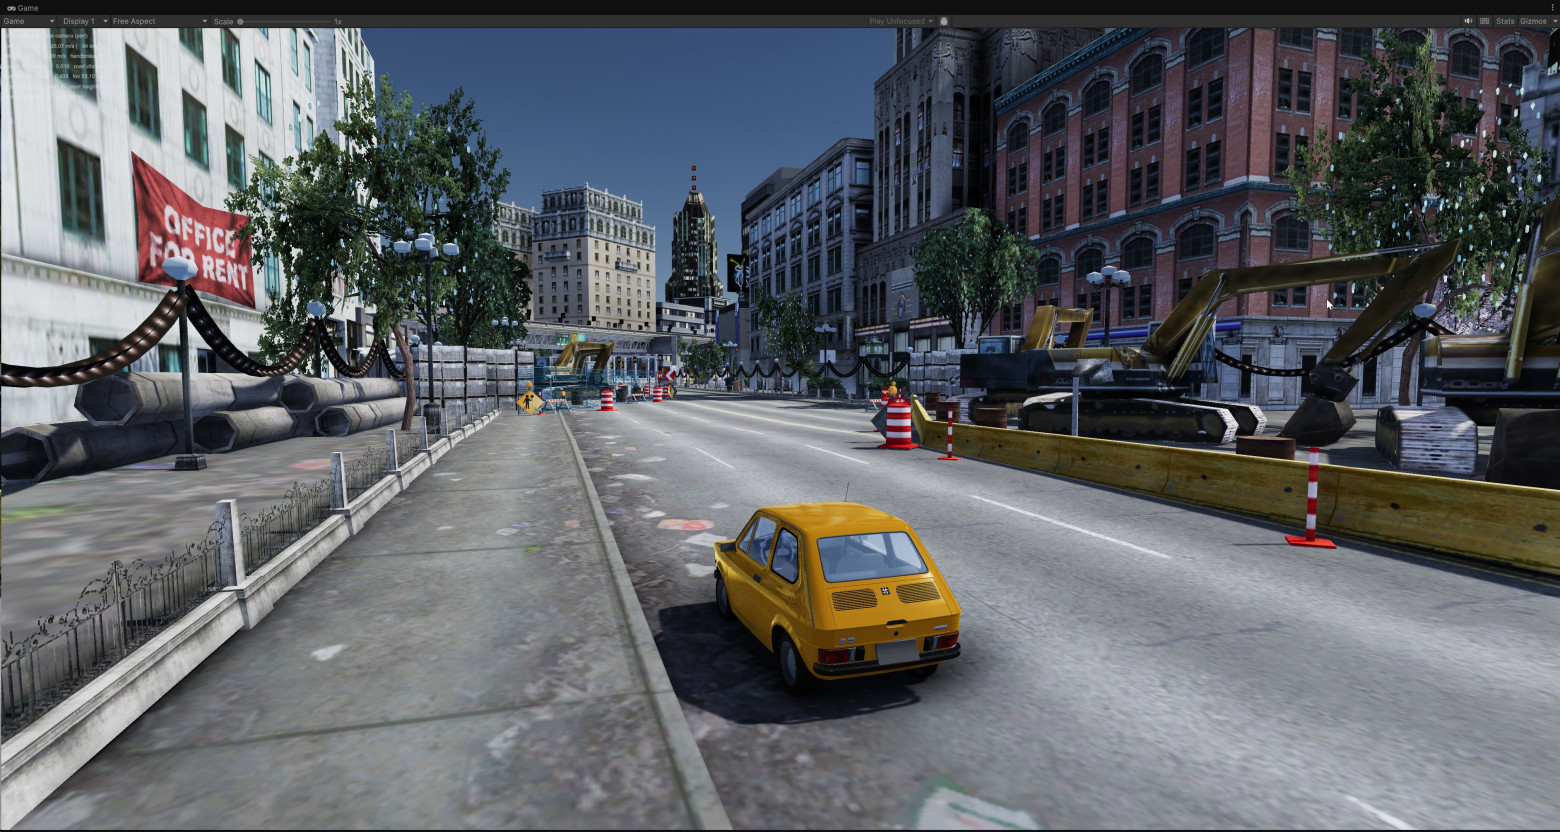
А бонусом пишем загрузчик карты из NFS Underground, чтобы кататься было не скучно.
Пишем игры для детей по фото
Меня попросили сделать несколько развивающих игр для детей. Было интересно, как LLM справится без моего активного участия и хорошего описания задачи. Поэтому я сделал скриншоты игр из презентаций и закинул их в окно чата с просьбой сделать. Сама по себе игра максимально простая: найти разницу между двумя изображениями.
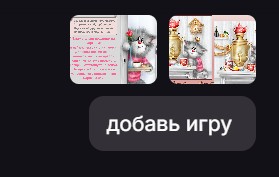
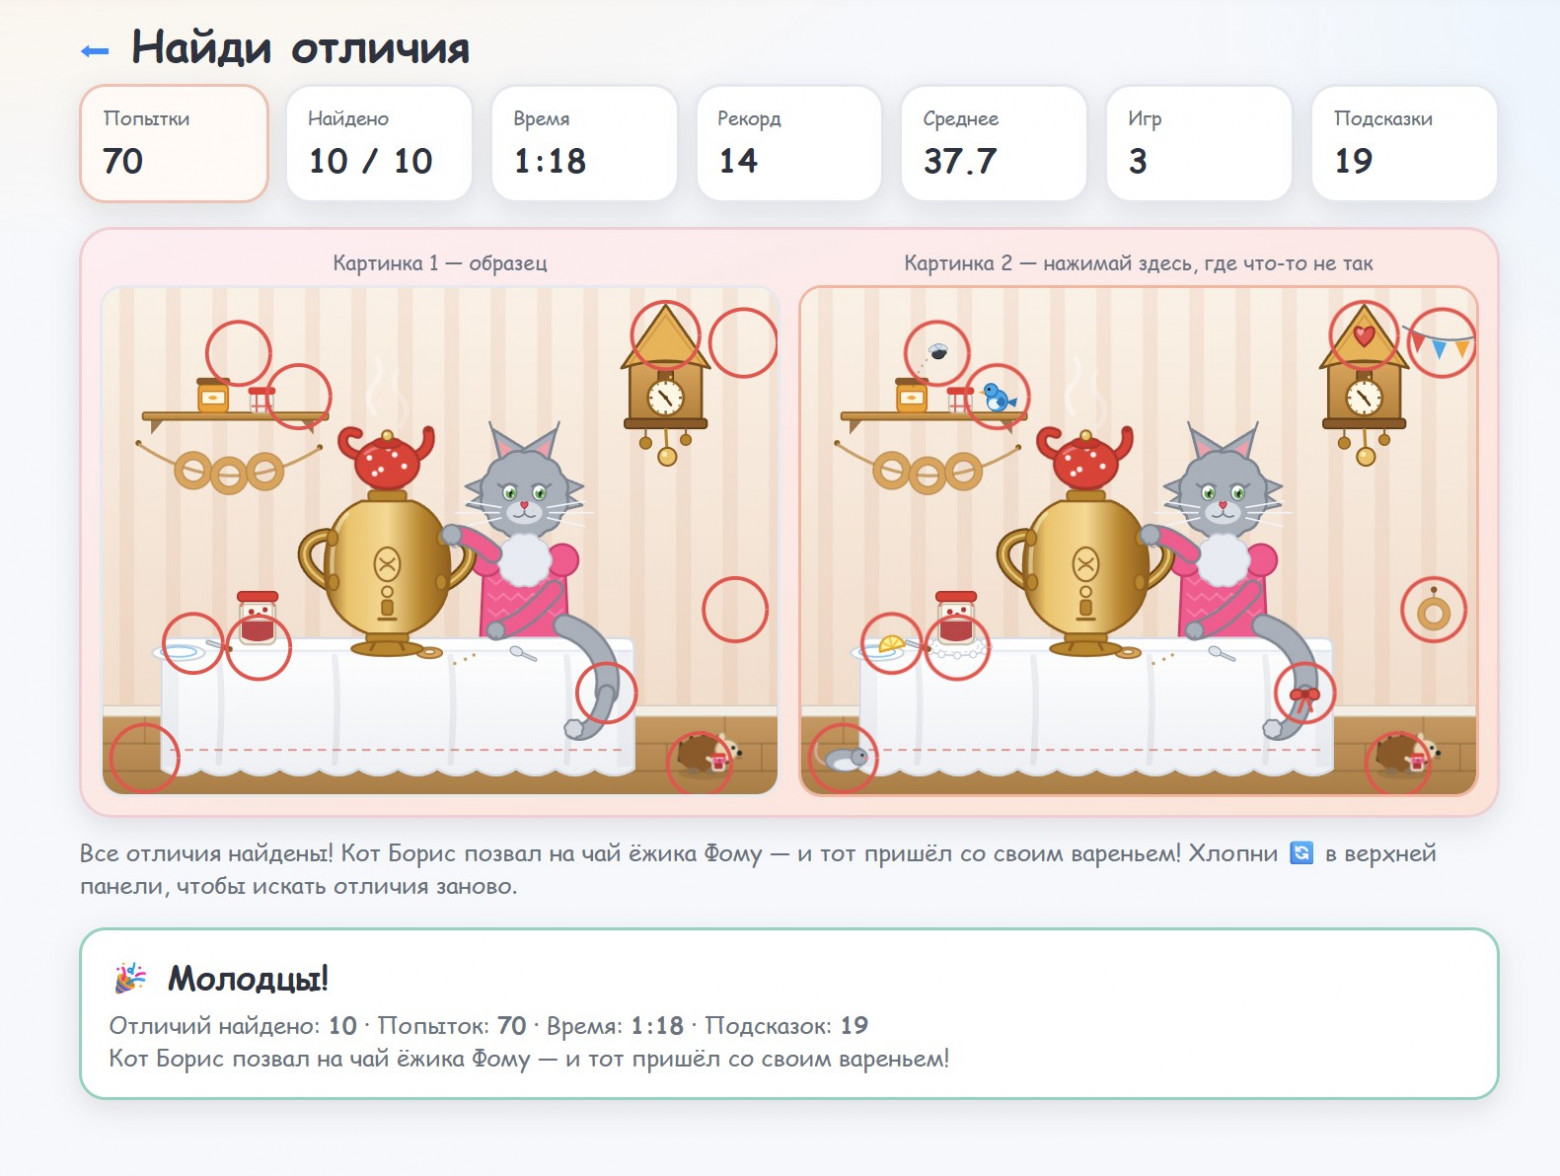
И оно справилось! Конечно, SVG арт немного кривоват, но его можно починить, в целом же игра полностью рабочая.
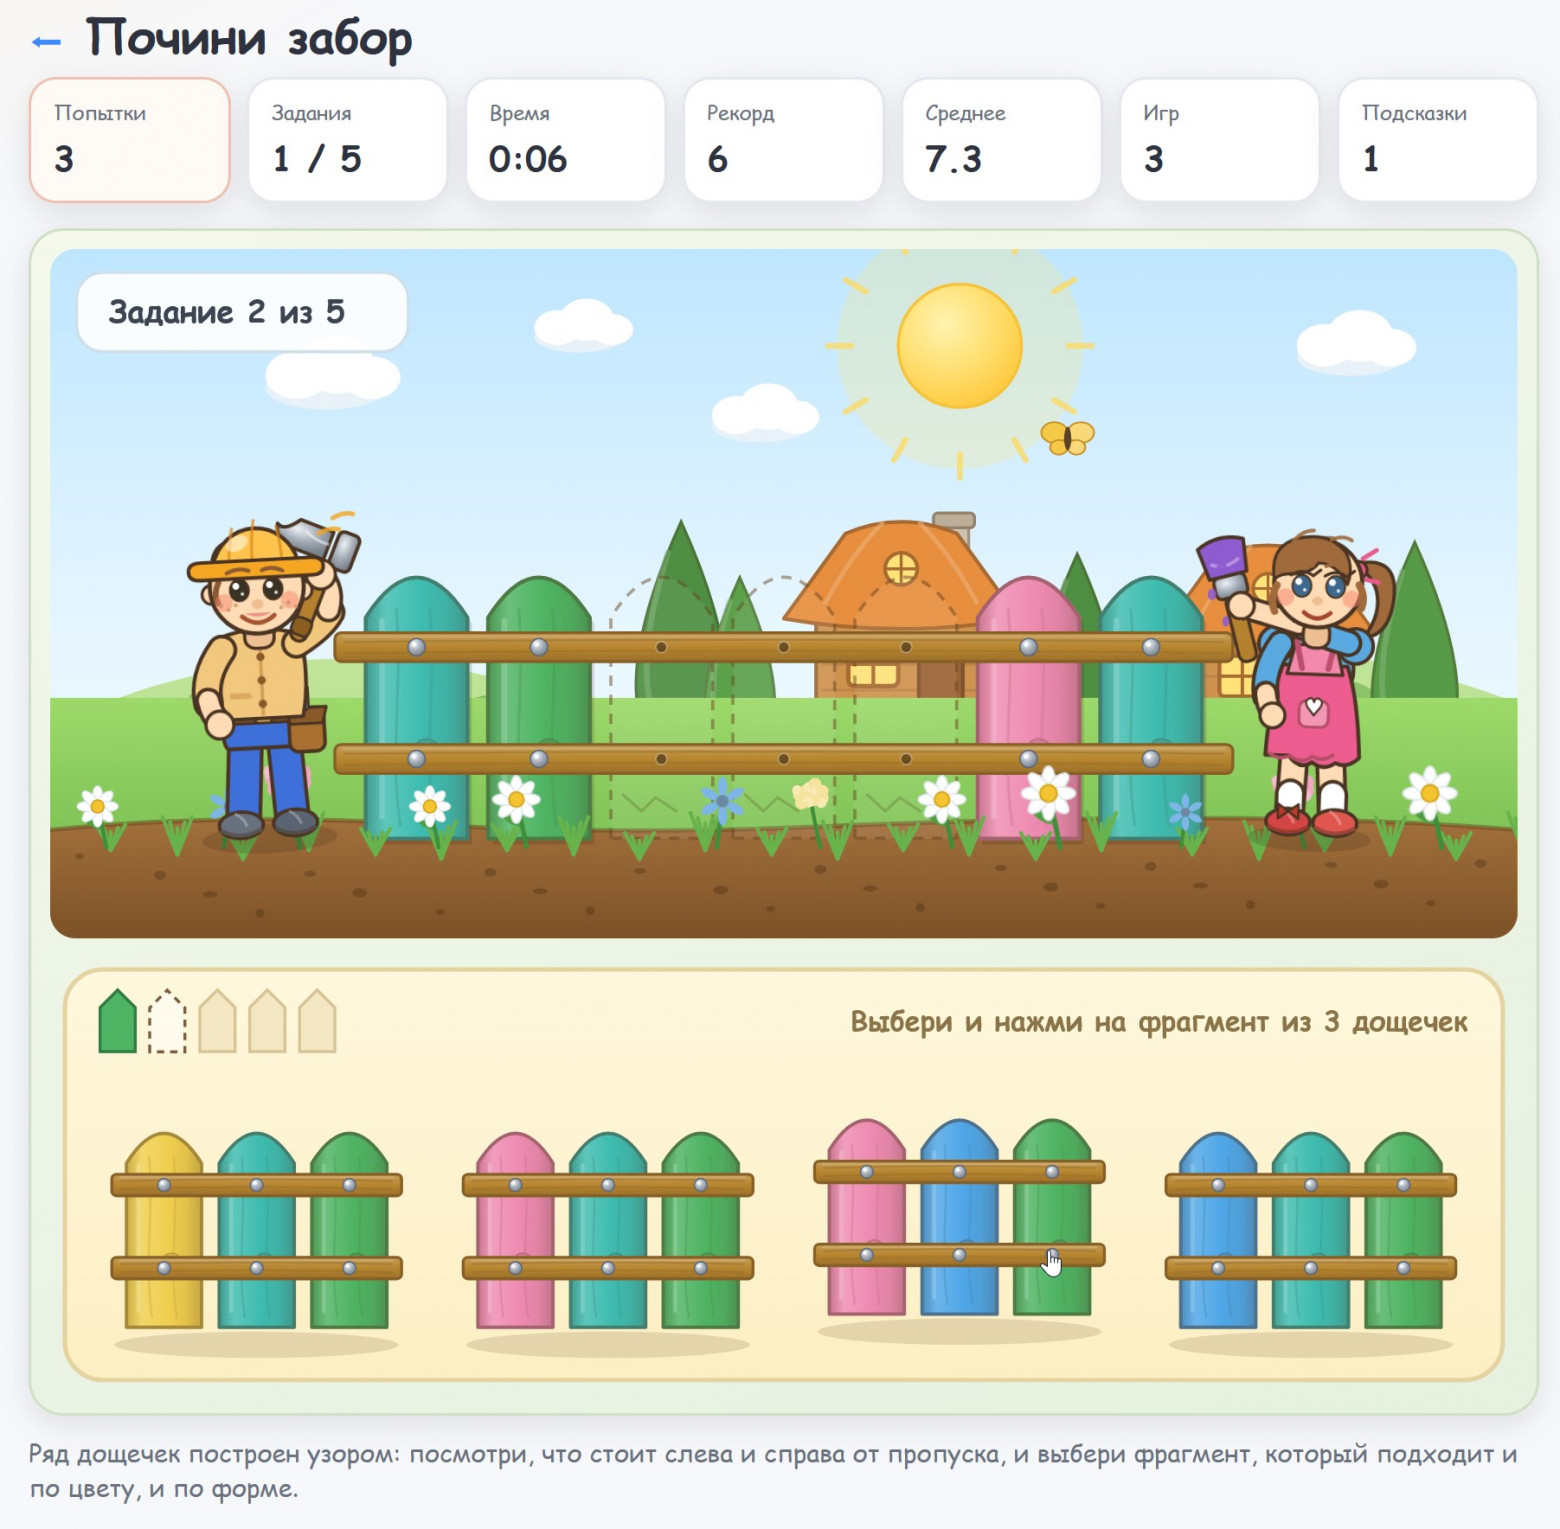
Тем же алгоритмом добавил вторую игру с забором. Тут SVG арт ещё хуже, особенно на людях, и это уже после правок. Сама игра работает отменно и без багов, а спрайты можно нагенерировать локально в более подходящем для этого софте (ComfyUI + MiniMax H3).
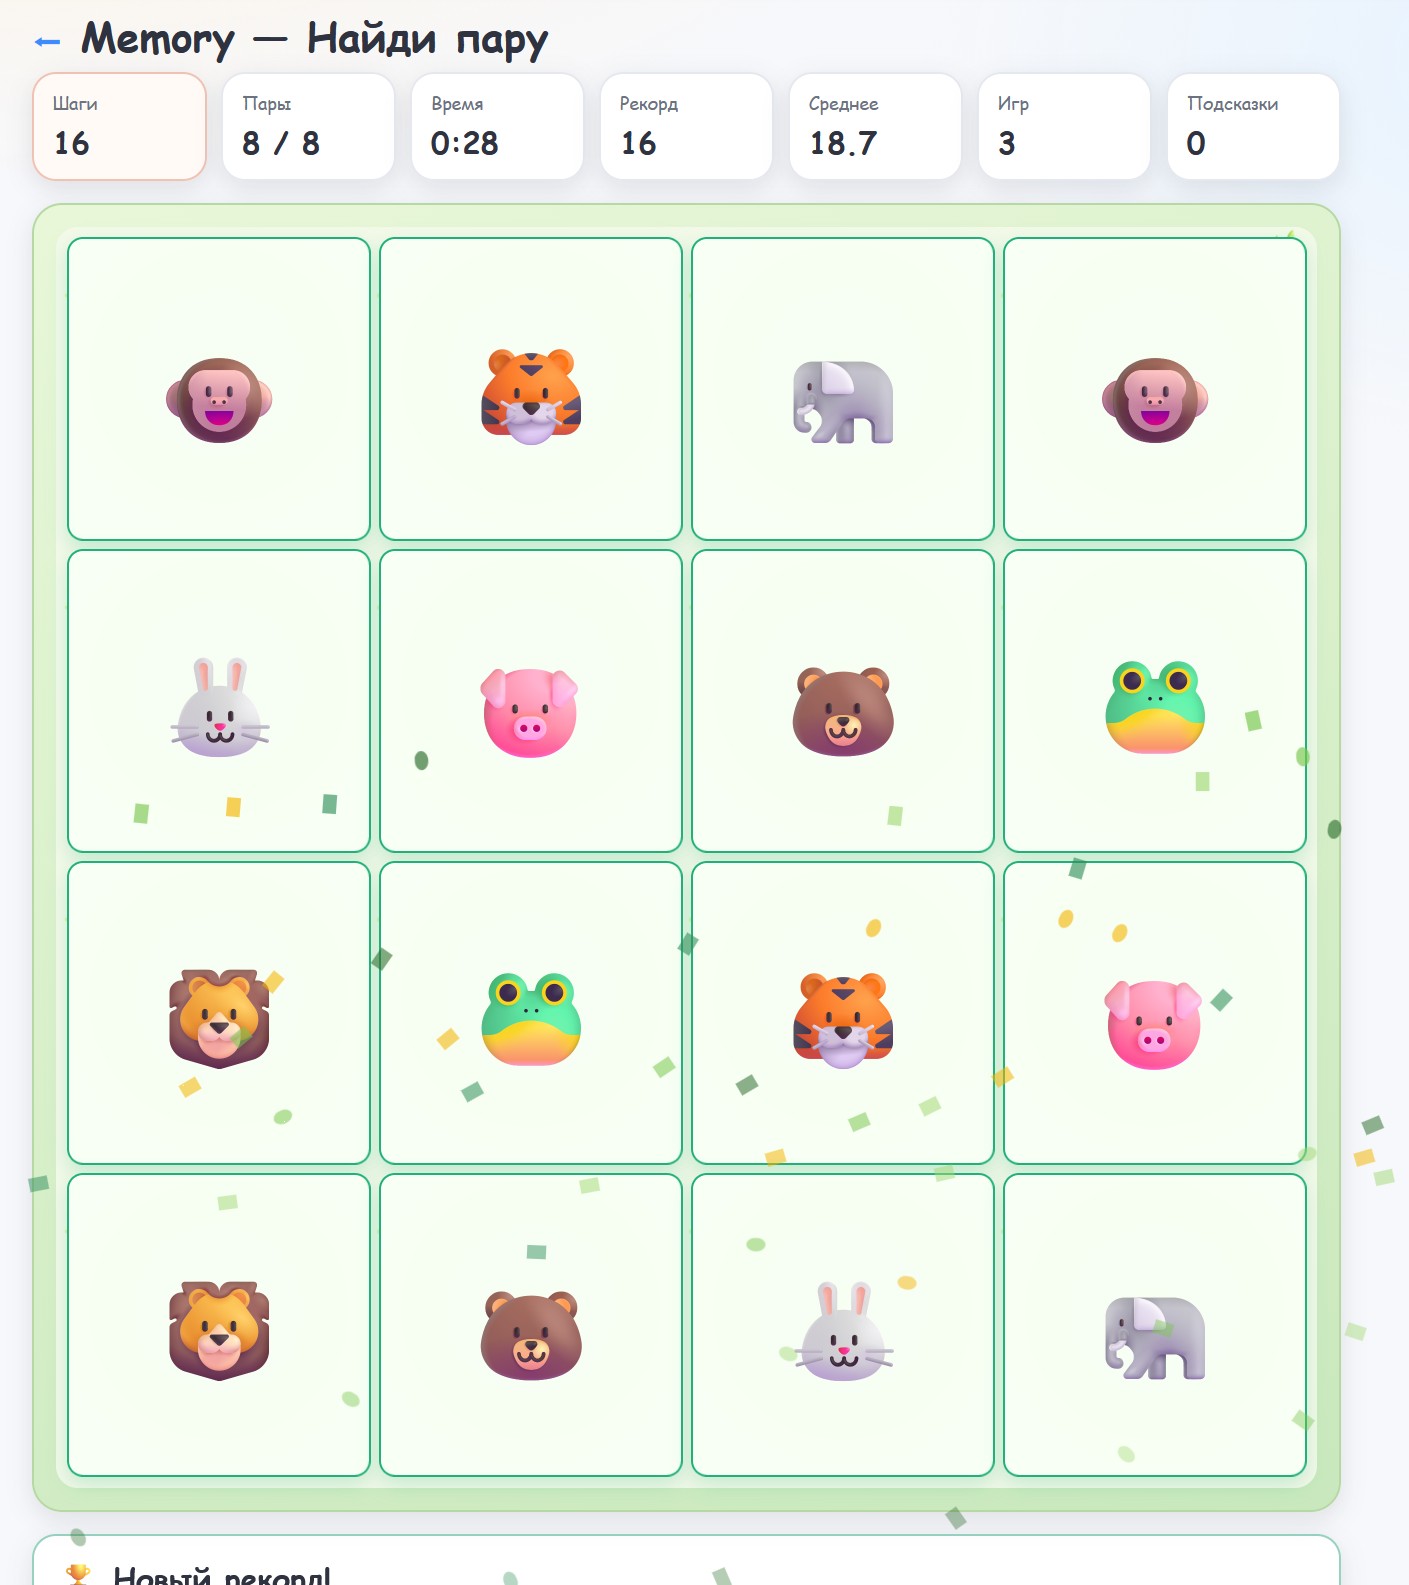
Старый добрый Memory Match тоже прекрасно получился. Не с первого раза, правда, поначалу закрытая карточка была кривовата, но после пары правок в чате всё работает отлично.
Генерация 3D модели
Ради интереса решил ей скормить весёлую задачку в виде создания 3D модели. На кухне у меня светом управляет ESP8266 с парой мосфетов и DC-DC. Для генерации я так же скинул фотки и сделал пару запросов.
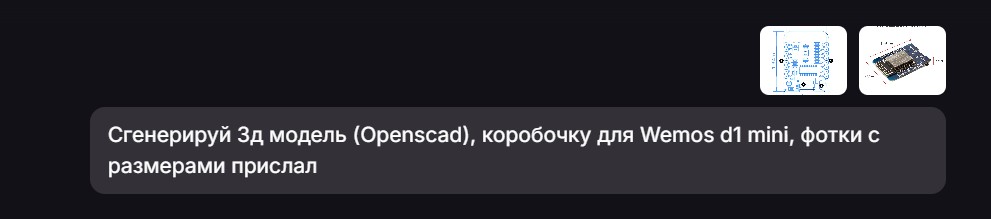
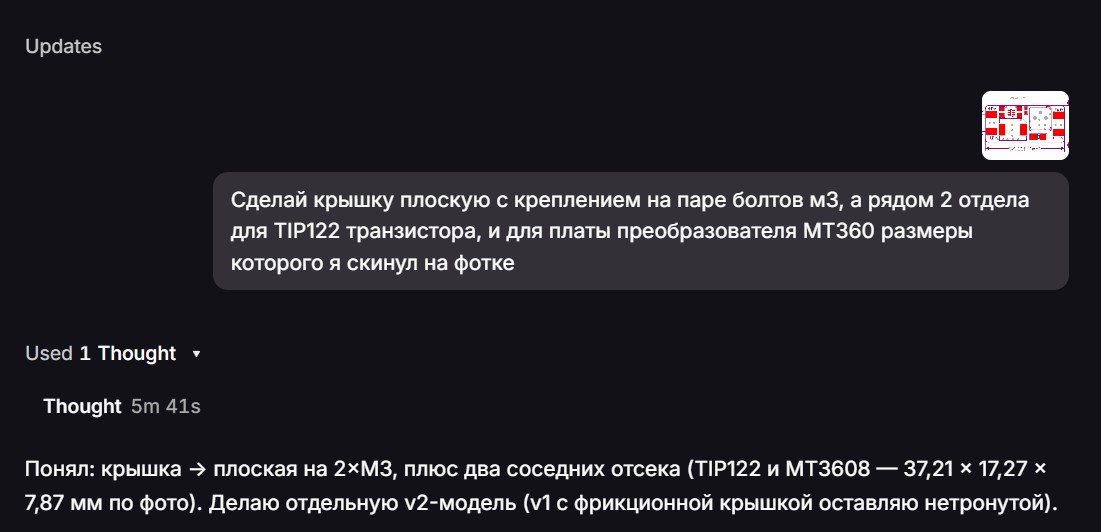
Спустя 5 сообщений, 3 часа реального времени и 4 итерации я получил вполне себе адекватную коробочку в OpenSCAD. Что интересно, LLM даже делала симуляцию прокладки проводов в корпусе, дабы понять, где и как лучше расположить отверстия!
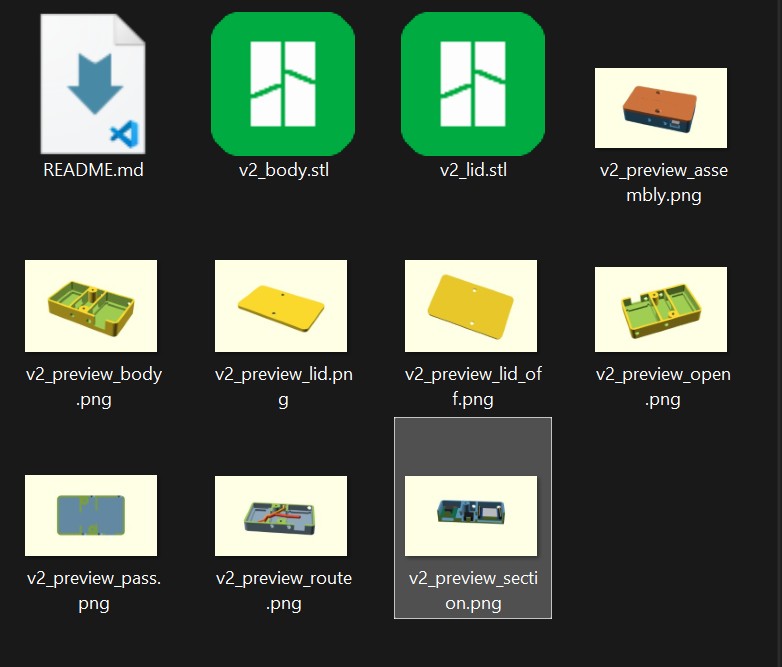
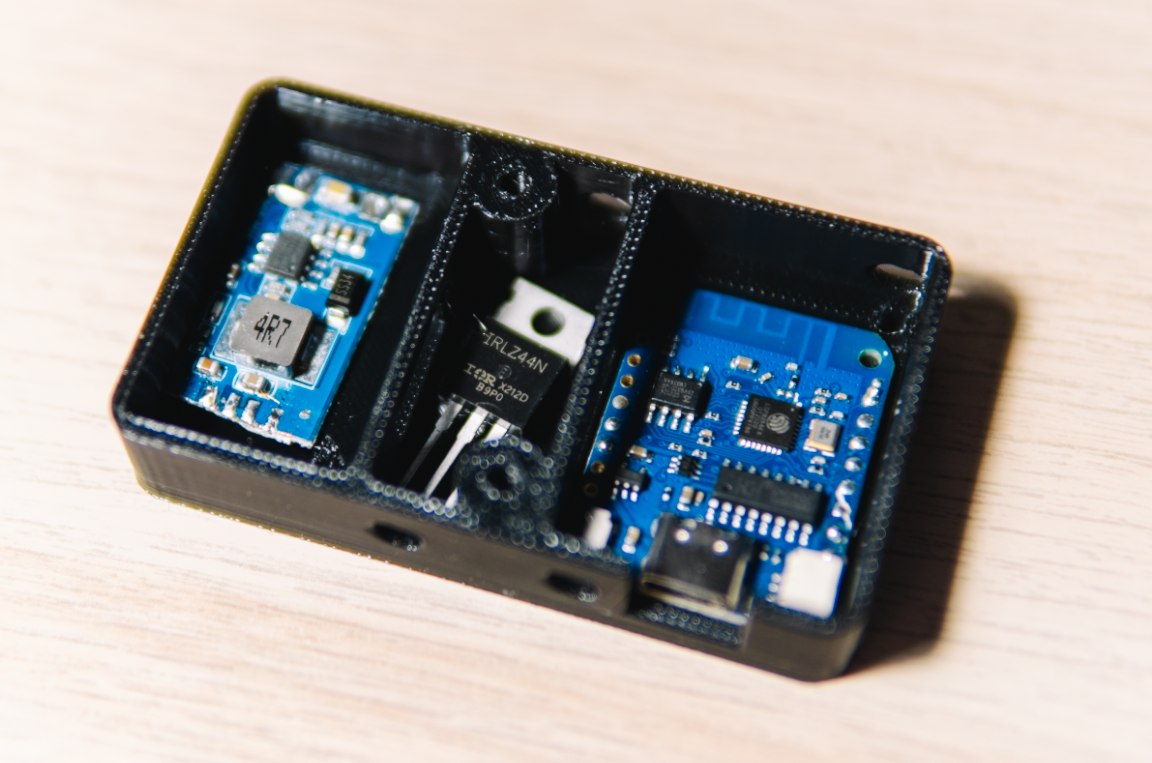
Я, конечно же, её распечатал. Детали поместились, но зазоры слишком большие. Использовать можно, но только добавив клея. Правда, сама LLM сказала, что делала модели примерно по паре скриншотов и они не очень точные. И чтобы выдать результат лучше, она предложила мне сделать замеры самому и дать их ей.
Доработка торрент-поисковика
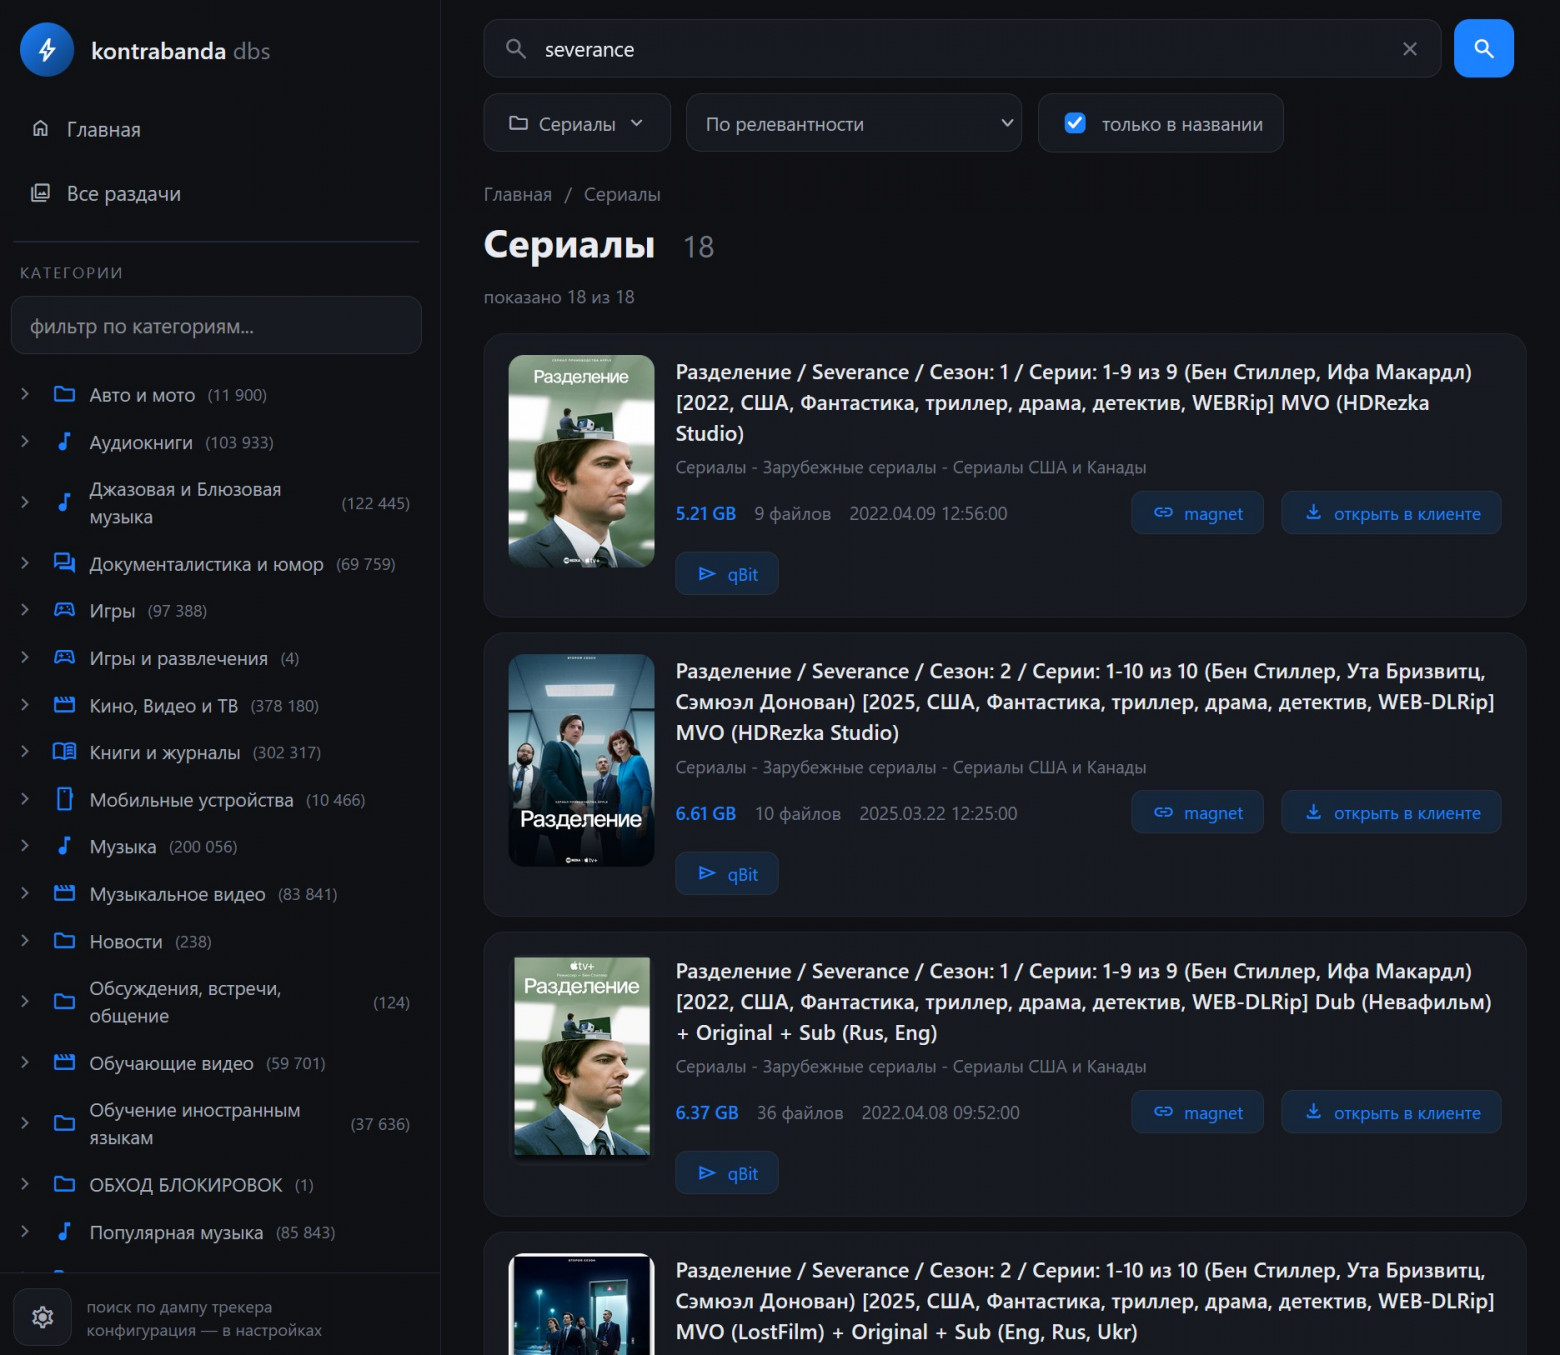
Ещё один пример — Kontrabanda-dbs. Мой небольшой проект, в котором я изучал работу с крупными базами данных и поиску по ним. За основу взята БД RuTracker, которую я под присмотром Клода научился парсить, переводить в SQLite и работать с модулем FTS5 для поиска с top-K.
Но после активной разработки Клод упёрся в лимиты, начал сбрасывать кэш, писать файл с нуля, а дальше обрываться на полуслове с окончанием дневных лимитов. Мой домашний Клод в виде Квена без проблем переваривает такие нагрузки. C ним я сделал приятный дизайн, интеграцию с qBitTorrent и его категориями, добавил карточки торрентов и разбил весь проект с одного питон-файла на логичные модули + веб фронт. Бонусом настроил сборку докер образа.
Подключаем к умному дому
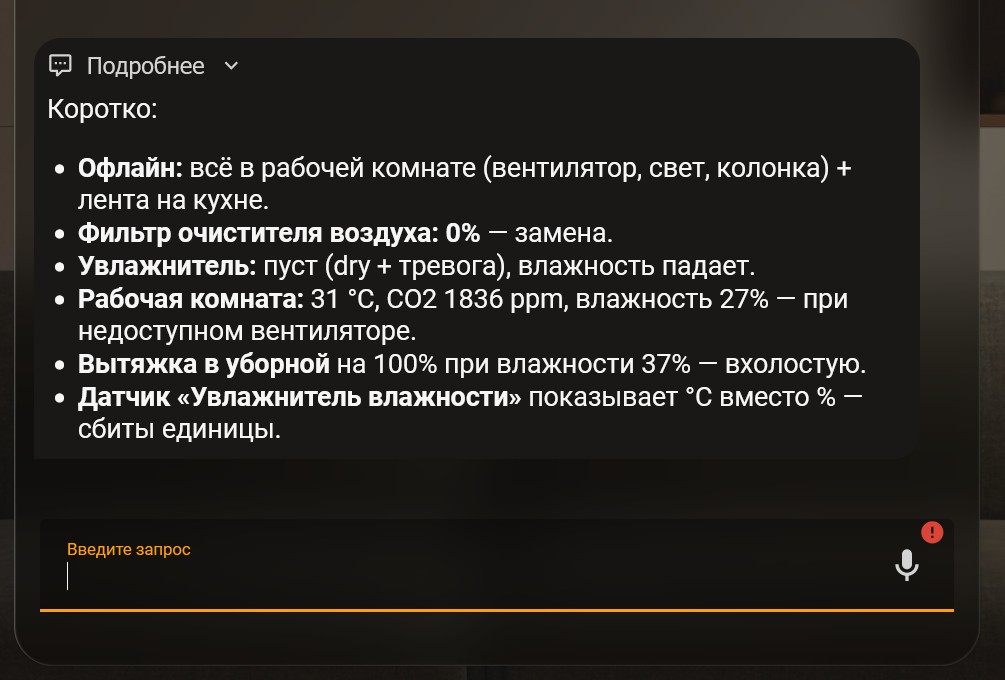
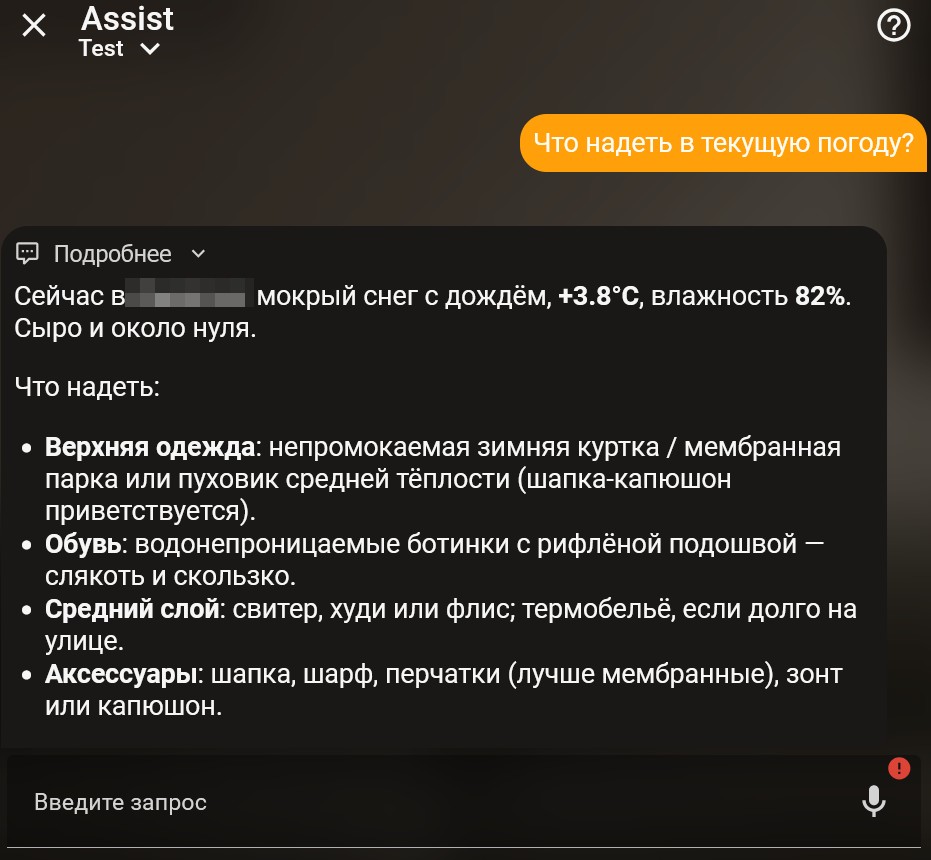
Конечно, такая огромная LLM для управления лампочками просто не нужна. Я уже экспериментировал с Qwen 3.5 9B и получил великолепные результаты, где эта маленькая модель отвечала просто молниеносно (если отключить размышления) и очень хорошо понимала задачи. Но что, если мы выдадим умному дому огромную и умную модель?
Отвечает она так же быстро, лампочками и техникой управляет без проблем. Но при этом аналитические возможности у неё явно лучше.
Собирать мощную систему хостинга LLM для умного дома точно не стоит, с этим справляются и более простые модели.
Бонусный контент — запускаем Strata на слабом процессоре и DDR3 памяти
DDR5 и топовый Ryzen — это, конечно, хорошо, но как Strata поведёт себя на старой платформе с дешёвой и медленной DDR3? Чтобы узнать это, я взял плату из прошлого обзора. В ней стоит достаточно слабый процессор Intel D1581 в паре с медленной DDR3L памятью в 2 канала (в тесте AIDA64 она развивает 20 Гбайт/сек и до 90 нс задержек), и SSD диском/видеокартой на PCIE GEN3 шине. Но при этом оставил карточку RTX 2000 ADA 16 GB.
Собрав всё это воедино в 2U сервер, я установил и запустил Strata. Оба этих сценария занимают заметно больше времени на слабом железе.
Результат ожидаемый: всё прекрасно работает, генерация идёт, модель всё такая же умная, как на более дорогом железе, но скорость заметно ниже.
На тот же сапёр ушло 3 минуты, работает с первого раза, выглядит приемлемо.
Генерация просела с 35–70 т/с до 19–55 т/с, сама видеокарта при этом недогружена и в активной работе потребляет 30–62 ватта вместо максимальных 70. Это говорит нам о том, что платформа не успевает готовить данные для ГПУ. Префил тоже сильно упал, 110–300 токенов в секунду — это, мягко говоря, мало. Что бы прочитать 60к контекста (половина от выставленных 120к), уйдёт более 3 минут.
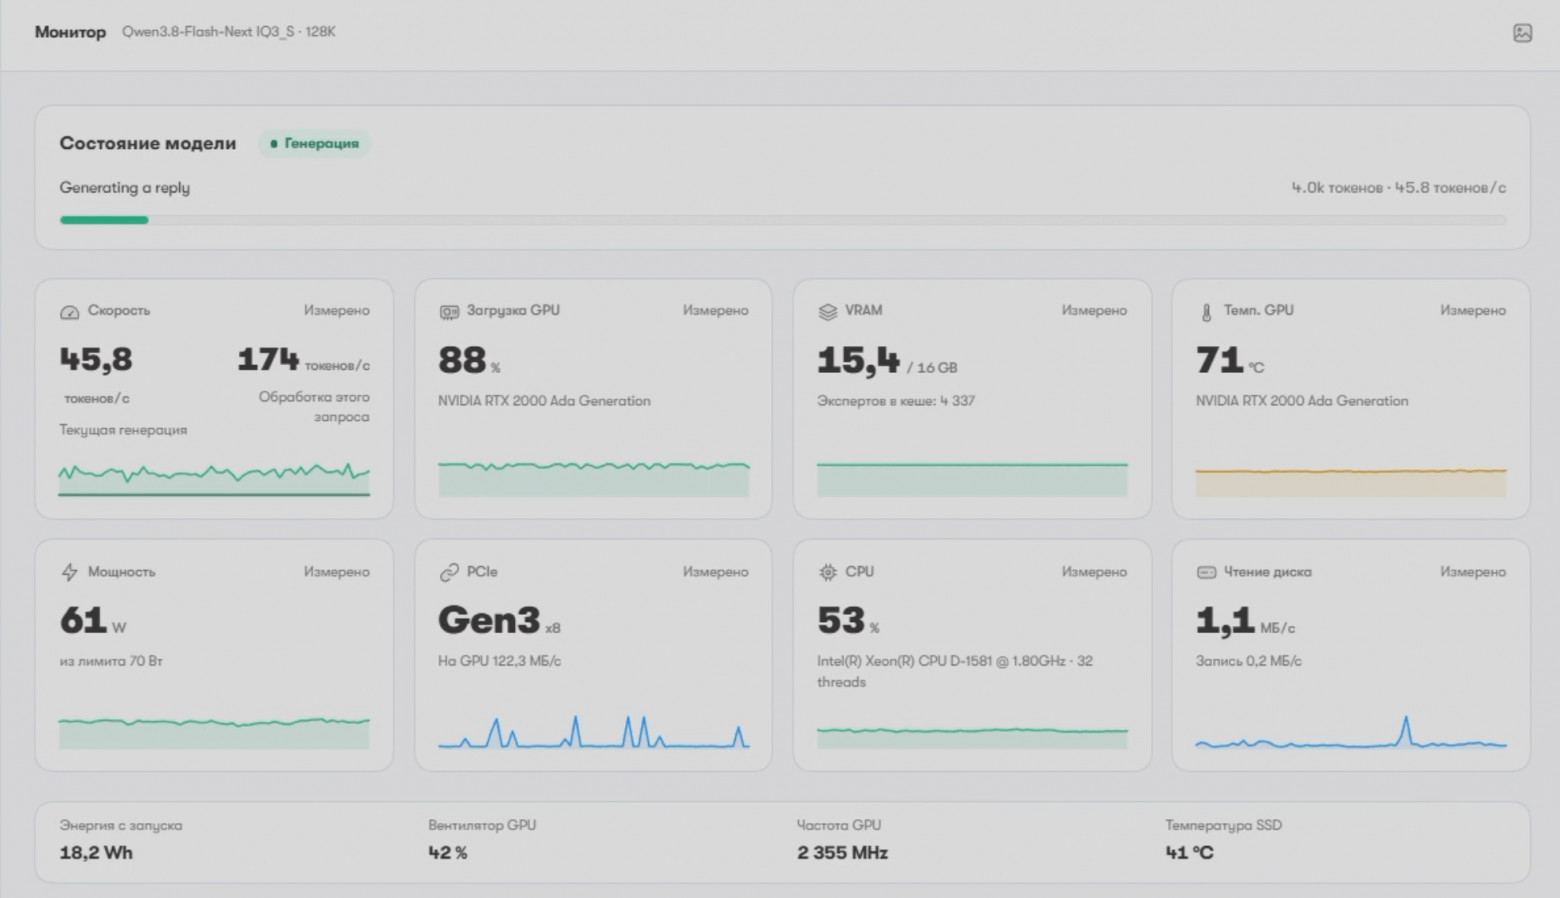
С такими результатами ставить что-то мощнее, чем 3060 на 12 ГБ, смысла нет. Зато есть смысл собрать бюджетную LLM машину на Nvidia P100. Энтузиасты уже провели тесты и получили около 30 т/с. Этого вполне достаточно для неторопливой работы с кодом.
Конечно, можно возразить: подписки! И да, модели по подписке будут лучше, контекст больше, и работают они быстрее. Но надолго ли? Особенно на фоне волн банов.
Выводы
Я долгое время относился к локальным LLM как к игрушкам. Ничего больше мелкого рефакторинга им отдать было нельзя. Но со Strata я первый раз почувствовал, что реально работаю и решаю задачи на своём железе, а не тестирую модельки. Конечно, это решение не совсем дешёвое, и есть свои нюансы с ручными настройками для получения максимальной скорости. Но порог входа в локальные LLM ещё никогда не был так низок. А их качество так высоко.
Поэтому скажу: дерзайте, пробуйте, это того на 100 % стоит, даже если у вас старое железо.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.