Модульность без микросервисов: почему она того стоит
Монолит пилят на микросервисы вводят ради четырёх обещаний: производительности, отказоустойчивости, чистых границ и независимых релизов. А потом оказывается, что команда одна, база одна, язык один, а сервисов больше, чем разработчиков, — и ни одно из обещаний толком не выполняется.
Ниже разберём каждое из четырёх обещаний и посмотрим, что происходит на практике.
Это первая из четырёх статей по мотивам моего доклада «Модульность без микросервисов в ASP.NET из коробки» на DotNext 2026:
Модульность без микросервисов: почему она того стоит (вы здесь).
Модульный монолит на штатном ASP.NET.
Как ломается модульный монолит и как с этим бороться.
eShop: запилить модульный монолит.
TL;DR
Микросервисы вводят ради четырёх обещаний: производительность, отказоустойчивость, чистые границы, независимые релизы. На практике каждое из них оборачивается издержками.
Вызов функции по HTTP или gRPC стоит в 3,5 раза больше ресурсов на запрос, чем вызов в процессе, через RabbitMQ — в 6,3 раза.
Google, сложив 11 микросервисов в один процесс, получил в 9 раз меньше ядер и в 14 раз меньшую задержку.
Отказоустойчивость хороша в теории: обработку отказов почти никто не тестирует. на практике каскадные отказы случаются чаще, чем хотелось бы.
Границы между сервисами затвердевают, API замерзают, а разные версии сервисов встречаются в продакшене. Две трети катастрофических отказов при обновлениях распределённых систем — как раз от этого.
Корень всех проблем в том, что логические границы (как написан код) и физические (как он развёрнут) проведены одной линией. Модули их разделяют.
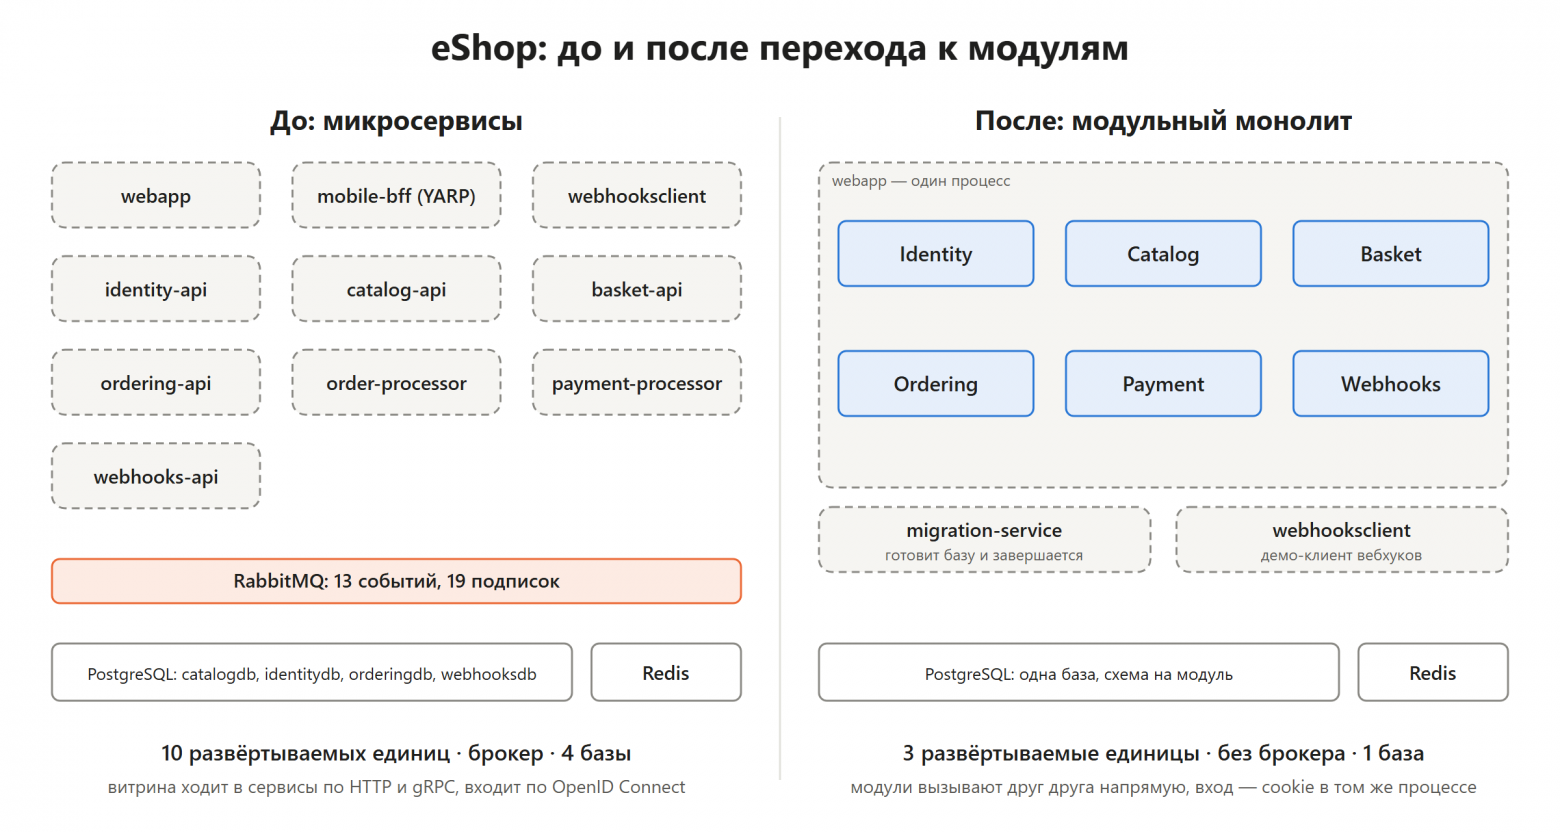
На eShop, эталонном микросервисном приложении Microsoft, переход к модулям дал −75% памяти, −81% CPU на старте, три развёртываемые единицы вместо десяти и −39% серверного кода. Ресурсы сэкономила сама миграция, код сократило удаление того, что нужно только распределённой системе. По дороге нашлись семь дефектов исходной версии.
Отдельный сервис действительно нужен в нескольких случаях. «В будущем понадобится масштабировать» среди них нет.
Что обещают микросервисы
Санджай Гемават, соавтор MapReduce и Bigtable, с коллегами из Google в работе «Towards Modern Development of Cloud Applications» (HotOS '23) опросили инфраструктурные команды Google: зачем приложения режут на отдельные сервисы? Причин оказалось четыре:
Производительность — бинарники масштабируются независимо, ресурсы используются лучше.
Отказоустойчивость — падение одного сервиса не роняет остальные.
Границы абстракций — у сервиса явный API, код меньше путается.
Гибкие выкатки — каждый бинарник релизится в своём темпе.
Заподозрить авторов в нелюбви к распределённым системам сложно. Тем не менее их вывод — некоторые проблемы микросервисов прямо противоречат этим обещаниям. Пройдёмся по каждому.
Производительность: налог на каждый вызов
Каждый вызов сервиса — это сериализация и поход по сети. Насколько это дорого, я решил померить.
Сколько стоит сложить два числа
Сценарий нарочно примитивный: функция, которая складывает два числа. Бизнес-логики в ней ноль, поэтому всё, что мы намеряем сверх прямого вызова, — чистая стоимость взаимодействия. Четыре способа её вызвать:
Прямой вызов внутри приложения.
HTTP — без JSON, ответ — просто число в теле.
gRPC.
RabbitMQ — RPC поверх очереди через EasyNetQ, настройки по умолчанию, у запроса TTL 60 секунд. Отвечающая сторона — hosted-сервис в том же веб-процессе, поэтому в колонку «веб» ниже попадают обе стороны обмена, а в колонку «бэкенд» — сам брокер.
Веб-приложение вызывает интерфейс и не знает, что за ним стоит:
public interface ICalculator
{
    Task<int> Add(int a, int b);
}
Четыре реализации отличаются только транспортом:
// В процессе
public Task<int> Add(int a, int b) => Task.FromResult(a + b);

// HTTP
public async Task<int> Add(int a, int b) =>
    int.Parse(await client.GetByteArrayAsync($"/add?a={a}&b={b}"));

// gRPC
public async Task<int> Add(int a, int b) =>
    (await client.AddAsync(new() { A = a, B = b })).Result;

// RabbitMQ
public Task<int> Add(int a, int b) =>
    rpc.RequestAsync<AddRequest, int>(new(a, b), c => c.WithExpiration(TimeSpan.FromSeconds(60)));
Везде одно и то же a + b. Всё, что сверх этого, — цена доставки двух чисел туда и ответа обратно.
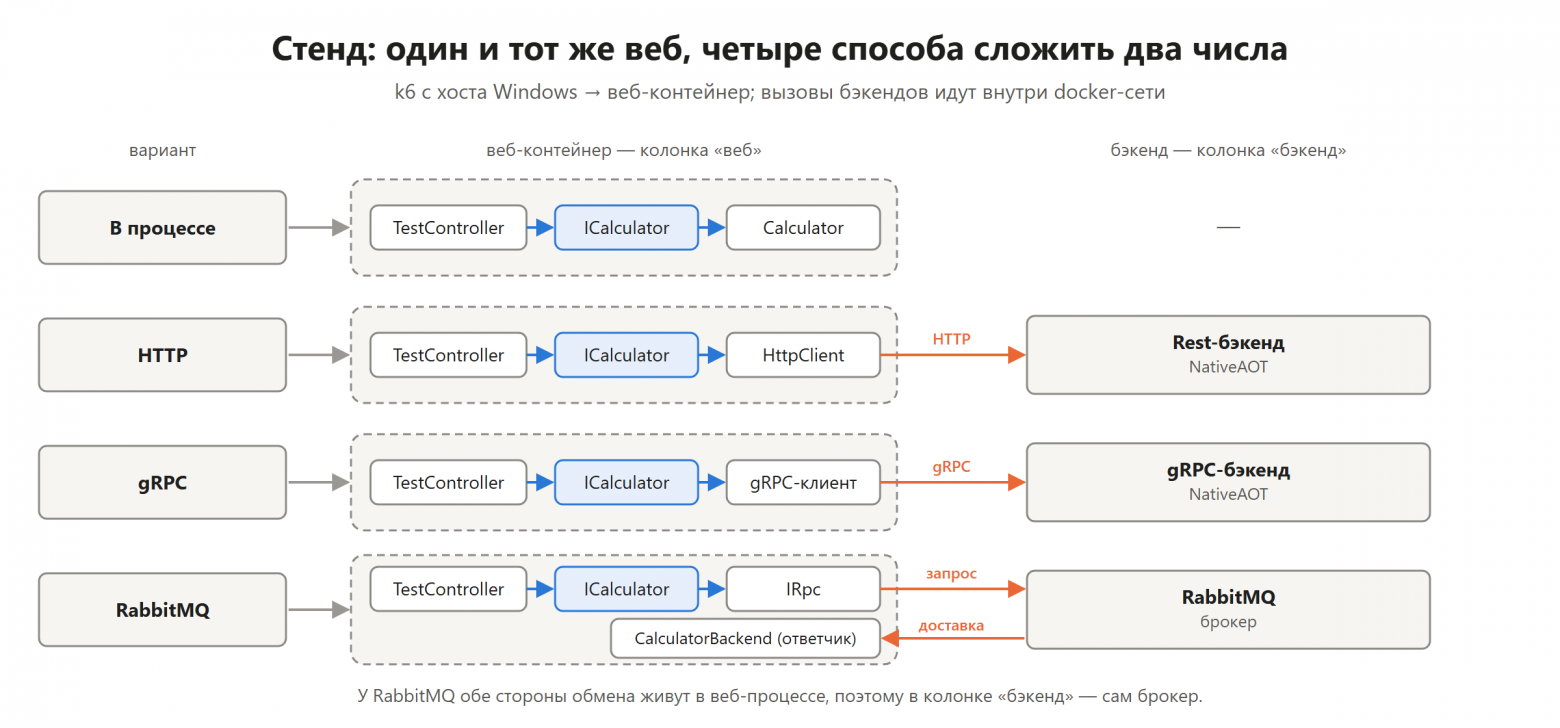
Бэкенды для HTTP и gRPC собраны с NativeAOT, чтобы им не в чем было проиграть. Веб-приложение, которое принимает запрос от нагрузки, во всех четырёх случаях одно и то же — без единой правки кода, — как это сделано, покажу в следующей статье.
Стенд: 12 CPU, 64 ГБ RAM, M.2 SSD, Windows 11 + WSL2. Все приложения вместе с RabbitMQ — в одном docker compose. Нагрузка — k6 v2.2.0 с хоста Windows: 250 виртуальных пользователей, 30 секунд на каждый вариант, перед замером — по одному прогревочному запросу. Путь трафика от k6 до веб-контейнера (проброс порта в WSL2) одинаков для всех вариантов, вызовы бэкендов идут внутри docker-сети. Сценарий — каждый запрос со случайными слагаемыми и проверкой ответа:
import { check } from 'k6';
import http from 'k6/http';

export const options = { duration: '30s', vus: 250 };

export default function () {
    const a = Math.trunc(Math.random() * 1000000);
    const b = Math.trunc(Math.random() * 1000000);

    const r = http.get(`${__ENV.URL}/test?a=${a}&b=${b}`);
    check(r, { 'status is 200': r.status === 200 });
    check(r, { 'answer is correct': parseInt(r.body) === a + b });
}
CPU и память — один снимок docker stats под нагрузкой, в середине прогона, не среднее. Каждый вариант прогонялся один раз, полные выводы k6 и docker stats лежат в репозитории (коммит b934693).
Вариант | Request/s | CPU %, веб | Память MiB, веб | CPU %, бэкенд | Память MiB, бэкенд |
|---|---|---|---|---|---|
Вызов в процессе | 20 243 | 214 | 69 | — | — |
HTTP | 14 398 | 445 | 126 | 125 | 38 |
gRPC | 14 820 | 459 | 150 | 96 | 21 |
RabbitMQ | 10 650 | 365 | 106 | 300 (брокер) | 137 (брокер) |
Сырые цифры сложно сравнивать: удалённые варианты обслуживают меньше запросов, но и тратят больше. Поэтому нормирую каждый показатель к вызову в процессе и делю на нормированный RPS — получается, во сколько раз больше CPU и памяти уходит на один запрос:
Вариант | RPS, отн. | CPU на запрос | Память на запрос | Среднее |
|---|---|---|---|---|
Вызов в процессе | 1,00 | 1,00× | 1,00× | 1,00× |
HTTP | 0,71 | 3,74× | 3,33× | 3,53× |
gRPC | 0,73 | 3,54× | 3,36× | 3,45× |
RabbitMQ | 0,53 | 5,90× | 6,69× | 6,29× |
CPU и память — величины разной природы, поэтому складывать их «в лоб» нельзя. Последний столбец — простое среднее двух нормированных показателей с равным весом: эвристика, чтобы свести всё к одному числу. Вывод от неё не зависит — оба показателя по отдельности говорят то же самое.
Задержки (k6 считает медиану и перцентили до p95):
Вариант | Медиана | p90 | p95 |
|---|---|---|---|
Вызов в процессе | 9,8 мс | 17,3 мс | 22,3 мс |
HTTP | 15,0 мс | 23,5 мс | 29,2 мс |
gRPC | 14,3 мс | 22,7 мс | 29,4 мс |
RabbitMQ | 21,2 мс | 30,9 мс | 36,8 мс |
При фиксированном числе виртуальных пользователей задержка и RPS связаны, так что это не независимое подтверждение, а та же картина с другой стороны.
HTTP и gRPC тратят в три с половиной раза больше ресурсов на запрос, чтобы вызвать функцию, которая складывает два числа. RabbitMQ — в шесть с лишним. Взаимодействие съедает ресурсы, а не бизнес-логика. Если сервисы ваши, команда одна, а данные в одной базе, — это чистый налог без покупателя.
То же на настоящем приложении
Тест с калькулятором легко отмести: «в реальной системе бизнес-логика тяжелее, сеть потеряется на её фоне». Поэтому в той же работе Google есть эксперимент на настоящем приложении.
Авторы взяли Online Boutique — эталонное демо от самого Google, интернет-магазин из 11 микросервисов на gRPC и Kubernetes. Исходное приложение написано на нескольких языках, поэтому для честного сравнения его сначала целиком портировали на Go, а потом ещё раз — на свой прототип, где каждый микросервис стал компонентом: логически обособленным модулем с интерфейсом, а в каком процессе его запустить, решает рантайм. Нагрузку давали генератором Locust с постоянным потоком HTTP-запросов, обе версии автоматически масштабировали число реплик под нагрузку. Мерили, сколько ядер приложение занимает в установившемся режиме и какая у него сквозная задержка:
Вариант, 10 000 QPS | Ядер CPU | Медианная задержка |
|---|---|---|
Микросервисы на gRPC | 78 | 5,47 мс |
Прототип, каждый компонент в своём процессе | 28 | 2,66 мс |
Прототип, все 11 компонентов в одном процессе | 9 | 0,38 мс |
Вторая строка — та же топология, что у микросервисов: для честного сравнения авторы ничего не совмещали. Выигрыш почти в три раза здесь дал не другой код, а другой транспорт. Большая часть ускорения — от формата сериализации, в котором нет ни номеров полей, ни информации о типах: такое возможно, только если все участники обмена гарантированно одной версии и заранее знают набор и порядок полей. Плюс упрощённый протокол прямо поверх TCP вместо gRPC.
А третья строка — то, ради чего стоит читать работу. Стоило сложить все компоненты в один процесс, и приложение стало в 8,7 раза дешевле и в 14 раз быстрее исходной микросервисной версии. Отсюда «до 9× дешевле и до 15× быстрее» в аннотации. Тот же результат, что в моём тесте с калькулятором, только на реалистичном приложении с настоящей бизнес-логикой. Авторы отмечают, что это совпадает с опытом индустрии, и ссылаются на Amazon Prime Video (затраты на сервис мониторинга упали на 90% после возврата в один процесс) и Segment (вернулся от микросервисов к монолиту).
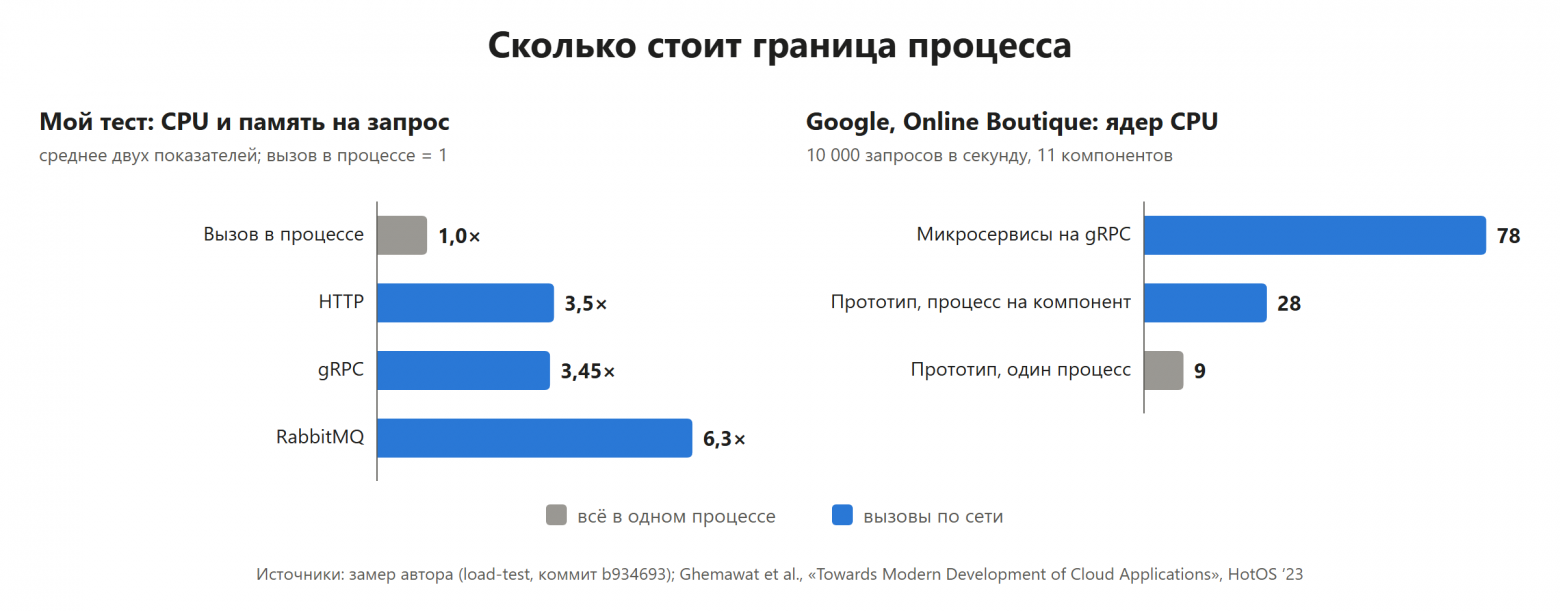
Выходит, первое обещание оборачивается своей противоположностью: производительность, ради которой резали, страдает первой. А при чрезмерном дроблении накладные расходы ещё и складываются: запрос пользователя проходит через несколько сервисов и платит налог на каждом переходе.
Отказоустойчивость: хороша в теории
Идея в том, что при падении одного сервиса функциональность деградирует, но приложение в целом остаётся доступным. На практике случаются каскадные отказы: ошибка или таймаут одного сервиса транслируется в ошибки остальных.
Устойчивость к отказам не появляется сама оттого, что код разнесён по процессам. Её должен сделать разработчик — и, главное, протестировать логику обработки отказов. А тестировать это дорого: собрать все сервисы, систематически ронять и поднимать их, проверять поведение. По наблюдению Google, так тестируют лишь малую долю микросервисных систем. Непротестированный circuit breaker изолирует сбои примерно так же, как его отсутствие.
Зато появляется класс ошибок, которого в одном процессе нет вовсе. Вызов упал по таймауту — повторить или вернуть ошибку? А если повторить, не выполнится ли операция дважды? Вызов метода в процессе по таймауту не падает.
Чистые границы: API замерзают
У сервиса явный API, и код меньше путается — это правда, пока API не нужно поменять. Опубликованный API трудно изменить, не сломав потребителей, поэтому старые версии живут вечно, а новые латают поверх. Поменяли контракт сервиса — меняйте всех клиентов.
Граница сервиса режет не только код, но и данные. JOIN в базе написать нельзя, поэтому джойнят в коде: тянут коллекции по сети или держат в каждом сервисе копию чужих данных и синхронизируют её. Транзакция между сервисами превращается в сагу с компенсациями, и данные всё равно расходятся.
Вот как это выглядит на простом отчёте — неоплаченные заказы старше трёх дней вместе с данными клиента. Когда заказы и клиенты в одной базе, JOIN делает база:
group.MapGet("/unpaid", (DbContext ctx) =>
    from o in ctx.Set<Order>()
    join c in ctx.Set<Customer>() on o.CustomerId equals c.Id
    where o.PaymentDate == null
    where o.OrderDate < DateTime.UtcNow.AddDays(-3)
    select new
    {
        OrderId = o.Id,
        o.OrderDate,
        Customer = new { c.Id, c.Name, c.Email }
    });
Когда клиенты живут в другом сервисе, JOIN делает приложение:
group.MapGet("/unpaid", async (DbContext ctx, HttpClient http, CancellationToken ct) =>
{
    var orders = await (from o in ctx.Set<Order>()
                        where o.PaymentDate == null
                        where o.OrderDate < DateTime.UtcNow.AddDays(-3)
                        select new { o.Id, o.OrderDate, o.CustomerId }).ToListAsync(ct);

    var ids = orders.Select(o => o.CustomerId).Distinct();
    var customers = await http.GetFromJsonAsync<CustomerDto[]>(
        $"http://customers/customers?{string.Join('&', ids.Select(i => "id=" + i))}",
        JsonSerializerOptions.Web, ct);
    var byId = customers!.ToFrozenDictionary(c => c.Id);

    return orders.Select(o => new
    {
        OrderId = o.Id,
        o.OrderDate,
        Customer = byId.TryGetValue(o.CustomerId, out var c)
            ? new { c.Id, c.Name, c.Email }
            : null   // клиент не нашёлся: у JOIN такого вопроса не было
    });
});

// Копия чужой сущности: её надо держать в согласии с оригиналом
record CustomerDto(int Id, string Name, string Email);
Во втором варианте появились поход по сети, DTO — копия чужой сущности, словарь в памяти и вопрос «что делать, если клиента нет». А если неоплаченных заказов наберутся тысячи, список идентификаторов перестанет помещаться в URL. Во второй статье я измерю и это: вариант с JOIN в приложении обслуживает на 11% меньше запросов, а кода в нём вдвое больше.
И главное: граница затвердевает. Разработчик режет приложение вручную и заранее — до того, как стало понятно, где на самом деле узкие места. Потом в код добавляются эндпоинты, клиенты, DTO, структуры данных, оптимизированные под сеть. После этого разрез трудно отменить или передвинуть, даже когда это имеет смысл. Чистая граница, проведённая не в том месте, — это не управление сложностью, а её консервация.
Независимые релизы: версии встречаются в продакшене
Каждый сервис выкатывается в своём темпе, а значит, в продакшене всегда одновременно живут разные версии. Протокол между ними приходится версионировать, а форматы данных — делать совместимыми, а не удобными. Рассуждать о том, как взаимодействует каждая развёрнутая версия каждого сервиса, невозможно.
Это не теоретическая проблема. В исследовании более ста катастрофических отказов восьми популярных распределённых систем две трети вызваны взаимодействием разных версий (Zhang et al., SOSP '21).
У независимости есть и обратная сторона. Изменение, которое затрагивает несколько сервисов, нельзя выкатить атомарно — его приходится планировать под чужие релизные циклы: «сначала выкатим v2 рядом с v1, потом переключим клиентов, потом удалим v1». Вместо одного приложения — много, у каждого своё расписание. Запустить всё одной кнопкой нельзя, а e2e-тест на локальной машине превращается в инженерный подвиг.
Корень проблемы
Все четыре истории сводятся к одной причине. Google формулирует её фразой, которую стоит повесить над столом: микросервисы «conflate logical boundaries (how code is written) with physical boundaries (how code is deployed)» — смешивают логические границы (как написан код) с физическими (как он развёрнут).
Логическая граница — это модуль, интерфейс, контракт. Она нужна, чтобы код не путался.
Физическая граница — это процесс, сеть, отдельный деплой. Она нужна для изоляции, отдельного масштабирования, разных релизных циклов.
Микросервисы проводят обе границы одной линией, раз и навсегда. Вместе с полезной логической границей приложение получает все издержки физической: налог на вызов, версии в продакшене, затвердевшие разрезы.
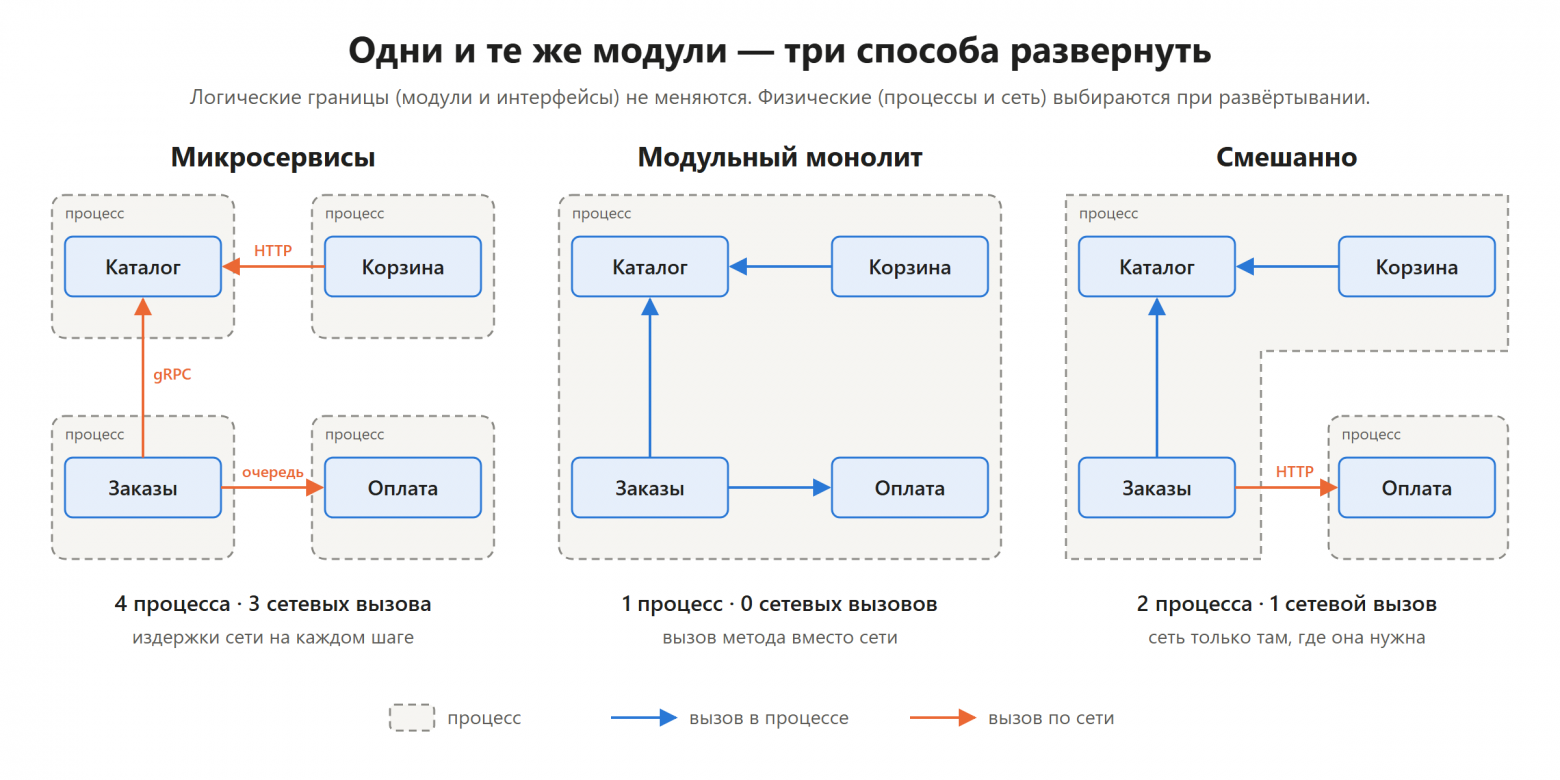
Отсюда три принципа:
Писать приложение, разбитое на логически обособленные модули. Границы в коде нужны.
Решать, какие модули в каких процессах, отдельно и позже — когда станет понятно, где на самом деле узкие места.
Выкатывать всё одной версией, чтобы разные версии модулей никогда не встречались.
Если модули при этом работают в одном процессе, налог на вызов исчезает, а e2e-тест становится обычным тестом, который можно запустить по F5. Тогда и обработку отказов наконец можно тестировать автоматически.
Важная оговорка. Одна версия кода не спасает от базы данных: персистентные данные по определению переживают версии кода, так что миграции всё равно должны быть совместимы с предыдущим кодом. И если модули всё-таки разнесены по разным машинам, фундаментальные проблемы распределённых систем никуда не деваются. Модульность убирает издержки распределённости там, где она не нужна, но не отменяет её там, где она нужна.
Проверка на полноценном .NET-приложении: eShop
Калькулятор — синтетика, а Online Boutique — на Go. Мне хотелось проверить принципы выше на обычном .NET-приложении, которое писали под микросервисы, а не под модули. Я взял eShop — эталонное приложение, которое рекомендует Microsoft для изучения: семь сервисов, BFF для мобильного клиента, RabbitMQ, четыре базы, всё на Aspire.
Работа шла в два этапа. Сначала миграция: каждый сервис стал модулем, все модули — в одном процессе с одной базой, код почти не менялся. Потом упрощения: про каждый слой я задавал один вопрос — зачем он здесь, если сети больше нет? До и после мерил одной процедурой на одной машине: чистый старт, минута простоя, e2e-сценарии на Playwright с проверкой, что заказ дошёл до оплаты; медиана трёх прогонов. Подробно о миграции — в четвёртой статье, здесь — итоги.
Железо
Показатель | Микросервисы | Модули | Изменение |
|---|---|---|---|
Память приложений и контейнеров в простое, МБ | 1 606 | 391 | −75% |
CPU приложений на старте, с | 34,4 | 6,6 | −81% |
CPU приложений за прогон e2e, с | 17,9 | 7,9 | −56% |
Длительность e2e, с | 15,5 | 12,1 | −22% |
Развёртываемых единиц | 10 | 3 | |
Контейнеров инфраструктуры | 4 | 2 | |
| 143,6 | 94,9 | −34% |
Основное дала сама миграция, ещё до всяких упрощений: базовая цена .NET-процесса платится один раз, а не девять. Рабочий набор процессов сократился с 1 292 до 332 МБ. Остальное — инфраструктура, которая стала не нужна: без RabbitMQ контейнеры занимают 70 МБ вместо 194. Это тот же налог, что в тесте с калькулятором, только теперь он посчитан на приложении с настоящей бизнес-логикой и в мегабайтах, за которые платят каждый месяц.
Код
Серверного кода стало на 39% меньше — 6 205 авторских строк вместо 10 244, а цикломатическая сложность упала на 45%. Самое интересное — откуда это взялось. Сама миграция сократила код на 0,6%. Всё остальное дало удаление того, что существовало только ради распределённости:
13 интеграционных событий и 19 подписок → ноль. RabbitMQ удалён целиком. Там, где получатель пишет в ту же базу или просто отвечает на вопрос, событие стало вызовом метода.
Сага заказа из семи событий через четыре сервиса → один класс, который читается сверху вниз. Оплата и списание остатков теперь одна транзакция, а не цепочка с компенсациями, которая приводила к багам.
Конвейер MediatR вокруг одного вызова — 8 команд, 8 обработчиков, 3 behavior — стал одним сервисом.
Вход по OpenID Connect от витрины к Identity, работающему в том же процессе: цепочка перенаправлений, обмен кода и запрос userinfo — HTTP-запросы приложения к самому себе. Стал обычный cookie, а модуль Identity сократился с 2 308 до 853 строк.
Сагу заказа стоит показать. Было — семь событий через четыре сервиса, и чтобы понять, как заказ доходит до оплаты, нужно было собрать картину из шести классов:
OrderProcessor   SELECT … FROM ordering.orders  (сырой SQL по чужой таблице)
  → GracePeriodConfirmed       → Ordering: SetAwaitingValidation
  → AwaitingValidation         → Catalog: проверка остатков, по запросу на строку
  → StockConfirmed / Rejected  → Ordering: SetStockConfirmed / Rejected
  → StockConfirmed             → Payment: решение об оплате
  → PaymentSucceeded / Failed  → Ordering: SetPaid / Cancel
Стало — один класс, который читается сверху вниз:
OrderFulfillment.ProcessAsync(orderId)
  Submitted          → SetAwaitingValidation
  AwaitingValidation → ICatalogStock.CheckStockAsync   (один запрос с IN)
                       → SetStockConfirmed | SetStockRejected
  StockConfirmed     → IPaymentApi.ProcessPaymentAsync
                       → SetPaid | CancelOrder
Каждый шаг читает статус заказа и делает то, что ему соответствует, поэтому заказ, брошенный на полпути, подхватывается на следующем проходе. Компенсации не нужны: оплата и списание остатков либо проходят вместе, либо не проходят вовсе.
Это иллюстрация к «границе, которая затвердевает». Разрез eShop на сервисы оброс событиями, сагами и протоколами, и пока сервисы были сервисами, всё это было необходимо. Стоило убрать физическую границу и оставить логическую, как четыре тысячи строк оказались ненужными.
Надёжность и дефекты
Пункт про отказоустойчивость, которую никто не тестирует, на eShop подтвердился буквально. Потребитель шины терял сообщение, если обработчик бросал исключение, а упавшие записи outbox никто не переотправлял. В модульной версии изменение статуса заказа пишется в outbox в той же транзакции, а доставка подписчикам в процессе повторяется, пока не пройдёт.
А при разборе модуля заказов нашлись семь дефектов исходной версии. Самые неприятные:
обёртка команды глотала исключение через
catch { return default; }, а транзакция всё равно коммитилась: API отвечает 200, заказа нет, повторить его нельзя — повтор считается дублем. Годами это прятал тест, который отправлял заказ с просроченной картой и проверял только код ответа;GET /api/orders/{id}не проверял владельца: любой вошедший пользователь читал чужие заказы перебором номеров;отменить чужой заказ или «отгрузить» любой оплаченный мог любой вошедший пользователь.
Модульность сама по себе эти дефекты не исправляет: они были в исходном коде и переехали вместе с ним. Но первый из них жил как раз в обвязке, которая нужна была только распределённой системе, и обнаружился, когда её стали удалять. Чем меньше слоёв между запросом и бизнес-логикой, тем проще увидеть, что она на самом деле делает.
Когда сервис всё-таки нужен
Разговор о налоге был бы нечестным без списка случаев, когда за отдельный сервис платить надо. Вот шесть настоящих причин:
Другой язык или фреймворк — тут очевидно.
Отдельная команда со своим релизным циклом.
Изоляция как смысл — комплаенс, blast radius, мультитенантность.
Другой профиль нагрузки — уже сейчас, а не «в будущем».
Другой SLA и другой change-management.
Специальное хранилище, которое решает бизнес-задачу, — durable-очередь, поисковый индекс и т. п.
Google называет почти те же: приложение переросло одну команду, частям нужны разные релизные циклы. Обратите внимание, чего нет ни в одном из списков: «в будущем понадобится масштабировать» и «так модно».
Если причина появится, выделить сервис из хорошо разделённого монолита проще, чем что-либо ещё: границы уже проведены, остаётся поменять транспорт.
А теперь вопрос к вам. Возьмите свою систему и пройдитесь по сервисам: у скольких из них есть причина из этого списка? Сколько сервисов у вас останется, если оставить только их? Напишите в комментариях два числа — сколько сервисов сейчас и сколько осталось бы. Мне правда интересно, какая получится статистика.
Что дальше
Три принципа выше Google реализовал фреймворком Service Weaver со своим кодогенератором, RPC и рантаймом — и в 2024 году отправил его в архив.
В следующей статье я покажу, что в ASP.NET Core те же свойства собираются штатными средствами: код разбит на модули, состав процесса задаётся переменной окружения, один Docker-образ обслуживает и монолит, и набор сервисов. Для этого не нужно тащить в код фрейморки или переписывать код. Решение «резать или не резать» перестаёт быть необратимым — его можно пересмотреть одной строчкой в compose. Там же разберём, почему у Google не получилось.
Материалы
Доклад: Модульность без микросервисов в ASP.NET из коробки — DotNext 2026
Исходное приложение для миграции: dotnet/eShop
Нагрузочный тест: load-test в репозитории доклада — код, compose, выводы k6 и
docker statsРабота Google: S. Ghemawat et al. Towards Modern Development of Cloud Applications, HotOS '23 (CC BY 4.0); фреймворк Service Weaver
Исследование отказов при обновлениях: Y. Zhang et al. Understanding and Detecting Software Upgrade Failures in Distributed Systems, SOSP '21
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.