TabPFN 3.5 — модель работы с табличными данными, умеющая в Фурье-препроцессинг, тестируем по SDD (OpenSpec + OpenCode)
Наконец-то приехала фундаментальная модель, заточенная под работу с табличными данными и уже в базе умеющая препроцессить сырые данные. И у меня дошли руки ее потестировать.
Технический отчёт: https://arxiv.org/abs/2609.17895
Обзор отчёта: https://arxiviq.substack.com/p/tabpfn-35-technical-report
Код (pip-пакет
tabpfn): https://github.com/PriorLabs/TabPFNВеса модели: https://huggingface.co/Prior-Labs/tabpfn_3_5
А у меня как раз такие данные, которые идеально подходят для теста этой модели: записи отсчетов измерений напряжения с умной розетки в разных сценариях энергопотребления. Нюанс этих данных в том, что их, конечно, можно интепретировать как временные ряды, но гораздо эффективнее извлекать из них FFT-спектры и работать уже с частотным представлением. В посте двухгодовалой давности лучшие результаты показал ансамбль катбустов в составе фреймворка Light Auto ML - именено после предварительного процессинга табличных данных и переходом от временного представления (Time Series) к частотному через быстрое преобразование Фурье (FFT).
Увы, руки уже не столько мои, сколько кодингового агента, но на этот раз я взял на вооружение SDD (Specification-Driven Development) в реализации OpenSpec. Из прошедших через мои руки бесплатных и условно-бесплатных альтернатив самому популярному агенту на букву "К" я остановился на OpenCode как самой продвинутой на текущий момент (из тех, что успел "пощупать"). Сразу оговорюсь - многое зависит от того, какая конкретно модель используется внутри OpenCode, буквально вчера я решал другую задачу с помощью MiniMax 3.1-Flash, и пришлось править две ошибки, а сегодня GLM-5.3-Flash меня приятно удивила быстротой, точностью выполнения моих инструкций - и отсутствием ошибок (кроме одного нюанса, который был обнаружен экспериментальным путем). Ну и, конечно, следование подходу SDD.
Результат будет хз, если не было... спецификаций
Сам подход, безусловно, не нов. Но он предоставляет мощную подпорку для работы белковых разработчиков с искусственными нейронными сетями: во-первых, он заставляет четко формулировать задачу. Кажется очевидным, но давайте будем честны в ответе на вопрос - а мы сами-то всегда ли четко артикулируем то, над чем работаем? Для тех, кто не застал СССР, хочу напомнить старый советский анекдот, отражавший дефицит суперкомпьютеров в Советском Союзе:
Американский физик спрашивает у советского: "Как вам удается достигать таких высоких результатов в науке, ведь ваши компьютеры сильно отстают от наших?" На что тот отвечает: "Все просто: вы садитесь за компьютер и думаете над каждым его ответом, а мы сначала думаем, а потом уже садимся за компьютер".
Тут тоже самое. Сначала подумай, какую задачу ты хочешь решить. Какие есть ограничения. Какие ожидания. И только после этого запускай команду /opsx-proposal или /openspec-proposal.
Provided arguments: ## Цель: протестировать новую модель TabPFN-3.5 на данных о сценариях потребления энергии пользователями.
## Задача: создать .ipynb ноутбук
## Ресурсное ограничение: .ipynb ноутбук должен работать в Google Colab
## Описание TabPFN-3.5:
# Информацию о модели можно взять из статьи: https://arxiv.org/abs/2609.17895 и ревью к ней https://arxiviq.substack.com/p/tabpfn-35-technical-report
# Код можно взять в репозитории https://github.com/PriorLabs/TabPFN
# А саму модель из https://huggingface.co/Prior-Labs/tabpfn_3_5
# Я не вижу размера модели на HF, поэтому первый же вопрос: требуется ли GPU или можно запустить на CPU?
# Второй вопрос: если все-таки требуется GPU, влезет ли она в T4, доступный в Google Colab?
## Данные для проверки
# Пример загрузки данных из монтируемого Google Drive описан в ноутбуке TimesFM3_DeepSeek.ipynb - он лежит в папке проекта
# Если требуется предобработка данных - смотри на структуру данных в этом ноутбуке.
## Дополнительно: избегай установки лишний пакетов - минимизируй зависимости.
# После генерации ноутбука проверь на наличие лишнего кода, удаляй неиспользумый код и импорты
# Каждую ячейку снабжай подробным комментарием: что здесь проиходит и зачем это нужно.
# Также не забывай снабжать описания классов docstring и комментариями.
# Разбивай секции markdown-ячейками.
После того как агент отработает, стоит проверить артефакты генерации спефикации в папке /openspec/changes - ищем там proposal.md и tasks.md.
Второй аспект полезности SDD: когда у агента переполняется окно внимани, он сжимает (суммаризирует) текущую сессию - и перезапукается. При перезапуске он подгражует себе Guardrails и прочие настройки системного промта (при желании их можно найти и подшаманить), а также саммари контекста сессии и спецификации. Если вы используете локальные модели с небольшим окном контекста, то перезапускаться агент будет часто. Поэтому чем давать комментарии по ходу исполнения, которые будут как-то суммаризироваться, лучше сразу записать их в спецификацию.
У нас почти все получилось. Но всплыл нюанс:
TabPFNLicenseError: TabPFN requires a one-time license acceptance to download
model weights for local inference, but no interactive terminal
is available.
Агент утверждает, что этого не было в документации:
Interesting: the README/HF card I fetched didn't mention this — but the FAQ had "How do I use TabPFN without an internet connection?" and "How do I get access to TabPFN-2.5/3/3.5?" questions. The error message explains the flow: register at https://ux.priorlabs.ai, accept license, copy API key, set TABPFN_TOKEN env var before fit().
Options:
1. User accepts license once at ux.priorlabs.ai, gets API key, sets
os.environ["TABPFN_TOKEN"]in a Colab cell before evaluation. I should update the notebook to handle this: add a config cell (early) where user pastes their API key or it checks TABPFN_TOKEN, with clear Russian explanation, without breaking the "Run All" neutral flow.2. Alternative: check if HF token works — the error mentions
try_browser_login(gui_url, hf_repo_id=...). In old tabpfn versions, downloading from HF worked anonymously (the model card earlier versions had no gating). Apparently for 3.5 the package introduced license-gating with API keys.
Но, на самом деле, агент не совсем прав - веса можно скачать напрямую с HuggingFace, они там реально выложены и их можно скачать без авторизации. Но для этого надо влезть в импортируемый пакет tabpfn и переделать загрузку весов. Агент пошел по первому пути, предложив зарегаться на сайте Prior Labs (поставщиков пакета), получить API Key и добавить его в секреты Colab-ноутбука. Аплодирую Prior Labs - молодцы, грамотно придумали способ сбора статистики загрузок, независимый от HF. Ну а для себя - отмечу еще идин пункт в будущих спефикациях.
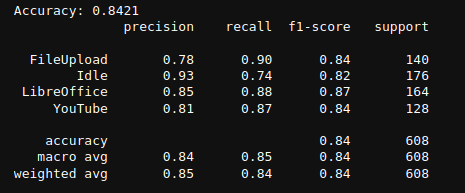
Ну, собственно, все. Модель отработала:
И модели удалось превзойти по макроусредненной F-мере baseline: ансамбль катбустов (с которого все начиналось) - пусть и немного, всего на 1 процент. Пожалуй, запишу себе модель в список проверенных инструментов для классификации табличных данных.
Код опубликован в репозитории https://github.com/Archelephant/TabPFN_w_OpenSpec
З.Ы. А вот знаете, что я забыл добавить в спецификацию перед пушем в Github? Можете накидать мне в комментариях...
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.