Code as Policy: как LLM управляет роботом через сгенерированный код
Привет, Хабр! Сегодня мы поговорим о том, как нейросети могут эффективно управлять роботами, используя не самый очевидный на первый взгляд подход.
В 2023 году Alphabet закрыл проект Everyday Robots, в котором пытались создать робота для уборки офисов и сортировки мусора. Увы, андроиды оказались не способны выполнять задачи в сложной и изменчивой обстановке естественной человеческой среды. Но благодаря этой попытке появилась технология Code as Policy (CaP), продолжившая свое развитие как отдельное направление. Ее принцип прост — LLM сама пишет код, который управляет манипулятором.
Попробуем разобраться, как устроен подход CaP и как его проверяет свежий бенчмарк CodeActionBench, вышедший в конце сентября. А также где метод работает, где ломается и почему «робот, который программирует сам себя» перестал быть маркетинговым слоганом.
Интерфейс между смыслом и движением
В классической робототехнике, к которой мы все привыкли, можно выделить два полюса. При традиционном подходе инженер пишет код, жестко задающий порядок действий для манипулятора. Альтернативой ему является end-to-end обучение, когда нейросеть получает пиксели и выдает углы сервоприводов.
У каждого из этих подходов есть свои плюсы и минусы. Первый жестко фиксирует логику работы робота, сводя к минимуму появление сюрпризов. А второй дает слишком много свободы управляемому устройству.
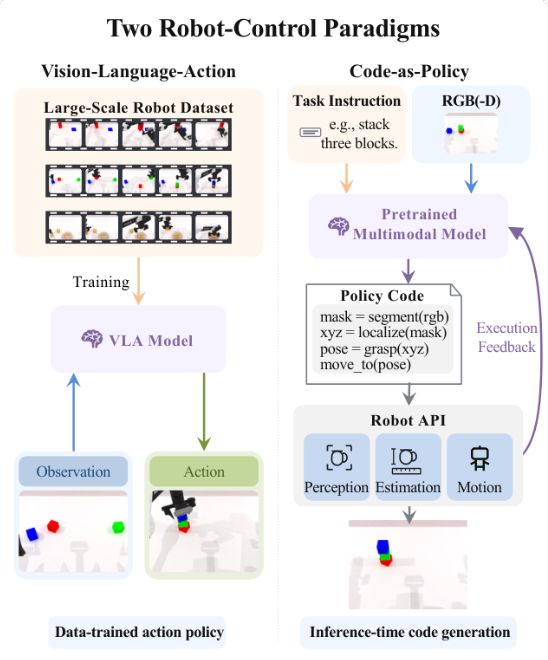
Подход Code as Policy предлагает третий путь, при котором языковая модель получает инструкцию на естественном языке («положи кубик на красный стол») и описание API робота (функции вроде get_object_position(), move_to(), close_gripper()). На выходе мы получаем исполняемый код на Python, который вызывает эти функции в правильном порядке.
Этот подход принципиально меняет роль модели. Она теперь рассуждает о задаче и выражает это рассуждение в структурированной форме, а не учится управлять моторами напрямую. А код выступает в роли интерфейса между семантикой (что значит «положить») и физикой (какие именно вызовы API это реализуют).
Чем хорош CaP
Ключевым преимуществом CaP является интерпретируемость и отлаживаемость. Если робот не справился с задачей, вы можете открыть сгенерированный код и увидеть, где именно модель ошиблась. Например, перепутала координаты, не учла препятствие или забыла открыть захват. В то время как у VLA-модели можно увидеть только неверный вектор действий и никакой конкретики.
Второе преимущество — композициональность подхода CaP. Так, один раз написав функцию pick_up(object), вы можете использовать ее в разных задачах. А языковая модель сгенерирует готовые политики с параметрами, которые принимают аргументы и адаптируются к ситуации.
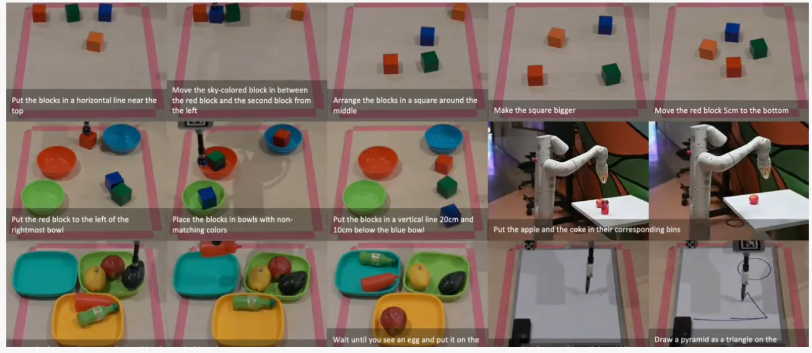
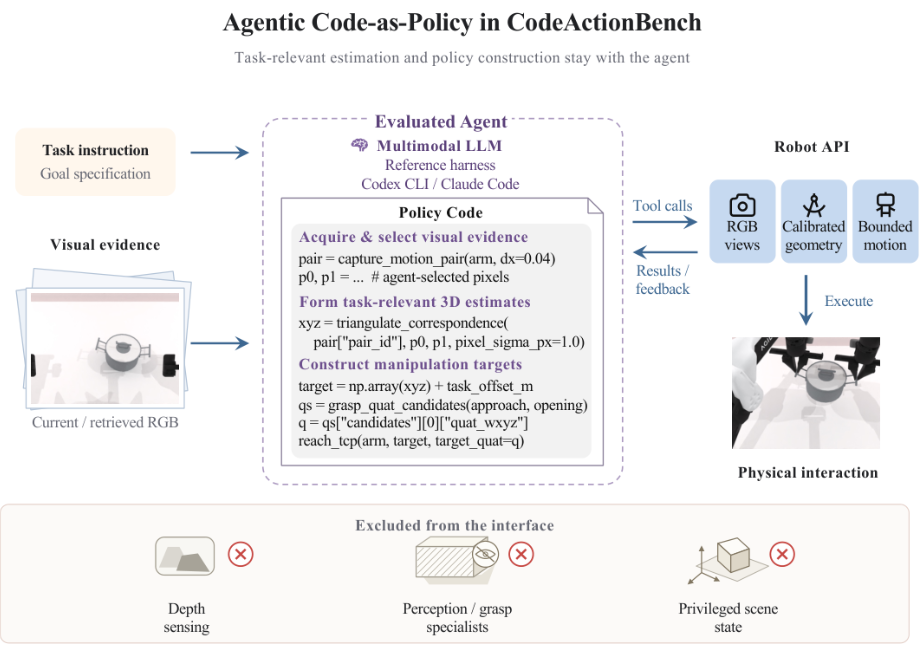
И еще одно важное преимущество — нулевое дообучение. Подход CodeActionBench специально лишает агента демонстраций и специализированных модулей восприятия. Все обучение происходит через промпт и итеративное переписывание кода на основе обратной связи.
Когда одного раза недостаточно
Наверняка многие читатели, дочитавшие до этого места, задались вопросом, почему нельзя просто один раз написать скрипт? Дело в том, что если бы CaP работал в режиме «пользователь сказал, модель послушно написала код, а робот также послушно выполнил», успешность такого действия была бы близка к нулю.
Реальная сила подхода раскрывается в агентном цикле, основой которого является наблюдение. Агент получает RGB-изображение и текущее состояние системы. Затем, на основании полученных данных модель пишет программу, вызывающую API.
На следующем этапе исполнения программа запускается, и по завершении выполнения агент смотрит на обратную связь. Какие возникли ошибки в процессе работы: например, объект не сдвинулся или захват не удался. Все эти сбои анализируются, затем модель корректирует код и пробует снова.
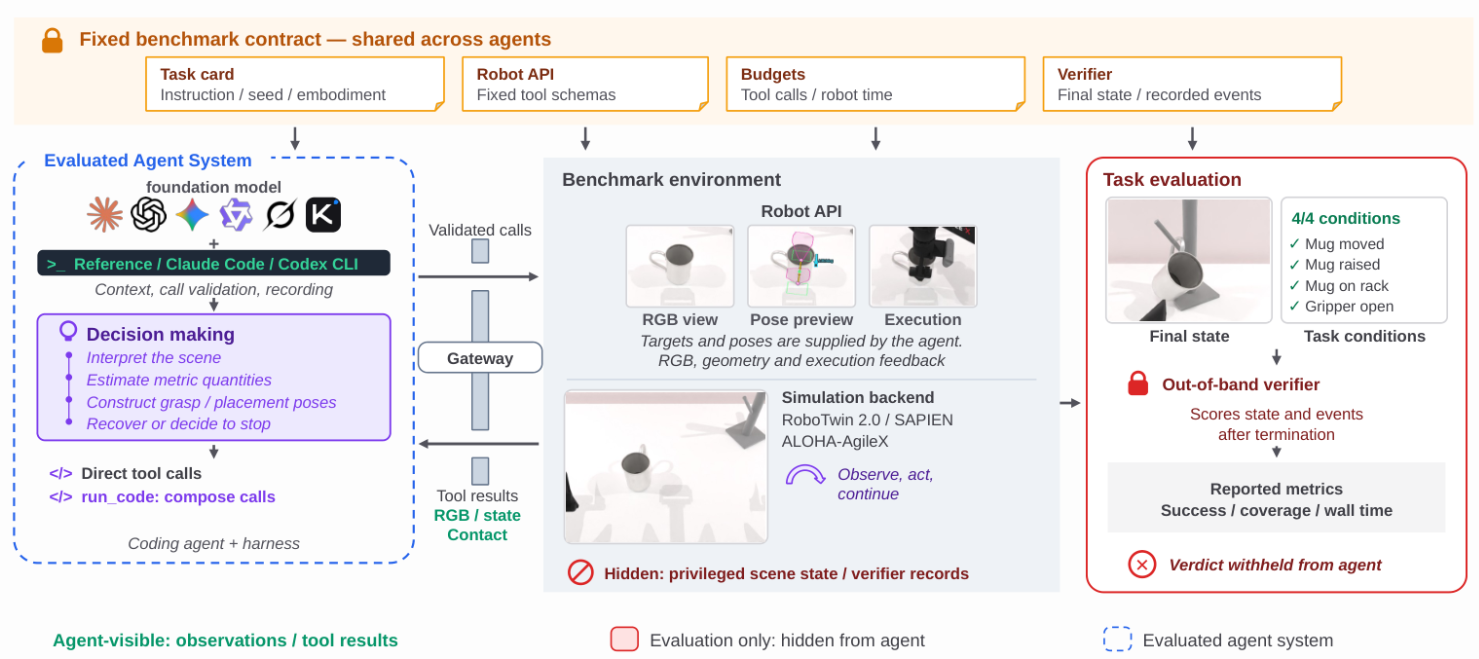
Именно этот цикл позволяет наиболее мощным моделям (например, GPT-6 Astra с Codex CLI) решать 22 из 25 задач хотя бы раз за три попытки. Без итеративной адаптации кода под происходящее вокруг результат был бы значительно скромнее.
Но здесь же кроется и главная проблема реального использования CaP. Анализ траекторий в CodeActionBench выявил ситуации, когда агент считал задачу выполненной, а по факту этого не было. Например, модель успешно завершила все движения, но объект остался на месте или упал. То есть выполнение скрипта еще не означает достижения цели.
Когда CaP ломается
Первой проблемой является пространственное выравнивание. Языковые модели хорошо понимают, что нужно сделать (поднять, перенести, поставить), но плохо представляют, где находится предмет. Фраза «красный кубик слева от синей чашки» вроде бы звучит понятно, но ее нужно перевести в точные координаты с уч етом перспективы камеры и калибровки. И если ошибиться, робот схватит воздух, но доложит об успешном выполнении задачи.
Еще захваченный роботом объект может выскользнуть при движении и сбежать защищать человечество дальше. Сгенерированный код редко учитывает необходимую силу сжатия и прочее. Что логично, так как LLM не получает в реальном времени данные о трении, ускорении и не имеет встроенной физической модели.
Третьей проблемой является неточность оценки завершения. Система может выполнить все движения правильно, но не подтвердить решение задачи. Или поставить объект на нужное место и определить это как провал. Успех в манипуляции — это изменение физического состояния мира, и при CaP робот не всегда может правильно его распознать.
Это подтверждается в исследовании RoboProcessBench (2026). VLM-модели, используемые как визуальные критики в робототехнических пайплайнах, не умеют оценивать процесс выполнения. Они видят финальный кадр, но не замечают, что контакт был неверным, выравнивание сбилось, а порядок примитивов нарушен.
Что это значит для будущего робототехники
Code as Policy не является заменой VLA-моделям. Это просто дополнение, занимающее свою нишу при выполнении определенных задач робототехники.
Проблема данных для VLA при этом решается отдельно. Недавно у нас в блоге выходил материал про AgenticFocus: пайплайн, который превращает обычное видео от первого лица в датасет для обучения гуманоидных роботов, без motion-capture и перчаток с датчиками. Если такие датасеты станут доступнее, у CaP останется меньше преимуществ в скорости старта.
CaP будет незаменим там, где нужна быстрая адаптация к новой задаче без сбора данных. Вы можете за пять минут написать промпт с описанием API и получить работающего агента для новой манипуляции. А вот для того, чтобы использовать VLA-модель, вам потребуются тысячи траекторий и долгие часы обучения. Хотя это тоже можно обойти, используя существующие VLA-модели и модульный агентный подход, позволяющий генерировать будущие действия робота прямо из картинки и текста. Также CaP будет выигрывать в задачах, где нужна интерпретируемость и отладка. Но проиграет там, где нужна физическая точность и надежность.
И здесь будущее, вероятно, за гибридными архитектурами, в которых CaP будет использоваться для высокоуровневого планирования и генерации политик, а VLA или классические контроллеры — для низкоуровневого исполнения. Языковая модель будет решать, что делать и в каком порядке, а специализированные модули — как именно это сделать так, чтобы объект не выскользнул из захвата.
Эксперименты с CodeActionBench и полученный разброс от 2,7% до 73,3% показывают именно это: потенциал огромен, но пока генерация кода с решением задач не справляется, и нужно использовать какие-то еще приемы.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.