Свежие научные работы про ИИ, агентов и все такое. Сентябрь-2026: мультимодальный ИИ и робототехника
Привет, Хабр! В прошлой части дайджеста я собрал научные работы про LLM, агентную разработку и безопасность, а теперь перейду к изображениям, речи и роботам. Всего в этом дайджесте 17 исследований о CV, речи, роботах и других системах, объединяющих различные виды данных. В одних исследованиях ученые тестировали настоящие манипуляторы и дроны, в других ограничивались симуляцией. В каждом разборе мы уточняем, как именно проходили испытания, поскольку хорошие результаты тестов — еще не гарантия, что робот так же классно справится с задачей в реальных условиях. Для самых показательных работ мы добавили иллюстрации из оригинальных публикаций.
Дисклеймер
При работе над блогом МТС через меня проходит какой-то невообразимый поток информации — научные работы, бизнесовые исследования, аналитические статьи. На публикацию из этого уходит только часть, и то небольшая. Оставшиеся статьи тоже интересные и могут кому-то помочь, засим я и вынес их в эту подборку.
Оглавление
TrafficFab: автономный стенд edge-cloud для управления дорожным движением с ИИ
SkinAgent AI: безопасный мультимодальный помощник по уходу за кожей без диагностики
M3GD: геометрическая генерация новых ракурсов по данным камеры и лидара
Мультимодальные рассуждения с помощью программ, создающих изображения
TrackEverything: плотное отслеживание точек на длинном видео без дублирования 3D-сцены
Доверять или нет: проверка устных фактов с поиском внешних источников
ИИ-агенты-программисты для планирования задач и движений роботов
SemMSA: устойчивый анализ эмоциональной окраски по неполным мультимодальным данным
Rolling-WAM: модели мира и действий со скользящим прогнозом будущего
Восстановление скрытых траекторий роботов по последовательностям градиентов обучения
AD-WM: модели мира, различающие действия, для контрфактического планирования
За пределами точности: неустойчивость выводов и демографические смещения медицинских LLM
CodeActionBench: проверка кода для управления роботизированными манипуляциями
От разовой генерации к последовательному редактированию музыкальных партитур с LLM
Планирование траекторий множества роботов через шумоподавление
1. TrafficFab: автономный стенд edge-cloud для управления дорожным движением с ИИ
Оригинальная публикация: TrafficFab: An Autonomic Edge-Cloud Testbed Fabric forAI-Driven Traffic Management · 24.09.2026 · arXiv:2609.29223
Представьте город, усеянный тысячами камер видеонаблюдения. Если мы решим отправлять и хранить видео с каждой в облаке, сеть и серверы нам спасибо не скажут. Они быстро окажутся перегружены, а обработка станет запаздывать. TrafficFab — испытательный стенд, на котором можно проверить распределение работы между устройствами у камер (edge) и облачными серверами (cloud) до установки системы по всему городу. Небольшие устройства рядом с камерами выполняют часть видеоаналитики, а облачный сервер получает обработанные данные и краткосрочно прогнозирует дорожную обстановку. Когда камер становится больше, система решает, где запустить дополнительные вычисления.
При распределении задач система учитывает энергопотребление устройств и затраты на передачу обработки между ними. Для испытаний исследователи собрали стенд из Raspberry Pi, ускорителей Jetson, серверов с GPU и облачных виртуальных машин. В качестве основы для одного из сценариев взяли дорожную сеть Бангалора. Система обрабатывала в реальном времени около 400 видеопотоков, причем часть из них имитировала работу городских камер, а не поступала с реальных устройств. Обновлять нейросети авторы предложили с помощью федеративного обучения: каждое устройство обучает свою версию модели на локальных данных, после чего сервер объединяет полученные обновления. Передавать ему все видеозаписи для этого не требуется. Исследователи также рассчитали, как архитектура может работать при большем количестве камер, но до полноценного развертывания в городе дело пока не дошло. Работа позволяет оценить возможности такой системы и выявить потенциальные ограничения еще до того, как город начнет тратить деньги на ее внедрение.
2. SkinAgent AI: безопасный мультимодальный помощник по уходу за кожей без диагностики
Оригинальная публикация: SkinAgent AI: A Safety-Grounded Multimodal Agentic Framework for Non-Diagnostic Skincare Support · 24.09.2026 · arXiv:2609.29341
Представим, что пользователь отправляет фото своего лица и просит подобрать уход для кожи. ИИ должен определить характерные признаки на изображении, понять и обработать запрос, сверить характеристики продуктов и получить согласие пользователя перед действиями там, где это необходимо. SkinAgent AI собирает эти шаги в одну систему. Отдельные модели оценивают тип кожи, выявляют признаки акне, морщины и другие особенности. В свою очередь, агент вызывает специальные инструменты, чтоб подобрать средства ухода. Система дополнительно проверяет источники рекомендаций, ограничения безопасности и обращения с данными. В результате пользователь получает рекомендации по уходу с конкретными средствами — важно, что это именно рекомендации, а не медицинский диагноз.
По отдельности модули работали заметно лучше, чем агент целиком. Классификатор, определяющий, связано ли обращение с акне, порами или морщинами, достиг 99,84% точности, но на внутреннем наборе из 240 комплексных заданий, который не проходил независимую проверку, агент правильно определял намерение в 80% случаев, выбирал точный набор инструментов в 62,92% и проходил все этапы задания без нарушений заданных требований лишь в 47,08% случаев. Агент мог выбрать не тот инструмент или не проверить важную характеристику рекомендованного средства. Поэтому даже почти идеальный классификатор запросов не гарантировал правильную рекомендацию. В небольших тестах защиты исследователи не обнаружили нарушений. Масштаба этих проверок недостаточно для выводов об абсолютной безопасности. Авторы пока не подтвердили результаты независимыми клиническими испытаниями.
3. M3GD: геометрическая генерация новых ракурсов по данным камеры и лидара
Оригинальная публикация: M3GD: Multi-Modal Multi-View Geometric Diffusion for Camera--LiDAR Novel View Synthesis · 24.09.2026 · arXiv:2609.30056
Роботу иногда нужно представить, как комната будет выглядеть с другой точки обзора. Генератор, который видит только фотографии, может нарисовать правдоподобную стену или предмет, но ошибиться с расстоянием до него. В M3GD к фотографиям добавили данные лидара — датчика, измеряющего расстояния до поверхностей лазерными лучами. Так модель получает сведения о геометрии сцены, которых может не хватать на обычном снимке. Авторы объединили готовую нейросеть для изображений с моделью, которая обрабатывает облако точек лидара. Дополнительный модуль передает генератору изображений данные о расстояниях до объектов.
Метод испытывали на наборе GrandTour: модели поручили построить изображение сцены с новой точки обзора и карту глубины, демонстрирующую расстояние до видимой поверхности для каждого пикселя. С данными лидара генератор точнее передавал расположение предметов и глубину сцены. Отдельные эксперименты подтвердили, что улучшение дают конкретные измерения, согласованные с изображением. Авторы также испытали метод на наземном роботе. Но все же основные результаты получены на конкретном наборе данных и оборудовании, поэтому пока нельзя утверждать, что система будет столь же точно работать в любой незнакомой обстановке.
Сравнение ракурсов M3GD показывает, как данные лидара помогают сохранять расположение объектов и расстояния между ними.

4. Мультимодальные рассуждения с помощью программ, создающих изображения
Оригинальная публикация: Multimodal Thinking with Renderable Programs · 24.09.2026 · arXiv:2609.30130
При решении геометрической задачи языковая модель может построить рисунок и проверить его по ходу рассуждения. Словесного описания порой недостаточно. Исследователи предложили SVGLM: модель составляет SVG — текстовое описание линий, окружностей и других фигур, из которого программа строит векторное изображение. Например, модель может нарисовать треугольник, заметить ошибку в расположении вершины и исправить только нужные координаты. Такой рисунок удобно снова использовать в рассуждении, не пересоздавая все изображение.
Для обучения подготовили задачи на создание и редактирование SVG, затем адаптировали открытые визуально-языковые модели. Авторы проверили результат на заданиях, где требуются математические и пространственные рассуждения, и показали, что модель может создавать промежуточные изображения в процессе решения. Пока авторы проверили метод на конкретных задачах и моделях. Из этого нельзя заключить, что SVG поможет при любом вопросе с картинками или заменит полноценный графический редактор. Рисунок здесь помогает находить решение и исправлять ошибки во время рассуждения.
5. Иллюзия согласованности в мультимодальных языковых моделях
Оригинальная публикация: The Alignment Illusion in Multimodal Large Language Models · 24.09.2026 · arXiv:2609.30210
Как проверить, действительно ли мультимодальная модель учитывает содержание картинки при ответе? Один из способов проверки — сравнить внутренние числовые представления картинки и текста. Если они похожи, это иногда принимают за признак понимания изображения. Авторы этой работы решили проверить сам показатель. У 13 моделей пяти семейств они заменили визуальные данные на случайный шум и повторили тесты. Без настоящей картинки модели отвечали намного хуже. Но несколько метрик продолжали показывать высокое сходство между текстом и визуальными данными, хотя вместо изображения им подали шум.
Исследователи поясняют эффект тем, как устроены общие слои LLM. Дело в том, что они делают числовые представления текста и картинки схожими, даже когда модель уже потеряла сведения об изображении в длинном контексте. Чтобы это побороть, авторы предложили использовать principal-angle gap — разницу между двумя ведущими показателями геометрического сходства. Эта мера помогает отличить, когда совпадение произошло из-за устройства сети, а когда связано с содержанием картинки. В тестах эксперты увидели, как постепенно все сильнее портился и искажался визуальный сигнал. В общем, высокая внутренняя метрика «согласованности» еще не доказывает, что модель каким-то образом «понимает» изображение. Она вообще уже могла забыть, как оно выглядело. Поэтому метрику обязательно нужно сопоставлять с реальным качеством выполнения задач.
6. TrackEverything: плотное отслеживание точек на длинном видео без дублирования 3D-сцены
Оригинальная публикация: TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations · 24.09.2026 · arXiv:2609.30222
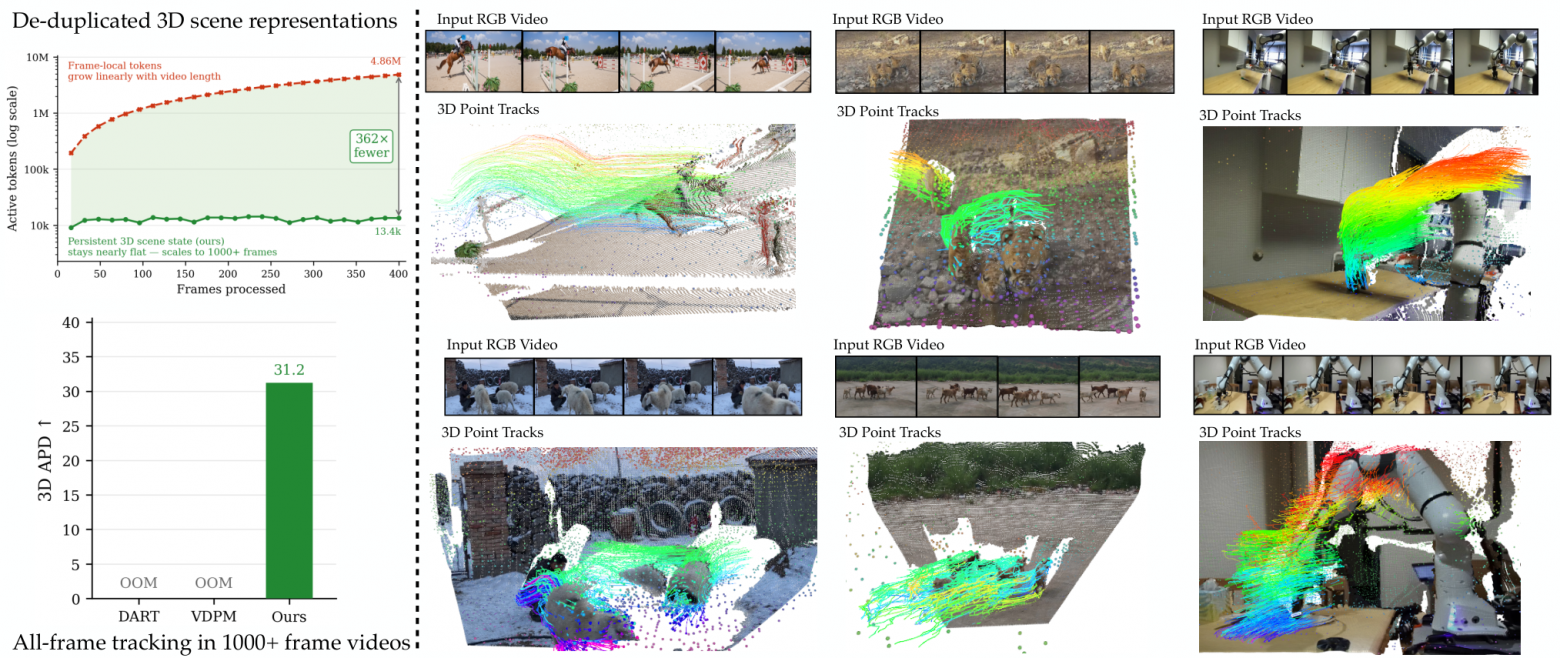
Попробуйте проследить за каждой видимой точкой в длинном видео. Раньше обычно приходилось идти на компромисс: долго-предолго следить за несколькими точками или недолго, но почти за всеми. Но такой квест с отслеживанием невероятно быстро расходовал видеопамять. TrackEverything попробовали решить эту задачу по-другому: сложить наблюдения в общую трехмерную сцену. Если камера снова увидела ту же стену, стол или другую поверхность, алгоритм не создает для нее новую копию. Для неподвижных объектов достаточно хранить положение, а подробные траектории нужны прежде всего движущимся точкам.
Авторы утверждают, что метод отслеживает все видимые точки в роликах длиннее тысячи кадров в пределах 40 ГБ видеопамяти. На TAPVid-3D метод более чем на 20% превосходил сравниваемые открытые плотные трекеры по APD — доле точек с достаточно точным прогнозом трехмерного положения, усредненной по нескольким порогам допустимой ошибки — на коротких клипах. На рисунке из статьи каждая цветная линия показывает, как конкретная точка перемещалась в трехмерном пространстве. Так, видно, насколько подробно система отслеживает множество точек на поверхностях предметов по всему кадру. Ограничение в том, что метод зависит от качества построения 3D-сцены: неверно объединенные поверхности могут испортить отслеживание, а если камера постоянно снимает новые поверхности, системе все равно приходится выделять под них дополнительную память.

7. Доверять или нет: проверка устных фактов с поиском внешних источников
Оригинальная публикация: To Trust or Not to Trust: Retrieval-Augmented Fact Checking in Speech · 24.09.2026 · arXiv:2609.30227
ИИ может правильно проверить утверждение, когда оно написано, и ошибиться, когда те же слова произнесены вслух. Именно это исследуют в VeriSpeak — наборе из 3879 аудиозаписей с проверяемыми фактами о датах, местах и отношениях между объектами. В наборе есть как верные, так и ложные утверждения, чтобы модель не могла просто всегда отвечать «правда». Модель должна распознать слова, найти внешнее подтверждение и сопоставить его с услышанным утверждением. Например, совпадение отдельных слов еще не значит, что источник подтверждает нужную дату или событие.
Исследователи обнаружили разрыв между текстовой и речевой проверкой. Одного поиска в Интернете оказалось мало: модель могла найти страницу с похожими словами и ошибочно принять ее за подтверждение, хотя источник говорил о другом событии или дате. Лучше модель справлялась с проверкой, когда сначала сопоставляла утверждение из аудиозаписи с представленными доказательствами, а затем объясняла свой ответ. Одна из моделей в таком режиме достигла 86,1% точности на тестовом наборе. Правда, для экспериментов использовали речь, синтезированную одним голосом, а реальные записи с фоновым шумом не проверяли. Поэтому пока неизвестно, насколько хорошо система справится с интервью, подкастами и прямыми эфирами.
8. ИИ-агенты-программисты для планирования задач и движений роботов
Оригинальная публикация: Coding Agents for Generalized Task and Motion Planning Problems · 24.09.2026 · arXiv:2609.30233
Допустим, робот должен переставить несколько коробок. Сначала ему нужно решить, какую коробку брать первой, а затем проверить, дотянется ли до нее рука и не заденет ли другие предметы по пути. Обычно такие планировщики долго разрабатывают вручную. Авторы проверили альтернативу: coding-агенту дают описание задачи и доступ к симулятору, где он может пробовать решения, замечать ошибки и писать программу. После разработки авторы фиксируют программу и запускают ее в новых сценах, которые агент еще не видел. Так проверяют, переносит ли агент найденную стратегию на незнакомые расстановки предметов.
Тест включал 28 симулированных сред. Всего создали 980 программ и провели 98 тысяч запусков на отложенных заданиях. На 16 средах, где был доступен обычный планировщик, средняя успешность различных агентных конфигураций составила 56–95% против 47% у сравниваемого планировщика. Интересно, что агенты сами проводили маленькие эксперименты, чтобы уточнять правила движения и пределы действий. Однако они работали в симуляции с доступом к точному состоянию объектов; неизвестно, сохранится ли преимущество при ошибках настоящих камер и датчиков.
9. SemMSA: устойчивый анализ эмоциональной окраски по неполным мультимодальным данным
Оригинальная публикация: SemMSA: Latent Semantic-Aided Robust Multimodal Sentiment Analysis with Incomplete Data · 24.09.2026 · arXiv:2609.30238
Чтобы определить эмоциональную окраску высказывания, например положительную или отрицательную, система сопоставляет слова человека, интонацию и выражение лица. Но что делать, если аудио отсутствует или часть видеокадров потеряна? Часто алгоритмы пытаются восстановить недостающие данные, рискуя придумать признаки, которых никто не наблюдал. SemMSA идет другим путем: работает с сохранившимися сигналами и использует предварительно обученную языковую модель с неизменными весами, чтобы объединять уцелевшие текстовые, звуковые и визуальные сигналы в общее числовое представление настроения.
После этого отдельный модуль сопоставляет доступные сигналы. Если камера не передала изображение, алгоритм все равно может опереться на слова и голос. Авторы проверяли подход на наборах SIMS, MOSI и MOSEI и сообщили результаты уровня лучших сравниваемых систем. В аннотации нет сопоставимых численных показателей, поэтому объявлять метод победителем с определенным процентом нельзя. Эксперименты охватывали несколько наборов видеозаписей с выражением мнения; поведение метода в других сценариях общения пока неизвестно. Однако числовое представление эмоции само по себе не объясняет, какие слова или интонации повлияли на решение.
10. Rolling-WAM: модели мира и действий со скользящим прогнозом будущего
Оригинальная публикация: Rolling-WAM: World Action Models with Rolling Imagination · 24.09.2026 · arXiv:2609.30247
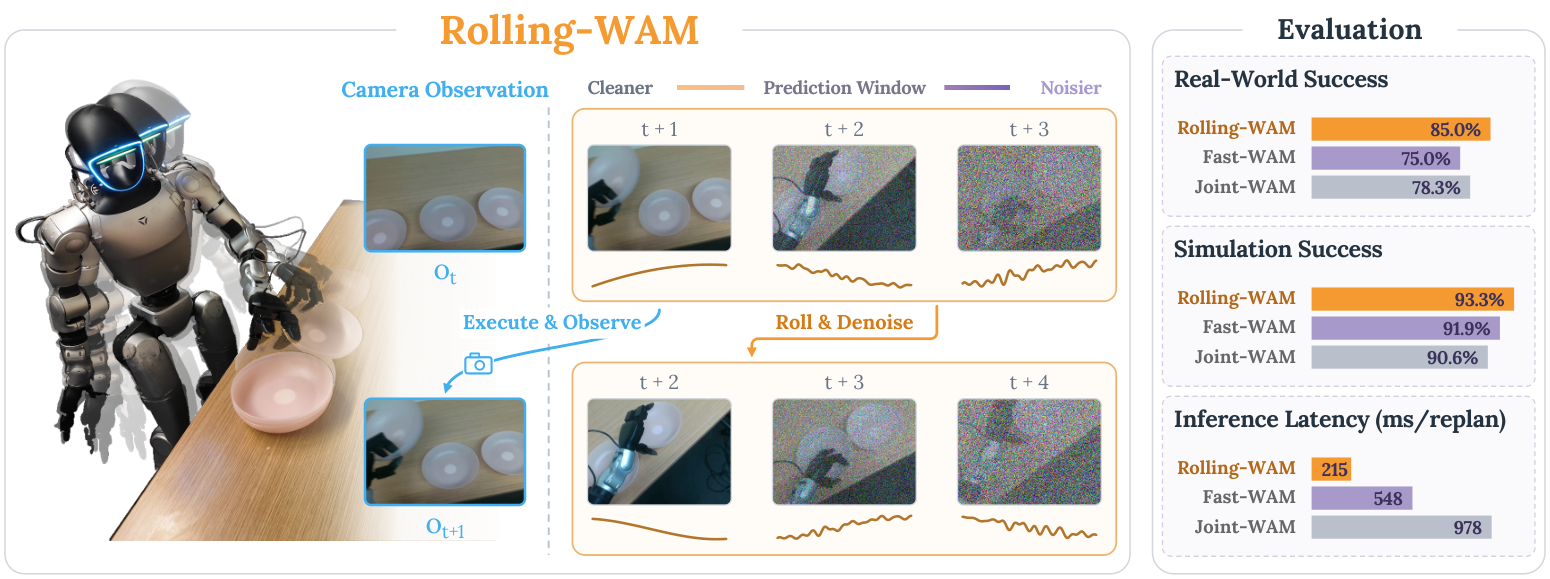
Робот, который ориентируется по камере, не может просто взять и составить план движения и следовать ему до победного конца. Стоит предмету сдвинуться, и траекторию придется пересматривать. Модели World Action Models (WAM) пытаются предсказать сразу две вещи: что камера увидит в следующих кадрах и какие действия выполнит робот. Но в базовой WAM с каждым новым изображением вся последовательность движений рассчитывается заново. Пока нейросеть занята вычислениями, робот ждет следующую команду.
Авторы Rolling-WAM предложили не пересчитывать весь план целиком. Робот получает команду для ближайшего движения, а система тем временем готовит следующие действия и уточняет их по новым кадрам. Часть предыдущих расчетов сохраняется, поэтому начинать все с нуля уже не нужно. Подход испытали на LIBERO, RoboTwin и реальном гуманоиде Unitree G1. При повторных циклах управления пересчет плана происходил в 4,5 раза быстрее, чем в базовой WAM, а с испытанными манипуляциями робот справлялся не хуже. Правда, у такого способа есть слабое место: если обстановка резко изменится, заранее подготовленные действия могут потерять смысл. Авторам еще предстоит разобраться, сколько шагов стоит рассчитывать наперед и как быстро перестраивать план в подобных ситуациях.

11. RAPID: агентное программирование роботов по демонстрациям
Оригинальная публикация: RAPID: Robot Agentic Programming from Demonstrations · 24.09.2026 · arXiv:2609.30249
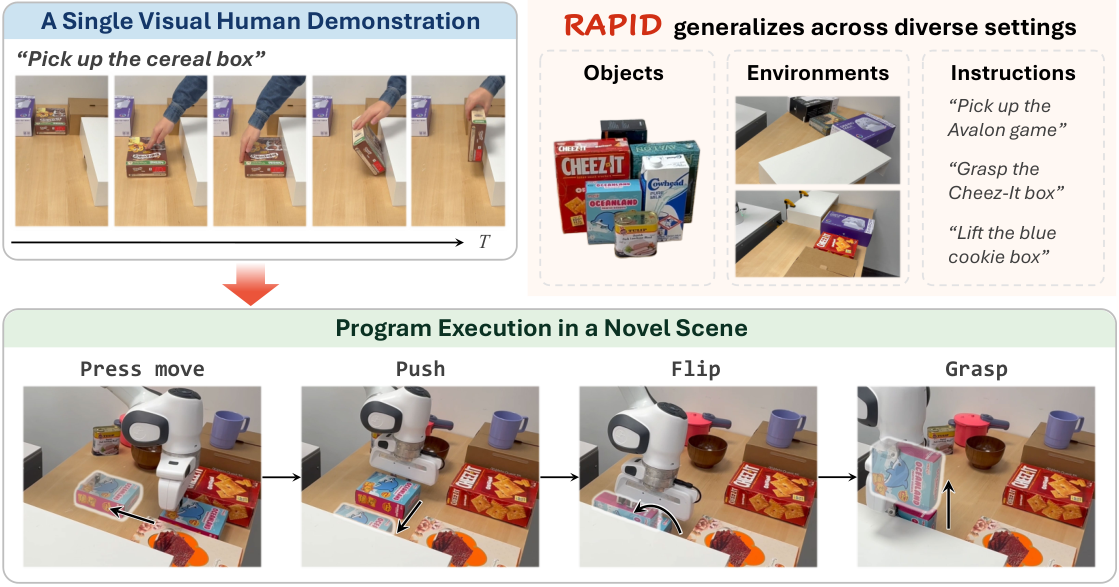
Человек показывает роботу действие на видео, например, как подтолкнуть предмет в нужное место. Обычное копирование движений не подойдет, если предмет другой формы или лежит чуть левее. RAPID пытается понять цель демонстрации: какой предмет нужно передвинуть, куда он должен попасть и по какому признаку можно проверить успех. Повторять движение человеческой руки буквально системе не требуется. После одной визуальной демонстрации агент формирует проверяемое описание задачи, набор доступных движений и программу для робота.
Затем агент запускает программу в тестовой среде. Если предмет оказывается не там, где требуется, агент исправляет код и пробует снова. Авторы испытали подход на восьми задачах, где робот должен двигать предметы, в том числе толкать их без захвата. Дополнительные проверки провели в LIBERO-Pro и на настоящем манипуляторе Franka. В испытаниях программы переносились на новые положения и свойства объектов. Это не обучение любого робота произвольной работе с одного видео: подход проверяли на конкретных классах задач и роботизированной платформе.

12. Восстановление скрытых траекторий роботов по последовательностям градиентов обучения
Оригинальная публикация: Temporal Gradient Inversion for Private Trajectory Reconstruction in Embodied Reinforcement Learning · 24.09.2026 · arXiv:2609.30258
При распределенном обучении робот может не отправлять на сервер видео с камеры. Вместо кадров сервер получает градиенты — данные о том, как нужно изменить параметры нейросети после очередного шага обучения. Это выглядит безопаснее, чем передача сырых записей. Однако в градиентах остаются следы наблюдений и действий. Исследователи создали TRACE — метод, который анализирует последовательность таких обновлений и пытается восстановить, что робот видел и как двигался. В отличие от атак на один кадр, TRACE использует связи между соседними моментами движения.
На тестовых сценах восстановленные изображения получили 18,8 дБ по PSNR — числовой мере сходства с оригиналом, где более высокое значение означает меньшую ошибку. Метод также почти полностью восстанавливал выбранные дискретные действия робота; обработка кадра занимала 3–4,5 мс. Авторы повторяли испытания с разными моделями управления и проверяли, помогают ли защитные преобразования скрыть информацию в градиентах. Простые защитные преобразования градиентов в некоторых условиях пропускали данные. Более сильные меры приватности снижали качество обучения. Атакующему в этих опытах нужен доступ к упорядоченным градиентам отдельных шагов, поэтому цифры нельзя считать оценкой взлома всех роботизированных систем.
13. AD-WM: модели мира, различающие действия, для контрфактического планирования
Оригинальная публикация: AD-WM: Action-Discriminative World Models for Counterfactual Model Predictive Control · 24.09.2026 · arXiv:2609.30264
Робот должен сравнивать последствия разных команд, чтобы выбрать подходящую. Одного прогноза следующего кадра для этого недостаточно. AD-WM проверяет, умеет ли модель мира различать последствия разных команд, даже если будущие кадры выглядят почти одинаково. Прогноз следующего кадра может выглядеть точным, даже если модель ошибочно оценивает разницу между командами «сдвинуть левее» и «сдвинуть правее». Для управления эта разница решающая. Во время обучения авторы добавили задачу: по предсказанному состоянию угадать, какое действие к нему привело. Так модель вынуждена замечать разницу между командами. Это заставляет модель сохранять информацию о последствиях разных команд.
На симулированных манипуляциях OGBench-Cube в сложном начальном положении успешность выросла с 3,7 до 52% относительно сопоставимой модели без нового компонента. На реальном манипуляторе Franka успешность простой задачи pick-and-place — взять предмет и переложить его — выросла с 42,2 до 71,1%. Сам алгоритм выбора движения при этом не меняли: изменилось обучение модели мира. Но на реальном оборудовании проверяли ограниченную задачу с заранее заданными подцелями, поэтому говорить об универсальном улучшении управления роботами рано.
14. За пределами точности: неустойчивость выводов и демографические смещения медицинских LLM
Оригинальная публикация: Beyond Accuracy: Counterfactual Fragility and Demographic Bias in Clinical Evaluation of LLMs · 26.09.2026 · arXiv:2609.32807
Медицинская LLM может верно ответить на экзаменационный вопрос, но насколько хорошо она понимает, какие факты меняют диагноз? Исследователи дали шести моделям 150 заданий MedQA USMLE и проверили их двумя способами. Сначала модели предлагали изменить одну важную деталь клинического случая так, чтобы правильный диагноз или ответ тоже изменился. Например, конкретный симптом мог изменить правильный ответ; случайные детали истории пациента не должны были влиять на него. Из 900 попыток автоматическая проверка признала корректными лишь 228 — 25,3%. Этот тест проверял, понимает ли модель, какой симптом действительно меняет диагноз; обычный балл за правильный ответ на экзаменационный вопрос этого не показывает.
Затем исследователи меняли в описании пациента демографические признаки и проверяли, изменится ли ответ модели, хотя медицинские симптомы и результаты обследований остались прежними. В 5400 сравнениях ответ менялся 1097 раз — в 20,3% случаев. Разные модели показывали разную степень устойчивости; высокая экзаменационная точность не гарантировала хорошие результаты по обеим проверкам. Все решения и признаки стереотипизации здесь оценивали автоматические судьи, без экспертной проверки врачами. Поэтому исследование помогает обнаружить тревожные закономерности в ответах моделей. Реальную частоту врачебных ошибок по этим результатам определить нельзя.
15. CodeActionBench: проверка кода для управления роботизированными манипуляциями
Оригинальная публикация: CodeActionBench: Evaluating Agentic Code-as-Policy for Embodied Manipulation · 27.09.2026 · arXiv:2609.33807
Одно дело — попросить мультимодальную модель описать, как взять предмет, и совсем другое — заставить ее написать код, который действительно выполнит движение. CodeActionBench проверяет именно второе. Агент получает изображения сцены, ограниченные команды движения и геометрические инструменты. Он должен сам оценить положение предметов, выбрать действие, запустить программу и проверить результат. Агент не получает ни готовый алгоритм захвата, ни пример правильной траектории, ни точные координаты всех предметов. Ему приходится находить решение самому.
Авторы включили в тест 25 задач на роботизированные манипуляции. Девять конфигураций моделей и агентных оболочек выполнили 675 попыток; успешность составляла от 2,7 до 73,3%. Самая сильная конфигурация получила до трех попыток на каждую задачу и хотя бы один раз справилась с 22 заданиями из 25. Это не значит, что ее успешность в одной попытке составляла 88%. Частый сбой выглядел так: команда движения выполнилась, но предмет оказался не в нужном месте. Иногда агент этого не замечал и объявлял задачу завершенной. Авторы проводили испытания в контролируемой симуляции и пока не проверяли перенос результатов на физических роботов.
16. От разовой генерации к последовательному редактированию музыкальных партитур с LLM
Оригинальная публикация: From One-Shot Generation to Incremental Music Composition: Adapting a General-Purpose Instruction LLM for Persistent Symbolic Editing · 28.09.2026 · arXiv:2609.34994
Обычно музыкальную нейросеть просят создать целую мелодию. Но композитор чаще работает иначе: возвращается к уже написанной партитуре, добавляет аккорды, переносит мелодию в другую тональность или меняет несколько тактов. Авторы проверили, можно ли научить обычную языковую модель именно так редактировать музыку. Для нот авторы выбрали текстовую нотацию ABC: мелодию в ней записывают буквами и символами. Такая запись удобна для точечных текстовых правок. Модель училась добавлять аккорды, заполнять пропущенные такты и переносить музыку в другую тональность. Все остальное при правке должно оставаться без изменений.
На 496 038 диалоговых примерах из ирландской традиционной музыки авторы дообучили Llama 3.1 8B Instruct методом LoRA — экономным способом менять поведение модели, не обновляя все ее параметры. В испытании с 1750 попытками на модель доля результатов, прошедших автоматическую проверку формата, выросла с 29,37 до 99,37%. Для результатов, прошедших форматную проверку, оценка соблюдения правил редактирования по шкале от 0 до 1 выросла с 0,7205 до 0,9798. Это показывает, что модель стала надежнее сохранять структуру партитуры и выполнять точечные команды. Но музыканты не оценивали художественное качество получившихся произведений.
17. Планирование траекторий множества роботов через шумоподавление
Оригинальная публикация: Denoising Multi-Robot Trajectories · 28.09.2026 · arXiv:2609.35651
Когда несколько роботов движутся в одном пространстве, каждый учитывает препятствия и движения остальных, чтобы избежать столкновений. Чем больше машин, тем труднее рассчитать маршруты: у каждой есть пределы скорости и поворота, а пересечения траекторий грозят столкновениями. В Denoising Multi-Robot Trajectories авторы проверили D4orm: метод берет множество грубых вариантов движения и шаг за шагом убирает из них случайные отклонения, чтобы найти выполнимые траектории без столкновений. Этот прием называют диффузионным шумоподавлением. GPU одновременно проверяет множество вариантов.
На основе метода сделали несколько способов планирования: для крупных групп, для постоянного пересчета по новым наблюдениям и для распределенного управления при ограниченных вычислительных ресурсах. В опытах участвовали 10 реальных квадрокоптеров, шесть наземных роботов и до 100 машин в симуляции. В выбранных испытаниях D4orm быстрее и надежнее сравниваемых планировщиков находил безопасные движения. Среди них был MPPI — метод, который многократно моделирует пробные траектории и выбирает лучшие. Результаты относятся к определенным условиям испытаний. В незнакомой среде избегания всех столкновений система пока не гарантирует.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.