ゼロから独自開発した国産AIでトップクラスの日本語翻訳精度を実現する「PLaMo翻訳」を開発したPreferred Networksエンジニアに編集長が根掘り葉掘り聞いてみたよインタビュー
日本の企業・Preferred Networks(PFN)が提供する「PLaMo」はフルスクラッチで開発された国産生成AI基盤モデルで、日本語に特化しているのが特徴。このPLaMoベースで開発された「PLaMo翻訳」はとにかく非常に質の高い翻訳が可能で、テキスト翻訳だけでなくFirefoxやChromeの拡張機能でも提供されています。2026年10月にはPLaMo 3 NICTをベースにしたplamo-3-translateも登場し、翻訳の精度は随一のレベルに到達しています。そんなPLaMo翻訳がいったいどのように開発されたのかを、Firefoxアドオンが出た最初からず~っと使い続けているGIGAZINE編集長がPFNのPLaMo開発メンバーに根掘り葉掘り聞いてみました。
PLaMo
https://plamo.preferredai.jp/
GIGAZINE編集長(以下、G):
ではまず自己紹介をお願いします。
奥井 寛樹さん(以下、奥井):
プロダクトマネージャーの奥井です。
鈴木 海渡さん(以下、鈴木):
はじめまして。PLaMo翻訳の開発を担当する鈴木と申します。よろしくお願いします。
今城 健太郎さん(以下、今城):
同じくモデルの開発を行っている今城と申します。Twitter上ではいもすというアカウントでも活動しています。よろしくお願いします。
G:
よろしくお願いします。自分はPLaMo翻訳を最初の頃からずっと使ってるユーザーで、これまで毎日Google翻訳やBingやDeepLといったいろんな翻訳を今まで使ってきたんですが、その中でもPLaMo翻訳が速度や精度で群を抜いていると感じました。PLaMoがバージョン2になった時もすごいなと思ったんですが、バージョン3は凄まじいレベルに到達したと思っています。その前に、GIGAZINE読者の中には「PFNって何?」という人も多いと思うので、説明していただけますか?
PFN広報:
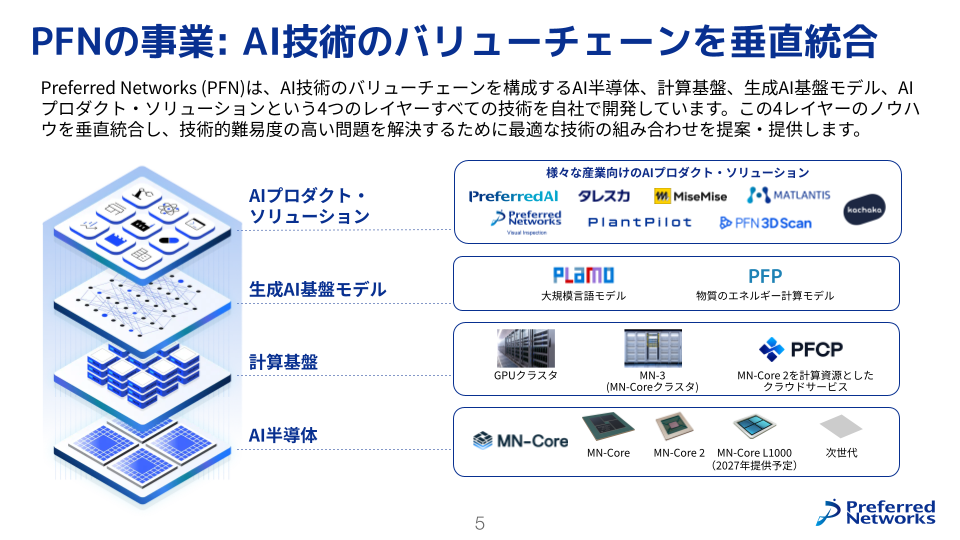
はい。PFNは2014年創業で、もうすでに10年以上経っている……ベンチャーというにはもはや古株のAI企業です(笑) 社員数は450人くらいいます。元々は西川徹と岡野原大輔が創業した会社で、事業としてはAIの半導体から計算基盤、要はスーパーコンピューターを使って動かすPLaMoのような生成AI基盤モデル、さらに様々なAIソリューションやプロダクトの提供があります。AIに関わるいろいろな技術を自社開発しており、Googleなどの大手IT企業と同じような幅広い技術レイヤーを持っています。日本においてほぼ同じような事業形態の会社はありませんし、グローバルで見てもベンチャーでここまでいろいろやっている会社というのは少ないといえますね。
G:
なるほど。そもそも論として、10年以上前に会社を創立した時点ではPLaMoのようなAIモデルはなかったと思うのですが、一体どういう経緯で開発し始めることになったんでしょうか。
PFN広報:
PFNの前身は創業者の岡野原や西川が大学院生だった2006年に起業した検索エンジンの開発会社なんです。つまり、PFNの起源というのはソフトウェア開発企業で、そこにコンピュータサイエンスや競技プログラミングに強い人たちがいっぱい集まって始まりました。
AIやディープラーニングがどうやってできているのかといえば、元を正せばやっぱり半導体という計算資源によって支えられていて、計算が大きくできるようになるほど技術も向上するわけです。そのため、ソフトとハードを両輪で開発すべきだという考えのもと、2016年から半導体の開発をスタートしています。つまり、PFNを創業してから2年目で半導体を開発するという、かなり無茶なことをやっています(笑) 当時から競争力の源泉である計算基盤、すなわちスーパーコンピューターも自社で持つべきだと考え、大きなクラスターを抱えてさまざまなAIソリューションを開発するようになったというのが経緯です。
G:
なるほど、そういう感じなんですね!そして、今城さんがPLaMoの基礎を作ってるということにはなるんですか?
今城:
モデル開発には結構当初から関わっていて、PLaMoのモデル名を決めた時にアイデアを出したのも僕です。翻訳モデルを作ろうと言い出したのも、そして最初にPLaMo翻訳モデルを作ったのも自分という形になりますね。
G:
それでは鈴木さんはどういう役割をしてるんでしょうか。
鈴木:
PLaMo 2 Translateという一つ前の世代のモデルを今城さんが作られた後、次世代モデルに向けてもっといいやつを作ろうというところで私が合流しました。今回はモデルの性能をがっつり引き上げるための拡張を担当しています。
G:
プロダクトマネージャーの奥井さんはどういう立場で今回関わってるんでしょうか。
奥井:
今城さんと鈴木さんのお二人がすごく良い翻訳モデルを開発してくれたので、利用される方々が自分の実際の業務に使ってその価値を体感できる形でお届けするためのアプリケーション開発を主にしています。
G:
ありがとうございます。自分がPLaMo翻訳をなぜ使うようになったかを話すと、普段のブラウザにはFirefoxを利用しており、PLaMo翻訳にはFirefoxのアドオンがあったからというのが一番大きい理由です。普通はChromeの拡張機能を作って終わりというケースも多いものですが、Firefoxのアドオンを作ろうとなったのはなぜなのでしょうか?
奥井:
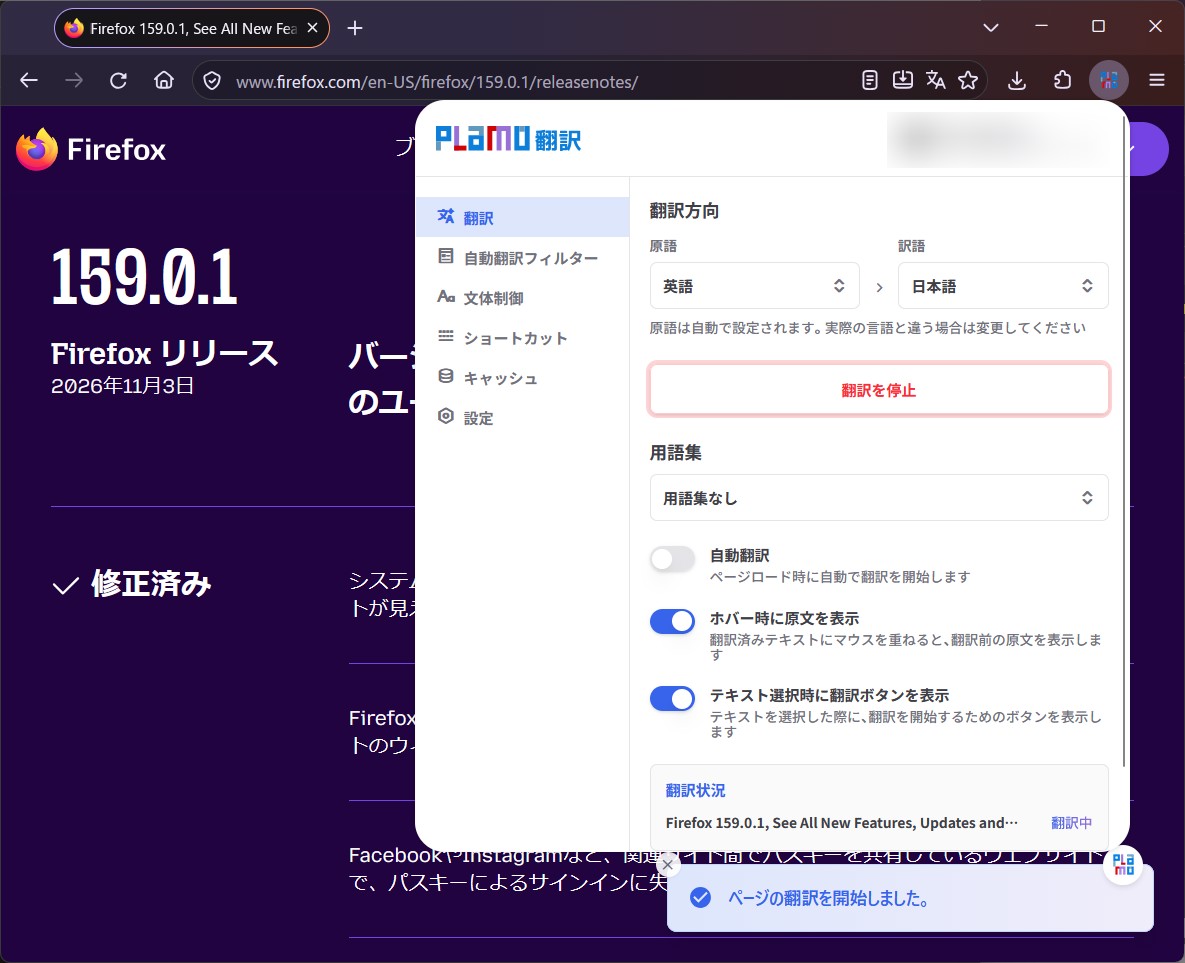
おっしゃる通り、初めはやはりChromeで作っていたのですが、Chromeの拡張機能を出した時に「Firefoxは翻訳がひどいから、Firefoxのアドオンをぜひ出してくれ」というご要望をかなりの方からいただきました。Firefoxはセキュリティ面で利があるので使ってる方がたくさんいらっしゃると思うんですが、実際に試してみたら確かにデフォルトで搭載されている翻訳機能のクオリティが低かったんですね。これは「FirefoxユーザーにPLaMo翻訳を使ってもらう方が、翻訳品質の改善という価値向上はChromeよりも圧倒的に高いだろう」と考え、ぜひお届けしたいと思ってFirefoxのプラグインを開発したという次第です。
G:
なるほど。確かにFirefoxにはまともな日本語翻訳がなかったというのが現状なのでわかります。今城さんは一番最初、PLaMo翻訳をゼロから作り始めた時点でここまでのものを作れるという確信はあったのでしょうか。それとも「とりあえずできるだろう」で進めたのでしょうか。
今城:
そうですね。別に確証があったわけではないんですが、PLaMo自体でOpenAIのモデルに勝とうというのはかなり大変なので、何かしら足がかりがあるといいなっていう要素はありました。これは結果論なんですけど、今だと翻訳ってもうLLMベースのモデルしか今後勝てない領域になりつつあるんですよね。でも「翻訳モデルを作る」という目的だけでLLMを開発するのはかなりコストがかかります。だったら既存のLLMから派生した翻訳モデルを作ってみると面白いかなと考えたわけです。実際にLLMの利用用途ランキングを調べると、翻訳は割と上位にある。一方で、ChatGPTに「翻訳してください」といちいち言うのも大変なので、翻訳サービス自体は残るだろうという総合的な判断もあります。
G:
なるほどなるほど。それで翻訳モデルを作ってみようというのは、会社の了解を取ってから作ってみたんでしょうか?
今城:
ああ。ちょっと僕……自由にさせていただいていて(笑) それで、社長の岡野原に「こんなものができそうなのですが、どう?」というすごく雑なふりでプロジェクト自体が始まりました。
G:
なるほどなるほど。じゃあ企画ありきというよりも、実際に作ってみてからちょっと見せて、それで判断をうかがう感じで始まったイメージなんでしょうか。
今城:
そうですね。それでモデルができた後、実際にそのプロダクトとして開発していくという時には奥井をはじめとするメンバーが助けてくれました。そちらはちゃんと社内のプロセスに従って進めています。
G:
今城さんが作り始めてから、「会社のプロダクトとしていけるだろう」という風にゴーサインがでるまで、どれぐらい時間はかかったんでしょうか?
鈴木:
どうでしたっけ?
奥井:
割と早いんじゃないですか? 2人とも。
今城:
そうですね。僕自身は翻訳モデルしか作ってなかったんですけど、鈴木のプロトタイピングも途中にあって、ブラウザ翻訳にしたら便利じゃないかという話になって。
G:
そういう感じなのですね。それでは鈴木さんがブラウザ翻訳の形を作っていたというイメージなんでしょうか。
鈴木:
そうですね、初めにレイアウトをちゃんと維持したままブラウザのページを翻訳するというのを社内版のプロトタイプとしてバッと出したんです。すると、社内でだいたい3分の1くらいの社員に使ってもらえたので、それを奥井が社外の皆さんにも使っていただけるような形にブラッシュアップしてくれたというのが公開までの経緯になりますね。
G:
PLaMo翻訳を使っていて感心したのは、ページのレイアウトを可能な限り維持した状態で、ちゃんと翻訳されるという点です。いろんなところが挑戦しているものの、うまいこといってる例は世界的に見てもそんなに多くなかったので、「日本の企業がこれを作り上げたのか」とびっくりした記憶があります。それでは外に出せる形、すなわちユーザーが使ってる形にしていったのは奥井さんということなんでしょうか。
奥井:
はい、おっしゃる通りです。鈴木がコアとなる技術要素を作ってくれたのですが、質が非常に良かったので、それをお客さんにとって使い勝手のいい形、つまりUXやセキュリティ周りといったユーザビリティを作り込むのを私が担当させていただきました。あの全体的な速さは相当なものだと思っていて……そもそもモデルを作って公開したのが確か2025年5月下旬だったんですが、その時にはまだその構想は一切ありませんでした。そして同年6月下旬に鈴木がプロトタイプを作ってくれました。
G:
早いですね!
奥井:
できたプロトタイプをみんなで触って「これはすごくいい。これは欲しい人が社外にもいっぱいいるんじゃないか」という話に火がついて、そこから1ヶ月ぐらいで作ってトライアルのリリースまで至りました。なので、1~2カ月で全てが進んだというスピード感で開発されました。
G:
すごい。聞いてると凄まじいスピード感(笑) その速度は中小企業ではなく、完全にベンチャー企業ですね。参考程度にお聞きしたいんですが、PFNとしてもPLaMo翻訳の開発は早い方なんでしょうか?
PFN広報:
いや、過去の例で言いますと、ディープラーニングのフレームワークChainerを数日で作って公開したこともあります。会社の規模は中小企業のようですが、その内部では1週間単位でものが進んでいくような会社ではあります。
G:
かなりノリのいい会社なんですね。すごい。
鈴木:
そもそも弊社社長の岡野原は最先端の論文を毎日読んでいて、細かい技術の話を突然話しても全部返ってくるぐらいの人なので、テクニカルなことを直接社長に喋りかければ通るような部分も大きいと思います。トップが技術的な話をちゃんと理解しているので、いいものが社内から出てきて「これいいね」となったらそのまま行ってしまうというフットワークが他の大企業さんとの決定的な違いかと思います。
G:
なるほど、なるほど。それほどまでに爆速でリリースして、実際に外に出してみた最初の時点で「これぐらいのユーザー数が欲しい」といった目標はある程度あったと思うんですが、リリース当初から好調だったんでしょうか? それともリリースから時間が経って何かのきっかけに増えたのでしょうか。
奥井:
そうですね。利用者に関しては出だしから好調だったかなと思っています。5月にモデルをリリースした時、まずはテキストの翻訳だけができるものを出したんですが、その時点で話題になりました。その後、ブラウザ翻訳をリリースした8月頃から一気に利用者が増えました。
G:
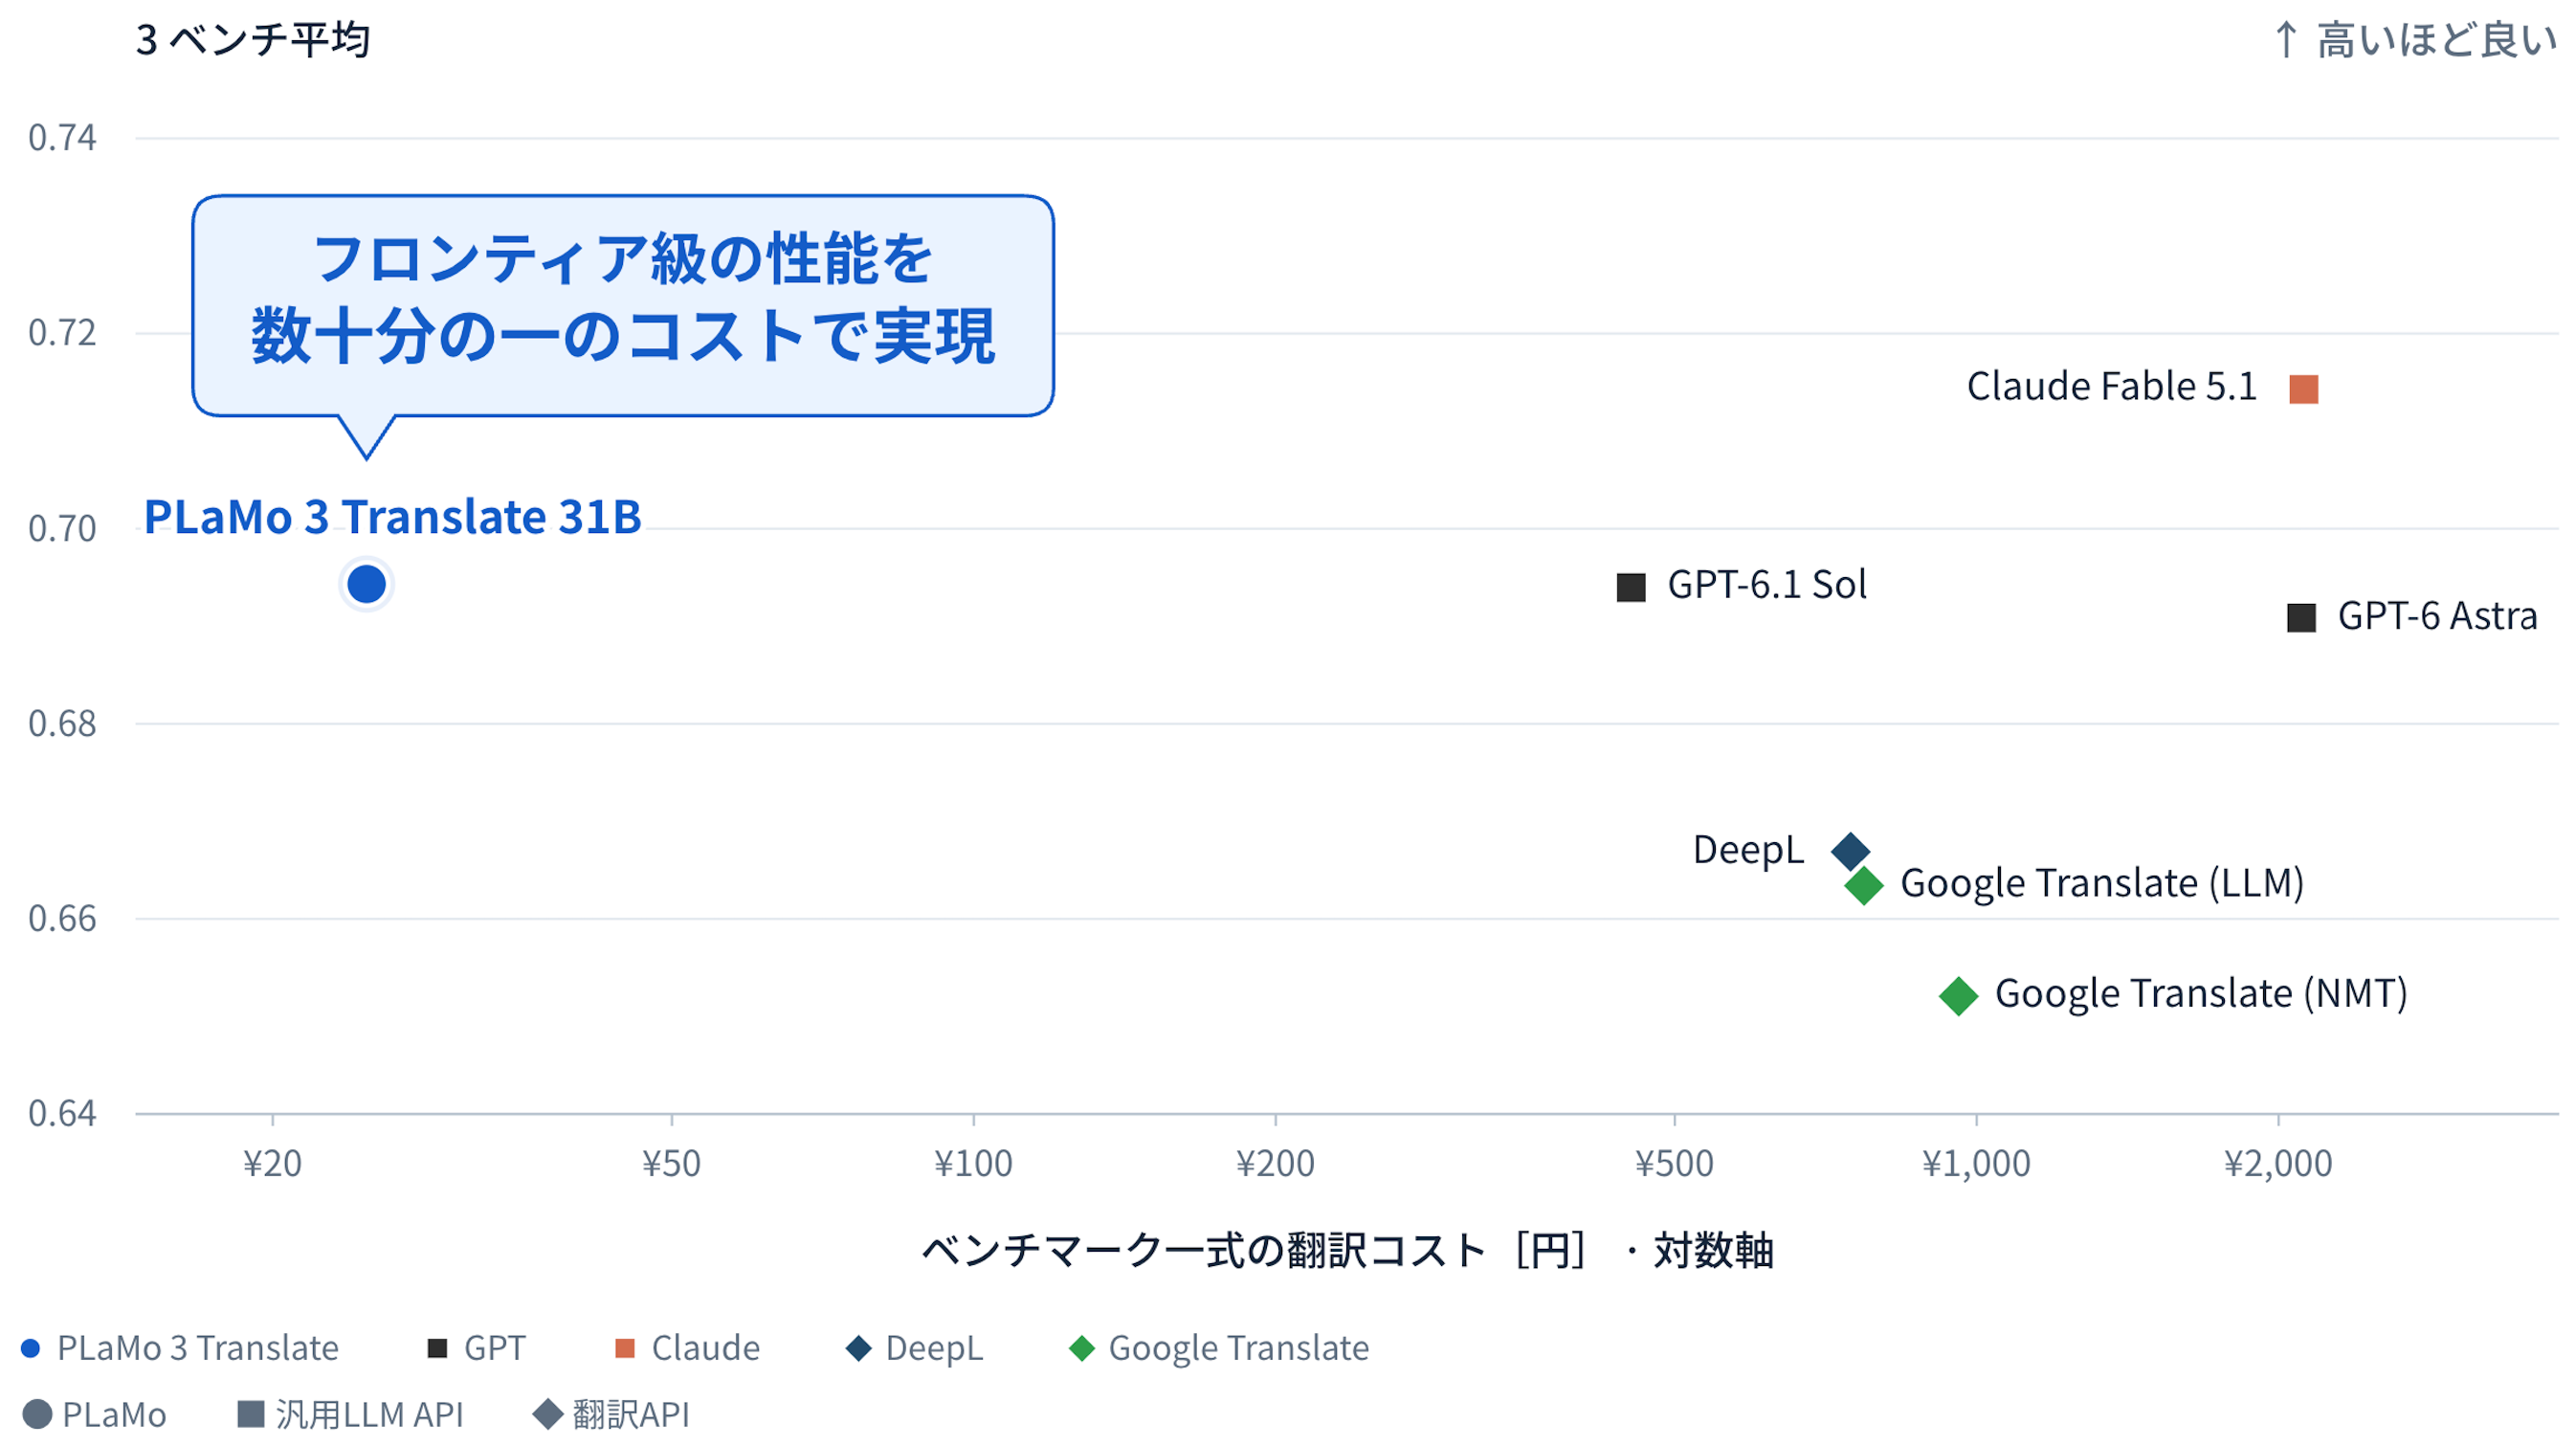
あと、あの値段の異様な安さが一番衝撃的だったのですが、あの値段で一応利益は出てるんですよね?
奥井:
利益を出すべくいろいろと努力をしておりますというところです(笑) ここに関して赤裸々に話しますと、例えばGoogle翻訳は組み込みで無償で提供していますし、DeepLも同じようなブラウザ翻訳を出していますが、比較的近い値段帯で提供しています。我々もいいものを作ったという自負はもちろんあるんですが、その値段に見合う価値を皆さまに提供するという点で……正直他社が安すぎて困っちゃうみたいなところがあるところはあるんですが(笑)
G:
そうなんですね。
奥井:
でも、やはり価格面でも他社に対してよりバリューを感じられるようにしないとそもそも検討してもらえませんので、かなり苦しい値付けになっていますが、いわばチャレンジしているというところです。
G:
実際のところ、PLaMo 3が出た時にびっくりしたのが、今までは日本語と英語の組み合わせだけだったのが突然それ以外の言語にも対応した点です。対応言語が一気にドカーンと増えたんですが、あれは何があったのでしょうか。
鈴木:
プロダクト側から割と要望が来てるところが多かったので、多言語対応はしようというのはもう決めていました。あと、翻訳は原文と訳文のペアが必要なんですね。例えばクロアチア語とロシア語をペアにした翻訳データって多分世の中のほとんど誰も作ってないと思うんですけど、LLMを使うとどっちかのデータを集めればもう片方を合成することがある程度できるようになってきました。その合成データを活用することで、これまで以上に学習データを作りやすくなったという側面があります。これは1年前からあった流れなのですが、直近になって大きく加速した部分があると思います。そういう時代の変化をうまく取り入れて、いろんな言語の間の翻訳データを作れるようになり、一気に言語対応を拡充できたというのがあります。
G:
つまり古本屋から山のように多言語の本を買ってきて裁断したというわけではなかったんですね(笑)
鈴木:
そうですね、それはやっていません(笑)
G:
PLaMoは訳文の日本語表現が非常に流暢(りゅうちょう)であるのが特徴ですが、なぜあそこまで自然な日本語に訳せるのかが非常に不思議なんですが、あれはどうやっているのでしょうか?
鈴木:
PLaMoのベースのモデル自体が日本語をかなり多めに学習に使っているモデルです。ベースモデルの時点で全体の30%ほどが日本語です。対してChatGPTだとおそらく1~2%入ってるか入ってないかぐらいだと思います。さらに追加学習データ量はだいたい文庫本72万冊分で、そのうち約23%に当たる17万冊が日本語なんですね。つまり、PLaMoは学習データの比率からある程度流暢な日本語を出力しやすいという側面があります。あと、ChatGPTみたいなAIの日本語や英語はちょっと不自然な表現をするようになっているとよくいわれますが、それはプログラムをコーディングしたり数学の問題を解決したり、そういった特定の目的を達成するための強化学習によって文章としての自然さが疎かになっているところが少しあると思います。
PLaMo翻訳の場合は純粋にすごくいいデータを作って、そのいいデータ通りに翻訳をするという、いわゆるSFT(教師ありファインチューニング)を徹底的に突き詰めたことによって流暢性を維持できたってところがあります。あとはPLaMoで良い翻訳モデルができたら、それを使ってデータをもう一回作り直すんですね。そうすると一回作った良い翻訳モデルをうまく活用して、ちょっとデータが良くなって、そしたらそのデータでもう一回学習をやり直す。それでちょっと良くなったものをもう一回データ合成に使うという、ちょっとしたループを回しています。そうすると学習が進むごとにデータもモデルも少しずつ改善を図ることができます。
今城:
そして、そこの肝が逆翻訳なんですよね。
G:
ほうほう。
今城:
今のLLMも含めて、文章の流暢性を正しく判定するのはすごく難しいんですよ。Google翻訳などでベンチマークを取っても、その流暢性を無視してスコアが取られるんで、なかなかそこで競うことは難しい。一方で流暢性を上げようと思ってもまず評価もできないので、「なるべく綺麗に翻訳したテキストを用意して、それを元に戻す」ということを学習し続けています。
例えば日本語で書かれた文章に一対一で対応するような英語を用意して、その英語から元の日本語の文章がどんなものだったかを作らせるように学習してるんです。そうするとおのずと日本語として自然なテキストを生成するようにモデルが頑張ってくれるのでそれを徹底的にやります。そして、その次のステップとして「今から翻訳じゃなくて逆翻訳を頑張りましょう」とやると、英語の方もさらに流暢になります。それを繰り返してやることで、流暢性を評価せずに流暢さを上げる工夫を行っているというのが我々の工夫の1つです。
G:
なるほど。
鈴木:
ちょっと補足すると、例えば日本語の文章を集めてきて、LLMで日本語に対して英語を合成するとします。まず自然な日本語が絶対入力になるんですけど、出力側の英語が合成データになっちゃいますよね。これを一回ひっくり返すんです。どういうことかというと「日本語から英語を合成してから、その合成した英語を入れて日本語を出す」という作業を行った時、合成に使ったLLMの書いた日本語の文章を超えるような、もっと自然な文章を書ける仕組みが内部的に入っているようなものにしようとしています。
G:
なるほど、そのループが非常に時間を食うイメージがあるんですが、実際に回そうと思うと結構時間がかかりそうですね。
今城:
いや、大変でした(笑) 特に精度を上げながら流暢性を維持するというのはすごく大変だったんで、そこは頑張りました。ちなみにこの逆翻訳を入れるとベンチマーク上のスコアは下がっちゃうんですよ。そこはトレードオフになるんです。
G:
今城さんはXでも「流暢性の向上で若干ですがキャラクターの訳し分けをする気持ちが感じられたりします」とポストされていたので、日本語翻訳の流暢性へのこだわりはあるんだろうなと感じていました。
今城:
小説を翻訳する時に、キャラクターの男性・女性を訳し分けられてないとやっぱり違和感がありますね。そういうのをちゃんとできるようにというのはちょっと意識しています。
G:
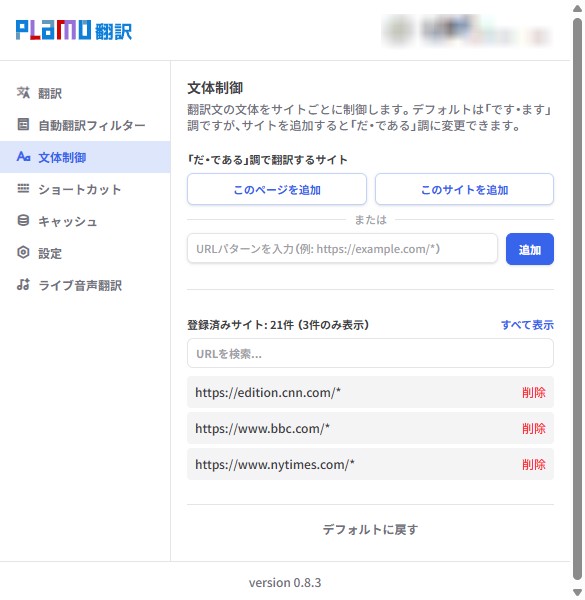
確かに。感心するのはその辺りなんですよね。PLaMoには「である」調や「です・ます」調を使い分けるという設定があるんですが、キャラクターや語尾という点では普通に翻訳してるだけでも読んでいて引っかかりがないという意味で、PLaMo 3で翻訳された文章は自然で流暢な日本語に翻訳されていて、最後まで引っかからずに読めます。
G:
あと地味なところでは、ページを丸ごと翻訳した時の速度が激烈に上がった気がします。レンダリング速度が突然向上した理由は何かあるんでしょうか。単純に反応速度が上がったのか、それとも違う理由なのか。
鈴木:
それはモデルの推論最適化というものですね。細かい量子化であるとか、先読みみたいなことをちょっとやるとか、そういうちょっとした工夫を積み重ねると、速度が同じモデルでも倍速ぐらいは期待できるような細かい最適化ができるようになってきており、今回PLaMo 3を開発するタイミングで同時に作り込んでいます。
G:
Google翻訳は一体何をどうやったらこんな速度で書き換わるんだという速さで書き換わるのですが、あれはレイアウトが壊れてしまうことがありますね。
鈴木:
他社の場合は古いモデルを使うことで、表示がすごく早い代わりに精度は落ちるということはあると思います。
G:
そうですね。だから精度をよくすると「ど、どうしたの? なんか硬直してるの?」みたいな時もあります。あと、「語尾が完全に同じ形の繰り返しになる」というのをある程度回避する機能があると非常に嬉しいですね。例えば文末で「です」が連続すると稚拙に見えてくるので、GIGAZINEで記事を書く上でも避けています。論文だとそういう文章でも成立するのですが、「いや、絶対に日本語だとこういうふうには言ってないんだよな」という違和感を感じる時があるので、翻訳でも文末に多様性を持たせるといった日本語表現の部分にもう一工夫があるとうれしいですね。……すいません。突然機能リクエストが始まってしまって(笑)
今城:
ユーザーインタビューだ(笑)
鈴木:
面白いですね。
奥井:
貴重なご意見ありがとうございます。
G:
OpenAIやAnthropicやGoogleもAIモデルを開発していますが、ああいったAIモデルとの差別化要素とはなんでしょうか。今の話でいうと、PLaMoの場合は要するに「そもそも学習してる日本語量が多いので、そこをクリアしやすい」というイメージで一応合ってるんでしょうか。
鈴木:
現状としてPLaMoのことをよく言うんだったらたぶん正しいですね。すごく赤裸々に言ってしまうと、ChatGPTやClaudeでちょっと妙な表現が出てくる理由は、おそらくプログラミングを書いたり数学を解いたりすることだけを高める学習だと「プログラミングや数学の他は犠牲にしてもいい」みたいな方向の学習が進むことがあって、そういうことをやり尽くした結果で妙な表現が頻出するのではないかと考えています。そういう点でいうと、もしPLaMoの開発を突き詰めていったらああいう方向になっちゃう可能性もあります。もちろんそうならないように頑張ろうというのがこれからの目標だと私は考えています。
G:
なるほどなるほど。一番基礎を作った今城さんとしては、どうでしょうか。
今城:
いや、これは非常に難しい問題で……何かしら評価ができるといいんですよね。その評価が難しいのでいろいろ苦心しています。例えば翻訳だったら翻訳モデルを使うのも一つのアプローチだし、あるいは修正するモデルなど、何らかの形でうまくできるように頑張りたいなと思っています。あの、僕自身も日本語の表現に関して、世の中の人はあんまり気にしてないのがすごく違和感があるレベルで気になるところがあって……例えばTikTok由来の動画で中国語フォントのキャプションが出ることがありますよね。僕はあれを見ててどうも耐えられないんですけど。
G:
(笑)
今城:
どうにかならないかなぁ。でも一方でオフィシャルなドキュメントに中国語フォントで書かれた文章が出てくるというのはさすがにその企業の信用問題にも関わるので、ゆくゆくは解決されていくんじゃないかなと思っています。中国語系のモデルだとやっぱり中国語特有の漢字や熟語がよく出てくるんですよね。そういった部分がもしかしたらモデルの差別化に使えるんじゃないかなと期待しています。
G:
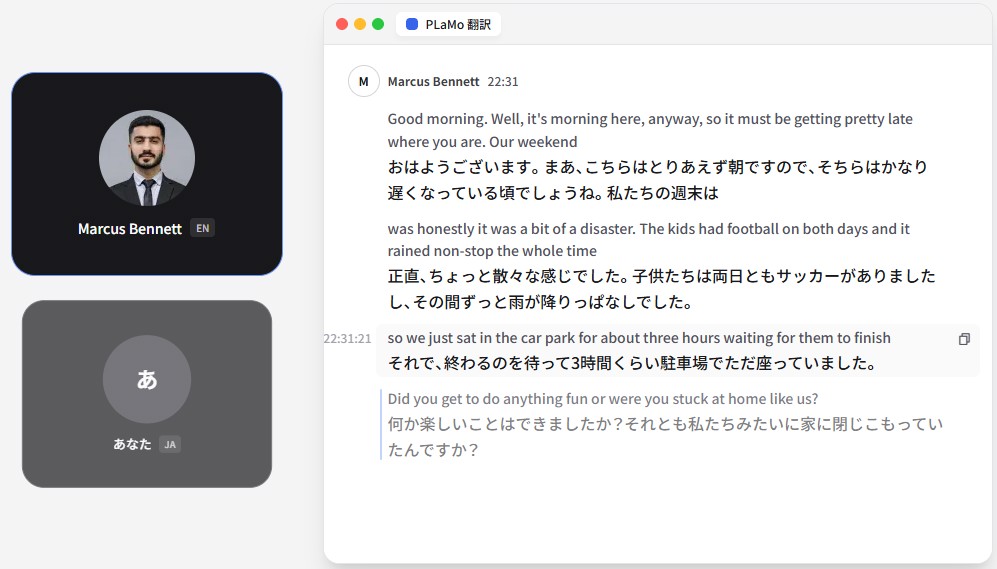
PLaMoで会議音声をリアルタイムで翻訳する「会議翻訳」という機能について、オンライン会議にPLaMoを参加させて3か国語同時で翻訳するというすさまじい機能がいつの間にか実装されていたんですが、あれもPLaMo 3のモデルの延長線上でああいうのが作られてるということなんですかね。
奥井:
はい、会議翻訳に関してはもちろんPLaMo 3を使っていて、PLaMo 3の翻訳品質の向上や速度の改善がしっかり効いている機能ですね。加えて、会議翻訳を実現しようと思うと翻訳だけではなくて、文字起こしをリアルタイムかつ高い精度で行う必要があります。翻訳で時間がかかってたら、やはり会議のテンポが悪くなっちゃいますし、文字起こしに失敗すると、そもそも間違った文章を翻訳しても当然間違ってしまいます。そのクオリティをいかに上げるかというところにこだわって作った結果、あの会議翻訳の機能が生まれております。なので、モデルの作り込みとそのアプリケーション自体のその品質を高めるための作り込みの合わせ技で実現できているといえますね。
G:
価格表を見て疑問に思ったのですが、何万語まで使えるという上限があるじゃないですか。わざわざああいったキャップが設定してあるということは、最高金額のプランでもあれを超えて使う人がある程度いるということなのでしょうか?
奥井:
機能によって違うんですけれども、文字数でキャップをかけているところに関してはほとんどいらっしゃらないです。かなり高めに設定されているので、ごくまれにいらっしゃるんですけれども、本当に極めてまれですね。
G:
それでもいるんですね(笑)
奥井:
はい。ただし最上位プランの方だとまだ到達された方はいらっしゃらないはずなので、非常にたくさん使っていただける形でご提供させていただいてます。
G:
やはり上限はかなり上に設定してあるということなんですね。
奥井:
そうですね。
G:
こんなことを聞いていいのかはわからないのですが、普通の日本人が話すような自然なレベルの日本語、要するに人が書いた文章と全く見分けつかず、全く違和感がないレベルに翻訳できるようになるのはいつなのでしょうか。難しいというのはわかるんですけれども、時間の問題なのか、それともそうではないのか。
奥井:
違和感ゼロというのは難しいかもしれないですけど、現行の翻訳モデルでも、少なくともこの速度で出てくる翻訳としてはかなり高いレベルに来ているので、そういう意味ではだいぶ差別化が難しい時代になってきてるかなと思います。一方で書籍を翻訳する場合、やはり長い文章だとちょっと気になるところは出てくることもあります。そこはどちらかというと翻訳モデルというよりもエンジニアリングに近い部分がありますね。書籍を翻訳するときにもまずは下訳を作って調整することはあると思うんですが、突き詰めるのはおそらくそっちの方向になると思います。まぁでも、そんなに遠くはないとは思いますね。今の技術でも工夫次第でもうちょっとうまくいくかなという気はしています。
G:
ああ、なるほど。そういうふうに言ってもらえると、今の翻訳モデルのレベルがすごいと実感できます。最後に、今回のインタビューを読んで「なるほど、じゃあPLaMoを一回使ってみるか」というGIGAZINE読者が絶対出てくると思うんですが、そういう人たちに向けて「PLaMo翻訳を使うのであれば、こういう風に使ってもらえるとその性能を実感できるよ」などのアドバイスがあれば。
今城:
ブラウザ翻訳は海外の小説を読むのに面白いなと思うんで、そういうところで差が出やすいのは結構面白いかなとは思います。あとこれは言っていいのかな……近々小さいモデルを出します。それは手元でびっくりするぐらい動くんですよ。それはぜひ体験してほしいですね。それぜひ体験してほしいですね。
G:
それはすごい。
今城:
そうです。スマホでも結構動くので、そこはちょっとぜひ楽しみにしておいてください。
G:
それは非常に楽しみですね。スマホで動くのは確かにすごいですね。
今城:
PCはもちろん、スマホでも当然動きます。PCだとすごくサクサク動きますし、なおかつ文章がネットワークにも流出しないので、いろんな人に安心して使ってもらえます。今まで国内ではなかったし、海外でもなかなか類を見ないと思います。
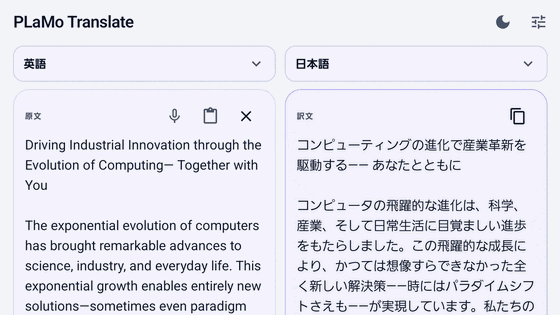
編注:このインタビューを行ってから後日、PFNからPLaMo 3 Translateのモデルウェイト4種が公開されました。実際に0.8Bモデルや2BモデルをスマートフォンやノートPCのローカル環境で爆速動作させてみた様子は以下の記事で確認できます。
国産日本語翻訳AI「PLaMo 3 Translate」の4モデルをPFNが無料公開、スマホ上のローカル動作でも爆速&高精度の日本語翻訳が可能になったので試してみた - GIGAZINE
G:
なるほど。エンジニアの鈴木さんの立場からこういうような使い方とかおすすめだよというのはありますか?
鈴木:
そうですね。今城が言ってくれた通り、いろんなモデルを公開するので自分のアプリに組み込んで使ってもらってもいいですし、試してみるのもいいですね。特にスマートフォンでも動くものを近々出すので、そこにぜひ着目してほしいというのが一番大きいと思っています。スマホで動くぐらいの規模のLLMは通常10億パラメータ以下で、それくらいになるとチャットだと全然使い物にならないんですが、翻訳に関しては普通のユースケースで全く不満がないぐらいのレベルに到達したと思っています。スマートフォンで動くLLMの実用的なユースケースとしては世界最先端のものを作れたと思っていて、そこはぜひ着目してほしいので、ぜひお楽しみに。
G:
それでは一番最後に、プロダクトマネージャーの奥井さんからもGIGAZINE読者にこういうような使い方がおすすめですよというのがあれば、なんか教えていただきたいです。
奥井:
そうですね、1つ目は今城や鈴木からの内容と基本同じになるんですけど……自動翻訳がほとんど人間が訳したのと見分けがつかないレベルになる世界は本当に近づいていると思うんです。LLMは結局そのサイズや投入した計算資源など、「モデルが大きいのはもはや正義で、大きければいくらでも精度上がる」というように資本の物量勝負みたいになってるところがあります。それこそGoogleなどが大きいモデルを出してきて、それで翻訳すると精度がガンガン上がるということをアピールしていますが、一方で我々の取り組みで主張したいのは「それらと同等の精度をめちゃめちゃ小さいモデルで実現してます」というところですね。ユーザー目線で見ると、結局裏のモデルが大きかろうが小さかろうが、最終的に同じようなインターフェースであれば一緒なので、そこはコストの安さや処理の速さといったところでしか体験できない部分ではあるんですが。
G:
そうですね。
奥井:
でも、モデルが小さいということは、スマートフォンや自分のPCなど手元で動いちゃうということです。昨今は情報漏えいが大きな問題になっていますが、自分の手元で動かせるから機密性の高いものでも翻訳できるといったユースケースがすごく広がってくると思っています。そこで「手元で動くものでめちゃめちゃ品質高いモデルを作り上げた」というのが今回のすごい成果だと思っているので、我々としてもいろんな方に触れていただけるようにしていきたいというふうに思ってますし、ぜひ皆さんも触っていただきたいなというふうに思ってます。
G:
なるほど。
奥井:
もう一点、翻訳もLLMで非常に高いクオリティにまで成長してきたので、各社モデルで比較してもかなり差別化が難しいと思います。一方で実利用シーンで見ると、例えばブラウザで翻訳すると文の構造が変わっちゃっておかしくなっちゃったり、PDFファイルの論文を読んでも数式がぶっ壊れちゃったりすることがあります。会議翻訳にしても、Google MeetやTeams、Zoomにも組み込みの翻訳があるんですけど、自分が会議の内容を理解する用途では使えるけど、お互いに母語で話し合うのは困難ですよね。日本人の多くは英語を喋るのが大変だから、喋るのも日本語でできたら嬉しいじゃないですか。
G:
確かに確かに。
奥井:
そういうところのユーザー体験をより高めていくというところがすごく大事だし、我々としてはその点をしっかり突き詰めていきたいというふうに思っています。なので、小さいモデルですごくいいもの出したというのに加えて、実際の翻訳体験をより向上していくためにはできることがたくさんあるので、そういったところを我々としてはしっかりこれからもやっていきます。ブラウザ翻訳やファイル翻訳、会議翻訳、さらにちょっと驚きを感じられるものを引き続き提供していきますので、ぜひ使っていただきたいですし、今後のアップデートにもご期待ください。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.