Убрать оригинальную речь из старого закадрового перевода
Суть идеи в том, что я хотел получить очищенный русский перевод для фильмов, в которых изначально под озвучкой был слышен английский оригинал. При этом сохранить музыку, звуки и сам голос переводчика.
Это мой давний закидон. Два голоса одновременно мне сильно мешают погрузиться в кино. Понимаю, что большинство людей это вообще не беспокоит, но я, к сожалению, не из них.
В результате эксперимента получился DubClean — это сервис, который сопоставляет оригинальную дорожку и дорожку с русским закадровым переводом, выделяет речь, убирает английскую подложку и собирает результат с музыкой и эффектами. Внутри сервиса готовые модели, две небольшие собственные нейронки и несколько алгоритмических этапов. Ниже опишу, как сложилась эта схема и где у неё остались ограничения.
Что удаляем
В закадровой озвучке перевод записан поверх готового звука фильма. Если переводчик заглушит исходную дорожку целиком, вместе с английским пропадут музыка, шаги, выстрелы и всё остальное. Поэтому оригинал оставляют слышимым.
В полноценном дубляже используют отдельную основу без диалогов, но для доступных мне старых закадровых переводов такой основы у меня не было. Поэтому сейчас для работы у меня есть только уже сведённая смесь: русский перевод + английская речь + музыка и эффекты.
И именно из этой смеси нужно было достать насколько возможно чистый русский перевод, а затем соединить его с чистым фоном. При этом сам перевод должен остаться полностью прежним, без перезаписи реплик или синтеза нового голоса.
Гипотеза про громкость и запаздывание
Первый эксперимент был с моделью, которая должна была выделять голос переводчика из одной смешанной дорожки. Начать хотелось с наиболее заметных различий между переводом и оригиналом. Переводчик обычно звучит громче и вступает немного позже исходной реплики (так я думал). Казалось, что этих различий может хватить, чтобы отделить нужную речь.
Эксперимент был доведён до работающей модели. На фильме, с которого всё начиналось, результат выглядел более‑менее пригодным. Но проверка на других фильмах показала, что для полноценной обработки этого недостаточно.
Соотношение голосов оказалось слишком непостоянным. Оригинал бывает тише перевода, громче или почти на одном уровне. Переводчик начинает позже, заканчивает раньше, иногда говорит уже поверх следующей реплики. В результате модель не обеспечивала устойчивого выделения русского перевода. В обработанной дорожке оставались то русские, то английские фрагменты, иногда прямо внутри одной фразы. При работе с полным звуком фильма заодно повреждались музыка и эффекты.
У меня, в общем‑то, нет требования получить идеальный студийный дубляж. Небольшие остатки оригинала или отдельные артефакты я готов терпеть. Но фильм, в котором половину предложения нужно слушать по‑русски, а половину по‑английски, мне точно не подходил.
Вариант с одной дорожкой я отложил. Стало понятно, что быстро закончить эксперимент не получится и придётся глубже разобраться в том, с каким звуком вообще предстоит работать.
Вторая референсная дорожка
Первым делом я решил убрать из задачи музыку и эффекты. Пока модель одновременно разбирается и с двумя голосами, и со всем остальным звуком фильма, слишком легко испортить что‑нибудь лишнее. Поэтому сначала нужно извлечь речь, а дальнейшие эксперименты проводить уже с ней.
Для этого я выбрал MossFormer2 SE 48K из ClearerVoice‑Studio. На выходе получалась дорожка с голосами, отделённая от основной части фона. Оба языка в ней оставались, но теперь хотя бы было понятно, что именно мы обрабатываем.
Следующая мысль была про оригинальную дорожку. Английский голос, который мешает в переводе, уже существует отдельно в оригинале того же фильма. Значит, можно дать системе образец того, что требуется удалить.
Получалась такая схема. Из закадрового перевода извлекаем смешанную русскую и английскую речь. Из оригинала извлекаем английскую. Затем пытаемся убрать из первой дорожки то, что есть во второй.
Следующим экспериментом стало простое алгоритмическое вычитание. Дорожки выравнивались по времени, после чего оценивалась и подавлялась общая составляющая. Получилось довольно плохо. Звук становился глухим, отдельные слова сжёвывались, а английская речь всё равно местами оставалась.
На слух в двух файлах говорит один актёр и произносит одну реплику. Но для вычитания этого недостаточно. В дорожке перевода оригинал уже приглушили, сжали, пропустили через другой кодек или иначе обработали частоты. К этому добавляются небольшие временные расхождения. Образец похож, но точно повторить им сигнал внутри перевода не получается.
При этом сама идея с двумя входами в перспективе оказалась полезной. В отличие от первой попытки, теперь был явный образец того, что нужно убрать. Я решил обучить небольшую модель именно под такую постановку.
На вход она должна получать смесь голосов и английский референс, а на выходе оставлять чистый русский перевод. Для этого понадобились обучающие примеры, в которых известны все три сигнала.
Какие бывают условия переводов
После первой попытки я уже не хотел собирать данные по принципу наложения одного голоса на другой и смотреть, что получится. Такой датасет легко воспроизведёт исходную ошибку, если во всех примерах перевод окажется громче оригинала.
Поэтому я начал с прослушивания разных дорожек и списка условий, которые должна выдерживать модель. Оказалось, что вариантов заметно больше, чем просто громкий и тихий голос.
— Типы голосов: мужские, женские, детские, молодые и пожилые, с низким или высоким тоном, хриплые и похожие друг на друга.
— Манера говорить: спокойная речь, эмоциональная, шёпот, крик, оборванная реплика.
— Темп и плотность: несколько слов с паузами, длинный монолог, быстрый диалог, несколько говорящих подряд.
— Наложение реплик: перевод может начинаться после оригинала, раньше него, перекрывать только часть фразы или продолжаться, когда английская реплика уже закончилась.
— Соотношение громкостей: английский тише русского, примерно на одном уровне или громче. Этот пункт отдельно учитывал неудачу первой модели.
— Приглушение подложки: оригинал может быть тихим постоянно, становиться тише только под переводчиком, приглушаться с задержкой или менять уровень по ходу сцены.
— Соответствие референса: небольшой сдвиг, разная скорость, постепенный уход по времени, монтажный скачок, неполная или вообще чужая реплика.
— Качество звука: ограниченная полоса частот, шум, гул, компрессия, короткие провалы, остатки музыки и повреждения после извлечения речи.
Из этого постепенно получился план с 18 факторами и более чем сотней вариантов. По этому плану был собран генератор обучающих примеров. Полный перебор всех сочетаний был бы слишком большим, поэтому генератор должен был соблюдать заданные доли отдельных условий и проверять важные сочетания. Например, английский громче русского именно в момент их наложения, а не где‑нибудь в паузе.
Дальше нужно было найти материал, в котором эти условия можно воспроизвести.
Каталог речевых фрагментов из фильмов
Я собрал исходный материал из 25 фильмов, всего 45 аудиодорожек. Среди них были оригиналы и русские дорожки с чистым переводом, без слышимой английской подложки. Чистый русский был нужен для того, чтобы позже собрать закадровую смесь и при этом сохранить правильный ответ. Источники фильмов не скажу.
Фильмы подбирались с учётом вариативности, перечисленной выше. Если нужны детские, пожилые, высокие и низкие голоса, одних спокойных диалогов взрослых мужчин недостаточно, сколько их ни нарезай.
Для подготовки материала было собрано отдельное приложение. Оно позволяло открыть дорожку, увидеть разметку, послушать нужный участок и проверить, что попадает в каталог. Сначала из аудио извлекалась речь, затем она разбиралась на фрагменты с дополнительными признаками.
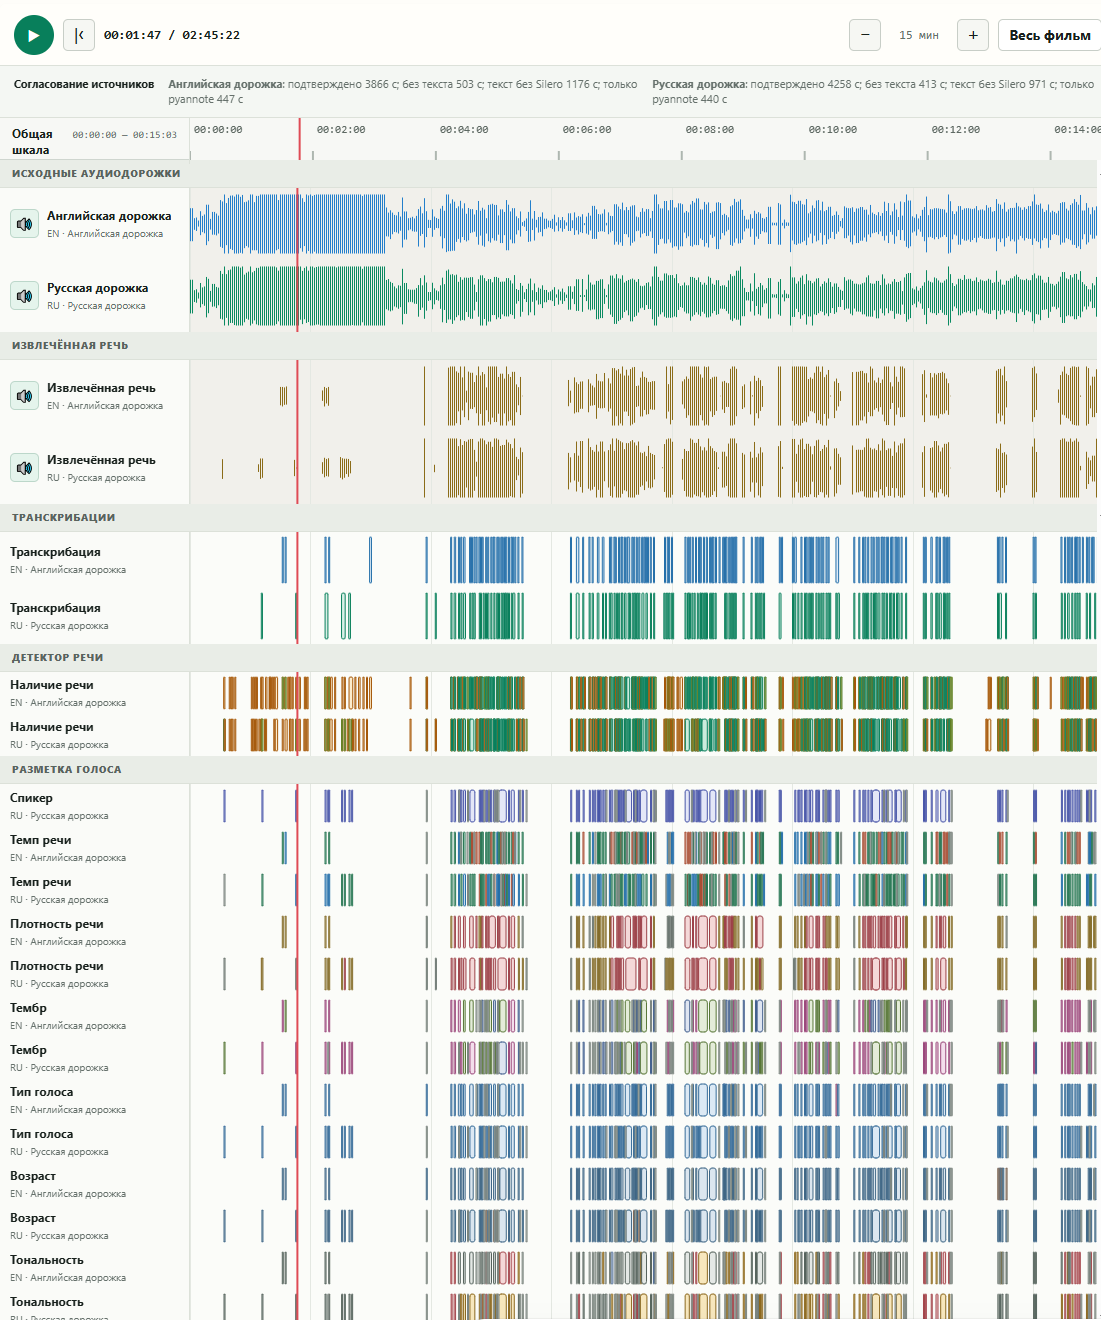
Silero VAD находил участки, где есть речь. pyannote.audio выполнял диаризацию, то есть группировал реплики по говорящим. Это помогало отличать несколько фраз одного человека от набора разных голосов.
Модель audeering на базе wav2vec2 давала предварительные оценки типа голоса и возраста. openSMILE считал акустические признаки, в том числе высоту тона и громкость. SpeechBrain помогал с грубыми эмоциональными метками. Темп речи оценивался по транскрибации и длительности, а эмбеддинги wespeaker использовались для поиска похожих голосовых кластеров, которые диаризация могла ошибочно разнести.
Это всё было нужно для отбора материала под конкретный вариант. Если генератору нужен тихий детский голос или эмоциональная женская реплика, он должен находить подходящий фрагмент, а не просто подписывать случайный кусок нужной меткой. Если требовался детский голос, в пример попадала детская реплика из исходного материала.
На этом этапе тоже нашлись ошибки. Например, на одной из дорожек с закадровым переводом оценки типа голоса и возраста сначала считались по участкам, где одновременно звучал английский. Классификатор уверенно описывал смесь двух людей. Выглядело правдоподобно, но для отбора русского голоса такие признаки были бесполезны.
Пришлось учитывать активность английской речи и искать более чистые фрагменты для оценки русского голоса. После перепроверки на этой дорожке из пятнадцати якобы устойчивых голосовых профилей осталось пять. Кластеры с заметным наложением оригинала были отмечены отдельно.
По той же причине я не стал считать результат любого разметчика истиной. Интервалы речи сопоставлялись по VAD, диаризации и транскрибации. Расхождения отмечались отдельно. Эмоции и возраст оставались вспомогательными признаками, а не точными характеристиками актёров.
В общем каталоге получилось около 13 тыс. речевых клипов общей длительностью около 25 часов. Дальше из этого пула выбирались подходящие русские и английские фрагменты для синтеза обучающих смесей.
Как собирался один обучающий пример
Здесь как раз пригодился чистый русский перевод. Генератор брал русский фрагмент, подмешивал к нему английскую речь и отдельно сохранял английский образец. Получались смесь для очистки, референс для удаления и эталонный результат.
Например, русскую реплику можно было начать чуть позже английской, оригинал приглушить только на время перевода, а референс немного сдвинуть и изменить его скорость. В другом примере английский делался громче русского, в третьем реплики перекрывались только концами.
При этом менялись не только уровни. Добавлялись шумы, частотные ограничения, имитации плохого кодирования и ошибок речевого экстрактора. Для модели было важно встретить не только аккуратную лабораторную смесь, но и то, что действительно приходит после обработки фильма.
Отдельный блок понадобился для разных мастерингов. В ранней синтетике английская подложка и референс были слишком похожи. На реальных релизах они так не выглядят. Поэтому в сложных примерах встроенная английская речь и её образец проходили независимые цепочки обработки.
Там имитировались различия сведения каналов, эквализации, динамической компрессии, плавающей громкости и микросдвигов. Важно было сохранить известный правильный ответ. Если сначала смешать голоса, а потом произвольно испортить весь файл нелинейной обработкой, отдельная чистая русская запись уже не обязательно будет точной целью для этой смеси. Поэтому преобразования учитывались по компонентам, чтобы удаляемый английский и целевой остаток по‑прежнему в сумме давали вход.
Ещё понадобились примеры, где ничего убирать не нужно. Только русский голос, пустой референс, тишина, образец из другой сцены. Иначе модель, которую учат только удалять, начинает искать себе работу даже там, где её нет.
Финальный набор собирался в несколько этапов. К 60 тысячам базовых примеров добавились 32 тысячи со сложными различиями обработки. Затем около 6 тысяч случаев «не вмешиваться» были повторно включены в обучение, чтобы довести их долю примерно до 20%.
В итоговом манифесте получилось около 98 тысяч примеров по 6 секунд. Примерно 82 тысячи использовались для обучения, по 8 тысяч для валидации и теста. Повторы здесь входят в общий счётчик, это не 98 тысяч уникальных исходных записей.
Фильмы разделялись между выборками до генерации смесей. Фрагменты одного произведения не должны были одновременно оказываться в обучении и тесте. Для сложных преобразований также разносились сочетания параметров, чтобы проверка не сводилась к повторению уже знакомого рецепта.
Что получилось обучить
Основную модель я назвал DubClean Voice. В итоговой версии 3 883 906 параметров. Она работает с речью на 24 кГц и сравнивает спектральные признаки смеси и референса. Небольшой U‑Net строит комплексную маску, которой преобразуется входной сигнал.
Одна из доработок касалась самой маски. В ранних вариантах её возможности были слишком ограничены, и подавление упиралось примерно в 4–6 дБ. Когда два голоса совпадают по времени и частотам, обычного приглушения недостаточно. В итоговой версии коэффициенты допускают усиление больше единицы, отрицательную действительную часть и изменение фазы.
Обучение проходило локально на тогдашней GTX 1060 с 6 гигами памяти. Одна эпоха занимала примерно 3 часа. После нескольких итераций с данными и дообучением по валидации был выбран чекпойнт эпохи 37. Следующие две эпохи дали худший результат, и обучение на этом завершилось.
На синтетическом тесте ошибка относительно русского эталона уменьшилась примерно на 7,5 дБ, а SI‑SDR составил около 24,2 дБ. Первая метрика отражает изменение ошибки между смесью и результатом очистки, вторая оценивает сходство с русским эталоном. По этим значениям удобно сравнивать версии, но они не описывают качество готового фильма целиком.
Поэтому дальше я проверял модель в конвейере на реальных дорожках. Можно было послушать и результат, и удалённую часть. Если в удалённом вдруг оказывалось русское слово, было понятно, какой именно случай ещё не учтён.
Почему после обучения работа не закончилась
К этому моменту модель умела обрабатывать речевой слой, но из него ещё нужно было получить полноценный звук фильма. На реальных прогонах нашлось несколько отдельных проблем.
Извлечение речи иногда теряло нужный голос
MossFormer2 хорошо справлялась с обычной дорожкой, но на двух наложенных голосах могла убрать часть русского ещё до DubClean Voice. Это ломало всю дальнейшую обработку. Следующая модель не может сохранить то, чего ей уже не дали на вход.
Под этот случай была подготовлена отдельная синтетика с наложенной речью, а MossFormer2 дообучена сохранять оба слоя. Поэтому в итоговом пайплайне используются разные экстракторы. Оригинал обрабатывает обычная версия, закадровый перевод обрабатывает дообученная.
Музыку и эффекты пришлось возвращать отдельно
Если очищенную русскую речь просто положить в фильм, весь остальной звук исчезнет.
Фон я решил получать из оригинала. Для этого появилась вторая модель, DubClean M&E, с 2 076 290 параметрами. Она получает полный звук оригинала и извлечённую из него речь, после чего строит музыку и эффекты без диалогов.
Подготовка данных для неё уже опиралась на сделанные инструменты. В обучении использовались фон (размеченные участки без речи) и добавленная речь, а извлечённый речевой сигнал служил подсказкой, что именно нужно удалить.
Для этой части также проверялись TIGER‑DnR, BandIt Plus и BandIt v2 multilingual (допускаю, что эти испытания могли быть проведены не вполне корректно, но как есть). Полноценного сравнения на достаточно большой независимой выборке не было, поэтому выводов о превосходстве одной модели над другой я не делаю. В текущем пайплайне осталась DubClean M&E.
Одинаковые слова удалялись на обоих языках
Имена и слова вроде «план» могут прозвучать почти одинаково по‑русски и по‑английски, причём в одном месте. Для референсного удаления это крайне неприятный случай (У нас есть ПЛАН — We have a PLAN). Модель находит сходство с образцом и убирает заодно русское слово.
Для таких мест появился модуль защиты. Он сравнивает удалённую часть с референсом и ищет короткие речевые остатки, которые образцом плохо объясняются. Если есть признаки потери нужной речи, часть сигнала возвращается.
Иногда вместе с русским словом возвращается и немного английского. Меня такой компромисс устраивает. Отдельное сдвоенное слово меньше мешает просмотру, чем потерянное слово или весь фильм с двумя голосами.
Есть и проверка целостности более длинных реплик. Она нужна, чтобы очистка не превращалась в незаметное вырезание фраз.
Повторный проход мог и помочь, и навредить
После DubClean Voice иногда оставались призвуки и артефакты. Повторный проход через MossFormer2 в некоторых местах убирал их очень хорошо, но в других повреждал речь.
Повторный проход был оставлен опциональным. Для него была добавлена проверка потери речи по сравнению с первым результатом. Если второй проход теряет часть фразы, сохраняется первый. Промежуточные результаты доступны для прослушивания.
Песни тоже оказались речью
Экстрактор воспринимает вокал как голос, который нужно отделить. Дальше конвейер может удалить его так же, как английский диалог.
Для защиты песен используется EfficientAT. Одной метки «здесь поют» оказалось недостаточно. Проверяются продолжительность, наличие музыки и потеря вокальной энергии после обработки. Если признаки сходятся, подходящий участок восстанавливается из оригинала.
Полностью закрыть эту проблему пока не удалось. В некоторых случаях песни всё ещё повреждаются, хотя с включённой защитой песен стало сильно лучше.
Подходящий оригинал есть не всегда
Две дорожки одного фильма могут различаться не только задержкой. Бывают разная скорость, другой монтаж и настолько разная обработка звука, что референс почти перестаёт соответствовать английской подложке.
Для временных расхождений в пайплайн были добавлены глобальное и локальное выравнивание. Сервис ищет соответствие по нескольким признакам, оценивает смещение по участкам и учитывает постепенный дрейф. Монтажные разрывы не пытается исправить одним сдвигом на весь фильм.
Но был и случай, когда после обработки английский практически не убирался (признаюсь, это фильм «Бронсон»). При проверке оказалось, что речь в выбранном оригинале очень слабо коррелирует с подложкой перевода. Для этой пары моя модель не давала приемлемого результата.
После этого в сервисе появилась предварительная проверка на пяти сценах из разных частей фильма. До полной сборки можно послушать результат и увидеть оценку совместимости дорожек. Это помогает не тратить часы на пару исходников, с которой текущий метод не справляется.
Какой пайплайн получился в итоге
В сервис загружается один фильм с несколькими аудиодорожками или два отдельных фильма с разными дорожками. Пользователь выбирает оригинал и перевод, запускает сопоставление и проверяет превью.
Дальше извлекаются оба речевых слоя. Английский приводится к таймлайну перевода и при необходимости адаптируется по громкости и частотному профилю. DubClean Voice убирает соответствующую ему подложку, после чего работают защиты русской речи и, если включён, второй проход очистки.
Параллельно DubClean M&E получает музыку и эффекты из оригинала. Фон переносится на тот же таймлайн, смешивается с русским голосом, затем применяется защита песен. Баланс речи и фона можно поправить вручную.
На выходе сохраняется отдельная звуковая дорожка. При необходимости сервис собирает с ней фильм, копируя видео без перекодирования. Промежуточные результаты тоже остаются доступными, поэтому можно проверить каждый этап и понять, где появился дефект. Готовые шаги кэшируются, чтобы изменение настройки не запускало весь процесс заново.
Результаты и оставшиеся ограничения
В итоге получилось собирать дорожку из очищенной русской речи и отдельно восстановленного фона. Насколько хорошо это работает на конкретном фильме, зависит от исходников. В примерах до и после обработки можно сравнить, насколько слышен английский и что произошло с русскими репликами, музыкой и эффектами.
Ограничения у текущей версии вполне конкретные. На другой языковой паре (французский, итальянский и так далее) я её не проверял. Речевой слой обрабатывается на 24 кГц, его полоса ограничена 12 кГц. Некоторые характерные голоса старых авторских переводов слабо представлены в обучении (тот же Гаврилов или Гоблин), потому что чистых записей этих голосов у меня не было. Песни иногда страдают, похожие слова могут остаться сдвоенными, а неподходящий референс делает всю обработку бессмысленной.
На основную часть эксперимента ушло около месяца. В этот срок вошли первые проверки, подготовка и разметка данных, обучение и сборка пайплайна. Больше всего времени заняли данные и проверка результата на реальных дорожках.
Где посмотреть результат и скачать проект
Видеофрагменты‑примеры до и после обработки собраны на Google Drive. По ним можно послушать, что получилось, и оценить, насколько заметны оставшиеся артефакты.
Модель DubClean Voice размещена на Hugging Face. Её можно скачать отдельно и использовать в собственном пайплайне.
Исходный код сервиса и инструкция по запуску доступны на GitHub. В репозитории находится код работы с обеими моделями DubClean и остальными этапами обработки. Небольшие веса включены в репозиторий, большие скачиваются установщиком из GitHub Releases.
Полный комплект для локального запуска, включая веса моделей и необходимые компоненты, можно скачать с Google Drive. Это вариант для тех, кто хочет запустить готовый пайплайн, не собирая его по частям.
Код DubClean и две собственные модели распространяются под AGPL-3.0-or‑later. Допускается в том числе коммерческое использование при соблюдении условий лицензии. Сторонние компоненты сохраняют свои лицензии.
Если будете публиковать обработанные дорожки где‑то в своих сервисах, у меня есть небольшая просьба добавлять к названию озвучки «очищено DubClean» или просто «by DubClean». Это добровольная пометка, не условие лицензии. Мне как зрителю, как и другим людям, она поможет узнать очищенную версию и понять, какую дорожку выбирать.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.