AI「Ataraxos」が軍人将棋型ボドゲ「ストラテゴ」で世界最強クラスのプレイヤーに15勝1敗4分で大勝
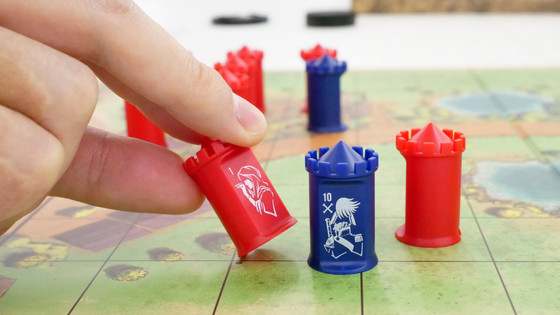
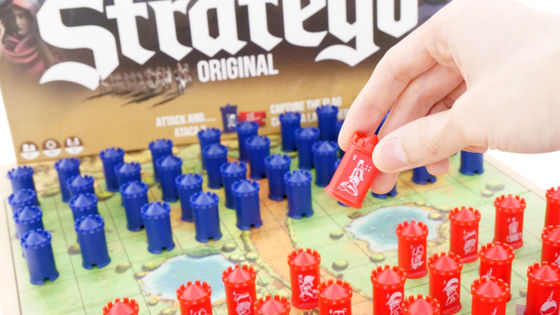
チェスや囲碁では盤上の情報が両者に公開されていますが、ストラテゴのようなゲームではプレイヤーごとに知っている情報が異なるため、「不完全情報ゲーム」と呼ばれます。例えば相手から手札が見えないポーカーも不完全情報ゲームの一種ですが、テキサス・ホールデムで最初に配られる2枚の手札は1326通りなのに対し、、ストラテゴでは初期配置だけで1033を超える可能性があります。さらに対局が非常に長くなることがあり、ブラフを使うかどうかも含めて判断しなければならないため、AIにとって非常に難しいゲームでした。
ストラテゴをプレイするAIとしては、Google DeepMindが2022年に発表したDeepNashが存在します。DeepNashはオンライン対戦サイト「Gravon」で評価され、評価対象となった50局のうち42局に勝利しました。
DeepMindのAI「DeepNash」がコマの正体を隠す軍人将棋「ストラテゴ」をマスター - GIGAZINE
by SonnyandSandy
しかし、研究チームによれば、すでに有力プレイヤーの多くがGravonで活動しなくなっており、DeepNashが対戦した相手はトップクラスの人間とは大きく実力が離れていたとのこと。また、2023年のストラテゴ世界選手権でDeepNashを人間と対戦させた際には19勝9敗を記録したものの、ニーメイヤー氏を含む上位プレイヤーの多くには敗れています。このため、DeepNashが「人間を超える強さ」に到達していたとは研究チームは評価していません。
AtaraxosとDeepNashはどちらも人間の棋譜を学習するのではなく、自分自身との対戦を繰り返す「自己対戦」によって戦略を学習する点では共通しています。しかし、Ataraxosは「実際の対局中に相手の隠された駒を推測し、その情報を使って先の展開を探索してから手を選ぶ」という点で、DeepNashと大きく異なるとのこと。DeepNashはストラテゴの膨大な探索空間を扱うことが困難だったため、対局中に先の展開を探索して判断を改善する仕組みは採用されていませんでした。
Ataraxosには、自己対戦によって手を選び勝敗を予測する「policy-value network」に加えて、相手の隠された駒を推測する「belief network」が導入されています。Ataraxosは手を指す前にbelief networkを使って、現在までに判明している情報から相手の駒の配置としてありそうなパターンを生成します。その上で、それぞれのパターンについて候補となる手から先の展開をシミュレーションし、結果を比較して実際の手を選びます。考えられる全配置を総当たりするのではなく、もっともらしい配置を絞り込んで探索することで、ストラテゴでも対局中の探索を実用的にしました。
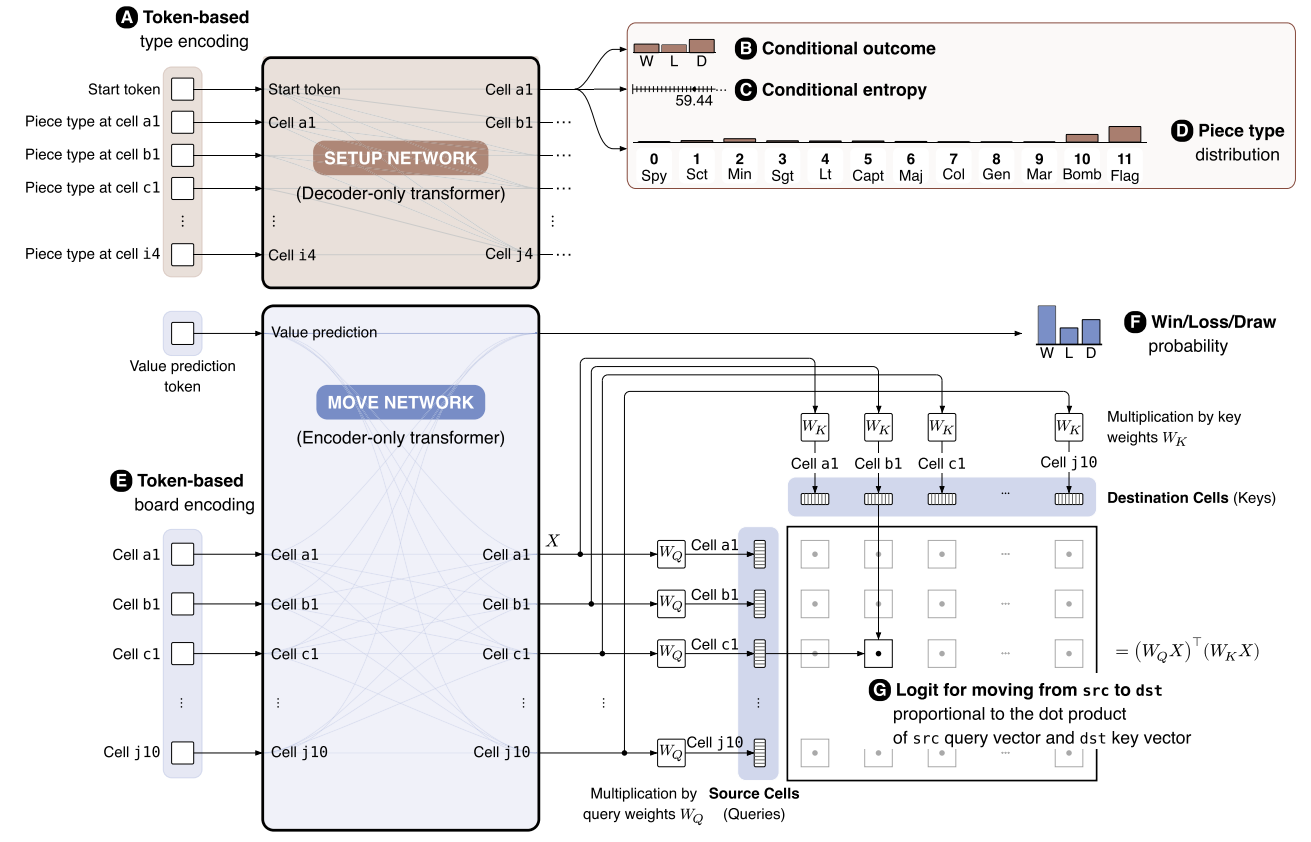
また、学習方法にも改良が加えられています。不完全情報ゲームでは、自己対戦による戦略の更新が循環したり不安定になったりしやすいため、Ataraxosは学習初期に戦略を大きく更新し、学習が進むにつれて更新を慎重にする仕組みを採用しました。また、駒の初期配置を学習するネットワークと、対局中の動きを学習するネットワークを分離しながら相互に連携させています。
さらに、計算コストもDeepNashとの大きな違いです。DeepNashは1024個のTPUを2~3カ月使用して学習したとされ、研究チームは2025年時点の価格なら計算コストは約300万~450万ドル(約4億5000万~6億7500万円)になると試算しています。また、学習した自己対戦も約55億局に上ります。一方、Ataraxosの強化学習には16基のNVIDIA H100を1週間、belief networkの学習には4基のH100を4日間使用しただけで、総コストは8000ドル(約120万円)未満でした。自己対戦は約1億6300万局で、DeepNashより大幅に少ない計算資源と学習データで、より強いAIを実現しています。
研究チームはAtaraxosを、世界選手権4回、オランダ国内選手権15回、オンライン世界選手権2回の優勝経験を持ち、世界ランキング1位に通算600週間以上在位という輝かしい戦績を持つニーメイヤー氏と20局対戦させました。その結果、Ataraxosは15勝1敗4引き分けとなり、引き分けを0.5勝として計算した実効勝率は85%でした。ニーメイヤー氏にはAtaraxosが対戦相手に合わせて戦略を変更しないことも事前に伝えられており、20局を通じてAIの弱点を探して攻略することも可能な条件でした。
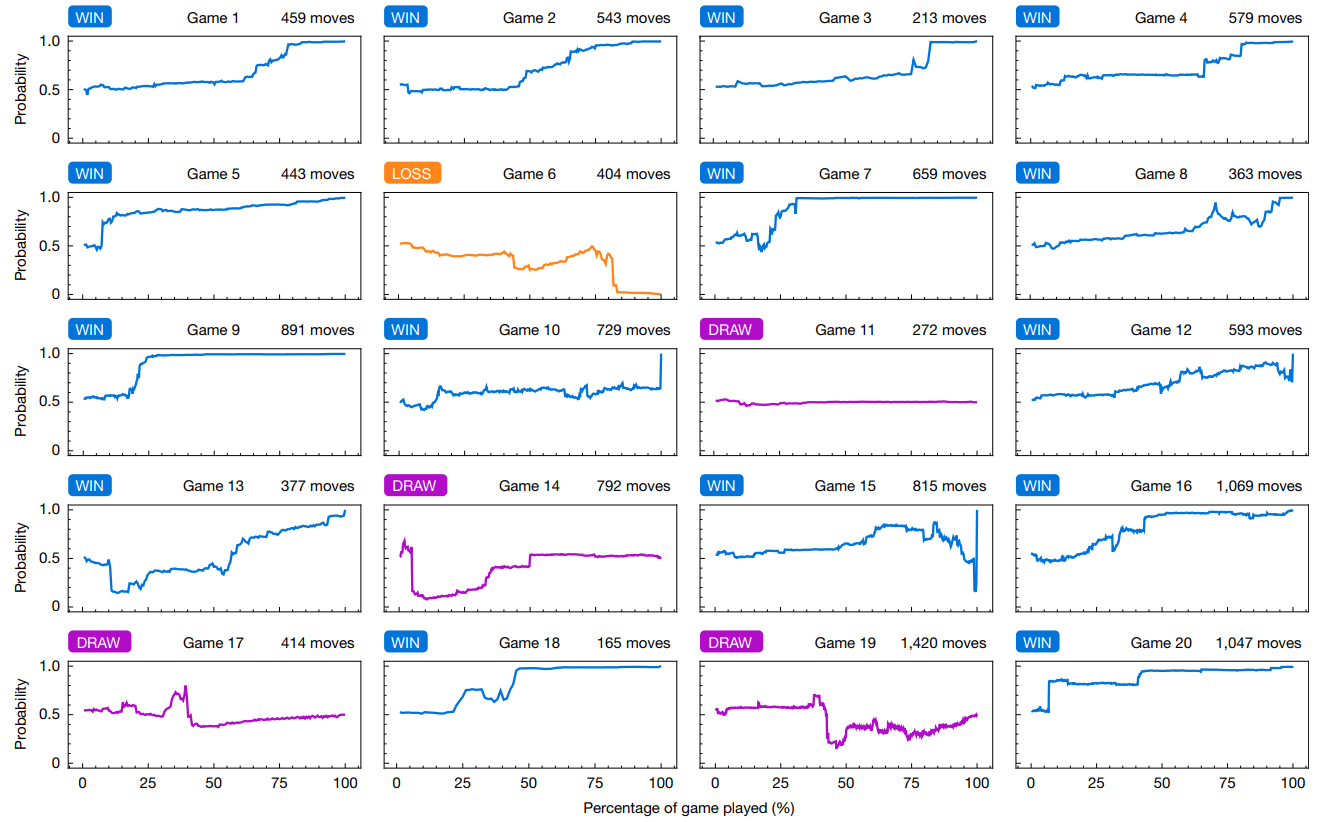
さらに、2025年ストラテゴ世界選手権の会場では参加者がAtaraxosと40局を戦い、Ataraxosが38勝2敗を記録。研究チームによると、人間とは異なる戦術も見られ、駒の正体を動きから読みにくくしたり、人間には危険すぎると考えられるブラフを使ったりするほか、不利な状況でも粘り強く戦って勝利や引き分けに持ち込む能力に優れていたとのことです。
加えて、研究チームは駒を8個に減らした「Barrage Stratego」でも世界王者3人を破ったほか、協力型カードゲームの「花火(Hanabi)」では従来の最高水準を更新し、中国で広く遊ばれているカードゲーム「闘地主」でも従来の最強クラスのAIを上回りました。研究チームは、大量の情報が隠された状況でも、「自己対戦による強化学習」「隠された情報を推測するモデル」「行動直前の探索」を組み合わせることで高度な意思決定が可能であることが示されたと論じています。
研究チームは、Ataraxosで開発した技術をボードゲーム以外にも応用できる可能性があると考えています。現実世界の交渉や金融市場、軍事衝突などはストラテゴとは異なり、明確なルールや勝敗が定められているわけではありません。しかし、共同研究者のユージン・ヴィニツキー氏は、現実の問題を扱う際にもまず単純化したモデルを構築することになると指摘し、「ウォーゲームは一般的に行われているものです。ここで開発された技術を使って状況を先に進め、強力な相手が自分の行動にどう反応するかを調べることができます」と述べています。
一方、Ataraxosには「なぜその手を選んだのか」を人間に説明できないという課題が残されています。共同研究者のガブリエレ・ファリーナ氏は、「ただ強いだけでなくその戦略を人間に説明できる段階にはまだ到達していないと思います」と述べ、今後の研究課題としました。
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.