История 6-го места ARC-AGI-3
Только что закончился конкурс на kaggle ARC-AGI-3. Пока что у меня есть данные только по публичной доске лидеров, то есть результат не окончательный. Окончательные результаты должны быть через месяц.
Пока мысли свежи захотелось сделать разбор.
Писать буду сам, без ИИ, так что может выйти немного сумбурно.
Для начала, про сам конкурс. Это соревнование на написание лучшего агента который прошел бы игры в стиле 8 бит https://arcprize.org/arc-agi/3 .
Условия такие: раз в день можешь делать отправку, которая будет 9 часов считаться на машине с мощной GPU (G4). 96 ГБ vram, 180GB RAM. Сам Kaggle дал всем участником по 30 часов такой же машины в свободное пользование (но без интернета) для участников конкурса. Этого достаточно чтобы запустить некоторые весьма толковые LLM. Например, Qwen3.8 Next Flash (то, на что практически все пересели ближе к концу).
Конкурс поделен на три ступени: milestone 1, milestone 2, final. Разница примерно 1 месяц между каждыми. Полагаются денежные призы за лидеров каждого (из тех кто отдаст в свободный доступ свое решение). Конкуренты были весьма сильны, так что и занятие 6-го места чувствуется достижением. Вот например на третьем - команда Kaggle Grandmaster от Nvidia.
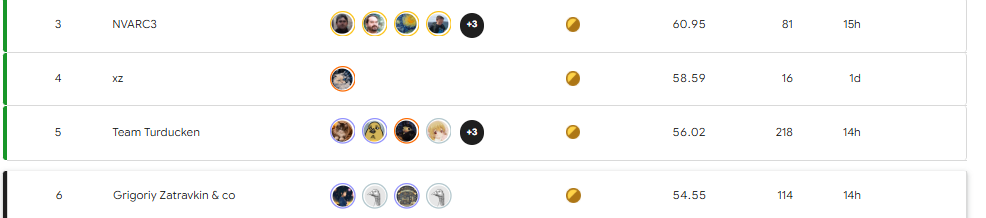
Сперва про общие впечатления. Это было мое первое участие в соревнованиях такого рода. И было это очень затягивающе! Мне кажется, сам формат подобных конкурсов генерирует некую дофаминовую петлю. Раз в день посылаешь результат и ждешь, обновляешь страницу, смотришь на результат. Ждать долго, вызывает нетерпение. Обычно очки +- такие же но иногда бывают прорывы! И это так весело.
Я подключился после Milestone 1. Топ-1 агент там был в целом простой, понятный. Модели передается Ascii + картинка (модель мультимодальная). Работает все через Python песочницу. Модель может запускать код для анализа доски либо для действий.
То что было неочевидно в начале, это то что практически любые правки поверх этого вообще ни к чему хорошему не приводили. Я попробовал просто огромное количество ручек. Небольшой список из того что сейчас вспоминается:
Агент-дуэлист (два агента параллельно), судья судит кто лучше
Разные цветовые схемы для изображения (больше контраст, выделить линиями рамки, заменить цвета, цветовые схемы для дальтоников и т.д.)
Разное количество пикселей на логический блок картинки
Агент-фотограф (пишет свой альбом механик и собирает скриншоты с подписями на каждую механику что сфотографировал)
Совсем другие типы окружения, навроде агент что пытается создать модель мира програмно (это то что хорошо работает у больших моделей)
В целом, результат - все либо в ноль (на уровне шума) либо сильное ухудшение.
Весь первый месяц участия я потратил на это, на подбор разных ручек, надеясь что уж в этот раз это сработает. А к тому же в первом месяце еще qwen3.8 next flash не вышел, все сидели на плотной модели. Она медленнее генерирует, а медленнее генерация - больше шума \ меньше опытов что можно провести.
К концу первого milestone, когда уже вышел Qwen3.8 next flash (модель с 512 экспертами вместо модели плотных весов что все использовали) я начал осторожно пробовать менять сам серв и оптимзиировать скорость.
В целом я был очень осторожен. Я в области оптимизации вычисления моделей новичок (хоть у меня и есть некий опыт с ГПУ с разработки игр), так что поспрашивал LLM (claude) что стоит делать, что разумно и т.д. Оттуда после некоторых исследований и получил идею срезать 112 экспертов, с 512 к 400.
Вот здесь я и получил небольшую прибавку к скорости, примерные цифры: играл 10 линий одновременно, скорость примерно 500 токенов в секунду вместо 300 в начале. И я даже гордился собой что вот смог наоптимизировать. Каково же было мое удивление и разочарование когда Milestone 2 победители открыли свои решения и практически все что они сделали было посвящено оптимзиациям серва! Сам агент практически полная копия того же что и я использовал. Просто значительно быстрее (примерно 900 токенов в секунду против моих 500). И от туда была весьма значительная разница в скоре: от моих 7 очков до их 20-25.
С этого момента (первые числа октября) я и решил по полной вложиться в interference optimizations. Примерно с первого октября по 20-ое провел по полной программе погружаясь в оптимизации серва на vllm.
Оптимизаций было столько что уже и упомнить все сложно. Но остановлюсь все же здесь немного поподробнее, так как это самая техническая часть статьи.
Вообще что из себя представляет модель qwen3.8 next flash?
Модель в основном это плотные веса, 512 экспертов, черновиковая голова на уровне данных. Постараюсь объяснить попроще, чтобы те кто никогда в модель не погружались смогли тоже понять. Я кстати и сам далеко не профи в interference optimization, разбирался в этом сам с нуля, с помощью claude последние недели 3. Так что технически может скажу что то не так.
Эксперты - это условно говоря просто те же веса модели, но нарезанные в кучку. Каждый ход роутер выбирает топ 10 экспертов которые наиболее подходят для того чтобы посчитать следующий токен на основе предыдущих токенов. И использует для расчета плотные веса (то что всегда используется) плюс эти топ 10 экспертов.
На уровне вычисления это примерно так идет:
Есть два типа шагов. Prefill и decode.
Prefill нужен тогда, когда добавляются новые токены (то есть ответ пользователя или сообщения от окружения к модели). Например, модель написали Python code, походило Action Right. Окружение посылает результат. Этот результат вставляется к модели и она продолжает размышления.
Принципиальная разница между prefill и decode шагами заключается в том, что токены у prefill можно читать параллельно. То есть этот от окружения к модели, его нужно обсчитать. Представить его в числовом виде. И можно это сразу делать со всеми токенами параллельно. Поэтому "Read" у моделей намного быстрее "write". Потому что писать токены нужно один за другим (с небольшим исключением из за черновиков). Черновики - сгенерирвоанное продолжение с помощью намного меньшей моделью.
У самого факта, что шаг prefill, есть некоторая цена. Он идет по немного другому пути и медленее. Есть примерно 30мс наценки на шаг за то, что он prefill. Поэтому и выгоднее чтобы этих шагов было как можно меньше. Это кстати одна из недавних оптимзиаций что делал. Планировщик префила - копить префил пока его не станет много. Тут дело в том, что пока линия ждет чтения (префил) она не может продолжать работу. Но так как по конкурсу 110 игр паралельно играют, то вполне можно подождать пока 2-3-4 линии не соберут побольше префила. А потом его прочитать вместе.
В целом, чем больше линий играет сразу, тем лучше. Есть несколько проблем. Сами 512 экспертов и плотные веса даже в низком разрешении забивают почти все 96 ГБ у карты. Примерно можно было гонять 15 линий параллельно так.
Вот здесь важно - это рецепт как гонять 110 линий параллельно на этой карте. Самые большие рычаги. Вынести всю память линий в RAM. Сделать обрезку памяти линий kv int 4 4 (это разрешение памяти в RAM. Чем меньше тем менее точно). Срезать сотку экспертов из ГПУ (то есть модель не сможет обращаться к наиболее подходящим экспертам, придется выбирать чуть худших).
В целом одно это позволяет гонять плюс минус эти 70 линий, но так как память в ram убрана, то выходит не очень быстро. Плюс минус 1200 т \с и это с потерей качества ( в основном из за утраты экспертов).
Моя итоговая скорость была ~3400 т\с, играет все 110 линия параллельно, 400 экспертов
Теперь постараюсь упомнить все самые значимые оптимизациями по которым прошелся за этот месяц и которые без подглядки могу вспомнить.
Стохастические черновики. Идея тут следующая. Черновиковая голова, как и сама модель, предскзаывает вероятности следующего токена. Черновик генерирует несколько токенов вперед (в моем случае генерировалось 4 токена продолжения) Если распределение близко к самой модели, то можно предсказать лучше, чем просто угадать топ-1 вариант модели.
Дележка экспертов. Идея такая. Если токену был нужен какой либо эксперт который был почти выбран ею, а он при этом еще и кем то другим был выбран, то даем ему этого вместо самого подходящего. Это дало процентов 5-10% скорости но в итоге вышло в минус по качеству - пришлось вычеркнуть.
Дообучение черновиков на контексте агента. Это чистый плюс - так еще процентов 5 скорости можно получить. Черновик не был специально заточен для именно этого агента. А так как модель весьма мелкая, то ее и несложно на дешевых картах обучить.
Не пересчитывать префил при обрезках контекста. Тут дело в том, что у модели есть две памяти. Одна - информацию про все токены. Это точная память. Второе - GDN память. Это что то навроде общего состояния всей памяти. Удобно сравнить с "смутное ощущение что это было где то здесь". Идея такая: при обрезке контекста не пересчитывать это состояние. Агент работал и даже были надежды что мол станет играть лучше потому что будет смутно помнить что уже делал. Это просто уменьшает количество префил шагов, может давало процентов 5% скорости тоже.
Переписывание с Triton на Cuda и использование небезопасного кода. Порядок то же примерно тот же: 3-5% к скорости.
Речь идет о большем количестве мелких оптимизаций, которые все в сумме позволили гонять 110 линий параллельно на скорости 3.3к. Из затрат на это ушло примерно 30 долларов на подписку Colab + подписка на Claude. Одно из самых эффективных действий для оптимизации - открыть SSH на Colab с машиной с картой и позволить Claude гонять по кругу улучшения. Но здесь даже на opus 5.5 нужен глаз да глаз. И направлять постоянно приходилось. Возвращать к перспективным направлениям. Уменьшать длину экспериментов. Оптимизировать эксперименты по времени и ресурсам. И т.д. https://gzatravkin.github.io/arc-agi-3-run-curves/ вот здесь можно посмотреть разные графики скорости (это то что я сам для внутреннего пользования делал и для отладки, выглядит немного неопрятно).
По очкам было так. Примерно 15-го октября удалось дойти до 45 очков. Потом увлекся оптимизациями. Были краши, давало 0 очков, 10 очков. Ближе к концу конкурса, Kaggle начало штормить. Постоянные очереди за ГПУ, отправки на оценивания ломались. Просто возвращало Kaggle error. Здесь, лично мне чувствуется немного несправедливости. У меня лично было 3 попытки подряд что не смог отправить из за ошибок. То есть было меньше возможности улучшить что то. Примерно 25-го октября ситуация стабилизировалась. Но я заметил, что даже с почти вдвое больше скоростью по сравнению с 15-го октября у меня скор немного меньше. 39 против 45.
Последние 5 дней провел пытаясь вернуться хоть к прежним очкам. Локально прогнал эксперементы на 9 часах на старом движке против нового. Удалось выяснить что да, была потеря качества от некоторых оптимизаций. Было видно, что старый серв играет немного лучше.
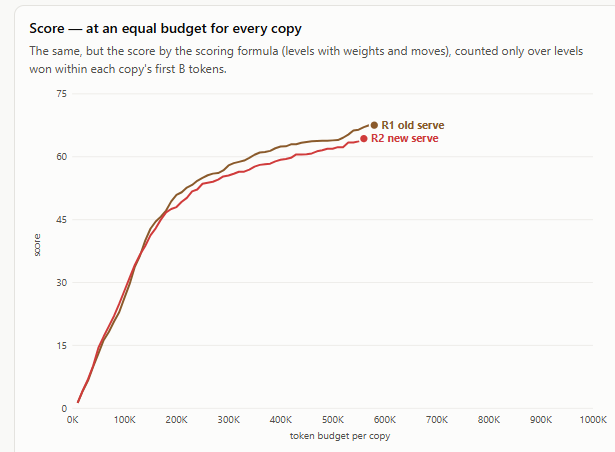
И самое важное - здесь проявляется плато. После долгих часов игр, практически нет никакой разницы между 600к токенов и 900к на игру.
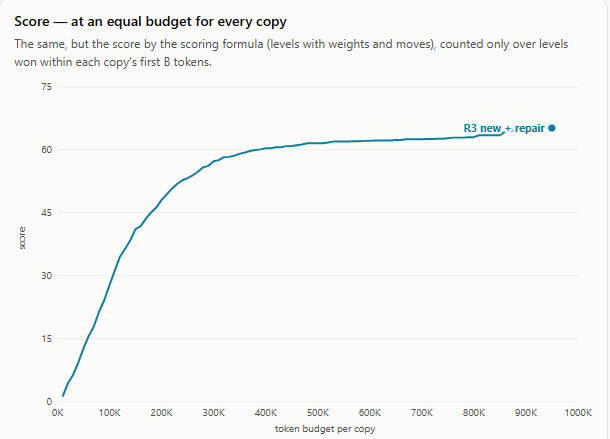
Это потому что модель застревает на самых сложных уровнях, все легкое уже взято, а даже если и проходит что то, то с очень маленькими очками (чем больше действий тем меньше очков дают).
Здесь я начал делать две вещи параллельно.
Во первых, отказался от большинства оптимизаций что хоть чуть чуть понижали качество (кроме 400 экспертов и int 4 памяти). Этим мне уже удалось добиться 50 очков когда оставалось 4 дня до конца.
Во вторых, начал очень активно искать любые способы пробить плато. Сделал "стэнд подсадных уток". Работает так: берем запись игры из одного момента. Делаем десяток вариантов из этой точки. Добавляем части модификации. И смотрим какие дальше пройдут.
И пробовал такие вещи как
Рой агентов: агенты делят форум и общаются между собой и пытаются посоветовать агенту как пройти,
Веер мыслей: из контекста агента прогоняем кучу вариантов с высокой температуре ответа на вопрос "чтобы мне по другому сделать?" и посылаем агенту кто играет
Свежий взгляд: агент без контекста получает все изображения ходов агента и пытается только на этой основе подсказать что делать
"Ученик мастера" - новый агент проходит все ходы мастера, изучает доски, подходит к его уровню и пытается сделать что то лучше него или посоветовать ему что то
Помощники-делегаты (кучка агентов копает разные направления, баги в коде, что мог упустить по механикам и т.д.).
В целом здесь как и раньше с модификациями агента. Никакие ручки не помогают. Вот вообще. Результат на уровне шума либо в минус. Только зря потратил несколько ценных дней.
А вот с другой стороны, в последние 2 дня перед самым самым финалом меня осенило. А может все же 400 экспертов это все же плохо? Тут дело в том, что по замерам у них дрейф очень маленький. Токены практически те же самые. Но а вдруг какой то игре был нужен в какой то момент именно узкий эксперт? Я проверил, можно ли найти специализацию агентов. В целом словами ее описать скорее сложно чем просто. Но вот есть например агент по "плаванию" или физике воды. Что может пригодится в некоторых играх.
Т.к. гонять все 512 с нуля это жертвовать слишком сильно скоростью, то и попробовал сделать "сперва быстро но плохо, потом медленно но качественно". Главное здесь то, что игры заканчиваются. К шестому часу остается может 70 линий. Вот я и сделал горячую перенастройку. Сперва играю быстро с 400 экспертами, примерно на 3.3 т\с. Потому на шестом часу (из девяти) подключаю оставшихся 512 и иду на полном качестве. Это помогло подняться с 50 до 54 очков.
В самую последнюю отправку попробовал развить эту идею, идти с начала на 410 экспертах, подключить сперва 430, потом всех 512. Но видимо что то не так вышло и у этой отправки скор был только 40.
Было очень весело. Отдельное спасибо Florencia Solange, моей девушки, что участвовала со мной в конкурсе и помогала с прогонами экспериментов, и моим двум напарникам: deepdreamer и aizealotwu, кто попросились в команду ближе к концу и дали доступ к мощным ГПУ попробовать сделать дообучение модели.
Здесь я попытался немного перенести ощущения от участия в конкурсе с помощью мини игры - https://gzatravkin.github.io/last-bet/ , оно конечно слопно, но похоже.
А код самого решения можно посмотреть здесь https://github.com/gzatravkin/pathbreaker-arc-agi-3 .
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.