NFS нельзя оставлять открытым: шифрование, отказоустойчивость и никакого VIP
Привет, Хабр! Меня зовут Егор Шманев, я системный инженер в К2Тех. В статье расскажу, как мы построили отказоустойчивый файловый сервис с шифрованием трафика на стандартных серверах, без специализированной СХД. Разберу, как устроено переключение без виртуального IP (VIP) и что нужно проверить, прежде чем вводить такое решение в промышленную эксплуатацию.
К нам обратился крупный заказчик из финансовой сферы, которому требовался отказоустойчивый файловый сервис для информационных систем с поддержкой шифрования NFS-трафика. Его предстояло построить на стандартном серверном оборудовании, без дорогой специализированной СХД.
Казалось бы, при этих ограничениях придется выбирать, чем пожертвовать: безопасностью, отказоустойчивостью, прозрачностью для приложений или бюджетом. Но мы нашли способ привычный для клиентов NFS, а сложную логику вынести туда, где она не мешает прикладным системам.
Ниже разберу, как устроена эта схема, почему в ней не нужен VIP, как два узла работают в составе единого файлового сервиса и какие условия нужно соблюсти, чтобы переключение не привело к потере данных.
На входе в проект заказчик обозначил три основных требования к файловому сервису:
трафик между клиентом и NFS‑сервером должен быть зашифрован;
сервис должен работать без виртуального IP, поскольку сеть заказчика поддерживает только L2-сегментацию и не позволяет реализовать необходимую для VIP L3-маршрутизацию;
сервис должен автоматически переключаться на резервный узел в другом ЦОДе при отказе активного.
Задача 1. Шифрование трафика
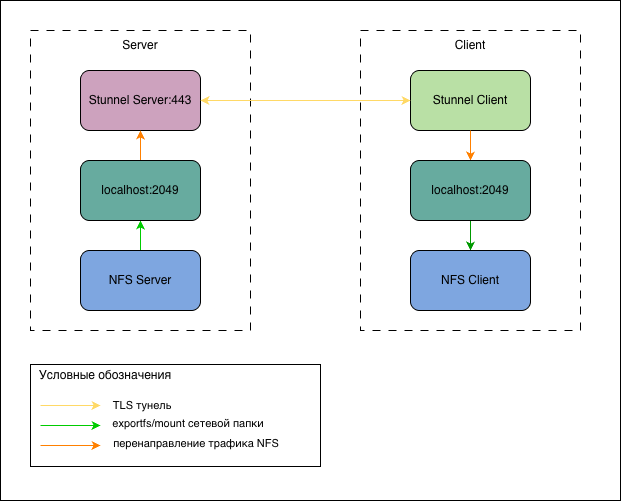
Для защиты трафика мы добавили отдельный слой шифрования на базе stunnel, который позволяет создавать зашифрованные туннели между серверами. В результате мы использовали следующую схему: серверный stunnel принимает зашифрованный трафик на порту 443, расшифровывает его и передаёт NFS-серверу на localhost:2049. На клиенте stunnel принимает локальные подключения на localhost:2049 и передает трафик серверному stunnel по зашифрованному соединению.
Задача 2. Переключение клиентов без VIP
Исторически в подобных схемах, без L3-маршрутизации, используют балансировщики с поддержкой GSLB, которые проверяют состояние служб и через DNS возвращают IP‑адрес текущего активного узла.
Изначально мы тоже рассматривали этот вариант, но нашли более простой подход. В конфигурации клиентского stunnel можно указать адреса двух серверов: при подключении он будет перебирать их и выбирать доступный. При отказе одного из узлов соединение восстанавливается через другой. Поскольку наша система работает в режиме active/passive и не требует балансировки нагрузки, такой вариант нам подходит.
Задача 3. Объединение компонентов в кластер
Мы определили, как зашифровать трафик и организовать переключение клиентов без VIP. Следующая задача — объединить компоненты в отказоустойчивый кластер. Для этого мы выбрали проверенную связку Pacemaker + DRBD.
DRBD, Pacemaker и NFS часто используют вместе для построения двухузлового высокодоступного файлового сервиса: DRBD обеспечивает репликацию хранилища, а кластерный менеджер Pacemaker управляет тем, на каком узле должен находиться активный ресурс.
В таблице ниже перечислены компоненты целевой архитектуры и их роли:
Компонент | Роль в архитектуре |
DRBD | Синхронно реплицирует блочное устройство между двумя узлами |
ext4 | Файловая система поверх активного DRBD-ресурса |
Corosync | Обеспечивает обмен сообщениями внутри кластера и информацию о составе его узлов |
Pacemaker | Управляет ресурсами, зависимостями и автоматическим переключением |
Quorum device | Помогает кластеру принимать решения в спорных сценариях |
NFS | Предоставляет клиентам доступ к файловому каталогу |
stunnel | Передает NFS-трафик по TLS и открывает внешний порт сервиса под управлением Pacemaker |
Клиентский stunnel | Предоставляет локальную точку подключения к NFS и направляет новые соединения к доступному TLS-бэкенду |
Для многокомпонентной системы active/passive важно задать в Pacemaker корректную последовательность запуска ресурсов. На активном узле она выглядит так:
DRBD Promoted
    ↓
Файловая система
    ↓
NFS server
    ↓
NFS export
    ↓
stunnel
Если нарушить эту последовательность, stunnel может начать принимать клиентские подключения до того, как будет смонтирована файловая система или активирован NFS-экспорт. Pacemaker в этой схеме нужен не только для перезапуска сервисов, но и прежде всего для соблюдения правильной последовательности состояний.
Реализация решения
Используем два рабочих узла и отдельный сервер quorum device:
Узел | Диск | IP-адрес | Роль |
nfs-01.dm.ald | /dev/sdb | 172.26.74.237 | Рабочий узел кластера |
nfs-02.dm.ald | /dev/sdb | 172.26.73.238 | Рабочий узел кластера |
nfs-03.dm.ald | __ | 172.26.72.239 | Сервер quorum device; не хранит данные и не запускает NFS-ресурсы |
В состав Pacemaker/Corosync‑кластера входят nfs-01.dm.ald и nfs-02.dm.ald. Узел nfs-03.dm.ald используется как отдельный сервер quorum device. Он не участвует в репликации DRBD и не обслуживает NFS, и является только дополнительным голосом для кворума.
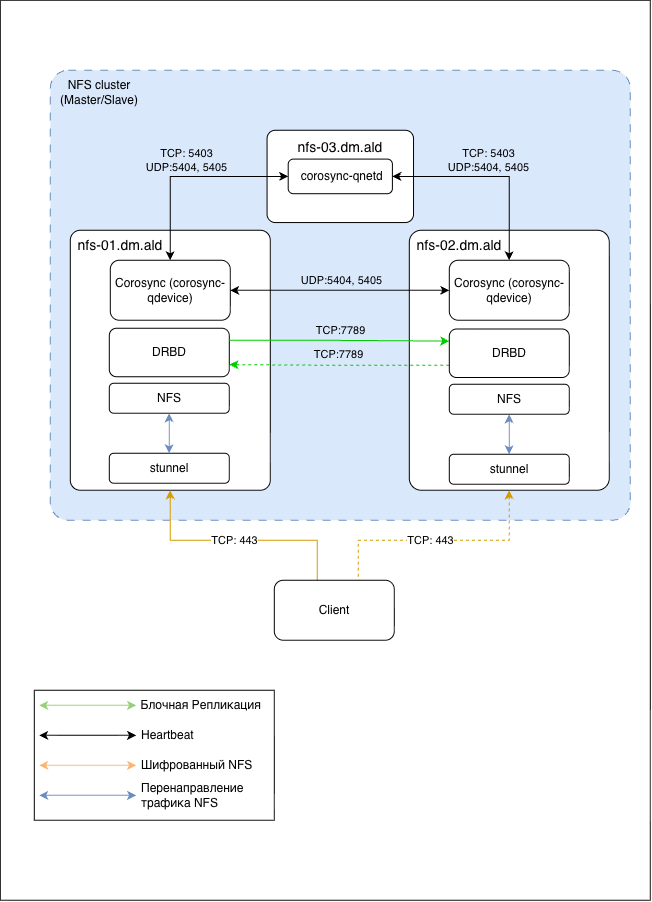
На обоих рабочих узлах используется локальный диск /dev/sdb. Раздел /dev/sdb1 служит основой для DRBD-ресурса shared, доступного как /dev/drbd1. Файловая система монтируется в /srv/nfs только на узле, который Pacemaker перевел в активную роль.
Шаг 1. Подготовка имен и дисков
a) Имена узлов, указанные в конфигурациях DRBD, Corosync и Pacemaker, должны совпадать с именем, которое возвращают hostname -f или uname -n, и стабильно разрешаться через DNS либо /etc/hosts. Разрешение имен нужно настроить для всех узлов, включая сервер quorum device.
#/etc/hosts
172.26.74.237 nfs-01.dm.ald nfs-01
172.26.73.238 nfs-02.dm.ald nfs-02
172.26.72.239 nfs-03.dm.ald nfs-03
b) На рабочих узлах подготавливаем раздел /dev/sdb1 на диске /dev/sdb:
#fdisk /dev/sdb

n
p
1
Enter
Enter
w
c) Создаем точку монтирования:
mkdir -p /srv/nfsШаг 2. Настройка DRBD
a) На рабочих узлах nfs-01.dm.ald и nfs-02.dm.ald устанавливаем DRBD и отключаем его самостоятельный запуск:
apt update

apt install -y drbd-utils

systemctl disable drbd
b) Создаем файл конфигурации DRBD-ресурса (например, /etc/drbd.d/shared.res), определяющий параметры ресурса на двух узлах:
resource shared {
    protocol C;
    device    /dev/drbd1;
    disk      /dev/sdb1;
    meta-disk internal;

    disk {
        fencing resource-and-stonith;
    }
    net {
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
        ping-timeout 30;
    }
    handlers {
        fence-peer "/usr/lib/drbd/crm-fence-peer.sh";
        after-resync-target "/usr/lib/drbd/crm-unfence-peer.sh";
    }

    on nfs-01.dm.ald {
        address 172.26.74.237:7789;
    }
    on nfs-02.dm.ald {
        address 172.26.73.238:7789;
    }
}
Файловая система на виртуальном устройстве /dev/drbd1 создается только один раз во время настройки. Не форматируйте ресурс на втором узле и не выполняйте mkfs после того, как ролью DRBD начал управлять Pacemaker.
c) Проверяем конфигурацию на обоих узлах:
drbdadm dump alld) Создаем метаданные, запускаем ресурс и проверяем его состояние на рабочих узлах:
drbdadm create-md shared
drbdadm up shared
drbdadm status
e) Для нового пустого устройства один из узлов однократно переводим в роль DRBD Primary и создаем файловую систему. В примере это nfs-01.dm.ald:
drbdadm primary shared
mkfs.ext4 /dev/drbd1
drbdadm status
Ниже примеры корректного статуса drbd после настроек на обоих узлах:
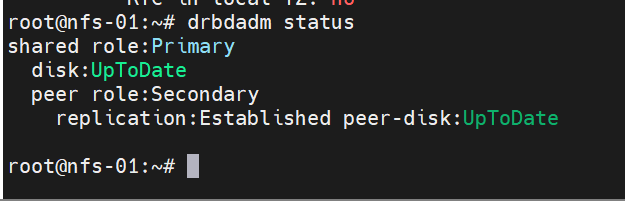
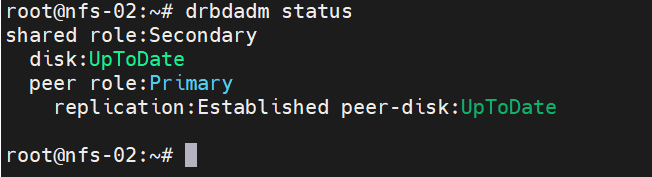
После настройки Pacemaker на шаге 4 он будет управлять ролями DRBD и монтированием файловой системы. Не следует вручную менять роль DRBD в работающем кластере: управлять состоянием ресурсов должен только кластерный менеджер.
Шаг 3. Подготовка stunnel и сертификатов
В конфигурации ниже используется взаимная TLS‑аутентификация: verifyChain = yes означает, что цепочка сертификата проверяется по доверенному CA, а requireCert = yes на сервере обязывает клиента предъявить сертификат. Поэтому для стенда нужны как минимум server.crt, server.key, client.crt, client.key и общий корневой сертификат ca.cert.pem.
Корневой сертификат в параметре CAfile должен быть одним и тем же на клиенте и на обоих NFS‑узлах. Сертификаты серверов и клиентов должны быть подписаны этим доверенным CA, иначе взаимная TLS‑аутентификация не будет работать.
a) На серверах nfs-01.dm.ald и nfs-02.dm.ald устанавливаем серверные пакеты:
apt update
apt install -y stunnel4 nfs-kernel-server
b) Запуском этих сервисов на NFS‑узлах управляет Pacemaker, отключаем их автозапуск и останавливаем сервисы на обоих узлах:
systemctl disable --now stunnel4 nfs-kernel-serverИначе stunnel может запуститься на пассивном узле, и TLS‑порт 443 окажется открытым не только на активном узле.
c) На обоих NFS‑узлах создаем /etc/stunnel/stunnel.conf:
chroot = /var/lib/stunnel4/
setuid = stunnel4
setgid = stunnel4
pid = /stunnel4.pid

cert = /etc/stunnel/server.crt
key = /etc/stunnel/server.key
CAfile = /var/lib/stunnel4/certs/ca.cert.pem

verify = 2

[NFS]
accept = 0.0.0.0:443
connect = 127.0.0.1:2049
В примере stunnel слушает все интерфейсы на TCP-порту 443. В промышленной среде ограничьте доступ к этому порту правилами межсетевого экрана и, если архитектура позволяет, укажите конкретный сервисный адрес вместо 0.0.0.0.
Серверный stunnel передает расшифрованный трафик в NFS только через loopback‑интерфейс: 127.0.0.1:2049. Внешние клиенты не должны иметь прямой сетевой доступ к TCP-порту 2049.
d) На NFS‑клиенте устанавливаем клиентские пакеты:
apt update
apt install -y stunnel4 nfs-common
e) На NFS‑клиенте создаем конфигурацию:
chroot = /var/lib/stunnel/
setuid = stunnel
setgid = stunnel
pid = /stunnel.pid

cert = /etc/stunnel/client.crt
key = /etc/stunnel/client.key
CAfile = /var/lib/stunnel/certs/ca.cert.pem
verify = 2

[NFS]
client = yes
accept = 127.0.0.1:2049
connect = nfs-01.dm.ald:443
connect = nfs-02.dm.ald:443

checkHost = nfs-01.dm.ald
checkHost = nfs-02.dm.ald
Две директивы connect задают адреса серверов для подключения и резервирования. Две директивы checkHost требуют, чтобы сертификат сервера содержал хотя бы одно из указанных DNS‑имен. Если для каждого узла используется отдельный сертификат, поле SAN сертификата nfs-01 должно содержать имя nfs-01.dm.ald, а поле SAN сертификата nfs-02 — nfs-02.dm.ald.
f) Перезапускаем stunnel на NFS-узлах и клиенте для применения настроек:
systemctl restart stunnel4Шаг 4. Настройка Pacemaker
a) Устанавливаем Pacemaker и Corosync на рабочих узлах nfs-01.dm.aldиnfs-02.dm.ald:
apt install -y corosync resource-agents pacemaker pcs corosync-qdeviceb) Для служебного пользователя hacluster задаем одинаковый пароль на всех трёх узлах:
passwd haclusterc) Запускаем службу pcsd на nfs-01.dm.aldиnfs-02.dm.ald:
systemctl enable --now pcsdd) Выполняем аутентификацию узлов и создаем кластер на nfs-01.dm.ald:
pcs host auth nfs-01.dm.ald nfs-02.dm.ald -u hacluster

pcs cluster setup newcluster nfs-01.dm.ald addr=172.26.74.237 nfs-02.dm.ald addr=172.26.73.238
e) На рабочих узлах nfs-01.dm.aldиnfs-02.dm.ald запускаем службы Pacemaker и Corosync и проверяем состояние кластера:
systemctl enable --now pacemaker corosync
pcs status cluster
Шаг 4.1 Подготовка сервера quorum device
a) На nfs-03.dm.ald устанавливаем компоненты quorum device и запускаем сервис:
apt update

apt install -y pcs corosync-qnetd

systemctl enable --now pcsd

pcs qdevice setup model net --enable --start
Точные команды подготовки qdevice зависят от версии pcs и используемого дистрибутива. Перед внедрением сверяйтесь с документацией вашей платформы: синтаксис команд
pcs qdevice setupиpcs quorum device addможет различаться.
b) На nfs-01.dm.ald выполняем аутентификацию сервера quorum device в pcs:
pcs host auth nfs-03.dm.ald -u hacluster После этого добавляем quorum device в двухузловой кластер:
pcs quorum device add model net \
  host=nfs-03.dm.ald \
  algorithm=ffsplit \
  tie_breaker=lowest

pcs quorum status
Убедитесь, что узлы nfs-01 и nfs-02 могут подключаться к nfs-03 по TCP-порту 5403: это типовой порт corosync-qnetd.
Шаг 5. Настройка STONITH: почему его нельзя бездумно отключать
В официальной документации Pacemaker STONITH рассматривается как обязательный механизм изоляции узлов (fencing). Он использует средства управления питанием серверов для предотвращения split-brain и запуска ресурсов на устаревших данных.
В лабораторных инструкциях STONITH нередко отключают для упрощения демонстрации. В промышленной среде такое решение требует отдельной оценки рисков. При сетевом разделении узлы могут потерять информацию о состоянии друг друга. Если кластер не способен гарантированно остановить прежний активный узел, возникает риск split‑brain: оба сервера могут получить право на запись в разные версии данных.
В нашем кейсе мы отключили STONITH по требованию службы ИБ заказчика. Поэтому при сетевом разделении кластер не может гарантированно остановить прежний активный узел, и риск split-brain сохраняется. Система работает в полуавтоматическом режиме: восстановление требует ручного вмешательства. Порядок действий мы подробно описали в проектной документации и согласовали с заказчиком.
Для отключения STONITH выполните команду:
pcs property set stonith-enabled=falseПри настройке STONITH следует предусмотреть:
реальный механизм fencing: SBD, IPMI, iLO/iDRAC, fence‑agent для гипервизора или облачной платформы;
согласование политики DRBD fencing с настройками Pacemaker;
тестирование отказа сетевого канала между узлами;
мониторинг состояния DRBD и операций fencing.
Шаг 6. Настройка ресурсов и зависимостей pacemaker
Ниже все команды выполняются через временную CIB‑конфигурацию drbdconf на любом рабочем узле кластера. Это позволяет сначала сформировать полную цепочку ресурсов и ограничений, проверить ее, а затем применить одним действием.
pcs cluster cib drbdconfa) Создаем DRBD‑ресурс:
pcs -f drbdconf resource create drbd_shared \
  ocf:linbit:drbd \
  drbd_resource=shared \
  op start interval=0s timeout=240s \
  op stop interval=0s timeout=100s \
  op monitor interval=31s timeout=20s role=Unpromoted \
  op monitor interval=29s timeout=20s role=Promoted
Наличие OCF‑агента
ocf:linbit:drbdи название пакета, который его поставляет, зависят от используемого дистрибутива и репозитория DRBD. Перед созданием ресурса проверьте, что агент доступен:pcs resource agents ocf:linbit.
b) Настраиваем ресурс как promotable: роль Primary может быть только у одного экземпляра:
pcs -f drbdconf resource promotable drbd_shared \
  promoted-max=1 \
  promoted-node-max=1 \
  clone-max=2 \
  clone-node-max=1 \
  notify=true
c) Настраиваем ресурс файловой системы:
pcs -f drbdconf resource create fs_drbd \
  ocf:heartbeat:Filesystem \
  device=/dev/drbd1 \
  directory=/srv/nfs \
  fstype=ext4 \
  options=noatime,nodiratime \
  op start interval=0 timeout=60s \
  op stop interval=0 timeout=60s \
  op monitor interval=20s timeout=40s
Файловая система должна запускаться только на узле, где ресурс DRBD находится в роли Promoted:
pcs -f drbdconf constraint colocation add \
  fs_drbd with drbd_shared-clone INFINITY \
  with-rsc-role=Promoted
Файловая система запускается строго после перевода ресурса DRBD в роль Promoted:
pcs -f drbdconf constraint order promote \
  drbd_shared-clone then start fs_drbd
d) Настраиваем ресурс NFS‑сервера:
pcs -f drbdconf resource create nfs_server \
  ocf:heartbeat:nfsserver \
  op start interval=0s timeout=40s \
  op stop interval=0s timeout=20s \
  op monitor interval=10s timeout=20s
NFS‑сервис привязывается к узлу, на котором активен ресурс хранения:
pcs -f drbdconf constraint order fs_drbd then nfs_server NFS‑сервис запускается строго после монтирования файловой системы:
pcs -f drbdconf constraint order fs_drbd then nfs_server e) Настраиваем ресурс NFS-экспорта:
pcs -f drbdconf resource create exportfs \
  ocf:heartbeat:exportfs \
  clientspec=localhost \
  directory=/srv/nfs \
  fsid=0 \
  unlock_on_stop=1 \
  options=rw,sync,no_subtree_check,insecure \
  op start interval=0s timeout=40s \
  op stop interval=0s timeout=120s \
  op monitor interval=10s timeout=20s
Опция
no_root_squashсохраняет root-права клиента на экспортируемой файловой системе. Добавлять ее стоит только для конкретного сценария, после оценки рисков и согласования со службой ИБ. В нашем решении мы ее исключили.Параметр
insecureразрешает клиентские подключения с непривилегированных исходных портов. В нашем случае исходящее соединение серверногоstunnelидёт с непривилегированного порта (2049), поэтому этот параметр обязателен.
NFS-экспорт привязывается к узлу, на котором активен ресурс NFS-сервера:
pcs -f drbdconf constraint colocation add exportfs with nfs_server INFINITYNFS-экспорт запускается строго после NFS-сервиса:
pcs -f drbdconf constraint order nfs_server then exportfsЭкспортом управляет ресурс
ocf:heartbeat:exportfsв Pacemaker. Не добавляйте этот же каталог вручную в /etc/exports: иначе у одного NFS‑экспорта появятся два независимых источника конфигурации.
f) Добавляем stunnel как внешний TLS‑прокси. Его запуск разрешен только после готовности экспорта:
pcs -f drbdconf resource create stunnel \
  systemd:stunnel4 \
  op monitor interval=60s timeout=30s \
  op start interval=0s timeout=90s \
  op stop interval=0s timeout=90s

pcs -f drbdconf constraint colocation add \
  stunnel with exportfs INFINITY

pcs -f drbdconf constraint order \
  start exportfs then start stunnel
Применяем CIB‑конфигурацию только после того, как в ней собраны все ресурсы и ограничения. После применения проверяем состояние кластера:
pcs cluster cib-push drbdconf

pcs status --full
Все зависимости заданы в Pacemaker: он не запустит stunnel, пока на активном узле не будут готовы DRBD, файловая система, NFS‑сервер и экспорт.
На этом настройка кластера завершена.
Как монтируется ресурс на клиенте
После запуска stunnel на клиенте NFS-ресурс монтируется не по адресу кластера, а через loopback‑интерфейс:
mkdir -p /NFS_Client

mount -t nfs4 -o port=2049 localhost:/ /NFS_Client
Для приложения точка монтирования остается прежней – /NFS_Client
С точки зрения сети трафик проходит по следующей цепочке:
Клиент NFS(/NFS_Client)
    ↓
localhost:2049
    ↓
client stunnel
    ↓
   TLS
    ↓
active NFS node:443
    ↓
server stunnel
    ↓
localhost:2049
    ↓
   NFS
Именно это разделение делает схему удобной: приложение не знает о DRBD, Pacemaker, DNS‑именах узлов, сертификатах и смене активного узла.
Что происходит при отказе
Рассмотрим сценарий отказа. Предположим, что активным был nfs-01.dm.ald.
До отказа:
nfs-01 — DRBD Primary, ext4, NFS, exportfs, stunnel
nfs-02 — DRBD Secondary
При отказе активного узла переключение происходит в следующем порядке:
Corosync и Pacemaker обнаруживают и фиксируют недоступность узла.
Pacemaker с помощью STONITH изолирует прежний активный узел и исключает возможность его дальнейшей работы. В нашей конфигурации этот шаг отсутствует, поскольку STONITH отключен.
Pacemaker переводит DRBD на
nfs-02в роль Primary. Дальнейшие действия выполняются наnfs-02.Монтируется
/dev/drbd1.Запускается NFS‑сервер.
Активируется NFS-экспорт.
Запускается серверный stunnel.
Когда Pacemaker запускает stunnel на
nfs-02.dm.ald, NFS‑клиент начинает восстанавливать разорванное соединение. При новой попытке подключения клиентский stunnel использует доступный бэкендnfs-02.dm.ald:443.
Stunnel не переносит существующее TCP‑соединение NFS между серверами. При отказе активного узла текущее соединение разрывается, а доступ восстанавливается за счет переподключения клиентского stunnel к новому активному узлу. Для NFS-клиента это выглядит как восстановление соединения с сервером. Так схема обеспечивает переподключение без VIP.
Что в итоге получилось
В результате мы получили программный файловый сервис с защитой трафика и переключением между двумя узлами – без специализированной СХД и внешних балансировщиков.
За этим результатом стоит не только настройка отдельных компонентов, но и понимание того, как они работают вместе – в штатном режиме и при отказах. Мы опирались на требования заказчика, подбирали под них технологический стек и адаптировали решение к ограничениям инфраструктуры.
Приходилось ли вам строить отказоустойчивый файловый сервис NFS? Делитесь в комментариях, как организовали переключение клиентов и с какими ограничениями столкнулись.
KioskNews shows a cleaned-up reading view extracted from the publisher’s page — the original always lives on their site, not ours.